
Uma atualização com dados mais recentes, não uma descoberta inédita
A Pesquisa de Participação Pública nas Artes (SPPA, na sigla em inglês) de 2022 permite fazer uma pergunta específica sobre leitura: entre adultos selecionados que responderam de forma válida às duas perguntas, como a participação declarada em clubes ou grupos de leitura difere entre quem ouviu algum audiolivro e quem não ouviu? As estimativas condicionais ponderadas são de 13,1043% e 3,3770%, respectivamente. Trata-se de uma associação entre duas atividades lembradas para os doze meses anteriores. Não é uma medida de filiação formal a um clube, de preferência por um formato de leitura nem do efeito de entrar num grupo. Manter essa pergunta mais estreita à vista é essencial para interpretar o resultado.
Esta análise atualiza um tema já estudado, com uma onda de pesquisa mais recente. O relatório de 2020 do National Endowment for the Arts, How Do We Read? Let’s Count the Ways, já examinava a participação em clubes e grupos de leitura em 2017, segundo o tipo de leitor. A Figura 12 e a discussão em torno dela incluem ouvintes de audiolivros, e o Apêndice B-4 traz modelos com ajuste. A distinção usada agora, entre ouvir algum audiolivro e não ouvir nenhum, não é idêntica às classificações de tipos de leitores desse relatório. Por isso, os novos cálculos não estabelecem uma mudança entre 2017 e 2022, não reproduzem um contraste histórico idêntico e não revelam uma associação que a pesquisa oficial anterior tenha deixado passar.
O que as duas perguntas realmente medem
A variável sobre audiolivros, PEC1Q17A, registra se a pessoa selecionada ouviu algum audiolivro nos doze meses anteriores. O alcance inclui expressamente gravações, transmissões e streaming pela internet. A pergunta não exige terminar um audiolivro, citar um título ou declarar um mínimo de horas de escuta. Ao contrário de perguntas vizinhas sobre algumas atividades de leitura, o texto deste item não exclui o que se faz por trabalho ou estudo. Uma resposta afirmativa mostra, portanto, escuta declarada dentro dessa definição ampla, e não escuta só por lazer nem dedicação contínua a um livro inteiro. Uma resposta negativa mostra que a pessoa declarou não ouvir, e não que ela não goste de áudio.
A variável de participação, PEMCQ1I, trata de tomar parte em algum clube ou grupo de leitura no mesmo período de lembrança. Ela não pergunta se a pessoa era sócia formal na data da entrevista, se pagava mensalidade, se participava pela internet, se se reunia numa biblioteca ou se ia a um mínimo de encontros. Uma pergunta separada sobre frequência vem depois, mas a frequência não é o resultado analisado aqui. Nenhuma das perguntas estabelece que um audiolivro tenha sido o livro escolhido pelo clube. A combinação descreve duas atividades da mesma pessoa, sem ligar os livros, as ocasiões ou os contextos sociais em questão.
Por que uma amostra conjunta importa
Os percentuais separados de quem ouve audiolivros e de quem participa de clubes não dizem com que frequência as duas coisas ocorrem nas mesmas pessoas. Conhecer só o total de cada formato e o total de participação deixa a sobreposição desconhecida. Nos arquivos de uso público de 2022 é possível observar essa sobreposição, porque algumas pessoas selecionadas receberam as duas seções relevantes do questionário. A escuta de audiolivros pertence ao Núcleo 1, e a pergunta sobre clubes pertence ao Módulo C. Por isso, a análise usa a interseção dessas duas atribuições, em vez de tomar a amostra completa de uma seção como denominador de um cálculo conjunto. Respostas de pessoas diferentes nunca são combinadas para fabricar uma relação individual.
O desenho aleatório da pesquisa atribuiu a cada pessoa um de dois núcleos e módulos adicionais. Os padrões de itens divulgados permitem recuperar 6.578 pessoas no Núcleo 1 e 6.615 no Módulo C, com 3.295 na interseção. Isso coincide com a distribuição do apêndice técnico: 1.651 pessoas no Núcleo 1 com os Módulos A e C e 1.644 no Núcleo 1 com os Módulos B e C. A coincidência confirma a estrutura de atribuição nos dados divulgados. Ela não prova que todas as pessoas selecionadas responderam aos dois itens e não faz de uma resposta ausente uma resposta negativa.
Da atribuição ao denominador de respostas observadas
O ponto de partida nos dados públicos são 13.251 adultos com 18 anos ou mais e peso positivo no suplemento. As pessoas mantidas são civis, porque a pesquisa trata da população civil fora de instituições. A construção não impõe uma restrição extra de entrevista concluída, pois os registros com peso positivo incluem algumas entrevistas incompletas e outras situações de resposta. Exigir um indicador de entrevista concluída alteraria a base analítica fornecida. Entre as 3.295 pessoas atribuídas às duas seções, 3.091 têm resposta sim ou não às duas perguntas. Essas 3.091 formam o grupo de itens completos e válidos usado na associação principal.
A diferença entre a população-alvo da pesquisa e esse grupo de respostas observadas é de fundo, e não uma nota de rodapé. Os pesos tratam de características do desenho da amostra e do seu ajuste, mas não provam que a falta de resposta a um item possa ser ignorada nesta relação condicional. Os percentuais principais descrevem diretamente as respostas ponderadas e válidas às duas perguntas. Estendê-los a todos os adultos elegíveis exige hipóteses adicionais sobre o comportamento de resposta. A atribuição aleatória das seções explica as omissões planejadas, mas não prova que recusa, dúvida ou falta de resposta dentro de uma seção atribuída não tenham relação com a participação em clubes ou com a escuta.
A comparação condicional principal
Entre as 597 pessoas com respostas válidas que declararam ouvir audiolivros, 81 declararam participar de um clube ou grupo de leitura. Entre as 2.494 que declararam não ouvir, 92 declararam participar. Com os pesos da pesquisa, as estimativas condicionais de participação são de 13,1043% para o grupo que ouviu e de 3,3770% para o grupo que não ouviu. Essas estimativas ponderadas não são simplesmente as frações brutas de respostas positivas. As contagens sem ponderação mostram quantas respostas sustentam o cálculo; os percentuais ponderados seguem o cálculo da pesquisa definido de antemão, dentro do grupo observado.
A diferença, definida antecipadamente como a estimativa de quem ouve menos a de quem não ouve, é de 9,7274 pontos percentuais. O erro-padrão, obtido com os pesos replicados fornecidos, é de 2,1480 pontos percentuais, e o intervalo de confiança normal aproximado de 95% vai de 5,5173 a 13,9374 pontos percentuais. Os intervalos de confiança correspondentes às duas proporções vão de 9,0563% a 17,1524% e de 2,4081% a 4,3458%. Esses intervalos medem a variação da amostragem segundo o cálculo especificado. Eles não incluem uma margem para todo erro possível de declaração, para fatores de confusão não medidos nem para mecanismos de falta de resposta, e não devem ser apresentados como garantia incondicional sobre a diferença na população.
Como ler a distribuição completa em quatro células
Os percentuais condicionais respondem a uma pergunta específica dentro de cada grupo de escuta. A distribuição completa, com duas categorias de escuta e duas de participação, responde a outra: como todo o grupo ponderado com respostas válidas às duas perguntas se divide entre as quatro combinações de respostas? Escuta e participação juntas somam 2,4508%; escuta sem participação, 16,2511%; participação sem escuta, 2,7454%; e nenhuma das duas atividades, 78,5528%. As quatro parcelas têm o mesmo denominador de respostas conjuntas válidas e somam 100% antes do arredondamento. Mostrar as quatro células impede que a discussão se reduza a um único contraste favorável.
As duas visões também explicam por que a participação condicional maior entre quem ouve audiolivros não significa que a maioria dos participantes de clubes seja de ouvintes. Os grupos que servem de condição têm tamanhos muito diferentes. Do mesmo modo, a célula grande de quem não declarou nenhuma das duas atividades não quer dizer que essas pessoas não leiam: esta análise não classifica o uso de livros impressos ou digitais. Alguém pode ler muito sem declarar audiolivros, e alguém pode participar de um grupo de leitura sem declarar uso de áudio. A tabela conjunta não sustenta uma classificação completa de leitores, uma ordem de preferências nem uma afirmação sobre formatos de leitura que se excluem.
A ponderação correta entre as seções
A documentação do Census especifica um fator de quatro quando se combinam um núcleo e um módulo. O cálculo multiplica o peso PWSUPWGT e cada um dos 160 pesos replicados fornecidos por esse mesmo fator no grupo conjunto. Esse multiplicador não foi escolhido para forçar concordância com um resultado publicado. Ele representa o tratamento amostral documentado para a combinação de seções. Um multiplicador comum se cancela no numerador e no denominador de cada proporção condicional, mas mantê-lo explícito evita confusão com o fator de uma única seção e com cálculos de totais da população, que não são apresentados aqui.
Os campos de peso têm quatro casas decimais implícitas. Os arquivos de totais suficientes guardam as unidades numéricas da fonte multiplicadas pelo fator de atribuição, em vez de mostrar esses valores armazenados, muito grandes, como números de pessoas. Dividir cada peso por dez mil mudaria a escala dos totais, mas não as razões nem suas estimativas replicadas. Essa distinção de escala importa para a reprodutibilidade: quem analisa não deve ler uma soma bruta de pesos armazenados como uma população estimada. A reprodução pública trabalha com numeradores e denominadores na mesma escala e produz percentuais, diferenças em pontos percentuais e suas medidas de amostragem, e não contagens de pessoas.
Replicações, covariância e os limites de um intervalo
Para cada conjunto de pesos replicados, a análise recalcula o numerador e o denominador de cada proporção. Em seguida, recalcula, dentro dessa mesma replicação, a diferença entre quem ouve e quem não ouve. A variância é quatro dividido por 160, multiplicado pela soma dos quadrados das diferenças entre as estimativas das replicações e a estimativa da amostra completa. Esse procedimento mantém a covariância entre as duas proporções condicionais. Somar as variâncias como se as estimativas fossem independentes daria outro erro-padrão para o contraste. O multiplicador comum de atribuição e o número quatro da fórmula da variância têm funções diferentes e não podem ser trocados um pelo outro.
Os pesos fornecidos não devem ser descritos como se tivessem uma construção comum de replicação repetida balanceada. A documentação do Census descreve replicação por diferenças sucessivas nos estratos autorrepresentados e um procedimento de meia amostra modificada nos estratos não autorrepresentados. O cálculo oficial de quatro sobre 160 corresponde à configuração declarada de erro quadrático médio de Fay com parâmetro um meio, mas essa equivalência de cálculo não é motivo para apagar os detalhes da construção. Todos os denominadores replicados relevantes foram positivos. Os intervalos normais aproximados são resumos úteis da amostragem; continuam condicionados à análise das respostas observadas e não transformam a associação em prova de que ouvir causa participar ou de que participar causa ouvir.
O que as respostas ausentes deixam sem resolver
Das 3.295 pessoas atribuídas às duas seções, 204 não têm um par válido de respostas. Juntas, elas carregam 7,5463% do peso-base do grupo conjunto nominal. A divisão aproximada é esta: 69 com escuta válida e participação ausente, dezesseis com participação válida e escuta ausente e 119 com os dois itens ausentes. Suas parcelas ponderadas são de 1,9797%, 1,0947% e 4,4719%, respectivamente. Os 3.091 pares completos restantes carregam 92,4537% do peso conjunto. Essas categorias descrevem o padrão de respostas ausentes na análise; não explicam por que faltam respostas nem estabelecem que as pessoas sem resposta sejam parecidas com as observadas.
O dicionário de dados distingue os códigos de não sabe, recusa e sem resposta, e um código em branco aparece também em outras partes do arquivo. Nenhum deles é convertido em não. Os itens de interesse não têm código em branco dentro da atribuição conjunta recuperada, mas essa constatação não justifica tratar campos em branco fora da atribuição como respostas de fato. Em especial, pessoas que não foram selecionadas para a seção relevante não podem servir para ampliar o grupo de respostas negativas. Os diagnósticos de respostas ausentes aparecem ao lado da estimativa principal, para que se veja a parte sem resposta e não se confunda um cálculo só com casos completos com a observação completa de todas as pessoas selecionadas.
Limites para uma parte do problema das respostas ausentes
Um cálculo limitado de sensibilidade trata das respostas ausentes sobre clubes entre pessoas cuja resposta sobre escuta é conhecida. Entre os 608 ouvintes observados, onze não têm resposta válida sobre participação. Atribuir todas as respostas de participação ausentes primeiro a não e depois a sim dá um intervalo ponderado de 12,9681% a 14,0078%. Entre os 2.552 não ouvintes observados, 58 não têm resposta válida sobre participação; o intervalo análogo vai de 3,2981% a 5,6343%. São limites de identificação de pior caso para esses grupos com escuta observada. Seus extremos vêm de atribuições alternativas dos resultados de clube sem resposta, e não de uma aproximação normal da amostragem.
Os limites não tratam das 135 pessoas atribuídas às duas seções cuja resposta sobre escuta está ausente, inclusive as 119 sem nenhum dos dois itens. Só com as informações observadas, essas pessoas não podem ser alocadas aos grupos de escuta. Por isso, os limites apresentados não são intervalos de confiança nem limites do contraste principal para todos os adultos. Mesmo um par de limites que pareçam separados nos grupos com escuta observada não permite afirmar uma ordem para toda a população quando as respostas ausentes podem ter qualquer padrão. Dizer qual é o alcance mais estreito desses limites deixa o exercício de sensibilidade útil, sem sugerir que ele resolva a seleção para os grupos com escuta observada ou com os dois itens válidos.
Autorrelato e resposta por terceiros: sensibilidade
A pesquisa permite que um terceiro responda quando a pessoa selecionada não está disponível. Um par de respostas sobre a mesma pessoa pode, portanto, não ter sido dado por ela mesma. A amostra principal de respostas conjuntas válidas tem 2.367 registros de autorrelato, 722 respondidos por terceiros e dois com o estado de resposta por terceiros em branco. A análise principal mantém todos, de acordo com a base de respostas fornecida pela pesquisa. Os dois registros de estado desconhecido não são classificados em silêncio como autorrelato. A distinção importa porque um terceiro pode conhecer de modo diferente as atividades privadas de escuta e as atividades sociais, mas os dados atuais não medem de forma independente a exatidão de nenhum dos dois modos de resposta.
Restringindo o cálculo ao grupo de autorrelato, a participação estimada é de 13,3873% entre quem ouve audiolivros e de 3,3072% entre quem não ouve, uma diferença de 10,0801 pontos percentuais. O erro-padrão obtido com os pesos replicados é de 2,0787 pontos percentuais. A análise de autorrelato tem 483 ouvintes observados e 1.884 não ouvintes observados. A semelhança com o resultado principal é um achado descritivo de sensibilidade, e não prova de que as respostas por terceiros não introduzam viés. A disponibilidade para responder pessoalmente pode ser seletiva, e retirar as respostas por terceiros muda o grupo de respostas. Nenhuma das duas análises é declarada uma estimativa corrigida da população só porque o resultado se parece com o da outra.
O que pode ser reproduzido e o que não pode ser inferido
Os dados agregados nacionais guardam os totais das quatro células para a amostra completa e para cada replicação, separadamente para o grupo principal e o grupo de autorrelato. Eles bastam para reproduzir as proporções condicionais informadas, a distribuição conjunta completa e a diferença com a covariância preservada, sem divulgar identificadores de respondentes. Acompanham esses dados os totais agregados de respostas ausentes e os dados de entrada dos limites para escuta observada. Os arquivos originais de uso público ficam separados deste pacote analítico compacto. A reprodução aceita locais explícitos de entrada e de saída e não depende de uma pasta privada do autor. O cálculo independente a partir dos arquivos originais e a reprodução dos agregados numa pasta limpa conferem a aritmética por caminhos diferentes.
Essas conferências mostram que o cálculo é reproduzível, e não que toda interpretação sobre comportamento seja verdadeira. Elas não permitem saber por que certos adultos ouvem audiolivros ou entram em grupos, não resolvem a falta de classificações de livros impressos e digitais e não provam hipóteses sobre a resposta aos itens. O plano de análise foi fixado localmente antes destes cálculos de associação; não era um protocolo registrado externamente, com histórico imutável e independente. A contribuição é uma atualização transparente com dados de 2022, com denominadores conjuntos explícitos, tratamento da incerteza e limites das respostas ausentes. A pergunta mais ampla, sobre filiação formal e todos os formatos, fica sem resposta, em vez de ser preenchida com oferta de bibliotecas, presença em eventos, seguidores em redes sociais ou uma história causal sem base.
Participação em clubes de leitura e audiolivros
Participação condicional ponderada entre adultos com respostas válidas aos dois itens, SPPA 2022; intervalos de confiança aproximados de 95%.
Gráfico completo e fonte
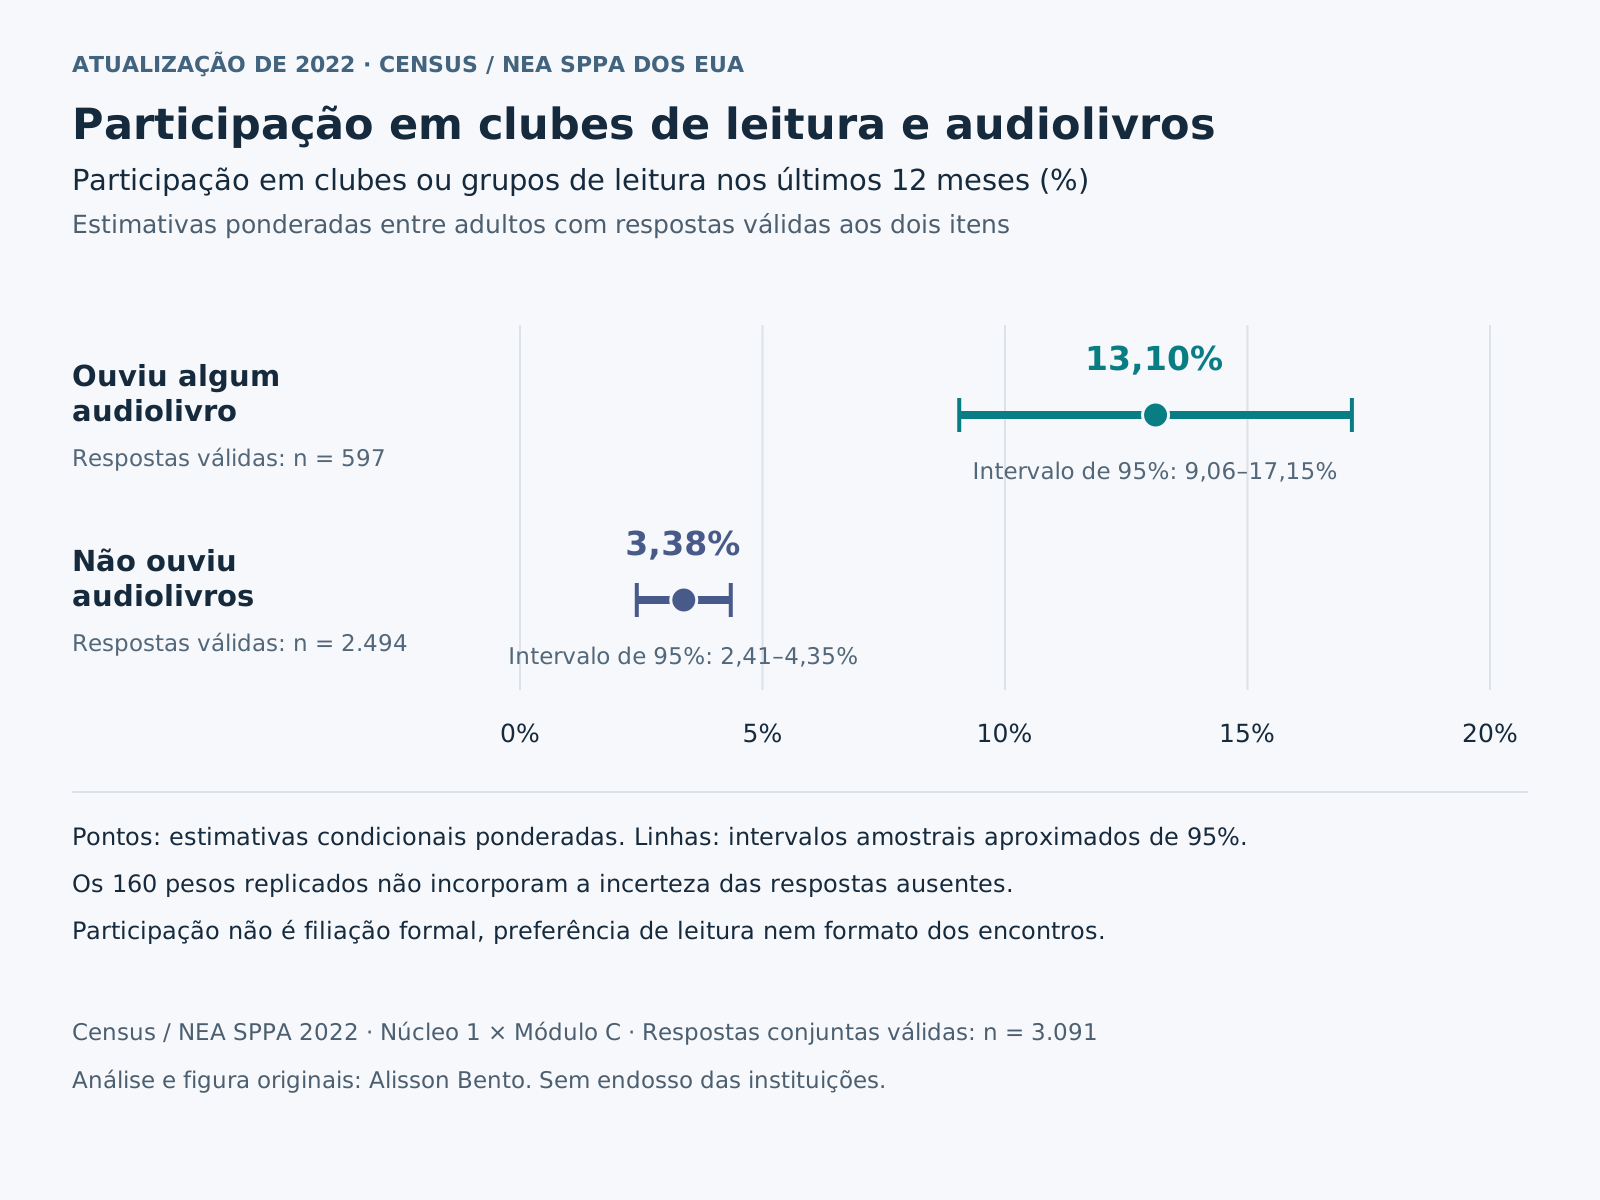
Role para os lados para examinar o gráfico. ↔
Gráfico e valores
Role a tabela para os lados para ver todas as colunas.
| Escuta de audiolivros | Respostas válidas (n) | Participa de clube: sim (n) | Participação (%) | Erro-padrão (pontos percentuais) | Limite inferior do intervalo de confiança de 95% (%) | Limite superior do intervalo de confiança de 95% (%) |
|---|---|---|---|---|---|---|
| Ouviu algum | 597 | 81 | 13,1043 | 2,0653 | 9,0563 | 17,1524 |
| Não ouviu | 2.494 | 92 | 3,3770 | 0,4943 | 2,4081 | 4,3458 |
Apenas respostas válidas de adultos aos dois itens. Os intervalos de confiança aproximados de 95% não incluem a incerteza causada por respostas ausentes.

Dados e downloads
Role a tabela para os lados para ver todas as colunas.
| Escuta de audiolivros | Respostas válidas (n) | Participa de clube: sim (n) | Participação (%) | Erro-padrão (pontos percentuais) | Limite inferior do intervalo de confiança de 95% (%) | Limite superior do intervalo de confiança de 95% (%) |
|---|---|---|---|---|---|---|
| Ouviu algum | 597 | 81 | 13,1043 | 2,0653 | 9,0563 | 17,1524 |
| Não ouviu | 2.494 | 92 | 3,3770 | 0,4943 | 2,4081 | 4,3458 |
Apenas respostas válidas de adultos aos dois itens. Os intervalos de confiança aproximados de 95% não incluem a incerteza causada por respostas ausentes.
Role a tabela para os lados para ver todas as colunas.
| Escuta de audiolivros | Participação em clubes | n | Parcela conjunta (%) | Erro-padrão (pontos percentuais) |
|---|---|---|---|---|
| Ouviu algum | Sim | 81 | 2,4508 | 0,3899 |
| Ouviu algum | Não | 516 | 16,2511 | 0,9567 |
| Não ouviu | Sim | 92 | 2,7454 | 0,4037 |
| Não ouviu | Não | 2.402 | 78,5528 | 1,0081 |
Denominador principal de respostas conjuntas válidas: 3.091. As quatro células nacionais foram mantidas. Os percentuais somam 100% antes do arredondamento.
Role a tabela para os lados para ver todas as colunas.
| Grupo / medida | n do denominador | Estimativa (% ou pontos percentuais) | Erro-padrão (pontos percentuais) | Limite inferior de 95% | Limite superior de 95% |
|---|---|---|---|---|---|
| Principal / Quem ouviu menos quem não ouviu (pontos percentuais) | 3.091 | 9,7274 | 2,1480 | 5,5173 | 13,9374 |
| Só autorrelato / Participação entre quem ouviu (%) | 483 | 13,3873 | 1,9937 | 9,4797 | 17,2950 |
| Só autorrelato / Participação entre quem não ouviu (%) | 1.884 | 3,3072 | 0,4913 | 2,3442 | 4,2702 |
| Só autorrelato / Quem ouviu menos quem não ouviu (pontos percentuais) | 2.367 | 10,0801 | 2,0787 | 6,0059 | 14,1543 |
Diferença = quem ouviu menos quem não ouviu. O autorrelato é um grupo de respostas selecionado, e não uma correção do viés das respostas por terceiros. Apenas intervalos de confiança aproximados.
Role a tabela para os lados para ver todas as colunas.
| Padrão de validade | n | Parcela ponderada (%) |
|---|---|---|
| Ambos válidos | 3.091 | 92,4537 |
| Escuta válida; clube ausente | 69 | 1,9797 |
| Escuta ausente; clube válido | 16 | 1,0947 |
| Ambos ausentes | 119 | 4,4719 |
Denominador: 3.295. Nenhum código negativo foi convertido em Não. As parcelas ponderadas usam todos os pesos-base da atribuição conjunta nominal.
Role a tabela para os lados para ver todas as colunas.
| Escuta de audiolivros | Escuta observada (n) | Sem resposta sobre clube (n) | Limite inferior (%) | Limite superior (%) |
|---|---|---|---|---|
| Ouviu algum | 608 | 11 | 12,9681 | 14,0078 |
| Não ouviu | 2.552 | 58 | 3,2981 | 5,6343 |
Limites de identificação, NÃO intervalos de confiança. Os 135 casos sem resposta sobre escuta ficam fora destes grupos de escuta observada.
Evidências e método
Como calculamos
- Atualização de 2022 identificada como tal; a análise anterior da NEA sobre 2017 é creditada. O agrupamento em duas classes (ouviu algum audiolivro ou não) difere dos tipos de leitores usados antes; não há estimativa de tendência.
- Plano local fixado antes dos cálculos de associação; não é um pré-registro externo nem tem histórico imutável.
- Adultos com 18 anos ou mais e peso positivo do suplemento. As atribuições ao Núcleo 1 e ao Módulo C foram recuperadas pelos padrões de itens não vazios, e as 3.295 atribuições conjuntas foram conciliadas. A análise principal usa 3.091 pares válidos; nenhuma resposta desconhecida ou de pessoa não selecionada vira Não.
- Fator 4 aplicado a PWSUPWGT e aos 160 pesos replicados, para um núcleo mais um módulo. Os pesos da fonte têm quatro casas decimais implícitas, e a escala comum se cancela nas razões.
- Cada replicação recalcula as razões e o contraste; variância = (4/160) vezes a soma dos quadrados dos desvios. A replicação do Census é mista, por diferenças sucessivas e meia amostra modificada; a covariância é mantida.
- Foram definidos de antemão: a distribuição completa das quatro células, as respostas ausentes em totais agregados, os limites de pior caso para a participação entre quem tem escuta observada e a sensibilidade só com autorrelato. Intervalos de confiança e limites das respostas ausentes são coisas separadas.
- Um cálculo independente a partir dos arquivos originais e outro a partir dos agregados chegaram às mesmas estimativas; o script público padrão reproduz a aritmética dos totais suficientes nacionais compactos, com caminhos explícitos.
O que os dados não permitem concluir
- Filiação formal, preferência, formato dos encontros, formatos que se excluem e efeitos causais não são medidos. Nada liga um livro ouvido à escolha de um clube.
- Interpretar o resultado como válido para toda a população exige hipóteses de resposta não verificadas; a alocação aleatória dos módulos não prova que a ausência de resposta aos itens seja totalmente aleatória (MCAR, na sigla em inglês).
- Os limites para respostas de clube ausentes, entre quem tem escuta observada, excluem 135 casos sem resposta sobre escuta; não são limites do contraste para todos os adultos nem intervalos de confiança.
- A análise principal inclui respostas por terceiros; a sensibilidade só com autorrelato é um grupo selecionado e não prova a ausência de viés dessas respostas.
- Não se afirma tendência de 2017 a 2022 nem descoberta inédita; o agrupamento em duas classes de 2022 difere da análise oficial anterior por tipos de leitores.
Fontes originais
- Census 2022 SPPA public-use data and replicate weights
Arquivo de pessoas de uso público de 2022 e 160 pesos replicados fornecidos; apenas agregados nacionais derivados. Os campos originais têm quatro casas decimais implícitas; a escala dos pesos armazenados nos agregados se cancela nas razões.
Acesso em 30 de outubro de 2026
- Census July 2022 CPS technical documentation
Anexo 3 e Tabela 1 do Anexo 16 especificam o fator conjunto 4; Anexo 7 (p. 7-9 e 7-25) e questionário (p. 11 e 32) definem PEC1Q17A e PEMCQ1I. São permitidas entrevistas por terceiros; PUNXTPR3 identifica o modo de resposta.
Acesso em 30 de outubro de 2026
- Census person-level supplement variance instructions
Instruções de 7 de março de 2012 citadas na documentação de 2022: fator do módulo aplicado ao peso-base e às replicações, estatísticas recalculadas, variância 4/160; construção mista por diferenças sucessivas e meia amostra modificada.
Acesso em 30 de outubro de 2026
- NEA 2022 SPPA technical appendix
Tabela A-2: alocação de núcleos e módulos; p. 11–12: pesos, hipóteses sobre respostas ausentes e configuração equivalente de erro quadrático médio de Fay com parâmetro 0,5. A hipótese de ausência totalmente aleatória (MCAR) publicada não é prova empírica.
Acesso em 30 de outubro de 2026
- NEA 2020 How Do We Read? Let’s Count the Ways
Análise anterior de 2017 (p. 33–34, Figura 12 e Apêndice B-4), que já relaciona participação e tipos de leitores. O agrupamento atual em duas classes (qualquer escuta de áudio, ou nenhuma), em 2022, não é idêntico; não se afirma descoberta inédita nem tendência.
Acesso em 30 de outubro de 2026
- NEA 2023 Arts Participation Patterns in 2022
Destaques oficiais de 2022: a parcela de quem ouviu audiolivros, impressa na p. 12 (18,5%), e a parcela de participação em clubes, impressa na p. 15 (cerca de 5%), foram usadas como verificações de codificação, e não como validação das hipóteses sobre respostas ausentes nem de inferência condicional conjunta.
Acesso em 30 de outubro de 2026
- Census Open Data policy
Estrutura de acesso público a dados e de reutilização e replicação, consultada em 30 de outubro de 2026; não se presume licença para arte, fotografias, logotipos de terceiros ou diagramação do questionário nos relatórios.
Acesso em 30 de outubro de 2026
- Census citation guidance
Orientações de atribuição para análise original de estatísticas públicas do Census; não se implica endosso institucional.
Acesso em 30 de outubro de 2026
- NEA public data resources
Acesso público a conjuntos de dados e análises sobre artes; atribuição às fontes preservada. Não constitui licença geral para materiais de terceiros.
Acesso em 30 de outubro de 2026
Como citar e reutilizar
Alisson Bento. Participação em clubes de leitura e audiolivros: atualização da pesquisa de 2022. Análise original da Survey of Public Participation in the Arts de 2022, do U.S. Census Bureau e do National Endowment for the Arts, com referência à análise da NEA de 2020 sobre tipos de leitura em 2017. https://alissonbento.com/pt/research/book-club-participation-audiobook-listening-2022/
Análise estatística e figuras originais: Alisson Bento. Estatísticas de uso público em que se baseia: U.S. Census Bureau / National Endowment for the Arts, Survey of Public Participation in the Arts de 2022. A análise anterior de 2017 é creditada à NEA, How Do We Read? Let’s Count the Ways, de 2020. Sem endosso oficial. As políticas de dados abertos e de citação do Census apoiam a reutilização analítica e a replicação, com atribuição; a NEA oferece conjuntos públicos de dados sobre artes. Isso não é uma licença geral para logotipos das instituições, fotografias de relatórios, obras de arte, textos de terceiros ou diagramação do questionário. Nenhum desses materiais, relatórios completos das fontes, microdados ou identificadores de respondentes está incluído. São fornecidos apenas agregados nacionais originais, código e descrições concisas das fontes. Não se inventa uma licença para o artigo inteiro.
Correções ou dúvidas editoriais