
A regra de seleção muda o acervo que se enxerga
Imagine que alguém monte uma lista de leitura a partir de metadados de livros e mantenha só os registros que trazem um crédito de autor. A regra parece um jeito simples de reter livros com responsabilidade atribuída a alguém. Mas ela é mais específica: mantém os registros com o campo de autor preenchido. Um crédito de editor da obra em outro campo do mesmo registro não atende à regra. Essa diferença importa sempre que a seleção pretendida inclui livros representados pela responsabilidade editorial, e não pela autoria. A questão aqui não é se esses livros merecem entrar, mas quantos registros uma regra de campos deixa passar. Neste artigo, editor da obra é quem organiza ou coordena um livro coletivo, indicado no campo dc.contributor.editor, e não a editora que o publica.
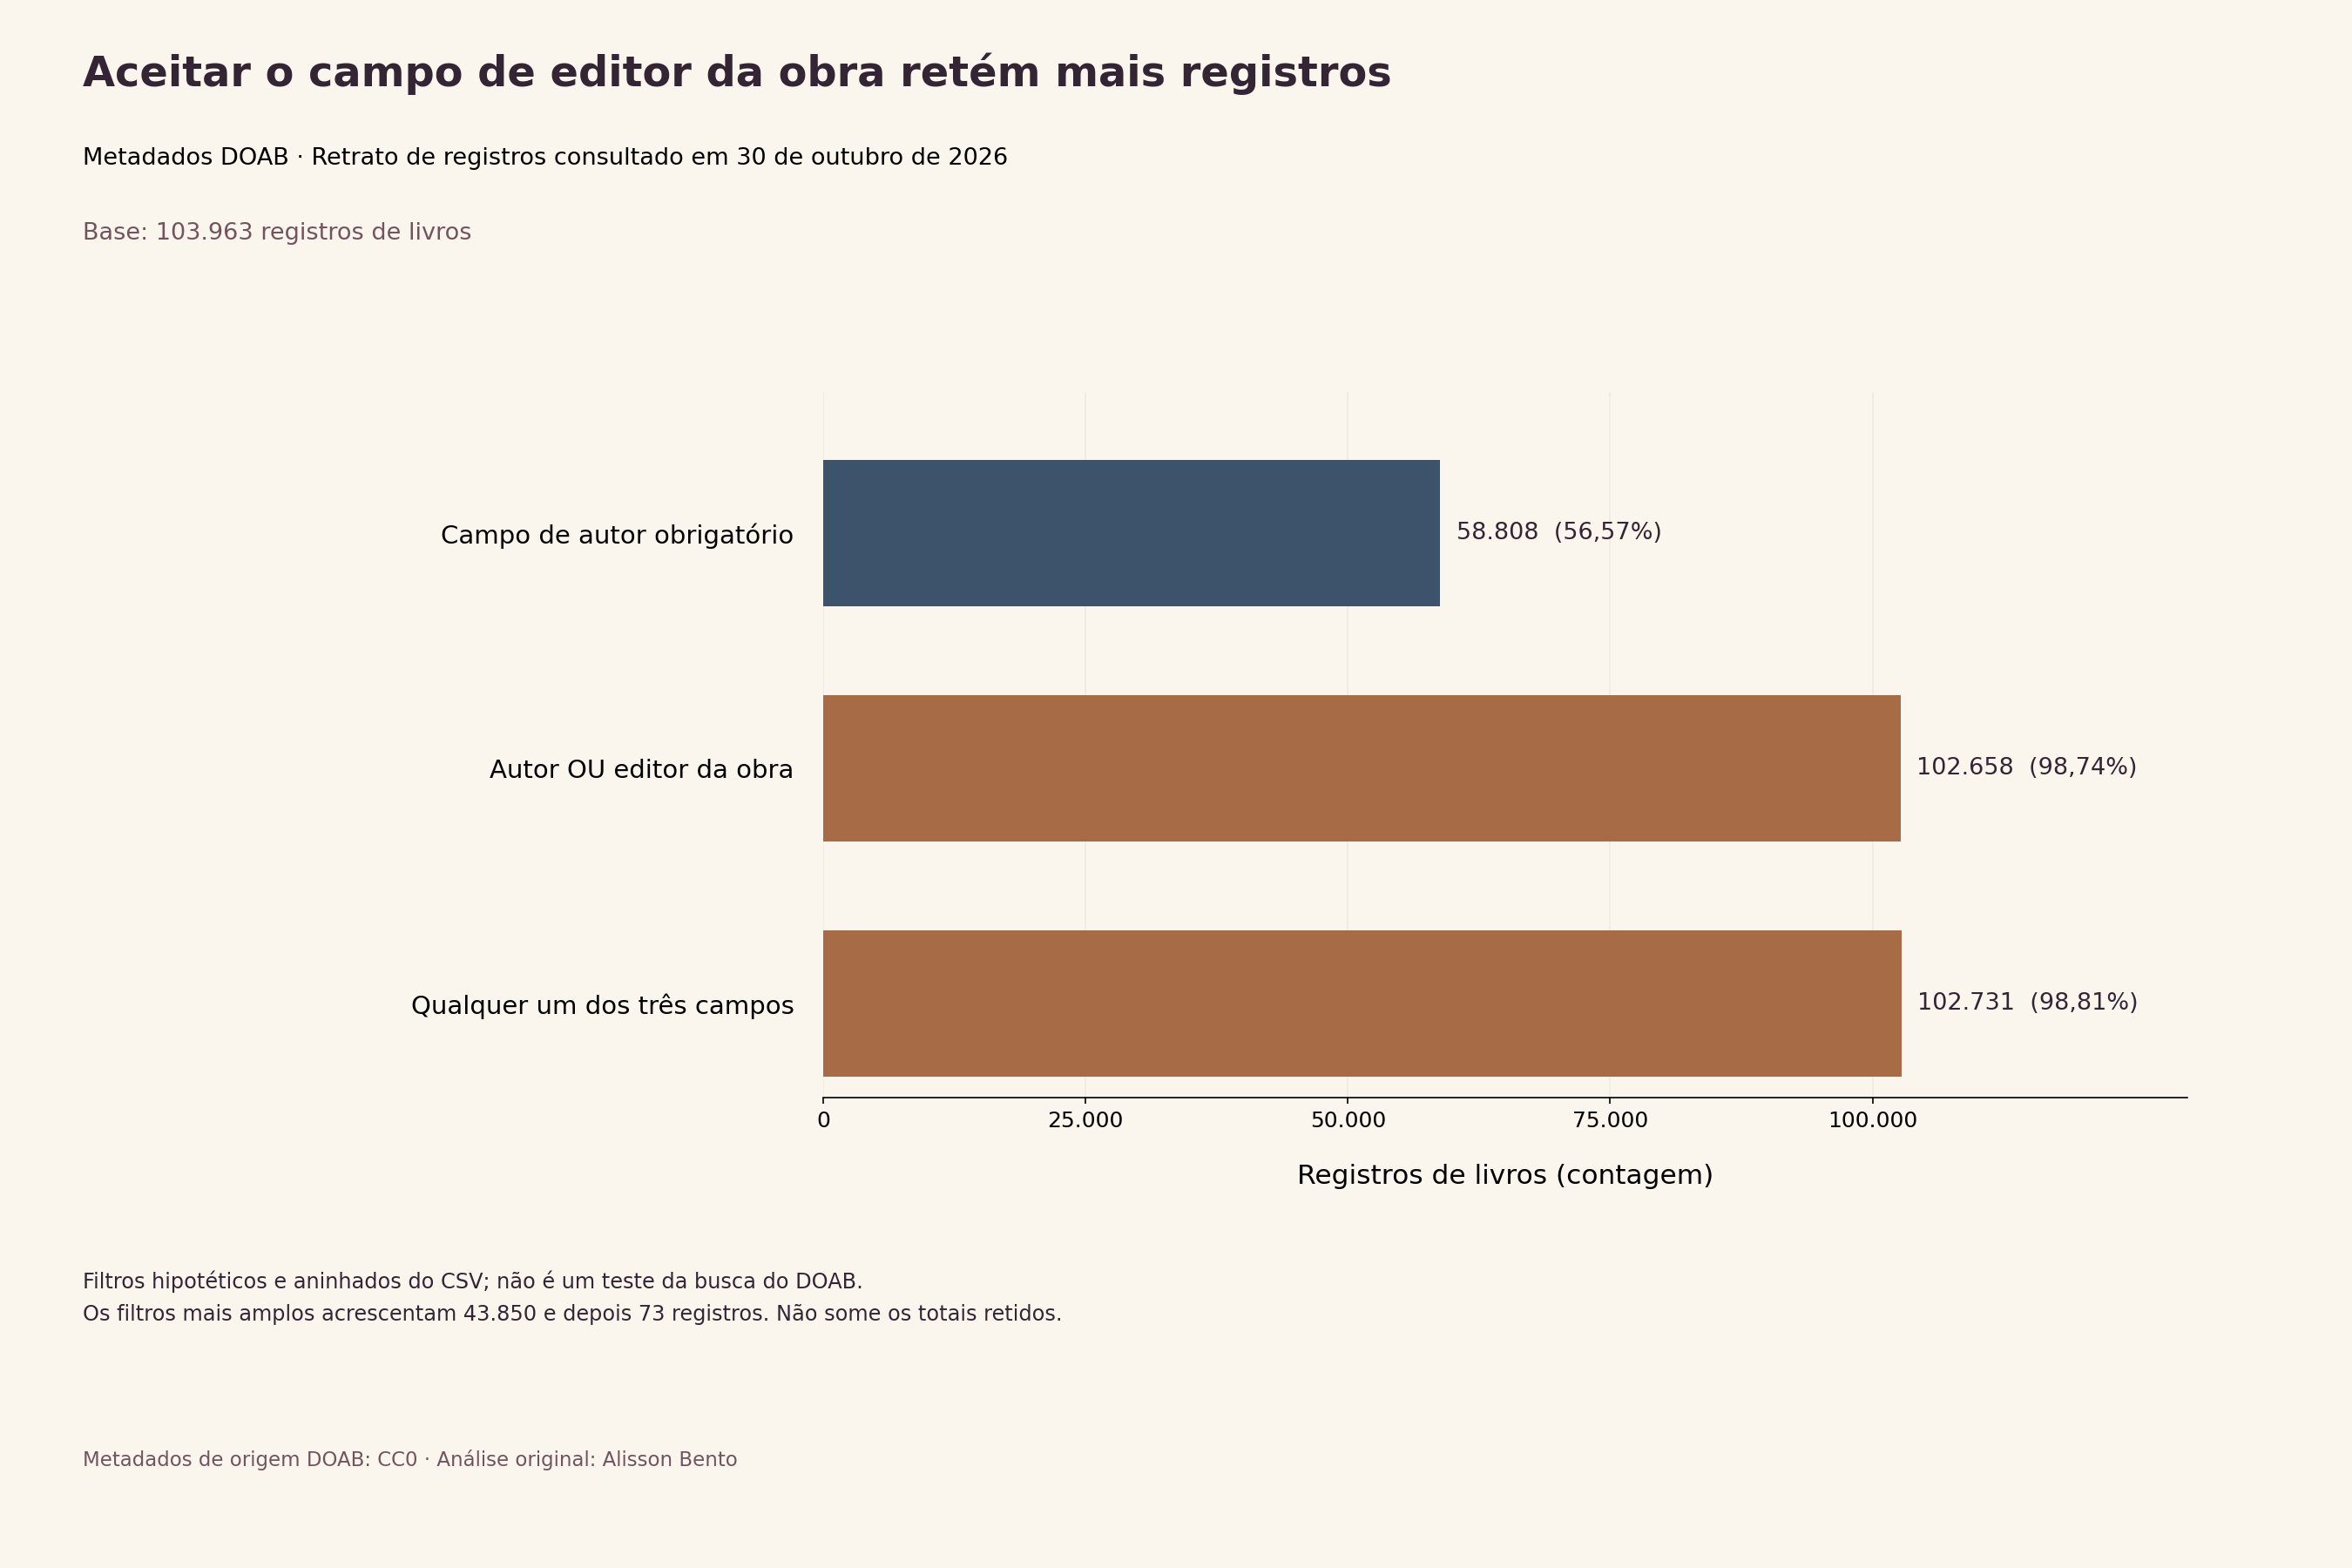
Na exportação do DOAB selecionada, exigir o campo de autor mantém 58.808 dos 103.963 registros de livros. Aceitar o campo de autor ou o de editor da obra mantém 102.658. A diferença é de 43.850 registros com o campo de editor da obra preenchido e o de autor vazio. Esse cálculo não exige reconhecer o nome de uma pessoa, decidir se dois nomes são da mesma pessoa nem avaliar o conteúdo de um livro. É uma comparação direta entre células preenchidas. Por não depender da leitura dos nomes, o resultado central fica especialmente claro: a seleção muda porque mudam os papéis aceitos.
Para quem monta uma bibliografia temática, ou para uma biblioteca que prepara um acervo derivado, a lição útil é declarar quais papéis se quer cobrir antes de aplicar um filtro. Uma lista feita para estudar especificamente registros com autoria atribuída pode, com razão, exigir esse campo. Uma lista feita para incluir livros de autor e livros organizados por editores precisa de outra regra. Este estudo mostra o tamanho e a composição dessa diferença em uma exportação fixa. Ele não mostra que o site do DOAB exclui livros organizados, que algum leitor deixou de encontrar um título nem que uma das seleções seja melhor em todos os casos.
O que a cópia dos dados contém e o que a data dela significa
As evidências vêm da resposta CSV oficial e completa do DOAB, obtida em 30 de outubro de 2026, às 08:37:57.351428 UTC. Essa resposta tinha 114.618 linhas de exportação. A análise seleciona as linhas cujo campo de tipo, dc.type, é exatamente book e cujo campo de livro que contém o item, oapen.relation.isPartOfBook, está vazio depois de retirados os espaços nas pontas. Essas condições resultam em 103.963 registros de livros. A condição sobre o livro que contém o item faz parte da definição do conjunto; ela não afirma que cada linha restante seja uma obra intelectual distinta, nem que as linhas excluídas não tenham valor para os leitores.
A data e hora da obtenção identificam o arquivo adquirido; não datam os livros nem mostram o estado exato do banco de dados do provedor naquele instante. Não se verificou nenhuma data e hora de geração do arquivo pelo provedor. Por isso, as referências aqui à cópia dos dados significam esta resposta específica, e não um censo de tudo o que o DOAB já abrigou ou de todos os livros de acesso aberto disponíveis naquele dia. O tamanho registrado do arquivo e a impressão digital SHA256 identificam os bytes de origem por trás das contagens. Uma resposta posterior, vinda do mesmo endereço oficial, poderia ser diferente sem contradizer nenhum resultado deste estudo.
No conjunto selecionado, as cadeias exatas de UUID e de handle estão preenchidas e são únicas. Isso ajuda a distinguir os registros, mas não resolve se registros separados descrevem edições, manifestações ou versões diferentes de uma mesma obra. Por isso, todos os denominadores deste artigo se referem a registros de livros. Um acervo especializado pode reter várias edições, e outra bibliografia pode reuni-las. Nenhuma dessas decisões foi imposta aqui. É possível interpretar os resultados dos filtros sem supor que o total de registros seja também o total de livros únicos em todos os sentidos bibliográficos.
Oito perfis ajudam a interpretar o campo de autor vazio
Três campos, cada um preenchido ou vazio, geram oito perfis possíveis. A primeira tabela mostra os oito em ordem binária (autor, editor da obra, outros), sem ordená-los por frequência nem por importância. Uma célula preenchida é aquela cujo texto, sem os espaços nas pontas, não está vazio. Uma célula vazia significa apenas que esta representação não traz texto naquele campo. Essa definição estreita, de propósito, evita um salto comum: a ausência de texto em uma célula dos metadados não prova que não exista o colaborador correspondente no livro, nas suas páginas iniciais ou em outro catálogo.
O maior perfil tem 55.673 registros com só o campo de autor preenchido, ou 53,55% de todo o conjunto selecionado. O seguinte tem 43.404 registros com só o campo de editor da obra preenchido, ou 41,75%. Esses dois perfis explicam boa parte da diferença entre os filtros, mas não toda. Outros 446 registros têm preenchidos os campos de editor da obra e de outros colaboradores, sem autor. Juntos, esses 43.404 e 446 registros formam os 43.850 acréscimos que surgem quando os créditos de editor da obra passam a valer. A composição fica à vista, em vez de escondida em um único total de destaque.
Os perfis menores completam a interpretação. Há 351 registros com autor e outros colaboradores, 2.578 com autor e editor da obra e 206 com os três campos preenchidos. Outros 73 têm só o campo de outros colaboradores preenchido, e 1.232 têm os três campos vazios. Essas categorias de registros são mutuamente exclusivas, ao contrário dos totais de filtros, que se sobrepõem e são discutidos adiante. A tabela de perfis responde, portanto, a uma pergunta diferente da tabela de retenção: mostra como os campos convivem dentro dos registros, inclusive combinações que ficariam indistintas se a análise informasse apenas se havia algum texto de colaborador.
Editor da obra preenchido é um dado, não uma falha no crédito de autor
Um registro com editor da obra preenchido afirma, nos metadados exportados, que há responsabilidade editorial. Não se deve descrevê-lo automaticamente como defeituoso só porque o campo de autor está em branco. Um volume organizado pode ser representado por quem o organizou, sem que o registro do livro atribua também autoria. Essa é uma possibilidade de interpretação, coerente com a distinção entre os papéis, e não uma explicação examinada registro a registro neste conjunto. O estudo não examinou as folhas de rosto dos livros nem comparou os créditos delas com as células exportadas; por isso, não pode atestar se uma atribuição individual está completa ou correta.
Para formar um acervo, a pergunta imediata é se a responsabilidade editorial cabe no escopo pretendido. Se a pessoa quer obras de nível de livro relevantes para um tema, excluir registros com editor da obra só porque lhes falta uma célula de autor pode estreitar, sem querer, o conjunto de candidatos. Se a tarefa trata de registros classificados explicitamente sob responsabilidade de autor, a seleção mais estreita pode ser exatamente a certa. O resultado empírico não decide entre essas finalidades. Ele mostra que tratá-las como equivalentes esconderia 43.850 registros nesta cópia dos dados, uma diferença grande o bastante para exigir uma escolha explícita.
O campo de outros colaboradores pede uma decisão à parte. O texto preenchido nele não pode ser reclassificado em silêncio como autoria, porque o campo pode representar diferentes tipos de contribuição, e esta análise não os classifica. Aceitá-lo como condição alternativa significa admitir uma categoria mais ampla de responsabilidade registrada, e não provar a presença de um autor ou de um editor da obra. Da mesma forma, os 1.232 registros com os três campos vazios devem continuar descritos como registros sem texto nessas três células. Chamá-los de livros sem crédito transformaria uma observação limitada sobre metadados em uma afirmação sem base sobre os próprios livros.
Três filtros aninhados, três denominadores diferentes
A comparação de retenção passa por três seleções aninhadas, isto é, cada uma contém a anterior. Primeiro, mantêm-se os registros com o campo de autor preenchido. Segundo, os registros com o campo de autor ou o de editor da obra preenchido. Terceiro, os registros com qualquer um dos campos de autor, editor da obra ou outros colaboradores preenchido. Cada regra mais ampla inclui todos os registros mantidos pela anterior. Por isso, os totais dessas regras, 58.808, 102.658 e 102.731, não devem ser somados. Os acréscimos que importam são as diferenças entre regras vizinhas: 43.850 quando os editores da obra passam a valer e, depois, 73 quando os outros colaboradores também passam. A segunda tabela mantém esses totais e esses acréscimos separados.
Usando o conjunto completo como denominador, as três regras mantêm, respectivamente, 56,57%, 98,74% e 98,81%. Os acréscimos com editor da obra preenchido representam 42,18% dos 103.963 registros selecionados. Essa é a medida mais direta de quanto do conjunto muda de situação entre as duas primeiras regras. Outra pergunta é qual parcela da seleção mais ampla, de autor ou editor da obra, é formada por esses acréscimos: a resposta é 42,71% de 102.658. Nenhum dos dois percentuais expressa o aumento em relação ao total menor, o da seleção que exige autor. Manter o denominador ligado a cada afirmação evita que uma mudança de redação aparentemente pequena altere o sentido dela.
Em relação aos 58.808 registros mantidos no início, os 43.850 acréscimos são um aumento de 74,56%. Essa razão é válida para descrever a expansão a partir da seleção mais estreita, mas não pode ser trocada pela parcela de 42,18% do conjunto completo. Para uma biblioteca que explica uma política de seleção, informar a contagem mantida e o denominador escolhido diz mais do que afirmar só que a cobertura aumentou. São comparações descritivas exatas de um conjunto fixo, com os percentuais arredondados como indicado. Elas não precisam de um intervalo de confiança artificial: a incerteza está em estender o significado delas para além da exportação observada, e não em uma amostragem dos registros aqui contados.
Contar textos de crédito sem fingir que se contam pessoas
A presença dos campos responde à principal pergunta de seleção, mas não mostra quanto texto de colaboradores cada registro mantido traz. Por isso, um segundo cálculo conta tokens literais nos três campos de papéis. Um token é um trecho de texto entre pontos e vírgulas. O procedimento é explícito: dividir o texto nos pontos e vírgulas literais, retirar os espaços nas pontas de cada parte, descartar as partes vazias e manter as repetições. As vírgulas ficam dentro dos tokens. Assim, uma vírgula dentro de um nome não é tratada como divisa entre colaboradores. A unidade resultante é uma ocorrência de token nesse procedimento, e não uma pessoa, uma identidade ou um crédito bibliograficamente completo, verificado de forma independente.
Essa distinção importa porque o guia oficial examinado não garante que cada ponto e vírgula separe exatamente um criador. Um token pode servir para comparar a estrutura dos campos exportados sem ser uma unidade confiável para estimar quantas pessoas fizeram um livro. Dois campos não vazios têm uma parte vazia entre pontos e vírgulas; descartar essas partes impede que só a pontuação aumente a contagem de tokens. Essa etapa de limpeza faz parte da regra de contagem declarada. Ela não garante que todas as demais partes tenham sido interpretadas corretamente como nomes de pessoas, nem que algum crédito tenha sido conferido na fonte.
Para o leitor, essas contagens servem sobretudo para descrever como os registros são representados. Elas indicam se um perfil costuma trazer um ou vários textos de crédito e até onde vai o máximo observado em cada perfil. Não permitem saber quantos colaboradores trabalharam em um volume, como a responsabilidade foi dividida nem de quem deve ser a contribuição que define uma entrada em uma lista de leitura. É essencial notar que nenhuma dessas limitações de interpretação muda o fato de um campo, sem os espaços nas pontas, estar preenchido ou vazio. A grande diferença de retenção entre a regra que exige autor e a de autor ou editor da obra continua, portanto, independente da análise de tokens, cuja interpretação é mais restrita.
O que a união de tokens exatos mostra sobre a repetição
A contagem complementar toma, em cada registro, os tokens exatos distintos, sem os espaços nas pontas, nos três campos de papéis. Essa união não troca maiúsculas por minúsculas, não junta variantes de nome, não expande iniciais, não concilia identificadores e não decide se textos escritos de modos diferentes se referem à mesma pessoa. Se o mesmo texto exato aparece mais de uma vez, a contagem de ocorrências preserva cada aparição, e a união o inclui uma única vez. A comparação pergunta como a repetição literal afeta o resumo numérico. Ela não produz uma contagem corrigida de pessoas, porque igualdade exata de texto e identidade de pessoa são tipos diferentes de evidência.
Há 1.184 registros em que as ocorrências de tokens superam a união de tokens exatos. A repetição pode acontecer dentro de um campo ou entre papéis. O cálculo, sozinho, não diz se um texto repetido é uma duplicação acidental, um crédito legítimo em mais de uma função ou uma coincidência entre colaboradores diferentes que escrevem o nome do mesmo jeito. Tratar toda diferença como erro iria além das evidências. Em sentido contrário, contagens de ocorrências e de união iguais não garantem que todos os colaboradores sejam pessoas distintas: textos diferentes podem se referir à mesma pessoa, e esta análise deixa essas possibilidades, de propósito, sem resolução.
A união deve ser lida como uma verificação de sensibilidade a uma escolha específica de representação. Se um resumo muda quando os textos exatamente repetidos são reunidos em um só, a pessoa sabe que a multiplicidade literal contribui para o resultado. Se não muda, o resumo é insensível a essa operação restrita, mas isso não o valida como um censo de criadores. Isso é especialmente útil ao comparar perfis com mais de um papel, em que um mesmo texto pode aparecer em mais de um papel. A análise preserva essas atribuições de papel na contagem de ocorrências e mostra o que acontece quando cada texto exato é contado só uma vez por registro.
Os resumos de tokens devem ser lidos dentro de cada perfil de papéis
As medianas calculadas por perfil separam o registro típico do caso extremo do perfil. Os registros só com autor têm mediana de uma ocorrência de token e mediana de um token exato distinto, mas a contagem máxima de ocorrências deles é 113. Os registros só com editor da obra têm medianas correspondentes de dois e dois, com máximo de 38. Esses resumos descrevem a distribuição do texto exportado segundo o procedimento declarado. Eles não mostram que livros organizados envolvam mais pessoas do que livros de autor em geral, nem que o registro só com autor e a maior contagem represente um grupo verificado de 113 criadores distintos.
Os perfis mistos mostram por que vale manter as duas definições de contagem. Os registros com editor da obra e outros colaboradores e os registros com autor e editor da obra têm, cada um, mediana de cinco ocorrências, mas mediana de quatro tokens exatos distintos. Os registros com os três campos de papéis preenchidos têm medianas de seis e cinco, respectivamente. São resumos de distribuição calculados separadamente, e não a afirmação de que todo registro numa mediana ocupa a posição correspondente na outra distribuição. Eles mostram que textos exatos repetidos afetam os resumos centrais desses perfis. Não identificam quais créditos se sobrepõem nem dizem se alguma sobreposição é adequada.
Os máximos reforçam a necessidade de manter separadas a composição e a escala. Os registros com editor da obra e outros colaboradores chegam a 154 ocorrências de tokens, os de autor e editor da obra a 147 e os de todos os três papéis a 47. O perfil com mais papéis preenchidos não tem, portanto, o maior máximo observado. Os registros só com outros colaboradores têm medianas de um e um e máximo de 14; os de autor e outros colaboradores têm medianas de dois e dois e máximo de 32. Esses resumos compactos ajudam a comparar representações sem transformar uma observação extrema em caso típico nem tratar uma combinação de papéis como ranking de complexidade bibliográfica.
Por que o limite da entrada manual não explica as contagens
O Publishers’ Guide do DOAB, de agosto de 2025, traz um contexto relevante sobre o envio de dados. Nas páginas 6 e 11, ele descreve um máximo de 20 criadores para obras inseridas manualmente e afirma expressamente que os envios em ONIX não têm esse limite. É uma distinção entre formas de envio em um guia datado, e não um teto universal para todo registro exportado. O guia é anterior à obtenção dos dados, em outubro de 2026, mas a data dele não indica quais instruções valiam para cada registro quando foi inserido ou revisado depois. O papel do guia aqui é delimitar a interpretação, e não reconstruir a história de entrada dos registros.
O conjunto selecionado tem 63 registros com exatamente 20 ocorrências de tokens e 463 com mais de 20. Essas observações não podem ser traduzidas em contagens de livros truncados nem de envios manuais. A análise não examinou as vias de entrada, os envios originais, as versões anteriores dos registros nem as listas completas de criadores. Além disso, a unidade medida é a ocorrência literal de token, enquanto o guia fala em criadores. Mesmo uma contagem que chamasse atenção por coincidir com um limite documentado não bastaria, por si só, para ligar essas unidades nem para mostrar por qual via um registro chegou ao catálogo. Do mesmo modo, uma contagem acima de 20 não prova entrada por ONIX.
Para quem examina uma exportação de metadados, o valor prático do guia é, portanto, servir de cautela contra uma história causal fácil, mas sem base. Um limite documentado pode sugerir uma pergunta para outra investigação, mas não pode respondê-la só por coincidir com uma contagem de tokens. Mostrar que houve truncamento exigiria evidências que ligassem os créditos exportados de um registro ao histórico de envio dele e a créditos mais completos nas fontes. Nada disso é apresentado aqui. O resultado defensável continua sendo o número observado de registros no limiar de tokens e acima dele, junto com a distinção explícita do guia entre entrada manual e ONIX.
Como usar os resultados em uma lista de leitura ou na seleção de uma biblioteca
Uma aplicação útil começa por traduzir a finalidade de um acervo em uma regra de elegibilidade. Se o objetivo é reunir registros de livros em que a responsabilidade de autor ou de editor da obra esteja explicitamente representada, a regra de autor ou editor da obra se ajusta melhor a essa redação do que uma regra só de autor. Neste conjunto, a escolha mantém 102.658 registros, e não 58.808. Isso é evidência sobre como montar um conjunto de candidatos, e não de que cada registro adicional pertença a um acervo temático específico. Relevância para o tema, escolha de edição, idioma e outros requisitos de seleção continuam sendo perguntas à parte, que esta análise dos campos de colaboradores não responde.
Uma segunda aplicação é preservar a informação de papel depois da seleção. Aceitar o campo de editor da obra como motivo para manter um registro não obriga a exibir esse editor da obra como autor. Do mesmo modo, aceitar o campo de outros colaboradores pode ampliar a elegibilidade sem mudar o sentido desse crédito. Essa separação entre a entrada na lista e a descrição dentro dela mantém a regra de análise compreensível para os leitores. Ela também deixa visíveis os 73 registros só com outros colaboradores como uma decisão à parte, em vez de escondê-los em uma afirmação ampla de que todo registro mantido tem autor ou editor da obra.
Uma terceira aplicação é explicar as exclusões com exatidão. Um registro recusado por uma regra que exige autor não passou nessa regra; isso não mostra que lhe falte responsabilidade atribuída a alguém nem que seja inadequado para leitura. A tabela de perfis dá um vocabulário preciso para dizer o que aconteceu. Nos 43.850 acréscimos com editor da obra, o fato decisivo é um campo de papel alternativo aceito. Nos 1.232 registros com todos os campos vazios, o fato decisivo é a ausência de texto nas três células examinadas. Nenhum dos resultados mede a facilidade real de encontrar os livros, a acessibilidade, a qualidade da leitura nem o sucesso da busca de uma pessoa no DOAB.
A contribuição é uma comparação reproduzível, não um veredito universal
A contribuição original é a combinação de uma comparação de filtros por papel em um conjunto fixo, uma descrição completa dos oito perfis e uma análise de sensibilidade delimitada dos textos literais de crédito. A documentação existente do DOAB dá o contexto da exportação, os termos de reutilização dos metadados e as orientações de envio; as regras de seleção de campos e os cálculos aqui apresentados são a análise de Alisson Bento sobre esse material. O trabalho não afirma criar a auditoria de metadados nem a comparação de textos como métodos novos. O valor dele está em mostrar exatamente como uma exigência de aparência familiar muda os registros mantidos em uma fonte específica e identificável.
O resultado principal tem um sentido local firme: aceitar editores da obra junto com autores acrescenta 43.850 registros, ou 42,18% do conjunto selecionado. Não há, ligada a ele, uma taxa de omissão universal demonstrada. Outra exportação, outra condição sobre o livro que contém o item, um acervo sem duplicações no nível da obra ou outro catálogo poderiam dar contagens diferentes. O resultado também não justifica um ranking de editoras nem uma nota de qualidade dos metadados. Um perfil de campos não é um veredito sobre a correção dos créditos de um livro, e um filtro amplo não é automaticamente melhor que um filtro estreito pensado para outra pergunta.
Para leitores e bibliotecas, a distinção duradoura é entre a responsabilidade por um livro, tal como aparece em campos separados, e a regra usada para admitir esse registro em um acervo. Tornar a regra explícita permite uma escolha que pode ser revista: autor obrigatório, autor ou editor da obra, ou qualquer um dos três campos de colaboradores. Apresentar os perfis mostra então o que cada escolha deixa para trás. O estudo para nesse limite da evidência. Ele não transforma metadados em biografia, não deduz criadores ausentes a partir de células vazias e não equipara retenção a sucesso em encontrar um livro. Oferece uma base concreta e reproduzível para escolher e explicar um filtro de colaboradores.
Quais campos de colaboradores estão preenchidos?
Metadados DOAB · Retrato de registros consultado em 30 de outubro de 2026
Gráfico completo e fonte

Role para os lados para examinar o gráfico. ↔
Gráfico e valores
Role a tabela para os lados para ver todas as colunas.
| Campo de autor preenchido | Campo de editor da obra preenchido | Campo de outros colaboradores preenchido | Registros de livros | Parcela do conjunto (%) | Mediana de ocorrências de tokens | Mediana de tokens exatos distintos | Máximo de ocorrências de tokens |
|---|---|---|---|---|---|---|---|
| Não | Não | Não | 1.232 | 1,19 | 0 | 0 | 0 |
| Não | Não | Sim | 73 | 0,07 | 1 | 1 | 14 |
| Não | Sim | Não | 43.404 | 41,75 | 2 | 2 | 38 |
| Não | Sim | Sim | 446 | 0,43 | 5 | 4 | 154 |
| Sim | Não | Não | 55.673 | 53,55 | 1 | 1 | 113 |
| Sim | Não | Sim | 351 | 0,34 | 2 | 2 | 32 |
| Sim | Sim | Não | 2.578 | 2,48 | 5 | 4 | 147 |
| Sim | Sim | Sim | 206 | 0,20 | 6 | 5 | 47 |
Todos os 103.963 registros de livros selecionados. Sim/Não significa preenchido/vazio depois de retirados os espaços nas pontas, e não presença/ausência real de uma pessoa creditada. As ocorrências de tokens, separados por ponto e vírgula, preservam as repetições; os tokens exatos distintos comparam textos sem os espaços nas pontas, sem identificar pessoas. Os percentuais usam como denominador todos os registros de livros e são arredondados com 2 casas decimais.

Aceitar o campo de editor da obra retém mais registros
Metadados DOAB · Retrato de registros consultado em 30 de outubro de 2026
Gráfico completo e fonte

Role para os lados para examinar o gráfico. ↔
Gráfico e valores
Role a tabela para os lados para ver todas as colunas.
| Filtro hipotético de campos do CSV | Registros de livros mantidos | Parcela do conjunto (%) | Registros adicionais em relação ao filtro anterior |
|---|---|---|---|
| Campo de autor obrigatório | 58.808 | 56,57 | Não se aplica |
| Campo de autor OU editor da obra | 102.658 | 98,74 | 43.850 |
| Qualquer campo de autor, editor da obra ou outros colaboradores | 102.731 | 98,81 | 73 |
Os filtros são seleções analíticas aninhadas, não comportamento observado na interface de busca do DOAB. Todas as parcelas usam 103.963 registros de livros. Os registros adicionais comparam cada filtro com o filtro imediatamente anterior; a primeira linha não tem filtro anterior.
Dados e downloads
Role a tabela para os lados para ver todas as colunas.
| Campo de autor preenchido | Campo de editor da obra preenchido | Campo de outros colaboradores preenchido | Registros de livros | Parcela do conjunto (%) | Mediana de ocorrências de tokens | Mediana de tokens exatos distintos | Máximo de ocorrências de tokens |
|---|---|---|---|---|---|---|---|
| Não | Não | Não | 1.232 | 1,19 | 0 | 0 | 0 |
| Não | Não | Sim | 73 | 0,07 | 1 | 1 | 14 |
| Não | Sim | Não | 43.404 | 41,75 | 2 | 2 | 38 |
| Não | Sim | Sim | 446 | 0,43 | 5 | 4 | 154 |
| Sim | Não | Não | 55.673 | 53,55 | 1 | 1 | 113 |
| Sim | Não | Sim | 351 | 0,34 | 2 | 2 | 32 |
| Sim | Sim | Não | 2.578 | 2,48 | 5 | 4 | 147 |
| Sim | Sim | Sim | 206 | 0,20 | 6 | 5 | 47 |
Todos os 103.963 registros de livros selecionados. Sim/Não significa preenchido/vazio depois de retirados os espaços nas pontas, e não presença/ausência real de uma pessoa creditada. As ocorrências de tokens, separados por ponto e vírgula, preservam as repetições; os tokens exatos distintos comparam textos sem os espaços nas pontas, sem identificar pessoas. Os percentuais usam como denominador todos os registros de livros e são arredondados com 2 casas decimais.
Role a tabela para os lados para ver todas as colunas.
| Filtro hipotético de campos do CSV | Registros de livros mantidos | Parcela do conjunto (%) | Registros adicionais em relação ao filtro anterior |
|---|---|---|---|
| Campo de autor obrigatório | 58.808 | 56,57 | Não se aplica |
| Campo de autor OU editor da obra | 102.658 | 98,74 | 43.850 |
| Qualquer campo de autor, editor da obra ou outros colaboradores | 102.731 | 98,81 | 73 |
Os filtros são seleções analíticas aninhadas, não comportamento observado na interface de busca do DOAB. Todas as parcelas usam 103.963 registros de livros. Os registros adicionais comparam cada filtro com o filtro imediatamente anterior; a primeira linha não tem filtro anterior.
Evidências e método
Como calculamos
- Usar a resposta CSV oficial e completa do DOAB, obtida em 30 de outubro de 2026, às 08:37:57.351428 UTC: 114.618 linhas de exportação, 230.316.814 bytes, SHA256 cddd2660be7cbb14cc88eeb854e31e1346767508d69dd74c1d46e5aba9e4c5e6. A data e hora da obtenção identificam a cópia adquirida; não se verificou nenhuma data e hora de geração pelo provedor.
- Selecionar exatamente dc.type == book e o campo oapen.relation.isPartOfBook vazio, depois de retirar os espaços nas pontas. Isso define um conjunto descritivo completo de 103.963 registros, e não um conjunto de obras intelectuais sem duplicações.
- Classificar cada registro conforme as células de autor, de editor da obra e de outros colaboradores estejam preenchidas ou vazias, depois de retirar os espaços nas pontas. Tabular os oito perfis mutuamente exclusivos e calcular três seleções aninhadas por presença de campos: autor; autor OU editor da obra; autor OU editor da obra OU outros colaboradores.
- Para as ocorrências de tokens literais, dividir cada um dos três campos de colaboradores só nos pontos e vírgulas, retirar os espaços nas pontas das partes, descartar as partes vazias, manter as vírgulas e preservar as repetições. Para os tokens exatos distintos, contar, em cada registro, os textos exatos distintos desses campos, sem espaços nas pontas, sem identificar pessoas e sem uniformizar maiúsculas e minúsculas.
- Calcular resumos descritivos por perfil e totais de retenção no conjunto fixo. Os percentuais das tabelas usam 103.963 registros e são arredondados a duas casas decimais. As razões alternativas no texto indicam explicitamente os seus denominadores diferentes. Não se atribuem intervalos de confiança a essas contagens descritivas completas.
- Usar a documentação oficial de metadados para o contexto do arquivo de dados e da reutilização, e o Publishers’ Guide de agosto de 2025 para o contexto da entrada manual e do ONIX. A fonte já havia sido usada em outros estudos; este artigo não alega pré-registro feito sem conhecer os resultados.
O que os dados não permitem concluir
- A análise testa filtros hipotéticos de campos do CSV, e não consultas ao site do DOAB, a capacidade real de busca, os resultados para leitores nem a acessibilidade.
- Os resultados descrevem uma exportação obtida e as condições de seleção declaradas; não são um censo de todos os livros, uma taxa de omissão universal nem um estado exato e verificado do banco de dados em alguma data passada.
- Cadeias de UUID e de handle preenchidas e únicas identificam os registros selecionados, mas não resolvem edições, manifestações nem obras intelectuais duplicadas.
- Células vazias de colaboradores mostram apenas falta de texto nesses campos. Os 73 registros só com outros colaboradores e os 1.232 com todos os campos vazios não mostram que os livros não tenham autores, editores da obra ou outros criadores.
- Tokens separados por ponto e vírgula são textos literais sem espaços nas pontas, e não pessoas validadas nem créditos com autoridade bibliográfica. Os tokens exatos distintos não resolvem identidades nem diagnosticam repetições erradas.
- O limite da entrada manual não vale para envios em ONIX. Para nenhum registro se estabeleceram a via de entrada, o envio original, uma versão anterior, a lista completa de criadores, truncamento ou violação de regra.
- A análise não avalia se as atribuições de papel estão corretas, não classifica os papéis de outros colaboradores, não examina a relevância para um tema e não cria rankings de livros, de editoras nem de qualidade de metadados.
- A data de obtenção é diferente da data do guia, agosto de 2025, e das datas de publicação dos livros. Não se alega pré-registro prospectivo, feito sem conhecer os resultados.
Fontes originais
- DOAB — official metadata CSV snapshot
DOAB — cópia oficial dos metadados em CSV: obtida em 2026-10-30T08:37:57.351428Z: 230.316.814 bytes; SHA256 cddd2660be7cbb14cc88eeb854e31e1346767508d69dd74c1d46e5aba9e4c5e6. As 114.618 linhas de exportação resultam em 103.963 registros de livros selecionados. Não se estabeleceram data e hora de geração pelo provedor nem eliminação de duplicações de obras ou de pessoas.
Acesso em 30 de outubro de 2026
- DOAB — metadata access and reuse documentation
DOAB — documentação de acesso e reutilização dos metadados: identifica o arquivo CSV e declara a disponibilidade dos metadados sob CC0, não a do texto integral dos livros nem a deste artigo. SHA256 do HTML preservado: a18c635b5950db92a7186c3974c7f2ea32b5f3d30900d83b789507e240e084ed.
Acesso em 30 de outubro de 2026
- DOAB — Publishers’ Guide, August 2025
DOAB — Publishers’ Guide, agosto de 2025: as páginas 6 e 11 descrevem um limite de 20 criadores na entrada manual e nenhum limite para ONIX; as páginas 14–16 tratam da exportação em CSV e dos identificadores. Essas passagens não mostram a via de entrada nem truncamento em nenhum registro. O guia é citado, não redistribuído nem reclassificado como CC0. SHA256 do PDF preservado: ed3b61e386c3267ba041843e71d9bb69f7915a9c564e25225882895c003175ee.
Acesso em 30 de outubro de 2026
Como citar e reutilizar
Alisson Bento. 2026. “Quando o campo de autor não basta: filtros de colaboradores em 103.963 registros de livros do DOAB.” Pesquisa original. https://alissonbento.com/pt/research/doab-creator-role-filtering-2026/
A documentação de metadados do DOAB afirma que os metadados estão disponíveis sob CC0. Essa dedicação vale para os metadados da fonte, e não para o texto integral dos livros, o PDF do Publishers’ Guide ou este artigo completo. As definições dos filtros de campos, os cálculos, a interpretação e o texto original aqui apresentados são contribuição original de Alisson Bento; os metadados do DOAB e a documentação de terceiros mantêm a sua origem. Só são redistribuídos agregados compactos e dados de entrada selecionados, derivados dos metadados. Não se afirma nenhuma licença geral para o artigo, permissão sobre o texto dos livros nem apoio institucional.
Correções ou dúvidas editoriais