
Duas populações por trás de um mesmo rótulo de não leitura
A pesquisa mexicana de leitura de 2025 distingue quem lê somente em redes sociais de quem não relata leitura em redes sociais nem dos outros materiais cobertos pela pesquisa. Entre adultos alfabetizados com idade conhecida, esses dois grupos dão perfis diferentes do motivo principal para não ler os materiais pesquisados. A distinção é útil porque o rótulo amplo de “não leitor de materiais do MOLEC” pode esconder diferenças grandes nas circunstâncias e nas práticas de leitura das pessoas.
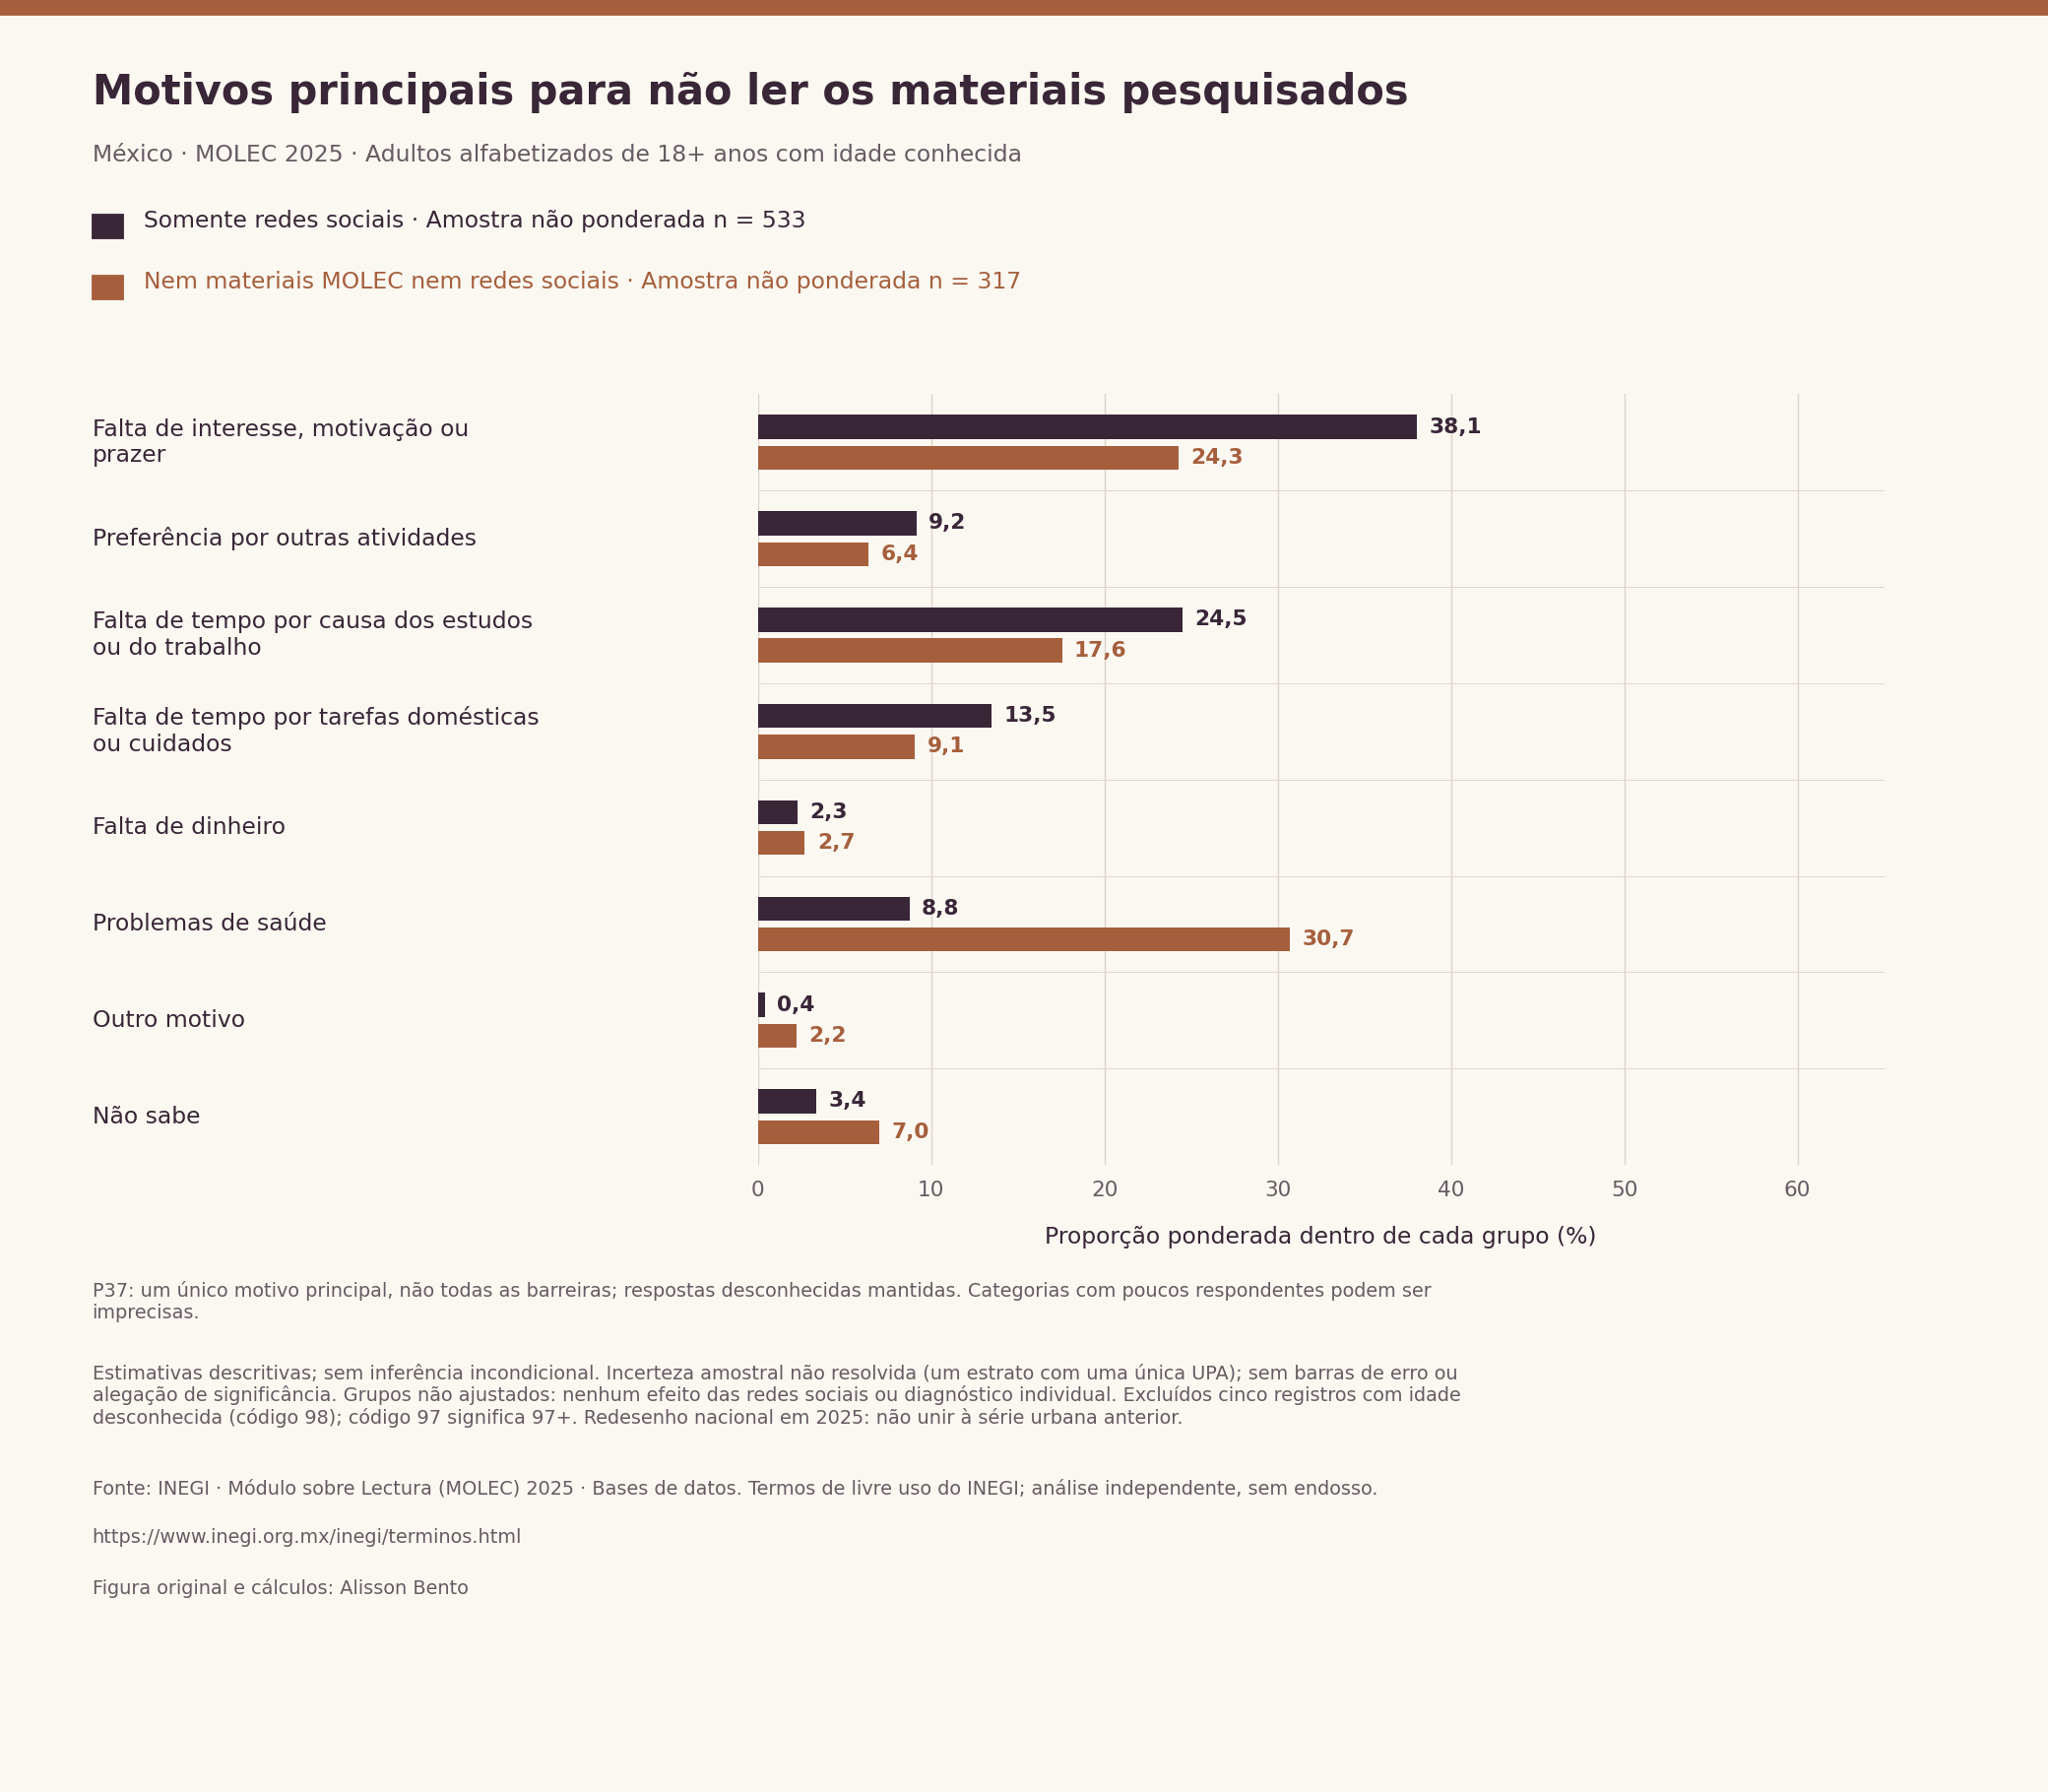
No grupo que lê somente em redes sociais, 38,1% apontaram falta de interesse, de motivação ou de prazer como motivo principal. No grupo que não relata nenhuma das categorias, 24,3% deram essa resposta. Problemas de saúde mostram o padrão oposto: 8,8% no primeiro grupo e 30,7% no segundo. São estimativas ponderadas dentro de cada grupo, e não percentuais de todos os adultos do México. Elas também não mostram que ler em redes sociais mude o interesse ou a saúde das pessoas.
A composição por idade é central para entender a comparação. Adultos de 60 anos ou mais são 19,7% do grupo somente redes sociais, mas 56,5% do grupo nenhuma das categorias. Comparar motivos é, portanto, comparar também populações em fases diferentes da vida. Este artigo mostra essa composição junto com as distribuições completas dos motivos, em vez de tentar atribuir as diferenças a um único comportamento. A análise descreve pessoas e as circunstâncias que elas relataram; não classifica a leitura de ninguém nem diagnostica motivação.
Uma nova pesquisa nacional, não a continuação do indicador antigo
O Instituto Nacional de Estadística y Geografía, o INEGI, fez as entrevistas do MOLEC 2025 de 2 a 27 de junho de 2025. A pesquisa redesenhada cobre, em todo o país, pessoas de doze anos ou mais, em áreas urbanas e rurais. Os indicadores anteriores do MOLEC usavam outra cobertura, e o questionário de 2025 acrescentou perguntas importantes de verificação e uma pergunta separada sobre leitura em redes sociais. Comparar os percentuais principais dos dois formatos misturaria mudanças na medição e na cobertura com possíveis mudanças de comportamento.
A população aqui é deliberadamente mais restrita que a do indicador nacional publicado para quem tem doze anos ou mais: adultos alfabetizados, com dezoito anos ou mais e idade conhecida, que moram em domicílios particulares ocupados cobertos pela pesquisa. A análise não inclui crianças, moradores fora dessa cobertura de domicílios nem pessoas que não passaram no filtro de alfabetização. Não diz nada sobre a parcela de todos os moradores do México que têm contato com a linguagem escrita. Também não é uma análise nacional da taxa de alfabetização.
O arquivo público de pessoas selecionadas tem 4.240 registros, dos quais 4.038 passam no filtro de alfabetização. Desses, 3.609 têm idade conhecida que os coloca na população adulta. Cinco registros de pessoas selecionadas têm o código especial de idade desconhecida, entre eles três respondentes alfabetizados; eles não são classificados em silêncio como pessoas de 98 anos nem como adultos. Um código separado, para pessoas de 97 anos ou mais, entra na população adulta. Essas distinções importam porque um filtro numérico de idade aparentemente simples poderia classificar mal as observações desconhecidas.
Como os grupos mutuamente exclusivos foram construídos
Os grupos vêm das respostas individuais, e não da subtração de percentuais arredondados de um comunicado. Para livros, revistas, jornais e quadrinhos ou mangás, a pesquisa faz primeiro uma pergunta direta sobre leitura. Quem responde “não” recebe uma pergunta de verificação, que admite de forma explícita uma leitura menos completa ou esclarece o material. Um “sim” em qualquer das duas etapas conta como leitura daquele material. Uma resposta em branco na verificação, depois de um “sim” direto, é um salto legítimo do questionário, e não indício de que a pessoa não leu.
Uma pessoa entra no domínio “nenhum material do MOLEC” só depois de respostas negativas, diretas e de verificação, para os quatro tipos de material, e de uma resposta negativa sobre páginas da internet, fóruns ou blogs, sem contar as redes sociais. A pergunta sobre redes sociais divide esse domínio em dois grupos que não se sobrepõem. Uma resposta afirmativa identifica a leitura somente em redes sociais; uma resposta negativa identifica nenhuma das categorias. A pergunta sobre redes sociais inclui leitura para informação, comunicação ou entretenimento, com exemplos como WhatsApp, Facebook e X.
As amostras de adultos resultantes têm 533 respondentes no grupo somente redes sociais e 317 no grupo nenhuma das categorias. Os pesos da pessoa selecionada representam cerca de 12,60 milhões e 7,98 milhões de pessoas, respectivamente. Esses totais continuam sendo estimativas, segundo as definições de população da pesquisa. Não devem ser lidos como contagem de público de plataformas, de usuários de um aplicativo específico nem de pessoas que nunca leem em nenhum contexto. Uma pessoa pode ter contato com outros tipos de texto que o questionário não lista, e os limites das categorias da pesquisa devem ficar à vista sempre que os resultados forem resumidos.
Um motivo principal, não uma lista de todas as barreiras
A pergunta P37 pede o principal motivo pelo qual a pessoa não lê livros, revistas, jornais ou quadrinhos. Ela aceita uma única resposta. O questionário leva a essa pergunta tanto quem lê somente em redes sociais quanto quem não relata nenhuma categoria de leitura pesquisada. O arquivo real concorda com a classificação feita a partir das perguntas de leitura: todos os 890 respondentes elegíveis, em todas as idades, têm um motivo preenchido, e nenhum respondente não elegível tem. Ao restringir a adultos de idade conhecida, ficam 850 respondentes.
Como a pergunta pede um único motivo principal, cada resposta mostra uma prioridade, e não um inventário. Quem cita estudos ou trabalho pode também sentir cansaço, ter pouco dinheiro ou achar difícil encontrar material interessante. Quem relata um problema de saúde pode também ter pouco tempo. Essas outras possibilidades não são medidas por essa resposta. Um percentual menor para um motivo não prova que a dificuldade correspondente não exista no resto da população.
A descrição pública das variáveis inclui uma resposta explícita “não sabe”, embora o questionário em papel exibido liste só as categorias de conteúdo. Essa resposta “não sabe” continua no denominador de cada grupo e aparece em separado na tabela. Ela corresponde a 3,4% do grupo somente redes sociais e a 7,0% do grupo nenhuma das categorias. Não se observou código separado para recusa, e os espaços em branco estruturais, fora do caminho da pergunta, não são recodificados nem como recusa nem como motivo. Manter as respostas “não sabe” evita inflar as proporções das respostas por uma exclusão seletiva.
Os perfis completos dos motivos
Falta de interesse, de motivação ou de prazer é a maior categoria estimada entre os adultos que leem somente em redes sociais: 38,1%. Em seguida vem a falta de tempo por estudos ou trabalho, com 24,5%, e as tarefas domésticas ou de cuidado respondem por 13,5%. A preferência por outras atividades é citada por 9,2%, os problemas de saúde por 8,8%, a falta de dinheiro por 2,3% e outro motivo por 0,4%. Os 3,4% restantes são a categoria explícita “não sabe”. Pequenas diferenças de arredondamento podem impedir que os valores com uma casa decimal somem exatamente cem.
Entre os adultos que não relatam nenhuma das categorias de leitura, os problemas de saúde respondem por 30,7%, seguidos da falta de interesse, de motivação ou de prazer, com 24,3%. A falta de tempo por estudos ou trabalho representa 17,6%, as tarefas domésticas ou de cuidado 9,1%, a preferência por outras atividades 6,4%, a falta de dinheiro 2,7% e outro motivo 2,2%. As respostas “não sabe” somam 7,0%. As duas distribuições diferem, portanto, no formato geral, e não apenas em quem tem a maior parcela entre tempo e interesse.
As respostas menos frequentes pedem muito cuidado. Por exemplo, a estimativa de “outro motivo” no grupo somente redes sociais se baseia em três respondentes, e a de falta de dinheiro, em dez. Publicar a distribuição completa torna essas categorias visíveis, mas não as transforma em estimativas precisas de experiências bem delimitadas. Não se reproduzem respostas livres, e nenhuma explicação individual é deduzida do agregado. A tabela permite ver o perfil geral das respostas, e não uma classificação confiável de cada pequena diferença entre os grupos.
Uma diferença sobre falta de tempo definida previamente
Antes de comparar as estimativas dos motivos entre os grupos, a análise definiu uma diferença principal: a proporção ponderada que escolhe a falta de tempo por estudos ou trabalho, no grupo somente redes sociais menos o grupo nenhuma das categorias. As estimativas são 24,4908% e 17,5578%, uma diferença de 6,9330 pontos percentuais. Em linguagem simples, estudos ou trabalho foram escolhidos como motivo principal por cerca de sete pontos percentuais a mais no primeiro grupo do que no segundo. É uma diferença descritiva, sem ajuste, e não um efeito estimado da leitura em redes sociais.
A falta de tempo por estudos ou trabalho continua distinta do tempo gasto com tarefas domésticas ou de cuidado. Juntar essas categorias depois de ver os resultados mudaria a pergunta definida previamente e poderia esconder circunstâncias diferentes. Do mesmo modo, a diferença é dada em pontos percentuais, e não como aumento percentual. Ela compara proporções com denominadores de grupo diferentes, e a amostra de nenhum dos grupos é um par comparável da outra.
A diferença pontual foi reproduzida de forma independente a partir do caminho validado da pergunta de motivos, separadamente da construção original do indicador de leitura. As dezesseis células de motivos também foram conferidas com essa seleção alternativa. Isso é uma auditoria útil do cálculo, mas a concordância entre cálculos não resolve todos os problemas da amostra. Em particular, as variáveis públicas do desenho trazem um estrato com uma única unidade, que exige uma convenção explícita de variância. Por isso, o texto principal não usa rótulo de significância nem sugere que a conferência aritmética independente transforme uma diferença descritiva em achado causal ou definitivo sobre a população.
A composição por idade faz parte do resultado
O grupo somente redes sociais se distribui nas faixas de 18 a 39 anos, de 40 a 59 e de 60 ou mais em 34,9%, 45,3% e 19,7%. No grupo nenhuma das categorias, as proporções correspondentes são 10,3%, 33,2% e 56,5%. Os mais velhos são a maioria do segundo grupo, mas cerca de um quinto do primeiro. Essas diferenças não são um detalhe de rodapé: mudam bastante o tipo de circunstância representada em cada distribuição de motivos.
Apenas com esses agregados, a pesquisa não diz qual seria a diferença na falta de tempo por estudos ou trabalho se os grupos tivessem a mesma estrutura de idade, a mesma saúde, a mesma escolaridade ou a mesma situação no mercado de trabalho. O peso da resposta sobre saúde também não estabelece um diagnóstico, um tipo de deficiência nem uma necessidade de acessibilidade. É um motivo principal autodeclarado, coletado em um caminho específico do questionário. A análise não afirma que a idade explica todas as diferenças nem que um ajuste por idade não deixaria nenhuma.
Nenhum modelo ajustado foi definido previamente para este estudo, e por isso nenhum é acrescentado para fabricar uma interpretação sobre comportamento. A medida inclui a composição de propósito: descreve as populações que os dois grupos de fato representam. Uma futura análise padronizada precisaria de uma população-alvo justificada à parte, de um plano claro de variáveis de controle e de verificações de que os dados sustentam as comparações. Ainda seria uma análise observacional, e não um experimento capaz de provar se ler em redes sociais leva a mais ou menos contato com livros ou outros materiais.
O que os pesos e a validação mostram
Os cálculos usam FAC_ELE, o fator de expansão da pessoa selecionada, e não um peso de domicílio ou de família. Cada proporção de motivo é a soma desses pesos para a resposta dividida pela soma dos pesos do grupo, mantida a categoria “não sabe”. Todos os registros de pessoas selecionadas têm pesos positivos. Os tamanhos de amostra brutos são informados à parte das estimativas ponderadas da população, para que se distinga o número de entrevistas do número de pessoas que elas representam.
Como validação nacional entre os respondentes alfabetizados de todas as idades pesquisadas (doze anos ou mais), a mesma classificação dá 79,0858% que leem materiais do MOLEC, 13,0561% que leem somente em redes sociais e 7,8581% que não relatam nenhuma das categorias. Arredondados a uma casa decimal, esses valores reproduzem os 79,1%, 13,1% e 7,9% publicados pelo INEGI. Essa conferência não é usada para fabricar as estimativas dos adultos. Ela mostra que a classificação por registro coincide com o resultado oficial antes de aplicar a restrição a adultos, definida de forma independente.
As variáveis do desenho identificam 1.201 unidades primárias de amostragem (UPA) em 99 estratos. As estimativas para subpopulações de adultos precisam manter essa estrutura completa da amostra, inclusive as unidades sorteadas cujos respondentes contribuem com zero para o domínio de interesse. Tratar os 850 adultos elegíveis como uma amostra aleatória simples ignoraria os conglomerados, a estratificação e a seleção com probabilidades desiguais. Um cálculo de tamanho efetivo da amostra baseado só nos pesos, usado como diagnóstico, não corrigiria esse problema nem substituiria a estimação da variância pelo desenho. Por isso, não se apresentam erros-padrão de amostragem aleatória simples.
Apêndice secundário: incerteza sob convenções explícitas
A documentação do desenho do INEGI descreve um cálculo de variância pelo método do conglomerado último. Um estrato público, porém, tem apenas uma UPA observada. Seus quatro respondentes estão fora do domínio de interesse. Suas contribuições observadas para a diferença linearizada são zero, mas isso não mostra que a unidade foi sorteada com certeza nem que o estrato da população não tem incerteza. A documentação do produtor consultada não traz uma regra para esse caso, estratos de variância agrupados e validados ou pesos replicados que resolvam o problema.
Duas convenções usuais, que não pressupõem certeza, foram definidas antes de examinar os cálculos de intervalos já existentes, depois que as estimativas pontuais e os diagnósticos já haviam sido vistos; trata-se de uma emenda, e não de um registro prévio original. Com a centralização pela média geral, a contribuição do estrato com uma única UPA é mecanicamente zero aqui, porque as influências conjuntas da diferença entre razões somam zero. Essa convenção, chamada “adjust”, é portanto ineficaz como salvaguarda para esta diferença específica e não deve ser descrita como prova de certeza. Uma alternativa troca a contribuição do estrato pela contribuição média dos 98 estratos com mais de uma UPA. Essa convenção, chamada “average”, assume sem verificação que as contribuições à variância desses estratos servem de guia razoável para o estrato com uma única UPA.
Por transparência, os intervalos de sensibilidade de 95%, por aproximação normal, vão de 0,14 a 13,73 pontos percentuais com a centralização pela média geral e de 0,10 a 13,76 com a imputação pela média dos estratos. São cálculos condicionais, e não intervalos de confiança incondicionais nem prescritos oficialmente. Limites inferiores só ligeiramente positivos não justificam uma manchete de significância, e nenhum valor-p é apresentado. Cálculos em Python reproduziram as fórmulas documentadas para o pacote survey do R; um ajuste no R não foi executado. O apêndice registra o efeito das convenções explícitas sem fingir que a informação ainda desconhecida sobre o desenho passou a ser conhecida.
Ler a evidência sem ir além dela
Os períodos de referência não são iguais para todos os materiais. Livros se referem aos doze meses anteriores, revistas a três meses e jornais à semana anterior. A triagem para quadrinhos ou mangás, páginas da internet ou blogs e leitura em redes sociais não define um período retrospectivo comum equivalente. Por isso, “nenhuma das categorias” é uma forma abreviada da classificação definida pela pesquisa, e não prova de que alguém ficou um ano inteiro sem ler texto algum. As novas perguntas de verificação também tornam inadequado igualar as classificações de 2025 às categorias antigas, sem uma análise específica de comparabilidade.
Os perfis completos são um ponto de partida mais cuidadoso para a discussão do que um único rótulo de não leitura. Tempo, interesse, saúde e responsabilidades de cuidado aparecem em proporções diferentes entre populações cujas idades também diferem muito. Eles sugerem perguntas que um autor, um educador ou uma iniciativa de leitura poderia investigar, mas não medem a demanda por um gênero específico, o impacto de uma intervenção, a qualidade do conteúdo das redes sociais nem a eficácia de uma plataforma. Nenhum resultado de um programa de leitura proposto pode ser calculado só com essas respostas.
As informações mais recentes do projeto, conferidas em 30 de outubro de 2026, ainda indicavam a divulgação de 2025, com a próxima publicação prevista para 18 de novembro de 2026. São, portanto, observações de junho de 2025, e não uma medida do comportamento atual, em 2026. O INEGI produziu os dados de origem; esta seleção, estes cálculos e esta explicação independentes são de Alisson Bento. Os materiais para download trazem resultados agregados, métodos e código, e os registros individuais ficam só no ambiente local da análise. A atribuição não implica endosso do INEGI, e nem os cálculos nem a interpretação escrita devem ser tomados como posição institucional oficial.
Motivos principais para não ler os materiais pesquisados
México · MOLEC 2025 · Adultos alfabetizados de 18 anos ou mais com idade conhecida. Proporção ponderada dentro de cada grupo (%). Somente redes sociais: n = 533; nem materiais do MOLEC nem redes sociais: n = 317 (amostra não ponderada).
Gráfico completo e fonte

Role para os lados para examinar o gráfico. ↔
Gráfico e valores
Role a tabela para os lados para ver todas as colunas.
| Motivo principal | Somente redes sociais (%) | Nenhuma das categorias (%) | Respondentes: somente redes sociais | Respondentes: nenhuma das categorias |
|---|---|---|---|---|
| Falta de interesse, motivação ou prazer | 38,1 | 24,3 | 216 | 90 |
| Preferência por outras atividades | 9,2 | 6,4 | 55 | 25 |
| Falta de tempo por estudos ou trabalho | 24,5 | 17,6 | 131 | 48 |
| Falta de tempo por tarefas domésticas ou cuidados | 13,5 | 9,1 | 65 | 26 |
| Falta de dinheiro | 2,3 | 2,7 | 10 | 9 |
| Problemas de saúde | 8,8 | 30,7 | 42 | 95 |
| Outro motivo | 0,4 | 2,2 | 3 | 8 |
| Não sabe | 3,4 | 7,0 | 11 | 16 |
Adultos alfabetizados de 18 anos ou mais com idade conhecida; percentuais ponderados por FAC_ELE. Somente redes sociais: n = 533; nenhuma das categorias: n = 317. Uma resposta principal; “não sabe” mantido. Células com poucos respondentes são imprecisas. “Nenhuma das categorias” significa nem materiais do MOLEC nem redes sociais, segundo as perguntas da pesquisa. Não se afirmam intervalos de confiança incondicionais.
Composição etária dos dois grupos de leitura
México · MOLEC 2025 · Adultos alfabetizados de 18 anos ou mais com idade conhecida. Proporção ponderada dentro de cada grupo (%). Somente redes sociais: n = 533; nem materiais do MOLEC nem redes sociais: n = 317 (amostra não ponderada).
Gráfico completo e fonte

Role para os lados para examinar o gráfico. ↔
Gráfico e valores
Role a tabela para os lados para ver todas as colunas.
| Idade | Somente redes sociais (%) | Nenhuma das categorias (%) |
|---|---|---|
| 18–39 | 34,9 | 10,3 |
| 40–59 | 45,3 | 33,2 |
| 60+ | 19,7 | 56,5 |
Percentuais ponderados dentro de cada grupo de adultos alfabetizados com idade conhecida; idade (variável EDAD) igual a 98 excluída, igual a 97 incluída como 97 anos ou mais. A composição é descritiva, não um ajuste.

Dados e downloads
Role a tabela para os lados para ver todas as colunas.
| Motivo principal | Somente redes sociais (%) | Nenhuma das categorias (%) | Respondentes: somente redes sociais | Respondentes: nenhuma das categorias |
|---|---|---|---|---|
| Falta de interesse, motivação ou prazer | 38,1 | 24,3 | 216 | 90 |
| Preferência por outras atividades | 9,2 | 6,4 | 55 | 25 |
| Falta de tempo por estudos ou trabalho | 24,5 | 17,6 | 131 | 48 |
| Falta de tempo por tarefas domésticas ou cuidados | 13,5 | 9,1 | 65 | 26 |
| Falta de dinheiro | 2,3 | 2,7 | 10 | 9 |
| Problemas de saúde | 8,8 | 30,7 | 42 | 95 |
| Outro motivo | 0,4 | 2,2 | 3 | 8 |
| Não sabe | 3,4 | 7,0 | 11 | 16 |
Adultos alfabetizados de 18 anos ou mais com idade conhecida; percentuais ponderados por FAC_ELE. Somente redes sociais: n = 533; nenhuma das categorias: n = 317. Uma resposta principal; “não sabe” mantido. Células com poucos respondentes são imprecisas. “Nenhuma das categorias” significa nem materiais do MOLEC nem redes sociais, segundo as perguntas da pesquisa. Não se afirmam intervalos de confiança incondicionais.
Role a tabela para os lados para ver todas as colunas.
| Idade | Somente redes sociais (%) | Nenhuma das categorias (%) |
|---|---|---|
| 18–39 | 34,9 | 10,3 |
| 40–59 | 45,3 | 33,2 |
| 60+ | 19,7 | 56,5 |
Percentuais ponderados dentro de cada grupo de adultos alfabetizados com idade conhecida; idade (variável EDAD) igual a 98 excluída, igual a 97 incluída como 97 anos ou mais. A composição é descritiva, não um ajuste.
Evidências e método
Como calculamos
- Microdados públicos de pessoas selecionadas do MOLEC 2025 do INEGI; população nacional de domicílios particulares ocupados, adultos alfabetizados de 18 anos ou mais com idade conhecida.
- A classificação por registro, mutuamente exclusiva, usa as respostas diretas e de verificação sobre leitura; a divisão por redes sociais usa a pergunta P2F. A P37 traz um motivo principal; o código “não sabe” (9) é mantido.
- Razões ponderadas por FAC_ELE; a diferença principal entre estudos e trabalho foi escolhida antes das estimativas entre grupos. Os perfis completos e a composição por idade são descritivos, sem ajuste nem interpretação causal.
- Todas as 16 células de motivos e os denominadores ponderados foram verificados de forma independente; as proporções nacionais de 12 anos ou mais reproduzem os valores oficiais arredondados 79,1/13,1/7,9.
- A estrutura completa de estratos e UPA foi mantida na sensibilidade secundária condicional por linearização de Taylor. Um estrato com uma única UPA, sem solução, impede a inferência incondicional pelo desenho oficial; foram usadas fórmulas em Python, e não um ajuste executado no R.
O que os dados não permitem concluir
- Cinco pessoas selecionadas têm idade desconhecida, entre elas três alfabetizadas; a medida de adultos com idade conhecida as exclui. A alfabetização e a cobertura de domicílios particulares limitam a generalização.
- Os motivos principais são prioridades de resposta única, e não todas as barreiras. Células pequenas podem ser imprecisas; “não sabe” é mantido.
- A composição por idade difere muito; não se estima efeito independente das redes sociais, relação causal, demanda por gênero nem benefício de intervenção.
- Os períodos de referência dos materiais diferem; as categorias nacionais redesenhadas em 2025 não podem ser emendadas às séries anteriores de adultos urbanos.
- As sensibilidades condicionais ao estrato com uma única UPA dependem de convenções explícitas; a troca pela média dos estratos não tem verificação, influência zero não é certeza, e limites de intervalo só ligeiramente positivos não justificam uma manchete de significância.
Fontes originais
- INEGI MOLEC 2025 project
Projeto INEGI MOLEC 2025: projeto, redesenho nacional e identificação da distribuição dos dados.
Acesso em 30 de outubro de 2026
- INEGI MOLEC 2025 public CSV microdata
Microdados públicos CSV INEGI MOLEC 2025: análise TMOLEC somente local; observações de pessoas selecionadas.
Acesso em 30 de outubro de 2026
- INEGI MOLEC 2025 file descriptor
Descritor INEGI MOLEC 2025: códigos, idade 98 desconhecida, idade 97 como limite superior aberto, FAC_ELE/UPM_DIS/EST_DIS.
Acesso em 30 de outubro de 2026
- INEGI MOLEC 2025 questionnaire
Questionário INEGI MOLEC 2025: páginas impressas 10, 14 e 16; alfabetização, perguntas de leitura, encaminhamento de somente redes sociais e motivo principal único.
Acesso em 30 de outubro de 2026
- INEGI MOLEC 2025 sample design
Desenho amostral INEGI MOLEC 2025: peso da pessoa selecionada e variância por conglomerado último, equações 17–20. Não foi identificada solução para o estrato unitário.
Acesso em 30 de outubro de 2026
- INEGI MOLEC 2025 results
Resultados INEGI MOLEC 2025: proporções nacionais arredondadas, para todas as idades elegíveis, usadas apenas na validação; divulgado em 18 de novembro de 2025.
Acesso em 30 de outubro de 2026
- INEGI MOLEC 2025 RNM metadata
Metadados RNM INEGI MOLEC 2025: acesso de uso público, atribuição, desenho e universo.
Acesso em 30 de outubro de 2026
- INEGI free-use terms
Termos de livre uso do INEGI: licença própria, atribuição e reutilização não enganosa, sem sugerir endosso oficial.
Acesso em 30 de outubro de 2026
- Survey package author documentation on singleton PSUs
Documentação do autor do pacote survey sobre unidades primárias isoladas: somente diagnóstico metodológico; ajuste ad hoc não constitui aprovação do INEGI.
Acesso em 30 de outubro de 2026
Como citar e reutilizar
Alisson Bento. Motivos diferentes para não ler: os grupos de somente redes sociais e de nenhuma das categorias no México. Análise independente do domínio adulto do INEGI, Módulo sobre Lectura (MOLEC) 2025. Fontes consultadas em 30 de outubro de 2026. https://alissonbento.com/pt/research/mexico-reading-barriers-social-only-2025/
Fonte: INEGI. Módulo sobre Lectura (MOLEC) 2025. Bases de datos. Reutilizado sob os próprios termos de livre uso do INEGI, https://www.inegi.org.mx/inegi/terminos.html. Cálculos e explicação: Alisson Bento. Análise independente; sem endosso oficial nem logotipos. Só os agregados derivados e o código são distribuídos.
Correções ou dúvidas editoriais