
A decisão antes do resultado numérico
Quem prepara uma amostra para download pode, com razão, testar o título, o nome de um personagem e uma frase característica. Encontrá-los é útil. Isso mostra que essas buscas funcionaram naquele programa. Não mostra que um revisor, um tradutor ou um leitor receberá os mesmos caracteres ao copiar o parágrafo ao redor para outro documento. Busca, extração e comparação do texto com a referência são operações diferentes, mesmo quando partem do mesmo PDF.
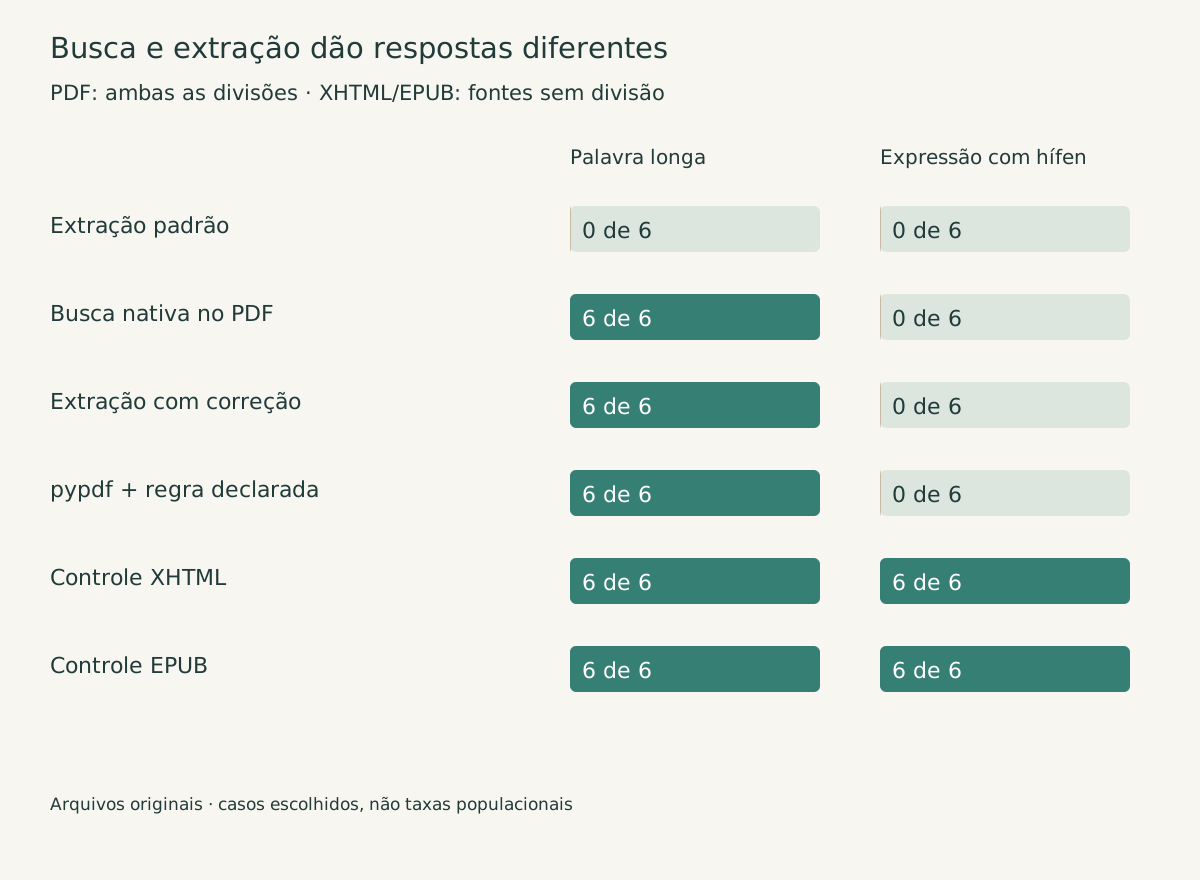
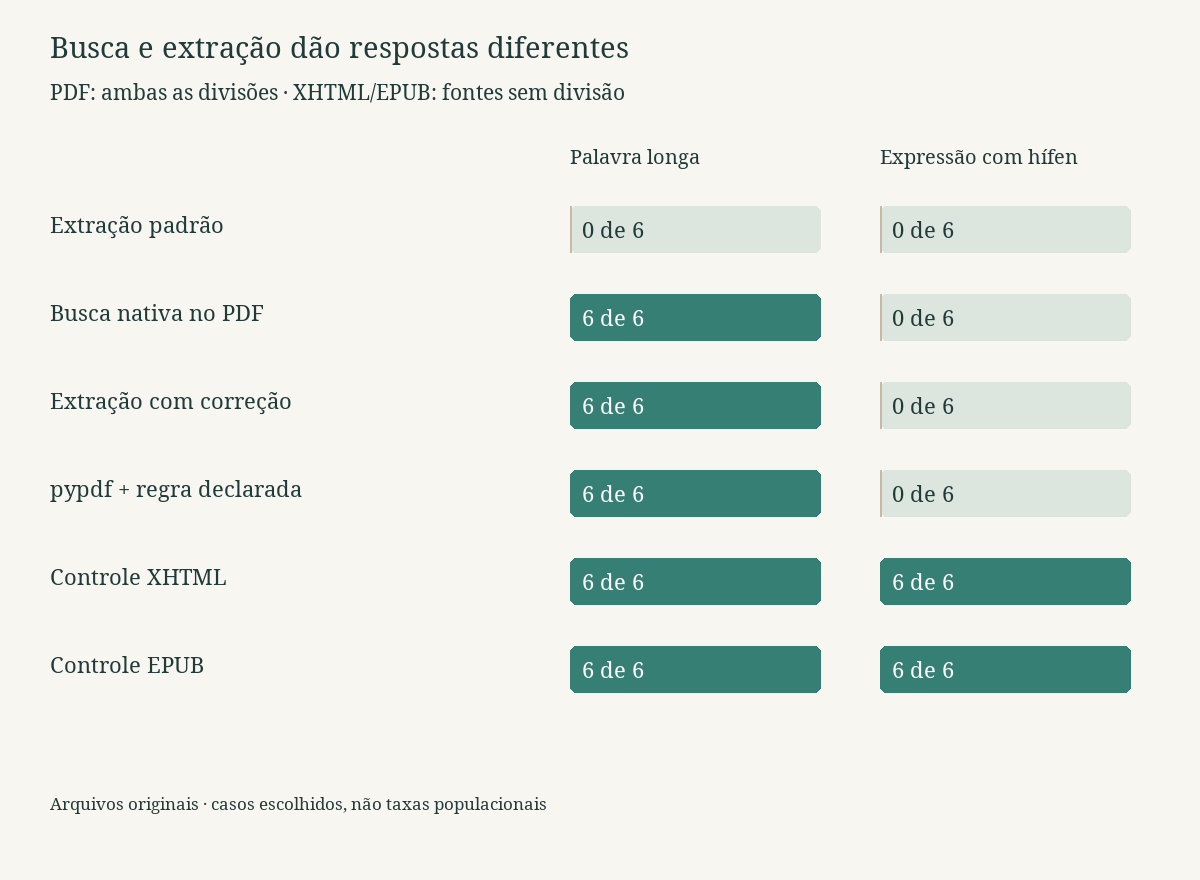
A pergunta prática aqui é deliberadamente estreita. Quando se remove um hífen de fim de linha para recuperar uma palavra quebrada, o procedimento também consegue preservar um hífen que pertence à palavra? Nas configurações testadas, a resposta foi não. Dois perfis de correção recuperaram as seis palavras-alvo quebradas pela diagramação, mas também apagaram os seis hifens legítimos das palavras compostas quando elas atravessavam uma linha. A busca nativa padrão do PDF encontrou as palavras quebradas pela diagramação, enquanto a extração padrão de texto não.
Este resultado sugere uma conferência da edição com dois exemplos opostos, e não com um único sucesso tranquilizador. Inclua uma palavra que deve ser unida e uma palavra composta que deve manter o hífen. Mantenha o manuscrito original como referência para decidir qual operação está certa. Uma regra automática que remove todo hífen de fim de linha que atenda a um critério não consegue deduzir a intenção do autor só pela pontuação.
O que os textos de teste contêm
O experimento usa seis microcontos novos, um em cada um destes idiomas: inglês, português, espanhol, francês, italiano e alemão. Cada texto de teste tem dois capítulos em miniatura, uma narrativa curta, uma nota de rodapé e uma pequena tabela de duas colunas, representada por três blocos de linha. Os textos foram criados para o experimento; nenhum romance publicado, manuscrito de cliente ou ebook comercial protegido foi enviado ou processado. São material de teste, e não uma amostra representativa de livros comerciais.
Cada idioma tem uma referência exata, com doze blocos de texto em ordem. As mesmas passagens de referência aparecem em PDF, XHTML e EPUB. A referência também contém um cartão de prova, com um acento decomposto, um acento composto, uma ligadura “ffi” literal, letras comuns e um algarismo dentro de um círculo. Esses exemplos tornam visíveis as escolhas de normalização. Eles estão na fonte de propósito e não são tratados como corrupção acidental só porque existe outra grafia Unicode.
O par do inglês é reconciliation e well-being. O português usa reconciliação e guarda-chuva; o espanhol, reconciliación e teórico-práctico; o francês, réconciliation e rendez-vous; o italiano, riconciliazione e italo-francese; o alemão, Wiedervereinigung e E-Mail. São alvos de diagnóstico fixos. Seis sucessos ou falhas significam seis textos de teste escolhidos, e não uma estimativa da porcentagem de livros ou de leitores afetados nesses idiomas.
Quatro condições pareadas de PDF
Para cada idioma, o PDF de controle quebra as linhas normalmente, sem dividir nenhum dos dois alvos. Uma segunda condição divide a palavra longa e acrescenta um hífen de exibição na quebra. Uma terceira divide a palavra composta logo depois do hífen verdadeiro. Uma quarta inclui as duas mudanças. A grade resultante tem 24 PDFs de uma página. Os controles em XHTML e EPUB mantêm as sequências de referência sem quebra, e o CSS permite a hifenização automática, em vez de inserir o hífen de exibição no texto de origem deles.
O desenho altera a quebra de linha especificada e, na condição da palavra longa, o hífen de exibição, que não faz parte da referência. As outras passagens, os tamanhos de fonte, a ordem dos blocos e a quebra normal de linha ficam fixos. O experimento não compara conversões comerciais bem-acabadas nem aplicativos de publicação concorrentes. O programa que gera o PDF posiciona o texto de forma explícita, o que torna a intervenção reproduzível e deixa a resposta esperada visível na referência. Quebrar uma palavra num ponto escolhido é uma intervenção de diagnóstico, e não uma recomendação de divisão silábica tipograficamente elegante.
O plano original foi escrito antes de gerar os textos de teste e de extrair o texto. Um piloto expôs depois dois problemas de construção: a fonte com serifa não tinha o glifo do algarismo circulado, e a primeira consulta de acentos podia coincidir com o exemplo já composto. O piloto foi mantido. Os textos aceitos acrescentam, como alternativa, uma fonte de símbolos de licença aberta e uma consulta única para o par de acentos. A emenda é declarada porque este é um experimento controlado e transparente, e não um pré-registro intocado nem uma análise confirmatória cega.
Ferramentas e operações realmente executadas
A execução offline usou PyMuPDF 2.0, pypdf 6.21.4 e lxml 6.1.3, com o ReportLab 5.1.0 gerando os textos de teste. Foram as versões que o índice oficial de pacotes mostrava na data da revisão das fontes. O PyMuPDF usa sua extração padrão de texto simples e um segundo perfil de extração que ativa TEXT_DEHYPHENATE (remoção de hifens de fim de linha). Sua busca nativa padrão é medida à parte. O resultado de uma busca nativa não conta como resultado de extração de texto.
No pypdf, a execução compara a extração simples, a extração com layout e uma regra declarada de pós-processamento. Essa regra remove um hífen que fica entre um caractere de palavra e uma quebra de linha seguida de outro caractere de palavra. Ela não tem dicionário, detector de idioma, consulta ao manuscrito nem juízo de contexto. Suas limitações fazem parte do método e não são uma surpresa de uma correção acrescentada depois de ver quais casos falharam. A expressão exata e os textos extraídos completos estão disponíveis para download.
No XHTML, o lxml percorre os blocos do corpo e preserva o texto interno e o texto que vem depois de cada elemento (os “tails”). No EPUB, o programa segue a ordem de leitura (spine) do pacote e depois usa a mesma extração por blocos. As células de tabela recebem espaços explícitos, e as linhas continuam sendo blocos separados. É um procedimento de extração próprio, que usa uma biblioteca de XML, e não a afirmação de que o lxml seja um leitor de EPUB completo. A conformidade do EPUB e a validação de acessibilidade são outras questões e não foram medidas aqui.
Recuperar uma palavra pode danificar outra
Os seis PDFs de controle coincidiram com suas referências, depois da uniformização declarada dos espaços em branco, em todos os perfis de extração de PDF. Os dois controles de fonte também coincidiram nos seis idiomas: seis arquivos XHTML e seis EPUB. Esses controles bem-sucedidos importam porque mostram que a pontuação, os acentos, a ligadura, a nota de rodapé e a pequena tabela testados podem sobreviver a esses caminhos específicos de fonte e de extração quando as quebras de diagnóstico não existem.
Com apenas o hífen de quebra de layout, a extração padrão do PyMuPDF, a extração simples do pypdf e a extração com layout do pypdf não recuperaram nenhuma das seis palavras-alvo inteiras como sequência exata. A remoção de hifens do PyMuPDF e a regra declarada do pypdf recuperaram as seis. Nessa condição, esses perfis de correção também restauraram o texto de referência completo, com os espaços em branco uniformizados. Esse é o lado bem-sucedido da intervenção e não deve ser omitido só porque a condição da palavra composta cria um problema.
Com as duas quebras de diagnóstico presentes, as saídas corrigidas voltaram a recuperar a palavra longa em seis de seis textos de teste. Elas também transformaram well-being em wellbeing, guarda-chuva em guardachuva e as palavras compostas correspondentes dos outros quatro idiomas em sequências sem hífen. Isso é uma diferença mensurável em relação à referência escolhida. Não exige afirmar que toda grafia resultante seja impossível nem que todo texto real seria mal compreendido. Para a fidelidade de uma citação, mudar a pontuação exata do autor já é a falha que importa.
Por que um bom resultado agregado pode esconder uma citação errada
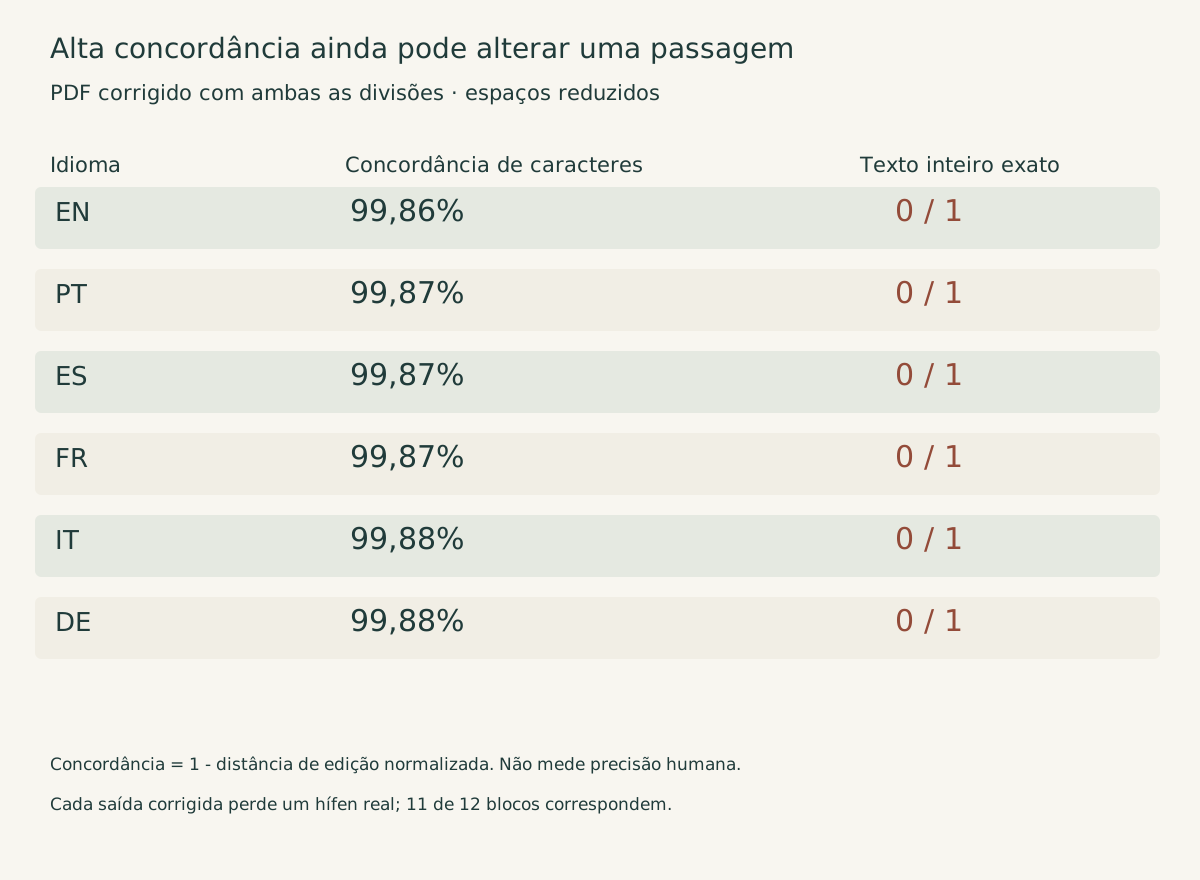
Os PDFs com as duas quebras contêm entre 726 e 841 pontos de código de referência (caracteres Unicode), depois de uniformizados os espaços em branco. As extrações padrão diferem em três operações de edição; as extrações corrigidas, em uma. Expressar um menos a distância de edição normalizada como concordância de caracteres dá cerca de 99,86% a 99,88% para as saídas corrigidas. É a descrição desta comparação exata, e não uma medida de exatidão humana, de legibilidade ou uma estimativa para uma coleção de ebooks.
Ao mesmo tempo, nenhuma das seis saídas corrigidas com as duas quebras é igual à sua referência completa. Onze dos doze blocos de referência são recuperados como sequências exatas; o parágrafo da palavra composta não é. Um valor alto de concordância no documento inteiro e uma passagem errada podem, portanto, coexistir. A métrica responde quanto as sequências diferem no total. Ela não consegue decidir se o caractere alterado pertence a um título, a um nome, a uma instrução ou a uma pontuação que uma citação precisa manter.
Autores não precisam rejeitar a comparação agregada. Precisam complementá-la com verificações ligadas ao uso real da edição. Um relatório de diferenças sobre o manuscrito inteiro pode localizar mudanças inesperadas. Algumas passagens-sentinela opostas podem expor uma correção que funciona num contexto e falha em outro. Nenhuma das duas substitui a revisão editorial, mas ambas informam mais do que tratar uma média quase perfeita como prova de que toda passagem está pronta para ser copiada.
A busca é uma condição de sucesso separada
A busca nativa padrão do PyMuPDF encontrou a consulta da palavra longa sem quebra nos seis PDFs com hífen de layout. A extração padrão de texto não continha essa sequência sem quebra em nenhum deles. A documentação oficial explica por que essas operações não precisam concordar: a busca e a extração de texto simples têm sinalizadores padrão diferentes, inclusive quanto à remoção de hifens. Um resultado positivo de busca é, portanto, compatível com uma extração padrão que mantém o hífen de exibição e uma quebra de linha.
O diagnóstico oposto também importa. A busca nativa não encontrou a consulta exata da palavra composta de referência em nenhum dos seis PDFs com as duas quebras. O estudo registra a presença da consulta, em vez de tentar interpretar retângulos destacados como um teste de leitura humana. Não testa o leitor de PDF de um navegador, o Acrobat, o Kindle, o Kobo nem a área de transferência de um sistema operacional. O comportamento deles pode ser diferente e precisa de observação própria antes que um autor afirme algo sobre esses programas.
Numa edição, mantenha a verificação de busca e acrescente uma verificação de extração. Registre o aplicativo ou a biblioteca, a versão, a consulta e as configurações de exportação. Se um leitor informar que a busca funciona, mas uma citação copiada muda, esses registros ajudam a identificar qual operação produziu a diferença. Eles também evitam que a solução de um problema seja atribuída ao formato em geral quando pertence a uma configuração ou a uma regra de pós-processamento específica.
Normalize às claras e guarde o original
O experimento relata separadamente as comparações em Unicode bruto, em NFC e em NFKC. “Bruto” não significa igualdade byte a byte dos arquivos: significa que os espaços em branco Unicode são unificados e os demais pontos de código da fonte ficam como estão. A NFC normaliza então a referência e a saída por equivalência canônica. A NFKC aplica, além disso, a normalização de compatibilidade. A versão do banco de dados Unicode do Python é guardada junto com o ambiente, para que se saiba qual implementação foi usada.
O cartão de prova mostra a distinção. O primeiro “café” usa um acento combinante, e o segundo, um caractere pré-composto. A consulta digitada do par de acentos compostos falha na comparação bruta e dá certo na NFC. Os pares do “office” expandido e do dígito comum precisam da NFKC neste texto de teste, porque a fonte inclui de propósito um caractere de ligadura e um algarismo circulado. São equivalências de busca declaradas, e não uma permissão para reescrever em silêncio o manuscrito de referência ou qualquer citação acadêmica.
Nem a NFC nem a NFKC resolvem o problema do hífen de diagnóstico. Um hífen de exibição seguido de uma quebra de linha e um hífen lexical legítimo têm intenções de autoria diferentes, mas a normalização sozinha não reconstrói essas intenções. Guarde um original intacto e identifique qualquer cópia normalizada usada para comparação. Assim é possível explicar se uma diferença informada vem da extração, de uma regra de equivalência escolhida ou de uma mudança real na fonte.
A conferência de uma edição e os limites do estudo
Antes de distribuir uma amostra, escolha passagens do manuscrito final real: uma frase comum, um nome acentuado, uma palavra longa que quebra de linha, uma expressão com hífen genuíno e qualquer tabela ou nota que os leitores possam citar. Compare a passagem exportada exata com o manuscrito. Teste a palavra que deve ser unida e o hífen que deve permanecer. Se a limpeza automática muda as duas, revise essas diferenças em vez de aplicar a regra ao livro inteiro sem uma referência.
Guarde juntos o texto de origem e o arquivo da edição. Ao revisar a tipografia ou as configurações de conversão, repita as mesmas verificações e guarde as versões das ferramentas. Uma fonte XHTML ou EPUB limpa pode oferecer um caminho de referência adicional, mas este experimento não prova que todo leitor de ebook, programa de conversão ou layout visual preserve o mesmo comportamento de cópia. Seus doze controles de fonte bem-sucedidos descrevem apenas os arquivos e o extrator por blocos fornecidos aqui.
Os registros para download também deixam o denominador visível. Cinco perfis de extração de PDF aplicados a 24 arquivos produzem 120 saídas de texto. Dois perfis de fonte estruturada em seis idiomas acrescentam mais doze. Comparar cada uma dessas 132 saídas com três regras de normalização gera 396 linhas de métricas. Essas linhas são visões repetidas do mesmo conjunto pequeno de arquivos, e não 396 testes independentes. Da mesma forma, cinco sondagens de sequência por linha de métrica dão 1.980 verificações registradas, sem aumentar o número de livros originais nem de idiomas. As 48 consultas de busca nativa ficam numa tabela à parte. Manter essas contagens separadas evita que um diagnóstico compacto pareça maior ou mais representativo só porque seus resultados foram registrados com cuidado.
Já existem comparações de extração de PDF. O DocLayNet oferece um grande conjunto anotado de layouts, e comparações publicadas avaliam vários extratores em diversas categorias de documentos. A contribuição deste estudo é menor e prática: passagens originais pareadas, alvos de hífen opostos, regras Unicode declaradas e saídas brutas que permitem a um autor reproduzir uma conferência de edição sem compartilhar um livro privado. O estudo não oferece certificação de leitura humana, parecer de acessibilidade, comparação de OCR, resultado causal de vendas nem afirmação sobre posição em buscas.
Busca e extração dão respostas diferentes
PDF: as duas quebras · XHTML/EPUB: fontes de controle sem quebra
Gráfico completo e fonte
Role para os lados para examinar o gráfico. ↔
Gráfico e valores
Role a tabela para os lados para ver todas as colunas.
| Operação | Palavra longa | Palavra composta com hífen |
|---|---|---|
| Extração padrão | 0 / 6 | 0 / 6 |
| Busca nativa no PDF | 6 / 6 | 0 / 6 |
| Extração sem hifens de fim de linha | 6 / 6 | 0 / 6 |
| pypdf + regra declarada | 6 / 6 | 0 / 6 |
| Controle XHTML | 6 / 6 | 6 / 6 |
| Controle EPUB | 6 / 6 | 6 / 6 |
PDF: as duas quebras · XHTML/EPUB: fontes de controle sem quebra
Uma concordância alta ainda deixa passar uma passagem alterada
PDF corrigido com as duas quebras · espaços em branco unificados
Gráfico completo e fonte
Role para os lados para examinar o gráfico. ↔
Gráfico e valores
Role a tabela para os lados para ver todas as colunas.
| Idioma | Concordância de caracteres | Texto inteiro exato |
|---|---|---|
| EN | 99,8623% | 0 / 1 |
| PT | 99,8661% | 0 / 1 |
| ES | 99,8721% | 0 / 1 |
| FR | 99,8705% | 0 / 1 |
| IT | 99,8767% | 0 / 1 |
| DE | 99,8811% | 0 / 1 |
Toda saída corrigida perde um hífen verdadeiro; 11 de 12 blocos coincidem.

Dados e downloads
Role a tabela para os lados para ver todas as colunas.
| Operação | Palavra longa | Palavra composta com hífen |
|---|---|---|
| Extração padrão | 0 / 6 | 0 / 6 |
| Busca nativa no PDF | 6 / 6 | 0 / 6 |
| Extração sem hifens de fim de linha | 6 / 6 | 0 / 6 |
| pypdf + regra declarada | 6 / 6 | 0 / 6 |
| Controle XHTML | 6 / 6 | 6 / 6 |
| Controle EPUB | 6 / 6 | 6 / 6 |
PDF: as duas quebras · XHTML/EPUB: fontes de controle sem quebra
Role a tabela para os lados para ver todas as colunas.
| Idioma | Concordância de caracteres | Texto inteiro exato |
|---|---|---|
| EN | 99,8623% | 0 / 1 |
| PT | 99,8661% | 0 / 1 |
| ES | 99,8721% | 0 / 1 |
| FR | 99,8705% | 0 / 1 |
| IT | 99,8767% | 0 / 1 |
| DE | 99,8811% | 0 / 1 |
Toda saída corrigida perde um hífen verdadeiro; 11 de 12 blocos coincidem.
Evidências e método
Como calculamos
- Os textos de teste sintéticos escolhidos não representam livros, leitores nem a prevalência de idiomas. Foram testados dois mecanismos de PDF e um único procedimento compartilhado de extração de fontes estruturadas.
- Uma correção do piloto, na fonte e na consulta de acentos, é declarada. As quebras de linha deslocam verticalmente as linhas seguintes. As 396 linhas repetem 132 saídas sob três normalizações.
O que os dados não permitem concluir
- Os textos de teste sintéticos escolhidos não representam livros, leitores nem a prevalência de idiomas. Foram testados dois mecanismos de PDF e um único procedimento compartilhado de extração de fontes estruturadas.
- Presença na busca, igualdade normalizada de sequências, legibilidade humana e acessibilidade são resultados diferentes. Não foram testados a área de transferência de um leitor comercial, OCR, conformidade EPUB, indexação, posição em buscas nem vendas.
- Uma correção do piloto, na fonte e na consulta de acentos, é declarada. As quebras de linha deslocam verticalmente as linhas seguintes. As 396 linhas repetem 132 saídas sob três normalizações.
Fontes originais
- DocLayNet document-layout dataset
Grande conjunto de layouts já estabelecido; contexto, e não insumo deste experimento com textos de teste originais.
Acesso em 31 de outubro de 2026
- Adhikari and Agarwal (2024), A Comparative Study of PDF Parsing Tools Across Diverse Document Categories, arXiv:2410.09871
Comparação anterior de dez ferramentas de PDF em seis categorias de documentos; não se afirma que a comparação de extratores seja novidade.
Acesso em 31 de outubro de 2026
- Meuschke et al. (2023), A Benchmark of PDF Information Extraction Tools using a Multi-Task and Multi-Domain Evaluation Framework for Academic Documents, arXiv:2303.09957
Comparação anterior de extração de documentos acadêmicos com várias tarefas.
Acesso em 31 de outubro de 2026
- PyMuPDF documentation: Constants and Enumerations (vars.html)
Definições oficiais dos sinalizadores de remoção de hifens e de preservação de ligaduras.
Acesso em 31 de outubro de 2026
- PyMuPDF documentation: Appendix 1, Details on Text Extraction (app1.html)
Explicação oficial da ordem de extração e dos padrões diferentes da busca.
Acesso em 31 de outubro de 2026
- pypdf documentation: Extract Text from a PDF
Métodos oficiais de extração simples e com layout, e suas ambiguidades.
Acesso em 31 de outubro de 2026
- lxml documentation: The lxml.etree Tutorial
Percurso oficial de XML e tratamento do texto que segue os elementos, usados nos controles de fonte.
Acesso em 31 de outubro de 2026
- Unicode Standard Annex #15: Unicode Normalization Forms
A normalização canônica e a de compatibilidade são distintas; o texto de origem é mantido.
Acesso em 31 de outubro de 2026
- PyMuPDF 2.0 release on PyPI
Versão fixada e licença na fonte oficial; a versão exata instalada é guardada.
Acesso em 31 de outubro de 2026
- pypdf 6.21.4 release on PyPI
Versão fixada e licença na fonte oficial; a versão exata instalada é guardada.
Acesso em 31 de outubro de 2026
- lxml 6.1.3 release on PyPI
Versão fixada e licença na fonte oficial; a versão exata instalada é guardada.
Acesso em 31 de outubro de 2026
- ReportLab 5.1.0 release on PyPI
Versão fixada e licença na fonte oficial; a versão exata instalada é guardada.
Acesso em 31 de outubro de 2026
Como citar e reutilizar
Alisson Bento. 2026. A busca no ebook funciona, mas o texto extraído muda: um experimento em seis idiomas. https://alissonbento.com/pt/research/ebook-search-copy-text-preservation-six-languages/
Textos de teste originais, resultados numéricos e figuras são creditados a Alisson Bento; ferramentas e fontes de terceiros mantêm suas próprias licenças.
Correções ou dúvidas editoriais