
Die praktische Entscheidung für Autorinnen und Autoren
Vor der Veröffentlichung einer Leseprobe sind Suchen nach Titel, Namen und einem markanten Satz sinnvoll. Ein Treffer zeigt, dass diese Suche in diesem Programm funktioniert hat. Er belegt nicht, dass beim Kopieren oder Exportieren dieselben Zeichen erhalten bleiben. Suche, Textexport und Vergleich mit dem Original sind verschiedene Vorgänge.
Die Frage des Versuchs ist eng gefasst: Kann eine Regel, die Trennstriche am Zeilenende entfernt, ein getrenntes Wort wieder zusammensetzen und zugleich einen Bindestrich bewahren, der zum Ausdruck gehört? In den geprüften Einstellungen stellten zwei Korrekturen alle sechs getrennten Wörter wieder her. Sie entfernten aber auch alle sechs echten Bindestriche, wenn diese Ausdrücke am Zeilenende umbrochen wurden. Eine Prüfung braucht deshalb zwei gegensätzliche Beispiele: ein Wort, das zusammengesetzt werden soll, und einen Bindestrich, der erhalten bleiben soll.
Eigene Texte und vier gepaarte Bedingungen
Für den Versuch wurden sechs sehr kurze Erzählungen geschrieben: auf Englisch, Portugiesisch, Spanisch, Französisch, Italienisch und Deutsch. Jede umfasst zwei winzige Kapitel, eine Anmerkung und eine kleine Tabelle, zusammen zwölf Referenzblöcke (Textblöcke). Dieselben Referenzpassagen erscheinen als PDF, XHTML und EPUB. Fremde Romane, private Manuskripte und geschützte kommerzielle E-Books wurden nicht verarbeitet.
Die Wortpaare lauten reconciliation und well-being, reconciliação und guarda-chuva, reconciliación und teórico-práctico, réconciliation und rendez-vous, riconciliazione und italo-francese sowie Wiedervereinigung und E-Mail. Das sind ausgewählte Testfälle und keine repräsentative Stichprobe von Sprachen. Sechs Fehler ergeben keine geschätzte Fehlerquote für alle Bücher.
Je Sprache gibt es vier einseitige PDFs. Die erste ist eine Kontrolle ohne Umbruch der Zielwörter. In der zweiten wird das lange Wort umbrochen und erhält zusätzlich einen sichtbaren Trennstrich. In der dritten wird nach dem echten Bindestrich umbrochen. Die vierte enthält beide Eingriffe zusammen. Das sind 24 PDFs, dazu sechs XHTML- und sechs EPUB-Dateien. Die strukturierten Quellen behalten die Zeichenfolgen des Referenztexts bei und erlauben automatische Trennung über CSS, ohne dass der sichtbare Trennstrich in den Quelltext eingefügt wird. Der gewählte Umbruch ist ein Eingriff für den Test und keine Empfehlung zur richtigen Silbentrennung.
Programme und offengelegte Korrektur nach dem Probelauf
Der lokale Lauf verwendete PyMuPDF 2.0, pypdf 6.21.4 und lxml 6.1.3; ReportLab 5.1.0 erzeugte die PDFs. Verglichen wurden der Standardtextexport von PyMuPDF und die Option TEXT_DEHYPHENATE, die Trennstriche am Zeilenende entfernt. Die Standardsuche wurde getrennt erfasst. Bei pypdf kamen der einfache Modus, der Layoutmodus und eine ausdrücklich festgelegte Nachbearbeitung zum Einsatz. Sie entfernt einen Bindestrich, der zwischen einem Wortzeichen und einem Zeilenumbruch steht, wenn danach wieder ein Wortzeichen folgt. Sie nutzt weder ein Wörterbuch noch das Manuskript.
Das Programm für XHTML geht mit lxml die Textblöcke im Hauptteil durch. Bei EPUB folgt es zuerst der im Paket festgelegten Lesereihenfolge. Es bewahrt Text in eingebetteten Elementen, trennt Tabellenzellen durch Leerzeichen und behandelt jede Tabellenzeile als Block. Das ist ein Ablauf, der mit einer XML-Bibliothek geschrieben wurde. Er ist keine Untersuchung aller EPUB-Leseprogramme oder ihrer Barrierefreiheit.
Der Plan entstand vor der Erzeugung der Dateien. Ein Probelauf zeigte, dass für die eingekreiste Ziffer ein Zeichenbild fehlte und dass eine Suche nach dem Akzent auch ein anderes Beispiel treffen konnte. Der Probelauf bleibt erhalten. Die akzeptierten Dateien ergänzen eine offen lizenzierte Symbolschrift und eine eindeutige Suche für das Akzentpaar. Diese Änderung ist dokumentiert. Der Versuch wird nicht als unveränderte Vorregistrierung (vorab festgelegter Plan) oder als verblindete Analyse dargestellt.
Eine Reparatur stellt Text wieder her und verändert ihn
Alle sechs Kontroll-PDFs stimmen nach der erklärten Zusammenfassung von Leerraum in allen Einstellungen des Textexports mit ihrem Referenztext überein. Das gilt auch für die sechs XHTML- und sechs EPUB-Kontrollen. Akzente, Ligaturzeichen, Anmerkung und kleine Tabelle bleiben auf diesen konkreten Wegen erhalten, solange die Umbrüche für den Test fehlen.
Ist nur der sichtbare Trennstrich im langen Wort vorhanden, finden der Standardexport von PyMuPDF und beide Modi von pypdf keines der sechs Zielwörter als vollständige, exakte Zeichenfolge. Die Option zum Entfernen von Trennstrichen und die nachträgliche Regel stellen alle sechs wieder her. In dieser Bedingung stellen sie außerdem den vollständigen Referenztext wieder her. Dieser gemessene Nutzen gehört zum Ergebnis.
Bei beiden Umbrüchen bleiben die langen Wörter nach der Korrektur erhalten. Zugleich wird etwa well-being zu wellbeing und E-Mail zu EMail; auch die vier anderen Ausdrücke verlieren ihren ursprünglichen Bindestrich. Für ein wortgetreues Zitat ist schon die Abweichung vom Manuskript relevant. Man muss nicht behaupten, jede entstandene Schreibweise sei unmöglich oder führe immer zu Missverständnissen.
Hohe Zeichenübereinstimmung kann ein verändertes Zitat verdecken
Nach der Behandlung des Leerraums enthalten die Referenzen 726 bis 841 Zeichen (Unicode-Codepunkte). Bei beiden Umbrüchen sinkt die Editierdistanz nach der Korrektur von drei Operationen auf eine. Die Editierdistanz zählt, wie viele einzelne Änderungen nötig sind, um einen Text in den anderen zu verwandeln. Eins minus der normalisierten Distanz ergibt etwa 99,86 bis 99,88 % Übereinstimmung der Zeichen. Das beschreibt zwei Zeichenfolgen und misst weder menschliche Genauigkeit noch Lesbarkeit.
Trotzdem stimmt keiner der sechs korrigierten Gesamtexporte exakt mit seinem Referenztext überein. Elf von zwölf Blöcken stimmen exakt überein; der Absatz mit dem geänderten Ausdruck weicht ab. Ein hoher Gesamtwert zeigt nicht, ob das veränderte Zeichen einen Namen, einen Titel oder einen wichtigen Beleg betrifft. Deshalb sollten Gesamtvergleich und gezielte Beispielpassagen zusammen betrachtet werden.
Die Standardsuche von PyMuPDF findet alle sechs langen Wörter in den PDFs, die nur den sichtbaren Trennstrich enthalten. Der Standardtextexport enthält keines davon vollständig. Die Dokumentation nennt unterschiedliche Voreinstellungen für Suche und Extraktion, darunter die Behandlung der Trennstriche. Die exakte Suche nach dem Ausdruck mit echtem Bindestrich findet dagegen in keinem der sechs PDFs mit beiden Umbrüchen etwas. Zwischenablage, Acrobat, Kindle, Kobo und Browser-Leseprogramme wurden nicht geprüft.
Unicode-Regeln ausdrücklich benennen
Der Versuch trennt Vergleiche ohne Unicode-Normalisierung, mit NFC und mit NFKC. Normalisierung vereinheitlicht verschiedene Schreibweisen desselben Zeichens. Der erste Vergleich fasst Unicode-Leerraum zusammen und bewahrt alle übrigen Zeichen. NFC wendet kanonische Äquivalenz (gleichwertige Zeichen) auf Referenz und exportierten Text an; NFKC ergänzt Kompatibilitätsäquivalenzen. Die Version der Unicode-Datenbank von Python ist dokumentiert.
Auf der Prüfkarte hat das erste „café“ einen kombinierenden Akzent, das zweite ein vorgefertigtes Zeichen. Die Suche, die beide Formen als vorgefertigte Zeichen eingibt, scheitert ohne Normalisierung und gelingt mit NFC. Das ausgeschriebene Paar „office“ und die gewöhnlichen Ziffern brauchen NFKC, weil die Quelle ein Ligaturzeichen und eine eingekreiste Ziffer enthält. Das sind erklärte Vergleichsregeln, keine Erlaubnis, das Manuskript unbemerkt umzuschreiben. Keine der beiden Normalisierungen löst das Problem mit dem Bindestrich.
Was sich im einzelnen Abschnitt verändert
Der deutsche Referenztext enthält Wiedervereinigung ohne Bindestrich und E-Mail mit Bindestrich. In der ersten Bedingung wird innerhalb des langen Wortes ein sichtbarer Trennstrich ergänzt und der Rest in die nächste Zeile gesetzt. Die andere Bedingung behält den echten Bindestrich bei und bricht unmittelbar danach um. Ein Strich am Zeilenende verrät also für sich genommen nicht, welche Aufgabe er hat. Die beabsichtigte Schreibweise steht im mitgelieferten Referenztext.
Ohne Korrektur bleibt im langen Wort der ergänzte Strich zusammen mit einem Leerzeichen stehen, nachdem die Umbrüche zusammengefasst wurden. Der echte Ausdruck behält seinen Bindestrich, erhält aber ebenfalls ein Leerzeichen zwischen den Teilen. Deshalb beträgt die Editierdistanz bei beiden Eingriffen drei Operationen. Die Korrektur beseitigt die beiden zusätzlichen Zeichen des ersten Falls und entfernt zugleich den nötigen Bindestrich des zweiten. Die Distanz sinkt auf eine Operation, obwohl eine Entscheidung der Autorin oder des Autors verändert bleibt.
Ein fehlender Suchtreffer bedeutet keinen verschwundenen Absatz
Ein Wort, das nicht zusammenhängend gefunden wird, ist von gelöschtem Text zu unterscheiden. Im Standardexport sind die Teile des langen Wortes vorhanden, getrennt durch Strich und Zeilenumbruch. Die exakte Suche findet sie in der Form des Referenztexts nicht. Die Aussage, ein Programm habe das Wort verloren, könnte dagegen eine vollständige Löschung nahelegen, die hier nicht beobachtet wurde. Die vollständigen Textdateien erlauben eine direkte Prüfung.
Auch ein erfolgreicher Suchlauf der eingebauten Suche hat nur begrenzte Aussagekraft. Er bestätigt nur, dass die Funktion das Wort nach ihren eigenen Regeln findet. Er bestätigt weder einen bereits korrigierten Export noch dasselbe Verhalten bei allen benachbarten Ausdrücken. Der Unterschied zwischen sechs Suchtreffern und keinem vollständigen Zielwort im Standardexport ist gerade deshalb aufschlussreich, weil beide Vorgänge dieselbe Datei und dieselbe Referenzsuche erhalten.
Viele Ergebniszeilen sind noch keine große Stichprobe von Büchern
Fünf Einstellungen für den Textexport bei 24 PDFs ergeben 120 Textausgaben. Die beiden Einstellungen für die strukturierten Quellen ergänzen zwölf weitere. Jede dieser 132 Textausgaben wird nach drei Unicode-Regeln verglichen; daraus entstehen 396 Ergebniszeilen. Das sind wiederholte Betrachtungen derselben Textausgaben und keine Hunderte unabhängiger Bücher. Die ausführliche Dokumentation verbessert die Nachprüfbarkeit, macht die Auswahl aber nicht repräsentativer.
Fünf Suchen nach exakten Zeichenfolgen je Ergebniszeile liefern 1.980 Prüfungen. Die 48 Suchen der eingebauten Suche stehen in einer eigenen Tabelle. Daraus sollte man keine gemeinsame Erfolgsquote bilden. Die Suchen prüfen unterschiedliche Anforderungen: ein Wort zusammenfügen, einen Bindestrich behalten, einen Akzent erkennen oder eine Kompatibilitätsäquivalenz zulassen. Eine einzige Summe könnte viele einfache Treffer belohnen und zugleich das veränderte Zitat verdecken, auf das es beim Export ankommt.
Was die EPUB- und HTML-Kontrollen belegen
Die sechs EPUB-Dateien enthalten dasselbe XHTML wie die sechs Kontrollen der Quelle. Das Programm für EPUB liest zunächst die im Paket festgelegte Reihenfolge und verwendet dann dieselbe Funktion für die Textblöcke. Zwölf erfolgreiche Kontrollen sind deshalb keine zwölf unabhängigen Leseprogramme, die einen allgemeinen Vorteil eines Formats bestätigen. Sie zeigen die Übereinstimmung dieser gepaarten Quellen mit diesem festgelegten Ablauf.
Die sichtbare automatische Trennung auf unterschiedlich großen Bildschirmen wurde nicht gemessen. CSS erlaubt sie, doch der Versuch untersucht den Quelltext und verlangt keine bestimmte Seitendarstellung durch ein bestimmtes Programm. Für die Planung einer E-Book-Veröffentlichung ist diese Trennung hilfreich: Die Darstellung kann wechseln, während die Zeichenfolge der Quelle unverändert bleibt. Wie Auswählen, Suchen oder Kopieren in einem konkreten Leseprogramm funktionieren, müsste dagegen zusätzlich direkt beobachtet werden.
Anmerkungen und Tabellen brauchen eigene Grenzen
Die Anmerkung hat einen ausdrücklichen Verweis und steht am Ende des kurzen Textes. Die Tabelle umfasst nur drei Zeilen mit jeweils zwei Zellen. Die Kontrollen erhalten diese einfache Folge. Damit sind weder verbundene Tabellenzellen noch die Zuordnung weit entfernter Fußnoten noch die Wiederherstellung mehrspaltiger Seiten geprüft. Die Aussage muss an die tatsächlich erzeugte Struktur gebunden bleiben.
Auch eine vollständig erhaltene Zeichenfolge einer Tabelle beweist nicht, dass die Beziehungen zwischen den Zellen in jedem Ausgabeformat verständlich dargestellt werden. Hier fügt der Ablauf bewusst ein Leerzeichen zwischen die Zellen ein und erhält die Reihenfolge der Zeilen. Diese Entscheidung gehört zur Methode. Sie verhindert, dass aneinandergeklebte Zellen fälschlich als Verlust des ursprünglichen Wortes erscheinen. Ein anderer Tabellenaufbau könnte andere Trennzeichen und einen eigenen Referenztext brauchen, bevor man seine Ergebnisse sinnvoll bewerten kann.
Unicode-Äquivalenz ist eine bewusste Entscheidung bei der Nutzung
Auf der Prüfkarte wandelt NFKC das Ligaturzeichen und die eingekreiste Ziffer in Kompatibilitätsformen um. Für eine Suche kann das zweckmäßig sein. Bei einer Transkription, die gerade die Schreibweise einer Buchausgabe untersucht, kann dadurch ein wichtiger Unterschied verloren gehen. Es gibt keine Normalisierung, die automatisch für jeden Zweck richtig ist. Deshalb bleiben Original, normalisierte Vergleichskopie und verwendete Regel unterscheidbar.
Das Beispiel mit dem Akzent betrifft dagegen die kanonische Äquivalenz: Ein kombinierendes Zeichen und ein vorgefertigtes Zeichen können nach NFC dieselbe Vergleichsform ergeben. Diese beobachtete Verbesserung der Suche löst nicht das Problem am Zeilenende. Ein Bindestrich, der zum Wort gehört, und ein Strich, der nur für den Umbruch ergänzt wurde, haben unterschiedliche Absichten. Die Unicode-Normalisierung allein gewinnt diese Absichten aus dem Manuskript nicht zurück. Eine Normalisierungsoption sollte deshalb nicht als allgemeine Reparatur von Text beschrieben werden.
Die Dateien lesen und den Lauf wiederholen
Das Paket enthält den Referenztext, PDF-, EPUB- und XHTML-Dateien sowie vollständige Rohtextexporte. Ein sinnvoller Einstieg ist ein einzelnes Dateipaar: das Zielwort ansehen, den Export vergleichen und erst dann die Kennzahl lesen. Die passende Zeile der CSV-Datei lässt sich über Sprache, Bedingung, Einstellung und Normalisierung auswählen. So bleibt klar, welche Zeichenfolge ein bestimmter Prozentwert beschreibt.
Für die Wiederholung braucht man die festgelegten Versionen der Programme und die mit Lizenz mitgelieferten Schriften. Die erste Installation erfordert Internetzugang; das Programm, das die Dateien erzeugt und den Text exportiert, führt keine Netzwerkaufrufe aus. Das ist keine Behauptung, dass das Betriebssystem das Netz tatsächlich getrennt hätte. Die unabhängige Prüfung hat die akzeptierten Dateien nachgerechnet. Mit einer gesonderten Umsetzung kontrollierte sie Distanzen, Suchen und die Gleichheit der Quellen. Sie untersuchte kein menschliches Textverständnis.
Der Beitrag gegenüber vorhandenen Vergleichen
DocLayNet bietet viele annotierte Seiten unterschiedlicher Dokumente. Veröffentlichte Vergleiche untersuchen bereits mehrere Programme zum Auslesen von Text nach Dokumentkategorie. Dass PDF-Text Probleme verursachen kann, ist kein neuer Befund. Hier geht es um eine kleinere redaktionelle Entscheidung: Eine Bereinigung erfüllt die gezielt geprüfte Suche und verändert gleichzeitig die Zeichensetzung eines zweiten Ausdrucks, dessen beabsichtigte Form ebenfalls bekannt ist.
Beide Anforderungen gemeinsam zu behalten verhindert eine Erfolgsmeldung aufgrund eines einzigen beruhigenden Beispiels. Der Versuch entwickelt keinen neuen Algorithmus und bestimmt keinen allgemeinen Sieger unter den Programmbibliotheken. Wer ein Buch veröffentlicht, kann die Zielpaare als Vorlage nutzen und in privater Umgebung eigene endgültige Stellen des Manuskripts prüfen. Die dabei beobachteten Fehler wären neue Ergebnisse für diese Dateien und Einstellungen. Ihre Häufigkeit lässt sich aus den sechs bewusst gewählten Sprachbeispielen dieses Versuchs nicht ableiten.
Eine wiederholbare Prüfung der fertigen E-Book-Datei
Für die Prüfung einer E-Book-Datei wählt man aus dem endgültigen Manuskript einen gewöhnlichen Satz, einen Namen mit Akzent, ein langes umbrochenes Wort, einen Ausdruck mit echtem Bindestrich sowie zitierbare Anmerkungen oder Tabellen. Man vergleicht den exportierten Text mit dem Original und hält Programm, Version und Optionen fest. Nach einer Layoutänderung wiederholt man dieselben Passagen. Behebt eine automatische Reinigung einen Fall und verändert einen anderen, prüft man die Unterschiede, bevor man sie auf das ganze Buch anwendet.
Vergleichstests für das Auslesen von PDF bestehen bereits, darunter DocLayNet und Vergleiche mehrerer Programme nach Dokumentkategorien. Dieser Beitrag ist kleiner: eigene gepaarte Texte, gegensätzliche Anforderungen an den Bindestrich, erklärte Unicode-Regeln und vollständige Textausgaben für eine Wiederholung ohne privates Buchmaterial. Der Versuch belegt weder EPUB-Konformität noch Barrierefreiheit, weder menschliches Verständnis noch OCR-Leistung, weder Verkäufe noch Indexierung noch Suchplatzierungen.
Suche und Textexport liefern verschiedene Ergebnisse
PDF: beide Umbrüche · XHTML/EPUB: ungetrennte Quellen
Vollständige Grafik und Quelle
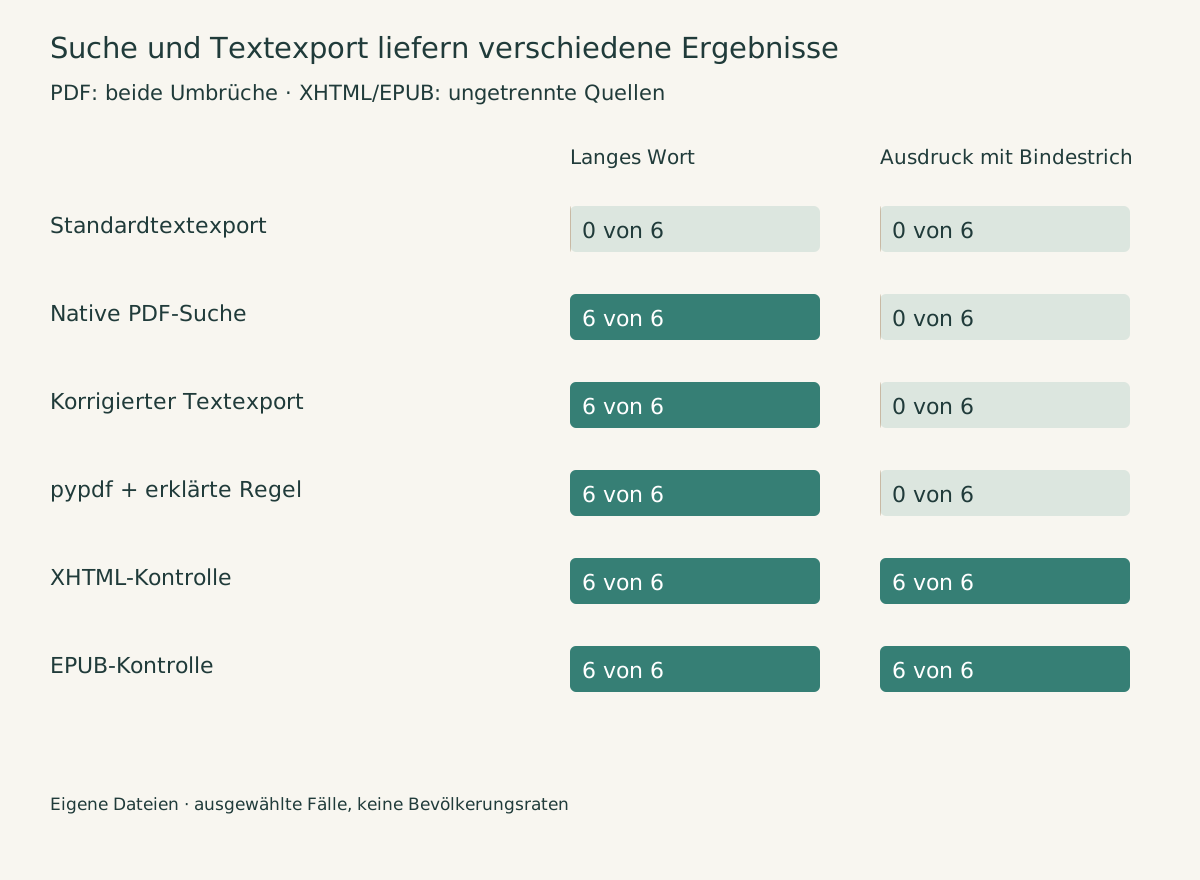
Diagramm seitlich scrollen, um alle Details zu sehen. ↔
Grafik und Werte
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Vorgang | Langes Wort | Ausdruck mit Bindestrich |
|---|---|---|
| Standardtextexport | 0 / 6 | 0 / 6 |
| Eingebaute PDF-Suche | 6 / 6 | 0 / 6 |
| Korrigierter Textexport | 6 / 6 | 0 / 6 |
| pypdf + erklärte Regel | 6 / 6 | 0 / 6 |
| XHTML-Kontrolle | 6 / 6 | 6 / 6 |
| EPUB-Kontrolle | 6 / 6 | 6 / 6 |
PDF: beide Umbrüche · XHTML/EPUB: ungetrennte Quellen
Hohe Übereinstimmung kann ein verändertes Zitat verdecken
Korrigiertes PDF mit beiden Umbrüchen · Leerraum vereinheitlicht
Vollständige Grafik und Quelle

Diagramm seitlich scrollen, um alle Details zu sehen. ↔
Grafik und Werte
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Sprache | Zeichenübereinstimmung | Gesamttext exakt |
|---|---|---|
| EN | 99,8623 % | 0 / 1 |
| PT | 99,8661 % | 0 / 1 |
| ES | 99,8721 % | 0 / 1 |
| FR | 99,8705 % | 0 / 1 |
| IT | 99,8767 % | 0 / 1 |
| DE | 99,8811 % | 0 / 1 |
Jeder korrigierte Export verliert einen Bindestrich; 11 von 12 Blöcken stimmen.

Daten und Downloads
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Vorgang | Langes Wort | Ausdruck mit Bindestrich |
|---|---|---|
| Standardtextexport | 0 / 6 | 0 / 6 |
| Eingebaute PDF-Suche | 6 / 6 | 0 / 6 |
| Korrigierter Textexport | 6 / 6 | 0 / 6 |
| pypdf + erklärte Regel | 6 / 6 | 0 / 6 |
| XHTML-Kontrolle | 6 / 6 | 6 / 6 |
| EPUB-Kontrolle | 6 / 6 | 6 / 6 |
PDF: beide Umbrüche · XHTML/EPUB: ungetrennte Quellen
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Sprache | Zeichenübereinstimmung | Gesamttext exakt |
|---|---|---|
| EN | 99,8623 % | 0 / 1 |
| PT | 99,8661 % | 0 / 1 |
| ES | 99,8721 % | 0 / 1 |
| FR | 99,8705 % | 0 / 1 |
| IT | 99,8767 % | 0 / 1 |
| DE | 99,8811 % | 0 / 1 |
Jeder korrigierte Export verliert einen Bindestrich; 11 von 12 Blöcken stimmen.
Daten und Methode
So haben wir gerechnet
- Die gewählten Dateien repräsentieren nicht alle Bücher, Lesenden oder Sprachen. Geprüft wurden zwei PDF-Programme und ein gemeinsamer Ablauf für strukturierte Quellen.
- Die Korrektur nach dem Probelauf ist erklärt. Umbrüche verschieben folgende Zeilen. Die 396 Zeilen wiederholen 132 Textausgaben unter drei Normalisierungen.
Was die Daten nicht aussagen
- Die gewählten Dateien repräsentieren nicht alle Bücher, Lesenden oder Sprachen. Geprüft wurden zwei PDF-Programme und ein gemeinsamer Ablauf für strukturierte Quellen.
- Suchtreffer, normalisierte Gleichheit, menschliches Lesen und Barrierefreiheit sind verschiedene Ergebnisse. Es gibt keine Tests mit kommerziellen Zwischenablagen, OCR, EPUB-Konformität, Indexierung, Suchplatzierung oder Verkäufen.
- Die Korrektur nach dem Probelauf ist erklärt. Umbrüche verschieben folgende Zeilen. Die 396 Zeilen wiederholen 132 Textausgaben unter drei Normalisierungen.
Originalquellen
- DocLayNet document-layout dataset
Vorhandener großer Datensatz zum Layout von Dokumenten; Hintergrund, keine Eingabedaten dieses eigenen Versuchs.
Abgerufen am 31. Oktober 2026
- Adhikari and Agarwal (2024), A Comparative Study of PDF Parsing Tools Across Diverse Document Categories, arXiv:2410.09871
Vorhandener Vergleich von zehn PDF-Programmen in sechs Kategorien; kein Anspruch auf eine neue Idee für Vergleichstests.
Abgerufen am 31. Oktober 2026
- Meuschke et al. (2023), A Benchmark of PDF Information Extraction Tools using a Multi-Task and Multi-Domain Evaluation Framework for Academic Documents, arXiv:2303.09957
Früherer wissenschaftlicher Vergleichstest für das Auslesen von Text mit mehreren Aufgaben.
Abgerufen am 31. Oktober 2026
- PyMuPDF documentation: Constants and Enumerations (vars.html)
Offizielle Definitionen zum Entfernen von Trennstrichen und zum Erhalt von Ligaturen.
Abgerufen am 31. Oktober 2026
- PyMuPDF documentation: Appendix 1, Details on Text Extraction (app1.html)
Offizielle Erklärung zur Reihenfolge des extrahierten Texts und zu abweichenden Voreinstellungen der Suche.
Abgerufen am 31. Oktober 2026
- pypdf documentation: Extract Text from a PDF
Offizielle einfache und Layout-Extraktion mit ihren Mehrdeutigkeiten.
Abgerufen am 31. Oktober 2026
- lxml documentation: The lxml.etree Tutorial
Durchlauf durch XML und Behandlung von eingebettetem Text für die Kontrollen der Quelle.
Abgerufen am 31. Oktober 2026
- Unicode Standard Annex #15: Unicode Normalization Forms
Kanonische Normalisierung und Kompatibilitätsnormalisierung sind verschieden; das Original bleibt erhalten.
Abgerufen am 31. Oktober 2026
- PyMuPDF 2.0 release on PyPI
Festgelegte Veröffentlichung und Lizenz aus offizieller Quelle; die installierte Version ist dokumentiert.
Abgerufen am 31. Oktober 2026
- pypdf 6.21.4 release on PyPI
Festgelegte Veröffentlichung und Lizenz aus offizieller Quelle; die installierte Version ist dokumentiert.
Abgerufen am 31. Oktober 2026
- lxml 6.1.3 release on PyPI
Festgelegte Veröffentlichung und Lizenz aus offizieller Quelle; die installierte Version ist dokumentiert.
Abgerufen am 31. Oktober 2026
- ReportLab 5.1.0 release on PyPI
Festgelegte Veröffentlichung und Lizenz aus offizieller Quelle; die installierte Version ist dokumentiert.
Abgerufen am 31. Oktober 2026
Studie zitieren und weiterverwenden
Alisson Bento. 2026. Die Suche im E-Book funktioniert, doch exportierter Text verändert sich: ein Versuch in sechs Sprachen. https://alissonbento.com/de/research/ebook-search-copy-text-preservation-six-languages/
Eigene Texte, Ergebnisse und Abbildungen: Alisson Bento. Programme und Schriften behalten ihre Lizenzen.
Korrekturen oder redaktionelle Fragen