
Was die Datensätze zeigen
Eine Bibliothek besitzt ein Buch, doch der zugehörige Ausleihvorgang wird nicht immer unter derselben Bibliothekskennung erfasst. In der öffentlichen Datei zu den Ausleihen in Pankow für 2024 stehen bei 50.080 regulären A-Vorgängen zwei verschiedene auswertbare Zahlenkennungen für die besitzende und die ausgebende Bibliothek. Das sind 5,50 % aller 911.020 regulären Vorgänge. Bei weiteren 855.057 Vorgängen steht in beiden Feldern dieselbe Kennung. Die übrigen 5.883 Fälle lassen sich mit den bewusst strengen Regeln dieser Auswertung keiner der beiden Beziehungen zuordnen.
Diese Zahlen beschreiben die Beziehung zwischen zwei Verwaltungsfeldern. Sie zählen weder Personen, die zwischen Bezirken unterwegs sind, noch Bücher in Lieferfahrzeugen, erfolgreich erfüllte Bestellungen zwischen Bibliotheken oder verschiedene Werke. Die amtliche Dokumentation erklärt, dass ein Medium zwischen Bibliotheken bestellt und in einer anderen Bibliothek ausgeliehen werden kann. Der Unterschied zwischen den Feldern hat also eine echte Bedeutung für den Bibliotheksbetrieb. Eine abweichende Kennung beweist aber nicht, was bei einem bestimmten Vorgang tatsächlich körperlich geschehen ist.
Der Unterschied wird wichtig, wenn jemand mit der Aktivität einer Zweigstelle beschreiben will, wie weit ihr eigener Bestand reicht. Eine Zählung nach Besitzkennung zeigt, wo der erfasste Bestand hingehört. Eine Zählung nach Ausgabekennung zeigt, welche erfasste Stelle den Vorgang bearbeitet hat. Das sind verwandte, aber verschiedene Rollen. Die herunterladbare Kreuztabelle hält sie getrennt. Keine der beiden Kennungen sagt, welche Bibliothek die Stammbibliothek einer Person ist oder wo sie wohnt.
Die wichtigste methodische Warnung betrifft die Verlängerungen. Von 731.076 T-Vorgängen fehlt bei 649.142 mindestens eine der erforderlichen Kennungen; weitere 2.113 enthalten eine ungültig formatierte Kennung. Bei diesen Verlängerungen ist es jeweils die Ausgabekennung. Eine Tabelle mit nur den vollständigen Verlängerungen würde deshalb einen kleinen, ausgewählten Teil dieses Vorgangstyps beschreiben. Wer ihr räumliches Muster direkt mit regulären Ausleihen vergleicht, verwechselt, ob eine Ortskennung vorhanden ist, mit dem tatsächlichen Verhalten.
Warum das Regal vor Ort als Beschreibungseinheit nicht ausreicht
Eine Zweigstelle in der Nachbarschaft ist für Lesende ein naheliegender Ausgangspunkt. Auch für Jahresberichte lassen sich Zahlen bequem nach einzelnen Bibliotheken ordnen. In einem vernetzten Bibliothekssystem wird diese einfache Einheit aber unscharf: Der Bestand, der einer Stelle zugerechnet wird, und die Vorgänge, die dort bearbeitet werden, haben nicht unbedingt dieselben Grenzen. Wer etwas über einen Bestand sagt, sollte deshalb benennen, welche Grenze er meint: die Besitzzuordnung oder die ausgebende Stelle. Erst dann sind unterschiedliche Tabellen sachlich vergleichbar.
Ein rein erfundenes Beispiel zeigt das Zählproblem. Ein Medium gehört laut Datensatz zur Kennung X, der Vorgang wird aber unter der Kennung Y ausgegeben. Eine Besitzstatistik rechnet den Vorgang X zu, eine Ausgabestatistik Y. Würde man beide Summen addieren, wäre derselbe Vorgang doppelt gezählt. Wer nur X zeigt, macht die ausgebende Rolle unsichtbar. Wer nur Y zeigt, verdeckt, zu welchem Bestand das Medium gehört. Das Beispiel erklärt das Zählproblem. Es schätzt weder einen Transport noch die Nachfrage noch die Qualität einer der beiden Stellen.
Die Pankower Datei macht diesen Unterschied überprüfbar, weil sie beide Felder enthält. In der Tabelle der regulären Vorgänge gehören alle auswertbaren Besitzkennungen im mitgelieferten amtlichen Schlüsselverzeichnis zu Pankow. Auswertbare Ausgabekennungen liegen dagegen sowohl in Pankow als auch in anderen Berliner Bezirken, die das Verzeichnis zuordnet. Das kennzeichnet diesen Export. Es macht ihn nicht zu einer vollständigen Erfassung aller Ausleihen in Berlin, aller Vorgänge von Menschen, die in Pankow wohnen, oder aller Möglichkeiten, Pankower Medien zu nutzen.
Praktisch geht es darum, wie man eine Karte, eine Tabelle oder einen lokalen Bericht beschriftet. Eine Darstellung nach Besitzkennungen kann die Bestandsseite der erfassten Vorgänge zeigen. Eine Darstellung nach Ausgabekennungen kann ihre Bearbeitungsseite zeigen. Als Karte der Wohnorte von Nutzenden darf keine von beiden bezeichnet werden, solange keine weiteren, geeigneten Belege diese Geografie stützen. Diese Studie verwendet die Merkmale der ausleihenden Personen, die ebenfalls in der Quelle stehen, absichtlich nicht. Sie braucht diese Angaben für ihre Frage nicht.
Quelle und zeitliche Grenzen
Grundlage ist der Datensatz, den das Bezirksamt Pankow über Berlin Open Data für 2022, 2023 und 2024 veröffentlicht hat. Wir analysieren nur die CSV-Datei für 2024. Ihre 348.162.105 Bytes sind durch die festgehaltene SHA-256-Prüfsumme 0d1994ba15217b381ba5ab1455433b7f7aea5dde07e2da943c688833664ab5c9 eindeutig bestimmt. Das Portal nennt den 1. Juli 2025 als Datum der Aktualisierung und stellt den Datensatz unter Creative Commons Zero (CC0). Der Datensatz beschreibt erfolgreiche und fehlgeschlagene Ausleihvorgänge. Deshalb darf man die gesamte Rohdatei nicht pauschal als Zahl abgeschlossener Ausleihen bezeichnen.
Die mitgelieferte Kurzdokumentation trägt das Datum 23. Januar 2023. Sie erläutert die Besitzkennung, die Ausgabekennung und die Arten von Vorgängen. Das ergänzende Verzeichnis der Bibliotheken haben wir über genau den Link bezogen, der auf der amtlichen Datensatzseite angegeben ist. Seine Prüfsumme ist gesondert festgehalten. Manche Einträge in diesem Verzeichnis enthalten historische Namen, zusammengesetzte Kennungen oder Hinweise auf geschlossene Standorte. Es dient dazu, gespeicherte Codes zu deuten. Es ist kein unabhängig geprüftes Verzeichnis der heute geöffneten Bibliotheken.
Wir schließen aus einem historischen Eintrag im Verzeichnis nicht, dass die genannte Stelle das ganze Jahr 2024 geöffnet war, heute noch arbeitet oder ein bestimmtes Servicemodell hatte. Zahlenkennungen, die das vorsichtige Zuordnungsverfahren im Verzeichnis nicht findet, bleiben ohne Zuordnung. Wir ersetzen die fehlende Verbindung weder durch Ähnlichkeit mit einer anderen Kennung noch durch einen vermuteten Bibliotheksnamen oder einen aktuellen Suchtreffer. So bleibt die beobachtete Zahlenbeziehung getrennt von einer Deutung als räumliche Beziehung.
Bei der Auswahl aus der Rohdatei sind nur sechs festgelegte Felder ohne Merkmale von Personen erlaubt: Medienart, Besitzkennung, Ausgabekennung, Zielgruppe des Mediums, Art des Vorgangs und Monat. Die Auswertung der Orte nutzt die ersten drei Felder und die Art des Vorgangs. Titel, Verfasserin oder Verfasser, Exemplarnummer, Benutzergruppe, Alter, Geschlecht, Wohngebiet und das zusätzliche Zeitfeld im Export von 2024 werten wir nicht aus. Die öffentlichen Ergebnisse enthalten zusammengefasste Kennungen von Einrichtungen und Anzahlen, keine einzelnen Vorgangszeilen mit weiteren Merkmalen.
Reguläre Vorgänge, Verlängerungen und Stornierungen bleiben getrennt
Die vollständige CSV-Datei enthält 1.701.989 Zeilen. Davon sind 911.020 reguläre Vorgänge (Code A), 731.076 Verlängerungen (Code T), 30.726 Stornierungen (Code O) und 29.167 Wiederholungsvorgänge nach einer Stornierung (Code 9). Laut amtlicher Dokumentation kann eine Stornierung zum Beispiel entstehen, wenn ein Ausleihvorgang rückgängig gemacht wird, weil der RFID-Chip nicht beschrieben wurde. Code 9 steht für den anschließenden erneuten Versuch. Diese Einzelheiten des Betriebs sind für die Deutung der Gesamtzahl wichtig.
Die zentrale Kreuztabelle der Besitz- und Ausgabekennungen beschränkt sich auf A-Vorgänge. Für T-Vorgänge gibt es eine eigene Tabelle, mit der wir prüfen, wie vollständig die Angaben sind und wie stark mögliche Vergleiche davon abhängen. Stornierungen (O) und Wiederholungsvorgänge (9) bleiben in der vollständigen Gesamtrechnung sichtbar, gehen aber weder in den Zähler noch in die Bezugsgruppe der Hauptauswertung ein. So vermeiden wir eine Verrechnung ohne Grundlage. Für diese Studie ist kein geeigneter Schlüssel nachgewiesen, der eine bestimmte Stornierung mit einem bestimmten Wiederholungsvorgang verbinden würde.
Auch in der Auswertung nur für A bleibt deshalb die sorgfältige Bezeichnung „reguläre Vorgänge“. Wir fassen Exemplare, Personen und Titel nicht zu eindeutigen Einheiten zusammen. Kommt dasselbe Medium in mehreren regulären Vorgängen vor, bleiben es mehrere Zeilen. Beschreibt die Einstufung eines Vorgangs in der Verwaltung sein endgültiges Ergebnis nicht genau, können wir das mit dieser Analyse nicht unabhängig korrigieren. Unser Beitrag ist, die veröffentlichte Datei nachvollziehbar zusammenzufassen. Wir rekonstruieren nicht das interne Buchungsprotokoll der Bibliothek.
Besonders wichtig ist, wie unterschiedlich vollständig die Vorgangstypen sind. Entfernt man bei A die nicht auswertbaren Kennungen, fallen etwa 0,65 % dieses Typs weg (5.883 von 911.020 Vorgängen). Bei T fallen etwa 89 % weg (651.255 von 731.076 Vorgängen). Ein Vergleich nur der vollständigen Fälle wendet deshalb in der Praxis sehr unterschiedliche Auswahlregeln an, obwohl die Formel dieselbe bleibt. Ein vertraut wirkender Prozentwert kann in die Irre führen, wenn sich seine beobachtbare Bezugsgruppe so stark verändert.
So wird die Beziehung der Kennungen berechnet
Wir gehen mit den Kennungen bewusst eng um. Leerzeichen am Anfang und Ende werden entfernt. Eine Ziffernfolge, gegebenenfalls mit der genauen Endung .0, wird als ganze Zahl in Textform dargestellt. Leere Angaben und die festgehaltenen Schreibweisen für fehlende Werte gelten als fehlend. Alle anderen Zeichenfolgen sind ungültig formatiert. Wir unterstellen nicht, dass zwei ungewöhnliche Werte dieselbe Bibliothek bezeichnen. Wir lösen zusammengesetzte Einträge nicht automatisch auf. Und wir ersetzen eine unbrauchbare Ausgabekennung nicht durch die Besitzkennung.
Bei jedem A-Vorgang mit auswertbaren Kennungen vergleichen wir die beiden bereinigten Zeichenfolgen. Sind sie gleich, liegt dieselbe Kennung vor; sind sie verschieden, liegen verschiedene Kennungen vor. Fälle mit fehlenden oder ungültig formatierten Angaben bleiben eigene Kategorien. Die wichtigste Quote teilt die beobachteten Vorgänge mit verschiedenen Kennungen durch alle A-Vorgänge, einschließlich der Fälle, deren Beziehung sich nicht bestimmen lässt. Sie ist deshalb ein ausdrücklich so benannter beobachteter Anteil. Unbekannte Fälle werden nicht stillschweigend einer bequemen Kategorie zugeschlagen.
Aus derselben Tabelle lässt sich eine zweite Quote für vollständige Kennungen berechnen: 50.080 geteilt durch die Summe aus 50.080 Fällen mit verschiedenen und 855.057 Fällen mit gleichen Kennungen. Ihre Bezugsgruppe ist kleiner. Beide Werte können nützlich sein, wenn ihre Bezeichnung eindeutig bleibt. Sie beantworten aber verschiedene Fragen. Die erste Quote sagt, welcher Anteil am gesamten Export der regulären Vorgänge beobachtet verschiedene Kennungen hat. Die zweite gilt nur unter der Bedingung, dass beide erforderlichen Kennungen auswertbar sind.
Für die obere Extremgrenze behandeln wir jeden A-Vorgang, den wir nicht einordnen können, als Fall mit verschiedenen Kennungen. Für die untere Extremgrenze zählen wir keinen dieser ungeklärten Fälle dazu. Das Intervall zeigt damit nur die rechnerische Folge dieser zwei Extremannahmen. Es ist kein Konfidenzintervall, keine Schätzung des Stichprobenfehlers und keine Vorhersage, wohin die unbekannten Angaben gehören. Fehler in Kennungen, die formal gültig aussehen, erfassen diese Grenzen ebenfalls nicht.
Die Medienart verändert den Vergleich
Die vollständige herunterladbare Tabelle enthält alle beobachteten Kategorien der Medienart. Die kompakte Abbildung zeigt die vier Kategorien mit den meisten A-Vorgängen. Wir haben sie nach der Anzahl ausgewählt, nicht nach auffälligen Abweichungsquoten. Es sind die Kategorien Buch, CD, DVD und Zeitschrift der Quelle. Diese Bezeichnungen folgen dem Export. Sie sind keine vollständige Einteilung aller Formen von Büchern und Veröffentlichungen. Auch kleine Kategorien sind in den zugänglichen Gesamttabellen enthalten.
Für Bücher enthält die Tabelle 30.681 beobachtete A-Vorgänge mit verschiedenen auswertbaren Kennungen bei insgesamt 615.833 Buchvorgängen. Für DVD sind es 10.278 bei 91.085. Die beobachteten Anteile an allen Vorgängen der jeweiligen Kategorie unterscheiden sich also. Ein höherer Anteil beweist aber weder eine schlechtere lokale Verfügbarkeit noch größere Beliebtheit, längere Transporte oder einen besseren Bestelldienst zwischen Bibliotheken. Der Export enthält weder eine Bezugszahl für den Bestand noch die Zahl der Anfragen, die nicht erfüllt werden konnten.
Es gibt mehrere denkbare Gründe, warum sich die Profile der Kategorien unterscheiden: wie der Bestand organisiert ist, ob Medien zentral gelagert werden, Ausleihregeln, Schwerpunkte einzelner Stellen oder die Art der Verwaltungscodes. Die Studie entscheidet sich für keinen dieser Gründe. Sie liefert einen prüfbaren Ausgangspunkt für Bibliotheksfachleute und Redaktionen, die die jeweiligen Abläufe direkt recherchieren können. Erklärungen sollten erst hinzukommen, wenn weitere Quellen oder eine korrekt zugeordnete Auskunft sie stützen. Die beobachtete Quote allein reicht dafür nicht.
Die Bereiche neben den Punkten der Medienarten folgen derselben Extremannahme wie die Gesamttabelle. Ein enger Bereich heißt: In dieser Kategorie haben wenige Datensätze keine auswertbare Kennungsbeziehung. Das bescheinigt dem zugrunde liegenden Angebot nicht, besonders zuverlässig zu sein. Ein weiter Bereich erlaubt umgekehrt nicht, die fehlenden Fälle durch eine besonders passende Geschichte zu ersetzen. Die Abbildung weist ausdrücklich darauf hin, dass alle ungeklärten Fälle nur für die obere Grenze als abweichend behandelt werden.
So lassen sich die Besitzprofile lesen
Die Abbildung der Besitzprofile zeigt für jede der acht auswertbaren Pankower Besitzkennungen, die bei den regulären Vorgängen vorkommen, einen Balken. Jeder Balken steht für alle erfassten A-Vorgänge dieser Kennung. Er unterteilt sie in fünf Gruppen: dieselbe Kennung, eine andere zugeordnete Pankower Ausgabekennung, einen anderen zugeordneten Bezirk, eine nicht zugeordnete Zahlenkennung und eine unbrauchbare Kennung. Die Achse zeigt die Zusammensetzung in Prozent. Sie ordnet Bibliotheken nicht nach der Qualität ihrer Leistungen.
Diese Gliederung verhindert mehrere Arten von Doppelzählung. Eine andere Pankower Stelle steht nicht zugleich im Abschnitt für andere Bezirke. Eine Zahlenkennung, die im Verzeichnis nicht zugeordnet ist, wird nicht stillschweigend als anderer Bezirk behandelt. Eine unbrauchbare Angabe wird nicht dorthin gelegt, wo sich der Balken am leichtesten erklären ließe. Der kleine ungeklärte Abschnitt gehört zum Ergebnis und bleibt in der Tabelle sichtbar. Die vollständige Zuordnung ist wichtiger als ein besonders glattes Bild.
Wer genaue Summen für einzelne Einrichtungen braucht, kann die vollständige Kreuztabelle von Besitz- und Ausgabekennung statt der zusammengefassten Balken verwenden. Bibliotheksnamen stammen nur aus dem mitgelieferten Verzeichnis, mit seinen historischen Einschränkungen. Beim Vergleich von Balken ist zu bedenken, dass sich die zugehörigen Bestände und Angebote unterscheiden. Eine Stelle mit kleinem Bestand, einer speziellen Mediengruppe oder einer besonderen Aufgabe in der Verwaltung lässt sich nicht einfach mit einer anderen gleichsetzen, nur weil beide eine Zahlenkennung haben.
Für eine Redaktion ist deshalb eine zurückhaltende Bildunterschrift am besten zu verteidigen: Die Abbildung zeigt, wie sich die A-Vorgänge jeder Besitzkennung in diesem Export auf die erfassten Ausgabekennungen verteilen. Sie zeigt nicht, wie weit eine Person gefahren ist. Linien zwischen zwei Bibliotheken auf einer Karte würden leicht einen körperlichen Weg nahelegen, den die Daten nicht belegen. Kreuztabelle und Balken vermeiden diese unbelegte Deutung.
Was gegenüber dem bestehenden öffentlichen Dashboard neu ist
Das amtliche ODIS-Dashboard für Pankow zeigt schon, dass sich öffentliche Ausleihdaten nützlich auswerten lassen. Seine sichtbaren Darstellungen für 2022 umfassen die Gesamtzahlen der Ausleihen und Verlängerungen, Medienkategorien, ausgewählte Tabellen zu Titeln und Verfassenden, Zusammenfassungen persönlicher Merkmale, die Aktivität nach Monaten und Erscheinungsjahre. Wir erkennen diese Vorarbeit ausdrücklich an. Diese Studie behauptet weder, die Pankower Daten entdeckt zu haben, noch, als Erste das Ausleihgeschehen in Pankow zu analysieren.
Unsere zusätzliche Frage gilt der Beziehung zwischen besitzender und ausgebender Kennung im Export für 2024 und der Frage, wie vollständig diese Felder je nach Vorgangstyp sind. Die bereitgestellte Kreuztabelle, der zurückhaltende Umgang mit den Kennungen und die Grenzen für ungeklärte Fälle machen diese Frage nachvollziehbar. Besonders wichtig ist, dass die Ausgabekennung bei Verlängerungen häufig fehlt. Dieser Befund begrenzt einen Vergleich, der zunächst reizvoll wirkt. Wir machen daraus keine dramatische Rangliste und keine Erklärung vermeintlicher Unterschiede im räumlichen Verhalten.
Die Untersuchung ist eine begrenzte Zweitnutzung von Verwaltungsdaten. Sie ist keine neue Befragung, keine Prüfung des Services vor Ort, keine vom Bibliotheksamt bestätigte Bewertung und kein Maß für das Verhalten einzelner Personen. Ihr Nutzen liegt darin, vor einer Aussage die passende Einheit der Verwaltung zu wählen. Eine Grafik in der Redaktion oder eine Beschreibung eines Bestands wird dadurch nachvollziehbarer: Sie kann offenlegen, welche Rolle gezählt wird und welche Aussagen mangels passender Angaben außerhalb der Analyse bleiben.
Weiterverwendung und Einordnung
Die zusammengefassten CSV-Dateien, die zugänglichen HTML-Tabellen, die Abbildungen und die Rechenanleitung sind dafür gedacht, zusammen verwendet zu werden. Wer sie weiterverwendet, behält das Beobachtungsjahr 2024, die Hauptbezugsgruppe aller A-Vorgänge, die gesonderte Warnung zur Vollständigkeit der Verlängerungen und den Unterschied zwischen abweichenden Kennungen und körperlicher Bewegung bei. Alisson Bento wird für die eigene Analyse genannt. Das Bezirksamt Pankow und die amtliche Dokumentation bleiben als ursprüngliche Datenquellen erkennbar. Die neue Auswertung ersetzt diese Rollen nicht.
Diese Veröffentlichung gibt weder die rohe Transaktionsdatei noch Angaben zu den ausleihenden Personen oder einzelne Datensätze weiter. Die Lizenz der Quelle erlaubt die Weiterverwendung der amtlichen Daten. Unnötige Offenlegung zu vermeiden bleibt trotzdem sinnvoll. Wer die Auswahl der Felder selbst wiederholen will, kann die genaue Quelle auf dem amtlichen öffentlichen Weg beziehen, die festgehaltene Prüfsumme kontrollieren und danach nur die festgelegten sechs Felder verarbeiten. Ein später verändert bereitgestellter Download wird nicht ungeprüft als gleiche Grundlage behandelt.
Eine künftige Aktualisierung könnte aussagekräftiger werden, wenn die Behörde eine verbindliche Geschichte der Versionen der Kennungen bereitstellt oder erklärt, wie Online-Verlängerungen erfasst werden. Solche Informationen würden eine datierte methodische Ergänzung rechtfertigen, keine unbemerkte Neuzuordnung unbekannter Fälle. Bis dahin lautet die genaue Schlussfolgerung: Die Datei enthält einen messbaren Unterschied zwischen dem Bestand, zu dem ein Medium gehört, und der Stelle, die es ausgibt. Das Muster fehlender Kennungen setzt zugleich eine erhebliche Grenze für räumliche Vergleiche von Verlängerungen.
Bei Verlängerungen fehlt oft die Ausgabekennung
Erfasste Beziehungen zwischen Kennungen von Einrichtungen; daraus werden keine Wege von Nutzenden und keine körperlichen Transporte abgeleitet. Erfasste Vorgänge – keine Personen, keine einzelnen Bücher, keine körperlichen Wege und keine abgeschlossene Lektüre.
Vollständige Grafik und Quelle

Diagramm seitlich scrollen, um alle Details zu sehen. ↔
Grafik und Werte
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Vorgangstyp | Beziehung der Kennungen | Vorgänge | Anteil aller Vorgänge dieses Typs (%) |
|---|---|---|---|
| Reguläre Vorgänge A | Gleiche auswertbare Kennung | 855.057 | 93,86 |
| Reguläre Vorgänge A | Verschiedene auswertbare Kennungen | 50.080 | 5,50 |
| Reguläre Vorgänge A | Fehlende erforderliche Kennung | 1 | 0,00 |
| Reguläre Vorgänge A | Erforderliche Kennung mit ungültigem Format | 5.882 | 0,65 |
| Verlängerungen T | Gleiche auswertbare Kennung | 62.442 | 8,54 |
| Verlängerungen T | Verschiedene auswertbare Kennungen | 17.379 | 2,38 |
| Verlängerungen T | Fehlende erforderliche Kennung | 649.142 | 88,79 |
| Verlängerungen T | Erforderliche Kennung mit ungültigem Format | 2.113 | 0,29 |
Erfasste Vorgänge – keine Personen, keine einzelnen Bücher, keine körperlichen Wege und keine abgeschlossene Lektüre.

Abweichende Ausgabekennungen sind je nach Medium unterschiedlich häufig
Erfasste Beziehungen zwischen Kennungen von Einrichtungen; daraus werden keine Wege von Nutzenden und keine körperlichen Transporte abgeleitet. Sandfarbener Bereich: alle ungeklärten Fälle als Abweichung gezählt; Extremgrenze, kein Konfidenzintervall.
Vollständige Grafik und Quelle
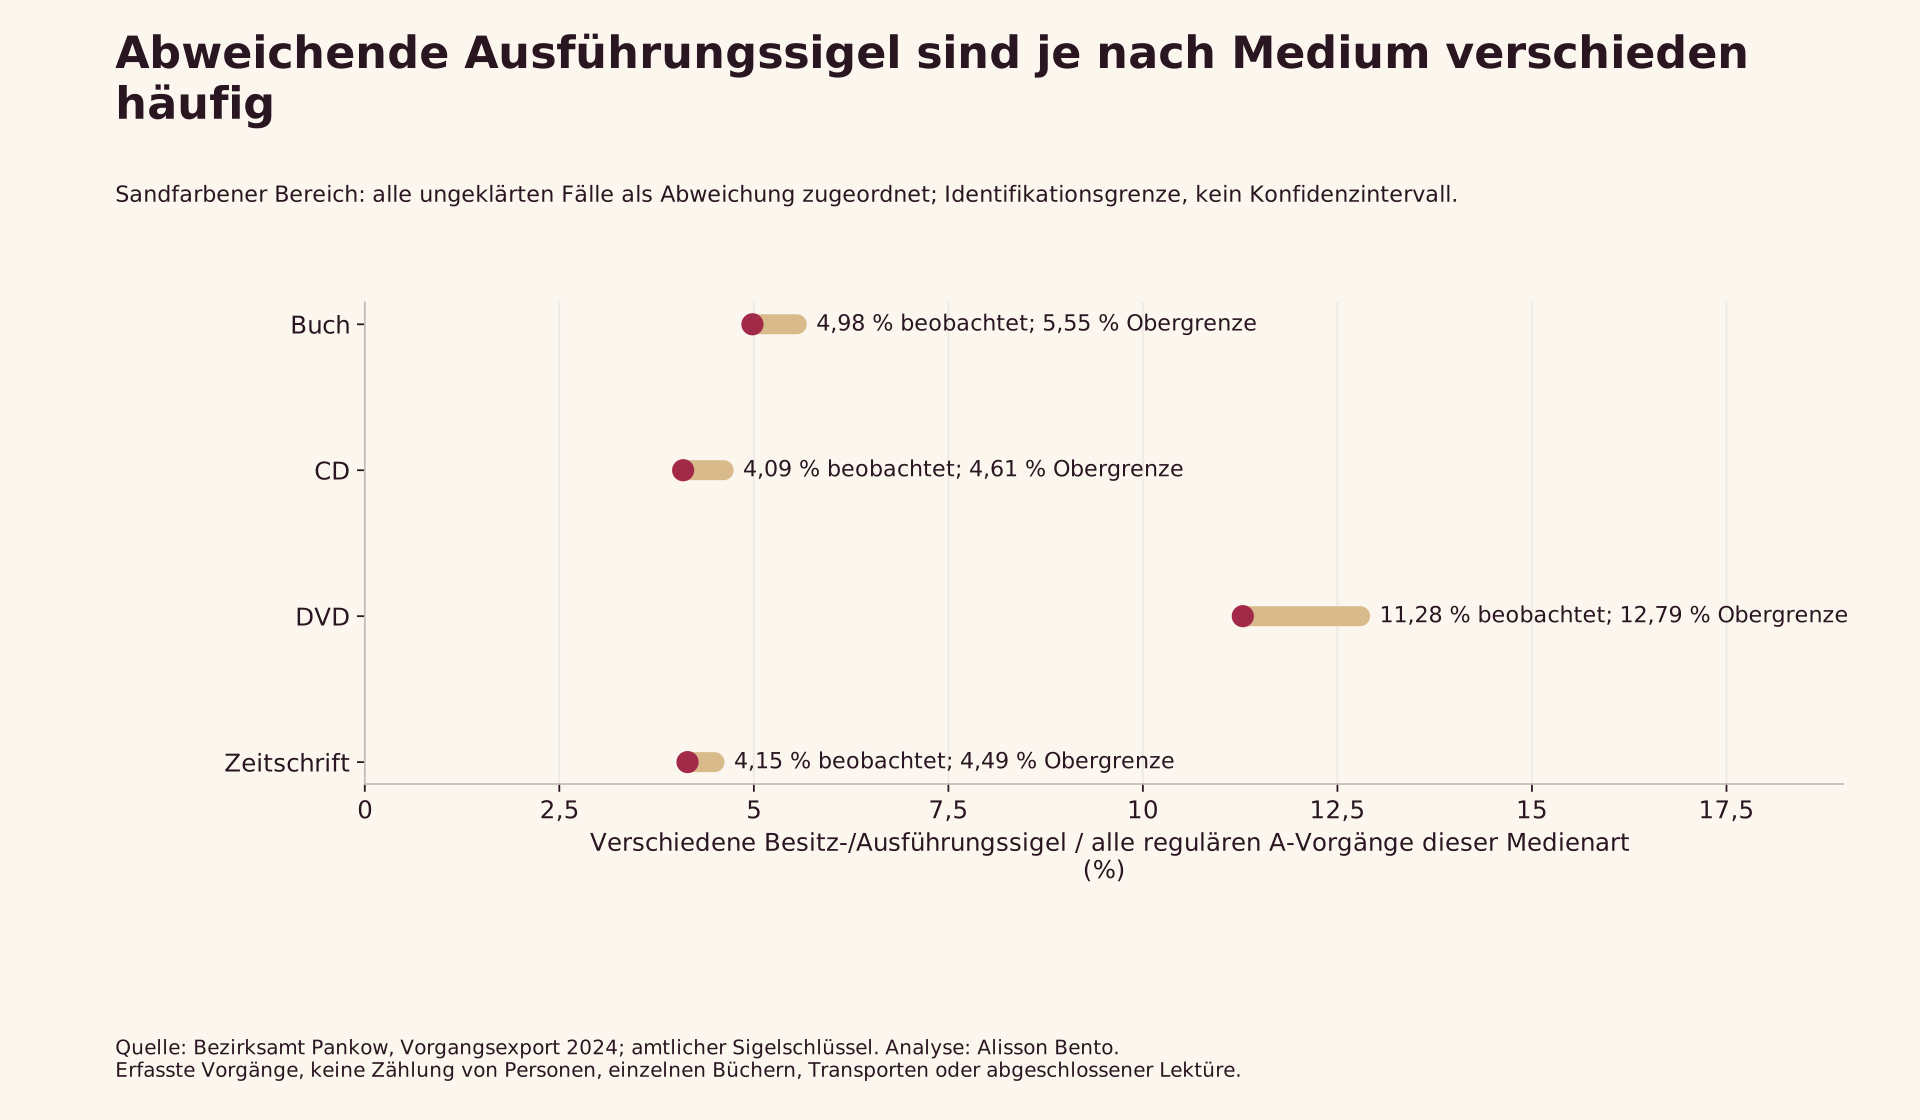
Diagramm seitlich scrollen, um alle Details zu sehen. ↔
Grafik und Werte
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Medienart in der Quelle | Vorgänge | Verschiedene auswertbare Kennungen | Anteil aller regulären A-Vorgänge der Kategorie (%) | Obergrenze bei Extremannahme (%) |
|---|---|---|---|---|
| Buch | 615.833 | 30.681 | 4,98 | 5,55 |
| CD | 111.430 | 4.559 | 4,09 | 4,61 |
| DVD | 91.085 | 10.278 | 11,28 | 12,79 |
| Zeitschrift | 42.217 | 1.751 | 4,15 | 4,49 |
Die vier Kategorien der Quelle mit den meisten regulären A-Vorgängen; die vollständigen Downloads enthalten alle Kategorien. Sandfarbener Bereich: alle ungeklärten Fälle als Abweichung gezählt; Extremgrenze, kein Konfidenzintervall. Die technischen Dateien mit zusammengefassten Werten sind auf Englisch und behalten die genauen Quellcodes, Anzahlen und Genauigkeit bei. Der begleitende Artikel und die Beschriftungen der Abbildungen liegen auf Deutsch vor.

Einen Bestand besitzen und ihn ausgeben sind verschiedene Rollen
Erfasste Beziehungen zwischen Kennungen von Einrichtungen; daraus werden keine Wege von Nutzenden und keine körperlichen Transporte abgeleitet. Erfasste Vorgänge – keine Personen, keine einzelnen Bücher, keine körperlichen Wege und keine abgeschlossene Lektüre.
Vollständige Grafik und Quelle

Diagramm seitlich scrollen, um alle Details zu sehen. ↔
Grafik und Werte
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Besitzkennung | Gleiche Kennung | Andere Pankower Kennung | Anderer zugeordneter Bezirk | Nicht zugeordnete Zahlenkennung | Unbrauchbare Kennung | Vorgänge |
|---|---|---|---|---|---|---|
| 457 | 115.909 | 5.674 | 7.979 | 27 | 1.547 | 131.136 |
| 462 | 251.991 | 3.050 | 7.000 | 333 | 1.549 | 263.923 |
| 471 | 39.728 | 1.034 | 1.555 | 22 | 319 | 42.658 |
| 650 | 112.751 | 2.971 | 3.672 | 17 | 814 | 120.225 |
| 655 | 55.232 | 521 | 1.388 | 7 | 206 | 57.354 |
| 971 | 118.262 | 2.929 | 3.240 | 29 | 639 | 125.099 |
| 972 | 52.990 | 1.387 | 1.480 | 8 | 225 | 56.090 |
| 975 | 108.194 | 2.787 | 2.954 | 16 | 583 | 114.534 |
Anzahlen regulärer A-Vorgänge nach Besitzkennung und Beziehung zur Ausgabekennung, keine Prozentwerte. Ein A-Vorgang ohne Besitzkennung fehlt in diesen acht Zeilen. Die Prozentwerte in der Grafik beziehen sich auf die Summe jeder Zeile. Erfasste Vorgänge – keine Personen, keine einzelnen Bücher, keine körperlichen Wege und keine abgeschlossene Lektüre.

Daten und Downloads
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Vorgangstyp | Beziehung der Kennungen | Vorgänge | Anteil aller Vorgänge dieses Typs (%) |
|---|---|---|---|
| Reguläre Vorgänge A | Gleiche auswertbare Kennung | 855.057 | 93,86 |
| Reguläre Vorgänge A | Verschiedene auswertbare Kennungen | 50.080 | 5,50 |
| Reguläre Vorgänge A | Fehlende erforderliche Kennung | 1 | 0,00 |
| Reguläre Vorgänge A | Erforderliche Kennung mit ungültigem Format | 5.882 | 0,65 |
| Verlängerungen T | Gleiche auswertbare Kennung | 62.442 | 8,54 |
| Verlängerungen T | Verschiedene auswertbare Kennungen | 17.379 | 2,38 |
| Verlängerungen T | Fehlende erforderliche Kennung | 649.142 | 88,79 |
| Verlängerungen T | Erforderliche Kennung mit ungültigem Format | 2.113 | 0,29 |
Erfasste Vorgänge – keine Personen, keine einzelnen Bücher, keine körperlichen Wege und keine abgeschlossene Lektüre.
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Besitzkennung | Gleiche Kennung | Andere Pankower Kennung | Anderer zugeordneter Bezirk | Nicht zugeordnete Zahlenkennung | Unbrauchbare Kennung | Vorgänge |
|---|---|---|---|---|---|---|
| 457 | 115.909 | 5.674 | 7.979 | 27 | 1.547 | 131.136 |
| 462 | 251.991 | 3.050 | 7.000 | 333 | 1.549 | 263.923 |
| 471 | 39.728 | 1.034 | 1.555 | 22 | 319 | 42.658 |
| 650 | 112.751 | 2.971 | 3.672 | 17 | 814 | 120.225 |
| 655 | 55.232 | 521 | 1.388 | 7 | 206 | 57.354 |
| 971 | 118.262 | 2.929 | 3.240 | 29 | 639 | 125.099 |
| 972 | 52.990 | 1.387 | 1.480 | 8 | 225 | 56.090 |
| 975 | 108.194 | 2.787 | 2.954 | 16 | 583 | 114.534 |
Anzahlen regulärer A-Vorgänge nach Besitzkennung und Beziehung zur Ausgabekennung, keine Prozentwerte. Ein A-Vorgang ohne Besitzkennung fehlt in diesen acht Zeilen. Die Prozentwerte in der Grafik beziehen sich auf die Summe jeder Zeile. Erfasste Vorgänge – keine Personen, keine einzelnen Bücher, keine körperlichen Wege und keine abgeschlossene Lektüre.
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Medienart in der Quelle | Vorgänge | Verschiedene auswertbare Kennungen | Anteil aller regulären A-Vorgänge der Kategorie (%) | Obergrenze bei Extremannahme (%) |
|---|---|---|---|---|
| Buch | 615.833 | 30.681 | 4,98 | 5,55 |
| CD | 111.430 | 4.559 | 4,09 | 4,61 |
| DVD | 91.085 | 10.278 | 11,28 | 12,79 |
| Zeitschrift | 42.217 | 1.751 | 4,15 | 4,49 |
Die vier Kategorien der Quelle mit den meisten regulären A-Vorgängen; die vollständigen Downloads enthalten alle Kategorien. Sandfarbener Bereich: alle ungeklärten Fälle als Abweichung gezählt; Extremgrenze, kein Konfidenzintervall. Die technischen Dateien mit zusammengefassten Werten sind auf Englisch und behalten die genauen Quellcodes, Anzahlen und Genauigkeit bei. Der begleitende Artikel und die Beschriftungen der Abbildungen liegen auf Deutsch vor.
Daten und Methode
So haben wir gerechnet
- Vor der Auswahl der Felder prüfen wir die festgehaltene amtliche CSV-Datei für 2024 anhand ihrer SHA-256-Prüfsumme. Die Dokumentation von 2023 erläutert die Felder zu Vorgang und Medium; das Portal nennt den 1. Juli 2025 als Datum der Aktualisierung.
- Wir verarbeiten nur die sechs festgelegten Felder ohne Merkmale von Personen. Fehlende, ungültig formatierte, gleiche und verschiedene Kennungen bleiben getrennt. Bei der Bereinigung entfernen wir Leerzeichen am Rand und bei Zahlenangaben nur die genaue Endung .0.
- Genaue numerische Einträge im amtlichen Schlüsselverzeichnis (Sigelschlüssel) liefern Namen und Bezirke. Zusammengesetzte oder mehrdeutige Einträge lösen wir nicht automatisch auf. Historische Namen und Vermerke zu Schließungen belegen keinen heutigen Bibliotheksbetrieb.
- Die Hauptbezugsgruppe sind alle regulären A-Vorgänge. Verlängerungen (T) werten wir getrennt aus; Stornierungen (O) und Wiederholungsvorgänge (9) bleiben in der Gesamtrechnung sichtbar. Extreme Annahmen für ungeklärte Fälle ergeben Extremgrenzen, keine Konfidenzintervalle.
Was die Daten nicht aussagen
- Ein Verwaltungsvorgang ist keine eindeutig gezählte Person und kein einzelnes Exemplar oder Werk, keine erfüllte Bestellung, keine Fahrt und keine abgeschlossene Lektüre. Der Export liefert keine geeigneten Bezugsgrößen für Bestand, Nachfrage, Kosten oder Servicequalität.
- Bei den meisten T-Verlängerungen fehlt eine auswertbare Ausgabekennung. Beschränkt man sich auf vollständige Kennungen, ist das kein repräsentativer räumlicher Vergleich aller Verlängerungen.
- Das amtliche Schlüsselverzeichnis kann historische Bezeichnungen und zusammengesetzte Einträge enthalten. Nicht zugeordnete Kennungen bleiben ungeklärt. Wir können weder die Vollständigkeit der Quelle noch interne Korrekturen von Vorgängen unabhängig bestätigen.
- Die beobachteten Rollen im Export für 2024 belegen weder, wo Nutzende wohnen, noch heutige Öffnungszeiten oder die künftige Verfügbarkeit. Das amtliche Dashboard für 2022 ist Vorarbeit; wir beanspruchen keine Erstanalyse.
Originalquellen
- Bezirksamt Pankow, Berlin Open Data: 2024 circulation export
Bezirksamt Pankow, öffentlicher Datensatz für 2022–2024; wir verwenden nur die genaue CSV-Datei für 2024. Das amtliche Portal weist CC0 aus und nennt den 1. Juli 2025 als Datum der Aktualisierung.
Abgerufen am 31. Oktober 2026
- Pankow short data documentation, 23 January 2023
Die amtliche Kurzdokumentation vom 23. Januar 2023 definiert reguläre Vorgänge (A), Verlängerungen (T), Stornierungen (O) und Wiederholungsvorgänge (9). Die Zielgruppenkategorien betreffen das Medium, nicht die ausleihende Person.
Abgerufen am 31. Oktober 2026
- Official Bibliotheks Sigel key
Das amtlich verlinkte Schlüsselverzeichnis haben wir am 31. Oktober 2026 bezogen. Genaue numerische Einträge deuten wir vorsichtig; historische Namen und zusammengesetzte Einträge belegen keine heute betriebenen Zweigstellen.
Abgerufen am 31. Oktober 2026
- ODIS public Pankow dashboard, 2022
Das öffentliche ODIS-Dashboard für Pankow beschreibt Anzahlen, Kategorien und die Aktivität nach Monaten für 2022 und wird als Vorarbeit genannt. Die begrenzte Erweiterung für 2024 beansprucht weder, die erste Analyse zu sein, noch eine amtliche Bestätigung.
Abgerufen am 31. Oktober 2026
Studie zitieren und weiterverwenden
Alisson Bento. Ein Bibliotheksbestand hat zwei Adressen: Besitz- und Ausgabekennungen in Pankows Vorgangsdaten 2024. Eigene Sekundäranalyse der offenen Daten des Bezirksamts Pankow. https://alissonbento.com/de/research/pankow-owning-issuing-library-codes-2024/
Die eigenen zusammengefassten Auswertungen und Abbildungen dürfen unter Nennung von Alisson Bento und des Bezirksamts Pankow weiterverwendet werden. Dabei müssen das Beobachtungsjahr 2024, die Bezugsgruppen der Vorgänge, die Grenzen durch fehlende Kennungen und der Hinweis erhalten bleiben, dass keine Aussagen über Transporte möglich sind. Rohdaten einzelner Vorgänge und Merkmale von Personen werden nicht weitergegeben.
Korrekturen oder redaktionelle Fragen