
Mieux voir comment les lectures parviennent aux gens
Un pourcentage de lecture numérique décrit un format. Un pourcentage d’accès gratuit décrit la façon dont une personne s’est procuré, pour l’essentiel, ce qu’elle lit. En réunissant ces deux réponses, on voit où ces deux caractéristiques se recoupent. On voit aussi des combinaisons que l’opposition simple entre numérique et papier masque : une personne peut lire dans les deux formats, recevoir ou emprunter un document numérique, ou acheter neuf une publication numérique.
Cette analyse rapproche les réponses des mêmes personnes dans le Módulo sobre Lectura (MOLEC) 2025 du Mexique. Son résultat central est un profil complet qui croise trois combinaisons de formats déclarés et les quatre modes principaux d’obtention du questionnaire. Les tableaux à télécharger gardent les dénominateurs, les effectifs de l’échantillon, les intervalles approximatifs et les indicateurs de fiabilité dont on a besoin pour lire ce profil correctement.
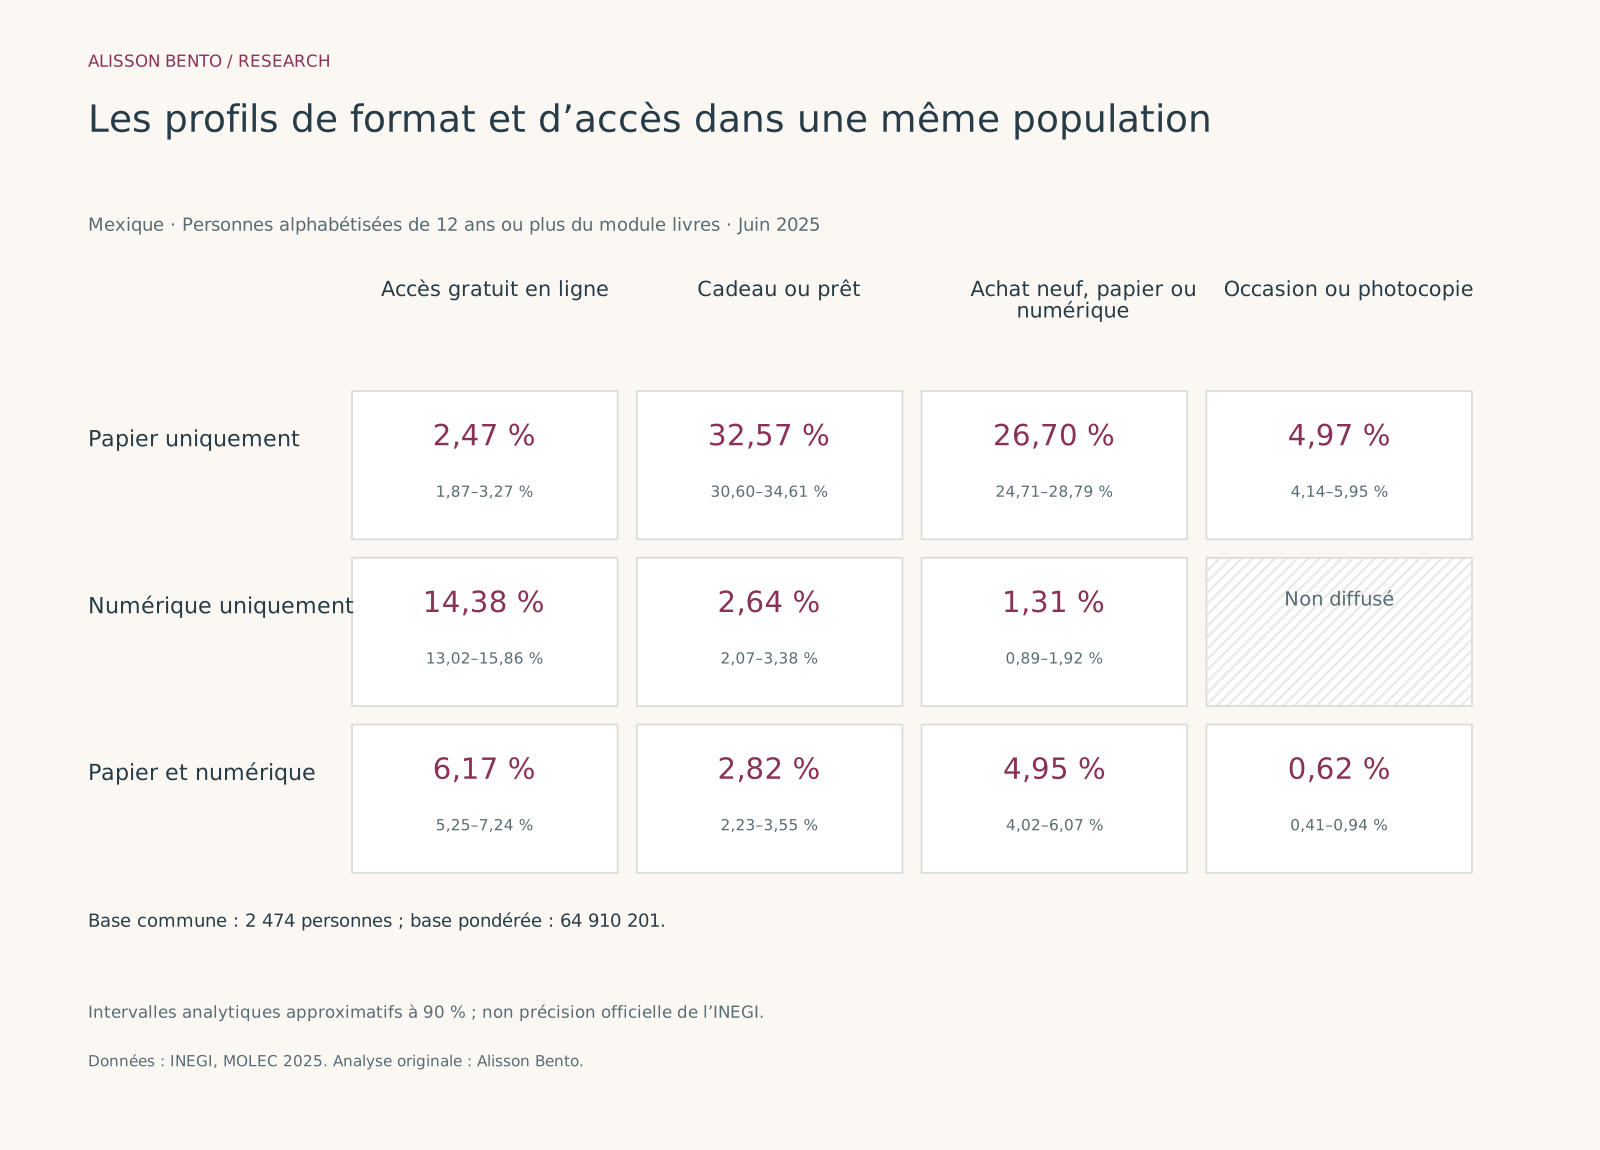
La plus grande des combinaisons mises en avant est la lecture sur papier seul, avec le cadeau ou le prêt comme mode d’obtention principal : 32,57 % de la population des lecteurs de livres admissibles, dans l’analyse pondérée. C’est une description des réponses des lecteurs. Elle ne compte pas les livres qui ont circulé, n’identifie pas les personnes ou les institutions qui les ont fournis et ne mesure pas leur valeur en argent.
Deux questions, deux dénominateurs
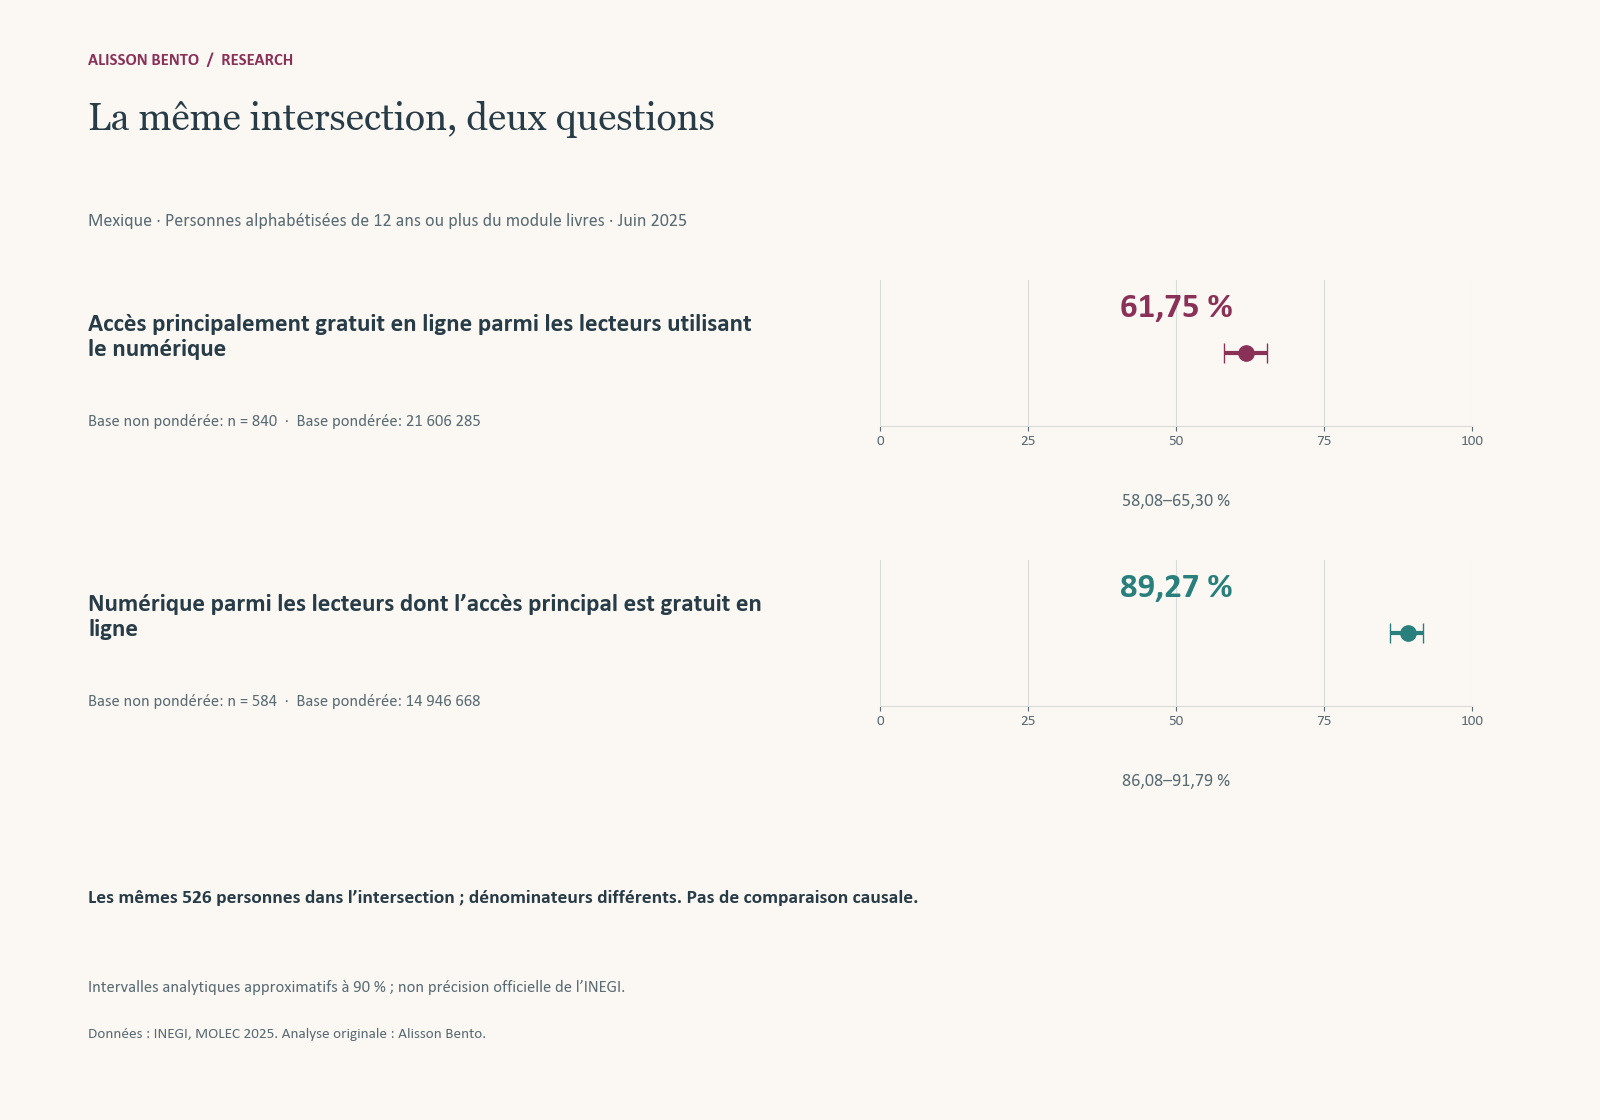
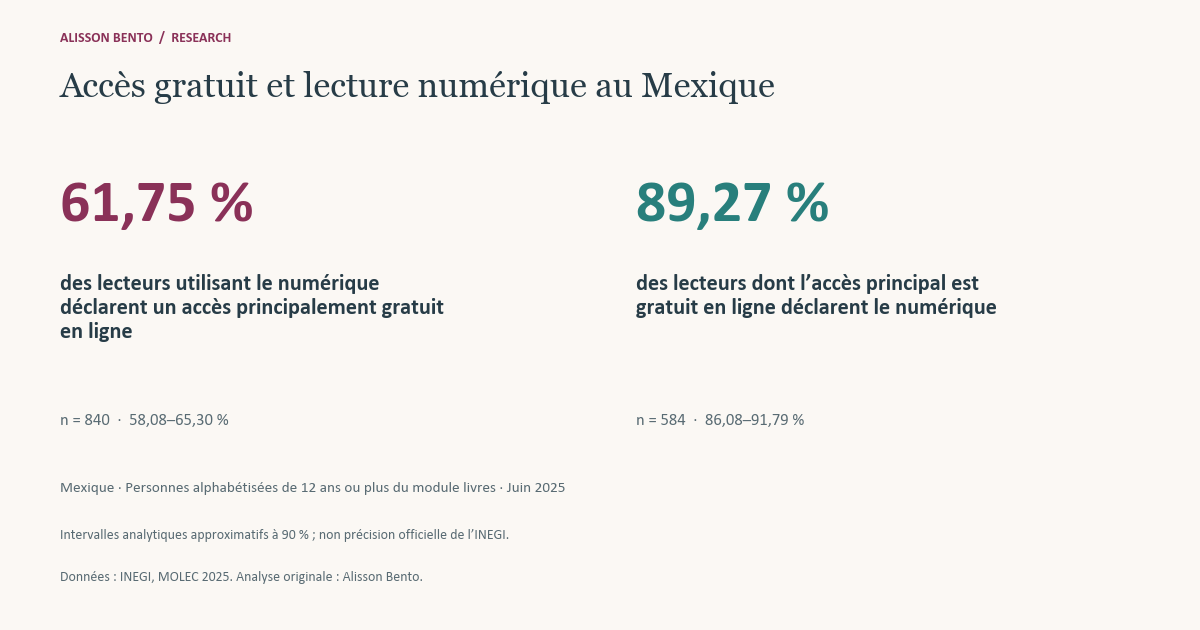
Commençons par les personnes interrogées qui ont déclaré lire dans un format numérique, y compris celles qui lisent aussi sur papier. Ce groupe compte 840 personnes interrogées et correspond à une population estimée, après pondération, de 21 606 285 personnes. Dans ce groupe, la part de celles dont le mode d’obtention principal est l’accès gratuit en ligne est de 61,75 %.
Prenons maintenant les personnes dont le mode d’obtention principal était le téléchargement gratuit ou la consultation gratuite en ligne. Ce groupe compte 584 personnes interrogées, soit une population estimée de 14 946 668 personnes. Dans ce second groupe, 89,27 % ont déclaré un format numérique. Les deux calculs comptent les mêmes 526 personnes de l’échantillon dans le recoupement, mais celui-ci est divisé par un dénominateur pondéré différent.
Ces deux estimations répondent donc à des questions différentes pour une rédaction. La première décrit les modes d’obtention parmi les lecteurs numériques. La seconde décrit les formats parmi les lecteurs qui s’appuient surtout sur l’accès gratuit en ligne. Aucune ne peut remplacer l’autre dans un titre. Les soustraire ne mesurerait ni l’effet de la lecture numérique, ni une évolution dans le temps, ni la proportion de livres distribués gratuitement.
Quels lecteurs l’analyse décrit
La collecte de MOLEC 2025 a eu lieu du 2 au 27 juin. L’enquête, remaniée, couvre l’ensemble du Mexique, zones urbaines et rurales comprises, et les résidents habituels de douze ans ou plus dans des logements privés occupés. Le domaine de la lecture de livres compte ici 2 474 personnes interrogées qui savent lire et écrire. Leurs poids finaux d’enquête les étendent à environ 64 910 201 personnes. C’est une estimation d’enquête, pas un chiffre de recensement.
L’admissibilité suit la question directe sur les livres et sa voie de vérification. Celle-ci peut faire retrouver la lecture d’un livre non terminé, d’un manuel ou d’un document après une première réponse négative. Il faut garder cette voie pour respecter la population définie par le questionnaire. Les résultats sont donc plus larges que la lecture de loisir, les livres terminés, la fiction ou la clientèle commerciale des livres.
Le fichier publié des personnes sélectionnées compte 4 240 enregistrements. Les personnes extérieures au domaine des lecteurs de livres sont gardées, avec des contributions nulles, pour le calcul de la variance du plan de travail. Cette analyse nationale ne donne aucune estimation pour Mexico, pour un État pris isolément ni pour une ville du regroupement distinct de 32 villes. Les observations restent celles de 2025, même si l’on consulte l’analyse plus tard.
Trois combinaisons de formats et quatre modes principaux d’obtention
La question sur le format enregistre séparément le numérique et le papier. Une personne peut répondre oui à l’un, à l’autre ou aux deux. Nous distinguons donc le papier seul, le numérique seul, et le papier avec le numérique. Réunir les lecteurs exclusivement numériques et ceux qui utilisent les deux formats répond à la question plus large de toute lecture numérique. On ne doit pas appeler cela de la lecture exclusivement numérique.
La question sur l’obtention accepte une seule réponse sur la façon principale dont la personne s’est procuré la plupart des livres, manuels ou documents lus. Ses quatre catégories sont : le téléchargement ou la consultation gratuite en ligne ; le cadeau ou le prêt ; l’achat de documents neufs ; et l’achat de documents d’occasion ou de photocopies. Les cadeaux et les prêts sont réunis, de même que les documents d’occasion et les photocopies. L’achat neuf comprend les publications numériques payantes.
Ces définitions évitent une décomposition tentante mais non fondée. Le groupe « cadeau ou prêt » ne peut pas devenir un total de prêts en bibliothèque. Le groupe « occasion ou photocopie » ne peut pas devenir une part de marché de l’occasion. L’accès gratuit en ligne n’identifie ni une plateforme, ni le statut juridique d’une source, ni un type particulier de service en ligne.
Comment lire le tableau croisé complet
Chaque cellule du tableau croisé a le même dénominateur : l’ensemble des lecteurs de livres admissibles. Par exemple, la cellule « papier seul, cadeau ou prêt » représente 32,57 % de cette population commune. Le tableau garde toutes les combinaisons de format et de mode d’obtention. On voit ainsi le tableau d’ensemble, au lieu de prendre deux statistiques mises en avant pour une description complète.
Le tableau complémentaire change de point de vue : il montre le mode d’obtention à l’intérieur de chaque groupe de format. Ces lignes ont des dénominateurs différents, indiqués à côté des estimations. Un pourcentage de tous les lecteurs de livres et un pourcentage parmi les lecteurs uniquement numériques répondent à des questions différentes, même si leurs intitulés citent le même mode d’obtention. Les légendes des tableaux indiquent quelle lecture s’applique.
Une combinaison de format et de mode d’obtention, trop rare, n’est pas publiée, en application de la règle de fiabilité fixée à l’avance. Son absence dans un tableau chiffré ne prouve pas que cette combinaison n’existe jamais. La source contient des réponses, mais l’analyse ne publie pas l’estimation, parce que les conditions d’effectif et de précision fixées à l’avance ne sont pas remplies. Il ne faut pas forcer les cellules arrondies à totaliser 100 % en mettant zéro dans la case vide ni en réajustant les autres sans le dire.
Un profil à part pour les lecteurs qui lisent de la littérature
Un tableau secondaire décrit les modes d’obtention principaux déclarés par les personnes qui ont dit que leurs lectures comprenaient de la littérature : romans, nouvelles, science-fiction ou poésie. Parmi ces 1 048 personnes interrogées, 40,03 % ont déclaré l’achat neuf comme mode principal pour les lectures couvertes par la partie du questionnaire sur les livres. Le tableau garde le profil correspondant pour les lecteurs qui n’ont pas déclaré de littérature.
Cette comparaison reste au niveau de la personne. Une personne peut déclarer plusieurs sortes de livres, alors que la réponse sur l’obtention porte sur le mode principal pour l’ensemble des lectures. Le questionnaire ne relie aucun roman en particulier à un achat, un cadeau, un prêt ou un téléchargement gratuit. Il serait donc inexact de présenter 40,03 % comme la part des livres littéraires achetés neufs.
Pour les éditeurs et les organisations de lecture, ce profil donne un contexte pour comprendre les lecteurs au-delà d’un seul circuit de vente. Il ne peut pas fournir de volumes de vente, de taux de conversion de clients, de revenus d’auteurs ni l’effet d’un programme de diffusion. Ces questions demandent d’autres observations et, parfois, un autre type d’étude.
Ce que fait le calcul
Les estimations sont des rapports de sommes du poids final de la personne sélectionnée (variable FAC_ELE). Le numérateur additionne les poids des personnes qui ont la combinaison indiquée. Le dénominateur additionne les poids de la population nommée sur la ligne. Nous n’avons pas remplacé les poids des personnes par des poids de ménage. Tous les champs principaux viennent du même tableau des personnes sélectionnées : aucune jointure avec les ménages n’est nécessaire pour construire le recoupement.
Avant de calculer les nouvelles estimations croisées, les règles de l’analyse ont fixé la population, le codage des catégories, les dénominateurs, les méthodes d’incertitude et les seuils de publication des chiffres. Les marges de la source et du questionnaire étaient déjà connues à ce stade : ce n’était pas une expérience en aveugle. L’analyse reproduit sept pourcentages de marge publiés, à leur arrondi affiché, et rapproche le profil croisé de l’ensemble des personnes admissibles.
Les fichiers publics fournissent des résultats agrégés et une méthode de calcul hors ligne. Ils ne redistribuent ni les lignes des personnes interrogées, ni les clés d’identification, ni les réponses libres. La reproduction part du fichier source officiel obtenu séparément, avec son empreinte enregistrée. Une autre version de la source ne peut donc pas entrer dans le calcul sans qu’on s’en aperçoive.
Ce que couvrent les intervalles approximatifs
Le calcul d’incertitude s’appuie sur une approximation de travail du plan d’enquête : les poids finaux sont considérés comme fixes, et l’on garde les strates et les unités primaires de sondage publiées. L’ensemble complet compte 99 strates et 1 201 unités primaires de sondage. Une strate n’a qu’une seule unité observée. Sa contribution à la variance ne peut donc pas être estimée avec la formule habituelle à l’intérieur d’une strate.
Le calcul principal applique une correction documentée pour cette strate à unité unique. Des résultats de sensibilité distincts utilisent une contribution moyenne des strates estimables, puis un test de robustesse où la contribution de cette strate est nulle. Ce dernier ne prouve pas que l’unité ait été tirée avec certitude. Ces variantes rendent l’hypothèse visible. Elles ne forment pas des bornes qui prouveraient que tous les modèles d’incertitude plausibles sont couverts.
Les intervalles affichés sont des intervalles approximatifs à 90 %, calculés par formule sur l’échelle logit pour les proportions qui ne sont pas aux extrêmes. Pour l’estimation de 61,75 %, l’intervalle principal est de 58,08–65,30 %. Pour 89,27 %, il est de 86,08–91,79 %. Ce ne sont pas des mesures de précision officielles de l’INEGI, ni une reconstitution exacte d’une variance qui tiendrait compte du calage. L’incertitude liée à la construction des poids et les corrections de population finie ne sont pas reconstituées. Ces intervalles ne couvrent pas toutes les erreurs de déclaration, de mémoire ou de non-réponse.
Pourquoi certaines estimations ne sont pas publiées
La règle de publication fixée à l’avance exige trois choses : un dénominateur non pondéré d’au moins 100 personnes interrogées ; au moins vingt réponses à la fois dans le numérateur et dans son complément ; et un coefficient de variation principal d’au plus 30 %. Les proportions proches des bornes demandent aussi de la prudence, pour ne pas afficher un intervalle de largeur nulle, qui serait trompeur. Une grande population estimée ne remplace pas un échantillon observé suffisant.
Sur les 34 estimations prévues, 32 sont publiées en chiffres et deux ne le sont pas. Ces deux estimations décrivent la même combinaison rare de format et de mode d’obtention, avec des dénominateurs différents. C’est une décision de fiabilité analytique. Elle ne prouve pas que la source ait été formellement anonymisée, ni que chaque usage futur protégera la confidentialité.
Aucune valeur p, aucun test de significativité, aucun effet causal n’est présenté. Il ne faut pas déclarer l’écart entre deux cellules d’un tableau statistiquement significatif simplement parce que leurs intervalles séparés se chevauchent ou non. L’analyse fournit une référence descriptive, avec des choix d’incertitude explicites. Elle ne classe ni des modes d’obtention meilleurs, ni des types de lecteurs meilleurs.
Utiliser les résultats comme source
Une citation brève doit garder la population, l’année d’observation et le dénominateur. Par exemple : « Dans une analyse des microdonnées MOLEC 2025 de l’INEGI, 61,75 % des lecteurs de livres de douze ans ou plus qui savent lire et écrire et qui ont déclaré un format numérique ont indiqué l’accès gratuit en ligne comme mode d’obtention principal. » Si vous ajoutez un intervalle, présentez-le comme un intervalle approximatif calculé selon le plan de travail décrit dans cette étude.
L’INEGI publie déjà des marges importantes sur l’obtention et des tableaux croisés par caractéristiques, comme le sexe, le motif de lecture et la fréquence. L’apport de cette analyse est le profil croisé format–obtention pour les mêmes personnes, ses deux questions conditionnelles inverses et le traitement reproductible de l’incertitude. Cette lecture limitée des travaux antérieurs n’établit pas que personne n’a jamais examiné une question semblable.
Citez l’INEGI pour les données sources et Alisson Bento pour l’analyse et les graphiques originaux. Le texte et les graphiques originaux peuvent être réutilisés sous licence CC BY 4.0, et le code original sous licence MIT, en conservant la mention de l’auteur. Ces licences ne remplacent pas les conditions de libre utilisation de l’INEGI. L’analyse et les transformations sont un travail indépendant, et n’impliquent aucune approbation de l’INEGI.
Un même recoupement, deux questions différentes
Accès principalement gratuit en ligne parmi les lecteurs d’un format numérique quelconque : 61,75 %. Format numérique parmi les lecteurs dont l’accès principal est gratuit en ligne : 89,27 %. Les mêmes 526 personnes interrogées forment le recoupement ; les dénominateurs sont différents. Aucune comparaison causale. Intervalles approximatifs à 90 % ; pas une précision officielle de l’INEGI.
Graphique complet et source

Faites défiler le graphique horizontalement pour le consulter. ↔
Graphique et valeurs
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Question conditionnelle | Part pondérée (%) | Borne basse · intervalle approximatif à 90 % (%) | Borne haute · intervalle approximatif à 90 % (%) | Personnes interrogées dans le dénominateur | Dénominateur pondéré | Personnes interrogées dans la cellule |
|---|---|---|---|---|---|---|
| Format numérique parmi les lecteurs dont l’accès principal est gratuit en ligne | 89,27 | 86,08 | 91,79 | 584 | 14 946 668 | 526 |
| Accès principalement gratuit en ligne parmi les lecteurs qui utilisent un format numérique | 61,75 | 58,08 | 65,30 | 840 | 21 606 285 | 526 |
Les mêmes 526 personnes de l’échantillon entrent dans les deux numérateurs ; des dénominateurs pondérés différents donnent des estimations différentes. Les mêmes 526 personnes interrogées forment le recoupement ; les dénominateurs sont différents. Aucune comparaison causale. Intervalles approximatifs à 90 % ; pas une précision officielle de l’INEGI.
Télécharger le graphique (SVG) ↓ · Télécharger le graphique (PNG) ↓
Où les formats de lecture et les modes d’obtention se croisent
Où les formats de lecture et les modes d’obtention se croisent. Base commune : 2 474 personnes interrogées ; population estimée : 64 910 201. Intervalles approximatifs à 90 % ; pas une précision officielle de l’INEGI. Non publié : règle de fiabilité analytique.
Graphique complet et source
Faites défiler le graphique horizontalement pour le consulter. ↔
Graphique et valeurs
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Format déclaré | Mode d’obtention principal | Part pondérée (%) | Borne basse · intervalle approximatif à 90 % (%) | Borne haute · intervalle approximatif à 90 % (%) | Personnes interrogées dans le dénominateur | Personnes interrogées dans la cellule |
|---|---|---|---|---|---|---|
| Papier seul | Accès gratuit en ligne | 2,47 | 1,87 | 3,27 | 2 474 | 58 |
| Papier seul | Cadeau ou prêt | 32,57 | 30,60 | 34,61 | 2 474 | 777 |
| Papier seul | Achat neuf | 26,70 | 24,71 | 28,79 | 2 474 | 670 |
| Papier seul | Occasion ou photocopie | 4,97 | 4,14 | 5,95 | 2 474 | 129 |
| Numérique seul | Accès gratuit en ligne | 14,38 | 13,02 | 15,86 | 2 474 | 360 |
| Numérique seul | Cadeau ou prêt | 2,64 | 2,07 | 3,38 | 2 474 | 61 |
| Numérique seul | Achat neuf | 1,31 | 0,89 | 1,92 | 2 474 | 35 |
| Numérique seul | Occasion ou photocopie | Non publié | — | — | 2 474 | <20 |
| Papier et numérique | Accès gratuit en ligne | 6,17 | 5,25 | 7,24 | 2 474 | 166 |
| Papier et numérique | Cadeau ou prêt | 2,82 | 2,23 | 3,55 | 2 474 | 78 |
| Papier et numérique | Achat neuf | 4,95 | 4,02 | 6,07 | 2 474 | 110 |
| Papier et numérique | Occasion ou photocopie | 0,62 | 0,41 | 0,94 | 2 474 | 20 |
Un seul dénominateur commun : les 2 474 lecteurs de livres admissibles. Une cellule non publiée n’est pas égale à zéro. Les intervalles sont des résultats approximatifs du plan de travail. Base commune : 2 474 personnes interrogées ; population estimée : 64 910 201. Intervalles approximatifs à 90 % ; pas une précision officielle de l’INEGI.
Télécharger le graphique (SVG) ↓ · Télécharger le graphique (PNG) ↓

Le profil d’obtention change avec le dénominateur
Le profil d’obtention change avec le dénominateur. Intervalles approximatifs à 90 % ; pas une précision officielle de l’INEGI. Non publié : règle de fiabilité analytique.
Graphique complet et source

Faites défiler le graphique horizontalement pour le consulter. ↔
Graphique et valeurs
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Format déclaré | Mode d’obtention principal | Part pondérée (%) | Borne basse · intervalle approximatif à 90 % (%) | Borne haute · intervalle approximatif à 90 % (%) | Personnes interrogées dans le dénominateur | Personnes interrogées dans la cellule |
|---|---|---|---|---|---|---|
| Papier seul | Accès gratuit en ligne | 3,70 | 2,80 | 4,88 | 1 634 | 58 |
| Papier seul | Cadeau ou prêt | 48,83 | 46,11 | 51,54 | 1 634 | 777 |
| Papier seul | Achat neuf | 40,02 | 37,21 | 42,91 | 1 634 | 670 |
| Papier seul | Occasion ou photocopie | 7,45 | 6,22 | 8,89 | 1 634 | 129 |
| Numérique seul | Accès gratuit en ligne | 76,79 | 72,48 | 80,60 | 466 | 360 |
| Numérique seul | Cadeau ou prêt | 14,11 | 11,16 | 17,70 | 466 | 61 |
| Numérique seul | Achat neuf | 6,99 | 4,83 | 10,03 | 466 | 35 |
| Numérique seul | Occasion ou photocopie | Non publié | — | — | 466 | <20 |
| Papier et numérique | Accès gratuit en ligne | 42,41 | 37,07 | 47,93 | 374 | 166 |
| Papier et numérique | Cadeau ou prêt | 19,35 | 15,46 | 23,94 | 374 | 78 |
| Papier et numérique | Achat neuf | 33,99 | 28,61 | 39,82 | 374 | 110 |
| Papier et numérique | Occasion ou photocopie | 4,26 | 2,79 | 6,46 | 374 | 20 |
Chaque groupe de format a son propre dénominateur. Les catégories d’obtention regroupées suivent le questionnaire. Les cellules non publiées ne sont pas réajustées sans le dire. Intervalles approximatifs à 90 % ; pas une précision officielle de l’INEGI.
Télécharger le graphique (SVG) ↓ · Télécharger le graphique (PNG) ↓

Carte à partager et à réutiliser
Accès principalement gratuit en ligne parmi les lecteurs d’un format numérique quelconque : 61,75 %. Format numérique parmi les lecteurs dont l’accès principal est gratuit en ligne : 89,27 %. Les mêmes 526 personnes interrogées forment le recoupement ; les dénominateurs sont différents. Aucune comparaison causale. Intervalles approximatifs à 90 % ; pas une précision officielle de l’INEGI.
Graphique complet et source

Faites défiler le graphique horizontalement pour le consulter. ↔
Graphique et valeurs
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Question conditionnelle | Part pondérée (%) | Borne basse · intervalle approximatif à 90 % (%) | Borne haute · intervalle approximatif à 90 % (%) | Personnes interrogées dans le dénominateur | Dénominateur pondéré | Personnes interrogées dans la cellule |
|---|---|---|---|---|---|---|
| Format numérique parmi les lecteurs dont l’accès principal est gratuit en ligne | 89,27 | 86,08 | 91,79 | 584 | 14 946 668 | 526 |
| Accès principalement gratuit en ligne parmi les lecteurs qui utilisent un format numérique | 61,75 | 58,08 | 65,30 | 840 | 21 606 285 | 526 |
Les mêmes 526 personnes de l’échantillon entrent dans les deux numérateurs ; des dénominateurs pondérés différents donnent des estimations différentes. Les mêmes 526 personnes interrogées forment le recoupement ; les dénominateurs sont différents. Aucune comparaison causale. Intervalles approximatifs à 90 % ; pas une précision officielle de l’INEGI.
Télécharger le graphique (SVG) ↓ · Télécharger le graphique (PNG) ↓
Données et téléchargements
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Format déclaré | Mode d’obtention principal | Part pondérée (%) | Borne basse · intervalle approximatif à 90 % (%) | Borne haute · intervalle approximatif à 90 % (%) | Personnes interrogées dans le dénominateur | Personnes interrogées dans la cellule |
|---|---|---|---|---|---|---|
| Papier seul | Accès gratuit en ligne | 2,47 | 1,87 | 3,27 | 2 474 | 58 |
| Papier seul | Cadeau ou prêt | 32,57 | 30,60 | 34,61 | 2 474 | 777 |
| Papier seul | Achat neuf | 26,70 | 24,71 | 28,79 | 2 474 | 670 |
| Papier seul | Occasion ou photocopie | 4,97 | 4,14 | 5,95 | 2 474 | 129 |
| Numérique seul | Accès gratuit en ligne | 14,38 | 13,02 | 15,86 | 2 474 | 360 |
| Numérique seul | Cadeau ou prêt | 2,64 | 2,07 | 3,38 | 2 474 | 61 |
| Numérique seul | Achat neuf | 1,31 | 0,89 | 1,92 | 2 474 | 35 |
| Numérique seul | Occasion ou photocopie | Non publié | — | — | 2 474 | <20 |
| Papier et numérique | Accès gratuit en ligne | 6,17 | 5,25 | 7,24 | 2 474 | 166 |
| Papier et numérique | Cadeau ou prêt | 2,82 | 2,23 | 3,55 | 2 474 | 78 |
| Papier et numérique | Achat neuf | 4,95 | 4,02 | 6,07 | 2 474 | 110 |
| Papier et numérique | Occasion ou photocopie | 0,62 | 0,41 | 0,94 | 2 474 | 20 |
Un seul dénominateur commun : les 2 474 lecteurs de livres admissibles. Une cellule non publiée n’est pas égale à zéro. Les intervalles sont des résultats approximatifs du plan de travail. Base commune : 2 474 personnes interrogées ; population estimée : 64 910 201. Intervalles approximatifs à 90 % ; pas une précision officielle de l’INEGI.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Format déclaré | Mode d’obtention principal | Part pondérée (%) | Borne basse · intervalle approximatif à 90 % (%) | Borne haute · intervalle approximatif à 90 % (%) | Personnes interrogées dans le dénominateur | Personnes interrogées dans la cellule |
|---|---|---|---|---|---|---|
| Papier seul | Accès gratuit en ligne | 3,70 | 2,80 | 4,88 | 1 634 | 58 |
| Papier seul | Cadeau ou prêt | 48,83 | 46,11 | 51,54 | 1 634 | 777 |
| Papier seul | Achat neuf | 40,02 | 37,21 | 42,91 | 1 634 | 670 |
| Papier seul | Occasion ou photocopie | 7,45 | 6,22 | 8,89 | 1 634 | 129 |
| Numérique seul | Accès gratuit en ligne | 76,79 | 72,48 | 80,60 | 466 | 360 |
| Numérique seul | Cadeau ou prêt | 14,11 | 11,16 | 17,70 | 466 | 61 |
| Numérique seul | Achat neuf | 6,99 | 4,83 | 10,03 | 466 | 35 |
| Numérique seul | Occasion ou photocopie | Non publié | — | — | 466 | <20 |
| Papier et numérique | Accès gratuit en ligne | 42,41 | 37,07 | 47,93 | 374 | 166 |
| Papier et numérique | Cadeau ou prêt | 19,35 | 15,46 | 23,94 | 374 | 78 |
| Papier et numérique | Achat neuf | 33,99 | 28,61 | 39,82 | 374 | 110 |
| Papier et numérique | Occasion ou photocopie | 4,26 | 2,79 | 6,46 | 374 | 20 |
Chaque groupe de format a son propre dénominateur. Les catégories d’obtention regroupées suivent le questionnaire. Les cellules non publiées ne sont pas réajustées sans le dire. Intervalles approximatifs à 90 % ; pas une précision officielle de l’INEGI.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Question conditionnelle | Part pondérée (%) | Borne basse · intervalle approximatif à 90 % (%) | Borne haute · intervalle approximatif à 90 % (%) | Personnes interrogées dans le dénominateur | Dénominateur pondéré | Personnes interrogées dans la cellule |
|---|---|---|---|---|---|---|
| Format numérique parmi les lecteurs dont l’accès principal est gratuit en ligne | 89,27 | 86,08 | 91,79 | 584 | 14 946 668 | 526 |
| Accès principalement gratuit en ligne parmi les lecteurs qui utilisent un format numérique | 61,75 | 58,08 | 65,30 | 840 | 21 606 285 | 526 |
Les mêmes 526 personnes de l’échantillon entrent dans les deux numérateurs ; des dénominateurs pondérés différents donnent des estimations différentes. Les mêmes 526 personnes interrogées forment le recoupement ; les dénominateurs sont différents. Aucune comparaison causale. Intervalles approximatifs à 90 % ; pas une précision officielle de l’INEGI.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Littérature déclarée | Mode d’obtention principal | Part pondérée (%) | Borne basse · intervalle approximatif à 90 % (%) | Borne haute · intervalle approximatif à 90 % (%) | Personnes interrogées dans le dénominateur |
|---|---|---|---|---|---|
| Littérature déclarée | Accès gratuit en ligne | 20,62 | 18,24 | 23,22 | 1 048 |
| Littérature déclarée | Cadeau ou prêt | 32,80 | 29,85 | 35,90 | 1 048 |
| Littérature déclarée | Achat neuf | 40,03 | 36,92 | 43,23 | 1 048 |
| Littérature déclarée | Occasion ou photocopie | 6,55 | 5,24 | 8,15 | 1 048 |
| Littérature non déclarée | Accès gratuit en ligne | 24,85 | 22,53 | 27,33 | 1 426 |
| Littérature non déclarée | Cadeau ou prêt | 41,99 | 39,20 | 44,84 | 1 426 |
| Littérature non déclarée | Achat neuf | 27,61 | 25,09 | 30,27 | 1 426 |
| Littérature non déclarée | Occasion ou photocopie | 5,56 | 4,41 | 6,98 | 1 426 |
Profils au niveau des personnes uniquement. Aucun mode d’obtention n’est relié à un titre littéraire précis. Intervalles approximatifs à 90 % ; pas une précision officielle de l’INEGI.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Indicateur de la source | Valeur reproduite (%) | Valeur affichée par la source (%) |
|---|---|---|
| Accès gratuit en ligne | 23,03 | 23,0 |
| Cadeau ou prêt | 38,03 | 38,0 |
| Achat neuf | 32,96 | 33,0 |
| Occasion ou photocopie | 5,98 | 6,0 |
| Au moins un format numérique | 33,29 | 33,3 |
| Au moins un format papier | 81,27 | 81,3 |
| Littérature déclarée | 43,07 | 43,1 |
Reproduit à l’arrondi affiché par la source. Ces contrôles ne sont ni de nouveaux résultats croisés, ni des estimations d’incertitude officielles.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Question conditionnelle | Méthode pour la strate à unité unique | Erreur-type (points de pourcentage) | Borne basse · intervalle approximatif à 90 % (%) | Borne haute · intervalle approximatif à 90 % (%) |
|---|---|---|---|---|
| Format numérique parmi les lecteurs dont l’accès principal est gratuit en ligne | Correction pour strate à unité unique (méthode principale) | 1,7252 | 86,08 | 91,79 |
| Format numérique parmi les lecteurs dont l’accès principal est gratuit en ligne | Contribution moyenne des strates (sensibilité) | 1,7340 | 86,06 | 91,80 |
| Format numérique parmi les lecteurs dont l’accès principal est gratuit en ligne | Contribution nulle de la strate à unité unique (test de robustesse ; tirage avec certitude non vérifié) | 1,7252 | 86,08 | 91,79 |
| Accès principalement gratuit en ligne parmi les lecteurs qui utilisent un format numérique | Correction pour strate à unité unique (méthode principale) | 2,1975 | 58,08 | 65,30 |
| Accès principalement gratuit en ligne parmi les lecteurs qui utilisent un format numérique | Contribution moyenne des strates (sensibilité) | 2,2082 | 58,06 | 65,31 |
| Accès principalement gratuit en ligne parmi les lecteurs qui utilisent un format numérique | Contribution nulle de la strate à unité unique (test de robustesse ; tirage avec certitude non vérifié) | 2,1971 | 58,08 | 65,30 |
Intervalles approximatifs à 90 % selon trois conventions explicites. L’option à contribution nulle ne prouve pas un tirage avec certitude. Intervalles approximatifs à 90 % ; pas une précision officielle de l’INEGI.
Données et méthode
Notre méthode de calcul
- Nous utilisons le fichier officiel figé des personnes sélectionnées de MOLEC 2025. Nous gardons le filtre d’alphabétisation et les deux voies de repérage des livres. Sur la même ligne, nous associons les réponses sur le format (question P 5, numérique et papier) à l’unique réponse sur le mode d’obtention principal (question P 10).
- Nous calculons les ratios avec les poids finaux des personnes (variable FAC_ELE). Nous gardons les 4 240 enregistrements de l’échantillon, ainsi que les 99 strates et les 1 201 unités primaires de sondage d’origine pour la variance, avec des scores nuls en dehors de chaque domaine.
- Nous présentons une approximation par grappes ultimes avec remise, à poids finaux fixes. La méthode principale applique la correction pour strate à unité unique. Les variantes à contribution moyenne et à contribution nulle sont présentées à part, comme sensibilités. Nous n’avons ni précision officielle tenant compte du calage, ni vérification d’un tirage avec certitude.
- Nous utilisons des intervalles approximatifs à 90 %, fixés à l’avance, calculés par la méthode delta sur l’échelle logit. Nous ne publions une estimation que si le dénominateur, les effectifs de la cellule et de son complément et le coefficient de variation principal respectent la règle énoncée. Nous gardons les cellules non publiées et tous les dénominateurs.
Ce que les données ne permettent pas de conclure
- Ce sont des réponses de personnes sur le passé, qui portent sur le mode d’obtention principal des livres, manuels ou documents. Elles ne sont reliées à aucun exemplaire, titre, transaction ou genre précis.
- Cadeau/prêt et occasion/photocopie restent des catégories regroupées. L’accès gratuit en ligne n’indique ni le statut juridique, ni une plateforme ou un service de bibliothèque particulier.
- Le domaine est national : lecteurs qui savent lire et écrire, de 12 ans ou plus, en logement privé, en juin 2025. Nous ne donnons aucune estimation par ville ou par État, et nous n’avançons ni lien de cause, ni tendance historique, ni total de ventes, ni estimation d’économies, ni comparaison de la qualité des lectures.
- Les intervalles sont des résultats approximatifs d’un plan de travail, pas une incertitude officielle de l’INEGI. Le calage, la correction de population finie et l’incertitude de la construction des poids finaux ne sont pas reconstitués. Les erreurs qui ne tiennent pas à l’échantillonnage subsistent.
- Les sensibilités pour la strate à unité unique ne prouvent ni un tirage avec certitude, ni une variance sans biais pour cette strate, ni une couverture garantie, ni une robustesse complète.
Sources originales
- Official public selected-person microdata ZIP
Microdonnées officielles des personnes sélectionnées : TMOLEC, poids finaux FAC_ELE et champs du plan d’enquête publiés. L’empreinte du fichier source figé est notée dans le registre à télécharger ; les lignes des personnes interrogées ne sont pas redistribuées.
Consulté le 28 octobre 2026
- MOLEC 2025 file descriptor
Le descripteur officiel du fichier définit les indicateurs de format, la réponse sur le mode d’obtention principal, le filtre d’alphabétisation et les champs du plan d’enquête utilisés dans cette analyse.
Consulté le 28 octobre 2026
- MOLEC 2025 questionnaire
Le questionnaire définit les voies directe et de vérification pour les livres, y compris les manuels et les documents, ainsi que les catégories regroupées cadeau/prêt et occasion/photocopie.
Consulté le 28 octobre 2026
- MOLEC 2025 results
Le rapport officiel de résultats fournit des marges et des tableaux croisés déjà publiés. Les nouvelles estimations croisées format–obtention et les intervalles de cette étude sont des transformations indépendantes, pas des tableaux officiels de l’INEGI.
Consulté le 28 octobre 2026
- MOLEC 2025 RNM metadata
Les métadonnées RNM indiquent la population cible nationale, urbaine et rurale, de 12 ans ou plus, la collecte du 2 au 27 juin 2025 et la version de la source. Les dates d’observation sont distinctes de la date de publication de cet article.
Consulté le 28 octobre 2026
- MOLEC 2025 sample design
Le document de l’INEGI sur le plan d’échantillonnage décrit la pondération, le calage et les calculs par grappes ultimes. Cette analyse emploie un plan de travail explicitement approximatif, à poids finaux fixes, et ne reconstitue pas la précision officielle.
Consulté le 1 novembre 2026
- INEGI free-use terms
Les conditions de libre utilisation de l’INEGI exigent de citer la source, de conserver les métadonnées, d’indiquer clairement les transformations et de ne rien laisser entendre sur une approbation. Les droits d’origine de la source restent en vigueur.
Consulté le 1 novembre 2026
- Primary survey package documentation, version 4.5
La documentation du paquet logiciel « survey » (version 4.5) éclaire les conventions retenues pour les strates à unité unique et les domaines. Elle ne donne pas la précision officielle de MOLEC. Son code source et son manuel ne sont pas redistribués.
Consulté le 1 novembre 2026
Citer et réutiliser cette étude
Alisson Bento. 2026. Comment l’accès gratuit se recoupe avec la lecture de livres imprimés et numériques au Mexique. Analyse originale des microdonnées MOLEC 2025 de l’INEGI. https://alissonbento.com/fr/research/mexico-book-format-main-access-2025/
Source : INEGI. Módulo sobre Lectura (MOLEC) 2025. Bases de datos. Analyse, texte et graphiques originaux : Alisson Bento, CC BY 4.0 ; code original : MIT. La source d’origine reste soumise aux conditions de libre utilisation de l’INEGI. Aucune approbation de l’INEGI n’est sous-entendue.
Corrections ou questions éditoriales