
Un total de lecture ne révèle pas la forme de la journée
Deux journées consignées dans des carnets peuvent comporter autant de lecture d’intérêt personnel tout en l’organisant différemment. L’une peut réunir tout le temps codé en lecture ; l’autre peut le répartir entre des périodes séparées par d’autres codes d’activité principale. Le total quotidien traite ces configurations de la même manière. La question est ici plus précise que celle du temps de lecture des Américains : lorsqu’un carnet contient de la lecture d’intérêt personnel, quelle est la concentration de ce temps, et à quelle fréquence le code de lecture réapparaît-il après un autre code principal ? Cela rend l’organisation temporelle visible sans faire du carnet un relevé de chaque changement mental.
Les données proviennent de l’American Time Use Survey de 2024, qui couvre les personnes de 15 ans et plus, y compris celles de 15 à 17 ans. Parmi 7 669 carnets de participants, 1 574 enregistrent un temps positif sous le code de lecture d’intérêt personnel. Ces journées observées constituent l’échantillon analytique conditionnel de l’analyse principale. Chaque participant fournit un seul carnet rétrospectif, de 4 heures du matin à 4 heures du matin. Les résultats décrivent donc la distribution pondérée des journées avec ce code en 2024, et non une routine individuelle observée à plusieurs reprises ni la proportion de personnes qui divisent habituellement leur lecture.
Pour les lecteurs et les bibliothèques, cette distinction modifie la question qu’il est pertinent de poser. Au lieu de rechercher une durée idéale et unique de séance, l’analyse distingue l’existence de plusieurs périodes de la concentration des minutes à l’intérieur de celles-ci. Une journée peut comporter plusieurs séquences tout en réunissant l’essentiel du temps codé en lecture dans une grande séquence. Inversement, une mesure donnant davantage d’influence aux journées qui apportent plus de minutes de lecture peut révéler une organisation moins concentrée. Aucune configuration n’établit si la lecture était satisfaisante, difficile, volontaire ou interrompue.
Ce qui compte comme lecture dans cette étude
L’analyse suit le lexique officiel des activités de 2024 au lieu de lui substituer une définition courante de la lecture. Le code 120312, intitulé « Reading for personal interest » dans le lexique officiel (lecture d’intérêt personnel), inclut livres, journaux, magazines, livres audio, liseuses, recherche personnelle, le fait de se faire lire un texte et tâches de bibliothèque telles qu’emprunt, enregistrement des emprunts, retour et exploration des collections. Cette étendue importe au public des bibliothèques : certaines minutes peuvent correspondre à l’obtention ou à la découverte de documents plutôt qu’à la lecture continue d’un texte. Appeler chaque séquence une séance de lecture de livres restreindrait sans preuve la définition de la source et donnerait aux pourcentages un sens qu’ils n’ont pas.
Ce code ne mesure pas non plus toute la lecture. La lecture liée au travail, aux études, aux enfants ou à la religion peut relever d’autres catégories. La plupart des activités secondaires échappent à cette mesure de l’activité principale. Une personne peut avoir un contact avec du texte ou de l’audio pendant qu’une autre activité reçoit le code principal du carnet, mais ces données ne fournissent pas un inventaire complet de ce contact. L’expression appropriée est donc « temps codé en lecture » ; « d’intérêt personnel » désigne la catégorie officielle, sans porter de jugement sur la motivation ou l’expérience de la personne.
Ces limites comptent lorsqu’on rapproche les résultats des livres et des services de bibliothèque. L’analyse ne distingue pas un roman d’un journal, n’identifie pas les genres, ne compte pas les livres terminés et ne sépare pas tous les formats représentés. Elle ne détermine pas non plus quelles séquences impliquaient une bibliothèque. Elle montre comment le temps attribué à cette vaste catégorie liée à la lecture est organisé dans un carnet. Il s’agit d’une information utile sur l’organisation temporelle, à condition de laisser la catégorie explicite plutôt que de la masquer derrière une expression plus séduisante mais injustifiée, comme lecture soutenue de livres.
Des enregistrements d’activité aux séquences déclarées
Une séquence déclarée est une suite maximale d’enregistrements adjacents d’activité principale portant le code 120312. Si deux enregistrements de lecture se touchent dans le carnet, ils sont réunis en une séquence. Une nouvelle séquence ne commence qu’après au moins un enregistrement intermédiaire portant un autre code. Cette définition évite de considérer une division de codage comme la preuve que la lecture s’est arrêtée puis a repris. Elle préserve aussi la distinction entre les enregistrements de l’enquête et l’unité analytique construite à partir d’eux. Ni un enregistrement brut ni une séquence réunie ne constitue un participant supplémentaire.
Dans les carnets avec lecture, 2 291 enregistrements bruts deviennent 2 274 séquences réunies. Dix-sept journées observées comportent des divisions entre enregistrements adjacents, et sept journées seraient classées comme multiples avec les enregistrements bruts, mais pas après leur réunion. Ce sont des effectifs finis de l’échantillon, pas des estimations pondérées de population. Les groupes concernés n’atteignent pas le seuil minimal d’effectif retenu pour publier des pourcentages. Leurs effectifs expliquent pourquoi l’adjacence est traitée explicitement ; ils ne justifient pas un résultat principal sur la fréquence ou l’incidence des divisions de codage dans la population.
Le mot « séquence » ne doit pas être confondu avec une attention ininterrompue. Un carnet ne révèle ni un regard détourné de la page, ni une courte conversation omise du souvenir, ni une variation de concentration au sein d’une période codée. De même, deux séquences séparées ne représentent pas nécessairement une interruption non souhaitée. Une personne peut choisir de lire à plusieurs moments. Le fait observé est simplement qu’un autre code d’activité principale s’intercale entre des périodes de lecture. Cette définition modeste permet de répondre à une véritable question sans transformer la continuité des codes en mesure psychologique.
Une seule séquence domine, mais le code de lecture réapparaît souvent
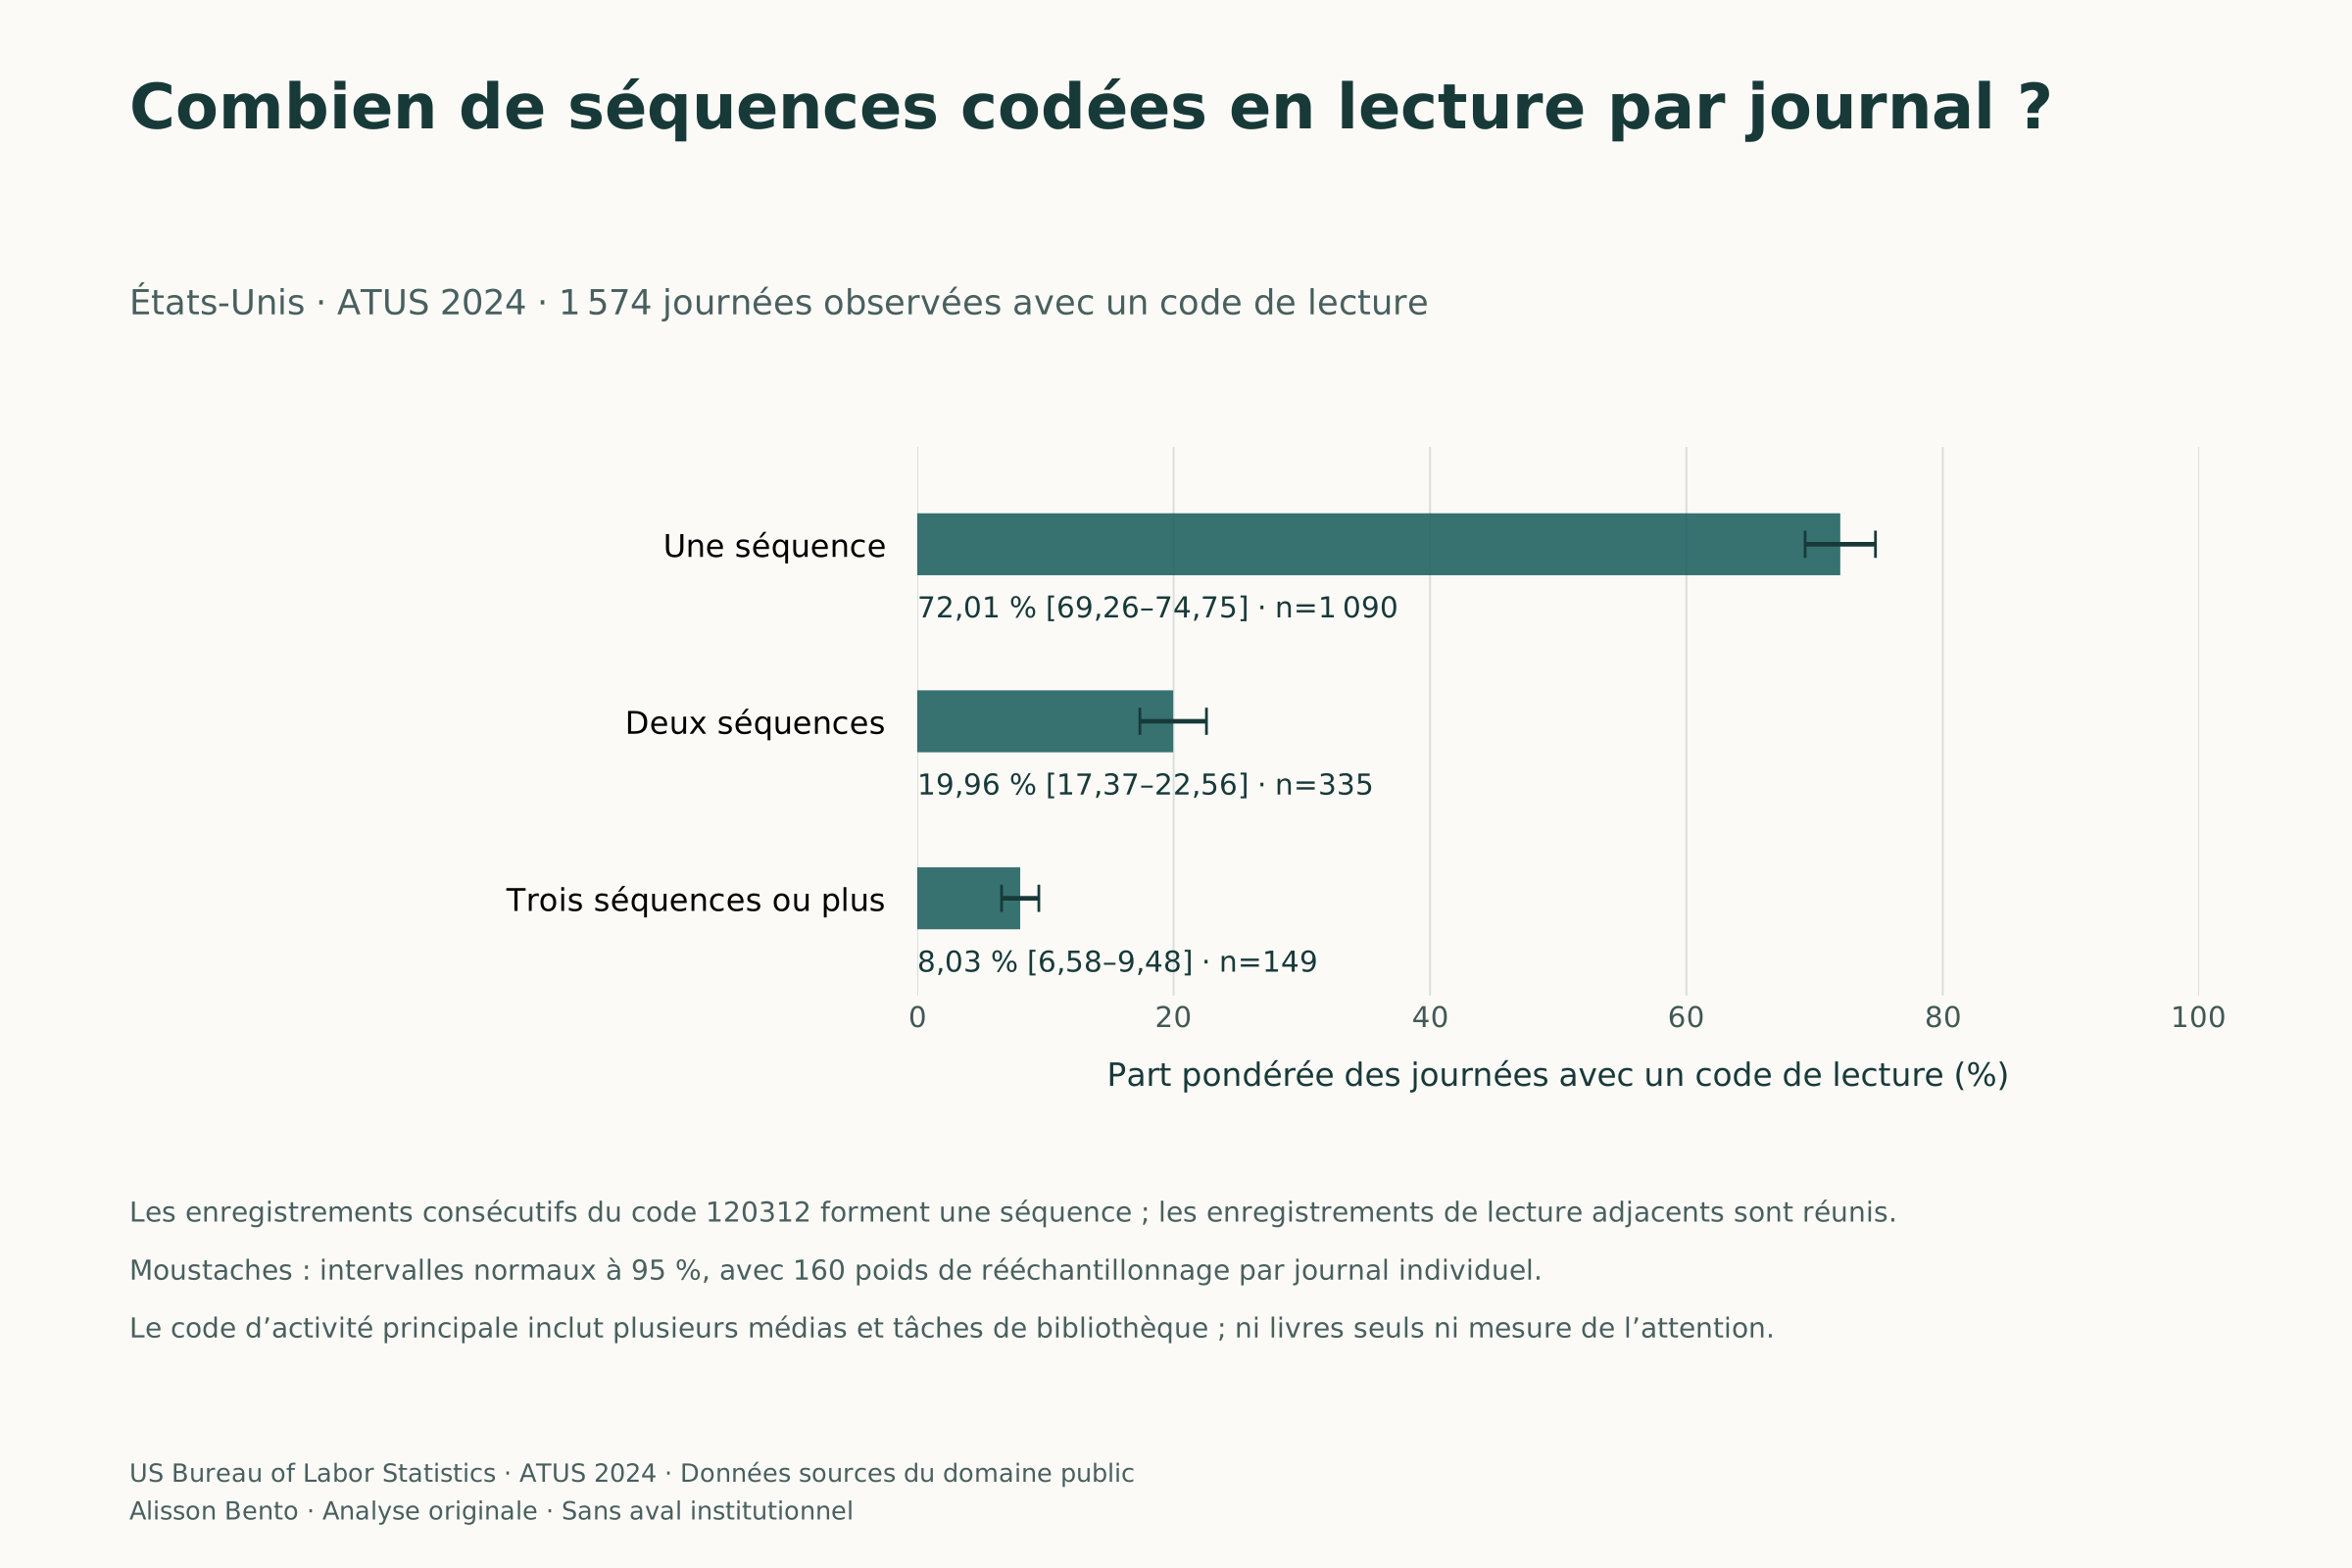
Dans la distribution pondérée des journées avec lecture, 72,006293 % comportent une séquence, 19,964115 % en comportent deux et 8,029592 % en comportent trois ou plus. Les effectifs observés correspondants sont de 1 090, 335 et 149 journées. La réunion des deux derniers groupes donne une part de séquences multiples de 27,993707 %, fondée sur 484 carnets observés. Son intervalle à 95 % va de 25,248699 % à 30,738715 %. Une séquence unique est donc la configuration majoritaire, tandis que le retour au code de lecture après une autre activité représente une minorité importante dans cet ensemble conditionnel.
Le dénominateur est essentiel. Ces pourcentages ne décrivent ni l’ensemble des 7 669 journées, ni tous les Américains, ni seulement les adultes de 18 ans et plus. Ils concernent les journées où l’enquête a enregistré du temps sous le code 120312 chez les personnes de 15 ans et plus. Ils ne révèlent pas non plus si la même personne suit habituellement cette organisation. Un participant observé avec deux séquences pourrait présenter une autre configuration un autre jour. L’enquête permet une description quotidienne pondérée, et non une classification des personnes en types stables de séance unique ou de lecture fragmentée.
Les trois catégories répondent à une question de nombre, pas de durée. Une journée à deux séquences peut comporter une période dominante et un bref retour, ou deux périodes plus équilibrées ; le nombre seul ne les distingue pas. De même, la catégorie ouverte de trois séquences ou plus n’établit pas si les minutes sont réparties uniformément entre elles. C’est pourquoi le nombre de séquences et la concentration dans la plus longue doivent être considérés ensemble. Le premier décrit la récurrence dans la succession des codes ; la seconde mesure combien du temps de lecture quotidien reste rassemblé dans la période la plus longue.
La pondération par journée : une séquence réunit généralement l’essentiel du temps
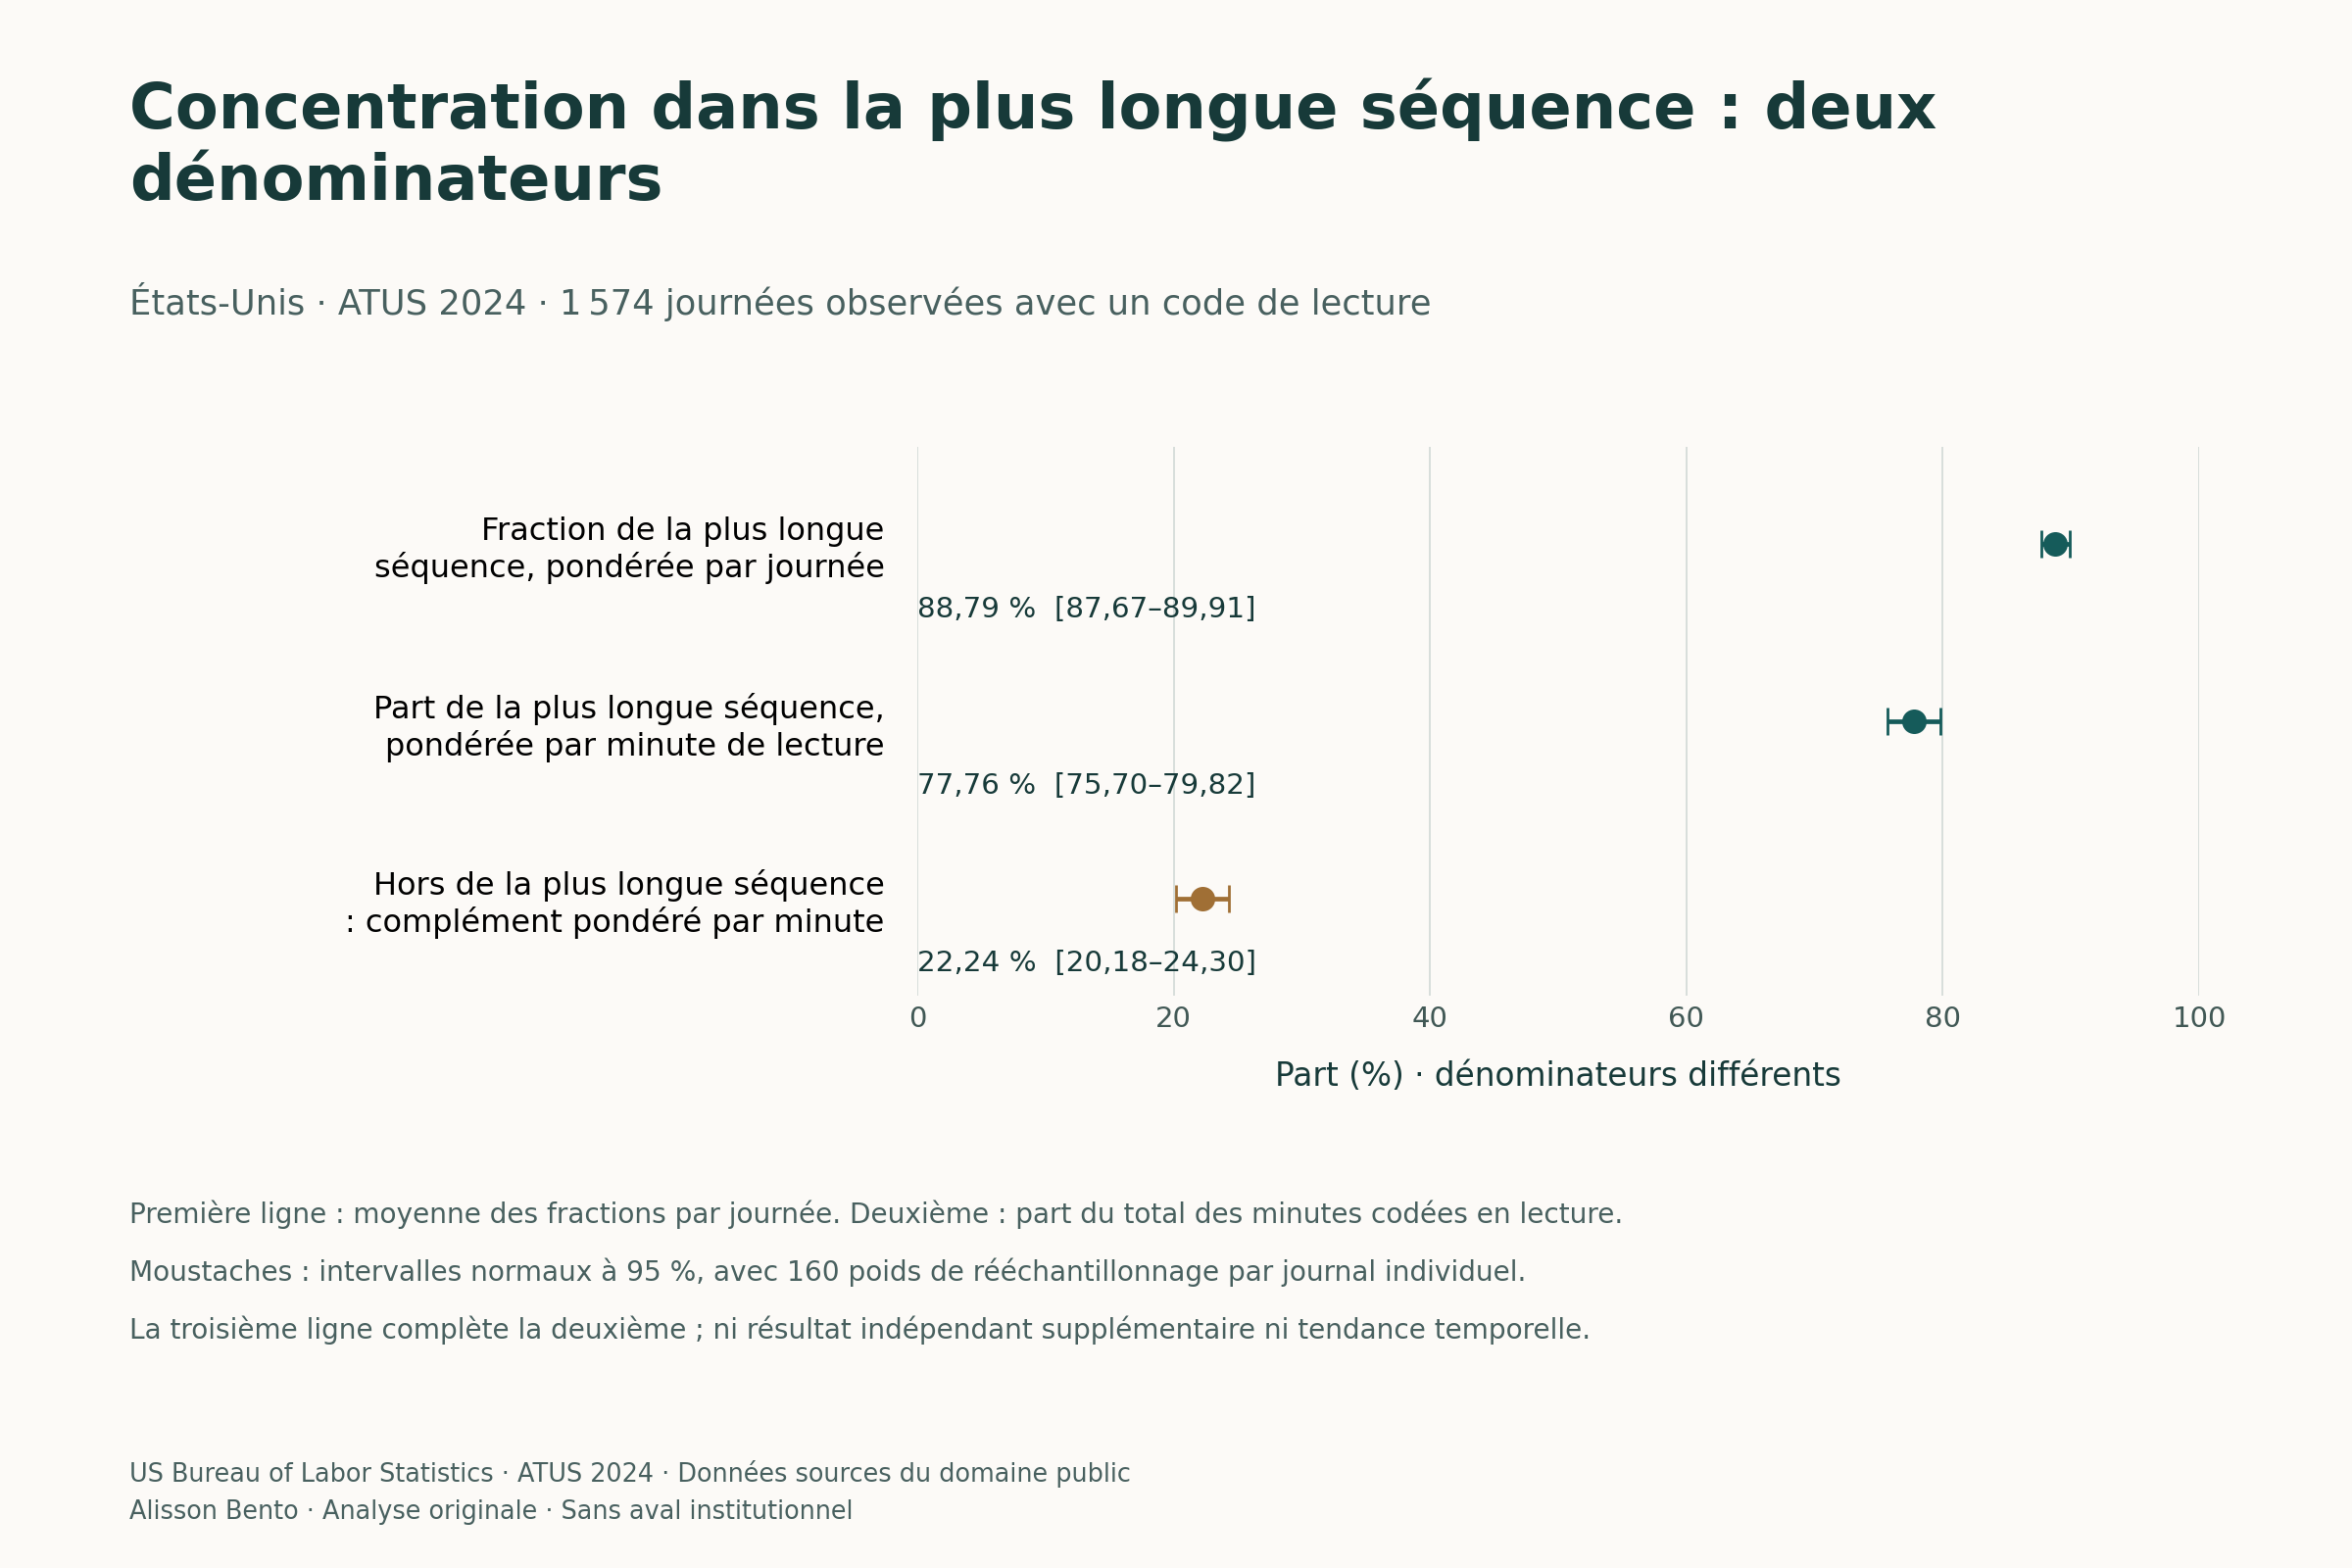
Pour mesurer la concentration, l’analyse identifie d’abord la plus longue séquence de chaque journée avec lecture et divise ses minutes par le total quotidien des minutes codées en lecture. Une journée à séquence unique a nécessairement une fraction de 100 %. Avec plusieurs séquences, cette fraction est inférieure, car des minutes de lecture se situent ailleurs. L’estimation pondérée par journée fait la moyenne de ces fractions quotidiennes avec les poids finaux de l’enquête. Elle atteint 88,789356 %, avec un intervalle à 95 % de 87,670100 % à 89,908611 %. Elle répond à la question suivante : quelle est la concentration lorsque les objets dont on fait la moyenne sont les journées avec lecture ?
Cela ne signifie pas que 88,79 % des journées possèdent une séquence dominante selon un seuil supplémentaire. Aucun seuil de ce type n’est introduit. C’est une moyenne de fractions quotidiennes continues, associant la concentration complète des journées à séquence unique à la concentration variable des journées à plusieurs séquences. L’estimation ne dit pas non plus que chaque lecteur consacre environ neuf dixièmes de son temps de lecture à une seule séance. Les fractions individuelles varient, et l’enquête n’observe qu’une journée par participant. La statistique résume ces fractions pondérées au lieu de prescrire une organisation personnelle.
Pour qui s’intéresse à la lecture, cela explique pourquoi plusieurs séquences ne supposent pas une journée uniformément dispersée. Revenir au code et concentrer l’essentiel des minutes dans une séquence sont compatibles. Une courte séquence supplémentaire fait passer le nombre d’une à deux, tout en pouvant laisser élevée la fraction de la plus longue. Les données résistent ainsi à une opposition simple entre lecture parfaitement continue et fragmentation généralisée. La distinction utile porte sur la fréquence de réapparition du temps codé en lecture et sur la force avec laquelle la plus longue séquence domine le total quotidien.
La pondération par minute offre une autre perspective compatible
Le calcul pondéré par minute utilise les mêmes 1 574 journées observées avec lecture, mais pose une autre question. Il divise les minutes pondérées réunies dans la plus longue séquence de chaque journée par l’ensemble des minutes pondérées codées en lecture. La part obtenue est de 77,763709 %, avec un intervalle à 95 % de 75,703107 % à 79,824310 %. Contrairement à la moyenne des fractions quotidiennes, ce rapport donne plus d’influence aux journées qui apportent davantage de minutes de lecture. Il décrit la répartition du volume de minutes, pas la concentration d’une journée envisagée selon la pondération par journée.
Le résultat plus faible de la pondération par minute est informatif, pas contradictoire. Il indique que laisser les journées riches en minutes de lecture contribuer davantage réduit la concentration mesurée. Les estimations par journée et par minute décrivent différents aspects de la même base observée, non des populations incompatibles. Elles ne doivent pas être moyennées, empilées comme une composition ni traitées comme des estimations concurrentes d’une quantité unique. L’incertitude de leur différence ne doit pas non plus être obtenue en soustrayant ou en combinant indépendamment les erreurs-types affichées : les deux proviennent des mêmes données de carnets individuels.
Le complément de la part pondérée par minute est de 22,236291 % : ce sont les minutes de lecture hors d’une plus longue séquence sélectionnée par journée. C’est une autre expression du même rapport, non une découverte distincte. Ce n’est pas davantage la part du temps de lecture interrompue par des distractions. Ces minutes restent codées en lecture, simplement dans d’autres séquences. Pour comparer des affirmations sur la concentration, la leçon pratique consiste à demander ce qui reçoit du poids. La journée codée typique peut sembler plus concentrée que la répartition du volume total de minutes, les deux descriptions restant justes pour leur propre dénominateur.
Entre les séquences : une séparation temporelle, pas une pause d’attention mesurée
Pour les 484 journées observées à plusieurs séquences, l’analyse examine les enregistrements non codés 120312 entre la première et la dernière séquence de lecture. La moyenne est de 8,9453 enregistrements intermédiaires et de 378,2263 minutes intermédiaires par journée à plusieurs séquences. L’intervalle à 95 % du temps intermédiaire total va de 348,8572 à 407,5954 minutes. Il s’agit de totaux des portions intermédiaires d’une journée, pas de la durée moyenne d’une pause individuelle. Un carnet comportant plusieurs retours au code peut apporter plusieurs périodes intermédiaires à ce seul total quotidien.
Cette distinction évite une interprétation particulièrement trompeuse : le résultat ne montre pas qu’un lecteur typique fait une pause de 378 minutes dans un livre. Il ne concerne que les journées à plusieurs séquences de lecture, cumule tout le temps entre elles qui n’est pas affecté au code 120312 et peut couvrir des parties très éloignées du carnet. Les activités précédant la première séquence ou suivant la dernière sont exclues du calcul. La mesure situe la séparation dans la journée observée ; elle n’identifie pas une séance planifiée qui aurait été suspendue puis reprise.
« Non codé en lecture » est aussi plus exact que « comportement sans lecture ». Certains enregistrements intermédiaires relèvent de codes de données inconnus ou inclassables, et d’autres catégories principales n’excluent pas tout contact simultané avec du texte ou de l’audio. La succession des codes ne permet pas d’établir ce qui a causé la fin d’une séquence. Un repas, un déplacement ou une tâche ménagère entre deux séquences indique une position temporelle, pas un évincement de la lecture. Dans une discussion bibliothécaire sur les interruptions, l’apport utile est donc une délimitation : la séparation est observable, mais pas la perte d’attention, la frustration ou l’arrêt imposé.
Ce qui occupe le temps codé entre les séquences
Le tableau conserve les 18 catégories officielles de premier niveau au lieu de sélectionner les plus grandes ou les plus frappantes. Son dénominateur est le total pondéré du temps intermédiaire entre la première et la dernière séquence de lecture, hors code 120312 lui-même. La socialisation, la détente et les loisirs représentent 27,38 % de ces minutes ; les activités ménagères, 18,90 % ; les repas et boissons, 11,06 % ; et les soins personnels, 9,29 %. Ce sont des parts de minutes intermédiaires, pas des pourcentages de lecteurs pratiquant chaque activité ni des parts du carnet entier.
Les intitulés demandent de la prudence. La catégorie des loisirs exclut le code étudié, mais ses minutes restantes ne prouvent pas que les loisirs concurrencent causalement la lecture. Le travail et les activités liées représentent 8,80 % des minutes intermédiaires, et les déplacements, 6,86 % ; aucun chiffre n’explique pourquoi la lecture a cessé ni ce qui arriverait si ces activités changeaient. L’effectif observé figure séparément, car la présence d’une activité sur de nombreuses journées et sa contribution au volume de minutes sont deux propriétés différentes. Le nombre de journées ne peut pas se substituer à la part pondérée des minutes.
Les codes de données restent une catégorie séparée : 50 journées observées contributrices apportent 1,35675 % des minutes intermédiaires avant l’arrondi du tableau. Ces enregistrements sont inconnus ou inclassables, pas des comportements sans lecture confirmés. Plusieurs autres catégories ont des estimations pondérées non publiées selon le filtre d’effectif et de précision de l’analyste, mais leurs noms et effectifs demeurent visibles. Il ne faut donc ni compléter les parts absentes, ni conclure à l’absence des catégories masquées, ni attendre que les seuls pourcentages publiables totalisent 100 %. Conserver toutes les catégories montre à la fois la diversité du temps intermédiaire et les limites de l’estimation fiable.
La limite du carnet n’est pas nécessairement celle de la lecture
La journée cible de l’enquête commence et finit à 4 heures du matin. Une séquence qui touche l’une des limites peut appartenir à une activité se poursuivant hors de la fenêtre observée ; l’analyse inclut donc un calcul de sensibilité aux limites. Vingt-sept journées observées avec lecture touchent une limite. Leur exclusion laisse 1 547 journées, contre 1 574 dans l’analyse principale. La base principale demeure la description de référence ; la base réduite demande comment se présentent les estimations sans les cas touchant les extrémités. Elle ne reconstruit pas le temps non observé au-delà du carnet.
Dans le sous-ensemble sans contact avec les limites, la part à plusieurs séquences est de 27,377105 %, avec un intervalle à 95 % de 24,607955 % à 30,146255 %. La fraction de la plus longue séquence pondérée par journée est de 89,05935 %, et sa part pondérée par minute de 78,84581 %. Ces valeurs maintiennent le schéma descriptif général : une majorité de journées à séquence unique et une concentration supérieure par journée à celle par minute. Ce n’est pas une comparaison avant/après, puisque la base observée change. Des résultats proches ne prouvent pas l’absence d’effets de limite, et l’étude n’estime pas causalement ce que produit la limite.
La mesure de durée suit la fenêtre cible officielle. Une activité finale non codée en lecture présente un écart inexpliqué de 30 minutes entre son horloge brute étendue et sa durée non tronquée. Sa durée bornée et la séquence cumulée de 4 heures à 4 heures sont cohérentes ; l’enregistrement reste donc inchangé, sans réparation ni exclusion. Cette réserve importe : une séquence bornée valide de 1 440 minutes ne démontre pas un accord universel entre tous les champs d’horloge étendue. L’analyse emploie la mesure bornée définie par la source tout en laissant explicitement cet écart distinct non résolu.
Pourquoi la durée moyenne par journée diffère de la moyenne par séquence
Un autre diagnostic de dénominateurs concerne la durée moyenne des séquences. Une approche calcule d’abord la durée moyenne des séquences de chaque journée, puis la moyenne de ces valeurs avec les poids de l’enquête. Elle donne 72,16138 minutes. Une autre calcule une moyenne entre séquences en répétant pour chacune le poids original du carnet ; elle donne 74,88477 minutes. La première fait contribuer chaque journée par une moyenne quotidienne ; la seconde permet aux journées ayant davantage de séquences d’apporter davantage d’observations. Les deux restent fondées sur l’échantillonnage des carnets individuels, sans traiter les séquences comme des participants indépendants dans le calcul d’incertitude.
Ces résultats complémentaires ne doivent pas devenir une annonce de différence de durée statistiquement significative. Ils servent à rendre visible l’unité dont on fait la moyenne. Le tableau présente aussi des moyennes non pondérées de l’échantillon, qui décrivent l’échantillon observé sans remplacer les résumés pondérés de population. Aucune moyenne n’est une durée de séance recommandée. La catégorie dépasse les livres, et une séquence moyenne ne révèle pas la durée convenant à un lecteur, un format, une tâche ou un cadre de bibliothèque donnés. En faire une cible ajouterait une recommandation que l’étude ne justifie pas.
Les règles de précision ont une autre fonction que les choix de dénominateur. Les estimations publiques exigent au moins 30 journées observées contributrices au numérateur et une erreur-type relative de réplication ne dépassant pas 30 %. C’est un filtre de fiabilité de l’analyste, non une règle de publication du BLS ni une protection contre la divulgation. Il ne publie pas le pourcentage pondéré de divisions adjacentes, le contraste entre enregistrements bruts et séquences réunies et la prévalence du contact avec les limites, car leurs effectifs sont trop faibles. Afficher les effectifs explique les diagnostics sans conférer une autorité apparente aux estimations instables. Le même filtre s’applique au tableau fixe des catégories intermédiaires.
Ce que lecteurs et bibliothèques peuvent retenir de la séquence
L’apport est une description articulée de la récurrence, de la concentration et du temps intermédiaire codé dans les carnets avec lecture de 2024. La plupart de ces journées comportent une séquence ; une minorité importante connaît des retours au code ; et la perspective du volume de minutes est moins concentrée que la moyenne des fractions quotidiennes. Ensemble, ces résultats expliquent ce que le total quotidien ne montre pas : le temps lié à la lecture peut se rassembler dans une période dominante et apparaître ailleurs dans la journée. L’analyse n’établit pas de déclin, ne compare pas les années et n’identifie pas un nouveau type de lecteur.
La question s’appuie sur des recherches existantes au lieu d’inventer l’analyse temporelle. L’étude de Bone et ses collègues, en 2025, examine participation à la lecture, durée, contexte social, localisation et tendances dans l’ATUS. Le travail de Flood, Hill et Genadek sur les parcours temporels quotidiens utilise horaires et séquences pour distinguer totaux quotidiens et organisation temporelle. En 2011, Drago distingue activités secondaires et brefs épisodes séquentiels, avertissement directement pertinent pour interpréter les séquences ici. La présente analyse applique ces distinctions établies à un ensemble borné de mesures de séquence et de concentration ; elle ne revendique ni priorité méthodologique ni exclusion exhaustive des travaux antérieurs.
Pour un groupe de lecture en bibliothèque ou une personne examinant son emploi du temps, l’application utile est un vocabulaire plus précis pour poser des questions, non une prescription comportementale. On peut distinguer un retour à la lecture d’une défaillance d’attention, une séquence dominante d’une journée entière consacrée à lire, et la concentration de la journée moyenne de celle du volume de minutes. Une étude future des formats de livres, des préférences ou de l’usage des bibliothèques devrait mesurer directement ces sujets. Les carnets ne les fournissent pas par implication. Leur contribution plus étroite demeure concrète : montrer comment la catégorie enregistrée de lecture d’intérêt personnel occupe la journée et y réapparaît.
Combien de séquences codées en lecture par carnet ?
États-Unis · ATUS 2024 · 1 574 journées observées avec un code de lecture
Graphique complet et source
Faites défiler le graphique horizontalement pour le consulter. ↔
Graphique et valeurs
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Séquences | Journées observées | Part pondérée (%) | Intervalle à 95 % |
|---|---|---|---|
| Une | 1 090 | 72,01 | 69,26–74,75 |
| Deux | 335 | 19,96 | 17,37–22,56 |
| Trois ou plus | 149 | 8,03 | 6,58–9,48 |
ATUS 2024, code 120312 ; pas uniquement la lecture de livres. Les trois classes partagent le même dénominateur conditionnel pondéré, fondé sur 1 574 journées observées avec lecture. Les intervalles normaux à 95 % utilisent les poids de réplication des carnets, pas un échantillonnage indépendant des séquences.
Télécharger le graphique (SVG) ↓ · Télécharger le graphique (PNG) ↓

Concentration dans la plus longue séquence : deux dénominateurs
États-Unis · ATUS 2024 · 1 574 journées observées avec un code de lecture
Graphique complet et source

Faites défiler le graphique horizontalement pour le consulter. ↔
Graphique et valeurs
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Mesure | Estimation (%) | Intervalle à 95 % | Journées observées à numérateur positif |
|---|---|---|---|
| Fraction de la plus longue séquence, pondérée par journée | 88,79 | 87,67–89,91 | 1 574 |
| Part de la plus longue séquence, pondérée par minute de lecture | 77,76 | 75,70–79,82 | 1 574 |
| Minutes de lecture hors d’une plus longue séquence par journée | 22,24 | 20,18–24,30 | 484 |
Les mêmes 1 574 journées observées fondent les deux dénominateurs. La pondération par journée forme d’abord la fraction quotidienne de la plus longue séquence. La pondération par minute divise les minutes pondérées des plus longues séquences par le total pondéré des minutes. La dernière ligne est un complément, pas un résultat indépendant supplémentaire.
Télécharger le graphique (SVG) ↓ · Télécharger le graphique (PNG) ↓
Données et téléchargements
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Séquences | Journées observées | Part pondérée (%) | Intervalle à 95 % |
|---|---|---|---|
| Une | 1 090 | 72,01 | 69,26–74,75 |
| Deux | 335 | 19,96 | 17,37–22,56 |
| Trois ou plus | 149 | 8,03 | 6,58–9,48 |
ATUS 2024, code 120312 ; pas uniquement la lecture de livres. Les trois classes partagent le même dénominateur conditionnel pondéré, fondé sur 1 574 journées observées avec lecture. Les intervalles normaux à 95 % utilisent les poids de réplication des carnets, pas un échantillonnage indépendant des séquences.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Mesure | Estimation (%) | Intervalle à 95 % | Journées observées à numérateur positif |
|---|---|---|---|
| Fraction de la plus longue séquence, pondérée par journée | 88,79 | 87,67–89,91 | 1 574 |
| Part de la plus longue séquence, pondérée par minute de lecture | 77,76 | 75,70–79,82 | 1 574 |
| Minutes de lecture hors d’une plus longue séquence par journée | 22,24 | 20,18–24,30 | 484 |
Les mêmes 1 574 journées observées fondent les deux dénominateurs. La pondération par journée forme d’abord la fraction quotidienne de la plus longue séquence. La pondération par minute divise les minutes pondérées des plus longues séquences par le total pondéré des minutes. La dernière ligne est un complément, pas un résultat indépendant supplémentaire.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Mesure | Estimation | Intervalle à 95 % | Unité |
|---|---|---|---|
| Moyenne des enregistrements intermédiaires non classés sous le code 120312 | 8,95 | 8,16–9,73 | enregistrements d’activité |
| Moyenne des minutes intermédiaires non classées sous le code 120312 | 378,23 | 348,86–407,60 | minutes |
Parmi 484 journées observées à plusieurs séquences. Le temps intermédiaire n’est pas codé 120312 et comprend des codes de données ; il ne démontre ni distraction ni raison d’arrêter. Les minutes moyennes sont le temps intermédiaire total par journée à plusieurs séquences, pas la durée moyenne d’une pause individuelle.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Niveau | Catégorie officielle | Journées observées comportant ces minutes | Part pondérée des minutes (%) | Intervalle à 95 % | Statut |
|---|---|---|---|---|---|
| 01 | Soins personnels | 252 | 9,29 | 7,10–11,48 | publiable |
| 02 | Activités ménagères | 363 | 18,90 | 16,75–21,06 | publiable |
| 03 | Soins et aide aux membres du ménage | 39 | 2,17 | 1,03–3,30 | publiable |
| 04 | Soins et aide aux personnes hors du ménage | 30 | Non publié : filtre de précision de l’analyste | Non publié : filtre de précision de l’analyste | non publié |
| 05 | Travail et activités liées | 48 | 8,80 | 5,24–12,36 | publiable |
| 06 | Études | 5 | Non publié : filtre de précision de l’analyste | Non publié : filtre de précision de l’analyste | non publié |
| 07 | Achats de consommation | 120 | 3,38 | 2,07–4,69 | publiable |
| 08 | Services professionnels et de soins personnels | 21 | Non publié : filtre de précision de l’analyste | Non publié : filtre de précision de l’analyste | non publié |
| 09 | Services ménagers | 9 | Non publié : filtre de précision de l’analyste | Non publié : filtre de précision de l’analyste | non publié |
| 10 | Services publics et obligations civiques | 3 | Non publié : filtre de précision de l’analyste | Non publié : filtre de précision de l’analyste | non publié |
| 11 | Repas et boissons | 403 | 11,06 | 9,84–12,28 | publiable |
| 12 | Socialisation, détente et loisirs | 343 | 27,38 | 24,77–29,99 | publiable |
| 13 | Sports, exercice et activités récréatives | 102 | 3,74 | 2,74–4,74 | publiable |
| 14 | Activités religieuses et spirituelles | 19 | Non publié : filtre de précision de l’analyste | Non publié : filtre de précision de l’analyste | non publié |
| 15 | Bénévolat | 29 | Non publié : filtre de précision de l’analyste | Non publié : filtre de précision de l’analyste | non publié |
| 16 | Appels téléphoniques | 72 | 2,24 | 1,44–3,04 | publiable |
| 18 | Déplacements | 232 | 6,86 | 4,84–8,89 | publiable |
| 50 | Codes de données | 50 | 1,36 | 0,84–1,87 | publiable |
Toutes les catégories fixes de premier niveau des minutes entre la première et la dernière séquence, hors code 120312. La catégorie 12 exclut le code 120312. La catégorie 50 contient des codes de données, dont des enregistrements inconnus ou inclassables, pas des comportements sans lecture confirmés. Le filtre de l’analyste exige au moins 30 journées observées à numérateur positif et une erreur-type relative d’au plus 30 % ; ce n’est pas une règle officielle du BLS. Les lignes publiables ne totalisent pas seules 100 %, car les estimations de sept catégories ne sont pas publiées.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Mesure | Estimation principale | Intervalle principal à 95 % | Estimation sans contact avec les limites | Intervalle à 95 % sans contact avec les limites |
|---|---|---|---|---|
| Au moins deux séquences déclarées de lecture séparées dans le temps | 27,99 | 25,25–30,74 | 27,38 | 24,61–30,15 |
| Fraction de la plus longue séquence, pondérée par journée | 88,79 | 87,67–89,91 | 89,06 | 87,92–90,20 |
| Part de la plus longue séquence, pondérée par minute de lecture | 77,76 | 75,70–79,82 | 78,85 | 76,77–80,92 |
La base principale est conservée. Seule cette sensibilité prédéfinie exclut les journées avec lecture touchant une limite de 4 heures du matin, réduisant l’effectif de 1 574 à 1 547. La prévalence du contact avec les limites n’est pas publiée, car seules 27 journées observées répondent au critère. Ces résumés de bases différentes ne constituent pas une comparaison causale avant/après.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Mesure | Minutes pondérées | Intervalle à 95 % | Minutes non pondérées de l’échantillon |
|---|---|---|---|
| Durée moyenne des séquences dans la journée, pondérée par journée | 72,16 | 68,50–75,83 | 75,93 |
| Durée moyenne pondérée par séquence | 74,88 | 70,86–78,91 | 77,64 |
Diagnostic complémentaire des dénominateurs, pas affirmation d’un changement d’habitudes ni différence testée. Les moyennes par séquence répètent les poids originaux du carnet par séquence ; la variance reste au niveau du carnet individuel. Les valeurs non pondérées décrivent uniquement cet échantillon fini.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Diagnostic | Effectif observé | Politique d’estimation |
|---|---|---|
| Journées documentées par les participants | 7 669 | Tous les enregistrements officiels de 2024 ; poids positifs |
| Journées avec code de lecture | 1 574 | Base de l’analyse conditionnelle |
| Enregistrements bruts d’activité codés en lecture | 2 291 | Ne représentent pas des personnes indépendantes |
| Séquences de lecture déclarées après réunion | 2 274 | Enregistrements adjacents du code 120312 réunis |
| Journées avec enregistrements adjacents divisés | 17 | Pourcentage pondéré non publié |
| Journées à enregistrements bruts multiples mais à une seule séquence réunie | 7 | Contraste pondéré en points de pourcentage non publié |
| Journées avec code de lecture touchant une limite | 27 | Prévalence pondérée non publiée |
Effectifs finis non pondérés de l’échantillon. Les contrastes pondérés des divisions adjacentes et des enregistrements bruts multiples moins les séquences réunies multiples ne sont pas publiés selon le filtre prédéfini, avec 17 et sept journées à numérateur positif respectivement. Ne pas soustraire les erreurs-types marginales pour inventer l’incertitude du contraste apparié. Aucun enregistrement individuel ni identifiant n’est divulgué.
Données et méthode
Notre méthode de calcul
- Période observée : carnets ATUS de 2024 de personnes de 15 ans et plus. Les sources officielles ont été obtenues le 30 octobre 2026 ; cette date d’accès n’est pas l’année observée. Les données comprennent les fichiers des participants, des activités, de synthèse des activités et des 160 poids de réplication.
- L’échantillon complet comporte 7 669 carnets et 139 535 enregistrements d’activité, avec des poids finaux positifs. L’analyse conditionnelle utilise 1 574 journées ayant des minutes positives sous le code 120312. L’ordre des activités suit les champs TUCASEID et TUACTIVITY_N ; les durées bornées du champ TUACTDUR24 définissent la journée cible de 1 440 minutes.
- Les séquences réunissent les suites maximales d’enregistrements adjacents codés 120312. Les mesures quotidiennes incluent le nombre de séquences, les minutes de la plus longue divisées par toutes les minutes de lecture, ainsi que les enregistrements et minutes intermédiaires entre la première et la dernière séquence. Les 18 catégories fixes de premier niveau sont conservées.
- Les estimations utilisent TUFINLWGT. Chaque rapport est recalculé pour FINLWGT001 à FINLWGT160 au niveau original du carnet individuel. La variance vaut (4/160) fois la somme des carrés des écarts de réplication à l’estimation complète ; les intervalles normaux à 95 % sont l’estimation plus ou moins 1,96 erreur-type.
- La concentration pondérée par journée moyenne les fractions quotidiennes de la plus longue séquence ; celle par minute divise les minutes pondérées des plus longues séquences par toutes les minutes pondérées de lecture. La durée moyenne par séquence répète le poids du carnet pour chaque séquence, mais l’incertitude repose toujours sur les réplications du carnet individuel.
- Le filtre fixe de l’analyste exige au moins 30 journées observées contributrices au numérateur et une erreur-type relative de réplication ne dépassant pas 30 %. Une sensibilité prédéfinie exclut 27 journées touchant les limites sans remplacer la base principale. Les matériaux publics se limitent aux statistiques suffisantes agrégées, métadonnées d’effectifs et empreintes des sources, sans enregistrements individuels.
Ce que les données ne permettent pas de conclure
- Le code 120312 inclut livres, périodiques, audio, liseuses, recherche personnelle et certaines tâches de bibliothèque ; il n’est ni réservé aux livres ni une mesure de toute la lecture.
- Le champ couvre les personnes de 15 ans et plus, dont celles de 15 à 17 ans. Les pourcentages principaux sont conditionnels à une journée avec code de lecture, pas des pourcentages de toutes les personnes ni de toutes les journées.
- Un seul carnet rétrospectif de 4 heures du matin à 4 heures du matin par participant ne permet d’établir ni habitudes, ni changement individuel, ni organisation habituelle de sa lecture.
- Des séquences adjacentes de codes principaux ne mesurent ni une attention ininterrompue, ni des interruptions momentanées, ni la qualité de la lecture, son contenu, son genre, son achèvement ou la plupart des lectures menées en même temps qu’une autre activité.
- Les totaux intermédiaires couvrent tout le temps non codé en lecture entre la première et la dernière séquence sur les journées à plusieurs séquences ; ce ne sont ni des durées moyennes de pause, ni des distractions démontrées, ni des raisons d’arrêter. Les codes de données demeurent explicitement inconnus ou inclassables.
- Des pondérations différentes de concentration répondent à des questions différentes. Leurs estimations sont dépendantes et le complément de la concentration par minute n’est pas un résultat indépendant.
- Les diagnostics à faibles effectifs et les estimations imprécises de catégories ne sont pas publiés, en application des règles de l’analyste et non de celles du BLS. La sensibilité aux limites modifie la base observée et n’est pas une comparaison causale.
- Une activité finale non codée en lecture présente un écart inexpliqué de 30 minutes dans l’horloge brute étendue. Sa durée bornée et sa séquence cible sont cohérentes ; elle est conservée sans modification. L’analyse n’affirme ni causalité, ni tendance, ni priorité méthodologique.
Sources originales
- BLS: 2024 ATUS official microdata files
Page annuelle officielle du BLS pour 2024, modifiée le 26 juin 2025 : fichiers des participants, activités, synthèse des activités et 160 poids de réplication. Consultée le 30 octobre 2026 ; les microdonnées brutes ne sont pas redistribuées. https://www.bls.gov/tus/data/datafiles-2024.htm
Consulté le 30 octobre 2026
- BLS: 2024 ATUS coding lexicon with activity examples
Lexique de codage du BLS de 2024, pp. 47–48 : le code 120312 inclut livres, périodiques, audio, liseuses, recherche personnelle et tâches de bibliothèque ; les codes de données restent séparés. Consulté le 30 octobre 2026. https://www.bls.gov/tus/lexicons/lexiconwex2024.pdf
Consulté le 30 octobre 2026
- BLS: 2024 ATUS interview data dictionary
Dictionnaire des entretiens du BLS de 2024, édition de juin 2025 : ordre des enregistrements et TUACTDUR24 bornée contre TUACTDUR non tronquée. Un écart inexpliqué de l’horloge étendue reste inchangé hors de la mesure bornée. Consulté le 30 octobre 2026. https://www.bls.gov/tus/dictionaries/atusintcodebk24.pdf
Consulté le 30 octobre 2026
- BLS: ATUS User’s Guide, September 2026
Guide de l’utilisateur ATUS du BLS, septembre 2026, chapitre 7 et pp. 44–45 du PDF : 160 réplications annuelles et formule de variance ; dispositif d’activité principale sur une journée. Consulté le 30 octobre 2026. https://www.bls.gov/tus/atususersguide.pdf
Consulté le 30 octobre 2026
- BLS: Linking and Copyright Information
Politique du BLS sur les liens et le droit d’auteur : publications du domaine public sauf éléments visuels antérieurement protégés ; ni usage de l’emblème ni aval implicite. Consultée le 30 octobre 2026. https://www.bls.gov/bls/linksite.htm
Consulté le 30 octobre 2026
- Bone et al. (2025): The decline in reading for pleasure over 20 years of the ATUS
Bone et ses collègues, 2025, The decline in reading for pleasure over 20 years of the ATUS : recherches antérieures sur participation, durée, contexte, localisation et tendances. Consulté le 30 octobre 2026. https://pmc.ncbi.nlm.nih.gov/articles/PMC12496190/
Consulté le 30 octobre 2026
- Flood, Hill and Genadek: Daily Temporal Pathways
Flood, Hill et Genadek, Daily Temporal Pathways, publication en ligne 2016/numéro de 2018 : analyse antérieure des horaires et séquences avec l’ATUS de 2006–2007. Consulté le 30 octobre 2026. https://pmc.ncbi.nlm.nih.gov/articles/PMC5793932/
Consulté le 30 octobre 2026
- Drago (2011): Secondary Activities in the 2006 ATUS
Drago, 2011, Secondary Activities in the 2006 ATUS, document de travail 446 du BLS : distingue activités simultanées et brefs épisodes séquentiels. Consulté le 30 octobre 2026. https://www.bls.gov/osmr/research-papers/2011/pdf/ec110040.pdf
Consulté le 30 octobre 2026
Citer et réutiliser cette étude
Alisson Bento. Une ou plusieurs séquences ? Comment le temps codé en lecture se répartit dans la journée. 2026, recherche originale. https://alissonbento.com/fr/research/us-reading-coded-runs-and-concentration-2024/
Le texte original et les calculs sont attribués à Alisson Bento. Les publications du US Bureau of Labor Statistics sont dans le domaine public, sauf photographies et illustrations antérieurement protégées ; citer le BLS, ne pas utiliser son emblème ni laisser entendre son aval. Cette politique n’accorde pas de droits sur les livres cités dans une catégorie, ne transfère pas les droits des recherches tierces et n’établit pas de licence générale pour cet article. Bone et ses collègues, Flood, Hill et Genadek, ainsi que Drago, conservent la paternité de leurs sources respectives. Les matériaux de reproduction contiennent uniquement agrégats, métadonnées d’effectifs et empreintes des sources ; ni microdonnées complètes, ni enregistrements individuels ou identifiants ne sont redistribués.
Corrections ou questions éditoriales