
La misura cambia quando cambia la regola sulle virgolette
Lo stesso romanzo digitale può produrre stime notevolmente diverse della porzione di testo racchiusa fra virgolette senza modificare una sola parola dell’input. Nelle due trascrizioni esaminate, il campo di variazione fra tre regole fisse di punteggiatura è stato di 5,78 punti percentuali per Pride and Prejudice e 35,70 per Frankenstein. Le differenze riguardano una misurazione meccanica del testo. Non stabiliscono quanto ciascun autore usasse il dialogo, quale narrazione sia più colloquiale o quale stile preferiscano i lettori. Il numeratore dipende dai token collocati dalla regola entro le citazioni; il denominatore dalla trascrizione e dall’estrazione selezionate.
L’analisi è partita da un controllo deliberatamente piccolo: i primi cinquanta paragrafi conservati di ciascun libro. Le tre regole restituivano percentuali identiche entro ciascuna finestra iniziale. Estenderle agli interi testi principali estratti ha fatto emergere divergenze non visibili negli inizi. Questa sequenza è centrale: l’accordo in un breve passaggio accessibile non bastava a dimostrare un comportamento coerente del programma di riconoscimento delle virgolette nell’intero libro. Né l’accordo iniziale né la divergenza successiva stabiliscono una proprietà universale dei romanzi; sono osservazioni riproducibili su due input fissati.
Una domanda circoscritta, non una classifica letteraria
La quantità misurata è la percentuale di parole (token) che una regola specificata classifica come comprese fra virgolette doppie, in una trascrizione estratta. La sensibilità è la percentuale massima meno la minima fra le tre regole sullo stesso testo. Tenere fisso il denominatore in ogni confronto separa le scelte sui confini delle citazioni dalle differenze di lunghezza. Non calcoliamo una media dei due romanzi per stimare la narrativa inglese. Non campioniamo autori, periodi, paesi, generi o lettori e non forniamo intervalli di confidenza per una popolazione immaginaria di libri.
Il campione è intenzionale e fisso: l’elemento Project Gutenberg 1342, Pride and Prejudice di Jane Austen, e il 42324, la versione 1831 di Frankenstein di Mary Shelley. Conversazione e narrazione epistolare o incorniciata offrono situazioni contrastanti utili per esaminare le regole, ma la motivazione della selezione non sostiene un confronto generale degli stili letterari. Nessun romanzo è stato aggiunto dopo i risultati. Il catalogo Gutenberg complessivo, le lingue e la copertura dei formati restano fuori. Il contributo è un controllo della misura entro il testo, non un ulteriore conteggio di voci di catalogo.
Libri, edizioni e file acquisiti
La paternità originaria resta di Austen e Shelley. Austen visse dal 1775 al 1817, Shelley dal 1797 al 1851. Pride and Prejudice apparve nel 1813, ma il frontespizio del testo 1342 identifica come fonte l’edizione illustrata di George Allen del 1894, con prefazione di George Saintsbury e illustrazioni di Hugh Thomson. Saintsbury visse dal 1845 al 1933 e Thomson dal 1860 al 1920. I loro contributi sono indicati a parte e non attribuiti ad Austen; la prefazione e i blocchi di illustrazioni sono esclusi dalla narrazione misurata. Non si tratta di un confronto fra prime edizioni.
L’elemento 42324 identifica la pubblicazione H. Colburn e R. Bentley del 1831; la nota di trascrizione descrive una riproduzione fotografica di quell’edizione, senza fornirne l’identità bibliografica specifica, che non inventiamo. I file sono stati acquisiti il 30 ottobre 2026. L’intestazione Austen riporta aggiornamento al 1º settembre 2026, mentre la pagina indicava il 29 settembre; quella Shelley indica il 23 ottobre. Sono date distinte dalle edizioni storiche. Gli hash dei byte, non il titolo o il collegamento corrente, definiscono gli input. La punteggiatura testimonia queste trascrizioni, non la tipografia dei manoscritti originali.
Definire e conservare i confini del testo principale
Inizi e finali sono stati controllati rispetto al testo circostante. Il testo principale di Austen comincia con la frase iniziale sulla verità universalmente riconosciuta, dopo frontespizi, prefazione e indice. Finisce con il paragrafo sui Gardiner, prima dell’illustrazione conclusiva, dei dati dello stampatore e del materiale Gutenberg. Il testo principale di Shelley inizia con la prima frase narrativa di Walton dopo introduzione e prefazione; destinatario e data della lettera iniziale precedono quell’ancora e sono esclusi. Finisce con la scomparsa della creatura, prima del marcatore finale, dei dati tipografici, delle correzioni e della licenza. Date, firme e destinatari delle lettere successive restano nel testo principale.
Entro questi confini, i blocchi illustrativi completi vengono rimossi con una procedura a parentesi bilanciate. Si eliminano anche i titoli autonomi di capitoli e lettere. Le righe vuote definiscono i paragrafi, poi uniti con due caratteri di nuova riga. Ancore esatte, posizioni dei caratteri nella fonte normalizzata e hash sono forniti col codice. È una specifica riproducibile, non l’affermazione che ogni token rimasto sia prosa narrativa. Note interne e residui di formattazione non coperti dalle regole restano presenti: un limite individuato dall’esame e conservato, non corretto silenziosamente dopo i risultati completi.
Tre regole fissate prima del confronto completo
R1 alterna globalmente lo stato alle virgolette doppie. Le virgolette curve sono trattate come quelle dritte; ogni segno fa passare da fuori a dentro o viceversa. Una coppia completa definisce un tratto citato anche se attraversa paragrafi. Una coda finale non chiusa è esclusa. La regola ignora la direzione dei segni curvi di apertura e chiusura. Tratta inoltre l’apertura ripetuta all’inizio di un paragrafo di continuazione come cambio di stato, anche quando un lettore la comprenderebbe come prosecuzione della stessa citazione.
R2 usa la stessa logica di alternanza a coppie ma riparte da fuori a ogni paragrafo. Contribuiscono le coppie completate entro il paragrafo; una coda incompiuta è esclusa prima del successivo. R3 distingue apertura e chiusura curve e mantiene lo stato fra paragrafi. Se la citazione è aperta, un’altra apertura all’inizio del paragrafo vale come continuazione. I segni dritti altrimenti alternano lo stato, con la stessa convenzione iniziale. Riaperture curve interne inattese e chiusure isolate sono registrate. Sono tre definizioni operative, non una gara con risposta corretta nota. R3 resta euristica, soprattutto con tipografia inconsueta e convenzioni miste.
Token, copertura e diagnostiche
Le parole sono individuate dall’espressione regolare dichiarata [A-Za-z]+(?:['’][A-Za-z]+)*. Gli apostrofi interni dritti o curvi restano nel token quando circondati da lettere; i trattini dividono i token e le cifre sono escluse. Lettere accentate e legature non rientrano negli intervalli alfabetici ASCII e possono quindi spezzare parole. Un token entra nel numeratore quando il suo punto medio cade in un tratto citato completato. La convenzione rende esatto e riproducibile il calcolo, ma non è una tokenizzazione linguisticamente esaustiva. Cambiarla definirebbe un’altra analisi, fuori dal confronto riportato.
Le tre regole ignorano intenzionalmente le virgolette singole come delimitatori autonomi. Un passaggio fra virgolette singole dentro una citazione doppia già conteggiata non aggiunge copertura: i token sono già nell’tratto esterno. Possono invece sfuggire discorsi fra virgolette singole al livello principale, delimitati da trattini o riportati senza segni. Le diagnostiche registrano tratti completati, code non chiuse, aperture di continuazione, chiusure isolate e riaperture interne. Per R2 una coda indica che lo stato resta aperto a fine paragrafo, non che il glifo iniziale fosse semanticamente un’apertura. Gli elenchi delle posizioni conservano dove si verificano.
Che cosa mostrava il pilota iniziale e che cosa no
Dopo l’estrazione corretta, i primi cinquanta paragrafi Austen contengono 1.254 token, dei quali 955 conteggiati da tutte le regole: 76,1563%. L’inizio Shelley contiene 3.885 token, con 156 conteggiati da tutte: 4,0154%. Gli tratti completati sono 52 per Austen e 13 per Shelley, senza code finali non chiuse con alcuna regola. Le finestre contengono quantità diverse di testo perché varia la lunghezza dei paragrafi. Le percentuali molto differenti non devono classificare interi romanzi né caratterizzare le abitudini tipiche delle autrici.
L’esame dei passaggi ha trovato un difetto nella prima estrazione prima di accettare il pilota. Un’espressione regolare fermava la rimozione delle illustrazioni a una parentesi annidata, lasciando residui e un marcatore senza didascalia che occupava posizioni nella finestra di cinquanta paragrafi. Il risultato Austen non valido era 850 su 1.140 token, ossia 74,5614%. La rimozione bilanciata ha ripristinato la finestra prevista e cambiato la quota di 1,5949 punti. Il risultato non valido è conservato con etichetta esplicita: documenta un errore d’implementazione, non una stima generale della distorsione da estrazione. L’accordo fra regole non aveva rilevato il difetto.
Sensibilità del testo principale completo nella trascrizione Austen
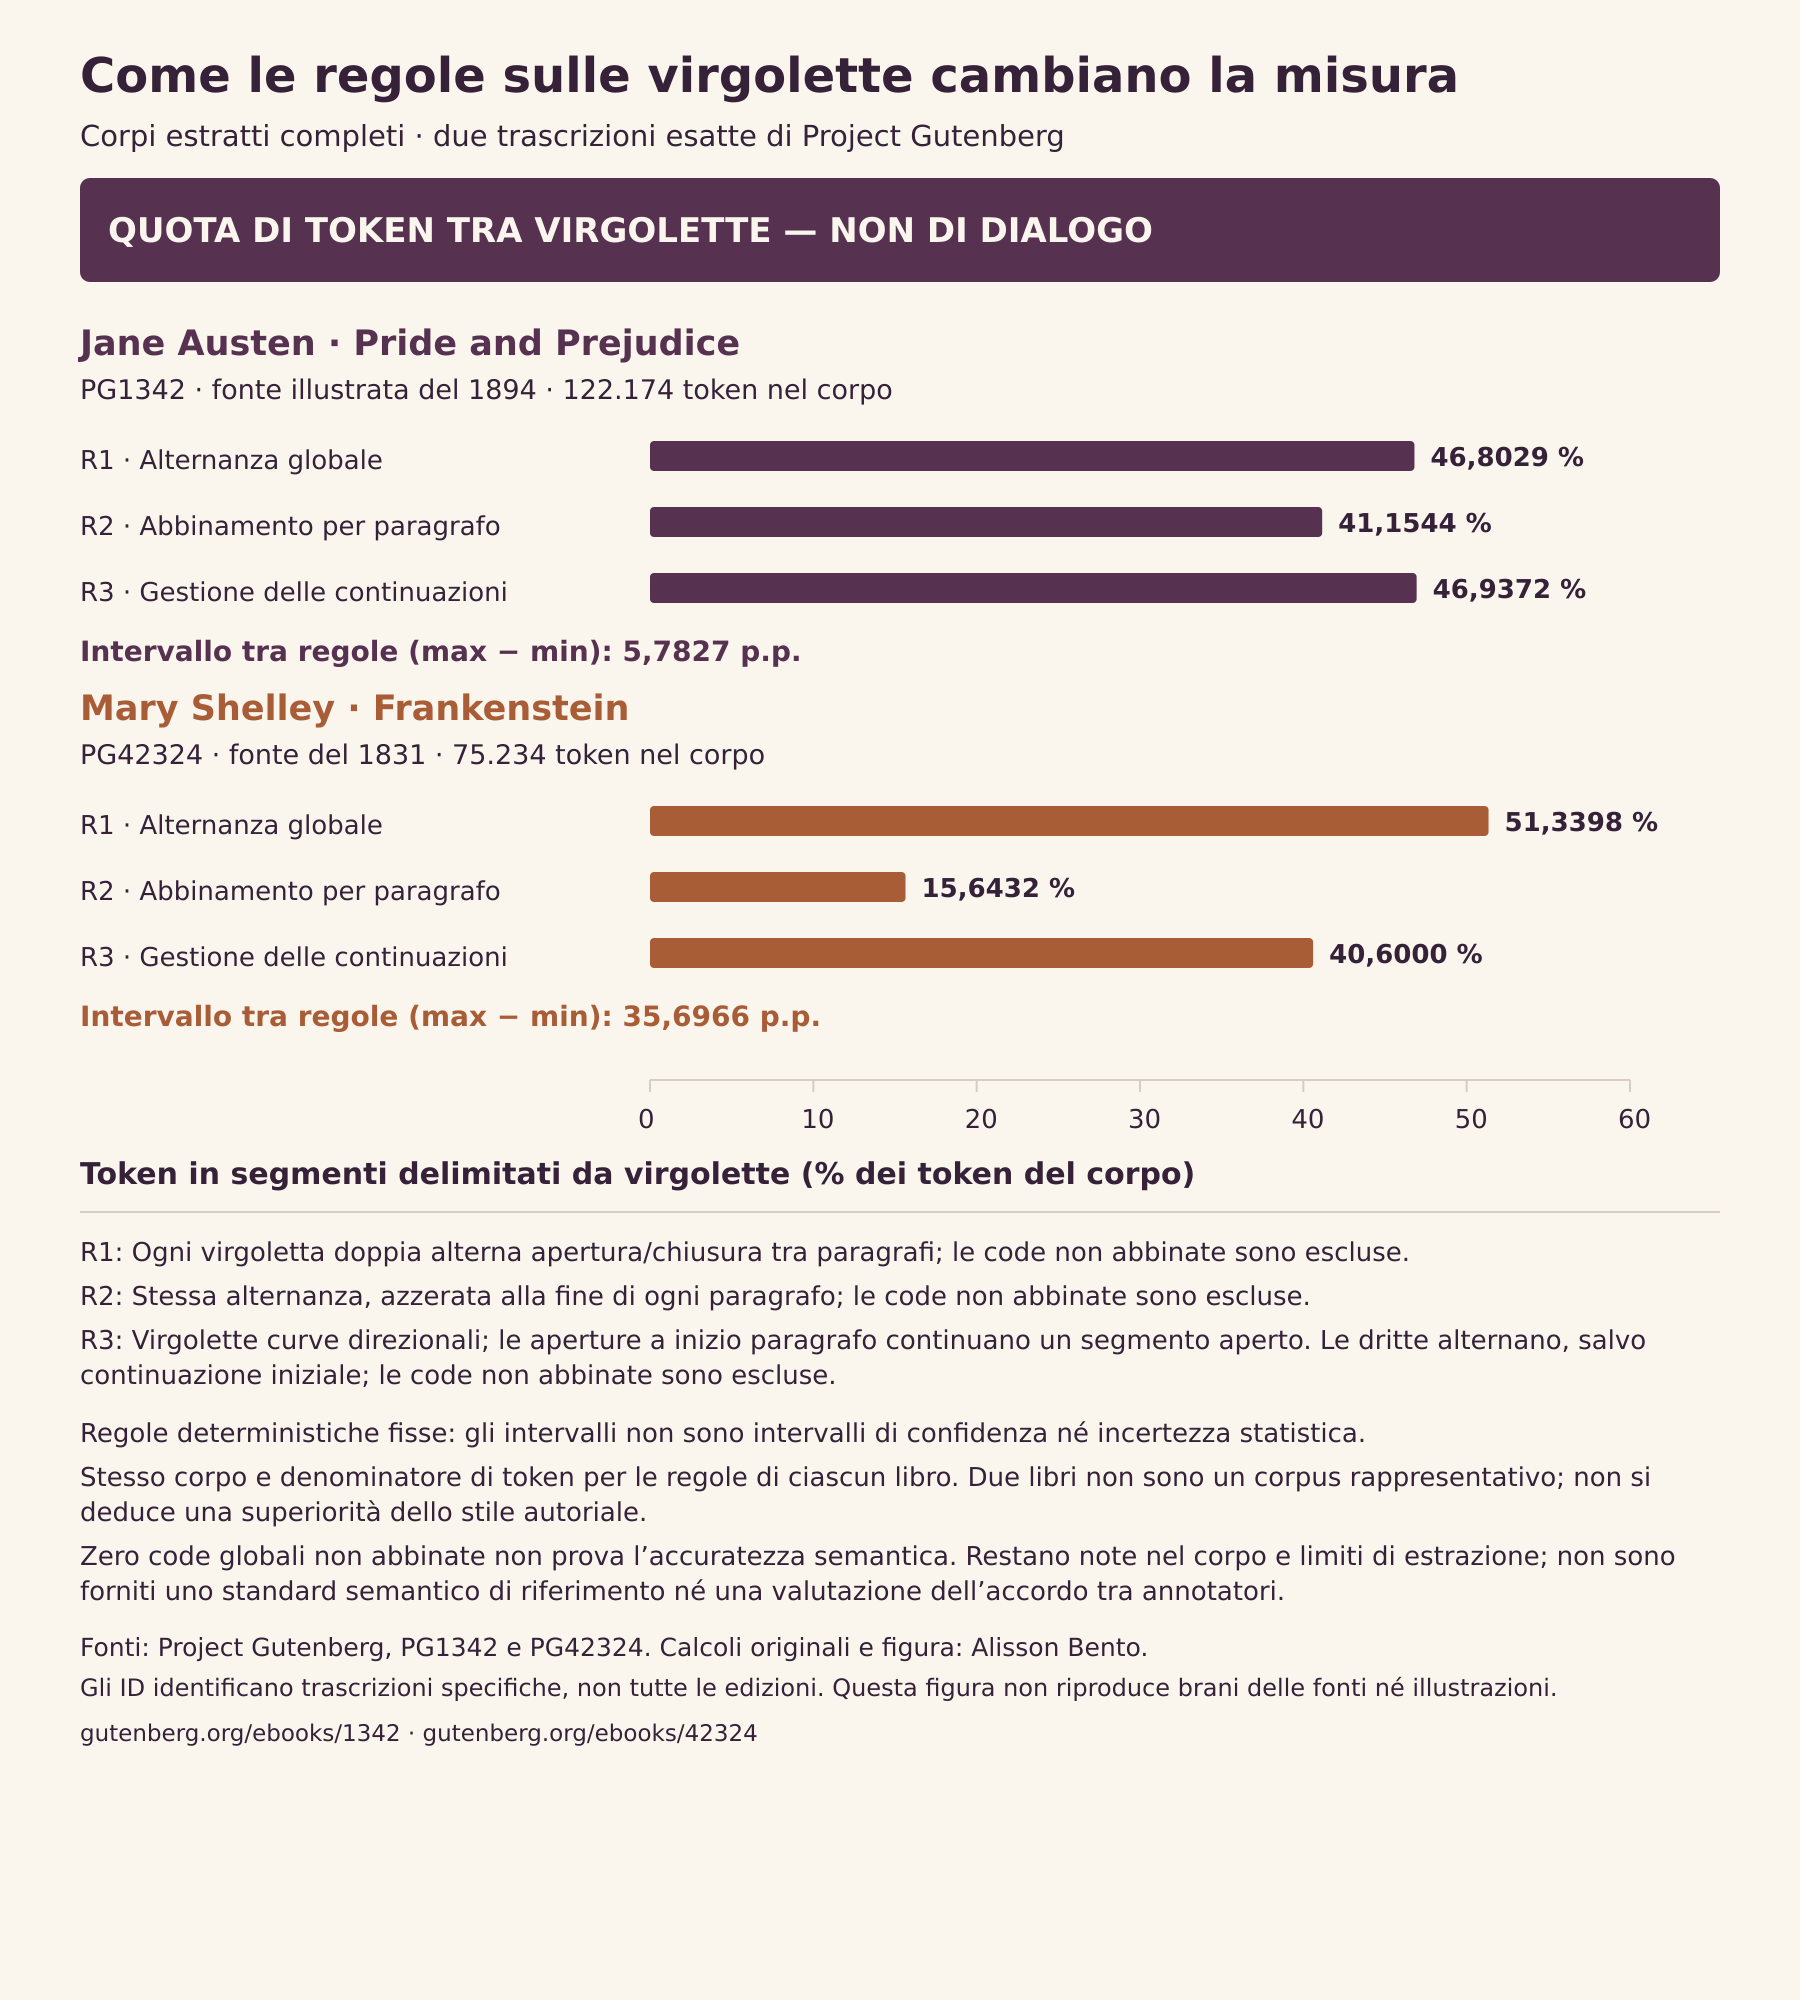
Il testo principale completo estratto di Austen contiene 122.174 token in 2.060 paragrafi conservati. R1 include 57.181 token, pari al 46,8029%; R2 ne include 50.280, il 41,1544%; R3 ne include 57.345, il 46,9372%. La differenza massima meno minima è 5,7827 punti percentuali. R1 trova 1.751 tratti completati; R2 e R3 ne trovano 1.735 ciascuna. R2 registra 32 code di paragrafo non chiuse; R3 riconosce 32 aperture di continuazione. R1 e R3 terminano senza coda non chiusa; R3 non registra chiusure curve isolate né riaperture curve interne.
La vicinanza delle percentuali aggregate fra alternanza globale e regola sensibile alla continuazione non dimostra che i tratti assegnati coincidano. La copertura aggregata può nascondere cambiamenti compensativi e non presentiamo una stima di accuratezza per token. La differenza maggiore dalla regola che riparte a ogni paragrafo mostra che limitare le coppie complete a un paragrafo esclude testo incluso dalle altre definizioni. Il controllo dei passaggi identifica lettere scritte su più paragrafi fra le strutture pertinenti. Una quota meccanicamente inclusa maggiore non significa quindi recuperare più conversazione parlata: può includere più testo di una lettera o di un altro oggetto scritto citato.
Sensibilità del testo principale completo nella trascrizione Shelley
Il testo principale completo di Shelley contiene 75.234 token in 768 paragrafi. R1 include 38.625 token, il 51,3398%; R2 ne include 11.769, il 15,6432%; R3 ne include 30.545, il 40,6000%. Il campo di variazione è 35,6966 punti percentuali. R1 riporta 388 tratti completati, R2 e R3 293 ciascuna. R2 registra 190 code di paragrafo non chiuse e R3 riconosce 190 aperture di continuazione. Nessuna regola globale finisce con una coda non chiusa. Poiché il testo misurato usa virgolette doppie dritte, le diagnostiche R3 specifiche dei segni curvi non risolvono le questioni semantiche sottostanti.
Questi risultati mostrano perché un numero finale pari di virgolette sia un controllo debole. L’alternanza globale può tornare nello stato esterno alla fine pur avendo attraversato prima confini inappropriati. Le aperture ripetute dei paragrafi possono modificarne lo stato e alterare lunghi tratti di copertura senza lasciare uno squilibrio finale. Il controllo conferma continuazioni nel racconto della creatura e in una lettera scritta, ma non classifica ogni token controverso né attribuisce l’intera differenza a una caratteristica. Il campo di variazione osservato appartiene a questa trascrizione e a queste regole, non a Frankenstein in ogni edizione.
Un esame sistematico fisso dei due testi principali
Prima di calcolare i risultati completi, sono state fissate dodici posizioni di paragrafo per libro, con indici equidistanti dal primo all’ultimo paragrafo conservato. La posizione k è 1 + floor(k × (N − 1) / 11), con k da zero a undici e N paragrafi. Sono stati esaminati tutti i ventiquattro paragrafi selezionati. Indici a base uno, hash ed etichette descrittive sono nel file di controllo. La procedura distribuisce l’esame fra inizio, centro e fine senza scegliere passaggi perché producono la divergenza numerica maggiore.
I paragrafi Shelley selezionati includono una continuazione del racconto della creatura, discorso fra virgolette singole annidato in quel racconto, una continuazione della lettera scritta di Elizabeth e testo esplicitamente identificato come iscrizione. Un altro è una nota interna che cita un titolo letterario. Le selezioni Austen includono discorso diretto, narrazione, domande riportate indirettamente e corrispondenza descritta nella narrazione. L’equidistanza non garantisce ogni caratteristica rara; sono descrizioni qualitative dei passaggi, non annotazioni validate indipendentemente. Il controllo sostiene descrizioni delle strutture incontrate, non precisione, richiamo, frequenza d’errore o affidabilità fra valutatori per tutto il corpus.
Perché testo fra virgolette non significa dialogo
Un precedente controllo intenzionale separato aveva esaminato ventisei paragrafi: dodici dalle finestre iniziali e quattordici passaggi diagnostici successivi. Registra lettere Austen con segni di continuazione, discorso riportato annidato, un proverbio citato e apostrofi. In Shelley registra un’esclamazione immaginata del destinatario, riferimenti letterari, frasi parlate dentro una lettera non racchiusa fra virgolette, una domanda riportata senza segni e una lettera su più paragrafi. Questo controllo è distinto dall’insieme sistematico fisso; alcuni paragrafi si sovrappongono, quindi i totali non si sommano come se ogni passaggio fosse unico. Gli esempi mirati non stimano un tasso d’errore.
Queste categorie contano perché citazione tipografica e funzione comunicativa rispondono a domande diverse. Una lettera può essere interamente fra virgolette senza essere uno scambio conversazionale. Un’iscrizione può essere citata come oggetto incontrato da un personaggio. Una frase può richiamare un’opera letteraria; una battuta immaginata può anticipare una risposta anziché rappresentare un evento parlato. Viceversa, la narrazione può riferire una domanda senza citarne le parole. Le regole non risolvono tali distinzioni. Chiamare i risultati percentuali di dialogo introdurrebbe un’affermazione semantica che misura e controlli non hanno validato.
Limiti residui dell’estrazione e portata delle prove
Il controllo sistematico ha individuato una nota Shelley dentro il testo principale; quello mirato precedente ha trovato residui di formattazione Austen intorno al saluto di una lettera. Quei token restano nella specifica invariata. Conservarli rende il calcolo riproducibile, ma impedisce di dire che il denominatore sia prosa narrativa depurata. Rimuoverli richiederebbe una variante di estrazione specificata separatamente e un nuovo calcolo, non una correzione invisibile dei risultati. Analogamente, divisione in parole con alfabeto ASCII, confini di paragrafo ed esclusione delle virgolette singole sono limiti deliberati, non caratteristiche dimostrate ottimali dai risultati.
Il campione è troppo piccolo e intenzionale per conclusioni di popolazione. I testi storici arrivano attraverso trascrizioni contemporanee che possono differire dai libri stampati; non le abbiamo collazionate con immagini di pagina o manoscritti. Non confrontiamo punteggiatura moderna e storica. Manca inoltre uno standard semantico annotato indipendentemente. Queste restrizioni non cancellano le differenze di sensibilità entro lo stesso input, ma ne delimitano il senso: un altro analista può riprodurre il comportamento delle tre procedure su quei byte, non inferire l’intenzione autoriale, l’esperienza del lettore o la correttezza di ogni intervallo.
Ricerca precedente e contributo metodologico circoscritto
L’analisi delle citazioni letterarie è un campo consolidato. Project Dialogism Novel Corpus offre annotazioni delle citazioni e dei loro attributi contestuali, mentre la documentazione LitBank distingue il discorso diretto da altri testi racchiusi fra virgolette. Non presentiamo quindi come scoperta l’osservazione che le virgolette possano racchiudere altro dal dialogo. Lo studio non sostituisce quelle risorse né stabilisce un modello migliore di attribuzione delle citazioni. Le tre regole trasparenti servono a mostrare decisioni di misurazione, non a competere con sistemi addestrati o dimostrare prestazioni allo stato dell’arte.
La prova più circoscritta combina due trascrizioni fissate, un pilota breve senza divergenze, risultati completi materialmente diversi, diagnostiche esplicite e una correzione documentata dell’estrazione. Mostra come un controllo preliminare rassicurante possa essere insufficiente per la portata di un calcolo successivo. I risultati richiedono verifica indipendente di codice e interpretazione; un’esclusione separatamente dichiarata del materiale editoriale o un’annotazione semantica affronterebbero altre incertezze. Aggiungere romanzi prima di quei controlli aumenterebbe il volume senza necessariamente migliorare la validità. Non è prevista ulteriore espansione del corpus in questa analisi.
I confini dei capitoli e le regole di individuazione del testo tra virgolette sono scelte di misurazione distinte; i loro effetti non determinano ritmo narrativo, prevalenza del dialogo o qualità letteraria. Quando la cornice finale cambia la distribuzione delle lunghezze dei capitoli
Riuso, attribuzione e riproducibilità
Le due pagine Gutenberg indicano le opere come di pubblico dominio negli Stati Uniti; intestazioni e licenze ricevute sono state esaminate senza trovare avvisi di opere soggette a restrizioni specifiche. Le indicazioni Gutenberg consentono ricerca su opere non soggette a restrizioni ma non certificano il diritto d’autore in ogni giurisdizione. Autrici e contributori storici sono morti da molto tempo: ciò sostiene una selezione prudente, non un’autorizzazione universale. Alisson Bento è responsabile di analisi, calcoli e spiegazione, non della paternità o proprietà dei romanzi, della prefazione o delle illustrazioni. I download non comprendono romanzi integrali o aggiunte editoriali moderne.
I file accompagnatori contengono conteggi derivati, etichette e hash dei controlli, metodi esatti, codice eseguibile e riferimenti. I file grezzi con licenza restano separati e privati. L’acquisizione ha usato due singoli file di testo da un sito speculare (mirror) elencato da Gutenberg, senza scansione ricorsiva, con richieste distanziate di oltre due secondi. Un vecchio percorso ha restituito 404 prima del successo del percorso generato supportato; non è stata aggirata alcuna restrizione. Pubblicazione originale, edizione fonte, aggiornamento della trascrizione e acquisizione rimangono distinti. Riprodurre i calcoli non autorizza automaticamente a ridistribuire i testi; i requisiti di riuso territoriali sono separati dalla riproducibilità computazionale.
Come le regole sulle virgolette cambiano la misura
Corpi estratti completi · due trascrizioni esatte di Project Gutenberg. QUOTA DI TOKEN TRA VIRGOLETTE — NON DI DIALOGO
Grafico completo e fonte

Scorri il grafico in orizzontale per esaminarlo. ↔
Grafico e valori
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Trascrizione | Token | R1 globale (%) | R2 per paragrafo (%) | R3 continuazione (%) | Campo di variazione (punti percentuali) |
|---|---|---|---|---|---|
| 1342 | 122.174 | 46,8029 | 41,1544 | 46,9372 | 5,7827 |
| 42324 | 75.234 | 51,3398 | 15,6432 | 40,6000 | 35,6966 |
Percentuale dei token di parola dichiarati meccanicamente compresi in tratti completati fra virgolette doppie. Non percentuali di dialogo.
Dati e download
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Trascrizione | Token | R1 globale (%) | R2 per paragrafo (%) | R3 continuazione (%) | Campo di variazione (punti percentuali) |
|---|---|---|---|---|---|
| 1342 | 122.174 | 46,8029 | 41,1544 | 46,9372 | 5,7827 |
| 42324 | 75.234 | 51,3398 | 15,6432 | 40,6000 | 35,6966 |
Percentuale dei token di parola dichiarati meccanicamente compresi in tratti completati fra virgolette doppie. Non percentuali di dialogo.
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Trascrizione | Regola | Token inclusi | Tratti completati | Code non chiuse | Aperture di continuazione | Chiusure isolate | Riaperture interne |
|---|---|---|---|---|---|---|---|
| 1342 | R1 | 57.181 | 1.751 | 0 | 0 | 0 | 0 |
| 1342 | R2 | 50.280 | 1.735 | 32 | 0 | 0 | 0 |
| 1342 | R3 | 57.345 | 1.735 | 0 | 32 | 0 | 0 |
| 42324 | R1 | 38.625 | 388 | 0 | 0 | 0 | 0 |
| 42324 | R2 | 11.769 | 293 | 190 | 0 | 0 | 0 |
| 42324 | R3 | 30.545 | 293 | 0 | 190 | 0 | 0 |
Zero code finali non chiuse non prova una segmentazione corretta. Le code R2 sono residui meccanici dell’alternanza.
Dati e metodo
Come abbiamo calcolato
- Due romanzi fissi originariamente in inglese; hash esatti delle fonti, ancore del testo principale controllate sul contesto e divisione in parole fissata prima del confronto completo.
- Tre regole sulle virgolette invariate; denominatore costante entro la trascrizione; confronti descrittivi e deterministici.
- Primi cinquanta paragrafi conservati come pilota esplorativo; difetto di rimozione delle illustrazioni v0 non valido corretto esplicitamente prima dell’estensione.
- Esaminate dodici posizioni equidistanti per libro; controllo intenzionale precedente etichettato separatamente; nessuna affermazione di accuratezza rispetto a uno standard semantico.
Cosa non possiamo dedurre dai dati
- Campione intenzionale di due trascrizioni; nessuna inferenza su autori, generi, popolazioni, preferenze dei lettori o causalità.
- Lettere citate, riferimenti letterari, iscrizioni e discorso immaginato non sono tutti dialogo parlato; escluse citazioni principali singole o delimitate da trattini.
- Conservati nota interna e residui di formattazione; il divisione in parole con alfabeto ASCII può spezzare parole accentate o con legature; nessuna affermazione sulla tipografia dei manoscritti.
- Nessuna annotazione semantica indipendente; zero code finali non chiuse non prova correttezza; R3 è euristica.
- Giurisdizioni fuori dagli USA non verificate; riproducibilità distinta dai diritti di ridistribuzione dei testi.
Fonti originali
- Project Gutenberg 1342: Pride and Prejudice
Project Gutenberg 1342, Pride and Prejudice: Jane Austen, 1775–1817; indicato di pubblico dominio negli USA. Il frontespizio acquisito identifica George Allen 1894; escluse prefazione Saintsbury e illustrazioni Thomson. Hash esatto dei byte del mirror nel manifesto.
Consultato il 30 ottobre 2026
- Project Gutenberg 42324: Frankenstein
Project Gutenberg 42324, Frankenstein: Mary Shelley, 1797–1851; indicato di pubblico dominio negli USA; versione H. Colburn/R. Bentley 1831. Il file descrive una riproduzione fotografica senza identità bibliografica specifica. Byte esatti fissati.
Consultato il 30 ottobre 2026
- Project Gutenberg License
Project Gutenberg License: riuso per ricerca di opere senza restrizioni; licenza effettiva verificata; giurisdizioni fuori dagli USA non certificate.
Consultato il 30 ottobre 2026
- Project Gutenberg Permission How-to
Project Gutenberg Permission How-to: differenze fra trascrizioni ed edizioni fonte, collegamenti di riconoscimento e limiti territoriali.
Consultato il 30 ottobre 2026
- Project Gutenberg Robot Access
Project Gutenberg Robot Access: nessuna scansione del sito; procedure di acquisizione designate; l’esempio indica intervalli di due secondi.
Consultato il 30 ottobre 2026
- Project Gutenberg Official Mirrors
Project Gutenberg Official Mirrors: elenca il mirror pglaf usato per i due singoli file UTF-8.
Consultato il 30 ottobre 2026
- Project Gutenberg Mirroring How-to
Project Gutenberg Mirroring How-to: indicazioni supportate per i mirror; rsync non disponibile nell’ambiente usato; nessuna copia ricorsiva effettuata.
Consultato il 30 ottobre 2026
- Project Dialogism Novel Corpus paper
Articolo Project Dialogism Novel Corpus: Vishnubhotla, Hammond e Hirst (2022), precedenti sull’annotazione delle citazioni letterarie; nessun testo del corpus acquisito o riusato.
Consultato il 30 ottobre 2026
- LitBank official repository
Repository ufficiale LitBank: distingue discorso diretto da altro testo fra virgolette e considera tipografia oltre tali segni; solo contesto della ricerca precedente.
Consultato il 30 ottobre 2026
- George Saintsbury author metadata
Metadati autoriali George Saintsbury: stabiliscono 1845–1933; prefazione della fonte Austen identificata separatamente, non attribuita ad Austen.
Consultato il 30 ottobre 2026
- Bodleian John Johnson Collection: Hugh Thomson
Bodleian John Johnson Collection, Hugh Thomson: nota istituzionale identifica l’illustratore, 1860–1920; illustrazioni escluse.
Consultato il 30 ottobre 2026
- Jane Austen House: first reading of Pride and Prejudice
Jane Austen House, prima lettura di Pride and Prejudice: pubblicazione originale nel gennaio 1813, distinta dall’edizione fonte 1894 analizzata.
Consultato il 30 ottobre 2026
Citare e riutilizzare lo studio
Alisson Bento. Come le regole sulle virgolette cambiano la misura in due trascrizioni di romanzi. Analisi metodologica delle trascrizioni Project Gutenberg 1342 e 42324, acquisite il 30 ottobre 2026; edizioni storiche delle fonti 1894 e 1831. https://alissonbento.com/it/research/quotation-measurement-sensitivity-two-transcriptions/
Analisi, calcoli e spiegazione: Alisson Bento. Romanzi originali: Jane Austen (1775–1817), Pride and Prejudice, e Mary Wollstonecraft Shelley (1797–1851), Frankenstein. Prefazione della fonte Austen: George Saintsbury (1845–1933); illustrazioni: Hugh Thomson (1860–1920), entrambe escluse. Elementi Gutenberg indicati come di pubblico dominio negli USA; licenze effettive esaminate; nessuna autorizzazione universale o approvazione dichiarata. Forniti solo sintesi derivate, codice, metodi e riferimenti, non romanzi integrali.
Correzioni o domande editoriali