
Mit der Regel verändert sich die Messung
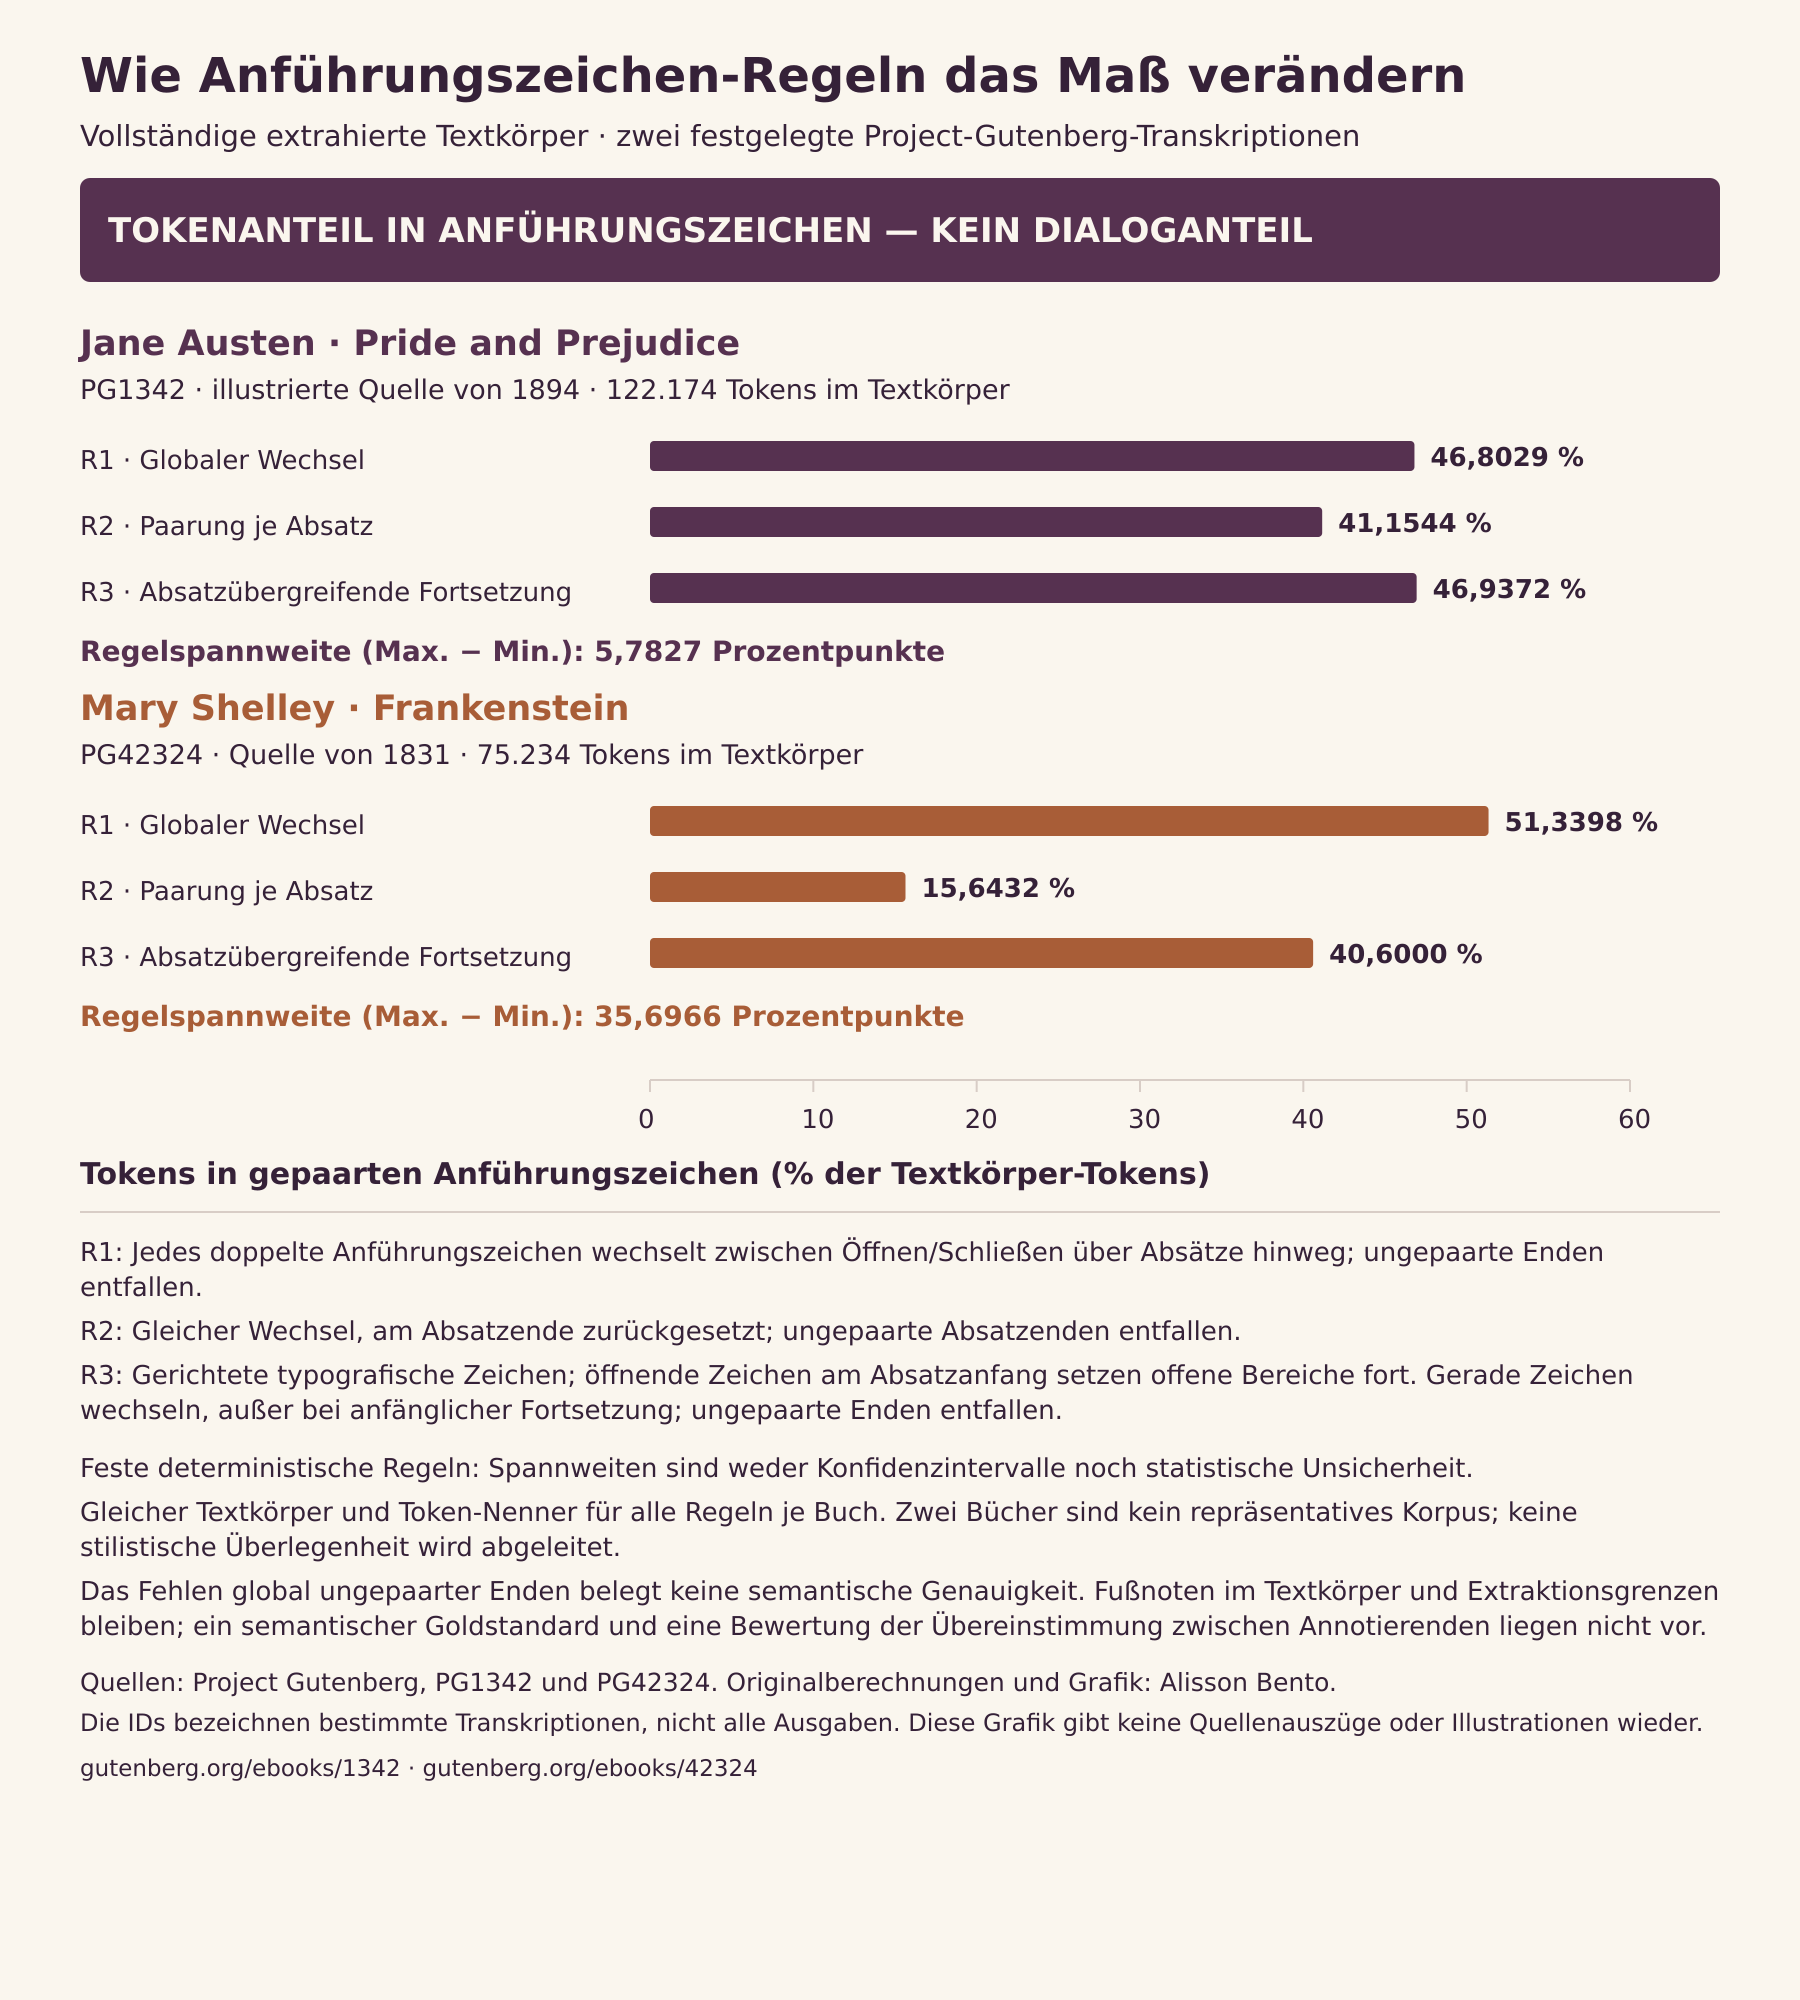
Derselbe digitale Roman kann sehr unterschiedliche Schätzungen für den Anteil des Textes in Anführungszeichen ergeben, ohne dass ein einziges Wort der Eingabe verändert wird. In den beiden untersuchten Transkriptionen liegen zwischen dem größten und dem kleinsten Wert dreier festgelegter Regeln für die Zeichensetzung 5,78 Prozentpunkte bei Pride and Prejudice und 35,70 Prozentpunkte bei Frankenstein. Die Unterschiede betreffen eine mechanische Messung am Text. Sie zeigen weder, wie viel Dialog die jeweilige Autorin verwendete, noch, ob eine Erzählung mehr Gespräch enthält, noch, ob Lesende einen bestimmten Stil bevorzugen. Die Zahl der Wörter in Anführungszeichen hängt davon ab, welche Wörter eine Regel zu den Zitatabschnitten rechnet. Die Gesamtzahl der Wörter hängt von der Transkription und vom Verfahren ab, mit dem der Text ausgelesen wird.
Die Analyse begann bewusst klein: mit den ersten fünfzig beibehaltenen Absätzen jedes Buches. In beiden Anfangsausschnitten lieferten alle drei Regeln identische Prozentwerte. Erst als wir dieselben Regeln auf den ganzen ausgelesenen Haupttext anwendeten, zeigten sich Abweichungen, die vorher verborgen geblieben waren. Diese Abfolge ist für die Fallstudie entscheidend. Dass die Regeln in einem kurzen, leicht zugänglichen Ausschnitt übereinstimmen, reichte nicht aus, um anzunehmen, dass sie sich im ganzen Buch gleich verhalten. Weder die anfängliche Übereinstimmung noch die spätere Abweichung belegt eine allgemeine Eigenschaft von Romanen. Beides sind nachprüfbare Beobachtungen an zwei festgehaltenen Eingaben.
Eine begrenzte Messfrage statt einer literarischen Rangliste
Gemessen wird der Prozentsatz der festgelegten Wörter, die eine bestimmte Regel in einer ausgelesenen Transkription als von doppelten Anführungszeichen eingeschlossen einstuft. Wie stark das Ergebnis von der Regel abhängt, messen wir als Spannweite: größter minus kleinster Prozentwert über die drei Regeln für dieselbe Eingabe. Weil die Gesamtzahl der Wörter innerhalb eines Vergleichs gleich bleibt, lassen sich Entscheidungen über die Grenzen von Zitaten von Unterschieden in der Länge der Bücher trennen. Wir mitteln die beiden Romane nicht zu einer Schätzung für englischsprachige Belletristik. Wir ziehen weder Autorinnen und Autoren noch Erscheinungsjahre, Länder, Genres oder Lesende als Stichprobe heran. Ein Konfidenzintervall für eine gedachte Gesamtheit von Büchern berechnen wir nicht.
Die Auswahl ist gezielt und festgelegt: Project Gutenberg 1342, Pride and Prejudice von Jane Austen, und 42324, die Fassung von Frankenstein von Mary Shelley aus dem Jahr 1831. Gespräche sowie Briefe und Rahmenerzählungen sind unterschiedliche Situationen, an denen man die Regeln gut untersuchen kann. Dieser Grund für die Auswahl trägt aber keinen allgemeinen Vergleich literarischer Stile. Nachdem die Ergebnisse vorlagen, haben wir keinen weiteren Roman ergänzt. Der größere Katalog von Gutenberg, die Verfügbarkeit von Sprachen und die Abdeckung von Formaten liegen außerhalb dieser Untersuchung. Ihr Beitrag ist eine Prüfung der Messung innerhalb bestimmter Texte, keine weitere Zählung von Katalogeinträgen.
Werke, Ausgaben und heruntergeladene Dateien
Die ursprüngliche Autorschaft bleibt bei Austen und Shelley. Austen lebte von 1775 bis 1817, Shelley von 1797 bis 1851. Pride and Prejudice erschien erstmals 1813. Die Angaben auf dem Titelblatt der erhaltenen Datei 1342 bezeichnen aber die illustrierte Ausgabe von George Allen aus dem Jahr 1894. Sie hat ein Vorwort von George Saintsbury und Illustrationen von Hugh Thomson. Saintsbury lebte von 1845 bis 1933, Thomson von 1860 bis 1920. Wir schreiben ihre Beiträge gesondert zu und nicht Austen. Vorwort und Illustrationen gehören nicht zur gemessenen Erzählung. Es ist also kein Vergleich von Erstausgaben.
Eintrag 42324 nennt die Veröffentlichung von H. Colburn und R. Bentley aus dem Jahr 1831. Die Anmerkung der Transkribierenden beschreibt einen fotografischen Nachdruck dieser Ausgabe, ohne dessen eigene bibliografische Identität anzugeben. Wir erfinden sie hier nicht. Die Dateien wurden am 30. Oktober 2026 abgerufen. Die Kopfzeile der Austen-Datei nennt eine Aktualisierung vom 1. September 2026, die zugehörige Webseite dagegen den 29. September. Bei Shelley nennt die Kopfzeile den 23. Oktober. Diese Angaben sind von den historischen Erscheinungsdaten der Ausgaben zu trennen. Die Eingaben sind durch die aufgezeichneten Prüfsummen der Dateien festgelegt, nicht allein durch Titel oder aktuelle Download-Links. Die Zeichensetzung belegt Eigenschaften dieser Transkriptionen, nicht die Typografie der ursprünglichen Manuskripte.
Grenzen des Haupttextes festlegen und beibehalten
Anfang und Ende wurden jeweils mit dem umgebenden Text verglichen. Austens Haupttext beginnt nach Titelangaben, Vorwort und Inhaltsverzeichnis mit dem ersten Satz über eine allgemein anerkannte Wahrheit. Er endet beim letzten Absatz über die Gardiners, vor der Schlussillustration, den Angaben der Druckerei und dem Material von Gutenberg. Shelleys Haupttext beginnt mit Waltons erstem erzählendem Satz nach Einführung und Vorwort. Anrede und Datum des ersten Briefes stehen vor diesem Ankerpunkt und sind ausgeschlossen. Das Ende liegt beim Verschwinden des Geschöpfs, vor der Endmarkierung, den Angaben der Druckerei, den Korrekturen der Transkription und der Lizenz. Spätere Briefdaten, Unterschriften und Anreden bleiben im Text erhalten.
Innerhalb dieser Grenzen entfernen wir ganze Illustrationsblöcke mit einem Verfahren, das die Klammern richtig zuordnet. Auch allein stehende Überschriften von Kapiteln und Briefen werden entfernt. Leerzeilen trennen Absätze, und die beibehaltenen Absätze werden mit zwei Zeilenumbrüchen verbunden. Die genauen Anfangs- und Endpunkte, die Zeichenpositionen im vereinheitlichten Quelltext und die Prüfsummen werden mit dem Programmcode mitgeliefert. Das ist eine nachvollziehbare Vorschrift für das Auslesen. Wir behaupten nicht, dass jedes verbliebene Wort Erzählprosa ist. Fußnoten im Haupttext und Reste der Formatierung, die diese Regeln nicht erfassen, bleiben vorhanden. Diese Grenze haben wir bei der Prüfung bemerkt und beibehalten. Wir haben sie nicht stillschweigend bereinigt, nachdem die Gesamtergebnisse vorlagen.
Drei Regeln, die vor dem Gesamtvergleich festgelegt wurden
R1 ist ein globaler Umschalter für doppelte Anführungszeichen. Typografische (geschwungene) doppelte Zeichen werden wie gerade behandelt. Jedes gefundene Zeichen schaltet zwischen „außerhalb“ und „innerhalb“ um. Ein vollständiges Paar bildet einen Zitatabschnitt, auch über Absatzgrenzen hinweg. Ein offener Rest am Ende bleibt ausgeschlossen. Diese einfache Regel ignoriert die Information über die Richtung geschwungener öffnender und schließender Zeichen. Auch ein öffnendes Zeichen, das am Anfang eines fortgesetzten Absatzes wiederholt wird, löst einen Wechsel aus, obwohl man es beim Lesen als Fortsetzung desselben Zitats versteht.
R2 nutzt dieselbe Logik der Paare, setzt den Zustand aber bei jedem Absatz zurück. Vollständige Paare innerhalb eines Absatzes tragen Wörter bei, ein unvollständiger Rest wird ausgeschlossen, bevor der nächste Absatz beginnt. R3 unterscheidet geschwungene öffnende und schließende Zeichen und führt den Zustand über Absätze hinweg fort. Ist ein Zitat schon offen, gilt ein weiteres öffnendes Zeichen am Absatzanfang als Fortsetzung. Gerade Zeichen schalten sonst um, mit derselben Regel für die Fortsetzung am Absatzanfang. Unerwartete erneute Öffnungen innerhalb eines Zitats und einzelne schließende geschwungene Zeichen werden protokolliert. Das sind drei praktische Definitionen, kein Wettbewerb mit einer gesicherten richtigen Antwort. R3 bleibt eine Faustregel, besonders bei ungewöhnlicher Typografie und gemischten Konventionen für Anführungszeichen.
Wörter, Abdeckung und Diagnosen
Wörter werden durch den festgelegten Ausdruck [A-Za-z]+(?:['’][A-Za-z]+)* erkannt. Gerade oder typografische Apostrophe bleiben innerhalb eines Wortes, wenn Buchstaben sie umgeben. Bindestriche trennen Wörter, Ziffern werden ausgeschlossen. Buchstaben mit Akzent und Ligaturen gehören nicht zu den ASCII-Buchstabenbereichen und können Wörter deshalb teilen. Ein Wort zählt zur Zahl der Wörter in Anführungszeichen, wenn sein Mittelpunkt innerhalb eines vollständigen Zitatabschnitts liegt. Diese Vorgabe macht die Berechnung genau nachvollziehbar. Sie ist aber kein sprachwissenschaftlich umfassendes Verfahren zum Zerlegen von Text in Wörter (Tokenizer). Würde man dieses Verfahren ändern, wäre das eine andere Analyse. Sie gehört nicht zum berichteten Vergleich der Regeln.
Alle drei Regeln ignorieren einfache Anführungszeichen als eigene Grenzen von Abschnitten. Ein einfach zitierter Abschnitt innerhalb eines schon gezählten doppelten Zitats erhöht die Abdeckung nicht zusätzlich, weil seine Wörter schon im äußeren Abschnitt liegen. Einfach zitierte Rede auf oberster Ebene, mit Gedankenstrichen abgegrenzte Rede und nicht markierte berichtete Rede können fehlen. Die Diagnosen zählen vollständige Abschnitte, offene Reste, öffnende Zeichen zur Fortsetzung, einzelne schließende Zeichen und erneute Öffnungen innerhalb eines Zitats. Bei R2 heißt ein offener Rest, dass der Umschalter am Absatzende noch offen ist. Er beweist nicht, dass das auslösende Zeichen inhaltlich ein öffnendes Anführungszeichen war. Listen mit Positionen halten fest, wo diese Reste vorkamen.
Was der Anfangstest zeigte und was nicht
Nach korrigiertem Auslesen enthalten die ersten fünfzig Absätze von Austen 1.254 Wörter. Davon zählt jede Regel 955, das sind 76,1563 %. Der entsprechende Anfang bei Shelley enthält 3.885 Wörter, von denen jede Regel 156 zählt: 4,0154 %. Im Austen-Anfang gibt es 52 vollständige Abschnitte, im Shelley-Anfang 13. Keine Regel lässt am Ende einen offenen Rest zurück. Die Ausschnitte umfassen unterschiedlich viel Text, weil die Absätze unterschiedlich lang sind. Die stark verschiedenen Prozentwerte dürfen weder ganze Romane in eine Rangfolge bringen noch die übliche Praxis der Autorinnen kennzeichnen.
Bevor wir den Anfangstest akzeptierten, fanden wir bei der Prüfung einzelner Textstellen einen Fehler in der ersten Fassung des Auslesens. Ein regulärer Ausdruck (ein Suchmuster) beendete das Entfernen einer Illustration schon an einer verschachtelten Klammer. Zurück blieben Reste von Klammern und eine Illustrationsmarkierung ohne Beschriftung, die Plätze im Ausschnitt der fünfzig Absätze belegten. Das ungültige Ergebnis für Austen lautete 850 von 1.140 Wörtern, also 74,5614 %. Das Verfahren mit richtig zugeordneten Klammern stellte den vorgesehenen Ausschnitt wieder her und änderte den Anteil um 1,5949 Prozentpunkte. Die ungültige Ausgabe bleibt mit ausdrücklicher Kennzeichnung erhalten. Sie belegt einen Fehler in der Umsetzung, keine allgemeine Schätzung für Verzerrungen beim Auslesen. Dass die Regeln übereinstimmten, hatte diesen Fehler nicht aufgedeckt.
Abhängigkeit von der Regel im ganzen Austen-Haupttext
Der vollständig ausgelesene Austen-Haupttext enthält 122.174 Wörter in 2.060 beibehaltenen Absätzen. R1 schließt 57.181 Wörter ein, das sind 46,8029 %. R2 zählt 50.280 Wörter, also 41,1544 %, und R3 57.345 Wörter, also 46,9372 %. Der Unterschied zwischen Maximum und Minimum beträgt 5,7827 Prozentpunkte. R1 findet 1.751 vollständige Abschnitte, R2 und R3 jeweils 1.735. R2 verzeichnet 32 offene Reste am Absatzende, R3 erkennt 32 wiederholte öffnende Zeichen am Absatzanfang. R1 und R3 enden ohne einen offenen Rest am Schluss. R3 protokolliert außerdem keine einzelnen schließenden geschwungenen Zeichen und keine erneuten Öffnungen innerhalb eines Zitats.
Dass die Gesamtanteile des globalen Umschalters und der Regel mit Fortsetzung nahe beieinanderliegen, belegt nicht, dass beide die Abschnitte gleich zuordnen. Gesamtwerte können gegenläufige Veränderungen verdecken, und eine Schätzung der Genauigkeit für einzelne Wörter legen wir nicht vor. Der größere Unterschied zur Regel mit Rücksetzung je Absatz zeigt: Wer vollständige Paare auf einen einzelnen Absatz beschränkt, schließt Text aus, den die anderen Definitionen einschließen. Die Prüfung der Textstellen nennt Briefe über mehrere Absätze als eine relevante Struktur. Ein größerer mechanisch eingeschlossener Anteil darf deshalb nicht automatisch als bessere Erfassung gesprochener Rede gelten. Er kann ebenso mehr von einem Brief oder einem anderen zitierten Schriftstück umfassen.
Abhängigkeit von der Regel im ganzen Shelley-Haupttext
Der vollständig ausgelesene Shelley-Haupttext enthält 75.234 Wörter in 768 beibehaltenen Absätzen. R1 zählt 38.625 Wörter, also 51,3398 %. R2 zählt 11.769 Wörter, also 15,6432 %, und R3 30.545 Wörter, also 40,6000 %. Die Spannweite beträgt 35,6966 Prozentpunkte. R1 meldet 388 vollständige Abschnitte, R2 und R3 jeweils 293. R2 protokolliert 190 offene Reste am Absatzende, R3 erkennt 190 wiederholte öffnende Zeichen am Absatzanfang. Keine der globalen Regeln endet mit einem offenen Rest. Die gemessene Datei verwendet gerade doppelte Zeichen. Deshalb klären die Diagnosen von R3 für einzelne schließende und erneut öffnende geschwungene Zeichen die Fragen zum Inhalt nicht.
Das zeigt, warum eine gerade Zahl von Anführungszeichen am Ende nur eine schwache Qualitätskontrolle ist. Ein globaler Umschalter kann am Schluss wieder außerhalb stehen, obwohl er vorher unpassende Grenzen überschritten hat. Wiederholte öffnende Zeichen am Absatzanfang können den Zustand ändern und lange Strecken der Abdeckung verschieben, ohne am Ende ein Ungleichgewicht zu hinterlassen. Die Prüfung bestätigt Fortsetzungen im Bericht des Geschöpfs und in einem geschriebenen Brief. Sie ordnet aber nicht jedes strittige Wort ein und führt den gesamten Unterschied in den Zahlen nicht auf ein einziges Merkmal zurück. Die beobachtete Spannweite gehört zu dieser Transkription und diesen Regeln, nicht zu Frankenstein in jeder Ausgabe.
Eine feste, systematische Prüfung beider Haupttexte
Bevor wir die Gesamtergebnisse berechneten, legten wir je Buch zwölf Absatzpositionen fest, gleichmäßig verteilt vom ersten bis zum letzten beibehaltenen Absatz. Konkret lautet die Position 1 + floor(k × (N − 1) / 11), wobei k von null bis elf reicht, N die Zahl der beibehaltenen Absätze ist und floor auf die nächste ganze Zahl abrundet. Alle 24 ausgewählten Absätze wurden geprüft. Ihre Positionsnummern, die bei eins beginnen, die Prüfsummen und die beschreibenden Kategorien stehen in der Prüfdatei. Das Verfahren verteilt die Durchsicht über Anfang, Mitte und Ende. Es wählt Absätze nicht danach aus, dass sie besonders große Unterschiede in den Zahlen erzeugen.
Die Auswahl bei Shelley umfasst einen fortgesetzten Teil des Berichts des Geschöpfs mit darin verschachtelter, einfach zitierter Rede. Dazu kommen ein Fortsetzungsabsatz aus Elizabeths geschriebenem Brief und ein Text, der ausdrücklich als Inschrift bezeichnet wird. Ein weiterer Absatz ist eine Fußnote im Haupttext, die einen Werktitel zitiert. Die Auswahl bei Austen enthält direkte Rede, Erzählung, indirekt berichtete Fragen und Korrespondenz, die in der Erzählung beschrieben wird. Gleichmäßige Abstände garantieren nicht, dass seltene Merkmale erfasst werden. Es sind qualitative Beschreibungen einzelner Textstellen, kein unabhängig geprüfter Satz von Annotationen. Die Prüfung stützt konkrete Beobachtungen zu den gefundenen Strukturen. Sie stützt keine Aussagen über Genauigkeit, Trefferquote, Häufigkeit von Fehlern oder Übereinstimmung verschiedener Bewertender im ganzen Korpus.
Warum Text in Anführungszeichen nicht einfach Dialog heißen darf
Eine getrennte, frühere gezielte Prüfung betrachtete 26 Absätze: zwölf aus den Anfangsausschnitten und vierzehn spätere Textstellen für die Diagnose. Bei Austen dokumentiert sie Briefe mit Zeichen für die Fortsetzung, verschachtelte berichtete Rede, ein zitiertes Sprichwort und Apostrophe. Bei Shelley dokumentiert sie einen vorgestellten Ausruf einer Empfängerin oder eines Empfängers, literarische Verweise und gesprochene Aussagen innerhalb eines nicht zitierten Briefes. Dazu kommen eine berichtete Frage ohne Anführungszeichen und ein geschriebener Brief über mehrere Absätze. Diese Auswahl ist von der festen systematischen Prüfung getrennt. Manche Absätze überschneiden sich. Die Zahlen darf man deshalb nicht addieren, als wäre jede geprüfte Textstelle verschieden. Gezielte Beispiele dienen nicht dazu, eine Fehlerrate zu schätzen.
Diese Kategorien sind wichtig, weil das typografische Zitieren und die Funktion in der Kommunikation verschiedene Fragen beantworten. Ein geschriebener Brief kann ganz in Anführungszeichen stehen, ohne ein Gespräch zu sein. Eine Inschrift kann als Gegenstand zitiert werden, dem eine Figur begegnet. Ein Ausdruck kann auf ein literarisches Werk verweisen, und vorgestellte Rede kann eine erwartete Antwort darstellen statt einer tatsächlich gesprochenen. Umgekehrt kann eine Erzählung berichten, jemand habe eine Frage gestellt, ohne die Worte als Zitat zu markieren. Die Regeln lösen diese Unterschiede nicht auf. Ihre Ergebnisse „Dialogprozente“ zu nennen, würde eine Aussage über den Inhalt hinzufügen, die weder die Messung noch die Prüfung bestätigt hat.
Verbleibende Grenzen beim Auslesen und Reichweite der Belege
Die feste systematische Prüfung fand eine Fußnote von Shelley im Haupttext. Die frühere gezielte Prüfung fand bei Austen übrig gebliebene Formatierungszeichen um eine Briefanrede. Diese Wörter bleiben bei der unveränderten Vorschrift zum Auslesen erhalten. Das macht die festgehaltene Berechnung nachvollziehbar. Man darf aber nicht behaupten, die Gesamtzahl der Wörter bestehe aus vollständig bereinigter Erzählprosa. Um die Fußnote oder die Formatierung zu entfernen, bräuchte man eine eigens festgelegte Variante des Auslesens samt neuer Berechnung. Eine unsichtbare Korrektur der vorliegenden Zahlen wäre kein Ersatz. Ebenso sind die ASCII-Zerlegung in Wörter, der Umgang mit Absatzgrenzen und der Ausschluss einfacher Anführungszeichen bewusste Grenzen. Sie sind keine Eigenschaften, die die Ergebnisse als beste Lösung nachgewiesen hätten.
Die Auswahl ist zu klein und zu gezielt, um daraus Schlüsse über eine Gesamtheit zu ziehen. Die historischen Texte liegen hier als heutige Transkriptionen vor, die von den gedruckten Vorlagen abweichen können. Wir haben sie nicht mit Seitenbildern oder Manuskripten abgeglichen. Einen Vergleich moderner mit historischer Zeichensetzung gibt es nicht. Außerdem fehlt ein unabhängig annotierter Goldstandard für den Inhalt. Das hebt die Unterschiede in der Abhängigkeit von der Regel innerhalb der Eingaben nicht auf, begrenzt aber ihre Bedeutung. Reproduzierbar ist, wie sich diese drei Verfahren auf genau diesen Dateien verhalten. Daraus folgen weder Absichten der Autorinnen noch Leseerfahrungen oder die Richtigkeit jedes Abschnitts.
Vorarbeiten und der engere methodische Beitrag
Die Analyse literarischer Zitate ist ein etabliertes Forschungsfeld. Der Project Dialogism Novel Corpus stellt Annotationen zu literarischen Zitaten und ihren Kontextmerkmalen bereit. Die Dokumentation von LitBank zu Zitaten unterscheidet direkte Rede von anderem Text in Anführungszeichen. Dass Anführungszeichen mehr als Dialog einschließen können, stellen wir deshalb nicht als Entdeckung dar. Die Studie ersetzt diese Ressourcen nicht und begründet kein besseres Verfahren, um Zitate den Sprechenden zuzuordnen. Ihre drei durchsichtigen Regeln sollen Entscheidungen bei der Messung sichtbar machen. Sie sollen nicht mit Systemen konkurrieren, die an Beispielen trainiert wurden, und keinen neuen Stand der Technik zeigen.
Der engere Beitrag liegt in der Kombination mehrerer Teile. Dazu gehören ein Vergleich zweier festgehaltener Transkriptionen, ein Anfangstest ohne Unterschiede zwischen den Regeln, ein deutlich anderes Ergebnis für den ganzen Text, ausdrückliche Diagnosen des Programms zum Erkennen der Zitatabschnitte (Parser) und eine dokumentierte Korrektur beim Auslesen. Sie zeigt einen konkreten Fall, in dem eine beruhigende Vorprüfung nicht ausreicht, um zu beurteilen, wie weit eine spätere Berechnung trägt. Programmcode und Deutung brauchen eine unabhängige Überprüfung. Ein gesondert festgelegter Ausschluss zusätzlichen Materials oder eine Annotation des Inhalts würde andere verbleibende Unsicherheiten angehen. Mehr Romane vor solchen Prüfungen würden die Menge erhöhen, aber nicht zwangsläufig die Gültigkeit verbessern. Eine weitere Erweiterung des Korpus gehört nicht zu dieser Analyse.
Kapitelgrenzen und Regeln für Text in Anführungszeichen sind zwei verschiedene Messentscheidungen. Ihre Auswirkungen sagen nichts über Erzähltempo, Dialoganteil oder literarische Qualität aus. Wenn eine abschließende Rahmenerzählung die Verteilung der Kapitellängen verändert
Weiterverwendung, Zuschreibung und Reproduzierbarkeit
Die beiden Eintragsseiten von Gutenberg kennzeichnen die Werke als in den Vereinigten Staaten gemeinfrei. Bei der Durchsicht der erhaltenen Dateiköpfe und Lizenzen fanden wir keinen Hinweis auf ein Werk mit Einschränkungen. Die Hinweise von Gutenberg erlauben Forschung an Werken ohne Einschränkungen, bescheinigen aber nicht den Urheberrechtsstatus in jeder Rechtsordnung. Dass die historischen Autorinnen und Mitwirkenden lange verstorben sind, spricht für eine vorsichtige Auswahl der Quellen. Es liefert aber keine rechtliche Freigabe für die ganze Welt. Alisson Bento verantwortet die Analyse, die Berechnungen und die Erläuterung, nicht die Autorschaft oder das Eigentum an den Romanen, am historischen Vorwort oder an den Illustrationen. Die öffentlichen Downloads enthalten keine vollständigen Romane und keine redaktionellen Ergänzungen moderner Ausgaben.
Die Begleitdateien enthalten abgeleitete Zahlen, Beschreibungen der Prüfungen und Prüfsummen, die genauen Methoden zum Auslesen, ausführbaren Programmcode für die Analyse und Verweise auf die Quellen. Die lizenzierten Rohdateien bleiben getrennt und privat. Abgerufen wurden zwei einzelne Textdateien von einem Spiegelserver, den Gutenberg aufführt, ohne rekursives Durchsuchen. Zwischen den Anfragen lagen mehr als zwei Sekunden. Ein veralteter Dateipfad lieferte den Fehler 404, bevor der unterstützte erzeugte Pfad funktionierte. Es wurde keine Zugriffsbeschränkung umgangen. Die Daten der Erstveröffentlichung, der Quellenausgabe, der Aktualisierung der Transkription und des Abrufs bleiben getrennt. Dass man die Berechnungen nachrechnen kann, erlaubt nicht automatisch, den Quelltext weiterzuverteilen. Anforderungen an die Nutzung, die vom Rechtsraum abhängen, sind etwas anderes als das technische Nachrechnen.
Wie die Regeln für Anführungszeichen das Messergebnis verändern
Vollständig ausgelesene Haupttexte · zwei festgelegte Transkriptionen von Project Gutenberg. ANTEIL DER WÖRTER IN ANFÜHRUNGSZEICHEN — KEIN ANTEIL VON DIALOG
Vollständige Grafik und Quelle

Diagramm seitlich scrollen, um alle Details zu sehen. ↔
Grafik und Werte
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Transkription | Wörter | R1 global (%) | R2 je Absatz (%) | R3 mit Fortsetzung (%) | Spannweite (Prozentpunkte) |
|---|---|---|---|---|---|
| 1342 | 122.174 | 46,8029 | 41,1544 | 46,9372 | 5,7827 |
| 42324 | 75.234 | 51,3398 | 15,6432 | 40,6000 | 35,6966 |
Prozent der festgelegten Wörter, die rein mechanisch innerhalb vollständiger doppelter Zitatabschnitte liegen. Keine Dialogprozente.
Daten und Downloads
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Transkription | Wörter | R1 global (%) | R2 je Absatz (%) | R3 mit Fortsetzung (%) | Spannweite (Prozentpunkte) |
|---|---|---|---|---|---|
| 1342 | 122.174 | 46,8029 | 41,1544 | 46,9372 | 5,7827 |
| 42324 | 75.234 | 51,3398 | 15,6432 | 40,6000 | 35,6966 |
Prozent der festgelegten Wörter, die rein mechanisch innerhalb vollständiger doppelter Zitatabschnitte liegen. Keine Dialogprozente.
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Transkription | Regel | Eingeschlossene Wörter | Vollständige Abschnitte | Offene Reste | Fortsetzungen am Absatzanfang | Einzelne schließende Zeichen | Erneute Öffnungen im Zitat |
|---|---|---|---|---|---|---|---|
| 1342 | R1 | 57.181 | 1.751 | 0 | 0 | 0 | 0 |
| 1342 | R2 | 50.280 | 1.735 | 32 | 0 | 0 | 0 |
| 1342 | R3 | 57.345 | 1.735 | 0 | 32 | 0 | 0 |
| 42324 | R1 | 38.625 | 388 | 0 | 0 | 0 | 0 |
| 42324 | R2 | 11.769 | 293 | 190 | 0 | 0 | 0 |
| 42324 | R3 | 30.545 | 293 | 0 | 190 | 0 | 0 |
Null offene Reste am Schluss beweisen keine richtige Aufteilung. Offene Reste bei R2 sind mechanische Reste des Umschaltens.
Daten und Methode
So haben wir gerechnet
- Wir verwenden zwei feste, ursprünglich englischsprachige Romane mit genauen Prüfsummen der Quellen, mit dem umgebenden Text abgeglichenen Ankerpunkten für den Haupttext und einer Zerlegung in Wörter, die vor dem Gesamtvergleich festgelegt wurde.
- Wir wenden drei unveränderte Regeln für Anführungszeichen an. Innerhalb jeder Transkription bleibt die Gesamtzahl der Wörter gleich. Alle Vergleiche sind beschreibend und deterministisch.
- Die ersten fünfzig beibehaltenen Absätze behalten wir als erkundenden Anfangstest. Einen Fehler der ungültigen ersten Fassung (v0) beim Entfernen von Illustrationen haben wir vor der Erweiterung offen korrigiert.
- Wir haben je Buch zwölf gleichmäßig verteilte Absätze geprüft. Die frühere gezielte Prüfung ist gesondert gekennzeichnet. Aussagen zur Genauigkeit auf Grundlage eines Goldstandards für den Inhalt machen wir nicht.
Was die Daten nicht aussagen
- Die Auswahl der zwei Transkriptionen ist gezielt. Wir ziehen keine Schlüsse auf Autorinnen und Autoren, Genres, Gesamtheiten, Vorlieben von Lesenden oder Ursachen.
- Zitierte Briefe, literarische Verweise, Inschriften und vorgestellte Rede sind nicht durchgehend gesprochener Dialog. Einfache Zitate auf oberster Ebene und Rede mit Gedankenstrichen sind ausgeschlossen.
- Eine Fußnote im Haupttext und Reste der Formatierung bleiben erhalten. Die ASCII-Zerlegung teilt Wörter mit Akzenten oder Ligaturen. Über die Typografie von Manuskripten sagen wir nichts.
- Es gibt keine unabhängige Annotation des Inhalts. Null offene Reste am Schluss beweisen keine Richtigkeit. R3 ist eine Faustregel.
- Die Rechtslage außerhalb der USA ist nicht geprüft. Nachrechnen und Rechte zur Weiterverteilung des Quelltextes sind getrennte Fragen.
Originalquellen
- Project Gutenberg 1342: Pride and Prejudice
Project Gutenberg 1342: Pride and Prejudice: Jane Austen, 1775–1817; als gemeinfrei in den USA gekennzeichnet. Die Titelangaben der Textdatei nennen George Allen 1894; das Vorwort von Saintsbury und die Illustrationen von Thomson sind ausgeschlossen. Die genaue Prüfsumme der vom Spiegelserver bezogenen Datei steht im Quellenverzeichnis.
Abgerufen am 30. Oktober 2026
- Project Gutenberg 42324: Frankenstein
Project Gutenberg 42324: Frankenstein: Mary Shelley, 1797–1851; als gemeinfrei in den USA gekennzeichnet; Fassung von H. Colburn/R. Bentley, 1831. Die Datei beschreibt einen fotografischen Nachdruck, dessen bibliografische Identität nicht angegeben ist. Die genaue Datei ist festgehalten.
Abgerufen am 30. Oktober 2026
- Project Gutenberg License
Project-Gutenberg-Lizenz: Nutzung für Forschung bei Werken ohne Einschränkungen; die tatsächliche Lizenz der Datei wurde geprüft; die Rechtslage außerhalb der USA wird nicht bescheinigt.
Abgerufen am 30. Oktober 2026
- Project Gutenberg Permission How-to
Project Gutenberg Permission How-to: Unterschiede zwischen Transkription und Quellenausgabe, Verlinkung der Quellenangabe und rechtliche Grenzen.
Abgerufen am 30. Oktober 2026
- Project Gutenberg Robot Access
Project Gutenberg Robot Access: Kein Crawl der Website; vorgesehene Wege zum Abruf; das Beispiel nennt zwei Sekunden Abstand.
Abgerufen am 30. Oktober 2026
- Project Gutenberg Official Mirrors
Offizielle Project-Gutenberg-Spiegelserver: Führt den pglaf-Spiegelserver auf, der für beide einzelnen UTF-8-Dateien verwendet wurde.
Abgerufen am 30. Oktober 2026
- Project Gutenberg Mirroring How-to
Project Gutenberg Mirroring How-to: Anleitung zum Spiegeln, die unterstützt wird; rsync war hier nicht verfügbar; es wurde keine rekursive Spiegelung durchgeführt.
Abgerufen am 30. Oktober 2026
- Project Dialogism Novel Corpus paper
Veröffentlichung zum Project Dialogism Novel Corpus: Vishnubhotla, Hammond und Hirst (2022), Vorarbeiten zur Annotation literarischer Zitate; kein Text des Korpus heruntergeladen oder weiterverwendet.
Abgerufen am 30. Oktober 2026
- LitBank official repository
Offizielles LitBank-Repository: Die Ebene für Zitate unterscheidet direkte Rede von anderem Text in Anführungszeichen und behandelt auch Typografie jenseits der Anführungszeichen; nur Hintergrund zu Vorarbeiten.
Abgerufen am 30. Oktober 2026
- George Saintsbury author metadata
Angaben zum Autor George Saintsbury (Metadaten): Sie belegen 1845–1933; sein Vorwort zur Austen-Quelle wird gesondert zugeschrieben, nicht Austen.
Abgerufen am 30. Oktober 2026
- Bodleian John Johnson Collection: Hugh Thomson
Bodleian John Johnson Collection: Hugh Thomson: Der Hinweis der Institution zur Sammlung nennt den Illustrator Hugh Thomson, 1860–1920; Illustrationen ausgeschlossen.
Abgerufen am 30. Oktober 2026
- Jane Austen House: first reading of Pride and Prejudice
Jane Austen House: Erste Lesung von Pride and Prejudice: Historische Erstveröffentlichung im Januar 1813, getrennt von der analysierten Quellenausgabe von 1894.
Abgerufen am 30. Oktober 2026
Studie zitieren und weiterverwenden
Alisson Bento. Wie die Regel für Anführungszeichen das Messergebnis in zwei Roman-Transkriptionen verändert. Methodische Analyse der Transkriptionen 1342 und 42324 von Project Gutenberg, abgerufen am 30. Oktober 2026; historische Quellenausgaben 1894 und 1831. https://alissonbento.com/de/research/quotation-measurement-sensitivity-two-transcriptions/
Analyse, Berechnungen und Erläuterung: Alisson Bento. Originalromane: Jane Austen (1775–1817), Pride and Prejudice, und Mary Wollstonecraft Shelley (1797–1851), Frankenstein. Vorwort der Austen-Quelle: George Saintsbury (1845–1933); Illustrationen: Hugh Thomson (1860–1920); beides ist ausgeschlossen. Die Einträge von Gutenberg sind als gemeinfrei in den USA gekennzeichnet; die tatsächlichen Lizenzen wurden geprüft. Wir behaupten weder eine rechtliche Freigabe für die ganze Welt noch eine Billigung. Bereitgestellt werden nur abgeleitete Zusammenfassungen, Programmcode, Methoden und Verweise, keine vollständigen Romane.
Korrekturen oder redaktionelle Fragen