
O resultado e a decisão de quem lê
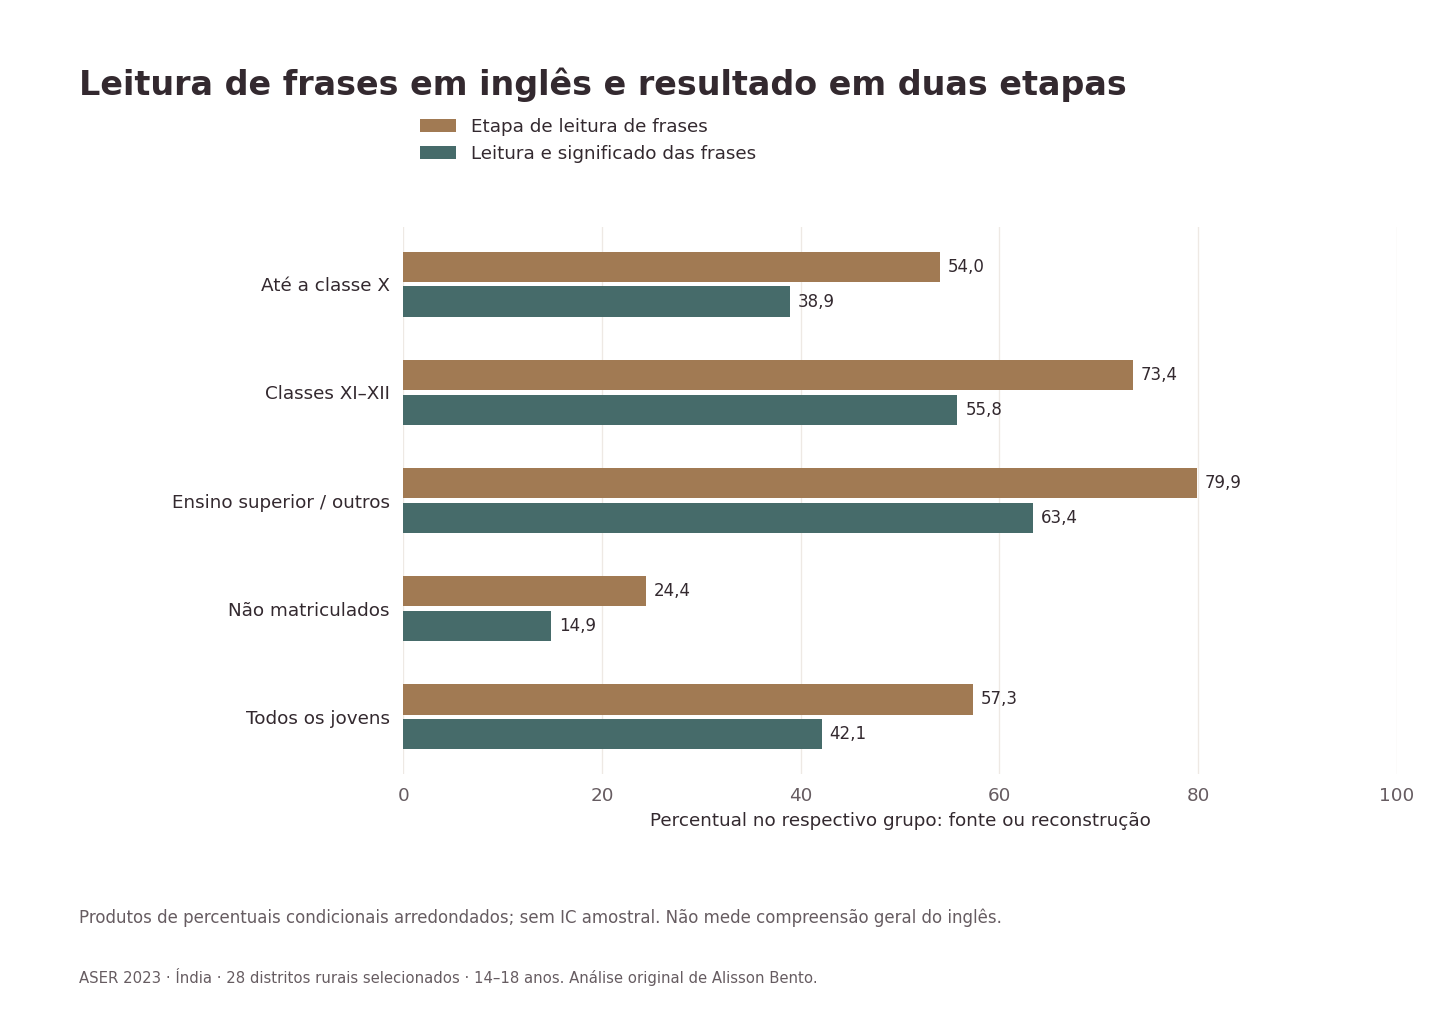
Na amostra do ASER 2023 (Annual Status of Education Report, a pesquisa indiana sobre a educação no meio rural) com jovens de 14 a 18 anos de 28 distritos rurais selecionados, 57,3% chegaram à etapa de leitura de frases em inglês. Entre esse grupo, 73,5% conseguiram dar os sentidos exigidos das frases. A reconstrução do resultado observado em duas etapas dá cerca de 42,1% do grupo completo da fonte passando nas duas etapas. Os 73,5% respondem a outra pergunta: o sucesso entre quem lê frases. Nenhum dos dois percentuais é uma estimativa nacional de compreensão do inglês, uma medida de leitura de um e-book nem um diagnóstico de um jovem em particular.
Esta referência torna explícita essa mudança de denominador em todas as células de matrícula por sexo das duas tabelas relevantes da fonte. Ela traz os valores numéricos originais, a multiplicação, cinco comparações pareadas e uma faixa transparente para o arredondamento dos dados de entrada. O cálculo não acrescenta nenhum respondente novo à pesquisa. O seu valor é ser uma ponte que se pode auditar entre um resultado condicional e o grupo maior do qual saíram os leitores bem-sucedidos. Quem edita um texto pode manter a condição correta no título, e quem publica e planeja material educativo pode ver por que uma taxa de sucesso alta em uma etapa posterior não prova um alcance igualmente amplo.
As duas perguntas por trás da manchete
O relatório do ASER Centre separa a leitura de uma frase curta em inglês da demonstração do seu sentido dentro do procedimento de avaliação. A Tabela 13 informa a parcela que chega ao nível de leitura de frases em cada grupo da fonte. A Tabela 14 informa, em seguida, o desempenho no sentido entre esses leitores de frases. Os dois percentuais são legítimos. Mas, colocados lado a lado sem as suas bases, o segundo pode parecer outro percentual sobre todas as pessoas. Ler “73,5% conseguem dar os sentidos” como uma afirmação sem condição eliminaria da fonte uma etapa importante de seleção.
O procedimento de origem é mais específico do que o domínio geral do inglês. Ele usa um pequeno conjunto de frases curtas e um limiar definido de leitura. O sentido pode ser comunicado na língua local, e as instruções de correção permitem uma explicação pelas principais palavras sublinhadas, sem exigir uma tradução bem acabada. Esta análise não reproduz essas questões protegidas por direitos autorais. Ela segue o encaminhamento entre as etapas para identificar o denominador. Passar neste protocolo não prova que a pessoa entenda todas as frases de um romance, acompanhe um argumento longo, avalie um site desconhecido ou aprenda bem em um curso só em inglês.
Outra diferença importa: quem está abaixo do nível de leitura de frases pode ter outros conhecimentos da língua. A fonte tem uma rota separada, para o sentido de palavras, para quem está no nível de palavras. Essa rota fica fora das tabelas selecionadas e fora deste cálculo. O complemento do resultado em duas etapas não deve, por isso, ser descrito como as pessoas que não entendem nada de inglês. Ele inclui vários caminhos observados diferentes e deixa sem medir muitas formas de uso da língua. Uma afirmação sobre um caminho de teste específico deve continuar sendo uma afirmação sobre esse caminho.
Reconstruir a base maior
Seja R chegar à etapa de leitura de frases e M o resultado bem-sucedido de sentido das frases, entre esses leitores, na fonte. A identidade necessária é P(R e M) = P(R) × P(M dado R). Para o total da fonte, o cálculo é 0,573 × 0,735 = 0,421155. Em porcentagem, isso é 42,1155%, exibido como cerca de 42,1%. A multiplicação não supõe que a leitura e o sentido sejam independentes. Ela funciona porque o segundo percentual condiciona de forma explícita à primeira etapa.
Um grupo imaginário de cem pessoas ajuda a acompanhar as bases. Cerca de 57,3 chegariam à primeira etapa. Aplicar a taxa condicional de sentido relatada a esses 57,3 dá cerca de 42,1 com os dois sucessos registrados. Cerca de 15,2 pontos percentuais correspondem a leitores de frases sem resultado bem-sucedido no sentido das frases, segundo a definição selecionada do relatório. São traduções aritméticas de taxas publicadas e arredondadas, e não contagens reconstruídas de pessoas. Nenhuma fração de pessoa foi observada, e multiplicar o resultado pelo tamanho total da amostra não recuperaria um número exato de respondentes.
A taxa condicional supera a taxa reconstruída do grupo completo em cerca de 31,4 pontos percentuais. Essa diferença não é uma piora no desempenho de ninguém. É só uma mudança de denominador. O numerador se refere ao mesmo sucesso observado nas duas etapas, e a base passa dos leitores de frases para o grupo completo da fonte. Falar em exagero só cabe quando alguém de fato liga a taxa condicional à base completa. A própria fonte declara a condição corretamente; não há necessidade de inventar um erro no relatório original para explicar a diferença.
O que as linhas de matrícula acrescentam
A análise mantém as quatro categorias de matrícula e o total separado. Ela não escolhe só a linha mais chamativa. Para os jovens matriculados até a classe X (em inglês, Standard X, uma série escolar indiana), os dados da fonte para os dois sexos juntos são 54,0% que chegam ao nível de frases e 72,0% de sucesso no sentido entre esses leitores. O resultado reconstruído das duas etapas é de 38,9% desse grupo de matrícula. Para as classes XI ou XII, 73,4% e 76,0% dão cerca de 55,8%. Para a categoria ensino superior ou outros, 79,9% e 79,3% dão cerca de 63,4%.
Entre os não matriculados, 24,4% chegam ao nível de frases e 60,9% desse subconjunto atendem ao critério de sentido. O produto é de cerca de 14,9% do grupo não matriculado da fonte. Informar só o número condicional esconderia quão poucos respondentes desse grupo entram na base do sentido das frases. Faria também os grupos de matriculados e não matriculados parecerem mais semelhantes no alcance total observado do que indicam os produtos das duas etapas. As tabelas apoiam essas comparações descritivas; elas não explicam por que os grupos diferem.
As categorias de matrícula também diferem em idade, escolaridade anterior e outras circunstâncias. Comparar quem está no nível universitário com quem não está matriculado não estima o que a matrícula faria com uma mesma pessoa. A análise não faz nenhum ajuste para essas diferenças de composição, e as tabelas agregadas selecionadas não permitem fazê-lo. Quem oferece educação pode usar as linhas para reconhecer que uma única suposição sobre a língua pode alcançar de modo diferente os grupos da fonte. Não pode usá-las para atribuir um retorno causal à escolarização, ordenar instituições de ensino ou prever o resultado de um aluno em particular.
Uma comparação pareada que muda de direção
A linha dos não matriculados traz um alerta útil sobre transferir para o caminho completo a direção de uma pequena comparação da primeira etapa. As taxas relatadas de leitura de frases são 24,3% para o sexo masculino e 24,5% para o feminino: uma diferença feminino menos masculino de 0,2 ponto percentual. As taxas condicionais de sentido são de 63,5% e 58,8%, respectivamente. Multiplicar os pares correspondentes dá cerca de 15,4% para o masculino e 14,4% para o feminino que passam nas duas etapas. A diferença feminino menos masculino resultante é de aproximadamente menos 1,0 ponto percentual.
Essa mudança de direção é uma propriedade aritmética das estimativas publicadas selecionadas, e não uma diferença demonstrada na população nem a afirmação de que um sexo seria naturalmente melhor com línguas. As duas taxas, a de cada etapa, entram no resultado conjunto. Uma pequena vantagem em uma etapa pode conviver com um produto menor se a segunda taxa condicional for diferente o bastante. O exemplo é útil porque o leitor pode conferir cada dado de entrada em uma única página da fonte. Ele não deve virar uma manchete sensacionalista que separe os números da sua amostra restrita, da tarefa, do arredondamento e da falta de incerteza amostral.
As cinco comparações pareadas são fornecidas, inclusive a do total, para que o exemplo não esconda linhas em sentido contrário. As estimativas das duas etapas para o grupo completo da fonte são de cerca de 43,5% para o masculino e 41,0% para o feminino, uma diferença feminino menos masculino de aproximadamente menos 2,5 pontos. Essas descrições de grupo se sobrepõem às linhas de matrícula e não devem ser somadas. As tabelas classificam o sexo nas duas categorias que a fonte mostra; a análise não deduz mais informações de gênero nem estende essas categorias a todas as identidades possíveis.
O que as margens de arredondamento mostram
As duas tabelas da fonte exibem os percentuais com uma casa decimal. O cálculo para download trata cada dado exibido como compatível com um valor dentro de 0,05 ponto percentual, limitado ao intervalo de zero a cem. Multiplicar os extremos inferiores e os extremos superiores dá uma faixa determinística para o produto, condicionada a essa tolerância de arredondamento. Para o total combinado da fonte, ela vai de cerca de 42,0501% a 42,1809%. Exibir o produto com uma casa decimal é, portanto, uma escolha de comunicação, e não evidência desse nível de exatidão estatística.
Para uma diferença pareada, o limite inferior conservador subtrai o extremo superior do produto masculino do extremo inferior do produto feminino. O limite superior faz o contrário. Na linha dos não matriculados, o intervalo resultante vai de cerca de menos 1,1101 a menos 0,9390 ponto percentual. Assim, o arredondamento comum de uma casa decimal dentro da tolerância declarada não apaga a mudança de direção nestas estimativas exibidas. Essa é toda a afirmação. O cálculo não mostra que um intervalo de confiança baseado no desenho da amostra excluiria o zero.
O erro de amostragem, a falta de resposta, o erro de medição e outras limitações que não vêm da amostragem ficam fora dessas faixas de arredondamento. As tabelas selecionadas não trazem a covariância nem a incerteza específica de cada célula, necessárias para calcular um erro-padrão justificado para cada novo produto ou diferença pareada. Esta referência não traz, por isso, valores-p, asteriscos de significância, intervalos de confiança de amostragem nem afirmações de equivalência. Uma faixa de arredondamento estreita pode conviver com uma incerteza de amostragem grande. Quem lê deve manter essas duas incertezas separadas sempre que um percentual calculado parecer preciso.
A população da fonte é mais estreita do que a Índia
A fonte pesquisou 34.745 jovens de 14 a 18 anos em 28 distritos rurais de 26 estados. O relatório descreve isso como um distrito rural selecionado na maioria dos estados principais, com dois em Uttar Pradesh e em Madhya Pradesh. Estes resultados não são apresentados aqui como uma estimativa representativa de todo o país para todos os jovens rurais, muito menos para todos os adolescentes indianos. O total combinado da fonte é mantido como total combinado da fonte. Ele não é rebatizado como taxa de prevalência para a Índia inteira só porque os distritos cobrem muitos estados.
Esta referência também não traz nenhuma tendência no tempo. ASER 2023 é o rótulo da observação; examinar o relatório em outubro de 2026 não torna as medições atuais para 2026. O cálculo não combina as amostras de 2017 e de 2023 nem interpreta as suas diferenças como mudanças nos mesmos lugares e nas mesmas pessoas. Também não compara as tarefas de inglês diretamente com PISA, PIRLS, PIAAC, um exame comercial de idioma ou avaliações de leitura em línguas regionais. Tarefas, populações e regras de encaminhamento diferentes impedem que esses instrumentos compartilhem um denominador só porque todos envolvem leitura.
Como quem publica e quem edita podem usar o resultado
Uma conferência independente deve começar pelos cabeçalhos das tabelas, e não pela calculadora. Confirme que a primeira célula se refere ao grupo selecionado de matrícula e sexo e, depois, que a segunda se refere aos leitores de frases dentro desse mesmo grupo. Mantenha à parte a linha do total da fonte. Só então multiplique os dois percentuais e divida por cem. Se um dos dados vier de outro distrito, faixa etária, ano da pesquisa ou nível de leitura, a mesma aritmética ainda dará um número, mas ele não reconstruirá mais o resultado descrito aqui. Uma fórmula que funciona não conserta dados incompatíveis.
A receita portátil também faz uma distinção editorial útil entre um número que se pode reproduzir e uma afirmação que se pode sustentar. Reproduzir 42,1155 a partir de 57,3 e 73,5 confere uma operação. Isso não valida por si só o trabalho de campo do ASER, não remove as limitações de seleção da fonte e não estabelece a exatidão de cada taxa exibida. Por outro lado, essas limitações não tornam sem sentido a identidade dos denominadores. Elas dizem o que o número reconstruído descreve e quais outras afirmações precisam de evidência. Manter esses passos separados é especialmente valioso quando uma tabela da fonte é resumida de novo em um gráfico, em uma reportagem ou em uma resposta extraída automaticamente.
Para quem edita, o resultado prático é uma atribuição curta que mantém a base na frase: cerca de 42,1% dos jovens do grupo combinado de distritos selecionados da fonte passaram nas duas etapas, de leitura e de sentido de frases em inglês, reconstruídas a partir dos percentuais condicionais arredondados do relatório. Se o número condicional for mais relevante para a matéria, mantenha a sua condição. As duas afirmações podem ser corretas. O erro é usar o número condicional, maior, com o rótulo de uma população mais ampla, ou converter um resultado de tarefa específica em um julgamento amplo sobre compreensão.
Para quem projeta material de leitura, o resultado sustenta uma pergunta a testar, e não uma receita pronta. Uma página de entrada só em inglês supõe duas capacidades que deveriam ser verificadas separadamente? Uma introdução na língua local, uma explicação em áudio ou um exemplo resolvido poderiam deixar a tarefa mais clara? Este estudo não testou nenhum desses desenhos e não pode prometer que melhorem a leitura ou o engajamento. Ele identifica a distinção entre etapas da fonte que um estudo responsável de usabilidade deveria preservar, em vez de achatá-la em um único rótulo de proficiência.
Os arquivos facilitam a reutilização sem distribuir a avaliação da fonte. A matriz da fonte lista as 30 entradas numéricas selecionadas; os resultados identificam os 15 produtos e as cinco comparações pareadas; o código reproduzível declara cada operação. Os gráficos originais usam os mesmos denominadores da tabela acessível. O ASER Centre recebe o crédito da fonte, e Alisson Bento é creditado por este cálculo secundário e pela explicação. Não se alega nenhum aval do ASER, licença dos instrumentos, nova pesquisa, nota individual ou relação universal antes desconhecida. A contribuição é uma reconstrução que se pode inspecionar e que ajuda quem lê a levar o denominador correto de uma tabela publicada até uma decisão.
Leitura de frases em inglês e resultado em duas etapas
Cinco grupos originais de matrícula e total; linhas com os dois sexos juntos, cada uma com a sua própria base completa da fonte.
Gráfico completo e fonte

Role para os lados para examinar o gráfico. ↔
Gráfico e valores
Role a tabela para os lados para ver todas as colunas.
| Grupo da fonte | Sexo na fonte | Leitura de frases (%) | Sentido entre os leitores de frases (%) | Duas etapas (%) | Limite inferior de arredondamento (%) | Limite superior de arredondamento (%) |
|---|---|---|---|---|---|---|
| Até a classe X | Masculino | 55,5 | 73,2 | 40,63 | 40,5617 | 40,6904 |
| Até a classe X | Feminino | 52,7 | 70,9 | 37,36 | 37,3025 | 37,4261 |
| Até a classe X | Todos | 54,0 | 72,0 | 38,88 | 38,8170 | 38,9430 |
| Classes XI–XII | Masculino | 75,8 | 76,2 | 57,76 | 57,6836 | 57,8356 |
| Classes XI–XII | Feminino | 71,4 | 75,7 | 54,05 | 53,9763 | 54,1234 |
| Classes XI–XII | Todos | 73,4 | 76,0 | 55,78 | 55,7093 | 55,8587 |
| Ensino superior / outros | Masculino | 80,7 | 80,0 | 64,56 | 64,4797 | 64,6404 |
| Ensino superior / outros | Feminino | 79,3 | 78,8 | 62,49 | 62,4094 | 62,5675 |
| Ensino superior / outros | Todos | 79,9 | 79,3 | 63,36 | 63,2811 | 63,4403 |
| Não matriculados | Masculino | 24,3 | 63,5 | 15,43 | 15,3866 | 15,4744 |
| Não matriculados | Feminino | 24,5 | 58,8 | 14,41 | 14,3644 | 14,4477 |
| Não matriculados | Todos | 24,4 | 60,9 | 14,86 | 14,8170 | 14,9023 |
| Todos os jovens | Masculino | 58,5 | 74,3 | 43,47 | 43,3991 | 43,5319 |
| Todos os jovens | Feminino | 56,3 | 72,8 | 40,99 | 40,9219 | 41,0510 |
| Todos os jovens | Todos | 57,3 | 73,5 | 42,12 | 42,0501 | 42,1809 |
Produtos de taxas aninhadas arredondadas; sem intervalos de confiança de amostragem. Não é compreensão geral do inglês. ASER 2023 · Índia · 28 distritos rurais selecionados · 14 a 18 anos. Análise original de Alisson Bento.
Uma comparação pareada pode mudar conforme a etapa
Cinco comparações pareadas feminino menos masculino, com a primeira etapa e o produto das duas etapas.
Gráfico completo e fonte

Role para os lados para examinar o gráfico. ↔
Gráfico e valores
Role a tabela para os lados para ver todas as colunas.
| Grupo da fonte | Diferença na etapa de frases (pontos percentuais) | Diferença nas duas etapas (pontos percentuais) | Limite inferior de arredondamento (pontos percentuais) | Limite superior de arredondamento (pontos percentuais) |
|---|---|---|---|---|
| Até a classe X | −2,80 | −3,26 | −3,3879 | −3,1356 |
| Classes XI–XII | −4,40 | −3,71 | −3,8594 | −3,5603 |
| Ensino superior / outros | −1,40 | −2,07 | −2,2310 | −1,9122 |
| Não matriculados | 0,20 | −1,02 | −1,1101 | −0,9390 |
| Todos os jovens | −2,20 | −2,48 | −2,6101 | −2,3482 |
Apenas contrastes aritméticos pareados; sem intervalos de confiança de amostragem, significância nem interpretação causal.

Dados e downloads
Role a tabela para os lados para ver todas as colunas.
| Grupo da fonte | Sexo na fonte | Leitura de frases (%) | Sentido entre os leitores de frases (%) | Duas etapas (%) | Limite inferior de arredondamento (%) | Limite superior de arredondamento (%) |
|---|---|---|---|---|---|---|
| Até a classe X | Masculino | 55,5 | 73,2 | 40,63 | 40,5617 | 40,6904 |
| Até a classe X | Feminino | 52,7 | 70,9 | 37,36 | 37,3025 | 37,4261 |
| Até a classe X | Todos | 54,0 | 72,0 | 38,88 | 38,8170 | 38,9430 |
| Classes XI–XII | Masculino | 75,8 | 76,2 | 57,76 | 57,6836 | 57,8356 |
| Classes XI–XII | Feminino | 71,4 | 75,7 | 54,05 | 53,9763 | 54,1234 |
| Classes XI–XII | Todos | 73,4 | 76,0 | 55,78 | 55,7093 | 55,8587 |
| Ensino superior / outros | Masculino | 80,7 | 80,0 | 64,56 | 64,4797 | 64,6404 |
| Ensino superior / outros | Feminino | 79,3 | 78,8 | 62,49 | 62,4094 | 62,5675 |
| Ensino superior / outros | Todos | 79,9 | 79,3 | 63,36 | 63,2811 | 63,4403 |
| Não matriculados | Masculino | 24,3 | 63,5 | 15,43 | 15,3866 | 15,4744 |
| Não matriculados | Feminino | 24,5 | 58,8 | 14,41 | 14,3644 | 14,4477 |
| Não matriculados | Todos | 24,4 | 60,9 | 14,86 | 14,8170 | 14,9023 |
| Todos os jovens | Masculino | 58,5 | 74,3 | 43,47 | 43,3991 | 43,5319 |
| Todos os jovens | Feminino | 56,3 | 72,8 | 40,99 | 40,9219 | 41,0510 |
| Todos os jovens | Todos | 57,3 | 73,5 | 42,12 | 42,0501 | 42,1809 |
Produtos de taxas aninhadas arredondadas; sem intervalos de confiança de amostragem. Não é compreensão geral do inglês. ASER 2023 · Índia · 28 distritos rurais selecionados · 14 a 18 anos. Análise original de Alisson Bento.
Role a tabela para os lados para ver todas as colunas.
| Grupo da fonte | Diferença na etapa de frases (pontos percentuais) | Diferença nas duas etapas (pontos percentuais) | Limite inferior de arredondamento (pontos percentuais) | Limite superior de arredondamento (pontos percentuais) |
|---|---|---|---|---|
| Até a classe X | −2,80 | −3,26 | −3,3879 | −3,1356 |
| Classes XI–XII | −4,40 | −3,71 | −3,8594 | −3,5603 |
| Ensino superior / outros | −1,40 | −2,07 | −2,2310 | −1,9122 |
| Não matriculados | 0,20 | −1,02 | −1,1101 | −0,9390 |
| Todos os jovens | −2,20 | −2,48 | −2,6101 | −2,3482 |
Apenas contrastes aritméticos pareados; sem intervalos de confiança de amostragem, significância nem interpretação causal.
Evidências e método
Como calculamos
- Examinar o relatório real da fonte, o encaminhamento das tarefas, os cabeçalhos das tabelas e as notas de rodapé. Conferir visualmente todas as células selecionadas e guardar os valores exatos da fonte, com uma casa decimal, como texto.
- Manter todas as linhas das tabelas selecionadas, inclusive as linhas separadas de total. Registrar a base do grupo completo e cada base condicional seguinte, declarada de forma explícita como aninhada, antes de multiplicar.
- Calcular os produtos com aritmética Decimal. Converter os percentuais de modo consistente; não multiplicar percentuais sem relação entre si nem supor independência para suprir a falta de informação conjunta.
- Envolver cada dado de entrada com uma casa decimal em uma tolerância explícita de 0,05 ponto percentual, limitada ao intervalo de 0 a 100. Usar produtos dos extremos, que variam em um só sentido, e limites conservadores para as diferenças pareadas.
- Registrar a especificação da análise depois da inspeção da fonte e de contas informais, e antes da derivação completa por script. Isso não é um pré-registro às cegas.
- Reproduzir todos os resultados em CSV e JSON a partir da matriz agregada selecionada, com soma de verificação conferida, usando Python com a biblioteca padrão, sem acesso à rede, sem contas e sem dados de respondentes.
- Usar a página 53 do PDF (impressa 47), Tabelas 13 e 14: cinco grupos de matrícula e total, por sexo masculino, feminino e todos. P(frase e sentido)=P(frase)×P(sentido dado frase).
- Ler o encaminhamento da avaliação de inglês nas páginas 225–226 do PDF (impressas 219–220). O sentido da frase pode ser explicado na língua local e pela rota permitida das principais palavras sublinhadas; o ramo separado do sentido de palavras não está incluído.
- Calcular as cinco diferenças pareadas feminino menos masculino na etapa de frases e no produto das duas etapas, sem testes de significância nem ajuste de composição.
O que os dados não permitem concluir
- A fonte descreve jovens de 14 a 18 anos em 28 distritos rurais selecionados de 26 estados. O total combinado da fonte não é uma estimativa representativa para toda a Índia, para o meio urbano ou para todas as idades.
- As observações são de 2023. Examinar a fonte em outubro de 2026 não torna as medições atuais, longitudinais nem comparáveis com outra pesquisa.
- Os produtos reconstroem taxas de bases publicadas explicitamente aninhadas, a partir de estimativas arredondadas. Não são contagens exatas de respondentes nem estimativas validadas de forma independente com microdados. Os detalhes de respostas ausentes por trás dos novos produtos não estão disponíveis.
- As faixas de arredondamento dos dados de entrada usam uma tolerância explícita de ±0,05 ponto percentual. Não são intervalos de confiança de amostragem, garantias de erro, testes de significância nem evidência de equivalência.
- As tabelas agregadas selecionadas não trazem a covariância nem a incerteza de amostragem específica de cada célula, necessárias para os produtos derivados ou para as diferenças pareadas. Não se apresentam valores-p nem inferência causal.
- As linhas de matrícula e de sexo se sobrepõem ao total separado e não são somadas nem tiradas em média para criar outro total. Não há ajuste por idade, escolaridade ou outra composição.
- Este é um cálculo secundário, e não uma nova pesquisa, uma descoberta inédita, uma avaliação individual, um aval do ASER nem uma licença para reproduzir os instrumentos de avaliação.
- O protocolo de sentido das frases não é compreensão geral do inglês, fluência, leitura de e-books nem uma classificação individual de proficiência validada. O seu complemento não é composto por pessoas que não entendem nada de inglês.
- O estudo não estima um efeito da matrícula ou do sexo, não explica as diferenças entre os grupos, não avalia materiais didáticos nem prescreve uma intervenção.
Fontes originais
- ASER Centre, Annual Status of Education Report (Rural) 2023: Beyond Basics
As Tabelas 13 e 14 trazem as 30 entradas numéricas selecionadas. O procedimento em inglês do relatório, nas páginas impressas 219–220, define o encaminhamento de leitura e sentido; nenhum texto de avaliação é redistribuído.
Acesso em 31 de outubro de 2026
- ASER 2023: About the survey
O documento de contexto da fonte descreve o desenho domiciliar dos distritos selecionados, a faixa etária e o contexto do trabalho de campo. A amostra combinada não é rebatizada como estimativa nacionalmente representativa.
Acesso em 31 de outubro de 2026
- ASER Centre: ASER 2023 Beyond Basics source page
A página oficial do ASER 2023 identifica o relatório, a documentação de contexto e os materiais de avaliação, distintos de outros anos da pesquisa ASER.
Acesso em 31 de outubro de 2026
- ASER 2023: Assessment tasks
A visão geral oficial da avaliação esclarece o contexto específico das tarefas. Esta análise secundária não reproduz os instrumentos nem trata algumas tarefas como compreensão sem restrições.
Acesso em 31 de outubro de 2026
Como citar e reutilizar
Alisson Bento. 2026. Ler frases em inglês e entender o sentido: por que dois percentuais precisam de dois denominadores. Análise secundária dos agregados publicados pelo ASER Centre em 2023 para distritos selecionados. https://alissonbento.com/pt/research/aser-english-staged-reading-reach-2023/
Os fatos numéricos selecionados são creditados ao ASER Centre. Os cálculos originais, a explicação e as figuras são de Alisson Bento. Os gráficos e os cálculos originais podem ser reutilizados com crédito e um link para este estudo, mantendo o seu alcance e as suas limitações. Não se deduz nenhuma licença para o texto do relatório do ASER, os instrumentos de avaliação, as fotografias, os gráficos da fonte ou as marcas da instituição. Não se sugere aval do ASER.
Correções ou dúvidas editoriais