
Ergebnis und Bezugsgruppe
In der Erhebung ASER 2023 erreichten 57,3 % der untersuchten Jugendlichen aus 28 ausgewählten ländlichen Distrikten die Stufe „Sätze lesen“. Innerhalb dieser Teilgruppe konnten 73,5 % die verlangte Bedeutung wiedergeben. Verknüpft man die beiden Quoten, die ausdrücklich aufeinander aufbauen, ergibt sich für beide erfolgreichen Schritte zusammen ein rekonstruierter Anteil von rund 42,1 % an der gesamten Gruppe der Quelle. Die höhere Quote beantwortet eine andere Frage: Wie oft gelang die Aufgabe zur Bedeutung unter denen, die schon die Stufe „Sätze lesen“ erreicht hatten?
Diese Untersuchung macht den Wechsel der Bezugsgruppe für alle ausgewählten Zellen der Tabellen sichtbar. Sie enthält die veröffentlichten Zahlen, die vollständigen Rechenwege, fünf Vergleiche zwischen den beiden ausgewiesenen Geschlechtsgruppen und eine gesonderte Prüfung, wie sich das Runden der Ausgangswerte auswirkt. Es ist eine Sekundäranalyse vorhandener Angaben und keine neue Befragung. Weder die Ausgangswerte noch ihre Produkte werden hier in ein landesweites Maß für das Verständnis von Englisch, in eine Aussage über das Lesen von E-Books oder in eine Diagnose einzelner Jugendlicher umgedeutet. Der Nutzen liegt in einer nachvollziehbaren Verbindung zwischen einer bedingten Quote und der übergeordneten Gruppe.
Welche beiden Fragen hinter den Zahlen stehen
Der Bericht des ASER Centre trennt das Lesen kurzer englischer Sätze von der anschließenden Aufgabe, deren Bedeutung wiederzugeben. Tabelle 13 nennt den Anteil auf der Stufe „Sätze lesen“ innerhalb der jeweiligen Gruppe nach Bildung und Geschlecht. Tabelle 14 verwendet danach nur die Jugendlichen dieser Stufe als Bezugsgruppe. Beide Prozentwerte sind für ihre jeweilige Frage sinnvoll. Stellt man sie ohne diese Einschränkung nebeneinander, kann der zweite Wert aber wie ein weiterer Anteil an allen Befragten wirken. Gerade in einer kurzen Zusammenfassung geht dadurch ein wichtiger Auswahlschritt verloren.
Das Verfahren dahinter ist enger als eine allgemeine Prüfung der Englischkenntnisse. Es verwendet wenige kurze Sätze und eine festgelegte Schwelle dafür, wann die Stufe „Sätze lesen“ erreicht ist. Die Bedeutung darf in einer örtlich gesprochenen Sprache erklärt werden. Nach den Regeln zur Bewertung kann auch eine passende Erläuterung anhand der wichtigsten unterstrichenen Wörter genügen; eine ausformulierte Übersetzung wird nicht in jedem Fall verlangt. Die Analyse übernimmt keine urheberrechtlich geschützten Prüfungsfragen. Sie nutzt die beschriebenen Wege durch das Verfahren nur, um festzustellen, auf wen sich die beiden Quoten beziehen.
Ein erfolgreicher Durchgang belegt deshalb nicht, dass jemand einen beliebigen Roman versteht, einem langen Gedankengang folgen oder aus einem Kurs lernen kann, der nur auf Englisch stattfindet. Umgekehrt können Jugendliche unterhalb der Stufe „Sätze lesen“ andere Sprachkenntnisse haben. Für die Stufe „Wörter lesen“ sieht das ursprüngliche Verfahren einen eigenen Weg zur Bedeutung von Wörtern vor. Dieser Weg gehört nicht zu den hier ausgewählten Tabellen. Der Rest, der zu den rund 42,1 % fehlt, darf deshalb nicht als Gruppe ohne jedes Verständnis von Englisch bezeichnet werden. Er umfasst mehrere verschiedene beobachtete Wege, und viele Fähigkeiten bleiben ungemessen.
Wie der Anteil für die größere Bezugsgruppe entsteht
R sei das Erreichen der Stufe „Sätze lesen“ und M der erfolgreiche Nachweis der Bedeutung innerhalb dieser Stufe. Dann gilt P(R und M) = P(R) × P(M gegeben R). Für die Gesamtzeile der Quelle lautet die Rechnung 0,573 × 0,735 = 0,421155. Als Prozentwert sind das 42,1155 %, zur übersichtlichen Anzeige rund 42,1 %. Dabei wird nicht angenommen, dass beide Leistungen unabhängig voneinander sind. Die Multiplikation funktioniert gerade deshalb, weil der zweite Ausgangswert ausdrücklich auf die schon erfolgreiche erste Gruppe beschränkt ist.
Eine gedachte Gruppe von hundert Personen macht den Unterschied anschaulich. Nach den veröffentlichten Quoten würden etwa 57,3 die erste Stufe erreichen. Wendet man auf diese Teilgruppe die berichtete Quote für die Bedeutung an, bleiben etwa 42,1 mit beiden erfolgreichen Schritten. Rund 15,2 Prozentpunkte entfallen rechnerisch auf Jugendliche, die Sätze lesen konnten, aber nach der Definition in dieser Auswertung die Bedeutung nicht erfolgreich wiedergaben. Das sind Umrechnungen gerundeter Quoten, keine rekonstruierten Personen. Niemand hat einen Bruchteil eines Jugendlichen beobachtet. Auch wenn man das Ergebnis mit dem gesamten Stichprobenumfang multipliziert, erhält man keine genaue Zahl erfolgreicher Befragter.
Die bedingte Quote für die Bedeutung liegt rund 31,4 Prozentpunkte über dem Produkt, das auf die gesamte Gruppe der Quelle bezogen ist. Dieser Abstand beschreibt keine Verschlechterung der Leistung. Er entsteht allein dadurch, dass derselbe beobachtete Erfolg über beide Stufen auf eine größere Gruppe bezogen wird. Von einer übertriebenen Darstellung sollte man nur sprechen, wenn jemand die bedingte Quote tatsächlich als Anteil an allen bezeichnet. Der ASER-Bericht selbst nennt die Einschränkung richtig. Um den Unterschied zu erklären, muss man weder einen Fehler in der Quelle erfinden noch deren Autorinnen und Autoren etwas unterstellen.
Warum alle Bildungsgruppen erhalten bleiben
Die Auswertung behält alle vier ausgewiesenen Bildungsgruppen und die gesonderte Gesamtzeile. Sie wählt nicht nur das auffälligste Beispiel aus. Für Jugendliche bis einschließlich Standard X nennt die Zeile für beide Geschlechter 54,0 % auf der Stufe „Sätze lesen“ und danach 72,0 % mit erfolgreicher Bedeutungsangabe unter diesen Jugendlichen. Daraus ergeben sich rund 38,9 %, die beide Schritte bestehen, innerhalb dieser Bildungsgruppe. Für Standard XI oder XII führen 73,4 % und 76,0 % zu rund 55,8 %. In der Kategorie Hochschulstudium oder sonstige Ausbildung ergeben 79,9 % und 79,3 % rund 63,4 %.
Unter den Jugendlichen, die zum Zeitpunkt der Erhebung in keiner Bildungseinrichtung eingeschrieben waren, erreichen 24,4 % die Stufe „Sätze lesen“. Von dieser Teilgruppe erfüllen 60,9 % das Kriterium für die Bedeutung. Das Produkt beträgt rund 14,9 % der gesamten zugehörigen Gruppe der Quelle. Nennt man nur die bedingte Quote, bleibt unsichtbar, wie wenige Jugendliche überhaupt in deren Bezugsgruppe gelangen. Zudem erschienen die eingeschriebenen und die nicht eingeschriebenen Gruppen dann beim insgesamt erreichten Ergebnis ähnlicher, als es ihre rekonstruierten Produkte über beide Stufen zeigen. Die Tabellen erlauben diese Beschreibung. Sie erklären nicht, woher die Unterschiede kommen.
Die Bildungsgruppen unterscheiden sich auch in Alter, bisheriger Schulzeit und weiteren Lebensumständen. Der Abstand zwischen einer Hochschulgruppe und den nicht eingeschriebenen Jugendlichen schätzt deshalb nicht, was eine Einschreibung bei derselben Person bewirken würde. Die Analyse gleicht solche Unterschiede in der Zusammensetzung nicht aus; die ausgewählten Gesamtzahlen reichen dafür nicht aus. Anbieter von Bildung können daran erkennen, dass eine einheitliche Voraussetzung bei Englisch verschiedene Gruppen unterschiedlich weit erreicht. Daraus lässt sich aber weder ein ursächlicher Ertrag von Schulbildung noch eine Rangfolge einzelner Einrichtungen noch eine Vorhersage für eine bestimmte lernende Person ableiten.
Ein kleiner Vergleich ändert seine Richtung
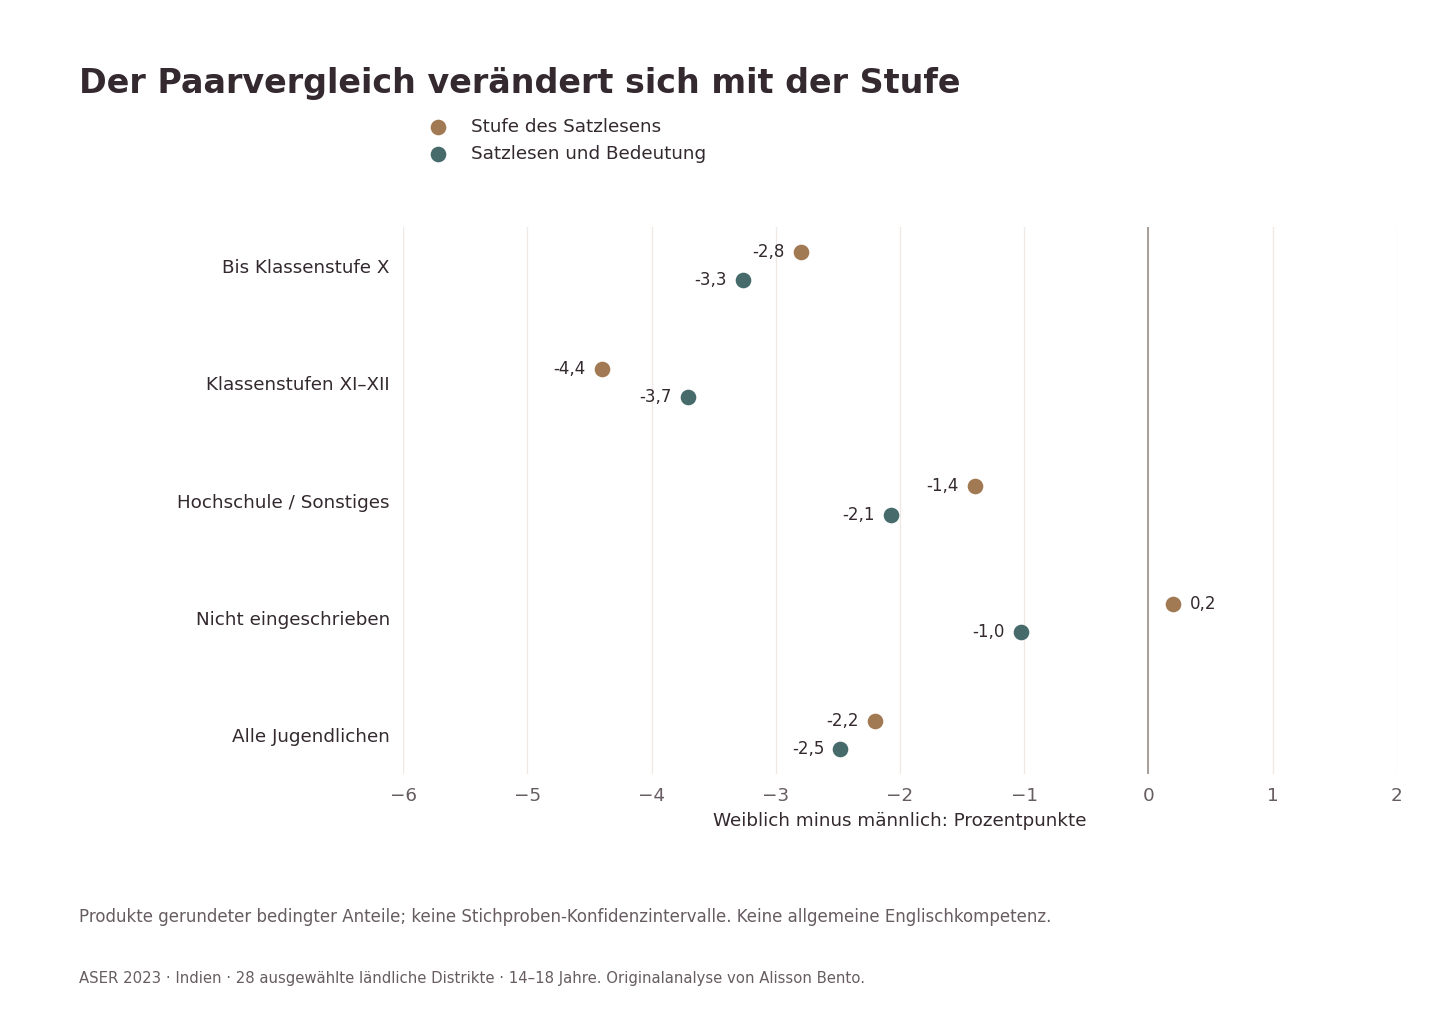
Die Zeile der nicht eingeschriebenen Jugendlichen zeigt, warum sich die Richtung eines ersten Vergleichs nicht automatisch auf den ganzen Weg übertragen lässt. Für männliche Jugendliche nennt die Quelle 24,3 % auf der Stufe „Sätze lesen“, für weibliche 24,5 %. Weiblich minus männlich ergibt hier also einen Abstand von plus 0,2 Prozentpunkten. Bei der Aufgabe zur Bedeutung in diesen Teilgruppen liegen die Werte dagegen bei 63,5 % und 58,8 %. Die zugehörigen Produkte betragen rund 15,4 % beziehungsweise 14,4 %. Für beide Schritte zusammen ergibt sich damit für weiblich minus männlich ein Abstand von ungefähr minus 1,0 Prozentpunkten.
Dieser Richtungswechsel ist eine Eigenschaft der ausgewählten veröffentlichten Zahlen. Er ist weder ein nachgewiesener Unterschied in einer gesamten Bevölkerung noch eine Aussage darüber, dass ein Geschlecht von Natur aus besser mit Sprache umgeht. Beide Quoten der einzelnen Stufen gehen in das Produkt ein. Ein kleiner Vorsprung bei der ersten Stufe kann mit einem niedrigeren gemeinsamen Anteil zusammenfallen, wenn die zweite bedingte Quote entsprechend abweicht. Das Beispiel ist nützlich, weil sich alle Eingaben auf einer einzigen Seite der Quelle nachprüfen lassen. Als Schlagzeile, die die Zahlen von ihrer engen Stichprobe, ihrer Aufgabe, der Rundung und der fehlenden Unsicherheit der Stichprobe löst, wäre es irreführend.
Alle fünf Vergleiche, auch der für die Gesamtzeile, sind verfügbar. Das Beispiel verschweigt also keine Zeilen, die anders verlaufen. Für die gesamte betrachtete Gruppe der Quelle ergeben sich über beide Stufen etwa 43,5 % bei männlichen und 41,0 % bei weiblichen Jugendlichen. Weiblich minus männlich sind das ungefähr minus 2,5 Prozentpunkte. Diese Beschreibungen überschneiden sich mit den Zeilen zur Bildung und dürfen nicht addiert werden. Die Quelle weist zwei Geschlechtskategorien aus. Die Sekundäranalyse übernimmt diese Einteilung der Tabelle. Sie schließt daraus nichts über die Geschlechtsidentität und dehnt die Kategorien nicht auf weitere Identitäten aus.
Was sich mit den Rundungsgrenzen sagen lässt
Beide Ausgangstabellen zeigen ihre Prozentwerte mit einer Nachkommastelle. Die Berechnung zum Herunterladen behandelt jeden Wert als vereinbar mit einer Abweichung von höchstens 0,05 Prozentpunkten, begrenzt auf den gültigen Bereich von null bis hundert. Das ist eine ausdrücklich gesetzte Toleranz für das Runden. Es wird nicht behauptet, die Quelle habe eine bestimmte Rundungsregel verwendet. Multipliziert man die unteren und die oberen Grenzen jeweils miteinander, erhält man einen Spielraum für das Produkt allein durch Rundung. Er ist ohne Zufall berechnet und gilt unter dieser Toleranz. Für die Gesamtzeile reicht er von etwa 42,0501 % bis 42,1809 %. Die Anzeige mit einer Nachkommastelle ist eine Entscheidung zur Darstellung und kein Beleg für eine entsprechende statistische Genauigkeit.
Bei einem Unterschied zwischen zwei Produkten wird die untere Grenze vorsichtig gebildet: aus der unteren Grenze des weiblichen und der oberen Grenze des männlichen Produkts. Für die obere Grenze werden die Endpunkte umgekehrt kombiniert. In der Gruppe der nicht Eingeschriebenen ergibt das ungefähr minus 1,1101 bis minus 0,9390 Prozentpunkte. Unter der genannten Toleranz beseitigt das übliche Runden der Eingaben den Richtungswechsel in den veröffentlichten Schätzwerten daher nicht. Mehr wird damit nicht festgestellt. Insbesondere folgt daraus nicht, dass ein korrektes Konfidenzintervall, das auf der Stichprobe beruht, den Wert null ausschließen würde.
Stichprobenfehler, fehlende Antworten, Messfehler und weitere Grenzen der Erhebung sind in diesen Rundungsgrenzen nicht enthalten. Die ausgewählten Tabellen liefern nicht die Kovarianzen (das gemeinsame Schwanken der Werte) und die zellspezifischen Unsicherheiten, die man bräuchte, um für jedes neue Produkt oder jeden Unterschied zwischen zwei Gruppen einen begründeten Standardfehler zu berechnen. Deshalb enthält diese Auswertung keine p-Werte, keine Signifikanzsterne, keine Konfidenzintervalle und keine Nachweise, dass Gruppen gleichwertig sind. Ein enger Spielraum durch Rundung kann neben einer erheblichen Unsicherheit der Stichprobe bestehen. Wer einen rechnerisch genauen Wert zitiert, sollte diese beiden Arten von Unsicherheit ausdrücklich auseinanderhalten und nicht die eine als Ersatz für die andere verwenden.
Die untersuchte Gruppe ist enger als ganz Indien
ASER 2023 erfasste 34.745 Jugendliche im Alter von vierzehn bis achtzehn Jahren in 28 ausgewählten ländlichen Distrikten aus 26 Bundesstaaten. In den meisten großen Bundesstaaten wurde ein ländlicher Distrikt untersucht, in Uttar Pradesh und Madhya Pradesh jeweils zwei. Die zusammengefasste Gesamtzeile wird hier als Gesamtzeile dieser Quelle verwendet. Sie wird nicht zu einer landesweit repräsentativen Quote für alle ländlichen Jugendlichen umbenannt. Noch weniger beschreibt sie alle Jugendlichen in Indien einschließlich der Städte. Eine breite geografische Streuung allein ergibt noch keine Bezugsgruppe für das ganze Land.
Auch einen Zeittrend enthält die Untersuchung nicht. Das Beobachtungsjahr bleibt 2023. Dass die Quelle im Oktober 2026 geprüft wurde, macht daraus keine Messung für 2026. Ergebnisse von 2017 und 2023 werden weder zusammengelegt noch als Veränderung derselben Orte oder Personen gelesen. Die englischen Aufgaben werden auch nicht unmittelbar mit PISA, PIRLS, PIAAC, kommerziellen Sprachprüfungen oder Lesetests in regionalen Sprachen verglichen. Verschiedene Aufgaben, Altersgruppen und Wege durch das Verfahren haben nicht schon deshalb eine gemeinsame Bedeutung oder Bezugsgruppe, weil es in allen ums Lesen geht. Eine solche Gleichsetzung müsste man eigens belegen.
Wie sich die Auswertung sinnvoll verwenden lässt
Eine unabhängige Kontrolle beginnt mit den Überschriften der Tabellen, nicht mit dem Taschenrechner. Zuerst ist zu prüfen, ob die erste Zelle zur ausgewählten Gruppe nach Bildung und Geschlecht gehört. Dann muss die zweite Zelle die Jugendlichen betreffen, die Sätze lesen konnten, und zwar in genau derselben Gruppe. Die Gesamtzeile bleibt dabei gesondert erhalten. Erst danach werden die beiden Prozentwerte multipliziert und durch hundert geteilt. Stammen Eingaben aus anderen Distrikten, Jahren, Altersgruppen oder Lesestufen, liefert dieselbe Rechnung zwar ebenfalls eine Zahl. Sie rekonstruiert dann aber nicht mehr das hier beschriebene Ergebnis. Eine richtige Formel macht unpassende Ausgangsdaten nicht passend.
Die Anleitung zum Nachrechnen trennt außerdem Wiederholbarkeit und Aussagekraft. Wer aus 57,3 und 73,5 erneut 42,1155 erhält, hat eine Rechenoperation überprüft. Damit ist weder die Feldarbeit des ASER Centre unabhängig bestätigt noch die Genauigkeit jeder Ausgangsquote belegt, noch die Einschränkung durch die Auswahl der Stichprobe aufgehoben. Umgekehrt machen diese Einschränkungen die Beziehung zwischen den Bezugsgruppen nicht bedeutungslos. Sie legen fest, was das Produkt beschreibt und welche weitergehenden Aussagen zusätzliche Belege brauchen. Diese Trennung ist besonders wichtig, wenn eine Tabelle der Quelle später in einem Diagramm, einem redaktionellen Beitrag oder einer automatisch ausgelesenen Antwort noch einmal zusammengefasst wird.
Für eine Redaktion eignet sich eine Formulierung, die die Bezugsgruppe gleich im Satz nennt: Rund 42,1 % der Jugendlichen in der zusammengefassten Gruppe der Quelle aus ausgewählten Distrikten haben beide Stufen bestanden, das Lesen englischer Sätze und die Aufgabe zur Bedeutung. Der Wert ist aus gerundeten, aufeinander aufbauenden Quoten rekonstruiert. Ist stattdessen die Leistung der Jugendlichen interessant, die Sätze lesen konnten, darf man die bedingte Quote verwenden, solange man ihre Einschränkung mitnennt. Beide Formulierungen können richtig sein. Problematisch wird die höhere Zahl erst, wenn sie mit einer weiter gefassten Bezeichnung der Bevölkerung verbunden wird oder mit einer allgemeinen Behauptung über das Verständnis von Sprache, für die der Test nicht gedacht ist.
Für Verlage und Anbieter von Lesematerial ergeben sich daraus Fragen für die Gestaltung, die man prüfen kann. Setzt eine Einstiegsseite auf Englisch zwei Fähigkeiten voraus, die man getrennt betrachten sollte? Könnten eine Einführung in der örtlichen Sprache, eine Erklärung als Audio oder ein durchgerechnetes Beispiel die gemeinte Aufgabe klarer machen? Die Studie hat solche Angebote nicht getestet und verspricht keine bessere Lernwirkung oder Nutzung. Sie zeigt nur die Unterscheidung in den Stufen der Quelle, die eine verantwortungsvolle Untersuchung des tatsächlichen Publikums beibehalten und nicht vorschnell zu einem einzigen Etikett für Kompetenz zusammenziehen sollte. Jede konkrete Gestaltung muss mit den vorgesehenen Leserinnen und Lesern geprüft werden.
Die Dateien erlauben die Nachnutzung, ohne die ursprüngliche Prüfung zu verbreiten. Die Matrix der Eingaben enthält dreißig ausgewählte Zahlen. Die Ergebnisse dokumentieren fünfzehn Produkte und fünf Vergleiche zwischen Geschlechtern. Der Code zum Nachrechnen legt jede Rechenoperation offen. Die eigenen Diagramme und die barrierefreien Tabellen verwenden dieselben Bezugsgruppen. Das ASER Centre wird als Quelle der Erhebung genannt, Alisson Bento als Urheber dieser Sekundärberechnung und der Erläuterung. Nicht behauptet werden eine Billigung durch ASER, eine Lizenz für dessen Prüfungsinstrumente, eine neue Umfrage, individuelle Testergebnisse oder ein erstmals entdeckter allgemeiner Zusammenhang. Der Beitrag ist eine nachprüfbare Rekonstruktion. Sie hilft, die richtige Bezugsgruppe von der veröffentlichten Tabelle bis zu einer Entscheidung in Redaktion oder Gestaltung mitzunehmen.
Englische Sätze lesen und das Ergebnis über beide Stufen
Alle fünf Gruppen nach Bildung und Gesamtgruppe; jeweils die Zeile für beide Geschlechter.
Vollständige Grafik und Quelle

Diagramm seitlich scrollen, um alle Details zu sehen. ↔
Grafik und Werte
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Gruppe der Quelle | Geschlecht | Stufe „Sätze lesen“ (%) | Bedeutung unter den Jugendlichen, die Sätze lesen konnten (%) | Beide Stufen (%) | Untere Rundungsgrenze (%) | Obere Rundungsgrenze (%) |
|---|---|---|---|---|---|---|
| Bis einschließlich Standard X | Männlich | 55,5 | 73,2 | 40,63 | 40,5617 | 40,6904 |
| Bis einschließlich Standard X | Weiblich | 52,7 | 70,9 | 37,36 | 37,3025 | 37,4261 |
| Bis einschließlich Standard X | Zusammen | 54,0 | 72,0 | 38,88 | 38,8170 | 38,9430 |
| Standard XI oder XII | Männlich | 75,8 | 76,2 | 57,76 | 57,6836 | 57,8356 |
| Standard XI oder XII | Weiblich | 71,4 | 75,7 | 54,05 | 53,9763 | 54,1234 |
| Standard XI oder XII | Zusammen | 73,4 | 76,0 | 55,78 | 55,7093 | 55,8587 |
| Hochschulstudium oder sonstige Ausbildung | Männlich | 80,7 | 80,0 | 64,56 | 64,4797 | 64,6404 |
| Hochschulstudium oder sonstige Ausbildung | Weiblich | 79,3 | 78,8 | 62,49 | 62,4094 | 62,5675 |
| Hochschulstudium oder sonstige Ausbildung | Zusammen | 79,9 | 79,3 | 63,36 | 63,2811 | 63,4403 |
| Nicht eingeschrieben | Männlich | 24,3 | 63,5 | 15,43 | 15,3866 | 15,4744 |
| Nicht eingeschrieben | Weiblich | 24,5 | 58,8 | 14,41 | 14,3644 | 14,4477 |
| Nicht eingeschrieben | Zusammen | 24,4 | 60,9 | 14,86 | 14,8170 | 14,9023 |
| Gesamte Quellengruppe | Männlich | 58,5 | 74,3 | 43,47 | 43,3991 | 43,5319 |
| Gesamte Quellengruppe | Weiblich | 56,3 | 72,8 | 40,99 | 40,9219 | 41,0510 |
| Gesamte Quellengruppe | Zusammen | 57,3 | 73,5 | 42,12 | 42,0501 | 42,1809 |
Die Zeilen zur Bildung und die Gesamtzeilen überschneiden sich. Die Rundungsgrenzen beziehen sich nur auf die gesetzte Toleranz für die Eingaben, nicht auf die Unsicherheit der Stichprobe.

Der Vergleich zwischen den Geschlechtern ändert sich mit der Stufe
Fünf Vergleiche derselben veröffentlichten Gruppen.
Vollständige Grafik und Quelle

Diagramm seitlich scrollen, um alle Details zu sehen. ↔
Grafik und Werte
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Gruppe der Quelle | Nur Stufe „Sätze lesen“ (Prozentpunkte) | Beide Stufen (Prozentpunkte) | Untere Rundungsgrenze (Prozentpunkte) | Obere Rundungsgrenze (Prozentpunkte) |
|---|---|---|---|---|
| Bis einschließlich Standard X | −2,80 | −3,26 | −3,3879 | −3,1356 |
| Standard XI oder XII | −4,40 | −3,71 | −3,8594 | −3,5603 |
| Hochschulstudium oder sonstige Ausbildung | −1,40 | −2,07 | −2,2310 | −1,9122 |
| Nicht eingeschrieben | 0,20 | −1,02 | −1,1101 | −0,9390 |
| Gesamte Quellengruppe | −2,20 | −2,48 | −2,6101 | −2,3482 |
Keine Signifikanztests. Ein Vorzeichen, das über die Rundungstoleranz hinaus Bestand hat, ist kein Nachweis eines Unterschieds in der Bevölkerung.
Daten und Downloads
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Gruppe der Quelle | Geschlecht | Stufe „Sätze lesen“ (%) | Bedeutung unter den Jugendlichen, die Sätze lesen konnten (%) | Beide Stufen (%) | Untere Rundungsgrenze (%) | Obere Rundungsgrenze (%) |
|---|---|---|---|---|---|---|
| Bis einschließlich Standard X | Männlich | 55,5 | 73,2 | 40,63 | 40,5617 | 40,6904 |
| Bis einschließlich Standard X | Weiblich | 52,7 | 70,9 | 37,36 | 37,3025 | 37,4261 |
| Bis einschließlich Standard X | Zusammen | 54,0 | 72,0 | 38,88 | 38,8170 | 38,9430 |
| Standard XI oder XII | Männlich | 75,8 | 76,2 | 57,76 | 57,6836 | 57,8356 |
| Standard XI oder XII | Weiblich | 71,4 | 75,7 | 54,05 | 53,9763 | 54,1234 |
| Standard XI oder XII | Zusammen | 73,4 | 76,0 | 55,78 | 55,7093 | 55,8587 |
| Hochschulstudium oder sonstige Ausbildung | Männlich | 80,7 | 80,0 | 64,56 | 64,4797 | 64,6404 |
| Hochschulstudium oder sonstige Ausbildung | Weiblich | 79,3 | 78,8 | 62,49 | 62,4094 | 62,5675 |
| Hochschulstudium oder sonstige Ausbildung | Zusammen | 79,9 | 79,3 | 63,36 | 63,2811 | 63,4403 |
| Nicht eingeschrieben | Männlich | 24,3 | 63,5 | 15,43 | 15,3866 | 15,4744 |
| Nicht eingeschrieben | Weiblich | 24,5 | 58,8 | 14,41 | 14,3644 | 14,4477 |
| Nicht eingeschrieben | Zusammen | 24,4 | 60,9 | 14,86 | 14,8170 | 14,9023 |
| Gesamte Quellengruppe | Männlich | 58,5 | 74,3 | 43,47 | 43,3991 | 43,5319 |
| Gesamte Quellengruppe | Weiblich | 56,3 | 72,8 | 40,99 | 40,9219 | 41,0510 |
| Gesamte Quellengruppe | Zusammen | 57,3 | 73,5 | 42,12 | 42,0501 | 42,1809 |
Die Zeilen zur Bildung und die Gesamtzeilen überschneiden sich. Die Rundungsgrenzen beziehen sich nur auf die gesetzte Toleranz für die Eingaben, nicht auf die Unsicherheit der Stichprobe.
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Gruppe der Quelle | Nur Stufe „Sätze lesen“ (Prozentpunkte) | Beide Stufen (Prozentpunkte) | Untere Rundungsgrenze (Prozentpunkte) | Obere Rundungsgrenze (Prozentpunkte) |
|---|---|---|---|---|
| Bis einschließlich Standard X | −2,80 | −3,26 | −3,3879 | −3,1356 |
| Standard XI oder XII | −4,40 | −3,71 | −3,8594 | −3,5603 |
| Hochschulstudium oder sonstige Ausbildung | −1,40 | −2,07 | −2,2310 | −1,9122 |
| Nicht eingeschrieben | 0,20 | −1,02 | −1,1101 | −0,9390 |
| Gesamte Quellengruppe | −2,20 | −2,48 | −2,6101 | −2,3482 |
Keine Signifikanztests. Ein Vorzeichen, das über die Rundungstoleranz hinaus Bestand hat, ist kein Nachweis eines Unterschieds in der Bevölkerung.
Daten und Methode
So haben wir gerechnet
- Alle 30 Zahlen, die in die Rechnung eingehen, stammen aus den Tabellen 13 und 14 von ASER 2023 auf PDF-Seite 53 (gedruckte Seite 47). Die ausgewählten Zellen wurden im Zusammenhang der Originaltabelle kontrolliert.
- Die zweite Quote bezieht sich ausdrücklich auf die Jugendlichen derselben Gruppe nach Bildung und Geschlecht, die Sätze lesen konnten. Das Produkt ist P(Sätze lesen) × P(Bedeutung gegeben Sätze lesen), ohne die Annahme, dass beide Leistungen unabhängig sind.
- Alle 15 Produkte und die fünf Vergleiche weiblich minus männlich bleiben erhalten. Die Gesamtzeile überschneidet sich mit den Untergruppen und wird nicht addiert.
- Jeder Eingabewert wird für die Prüfung der Rundung mit ±0,05 Prozentpunkten innerhalb von 0 bis 100 umgeben. Die Produkte der Endpunkte und die vorsichtig kombinierten Grenzen der Unterschiede liefern nur Spielräume, die ohne Zufall berechnet sind.
- Die Fragen für die Rechnung wurden nach der Durchsicht der Quelle und einer ersten informellen Rechnung dokumentiert, vor der vollständigen Berechnung mit dem Programm. Das ist keine Präregistrierung und keine Auswahl von Ergebnissen ohne Kenntnis der Daten.
- Das Programm zum Nachrechnen nutzt nur die ausgewählten Zahlen, braucht keinen Zugang zum Netz und keine Einzeldaten. Originalfragen der Prüfung, Fotos und Grafiken der Quelle werden nicht veröffentlicht.
- Verwendet werden PDF-Seite 53 (gedruckte Seite 47), Tabellen 13 und 14: fünf Gruppen nach Bildung beziehungsweise insgesamt, jeweils nach männlich, weiblich und zusammen. P(Satz und Bedeutung) = P(Satz) × P(Bedeutung gegeben Satz).
- Die Führung durch die englische Prüfung wird den PDF-Seiten 225–226 (gedruckte Seiten 219–220) entnommen. Die Bedeutung eines Satzes kann in der örtlichen Sprache und über die zulässigen wichtigsten unterstrichenen Wörter erklärt werden. Der gesonderte Zweig zur Bedeutung von Wörtern ist nicht enthalten.
- Alle fünf zugeordneten Unterschiede weiblich minus männlich werden für die Stufe „Sätze lesen“ und das Produkt über beide Stufen berechnet, ohne Signifikanztests und ohne Anpassung an die Zusammensetzung.
Was die Daten nicht aussagen
- Grundlage sind 14- bis 18-Jährige in 28 ausgewählten ländlichen Distrikten aus 26 Bundesstaaten. Die Gesamtzeile der Quelle ist keine repräsentative Quote für ganz Indien.
- Das Beobachtungsjahr ist 2023. Dass die Quelle im Oktober 2026 geprüft wurde, belegt weder eine Veränderung seit 2023 noch eine aktuelle Quote.
- Erfolg im Verfahren für Satzlesen und Bedeutung ist nicht allgemeines Verständnis von Englisch, Sprachfluss, das Lesen von E-Books oder eine Diagnose für einzelne Personen. Die Bedeutung kann in der örtlichen Sprache oder über wichtige Wörter erklärt werden.
- Die Produkte rekonstruieren veröffentlichte Bezugsgruppen. Interne Gewichtung, fehlende Einzelantworten und exakte Rohzahlen lassen sich nicht vollständig zurückgewinnen.
- Die Rundungsgrenzen sind keine Konfidenzintervalle. Fehlende Kovarianzen und Angaben zur Stichprobe erlauben keine begründeten Signifikanztests und keine Nachweise, dass Gruppen gleichwertig sind.
- Die Vergleiche nach Bildung und Geschlecht sind unbereinigt und beschreibend. Sie belegen weder ursächliche Wirkungen von Bildung noch angeborene Unterschiede der Fähigkeiten.
- Dies ist eine Sekundärberechnung: keine neue Befragung, kein erstmals gefundener Befund, keine Bewertung einzelner Personen, keine Billigung durch ASER und keine Lizenz, die Prüfungsinstrumente zu vervielfältigen.
- Die Zeilen nach Bildung und Geschlecht überschneiden sich mit der gesonderten Gesamtzeile und werden weder addiert noch gemittelt, um eine weitere Gesamtzahl zu bilden. Es gibt keine Anpassung nach Alter, Bildung oder anderen Merkmalen der Zusammensetzung.
- Die Studie schätzt keinen Effekt von Einschreibung oder Geschlecht, erklärt die Unterschiede zwischen den Gruppen nicht, bewertet kein Lehrmaterial und gibt keine Maßnahme vor.
Originalquellen
- ASER Centre, Annual Status of Education Report (Rural) 2023: Beyond Basics
Die Tabellen 13 und 14 liefern die 30 ausgewählten Zahlen. Die Beschreibung des Verfahrens im Bericht auf den gedruckten Seiten 219–220 legt fest, wie Lesen und Bedeutung aufeinander folgen. Es wird kein Text der Prüfung weitergegeben.
Abgerufen am 31. Oktober 2026
- ASER 2023: About the survey
Das offizielle Dokument zur Erhebung beschreibt die Auswahl, die Altersgruppe und den geografischen Zusammenhang. Die zusammengefasste Gruppe der Quelle wird nicht als ganz Indien bezeichnet.
Abgerufen am 31. Oktober 2026
- ASER Centre: ASER 2023 Beyond Basics source page
Die offizielle Übersichtsseite zu ASER 2023 verknüpft Bericht, Beschreibung der Erhebung und Material zu den Aufgaben. Ein Zugriffsdatum ersetzt kein Beobachtungsjahr.
Abgerufen am 31. Oktober 2026
- ASER 2023: Assessment tasks
Die offizielle Beschreibung der Aufgaben grenzt die verschiedenen Bereiche der Prüfung ab. Sie ist kein Beleg für allgemeines Sprachverständnis oder dafür, dass ein Leseangebot wirkt.
Abgerufen am 31. Oktober 2026
Studie zitieren und weiterverwenden
Alisson Bento. 2026. Englische Sätze lesen und ihre Bedeutung wiedergeben: Warum zwei Prozentwerte zwei Bezugsgruppen brauchen. Eigene Sekundäranalyse ausgewählter Gesamtwerte aus ASER 2023. https://alissonbento.com/de/research/aser-english-staged-reading-reach-2023/
Quelle der Zahlen: ASER Centre, Annual Status of Education Report (Rural) 2023: Beyond Basics. Berechnungen, Erläuterungen und eigene Grafiken: Alisson Bento. Die Originalgrafiken und Berechnungen dürfen mit Quellenangabe und einem Link zu dieser Studie weiterverwendet werden, wenn ihr Geltungsbereich und ihre Grenzen erhalten bleiben. Verwendet werden gekennzeichnete Zahlenangaben. Eine pauschale Lizenz für Texte des ASER-Berichts, Prüfungsinstrumente, Fotos oder Originalgrafiken wird nicht beansprucht. Diese Materialien gehören nicht zum öffentlichen Paket. ASER hat diese Sekundäranalyse weder durchgeführt noch gebilligt.
Korrekturen oder redaktionelle Fragen