
Eine Kapitelzählung ist auch eine Entscheidung über Grenzen
Ein Roman kann eine gleich bleibende Gesamtlänge haben und trotzdem unterschiedlich verteilte Kapitellängen ergeben. Dafür müssen sich die Wörter nicht ändern. Es genügt eine Entscheidung darüber, ob eine äußere Rahmenerzählung zum letzten nummerierten Kapitel gehört, ob einleitende Briefe als Kapitel zählen und ob eine Messung alle beibehaltenen Abschnitte abdeckt. Diese Untersuchung betrachtet solche Entscheidungen an zwei festgehaltenen Transkriptionen von Project Gutenberg: Pride and Prejudice, Nummer 1342, und der Fassung von Frankenstein aus dem Jahr 1831, Nummer 42324. Sie soll weder die Autorinnen einordnen noch ihre Gattungen kennzeichnen. Sie soll genau zeigen, wie eine ausdrücklich festgelegte Regel für die Struktur ein beschreibendes Ergebnis verändert.
Das zentrale Beispiel ist die abschließende Fortsetzung um Walton in der Frankenstein-Transkription. Bleibt dieser Abschnitt getrennt, haben die 24 benannten Kapitel einen Variationskoeffizienten (für die Population gerechnet) von 0,20839. Hängt man denselben Abschnitt an Kapitel XXIV an, steigt der Koeffizient auf 0,43033. Der Median bleibt bei 2.651 Wörtern, das Maximum steigt aber von 3.746 auf 8.269. Ein unveränderter Median heißt also nicht, dass sich die Verteilung nicht verändert hat. Auch die Abdeckung ändert sich, weil diese Kapitelgruppen unterschiedliche Teile des beibehaltenen Textes umfassen. Die vier einleitenden Briefe bleiben in beiden Definitionen, die nur Kapitel betrachten, außen vor.
Das sind deterministische Berechnungen für zwei bestimmte Dateien, keine Schätzungen aus einer repräsentativen Stichprobe fiktionaler Literatur. Dieselben Quelldateien dienten schon früher für eine andere Frage, nämlich welcher Anteil des Textes in Anführungszeichen steht. Hier messen wir benannte Einheiten der Struktur, ihre relative Größe und wie viel von der Gesamtzahl der Wörter des beibehaltenen Textes sie abdecken. Weder die Anteile des Textes in Anführungszeichen noch die bloße Gesamtzahl der Wörter zeigen die hier berichtete Verteilung, die von der Rahmenerzählung abhängt. Der Beitrag ist eine überprüfbare Berechnung für einen Fall. Wir behaupten nicht, das allgemeine Problem der Textsegmentierung neu entdeckt zu haben.
Zwei Transkriptionen, keine zwei allgemeingültigen Fassungen
Das Korpus wurde festgelegt, bevor wir Kapitellängen berechnet haben. Es umfasst genau die beiden zuvor festgehaltenen Dateien. Keine wurde nach Sicht der Ergebnisse durch eine günstigere ersetzt. Austens Transkription bezieht sich auf eine Quelle von George Allen aus dem Jahr 1894, mit einem Vorwort von George Saintsbury und Illustrationen von Hugh Thomson. Diese Ergänzungen sind aus dem gemessenen Text ausgeschlossen. Shelleys Datei nennt die Fassung von H. Colburn und R. Bentley aus dem Jahr 1831, vermittelt über einen nicht näher bezeichneten fotografischen Nachdruck. Dessen genaue bibliografische Identität ist nicht gesichert. „Quellenfassung von 1831“ ist deshalb genauer als die Behauptung, ein bestimmtes ursprüngliches Exemplar des Buches sei untersucht worden.
Die Identität der Ausgabe ist wichtig, weil die Darstellung der Kapitel, redaktionelle Zusätze, Typografie und die Praxis beim Transkribieren die rechnerisch erkannten Grenzen beeinflussen können. Project Gutenberg weist selbst darauf hin, dass seine Transkriptionen eine bestimmte Druckausgabe nicht identisch wiedergeben müssen. Die Ergebnisse beschreiben diese Transkriptionen. Sie beschreiben nicht alle Ausgaben, Handschriften, Übersetzungen oder Bearbeitungen der Werke. Wo die untersuchten Dateien im gemessenen Text keine ursprüngliche Einteilung in Bände liefern, rekonstruieren wir keine. Die Quellenangaben nennen die historisch Beteiligten, ohne ihre Urheberschaft der analysierenden Person zuzuschreiben.
Die Dateien wurden am 30. Oktober 2026 abgerufen. Dieses Datum bezeichnet den Abruf, nicht die Entstehung oder ursprüngliche Veröffentlichung der Romane. Der Katalog nennt für Austen derzeit eine Aktualisierung am 29. September 2026, während die Kopfzeile der festgehaltenen Datei den 1. September angibt. Wir setzen diese Angaben nicht gleich. Stattdessen bestimmt die Analyse ihre Eingabe durch die genaue Dateigröße in Bytes und die SHA-256-Prüfsumme. Bei Shelley nennen Katalog und Kopfzeile übereinstimmend den 23. Oktober 2026. Eine später ersetzte Datei gilt auch bei gleicher Gutenberg-Nummer nicht stillschweigend als dieselbe festgehaltene Eingabe.
Was die Zerlegung in Wörter misst
Jede berichtete Länge ist die Zahl der Wörter (Tokens), die der festgelegte Ausdruck [A-Za-z]+(?:['’][A-Za-z]+)* erzeugt. Er erkennt Folgen einfacher lateinischer Buchstaben, in denen gerade oder typografische Apostrophe stehen können. Ausdrücke mit Bindestrich werden in einzelne Wörter zerlegt, Ziffern zählen nicht als Wörter. Buchstaben mit Akzent und Ligaturen erfasst dieser Ausdruck nicht als vollständige Wörter aus Buchstaben. Weil die Regel unverändert bleibt, lässt sich die Berechnung wiederholen. Ihr Ergebnis ist aber keine allgemeine sprachwissenschaftliche Definition eines Wortes. „Wörter des beibehaltenen Textes“ oder „Wörter eines Abschnitts“ sind deshalb treffender als „reine Wörter der Erzählung“.
Vor der Zerlegung bleiben die Rohdaten (Bytes) unverändert und werden mit ihren festgehaltenen Prüfsummen verglichen. Eine Arbeitskopie wird in Text umgewandelt (dekodiert) und ihre Zeilenenden werden vereinheitlicht. Ganze Illustrationsblöcke mit zusammengehörigen Klammern werden durch Leerraum ersetzt. So bleiben die Zeichenpositionen im vereinheitlichten Text auch dann erhalten, wenn eine Bildunterschrift verschachtelte Klammern enthält. Das entfernt 154 Illustrationsblöcke im Text von Austen und zwei bei Shelley. Außerdem schließen wir drei nummerierte Blöcke mit Fußnoten bei Shelley aus. Mit den Bezeichnungen Footnote enthalten sie nach der Zerlegung 11 Wörter. Die übrigen Verweiszahlen ergeben keine Wörter aus Buchstaben. Titelei, Einleitungen, Vorworte, Nachspann und die Lizenz von Gutenberg liegen außerhalb der gewählten Grenzen.
Datierungen, Anreden, Unterschriften, Verse und eingebettete Briefe bleiben in den Abschnitten, in denen sie stehen. Shelleys erster Brief beginnt bei seiner Überschrift. Dadurch tragen seine einleitende Anrede und Datierung acht Wörter bei, die wegfielen, wenn man erst beim ersten Satz der Erzählung beginnen würde. Diese Entscheidungen definieren den Text der Abschnitte und keinen idealisierten reinen Prosatext. Würde man alle Zusätze zu Briefen oder alle Formatierungsblöcke entfernen, beantwortete man eine andere Frage und könnte bedeutungsvolle Briefe verwerfen. Die Analyse benennt deshalb ausdrücklich, welches Material eingeschlossen ist. Sie setzt nicht voraus, dass alles zwischen dem ersten und dem letzten Satz sprachlich gleichartig ist.
Alle neunzig Einheiten der Struktur bestimmen
Die Hauptaufteilung bei Austen enthält 61 Kapitel. Ihr erstes Kapitel braucht eine besondere Behandlung, weil die Bezeichnung Chapter I in einer Illustration vor dem ersten Satz der Erzählung eingebettet ist. Die erste Einheit beginnt bei diesem geprüften Satz. Die weiteren Überschriften reichen von II bis LXI. Bei XIII und XIV fehlt das Satzzeichen am Ende, XLVI verwendet gemischte Groß- und Kleinschreibung. Ein Programm, das genau ein großgeschriebenes Muster mit Satzzeichen verlangt, würde echte Grenzen übersehen. Umgekehrt würde eine Suche nach dem Wort chapter an beliebiger Stelle auch Verweise auf Illustrationen und anderes Material erfassen, das keine Grenze markiert. Keine dieser Abkürzungen gilt als ausreichender Nachweis.
Die Aufteilung bei Shelley umfasst vier einleitende Briefe, 24 benannte Kapitel und eine abschließende Fortsetzung um Walton, insgesamt also 29 Einheiten. Die Briefe haben ausdrückliche Überschriften und Übergänge mit Unterschriften, Anreden und Datierungen. Die abschließende Fortsetzung hat nach dem vorangehenden Einschnitt in der Erzählung eine eigene Überschrift und kehrt zur datierten äußeren Erzählung zurück. Eingebettete Briefe und die verschachtelte Erzählung des Geschöpfs bleiben in den benannten Kapiteln, in denen sie stehen. Datierungen innerhalb der abschließenden Fortsetzung schaffen keine neuen Kapitel. So bleibt der Unterschied zwischen einem redaktionell benannten Abschnitt, einer eingebetteten Geschichte und einem Wechsel von Sprechenden oder Anlass innerhalb eines Absatzes erhalten.
Jede mögliche Grenze wurde mit dem angrenzenden beibehaltenen Text verglichen und in einer eigenen Datei festgehalten, mit einer Beobachtung je Grenze. Ebenso wurden vollständige Folgen der Nummerierung, die Anfangspunkte und die abschließenden Endpunkte der Erzählung kontrolliert. Die Diagnosen enthalten Positionen in der Quelle und Prüfsummen statt unnötiger Textstellen. Das sind dokumentierte Prüfungen von Textzusammenhang und Rechnung. Wir behaupten keine Annotation durch Menschen, keine Übereinstimmung zwischen Annotierenden und keinen Goldstandard für den Inhalt. Die vollständigen Aufteilungen enthalten keine Abschnitte, die sich überlappen. Die Summe ihrer Wortzahlen entspricht der direkten Zerlegung des beibehaltenen Textes, nachdem die Überschriften ausgeschlossen wurden. Diese Gleichheit prüft die Rechnung zur Abdeckung. Die aufgezeichneten Beobachtungen begründen zugleich, warum die Grenzen sinnvoll sind.
Vollständige Aufteilungen und Abdeckung nur durch Kapitel
Die Aufteilung bei Austen enthält in der Hauptzählung 122.174 Wörter in 61 Kapiteln. Innerhalb des ausdrücklich definierten beibehaltenen Textes ist die Aufteilung in Kapitel vollständig: Ihre Abdeckung beträgt 100 %. Die vollständige Aufteilung bei Shelley enthält 75.228 Wörter in 29 Einheiten. Die 24 Kapitel, bei denen die Fortsetzung um Walton getrennt bleibt, umfassen 64.397 Wörter. Das sind 85,6024 % der Gesamtzahl der Wörter im vollständigen beibehaltenen Text. Der fehlende Anteil besteht nicht aus verlorenen Daten oder einem Fehler beim Auslesen. Es sind die ausdrücklich ausgeschlossenen vier einleitenden Briefe und die abschließende Rahmenerzählung, zusammen 10.831 Wörter.
Die einleitenden Briefe tragen 5.563 Wörter bei, die abschließende Fortsetzung 5.268. Hängt man Letztere an Kapitel XXIV an, steigt die Summe der Wörter in der Kapitelgruppe auf 69.665 und ihre Abdeckung auf 92,6051 %. Die vier einleitenden Briefe bleiben weiterhin ausgelassen. Es wäre deshalb falsch, diese Kapitelgruppe mit angehängter Rahmenerzählung den ganzen Roman zu nennen. Falsch wäre es auch, ihre Kapitellängen durch eine Gesamtzahl zu teilen, die verschweigt, dass es die Briefe gibt. Die vollständige Aufteilung in 29 Einheiten liefert die gemeinsame Gesamtzahl, an der man beide Arten der Kapitelbildung messen kann.
Abdeckung und Verteilung beantworten verschiedene Fragen. Die Abdeckung fragt, wie viel des beibehaltenen Textes zur ausgewählten Gruppe von Einheiten gehört. Der Median fragt nach der Mitte der geordneten Längen der Einheiten, wobei jede ausgewählte Einheit gleich viel zählt. Keine dieser Größen kann die andere ersetzen. Eine Verteilung kann regelmäßig aussehen und trotzdem viel Rahmenmaterial auslassen. Wer einen langen Abschnitt an eine vorhandene Einheit anhängt, kann den oberen Rand der Verteilung verändern, ohne die Mitte zu verschieben. Beide Maße zu berichten verhindert, dass eine bequeme Zusammenfassung der Kapitel unbemerkt nur einen Teil des Textes beschreibt.
Die Verteilungen hinter den Gesamtsummen
Für Austens 61 Kapitel der Hauptzählung beträgt der Median 1.835 Wörter. Das erste und das dritte Quartil (die Werte, unter denen ein Viertel bzw. drei Viertel der Kapitel liegen) betragen 1.563 und 2.335. Die kürzeste und die längste Einheit enthalten 676 und 5.188 Wörter. Der Variationskoeffizient für die Population beträgt 0,42458. Diese Kennzahlen unterscheiden die Mitte, die mittlere Hälfte und die äußeren Grenzen der beobachteten Längen. Die Endpunkte sind die tatsächlich kleinsten und größten Werte, keine Konfidenzgrenzen. Das längste Kapitel macht 4,2464 % der beibehaltenen Summe aller Kapitel aus. Das beschreibt mit einer anderen Bezugsgröße, wie stark sich der Text in der größten Einheit konzentriert.
Bei Shelleys vollständiger Aufteilung in 29 Einheiten beträgt der Median 2.616 Wörter, die Quartile liegen bei 2.074 und 3.015, die Werte reichen von 299 bis 5.268. Der Variationskoeffizient für die Population beträgt 0,34840. Diese Gruppe enthält Briefe und die abschließende Rahmenerzählung. Man darf ihre Verteilung deshalb nicht als Verteilung von 29 Kapiteln bezeichnen. Für die 24 Kapitel allein, bei getrennter Rahmenerzählung, beträgt der Median 2.651, die Quartile liegen bei 2.223 und 3.038, Minimum und Maximum bei 1.784 und 3.746. Das sind verschiedene Gruppen von Einheiten aus derselben festgehaltenen Transkription.
Austens größere Gesamtsumme geht in diesen beiden Fällen mit einer kleineren mittleren Kapitellänge einher. Das zeigt, dass die Gesamtlänge die Größe der Kapitel nicht eindeutig bestimmt. Zwei gezielt ausgewählte Transkriptionen können aber keinen allgemeinen Zusammenhang zwischen der Länge eines Romans und der Länge seiner Kapitel begründen. Wir schätzen weder eine Regression noch eine Korrelation in der Population, noch einen Effekt der Autorin oder des Autors, noch einen Vergleich von Gattungen. Die vollständige Tabelle mit der Zahl der Einheiten erlaubt es, die zugrunde liegende Verteilung zu prüfen. Man muss sich nicht allein auf verdichtete Kennzahlen verlassen. Das festgelegte Korpus verhindert zugleich, dass man nach der Berechnung ein günstigeres Beispiel auswählt.
Eine abschließende Rahmenerzählung verändert den oberen Rand der Verteilung
Die Gegenprobe mit angehängter Rahmenerzählung verändert eine bestehende Kapiteleinheit bei Shelley. Sie fügt kein fünfundzwanzigstes Kapitel hinzu. Die Fortsetzung mit 5.268 Wörtern wird mit dem letzten benannten Kapitel verbunden. So entsteht eine kombinierte Einheit mit 8.269 Wörtern. Die Zahl der Kapiteleinheiten bleibt 24, und die einleitenden Briefe bleiben außerhalb der Gruppe. Das Maximum steigt deshalb von 3.746 auf 8.269, das dritte Quartil von 3.038 auf 3.133,5. Der Median bleibt bei 2.651. Die veränderte Einheit gehört nämlich nicht zu den beiden mittleren Beobachtungen, aus denen man bei dieser geraden Zahl von Einheiten den Median berechnet.
Der Variationskoeffizient steigt von 0,20839 auf 0,43033. Er ist die Standardabweichung der Population geteilt durch den Mittelwert, wobei alle 24 Kapiteleinheiten gleich viel zählen. Wenn man zu einer schon vorhandenen Einheit viel hinzufügt, steigt zwar der Mittelwert. Zugleich entsteht aber ein deutlich längerer oberer Rand. Die relative Streuung steigt, statt durch den größeren Mittelwert ausgeglichen zu werden. Deshalb würde man eine wichtige Folge der Entscheidung über die Grenzen verbergen, wenn man nur den Durchschnitt oder den Median angibt. Die Änderung folgt zwangsläufig aus der angegebenen neuen Zuordnung. Sie ist weder eine Schwankung durch die Stichprobe noch ein geschätzter ursächlicher Effekt.
Austens Koeffizient der Hauptzählung, 0,42458, liegt zwischen den beiden Arten der Kapitelbildung bei Shelley. Die scheinbare Reihenfolge der Kapitelstreuung bei Austen und Shelley kehrt sich also um, wenn man die Fortsetzung um Walton anhängt. Dass sich die Reihenfolge so knapp umkehrt, warnt davor, eine unzureichend bezeichnete Kennzahl als Eigenschaft einer Autorin oder eines Autors zu verstehen. Es belegt nicht, dass eine der beiden Personen allgemein variabler schreibt. Die Entscheidung über die Struktur ist in der Transkription sichtbar, und beide Regeln lassen sich offen darstellen. Keine darf als die einzig natürliche Antwort gelten, ohne dass man erklärt, was mit der Rahmenerzählung und den einleitenden Briefen geschieht.
Beibehaltene Formatierung und eine eng begrenzte Gegenprobe
Eine gesonderte Prüfung fand sechs beibehaltene Formatierungsmarken bei Austen, die als Wörter mitgezählt werden: drei NIND und drei RIGHT. Zwei stehen in Kapitel VII, je eine in XIII, XLVII, XLIX und LII. Wegen dieser Marken kann man die festgehaltene Hauptsumme von 122.174 nicht als völlig bereinigte Zahl von Wörtern der Erzählung bezeichnen. Die Marken stehen in Formatierungsblöcken, die auch Anreden oder Datierungen enthalten. Würde man jeweils die ganzen Blöcke entfernen, ginge berechtigter Text der Abschnitte verloren. Das wäre keine angemessene Korrektur für das konkret festgestellte Problem.
Die festgelegte Gegenprobe entfernt deshalb nur diese sechs Marken an ihren aufgezeichneten Zeichenpositionen im vereinheitlichten Text. Sie ersetzt nicht die festgehaltene Hauptauswertung, ändert nicht die Zerlegung in Wörter und schreibt auch nicht das ursprüngliche Protokoll um, nachdem die Ergebnisse bekannt waren. Bei dieser begrenzten Änderung beträgt Austens Gesamtsumme 122.168 und der Variationskoeffizient 0,4245761045 statt 0,4245847284. Median, Quartile, Minimum und Maximum bleiben unverändert. Auch die zuvor beschriebene Umkehr der Reihenfolge der Streuung, die von der Regel abhängt, bleibt bestehen. Wir behalten Haupt- und Gegenprobe beide, damit der kleine Unterschied in den Zahlen sichtbar bleibt und nicht stillschweigend verschwindet.
Diese Prüfung beweist nicht, dass alle denkbaren Fehler der Transkription entfernt sind. Sie betrifft eine bestimmte beobachtete Gruppe von Marken und ist keine unbegrenzte Suche nach einer bevorzugten Zählung. Eine weitergehende sprachliche Bereinigung bräuchte eigene Regeln und Kontrollen, besonders bei Abkürzungen, Schreibung mit Bindestrich, Buchstaben mit Akzent und Zusätzen zu Briefen. Die vorliegende Schlussfolgerung ist enger: Das festgestellte Problem mit den sechs Marken erklärt das Ergebnis bei angehängter Rahmenerzählung nicht. Diese Trennung unterscheidet eine gemessene Prüfung der Robustheit von der Behauptung, der Text sei umfassend fehlerfrei.
Kapitelgrenzen und Regeln für Text in Anführungszeichen sind zwei verschiedene Messentscheidungen. Ihre Auswirkungen sagen nichts über Erzähltempo, Dialoganteil oder literarische Qualität aus. Wie die Regel für Anführungszeichen das Messergebnis in zwei Roman-Transkriptionen verändert
Die Berechnungen nachrechnen, ohne die Romane weiterzuverbreiten
Der kurze Weg zum Nachrechnen beginnt mit den bereitgestellten Zählungen je Einheit. Er berechnet die Kennzahlen der vollständigen Aufteilung und der Gruppen nur aus Kapiteln, die Gegenprobe mit angehängter Rahmenerzählung, die Abdeckung, die Quartile (mit inklusiver Methode) und die Variationskoeffizienten neu. Dafür braucht man keinen Download der Romane; erzeugt werden nur abgeleitete Daten. So bleibt die Rechnung zugänglich. Fragen zum Urheberrechtsstatus und zur zuständigen Rechtsordnung bei einer Weiterverbreitung der Quelltexte bleiben von der Rechenaufgabe getrennt. Ein zweiter, optionaler Weg prüft die genauen Rohdateien mit ihren aufgezeichneten Prüfsummen. Danach wiederholt er das Auslesen mit ausdrücklich angegebenen Verzeichnissen für Eingabe und Ausgabe.
Die Kontrollen beim Auslesen verwenden zwei Umsetzungen mit unterschiedlichem Aufbau. Die eine behält Positionen, indem sie ausgeschlossene Blöcke überdeckt, und erkennt benannte Überschriften. Die andere entfernt verschachtelte Klammerblöcke Schritt für Schritt und fasst Zeilen zu Abschnitten zusammen. Die Zählungen stimmen für alle 90 Einheiten überein. Diese zweite Umsetzung prüft unmittelbar die vollständigen Aufteilungen. Eine gesonderte Neuberechnung kontrolliert zusätzlich die Kennzahlen der Gruppen nur aus Kapiteln und der Gruppe mit angehängter Rahmenerzählung. Die Übereinstimmung stützt die Umsetzung für diese Eingaben. Sie schafft aber keinen unabhängigen Maßstab für die Annotation des Inhalts. Die Protokolle der Beobachtungen und die erklärte Regel für die Rahmenerzählung bleiben neben der übereinstimmenden Rechnung notwendige Belege.
Die Quartile werden mit inklusiver linearer Interpolation berechnet. Der Variationskoeffizient verwendet die Standardabweichung der Population, nicht die Standardabweichung einer Stichprobe. Für genaue Zählungen festgehaltener Dateien erfinden wir kein Unsicherheitsintervall. Relevante Unsicherheiten betreffen die Ausgaben, die Definition der Wörter, die beibehaltene Formatierung und die Deutung der Struktur. Sie betreffen keinen Stichprobenfehler dieser vollständigen Gruppen von Einheiten. Die Dokumentation zum Nachrechnen erläutert, wovon Prüfsummen berechnet werden und wie die Positionen im vereinheitlichten Text definiert sind. Eine Prüfsumme des Haupttextes nach dem Überdecken mit Leerraum bezeichnen wir nicht als Prüfsumme eines ursprünglichen Ausschnitts des Rohtextes. Eine veränderte Quelldatei besteht die Prüfung nicht. Unter unverändertem Dateinamen entsteht dann kein scheinbar vergleichbares Ergebnis.
Reichweite, Rechte und die Schlussfolgerung, die trägt
Beide aktuellen Einträge von Gutenberg kennzeichnen die Werke als in den Vereinigten Staaten gemeinfrei. Die erhaltenen Dateiköpfe warnen Nutzende außerhalb der USA, das jeweils geltende Recht zu prüfen. Diese Analyse macht daraus weder eine rechtliche Freigabe für die ganze Welt noch eine Lizenz für die Marke oder die Erlaubnis, beliebiges Quellenmaterial überall zu veröffentlichen. Die öffentlich vorgesehenen Materialien enthalten kompakte abgeleitete Zählungen, Berechnungen, Diagnosen zu den Grenzen und Verweise, keine vollständigen Romane, Illustrationen oder Vorworte. Die Zuschreibung unterscheidet die ursprünglichen Autorinnen und die Mitwirkenden an den Quellen von den eigenen Berechnungen und Erläuterungen von Alisson Bento.
Mehrere Fragen bleiben außerhalb der Datengrundlage. Die Auswahl repräsentiert weder Autorinnen und Autoren noch Gattungen, Nationalliteraturen oder das heutige Verlagswesen. Die Zahl der Wörter misst weder Lesezeit noch empfundenes Erzähltempo, Aufmerksamkeit, literarische Qualität, Geschmack der Lesenden oder Schwierigkeit des Textes. Die nicht näher bestimmte Identität von Shelleys fotografischem Nachdruck begrenzt die bibliografische Genauigkeit. Die Quelldateien sind Transkriptionen und keine garantierten Faksimiles. Die Grafiken vergleichen erklärte Messungen, keine konkurrierenden literarischen Leistungen. Diese Einschränkungen gehören zur Deutung. Sie sind kein Grund, ein sonst nachprüfbares Ergebnis zur Struktur zu unterdrücken.
Die gestützte Schlussfolgerung lautet: Wer eine Verteilung von Kapitellängen angibt, muss ausdrücklich erklären, was als Kapitel zählt und was außerhalb bleibt. In der Shelley-Transkription verändert es den oberen Rand der Verteilung und die relative Streuung erheblich, ob man die abschließende Rahmenerzählung abtrennt oder anhängt. Der Median bleibt dabei unverändert. Die vollständige Aufteilung und die Werte zur Abdeckung machen die einleitenden Briefe sichtbar, die beide Arten der Kapitelbildung auslassen. Austen liefert eine Gegenprobe mit einer vollständigen Aufteilung in Kapitel und eine offene kleine Prüfung der Formatierung. Sie ist keine repräsentative Kontrollgruppe. Zusammen zeigen die Fälle, warum Verteilungen, Abdeckung, Herkunft der Quelle und Regeln für Grenzen in denselben Bericht über die Messung gehören.
Die Streuung der Kapitel hängt von der Regel für die Rahmenerzählung ab
Alle fünf definierten Gruppen; Variationskoeffizient der Population und Abdeckung des vollständigen beibehaltenen Textes.
Vollständige Grafik und Quelle
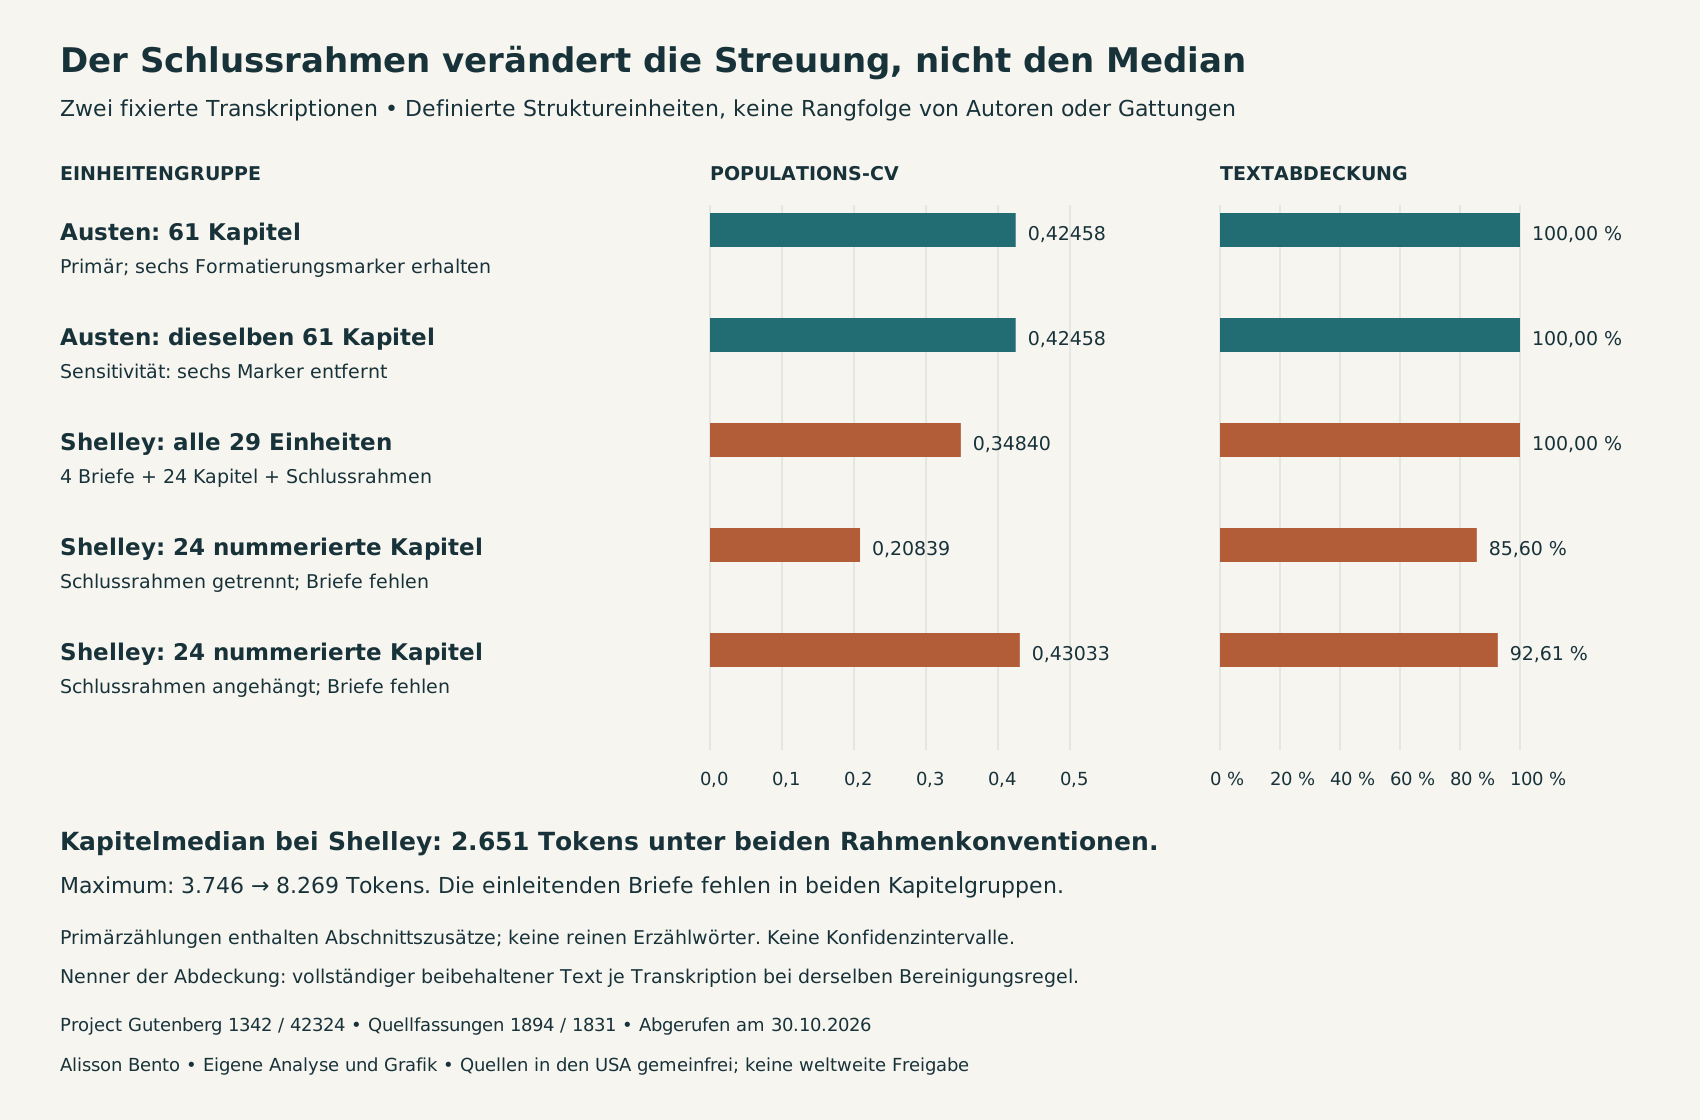
Diagramm seitlich scrollen, um alle Details zu sehen. ↔
Grafik und Werte
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Gruppe von Einheiten | Einheiten | Wörter | Minimum | Q1 (erstes Quartil) | Median | Q3 (drittes Quartil) | Maximum | Variationskoeffizient (Population) | Abdeckung (%) |
|---|---|---|---|---|---|---|---|---|---|
| Austen: 61 Kapitel (Hauptzählung) | 61 | 122.174 | 676 | 1.563,0 | 1.835,0 | 2.335,0 | 5.188 | 0,42458 | 100,0000 |
| Austen: sechs Marken entfernt | 61 | 122.168 | 676 | 1.563,0 | 1.835,0 | 2.335,0 | 5.188 | 0,42458 | 100,0000 |
| Shelley: alle 29 Einheiten | 29 | 75.228 | 299 | 2.074,0 | 2.616,0 | 3.015,0 | 5.268 | 0,34840 | 100,0000 |
| Shelley: 24 Kapitel; Rahmenerzählung getrennt | 24 | 64.397 | 1.784 | 2.223,0 | 2.651,0 | 3.038,0 | 3.746 | 0,20839 | 85,6024 |
| Shelley: 24 Kapitel; Rahmenerzählung angehängt | 24 | 69.665 | 1.784 | 2.223,0 | 2.651,0 | 3.133,5 | 8.269 | 0,43033 | 92,6051 |
Wörter nach der festgelegten Zerlegung in einfache lateinische Buchstaben, keine reinen Wörter der Erzählung. Der Variationskoeffizient nutzt die Standardabweichung der Population. Die Bezugsgröße der Abdeckung ist der vollständige beibehaltene Text bei derselben Regel für die Bereinigung; keine Intervalle für Stichproben. Die Austen-Zeile ohne sechs Marken ist eine gesonderte Gegenprobe, kein Ersatz. In beiden Zeilen von Shelley, die nur Kapitel enthalten, fehlen vier einleitende Briefe.
Daten und Downloads
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Gruppe von Einheiten | Einheiten | Wörter | Minimum | Q1 (erstes Quartil) | Median | Q3 (drittes Quartil) | Maximum | Variationskoeffizient (Population) | Abdeckung (%) |
|---|---|---|---|---|---|---|---|---|---|
| Austen: 61 Kapitel (Hauptzählung) | 61 | 122.174 | 676 | 1.563,0 | 1.835,0 | 2.335,0 | 5.188 | 0,42458 | 100,0000 |
| Austen: sechs Marken entfernt | 61 | 122.168 | 676 | 1.563,0 | 1.835,0 | 2.335,0 | 5.188 | 0,42458 | 100,0000 |
| Shelley: alle 29 Einheiten | 29 | 75.228 | 299 | 2.074,0 | 2.616,0 | 3.015,0 | 5.268 | 0,34840 | 100,0000 |
| Shelley: 24 Kapitel; Rahmenerzählung getrennt | 24 | 64.397 | 1.784 | 2.223,0 | 2.651,0 | 3.038,0 | 3.746 | 0,20839 | 85,6024 |
| Shelley: 24 Kapitel; Rahmenerzählung angehängt | 24 | 69.665 | 1.784 | 2.223,0 | 2.651,0 | 3.133,5 | 8.269 | 0,43033 | 92,6051 |
Wörter nach der festgelegten Zerlegung in einfache lateinische Buchstaben, keine reinen Wörter der Erzählung. Der Variationskoeffizient nutzt die Standardabweichung der Population. Die Bezugsgröße der Abdeckung ist der vollständige beibehaltene Text bei derselben Regel für die Bereinigung; keine Intervalle für Stichproben. Die Austen-Zeile ohne sechs Marken ist eine gesonderte Gegenprobe, kein Ersatz. In beiden Zeilen von Shelley, die nur Kapitel enthalten, fehlen vier einleitende Briefe.
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Bestandteil oder Gruppe | Einheiten | Wörter |
|---|---|---|
| Einleitende Briefe | 4 | 5.563 |
| Benannte Kapitel, Rahmenerzählung getrennt | 24 | 64.397 |
| Abschließende Fortsetzung um Walton | 1 | 5.268 |
| Vollständige Aufteilung | 29 | 75.228 |
| Benannte Kapitel, Rahmenerzählung angehängt | 24 | 69.665 |
Die abschließende Rahmenerzählung ist ausdrücklich eine eigene Einheit und nicht stillschweigend ein Kapitel. Die Kapitelgruppe mit angehängter Rahmenerzählung schließt die einleitenden Briefe weiterhin aus.
Daten und Methode
So haben wir gerechnet
- Wir verwenden ein festes Korpus (PG1342 und PG42324) mit genauen Prüfsummen. Die Grenzen der Abschnitte und die Zerlegung in Wörter wurden vor den Berechnungen der Längen festgehalten.
- Wir stützen uns auf 90 Beobachtungen zu Grenzen auf Ebene der Einheiten, vollständige Kontrollen der Nummerierung und ausdrückliche Anfangs- und Endpunkte. Einen Goldstandard durch Annotation von Menschen behaupten wir nicht.
- Ganze Illustrationsblöcke werden überdeckt, nummerierte Fußnoten ausgeschlossen und Zusätze in Abschnitten beibehalten. Austens Hauptzählung enthält sechs dokumentierte Formatierungsmarken.
- Die Quartile berechnen wir mit inklusiver Interpolation, den Variationskoeffizienten für die Population. Für vollständige Gruppen, benannte Kapitel und Gruppen mit angehängter Rahmenerzählung gelten ausdrücklich definierte Bezugsgrößen für die Abdeckung.
- Standardmäßig rechnet man nur mit zusammengefassten Daten nach; optional lassen sich die Rohtexte mit genauer Prüfsummenkontrolle auslesen. Eine anders aufgebaute Umsetzung stimmt bei allen 90 Zählungen je Einheit überein, und gesonderte Prüfungen der Rechnung erfassen alle Gruppen von Kennzahlen.
Was die Daten nicht aussagen
- Zwei gezielt gewählte Transkriptionen können Autorinnen und Autoren, Gattungen, Epochen oder Populationen nicht repräsentieren; es wird kein Zusammenhang der Längen für eine Grundgesamtheit abgeleitet.
- Wortzahlen messen weder literarische Qualität, Geschmack, empfundenes Erzähltempo, Aufmerksamkeit noch Lesezeit.
- Die Zerlegung in einfache lateinische Buchstaben und beibehaltene Zusätze in Abschnitten erlauben es nicht, die Zahlen als reine Wörter der Erzählung zu deuten. Die Gegenprobe mit sechs Marken ist eng begrenzt und keine vollständige Bereinigung.
- Transkriptionen von Gutenberg sind keine garantierten Faksimiles der Druckausgabe; die Identität von Shelleys fotografischem Nachdruck ist nicht näher bestimmt.
- Angaben zur Gemeinfreiheit in den USA begründen weder Rechte außerhalb der USA noch eine weltweite Lizenz noch eine überall geltende Erlaubnis, die Quelltexte weiterzuverbreiten.
Originalquellen
- Project Gutenberg 1342: Pride and Prejudice
Project Gutenberg 1342: Pride and Prejudice: Die Titelei der festgehaltenen Transkription nennt George Allen 1894, Saintsburys Vorwort und Thomsons Illustrationen; zusätzliche Materialien sind ausgeschlossen. Der offizielle Eintrag weist Gemeinfreiheit in den USA aus. Die Aktualisierung am 1. September in der Kopfzeile der Rohdatei weicht vom Datum im Katalog, dem 29. September 2026, ab; die genaue Prüfsumme der Datei bestimmt die Eingabe.
Abgerufen am 30. Oktober 2026
- Project Gutenberg 42324: Frankenstein
Project Gutenberg 42324: Frankenstein: Fassung von H. Colburn/R. Bentley aus dem Jahr 1831 über einen nicht näher bestimmten fotografischen Nachdruck, nicht die Fassung von 1818. Einleitung ausgeschlossen; die Identität des Nachdrucks bleibt unbestimmt. Der offizielle Eintrag weist Gemeinfreiheit in den USA aus; Kopfzeile der Datei und Katalog nennen den 23. Oktober 2026 als Datum der Aktualisierung.
Abgerufen am 30. Oktober 2026
- Project Gutenberg Permission How-to
Project Gutenberg, Hinweise zu Genehmigungen: Erläutert die Grenzen außerhalb der Rechtsordnung der USA und warnt, dass Transkriptionen nicht unbedingt einer bestimmten Druckausgabe entsprechen. Daraus wird weder eine allgemeine Freigabe der Rechte noch eine Billigung abgeleitet.
Abgerufen am 30. Oktober 2026
Studie zitieren und weiterverwenden
Alisson Bento. Wenn eine abschließende Rahmenerzählung die Verteilung der Kapitellängen verändert. Messung der Struktur anhand der Transkriptionen 1342 und 42324 von Project Gutenberg, abgerufen am 30. Oktober 2026; Quellenfassungen von 1894 und 1831. https://alissonbento.com/de/research/chapter-frame-length-two-transcriptions/
Eigene Analyse, Berechnungen und Erläuterungen: Alisson Bento. Ursprüngliche Romane: Jane Austen und Mary Wollstonecraft Shelley. Saintsburys Vorwort und Thomsons Illustrationen in der Austen-Quelle sind ausgeschlossen; Shelleys Quelle ist die Fassung von 1831 über einen nicht näher bestimmten fotografischen Nachdruck. Gutenberg kennzeichnet die Werke als in den USA gemeinfrei; eine allgemeine rechtliche Freigabe oder Billigung wird nicht behauptet. Nur kompakte abgeleitete Daten und Programmcode, keine vollständigen Romane.
Korrekturen oder redaktionelle Fragen