
Uma média útil ainda pode esconder seus componentes
Entre adultos de 16 a 65 anos que estavam empregados nos Estados Unidos, na pesquisa domiciliar PIAAC de 2017, um único indicador de leitura de livros pelo menos uma vez por semana, no trabalho ou fora dele, reúne três grupos diferentes. A média de proficiência avaliada em leitura e compreensão de textos (literacy, ou letramento) do conjunto é de 281,5 pontos. Esse número é uma descrição válida da população reunida, não uma média errada. Mas ele não mostra que o componente que lê toda semana só no trabalho tem média de 261,5, enquanto os componentes que leem só fora do trabalho e nos dois contextos têm médias de 284,7 e 284,6. São resumos históricos e sem ajuste de grupos, não avaliações individuais nem efeitos da leitura.
A diferença não é apenas que uma média nacional esconde variação. A regra de agrupamento é explícita: ler livros toda semana em pelo menos um de dois contextos, registrados separadamente, vira uma única categoria positiva. Dentro dela, quem lê só fora do trabalho é 65,1%, quem lê só no trabalho é 13,6% e quem lê nos dois contextos é 21,3%. Por isso, o resultado do grupo reunido fica numericamente muito mais perto dos dois componentes maiores, de média mais alta, do que do componente menor, o de leitura só no trabalho. Chamar todos esses de leitores frequentes de livros mantém a frequência em qualquer dos contextos, mas descarta qual contexto a produziu.
Este estudo mede essa simplificação descritiva com um conjunto fixo de comparações. Ele mantém os quatro estados conjuntos de leitura, informa a composição deles e examina uma média e uma parcela na faixa inferior da proficiência. Não estima a distribuição completa da proficiência nem inventa um índice geral de perda de informação. Também não defende que pesquisadores nunca devam combinar contextos. A pergunta é o que uma estatística combinada específica deixa de dizer a quem lê e quanta incerteza acompanha as descrições dos componentes que devolvem essa informação.
Duas perguntas sobre livros, uma população histórica de trabalhadores
A fonte é o arquivo domiciliar de uso público de 2017, dos Estados Unidos, do Programa Internacional de Avaliação das Competências dos Adultos (PIAAC). A análise seleciona pessoas que estavam empregadas, com 16 a 65 anos, com resposta válida às duas perguntas sobre frequência de leitura de livros e com peso amostral final positivo e finito. O conjunto de respostas sobre leitura resultante tem 2.395 registros. Ele não descreve todos os adultos dos EUA, as condições atuais, escolares, desempregados nem todos os que já tiveram um emprego. A definição de emprego também alcança o trabalho por conta própria e o trabalho em negócio da família que se enquadrem, e não só empregados.
O item do trabalho, G_Q01E, pergunta com que frequência a pessoa lê livros no emprego. O roteiro oficial do questionário liga os trabalhadores selecionados ao emprego atual, e não a um emprego anterior. O item de fora do trabalho, H_Q01E, trata da leitura de livros, de ficção ou não ficção, fora do trabalho. Para quem está matriculado em algum curso, as instruções incluem expressamente a leitura para os estudos. Assim, “fora do trabalho” não significa só lazer, nem leitura feita fisicamente em casa, nem leitura sem relação com os estudos. Os dois contextos podem incluir telas eletrônicas; nenhum dos itens identifica um livro, um gênero, um idioma ou uma quantidade de texto.
Os dois itens têm cinco categorias de frequência. Este estudo define “pelo menos semanal” como as duas respostas mais altas e “menos que semanal” como as outras três respostas válidas. Menos que semanal inclui “nunca”, mas não é sinônimo de nunca. Respostas ausentes, recusadas, desconhecidas ou puladas pelo roteiro não viram “não leitura”. Outro campo, H_Q01E_T, é uma recodificação resumida do item sobre a leitura fora do trabalho, feita para acompanhar tendências, e não um segundo relato independente. Tratar essa recodificação como um instrumento separado criaria uma comparação que as observações de origem não oferecem.
Os quatro estados e a composição do grupo reunido
Na população de trabalhadores selecionada, 53,3% leem livros menos que semanalmente nos dois contextos, 30,4% leem pelo menos toda semana só fora do trabalho, 6,4% só no trabalho e 10,0% nos dois. Esses percentuais são descrições ponderadas da população, não percentuais brutos da amostra. Por causa do arredondamento, os componentes exibidos podem não somar exatamente cem. Os quatro grupos descrevem uma classificação conjunta de frequência; nenhum identifica leitores de toda a vida, não leitores permanentes, qualidade de leitura nem uma identidade pessoal fixa.
Considerar só quem lê toda semana em algum contexto muda o denominador. Dentro desse grupo reunido, as parcelas estimadas dos componentes são: 65,1% só fora do trabalho, com intervalo de confiança aproximado de 95% de 61,5% a 68,4%; 13,6% só no trabalho, com intervalo de 11,4% a 16,2%; e 21,3% nos dois, com intervalo de 18,4% a 24,6%. Essas parcelas condicionais explicam a mistura representada pela estatística reunida de proficiência. Elas não devem ser confundidas com as parcelas correspondentes entre todos os trabalhadores elegíveis.
As contagens sem ponderação são 1.234 que leem menos que semanalmente nos dois contextos, 765 só fora do trabalho, 157 só no trabalho e 239 nos dois, o que dá 1.161 registros no grupo que lê toda semana em algum contexto. Cada grupo cumpre os mínimos definidos de antemão no estudo: 62 observações, suporte efetivo de Kish de pelo menos 30 e denominadores positivos em todas as réplicas ativas. A medida de Kish descreve a dispersão dos pesos amostrais; não garante precisão ajustada ao desenho da pesquisa. Cumprir essas verificações de suporte permite estimar, mas não torna todos os componentes igualmente precisos nem dispensa mostrar os intervalos.
O que as médias de proficiência avaliada descrevem
A média de quem lê só fora do trabalho é de 284,7 pontos, com intervalo de confiança aproximado de 95%, pontual, de 280,4 a 289,0. A média de quem lê só no trabalho é 261,5, com intervalo de 252,3 a 270,6. Para quem lê toda semana nos dois contextos, a média é 284,6, com intervalo de 277,2 a 292,0. A média do grupo reunido, que lê toda semana em algum contexto, é 281,5, com intervalo de 277,8 a 285,3. O grupo de referência, que lê menos que semanalmente nos dois contextos, tem média de 269,4, com intervalo de 265,9 a 272,9.
Esses números resumem a proficiência avaliada em inglês, e não inteligência, valor pessoal, gosto literário ou qualidade dos livros que as pessoas escolhem. O PIAAC mede a capacidade de adultos de compreender e usar informação escrita, por meio de uma avaliação estruturada. As perguntas de contexto registram frequências declaradas pelas próprias pessoas; não são experimentos que atribuem livros ou condições de leitura. As diferenças podem refletir trajetórias de estudo, experiências com a língua, seleção para empregos, tarefas do trabalho e outras características. Uma média mais baixa de um grupo não prova que ler no trabalho reduza a proficiência, assim como uma média mais alta não prova um benefício causado pela leitura por lazer.
A largura dos intervalos das médias também difere bastante: 8,7 pontos para quem lê só fora do trabalho, 18,3 para quem lê só no trabalho e 14,8 para quem lê nos dois contextos. O componente que lê só no trabalho é o menor dos três e tem o intervalo mais largo. O intervalo do grupo reunido é mais estreito, 7,5 pontos, mas essa precisão se refere ao grupo reunido, não a cada componente dele. Trocar cada componente pela média do grupo reunido daria uma resposta mais precisa a outra pergunta descritiva, e não resolveria a incerteza sobre o próprio componente.
Uma medida da faixa inferior acrescenta outra perspectiva
O segundo resumo de proficiência é a parcela abaixo de 226 pontos, que corresponde ao Nível 1 ou abaixo pelo limite contínuo oficial. O limite é aplicado separadamente a cada valor plausível (uma das dez pontuações possíveis de cada pessoa, usadas para estimar populações), antes de reunir as estimativas da população. Não é aplicado à média dos valores plausíveis de uma pessoa, e ninguém é classificado com um nível diagnosticado. Essa única medida da faixa inferior complementa a média, mas as duas ainda não descrevem uma distribuição inteira nem mostram como cada parte da escala difere.
A parcela estimada no Nível 1 ou abaixo é de 11,8% entre quem lê só fora do trabalho, com intervalo de confiança aproximado de 9,2% a 15,2%; de 23,3% entre quem lê só no trabalho, com intervalo de 15,0% a 34,3%; e de 11,3% entre quem lê nos dois contextos, com intervalo de 7,1% a 17,5%. O grupo reunido de leitores frequentes tem parcela de 13,3%, com intervalo de 10,6% a 16,5%. O grupo de referência, que lê menos que semanalmente nos dois contextos, tem parcela de 19,1%, com intervalo de 16,3% a 22,3%.
O intervalo da faixa inferior de quem lê só no trabalho é bem mais largo do que os dos outros componentes de leitores frequentes. Essa incerteza continua visível, mesmo com uma estimativa pontual diferente da do grupo reunido. A amplitude descritiva entre os componentes vai de 11,3% a 23,3%; não é um intervalo de confiança, um método de classificação nem pontos extremos escolhidos de forma independente. Todos os resultados especificados são mantidos. Não houve busca por outros pontos de corte, faixas etárias, ocupações ou anos de pesquisa para achar um contraste mais forte depois de ver estes resultados.
Os contrastes fixos incluem diferenças compatíveis com zero
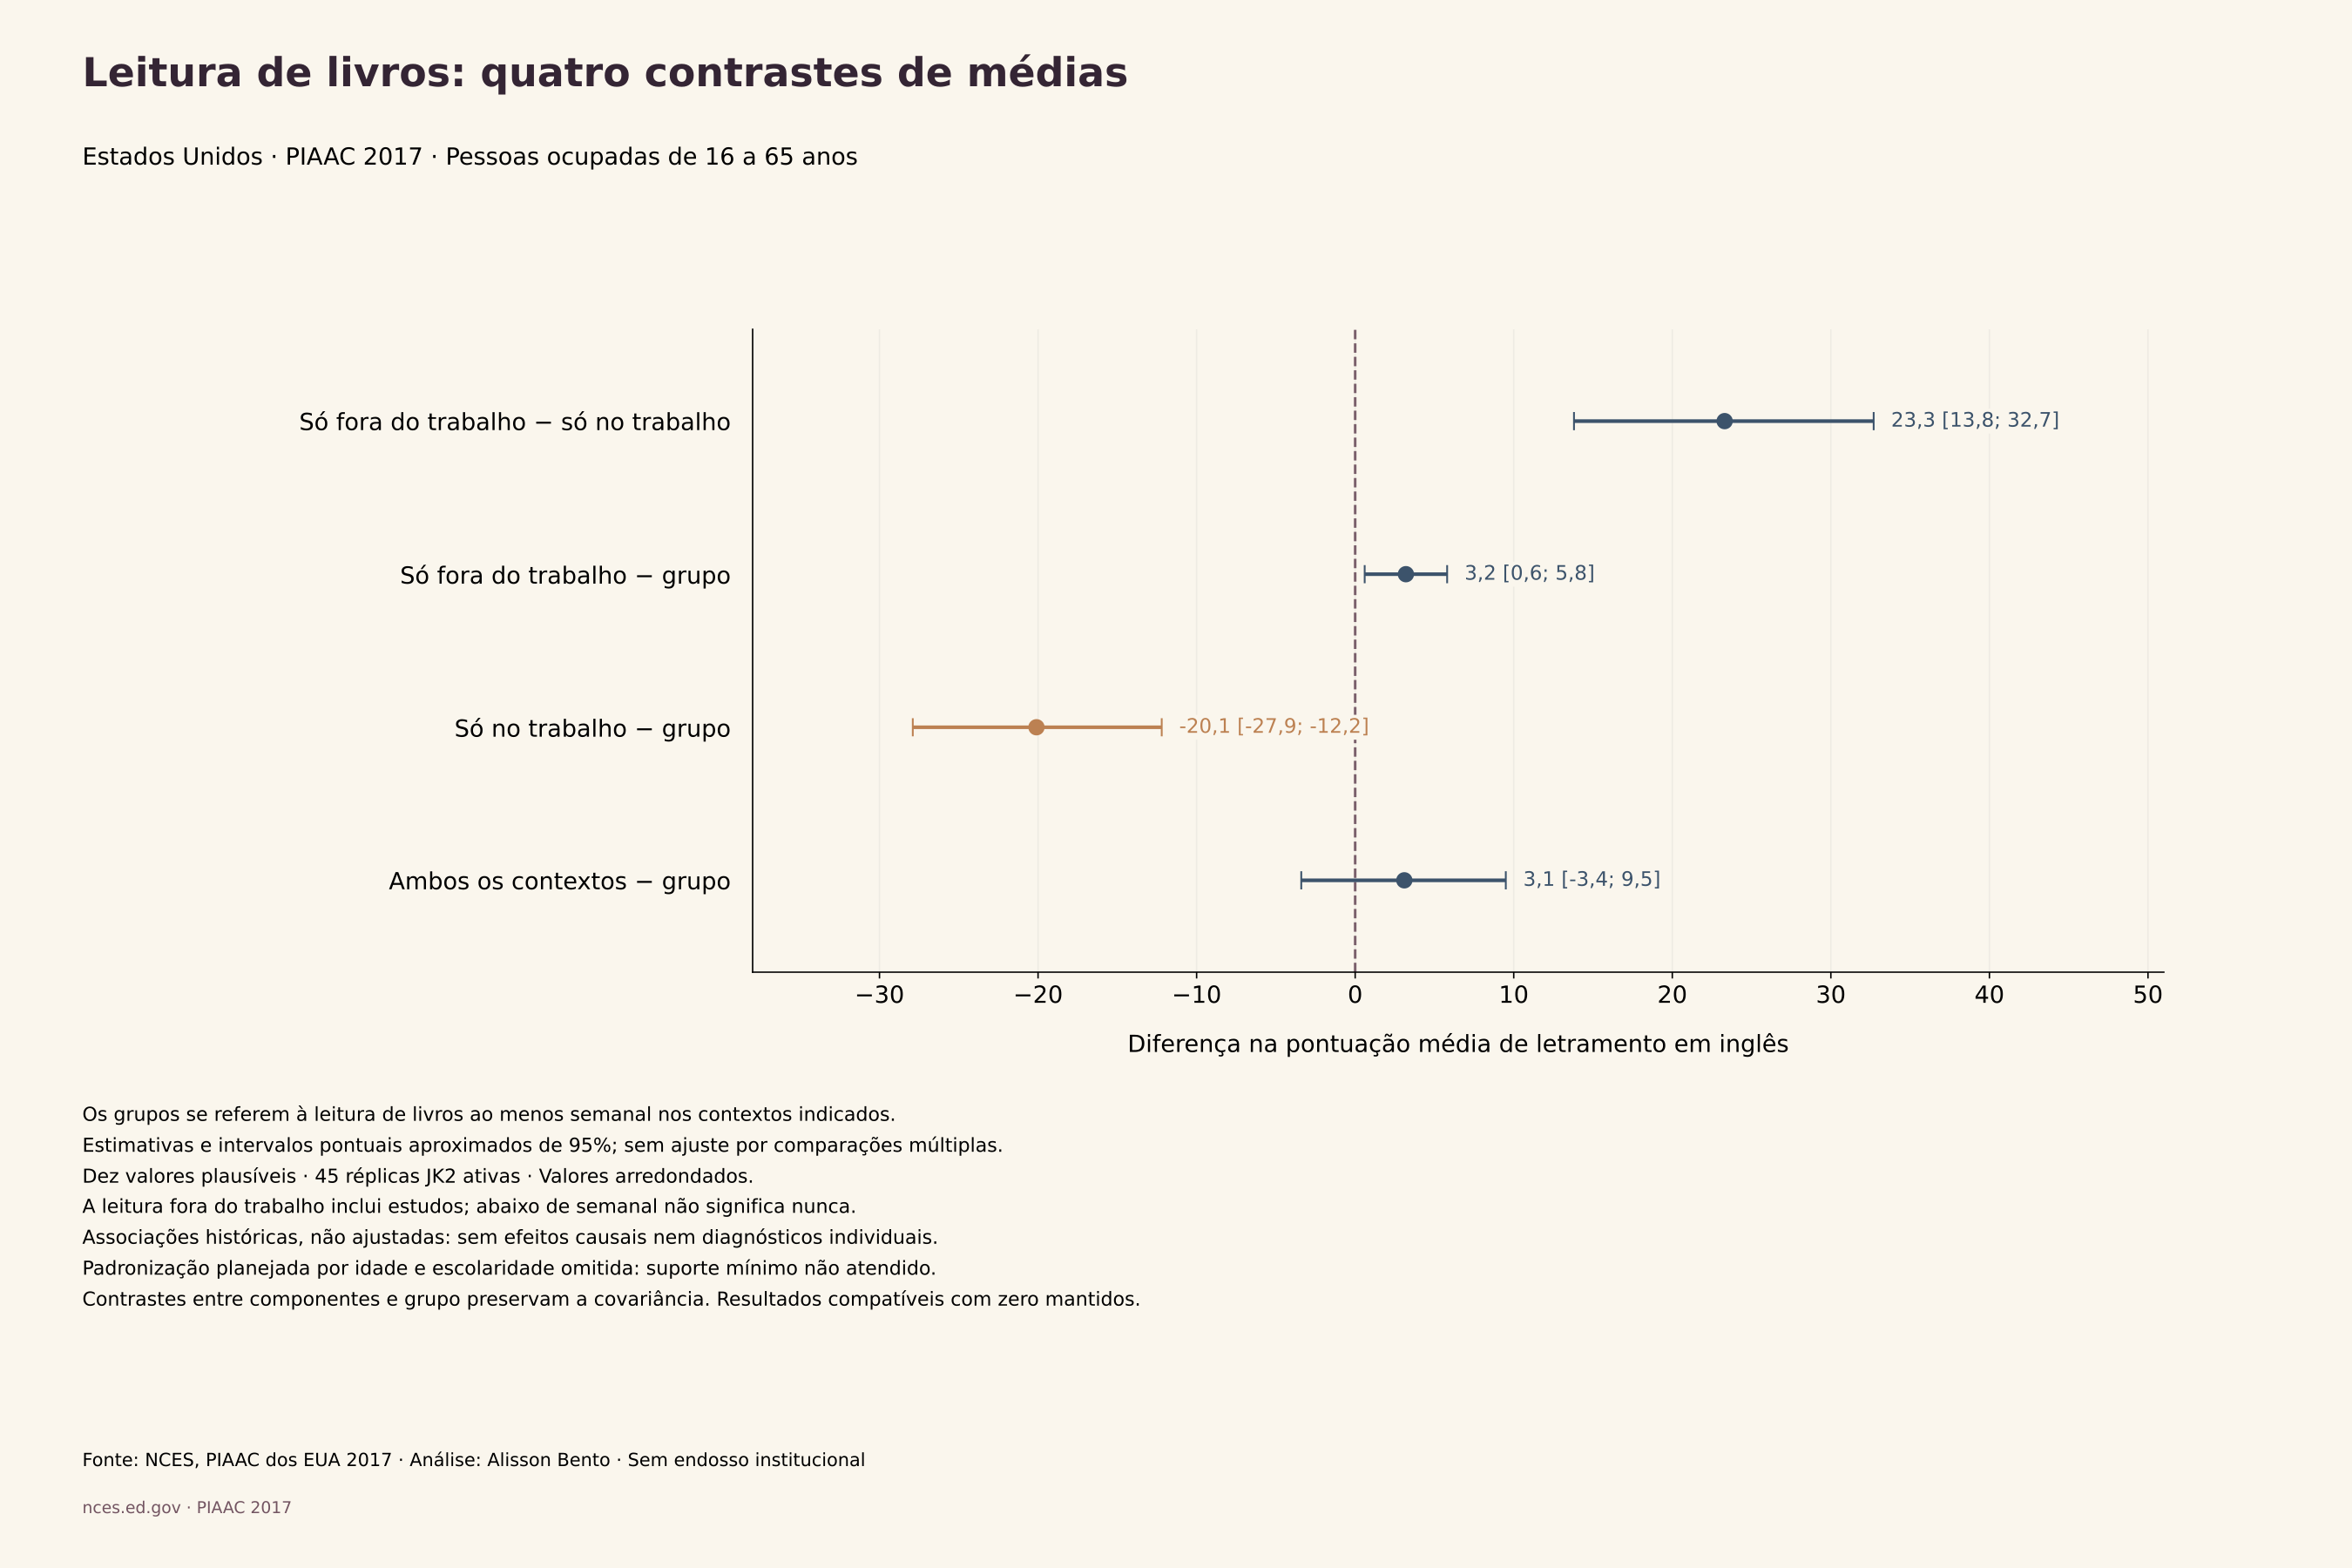
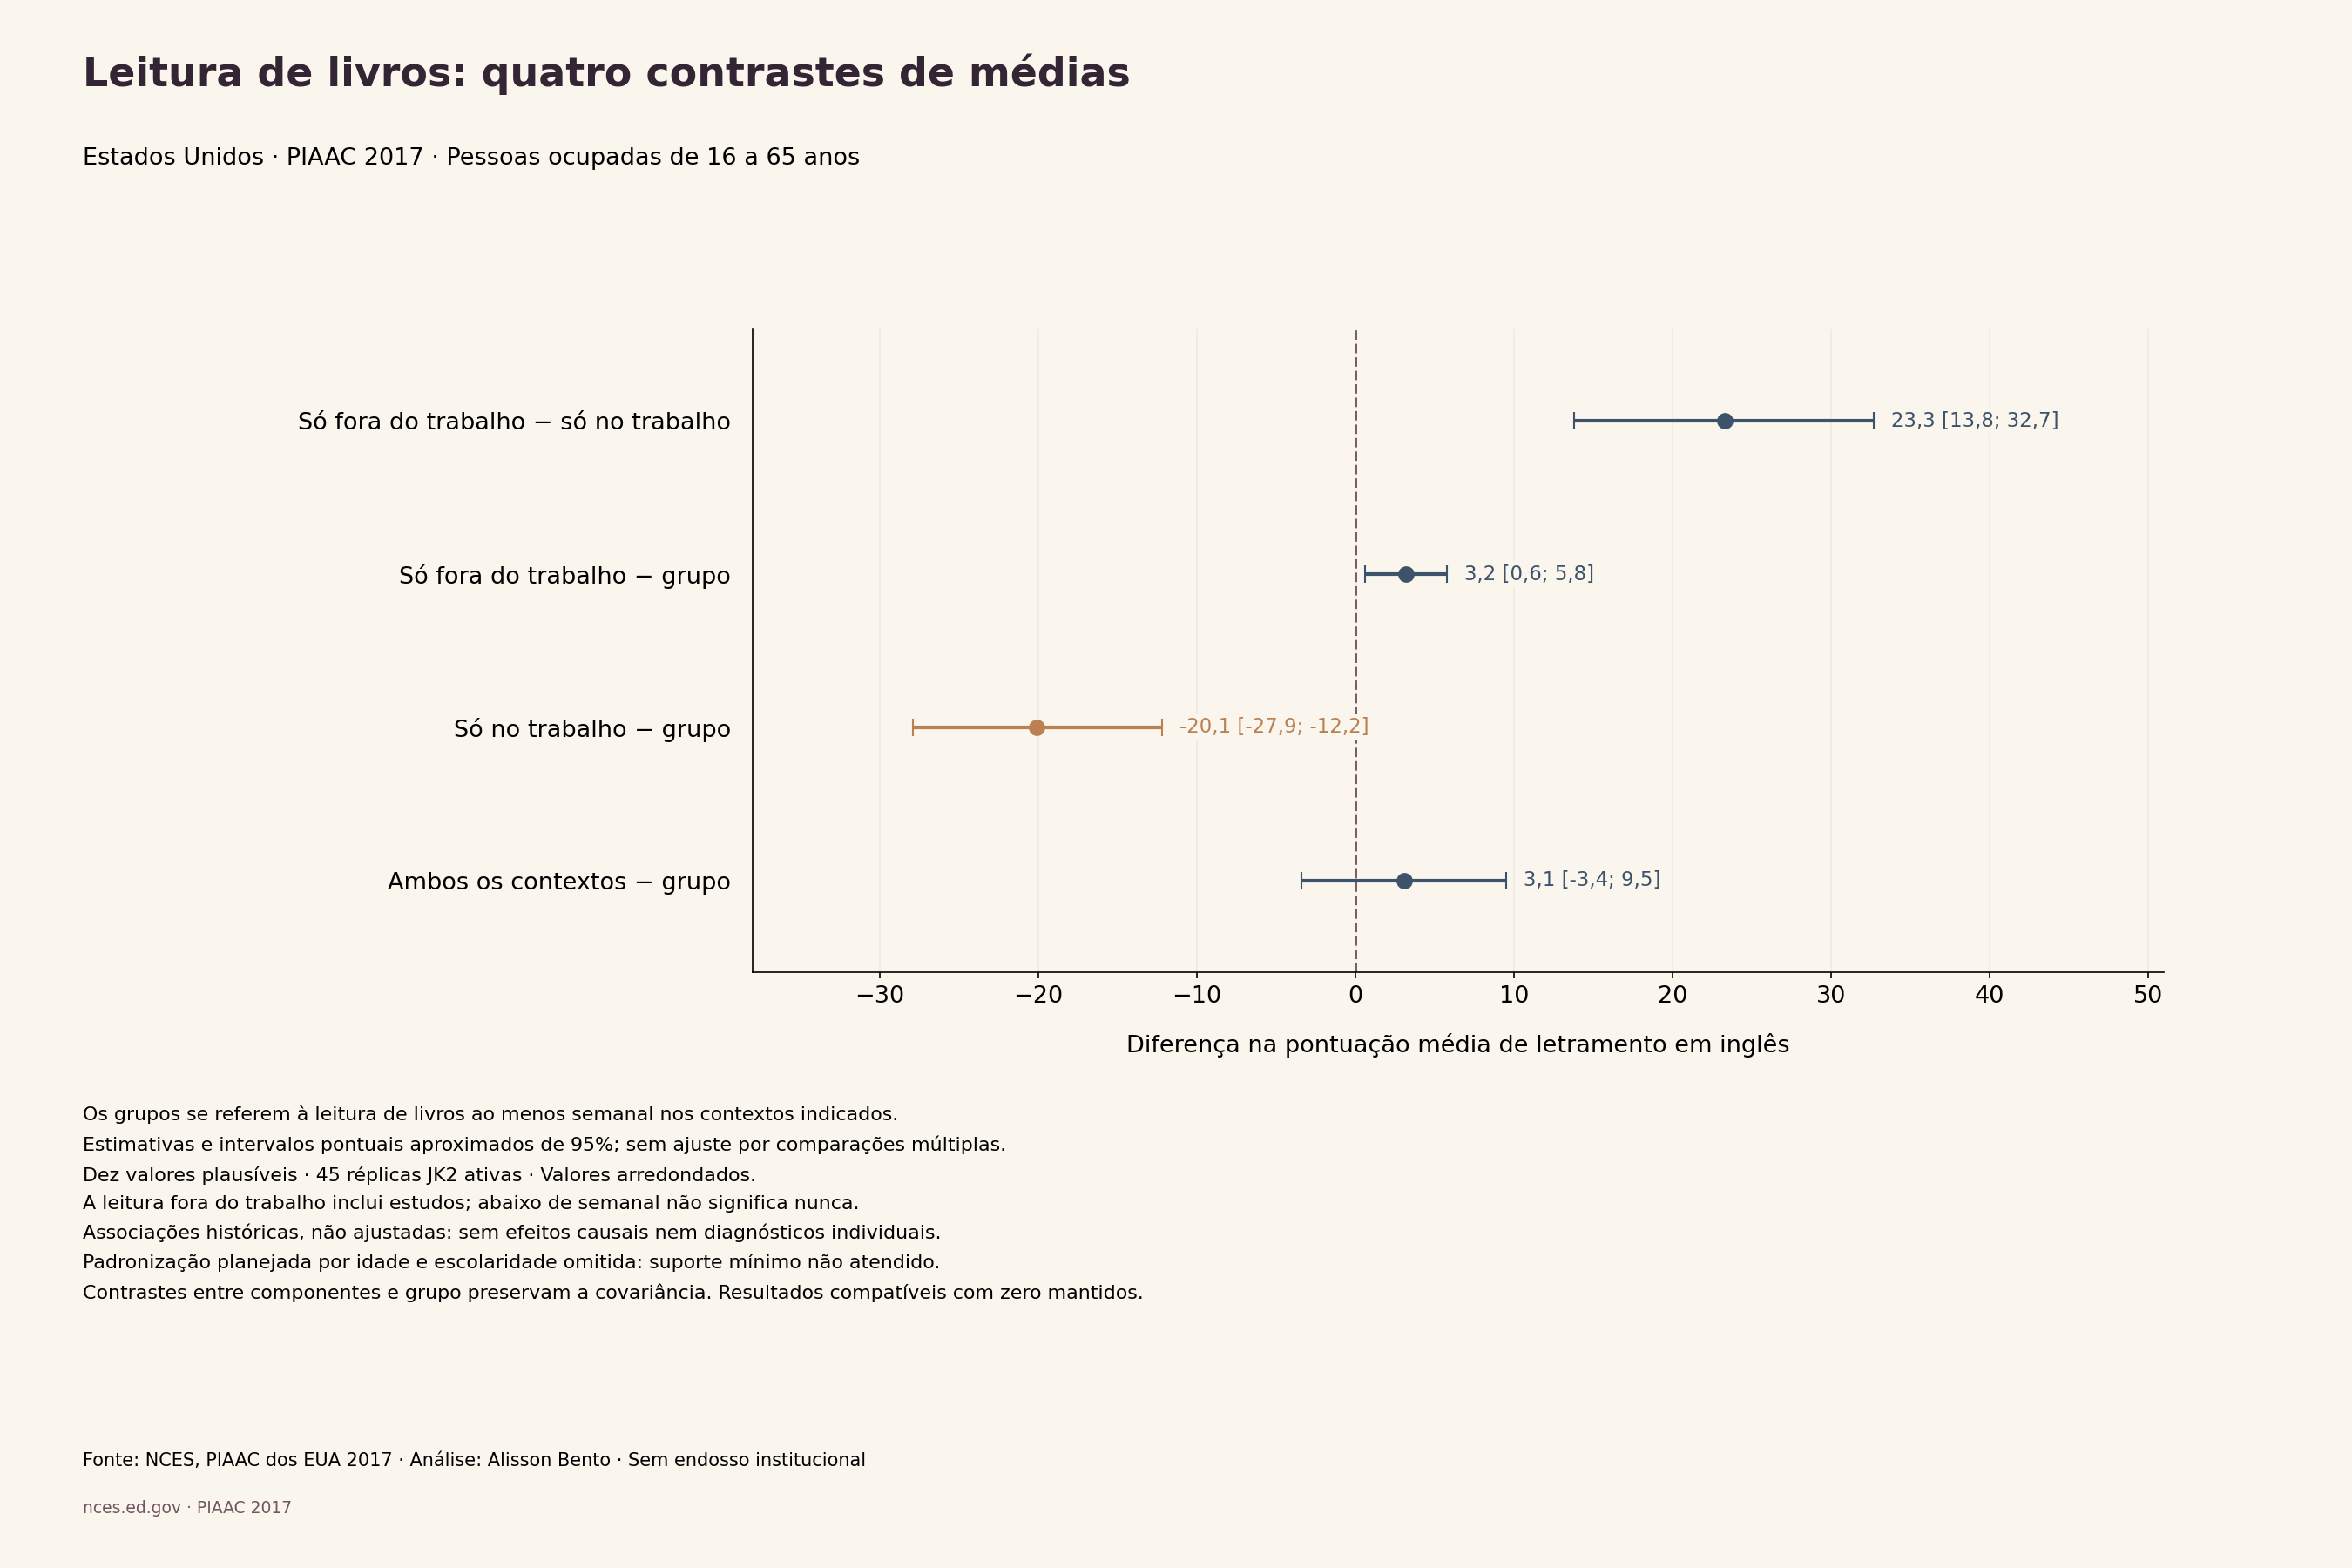
A comparação definida de antemão entre quem lê só fora do trabalho e quem lê só no trabalho é de 23,3 pontos na escala, com intervalo de confiança aproximado de 13,8 a 32,7. Para a parcela no Nível 1 ou abaixo, a diferença correspondente é de −11,5 pontos percentuais, com intervalo de −21,2 a −1,8. São contrastes descritivos dentro da população de trabalhadores selecionada. Seus intervalos levam em conta a incerteza da replicação da pesquisa e dos valores plausíveis, mas não têm ajuste para comparações múltiplas e não sustentam uma afirmação confirmatória para o conjunto das comparações nem uma interpretação causal.
Comparar cada componente com o grupo reunido de leitores frequentes responde mais diretamente à pergunta sobre a simplificação. Quem lê só fora do trabalho fica 3,2 pontos acima do grupo reunido, com intervalo de 0,6 a 5,8, e sua parcela na faixa inferior é 1,4 ponto percentual menor, com intervalo de −3,5 a 0,6. Quem lê só no trabalho fica 20,1 pontos abaixo do grupo reunido, com intervalo de −27,9 a −12,2, e sua parcela na faixa inferior é 10,0 pontos percentuais maior, com intervalo de 1,9 a 18,1. Esse último componente não é bem representado se apenas citarmos as estimativas pontuais do grupo reunido como se descrevessem todos os contextos.
O componente dos dois contextos fica 3,1 pontos acima do grupo reunido, com intervalo de −3,4 a 9,5, e 2,0 pontos percentuais abaixo na medida da faixa inferior, com intervalo de −6,3 a 2,3. Esses intervalos incluem zero, assim como o contraste da faixa inferior de quem lê só fora do trabalho. Eles são apresentados, e não descartados por inconvenientes. Um intervalo que inclui zero não prova equivalência, e um intervalo que não inclui zero não prova um mecanismo. O padrão completo informa mais do que uma manchete que escolha só as comparações que parecem especialmente diferentes.
Por que reunir os grupos não é, em si, um erro estatístico
Em cada resumo de proficiência, a estimativa do grupo reunido de leitores frequentes é igual às estimativas dos componentes ponderadas por suas parcelas na população frequente avaliada. Essa identidade vale antes do arredondamento. O cálculo a verifica para os dez valores plausíveis e para cada cálculo com o peso completo e com os pesos de replicação, e não só para a média final. A identidade explica por que um grupo reunido legítimo pode ficar perto de alguns componentes e longe de outro. Ela não torna o resultado enviesado e não define nenhum componente como a população correta para todo objetivo de pesquisa.
O denominador importa para essa identidade. As parcelas das respostas sobre leitura são definidas entre os respondentes elegíveis que deram as duas respostas de frequência. Os resumos de proficiência e os pesos de composição são definidos entre os que também têm os dez valores plausíveis de proficiência finitos. Nesta amostra selecionada, os dois domínios (os dois grupos de pessoas usados nos cálculos) têm os mesmos 2.395 registros; portanto, não há perda adicional de avaliação no total nem em qualquer contexto. Essa igualdade observada não justifica misturar as definições. Em outra divulgação ou população, usar as parcelas mais amplas das respostas de contexto para reconstruir as médias do domínio avaliado poderia falhar.
Um componente e o grupo reunido compartilham observações, então seus erros de estimação são dependentes. A análise calcula cada diferença entre componente e grupo reunido dentro de cada réplica e de cada valor plausível, preservando essa covariância antes de combinar a incerteza. Somar dois erros-padrão tratados como independentes não representaria a comparação real. Isso é especialmente importante quando um componente grande influencia muito o grupo reunido. O objetivo é descrever com transparência a recodificação escolhida, e não afirmar que classificações mais finas são sempre melhores ou que cada diferença possível merece um estudo à parte.
Um ajuste de composição planejado não teve suporte
Antes de examinar os resultados de proficiência, o desenho especificou uma padronização descritiva por três faixas de idade e três grupos de escolaridade. As faixas de idade eram de 16 a 34, de 35 a 54 e de 55 a 65 anos. Os grupos de escolaridade seguiam os códigos EDCAT6 da fonte, baseados na classificação internacional ISCED, e não equivalências presumidas com diplomas dos EUA. O alvo proposto era a distribuição comum de idade por escolaridade dos leitores frequentes avaliados com escolaridade válida. Isso compararia os três contextos sob a mesma composição observada, sem tornar a comparação causal.
O plano exigia que cada uma das 27 combinações de contexto e célula tivesse pelo menos 20 observações, suporte efetivo de Kish de pelo menos 10 e denominadores positivos nas réplicas. Dez células não passaram nesse filtro fixo. Por isso, toda a análise de sensibilidade padronizada foi omitida. Não juntamos células, não substituímos a análise por uma regressão e não introduzimos uma comparação só por idade depois de ver a falha. As contagens internas das células serviram para decidir se o estimador planejado tinha suporte, e não para publicar resultados de proficiência em células pequenas.
Por isso, os contrastes apresentados continuam sem ajuste por idade e escolaridade. O estudo não consegue determinar quanto do padrão por contexto essas características explicam, muito menos isolar uma relação direta com o contexto de leitura de livros. Informar essa omissão faz parte da interpretação do resultado e não é uma nota administrativa. A sensibilidade sem suporte não apaga a descrição sem ajuste, que tem suporte, mas limita bastante as afirmações de que os componentes continuariam diferentes sob uma composição comum. Nenhum resultado ajustado ou independente da composição é sugerido.
Pesos de replicação e valores plausíveis têm finalidades diferentes
O arquivo tem 80 campos de pesos de replicação, mas só 45 estão ativos neste desenho dos EUA. Os outros 35 repetem exatamente o peso da amostra completa. A variância pelo método jackknife pareado usa a soma dos quadrados dos desvios entre as estimativas das réplicas ativas e a estimativa com o peso completo; não usa a média desses desvios nem uma fórmula de bootstrap com 80 réplicas. Como verificação da fonte, reproduções separadas coincidem com os percentuais marginais publicados de emprego e de frequência de leitura de livros e com seus erros-padrão. Essas referências validam a implementação básica dos pesos antes de se interpretarem os novos resumos por contexto.
A proficiência usa também dez valores plausíveis. Cada um serve para estimar populações; nenhum deve ser tratado como pontuação individual definitiva. Para cada valor, todas as estimativas e diferenças são recalculadas com o peso completo e com as 45 réplicas. A variância total combina a média das variâncias amostrais dentro de cada valor com a variância amostral entre os valores, multiplicada por 1,1. Os intervalos de proporções usam uma transformação logit pelo método delta; as diferenças de proporções ficam na própria escala de diferença. As médias e seus contrastes usam intervalos simétricos aproximados, em pontos.
As estimativas, os erros-padrão e os limites dos intervalos são arredondados só depois do cálculo. Os mínimos de contagem do estudo, os limiares de Kish e os sinais de precisão são regras analíticas declaradas, não uma garantia oficial universal. Proporções positivas recebem um aviso de cautela se o erro-padrão relativo passar de trinta por cento; intervalos de proporção muito largos recebem um sinal de imprecisão. Nenhuma dessas regras esconde um contraste com sinal e valor próximo de zero só porque o erro relativo não é útil nesse caso. Intervalos nos limites da escala ou degenerados seriam marcados como indisponíveis, e não apresentados como certeza exata.
Uma extensão de pesquisas existentes, com limite reproduzível
Pesquisadores já combinam e distinguem a leitura no trabalho e a leitura fora dele, com finalidades diferentes. O trabalho longitudinal de Reder, Gauly e Lechner, de 2020, usa a maior frequência de tarefas entre os contextos em medidas de engajamento. O estudo de Tighe e colegas, de 2024, combina índices de trabalho e de casa em perfis de adultos dos EUA com baixa proficiência e discute expressamente análises mais específicas por contexto. A análise internacional de Kyröläinen e Kuperman, de 2021, inclui índices separados de leitura no trabalho e em casa. Este estudo não descobre a separação de contextos, não refuta esses desenhos e não afirma ser a primeira ligação entre práticas de leitura e proficiência.
Sua contribuição, mais restrita, é uma auditoria totalmente especificada de uma recodificação de frequência de leitura de livros numa amostra histórica de trabalhadores: quais componentes entram no grupo reunido, como dois resumos de proficiência avaliada diferem dele e quanta incerteza acompanha as comparações fixas. As perguntas sobre a leitura fora do trabalho e no trabalho não medem a qualidade da leitura, o idioma nem o conteúdo de um livro. A avaliação é em inglês, e a seleção para o trabalho e para as práticas de leitura continua sem tratamento. Estes dados transversais não permitem recomendar que mudar o contexto de leitura trará um ganho determinado de proficiência.
O programa de reprodução público aceita o arquivo original permitido do NCES e produz apenas agregados revisados quanto ao sigilo e arredondados. As impressões digitais das fontes, os métodos e a atribuição acompanham o código; registros de respondentes, pesos e valores individuais não são redistribuídos. A conclusão prática é que uma média de leitura semanal em algum dos contextos pode ser útil e, ao mesmo tempo, deixar de fora componentes muito diferentes. Quem lê com cuidado deve perguntar o que o indicador reúne, manter o grupo reunido válido, examinar as comparações fixas dos componentes e seus intervalos e lembrar que o ajuste de composição planejado não teve suporte nestes dados.
Leitura de livros: contextos e proficiência avaliada
Estados Unidos · PIAAC 2017 · Pessoas empregadas de 16 a 65 anos
Gráfico completo e fonte

Role para os lados para examinar o gráfico. ↔
Gráfico e valores
Role a tabela para os lados para ver todas as colunas.
| Contexto | Estimativa (pontos) | Erro-padrão | Limite inferior de 95% | Limite superior de 95% | Largura do intervalo |
|---|---|---|---|---|---|
| Menos que semanal nos dois contextos | 269,4 | 1,8 | 265,9 | 272,9 | 6,9 |
| Semanal só fora do trabalho | 284,7 | 2,2 | 280,4 | 289,0 | 8,7 |
| Semanal só no trabalho | 261,5 | 4,7 | 252,3 | 270,6 | 18,3 |
| Semanal nos dois contextos | 284,6 | 3,8 | 277,2 | 292,0 | 14,8 |
| Semanal em algum contexto (grupo reunido) | 281,5 | 1,9 | 277,8 | 285,3 | 7,5 |
Domínio A, avaliado. Dez valores plausíveis e 45 réplicas JK2 ativas; intervalos de confiança aproximados de 95%, pontuais, sem ajuste para comparações múltiplas. Sem diagnóstico individual nem inferência causal. O limite de 226 é aplicado separadamente a cada valor plausível para a parcela da faixa inferior. As larguras dos intervalos são calculadas antes do arredondamento; subtrair os limites arredondados pode não dar a largura exibida.

Leitura de livros: quatro contrastes de médias
Estados Unidos · PIAAC 2017 · Pessoas empregadas de 16 a 65 anos
Gráfico completo e fonte
Role para os lados para examinar o gráfico. ↔
Gráfico e valores
Role a tabela para os lados para ver todas as colunas.
| Comparação | Diferença (pontos) | Erro-padrão | Limite inferior de 95% | Limite superior de 95% | Largura do intervalo |
|---|---|---|---|---|---|
| Só fora do trabalho menos só no trabalho | 23,3 | 4,8 | 13,8 | 32,7 | 18,9 |
| Só fora do trabalho menos grupo reunido | 3,2 | 1,3 | 0,6 | 5,8 | 5,1 |
| Só no trabalho menos grupo reunido | −20,1 | 4,0 | −27,9 | −12,2 | 15,7 |
| Dois contextos menos grupo reunido | 3,1 | 3,3 | −3,4 | 9,5 | 12,9 |
Os contrastes conjuntos dentro de cada réplica e valor plausível preservam a covariância, inclusive entre componentes e grupo reunido, que se sobrepõem. Intervalos de confiança aproximados de 95%, pontuais; resultados compatíveis com zero mantidos. Escala de diferenças, e não subtração de intervalos independentes. As larguras dos intervalos são calculadas antes do arredondamento; subtrair os limites arredondados pode não dar a largura exibida.
Dados e downloads
Role a tabela para os lados para ver todas as colunas.
| Contexto de leitura | Registros | Parcela (%) | Erro-padrão (pontos percentuais) | Limite inferior de 95% (%) | Limite superior de 95% (%) |
|---|---|---|---|---|---|
| Menos que semanal nos dois contextos | 1.234 | 53,3 | 1,1 | 51,2 | 55,4 |
| Semanal só fora do trabalho | 765 | 30,4 | 1,0 | 28,5 | 32,4 |
| Semanal só no trabalho | 157 | 6,4 | 0,6 | 5,3 | 7,5 |
| Semanal nos dois contextos | 239 | 10,0 | 0,8 | 8,4 | 11,7 |
B: 2.395 trabalhadores atuais de 16 a 65 anos com as duas respostas de frequência válidas. Menos que semanal não é nunca. Percentuais ponderados e intervalos de confiança aproximados de 95%, pontuais; os valores exibidos podem não somar exatamente por causa do arredondamento. As contagens não são ponderadas.
Role a tabela para os lados para ver todas as colunas.
| Contexto frequente | Parcela B (%) | Limite inferior B, 95% (%) | Limite superior B, 95% (%) | Peso de composição A (%) |
|---|---|---|---|---|
| Semanal só fora do trabalho | 65,1 | 61,5 | 68,4 | 65,1 |
| Semanal só no trabalho | 13,6 | 11,4 | 16,2 | 13,6 |
| Semanal nos dois contextos | 21,3 | 18,4 | 24,6 | 21,3 |
Parcelas condicionais entre leitores frequentes. Os domínios B (respostas sobre leitura) e A (avaliação) têm 1.161 registros aqui; suas definições continuam distintas. As parcelas do domínio avaliado dão o peso nas identidades de composição da proficiência.
Role a tabela para os lados para ver todas as colunas.
| Contexto | Estimativa (pontos) | Erro-padrão | Limite inferior de 95% | Limite superior de 95% | Largura do intervalo |
|---|---|---|---|---|---|
| Menos que semanal nos dois contextos | 269,4 | 1,8 | 265,9 | 272,9 | 6,9 |
| Semanal só fora do trabalho | 284,7 | 2,2 | 280,4 | 289,0 | 8,7 |
| Semanal só no trabalho | 261,5 | 4,7 | 252,3 | 270,6 | 18,3 |
| Semanal nos dois contextos | 284,6 | 3,8 | 277,2 | 292,0 | 14,8 |
| Semanal em algum contexto (grupo reunido) | 281,5 | 1,9 | 277,8 | 285,3 | 7,5 |
Domínio A, avaliado. Dez valores plausíveis e 45 réplicas JK2 ativas; intervalos de confiança aproximados de 95%, pontuais, sem ajuste para comparações múltiplas. Sem diagnóstico individual nem inferência causal. O limite de 226 é aplicado separadamente a cada valor plausível para a parcela da faixa inferior. As larguras dos intervalos são calculadas antes do arredondamento; subtrair os limites arredondados pode não dar a largura exibida.
Role a tabela para os lados para ver todas as colunas.
| Contexto | Estimativa (%) | Erro-padrão | Limite inferior de 95% | Limite superior de 95% | Largura do intervalo |
|---|---|---|---|---|---|
| Menos que semanal nos dois contextos | 19,1 | 1,5 | 16,3 | 22,3 | 6,0 |
| Semanal só fora do trabalho | 11,8 | 1,5 | 9,2 | 15,2 | 6,0 |
| Semanal só no trabalho | 23,3 | 4,9 | 15,0 | 34,3 | 19,3 |
| Semanal nos dois contextos | 11,3 | 2,6 | 7,1 | 17,5 | 10,4 |
| Semanal em algum contexto (grupo reunido) | 13,3 | 1,5 | 10,6 | 16,5 | 5,9 |
Domínio A, avaliado. Dez valores plausíveis e 45 réplicas JK2 ativas; intervalos de confiança aproximados de 95%, pontuais, sem ajuste para comparações múltiplas. Sem diagnóstico individual nem inferência causal. O limite de 226 é aplicado separadamente a cada valor plausível para a parcela da faixa inferior. As larguras dos intervalos são calculadas antes do arredondamento; subtrair os limites arredondados pode não dar a largura exibida.
Role a tabela para os lados para ver todas as colunas.
| Comparação | Diferença (pontos) | Erro-padrão | Limite inferior de 95% | Limite superior de 95% | Largura do intervalo |
|---|---|---|---|---|---|
| Só fora do trabalho menos só no trabalho | 23,3 | 4,8 | 13,8 | 32,7 | 18,9 |
| Só fora do trabalho menos grupo reunido | 3,2 | 1,3 | 0,6 | 5,8 | 5,1 |
| Só no trabalho menos grupo reunido | −20,1 | 4,0 | −27,9 | −12,2 | 15,7 |
| Dois contextos menos grupo reunido | 3,1 | 3,3 | −3,4 | 9,5 | 12,9 |
Os contrastes conjuntos dentro de cada réplica e valor plausível preservam a covariância, inclusive entre componentes e grupo reunido, que se sobrepõem. Intervalos de confiança aproximados de 95%, pontuais; resultados compatíveis com zero mantidos. Escala de diferenças, e não subtração de intervalos independentes. As larguras dos intervalos são calculadas antes do arredondamento; subtrair os limites arredondados pode não dar a largura exibida.
Role a tabela para os lados para ver todas as colunas.
| Comparação | Diferença (pontos percentuais) | Erro-padrão | Limite inferior de 95% | Limite superior de 95% | Largura do intervalo |
|---|---|---|---|---|---|
| Só fora do trabalho menos só no trabalho | −11,5 | 5,0 | −21,2 | −1,8 | 19,4 |
| Só fora do trabalho menos grupo reunido | −1,4 | 1,1 | −3,5 | 0,6 | 4,1 |
| Só no trabalho menos grupo reunido | 10,0 | 4,1 | 1,9 | 18,1 | 16,2 |
| Dois contextos menos grupo reunido | −2,0 | 2,2 | −6,3 | 2,3 | 8,7 |
Os contrastes conjuntos dentro de cada réplica e valor plausível preservam a covariância, inclusive entre componentes e grupo reunido, que se sobrepõem. Intervalos de confiança aproximados de 95%, pontuais; resultados compatíveis com zero mantidos. Escala de diferenças, e não subtração de intervalos independentes. As larguras dos intervalos são calculadas antes do arredondamento; subtrair os limites arredondados pode não dar a largura exibida.
Evidências e método
Como calculamos
- Arquivo histórico de uso público da pesquisa domiciliar dos EUA de 2017; trabalhadores atuais de 16 a 65 anos com duas respostas válidas sobre frequência de leitura de livros e peso completo positivo.
- Os domínios B (respostas sobre leitura) e A (avaliação, com os dez valores plausíveis) são definidos separadamente; aqui os dois têm 2.395 registros, sem perda adicional de avaliação.
- Semanal = respostas 4 e 5; menos que semanal = respostas 1 a 3. A leitura fora do trabalho inclui estudos; o roteiro para o emprego atual foi verificado.
- Todas as 45 réplicas JK2 ativas, com soma dos quadrados dos desvios; dez valores plausíveis, com a média da variância interna mais 1,1 vez a variância amostral entre os valores.
- Média e parcela com valor plausível abaixo de 226 para os quatro estados e para o grupo reunido de leitores frequentes; os contrastes fixos entre só fora do trabalho e só no trabalho, e entre cada componente e o grupo reunido, são calculados em conjunto.
- 920 identidades de composição entre resumos, valores plausíveis e réplicas; a padronização fixa de 27 células não teve suporte e foi omitida por inteiro.
- Foram aplicados critérios de suporte, de precisão e de divulgação; os resultados públicos são arredondados só depois do cálculo; não há redistribuição de dados de respondentes.
O que os dados não permitem concluir
- Trabalhadores históricos selecionados, não todos os adultos nem as condições atuais. As frequências são autodeclaradas; menos que semanal não é ausência de leitura.
- Fora do trabalho não significa só lazer nem, necessariamente, em casa; não há identificação de livro, gênero, quantidade de material nem idioma de leitura.
- A avaliação de proficiência é em inglês; os valores plausíveis servem para estimar populações, não para diagnóstico individual.
- Comparações sem ajuste não distinguem idade, escolaridade, exigências do trabalho, seleção, experiências com a língua nem outras explicações.
- O grupo reunido é um alvo combinado válido, não um viés de agregação. Dois resumos não são distribuições completas.
- Os intervalos aproximados pontuais não têm ajuste para comparações múltiplas; contrastes compatíveis com zero não demonstram equivalência.
- Dez células da padronização não passaram; não há resultados ajustados, junção de células nem regressão como saída. Nenhuma recomendação causal sobre o efeito da leitura.
Fontes originais
- NCES: PIAAC 2017 original ASCII public-use archive
O arquivo original traz o esquema DAT e SAS. As impressões digitais da fonte e das entradas foram conferidas; a reprodução pública exige o arquivo original permitido, obtido por quem reproduz. Nenhum dado de respondentes é redistribuído.
Acesso em 30 de outubro de 2026
- NCES: U.S. PIAAC 2012/2014/2017 technical report
O capítulo 8 e o Apêndice E estabelecem as 45 réplicas JK2 ativas, os pesos de preenchimento, os dez valores plausíveis e a combinação das variâncias; o limite contínuo do Nível 1 é abaixo de 226.
Acesso em 30 de outubro de 2026
- NCES: 2017 household background questionnaire
O roteiro para trabalhadores atuais seleciona o emprego atual; a leitura fora do trabalho exclui o trabalho, mas inclui os estudos de quem está matriculado. O contexto não significa só lazer nem um lugar físico.
Acesso em 30 de outubro de 2026
- NCES PIAAC data usage agreement
Uso somente estatístico; sem tentativas de identificação nem ligação com registros identificáveis de pessoas. Os resultados públicos contêm agregados revisados, e não registros de respondentes.
Acesso em 30 de outubro de 2026
- NCES: 2017 background compendium
As estimativas marginais ponderadas e os erros-padrão oficiais servem como verificações de referência separadas para o emprego e para os dois itens de frequência de leitura de livros. Eles não trazem os novos resultados de proficiência por contexto conjunto.
Acesso em 30 de outubro de 2026
- NCES: PIAAC data files
A listagem oficial de fontes de uso público distingue os arquivos domiciliares acessíveis, para análise estatística, dos arquivos de uso restrito, que exigem licença.
Acesso em 30 de outubro de 2026
- Reder, Gauly and Lechner (2020): Practice makes perfect
Pesquisa longitudinal anterior combina as frequências de tarefas no trabalho e fora dele. Esta auditoria descritiva histórica da simplificação não refuta essa escolha nem estabelece um efeito causal da prática.
Acesso em 30 de outubro de 2026
- Tighe and colleagues (2024): Profiles of skills-use engagement
Um estudo anterior sobre perfis de adultos dos EUA com baixa proficiência combina índices de trabalho e de casa e discute pesquisas específicas por contexto e por item. Não se afirma ter descoberto uma lacuna de pesquisa na separação dos contextos.
Acesso em 30 de outubro de 2026
- Kyröläinen and Kuperman (2021): Predictors of literacy in adulthood
Pesquisa internacional anterior inclui índices separados de leitura no trabalho e em casa. Este estudo se concentra em uma recodificação explícita de um item sobre livros e não é a primeira evidência de que os contextos de leitura diferem.
Acesso em 30 de outubro de 2026
Como citar e reutilizar
Alisson Bento. O que a média de leitores semanais de livros deixa de fora: trabalho e leitura fora do trabalho. Análise secundária dos microdados domiciliares de uso público do PIAAC dos EUA 2017, do NCES. Fontes acessadas em 30 de outubro de 2026. https://alissonbento.com/pt/research/us-book-reading-context-coarsening-and-literacy-2017/
Informação da fonte: National Center for Education Statistics, arquivo domiciliar de uso público do PIAAC dos EUA 2017. Aplicam-se as condições de uso estatístico e de não identificação. Seleção, cálculos e explicação originais: Alisson Bento. Não se sugere aval do NCES nem da OCDE; não se reproduzem insígnias da agência, registros de respondentes nem figuras de artigos de terceiros.
Correções ou dúvidas editoriais