
Una media utile può comunque nascondere le sue componenti
Tra gli adulti statunitensi occupati, di età compresa tra 16 e 65 anni, nell’indagine PIAAC sulle famiglie del 2017, un unico indicatore di lettura di libri almeno una volta a settimana, al lavoro o nella vita quotidiana, riunisce tre gruppi diversi. La loro media combinata di competenza alfabetica misurata è di 281,5 punti. È una descrizione valida della popolazione combinata, non una media sbagliata. Non mostra però che la componente di chi legge solo al lavoro ha una media di 261,5, mentre quelle di chi legge solo nella vita quotidiana e di chi legge in entrambi i contesti hanno medie di 284,7 e 284,6. Sono riepiloghi storici e non corretti per altri fattori, non valutazioni individuali né effetti della lettura.
La distinzione non è semplicemente che una media nazionale nasconde la variazione. La regola di aggregazione è esplicita: leggere libri almeno una volta a settimana in almeno uno dei due contesti, registrati separatamente, diventa un’unica categoria positiva. All’interno di questa categoria, chi legge solo nella vita quotidiana pesa per il 65,1%, chi legge solo al lavoro per il 13,6% e chi legge in entrambi i contesti per il 21,3%. Di conseguenza il risultato combinato è numericamente molto più vicino alle due componenti più grandi e con media più alta che alla componente più piccola, quella del solo lavoro. Chiamare «lettori frequenti di libri» tutti i membri di questo gruppo conserva la frequenza in uno dei due contesti, ma perde l’informazione su quale dei due l’abbia fornita.
Questo studio misura tale accorpamento descrittivo con un insieme fisso di confronti. Conserva tutti e quattro gli stati di lettura congiunti, ne riporta la composizione ed esamina una media e una quota del livello più basso di competenza. Non stima l’intera distribuzione della competenza e non inventa un indice generale di perdita di informazione. Non sostiene nemmeno che i ricercatori non debbano mai unire i contesti. La domanda è che cosa una particolare statistica combinata non dica più a chi legge, e quanta incertezza accompagni le descrizioni delle componenti che restituiscono quell’informazione.
Due domande sui libri, una popolazione storica di persone occupate
La fonte è il file a uso pubblico delle famiglie statunitensi del 2017 del Programme for the International Assessment of Adult Competencies, o PIAAC. Questa analisi seleziona le persone attualmente occupate, di età compresa tra 16 e 65 anni, con risposte valide a entrambe le domande sulla frequenza di lettura di libri e con un peso campionario finale positivo e finito. Il dominio delle risposte sulla lettura che ne risulta contiene 2.395 record. Non descrive tutti gli adulti statunitensi, le condizioni attuali, gli scolari, le persone disoccupate o chiunque abbia mai avuto un lavoro. La definizione di occupazione comprende inoltre il lavoro autonomo e quello nell’azienda di famiglia che rientrano nei criteri, non solo il lavoro dipendente.
La domanda sul lavoro, G_Q01E, chiede con quale frequenza le persone leggono libri nel proprio lavoro. L’instradamento ufficiale del questionario collega le persone occupate selezionate al loro lavoro attuale, non a uno precedente. La domanda sulla vita quotidiana, H_Q01E, riguarda la lettura di libri, di narrativa o di saggistica, fuori dal lavoro. Per chi è iscritto a un percorso di istruzione, le istruzioni includono esplicitamente la lettura per lo studio. «Vita quotidiana» non significa quindi solo lettura per piacere, né lettura fisicamente a casa, né lettura estranea all’istruzione. Entrambi i contesti possono includere schermi elettronici; nessuna delle due domande identifica un libro, un genere, una lingua o una quantità di testo particolari.
Entrambe le domande offrono cinque categorie di frequenza. Questo studio fissa «almeno una volta a settimana» sulle due risposte più alte e «meno di una volta a settimana» sulle altre tre risposte valide. «Meno di una volta a settimana» include chi non legge mai, ma non è sinonimo di «mai». Le risposte mancanti, rifiutate, sconosciute o non previste dall’instradamento non vengono trasformate in assenza di lettura. Un altro campo, H_Q01E_T, è una ricodifica accorpata della domanda sulla vita quotidiana, adatta ai confronti nel tempo, non una seconda dichiarazione indipendente. Trattare quella ricodifica come uno strumento distinto creerebbe un confronto che le osservazioni di partenza non offrono.
I quattro stati e la composizione del gruppo combinato
Nella popolazione selezionata di persone occupate, il 53,3% dichiara di leggere libri meno di una volta a settimana in entrambi i contesti, il 30,4% almeno una volta a settimana solo fuori dal lavoro, il 6,4% almeno una volta a settimana solo al lavoro e il 10,0% almeno una volta a settimana in entrambi. Queste percentuali sono descrizioni della popolazione ponderate, non percentuali grezze del campione. Per via degli arrotondamenti, le componenti mostrate possono non sommare esattamente a cento. I quattro gruppi descrivono una classificazione congiunta della frequenza; nessuno identifica lettori di una vita, persone che non leggeranno mai, la qualità della lettura o un’identità personale stabile.
Condizionare alla lettura settimanale in uno dei due contesti cambia il denominatore. All’interno di questo gruppo combinato, le quote stimate delle componenti sono il 65,1% per chi legge solo nella vita quotidiana, con un intervallo di confidenza approssimato al 95% dal 61,5% al 68,4%; il 13,6% per chi legge solo al lavoro, con un intervallo dall’11,4% al 16,2%; e il 21,3% per chi legge in entrambi, con un intervallo dal 18,4% al 24,6%. Queste quote condizionate spiegano la miscela rappresentata dalla statistica combinata sulla competenza. Non vanno confuse con le quote corrispondenti tra tutte le persone occupate idonee.
I conteggi non ponderati dei gruppi sono 1.234 per chi legge meno di una volta a settimana in entrambi i contesti, 765 per la sola vita quotidiana, 157 per il solo lavoro e 239 per entrambi, per un totale di 1.161 record nel gruppo di chi legge almeno una volta a settimana in uno dei due contesti. Ogni gruppo soddisfa i minimi fissati in anticipo dallo studio: almeno sessantadue osservazioni, una numerosità efficace di Kish di almeno trenta e denominatori positivi in ogni replica attiva. La misura di Kish descrive la dispersione dei pesi campionari, non garantisce una precisione corretta per il disegno campionario. Soddisfare questi controlli consente di stimare; non rende ogni componente ugualmente precisa e non elimina la necessità di mostrare gli intervalli.
Che cosa descrivono le medie di competenza alfabetica misurata
La media di chi legge solo nella vita quotidiana è 284,7 punti, con un intervallo di confidenza puntuale approssimato al 95% da 280,4 a 289,0. La media di chi legge solo al lavoro è 261,5, con un intervallo da 252,3 a 270,6. Per chi legge almeno una volta a settimana in entrambi i contesti la media è 284,6, con un intervallo da 277,2 a 292,0. La media combinata di chi legge almeno una volta a settimana in uno dei due contesti è 281,5, con un intervallo da 277,8 a 285,3. Il gruppo di riferimento, che legge meno di una volta a settimana in entrambi i contesti, ha una media di 269,4, con un intervallo da 265,9 a 272,9.
Questi numeri riassumono la competenza alfabetica in inglese misurata, non l’intelligenza, il valore personale, il gusto letterario o la qualità dei libri che le persone scelgono. Il PIAAC misura la capacità degli adulti di comprendere e usare informazioni scritte con una prova strutturata. Le domande sui contesti sono frequenze dichiarate dalle persone, non esperimenti che assegnano libri o condizioni di lettura. Le differenze possono riflettere percorsi di istruzione, esperienze linguistiche, la selezione verso certi lavori, i compiti professionali e altre caratteristiche. Una media più bassa di un gruppo non può stabilire che leggere al lavoro riduca la competenza, così come una media più alta non può stabilire un vantaggio causato dalla lettura per piacere.
Anche le ampiezze degli intervalli delle medie differiscono molto: 8,7 punti per chi legge solo nella vita quotidiana, 18,3 per chi legge solo al lavoro e 14,8 per chi legge in entrambi i contesti. La componente del solo lavoro è la più piccola delle tre e ha l’intervallo più ampio. L’intervallo della media combinata è più stretto, 7,5 punti, ma questa precisione riguarda il valore combinato, non ogni componente al suo interno. Sostituire ogni componente con la media combinata darebbe una risposta più precisa a una domanda descrittiva diversa, non risolverebbe l’incertezza sulla componente stessa.
Un solo riepilogo della parte bassa della distribuzione aggiunge un’altra prospettiva
Il secondo riepilogo della competenza è la quota con un punteggio inferiore a 226, che corrisponde al livello 1 o inferiore secondo il limite continuo ufficiale. La soglia si applica separatamente a ciascun valore plausibile, prima di riunire le stime per la popolazione. Non si applica alla media dei valori plausibili di una persona e nessuno viene etichettato come avente un livello diagnosticato. Questa misura della sola parte bassa della distribuzione integra la media, ma insieme le due non descrivono l’intera distribuzione né mostrano come ogni parte della scala differisca.
La quota stimata al livello 1 o inferiore è dell’11,8% per chi legge solo nella vita quotidiana, con un intervallo approssimato dal 9,2% al 15,2%; del 23,3% per chi legge solo al lavoro, con un intervallo dal 15,0% al 34,3%; e dell’11,3% per chi legge in entrambi, con un intervallo dal 7,1% al 17,5%. Il gruppo combinato di chi legge spesso ha una quota del 13,3%, con un intervallo dal 10,6% al 16,5%. Il gruppo di riferimento, che legge meno di una volta a settimana in entrambi i contesti, ha una quota del 19,1%, con un intervallo dal 16,3% al 22,3%.
L’intervallo della quota più bassa per chi legge solo al lavoro è nettamente più ampio di quelli delle altre componenti di chi legge spesso. Questa incertezza resta visibile anche se la sua stima puntuale differisce da quella del gruppo combinato. L’intervallo descrittivo tra le componenti va dall’11,3% al 23,3%; non è un intervallo di confidenza, una procedura di classificazione o un estremo scelto in modo indipendente. Si conservano tutti i risultati delle componenti specificate. Non c’è stata alcuna ricerca di altre soglie, sottogruppi di età, professioni o anni di indagine per trovare un contrasto più forte dopo aver visto questi risultati.
I contrasti fissati includono differenze compatibili con zero
Il confronto definito in anticipo tra chi legge solo nella vita quotidiana e chi legge solo al lavoro, nel senso «vita quotidiana meno lavoro», è di 23,3 punti, con un intervallo approssimato da 13,8 a 32,7. Per la quota di livello 1 o inferiore, la differenza corrispondente è di −11,5 punti percentuali, con un intervallo da −21,2 a −1,8. Sono contrasti descrittivi all’interno della popolazione selezionata di persone occupate. I loro intervalli tengono conto dell’incertezza delle repliche campionarie e dei valori plausibili, ma non sono corretti per i confronti multipli e non sostengono un’affermazione confermativa complessiva né un’interpretazione causale.
Confrontare ogni componente con il gruppo combinato di chi legge spesso risponde più direttamente alla domanda sull’accorpamento. Chi legge solo nella vita quotidiana sta 3,2 punti sopra il gruppo combinato, con un intervallo da 0,6 a 5,8, e la sua quota di livello 1 o inferiore è più bassa di 1,4 punti percentuali, con un intervallo da −3,5 a 0,6. Chi legge solo al lavoro sta 20,1 punti sotto il gruppo combinato, con un intervallo da −27,9 a −12,2, e la sua quota di livello 1 o inferiore è più alta di 10,0 punti, con un intervallo da 1,9 a 18,1. Quest’ultima componente non è ben rappresentata se si citano semplicemente le stime puntuali del gruppo combinato come se descrivessero ogni contesto.
La componente di chi legge in entrambi i contesti sta 3,1 punti sopra il gruppo combinato, con un intervallo da −3,4 a 9,5, e 2,0 punti percentuali sotto nella misura della parte bassa, con un intervallo da −6,3 a 2,3. Questi intervalli includono lo zero, così come quello del contrasto sulla parte bassa per chi legge solo nella vita quotidiana. Sono riportati, non scartati perché scomodi. Un intervallo che include lo zero non prova l’equivalenza e un intervallo che non lo include non prova un meccanismo. Il quadro completo è più informativo di un titolo che scelga solo i confronti particolarmente diversi.
Perché mettere insieme i gruppi non è di per sé un errore statistico
Per ciascun riepilogo di competenza, la stima del gruppo combinato di chi legge spesso è uguale alle stime delle componenti pesate con le loro quote nella popolazione valutata di chi legge spesso. Questa identità vale prima dell’arrotondamento. Il calcolo la verifica per tutti i dieci valori plausibili e per ogni calcolo con il peso completo e con le repliche, non solo per la media finale. L’identità spiega perché un gruppo combinato legittimo possa stare vicino ad alcune componenti e lontano da un’altra. Non rende distorto il risultato combinato e non indica alcuna componente come la popolazione corretta per ogni scopo di ricerca.
Il denominatore conta per questa identità. Le quote delle risposte sulla lettura sono definite tra le persone idonee che hanno risposto a entrambe le domande sulla frequenza. I riepiloghi di competenza e i pesi della miscela sono definiti tra quelle che hanno anche tutti e dieci i valori plausibili finiti di competenza alfabetica. In questo campione selezionato, i due domini contengono gli stessi 2.395 record, quindi non c’è alcuna perdita aggiuntiva di valutazioni, né nel complesso né in alcun contesto. Questa uguaglianza osservata non giustifica di confondere le due definizioni. In un’altra versione dei dati o in un’altra popolazione, usare le quote più ampie dei dati di contesto per ricostruire le medie del dominio valutato potrebbe non funzionare.
Una componente e il gruppo combinato di cui fa parte condividono osservazioni, quindi i loro errori di stima sono dipendenti. L’analisi calcola ogni contrasto tra componente e gruppo combinato all’interno di ogni replica e di ogni valore plausibile, conservando quella covarianza prima di riunire l’incertezza. Sommare due errori standard trattati come indipendenti non rappresenterebbe il confronto reale. Questo è particolarmente importante quando una componente grande influenza molto il gruppo combinato. L’obiettivo è una descrizione trasparente della ricodifica scelta, non sostenere che classificazioni più fini siano sempre migliori, o che ogni possibile differenza meriti uno studio a parte.
Un aggiustamento per la composizione, previsto in anticipo, non era sostenibile
Prima di esaminare i risultati sulla competenza, il disegno dello studio prevedeva una standardizzazione descrittiva su tre fasce di età e tre gruppi di istruzione. Le fasce di età erano da 16 a 34 anni, da 35 a 54 e da 55 a 65. I gruppi di istruzione seguivano i codici EDCAT6 della fonte, basati sull’ISCED, e non equivalenze presunte con i titoli di studio statunitensi. L’obiettivo proposto era la distribuzione comune per età e istruzione di chi legge spesso e ha un’istruzione valida. Avrebbe confrontato i tre contesti con la stessa composizione osservata, senza rendere causale il confronto.
Il piano richiedeva che ciascuna delle ventisette combinazioni di contesto e cella avesse almeno venti osservazioni, una numerosità efficace di Kish di almeno dieci e denominatori delle repliche positivi. Dieci celle non hanno superato questo criterio fisso. Perciò l’intera analisi di sensibilità standardizzata è stata omessa. Le celle non sono state accorpate, non è stata sostituita una regressione e dopo aver visto il fallimento non è stato introdotto un confronto solo per età. I conteggi interni delle celle sono serviti a decidere se lo stimatore previsto fosse sostenibile, non a pubblicare risultati di competenza su celle piccole.
Di conseguenza, i contrasti riportati restano non corretti per età e istruzione. Lo studio non può stabilire quanta parte del quadro per contesto sia spiegata da queste caratteristiche, e ancor meno isolare una relazione diretta con il contesto di lettura dei libri. Dichiarare questa omissione fa parte dell’interpretazione del risultato, non è una nota amministrativa. L’analisi di sensibilità non sostenibile non cancella la descrizione non corretta che regge, ma limita fortemente le affermazioni secondo cui le componenti resterebbero diverse con una composizione comune. Non si suggerisce alcun risultato corretto o indipendente dalla composizione.
Pesi replicati e valori plausibili servono a scopi diversi
Il file contiene ottanta campi di pesi replicati, ma solo quarantacinque sono attivi per questo disegno statunitense. Gli altri trentacinque ripetono esattamente il peso del campione completo. La varianza jackknife a coppie usa la somma degli scarti al quadrato tra le stime delle repliche attive e la stima con il peso completo, non la loro media né una formula bootstrap a ottanta repliche. Come controllo sulla fonte, riproduzioni separate coincidono con le percentuali marginali pubblicate su occupazione e frequenza di lettura di libri e con i loro errori standard. Questi riferimenti convalidano l’implementazione di base della ponderazione prima di interpretare i nuovi riepiloghi congiunti per contesto.
La competenza alfabetica usa inoltre dieci valori plausibili. Ciascuno è adatto alla stima sulla popolazione; nessuno va trattato come il punteggio definitivo di una persona. Per ciascun valore, tutte le stime e i contrasti sono ricalcolati con il peso completo e con quarantacinque repliche. La varianza totale combina la media delle varianze di campionamento entro ciascun valore con la varianza campionaria tra i valori, moltiplicata per 1,1. Gli intervalli delle proporzioni usano una trasformazione logit con il metodo delta, mentre le differenze tra proporzioni restano sulla scala delle differenze. Le medie e i contrasti tra medie usano intervalli simmetrici approssimati, in punti di punteggio.
Le stime, gli errori standard e gli estremi degli intervalli mostrati sono arrotondati solo dopo il calcolo. I conteggi minimi, le soglie di Kish e i segnali di precisione dello studio sono regole analitiche dichiarate, non presentate come una garanzia ufficiale universale. Le proporzioni positive ricevono un avvertimento se l’errore standard relativo supera il trenta per cento; gli intervalli molto ampi per le proporzioni ricevono un segnale di imprecisione. Nessuna di queste regole sopprime un contrasto con segno vicino a zero solo perché lì l’errore relativo non è utile. Gli intervalli al limite o degeneri sarebbero segnalati come non disponibili, non presentati come certezza esatta.
Un’estensione della ricerca esistente, con un confine riproducibile
I ricercatori già combinano e distinguono la lettura al lavoro e quella nella vita quotidiana per scopi diversi. Il lavoro longitudinale di Reder, Gauly e Lechner del 2020 usa la frequenza più alta tra i contesti nelle misure di coinvolgimento. Lo studio di Tighe e colleghi del 2024 combina indici di lavoro e di casa nei profili degli adulti statunitensi con competenze alfabetiche più basse e discute esplicitamente ulteriori analisi specifiche per contesto. L’analisi internazionale di Kyröläinen e Kuperman del 2021 include indici separati di lettura al lavoro e a casa. Questo studio non scopre la separazione dei contesti, non confuta quei disegni e non pretende di essere il primo a collegare pratiche di lettura e competenza.
Il suo contributo, più circoscritto, è una verifica completamente specificata di una ricodifica della frequenza di lettura di libri in un campione storico di persone occupate: quali componenti entrano nel gruppo combinato, come due riepiloghi di competenza misurata differiscono da quel gruppo e quanta incertezza accompagna i confronti fissati. Le domande sulla vita quotidiana e sul lavoro non misurano la qualità della lettura, la lingua o il contenuto di un libro. La valutazione è in inglese e la selezione verso il lavoro e verso le pratiche di lettura non è affrontata. Questi dati trasversali non portano ad alcuna raccomandazione secondo cui cambiare contesto di lettura produrrebbe un certo guadagno di competenza.
Il programma pubblico di riproduzione accetta l’archivio originale NCES consentito e produce solo aggregati arrotondati e controllati per la riservatezza. Il codice è accompagnato da impronte delle fonti, metodi e attribuzione; non vengono ridistribuiti record dei rispondenti, pesi né valori individuali. La conclusione pratica è che una media di chi legge almeno una volta a settimana in uno dei due contesti può essere utile pur lasciando fuori componenti sostanzialmente diverse. Chi legge con attenzione dovrebbe chiedersi che cosa l’indicatore combini, mantenere il valore combinato valido, esaminare i confronti fissi tra le componenti con i loro intervalli e ricordare che questi dati non hanno sostenuto l’aggiustamento previsto per la composizione.
Contesti di lettura di libri e competenza alfabetica misurata
Stati Uniti · PIAAC 2017 · Persone occupate di 16–65 anni
Grafico completo e fonte

Scorri il grafico in orizzontale per esaminarlo. ↔
Grafico e valori
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Contesto | Stima (punti di punteggio) | Errore standard | Limite inferiore 95 | Limite superiore 95 | Ampiezza dell’intervallo |
|---|---|---|---|---|---|
| Meno di una volta a settimana in entrambi i contesti | 269,4 | 1,8 | 265,9 | 272,9 | 6,9 |
| Almeno una volta a settimana solo nella vita quotidiana | 284,7 | 2,2 | 280,4 | 289,0 | 8,7 |
| Almeno una volta a settimana solo al lavoro | 261,5 | 4,7 | 252,3 | 270,6 | 18,3 |
| Almeno una volta a settimana in entrambi i contesti | 284,6 | 3,8 | 277,2 | 292,0 | 14,8 |
| Almeno una volta a settimana in uno dei due contesti (gruppo combinato) | 281,5 | 1,9 | 277,8 | 285,3 | 7,5 |
Dominio A, valutato. Dieci valori plausibili e 45 repliche JK2 attive; intervalli puntuali approssimati al 95%, non corretti per i confronti multipli. Nessuna diagnosi individuale né inferenza causale. La soglia di 226 si applica separatamente a ogni valore plausibile per la quota della parte bassa. Le ampiezze degli intervalli sono calcolate prima dell’arrotondamento: sottrarre gli estremi arrotondati può non dare l’ampiezza mostrata.

Lettura di libri: quattro contrasti fissi tra medie
Stati Uniti · PIAAC 2017 · Persone occupate di 16–65 anni
Grafico completo e fonte
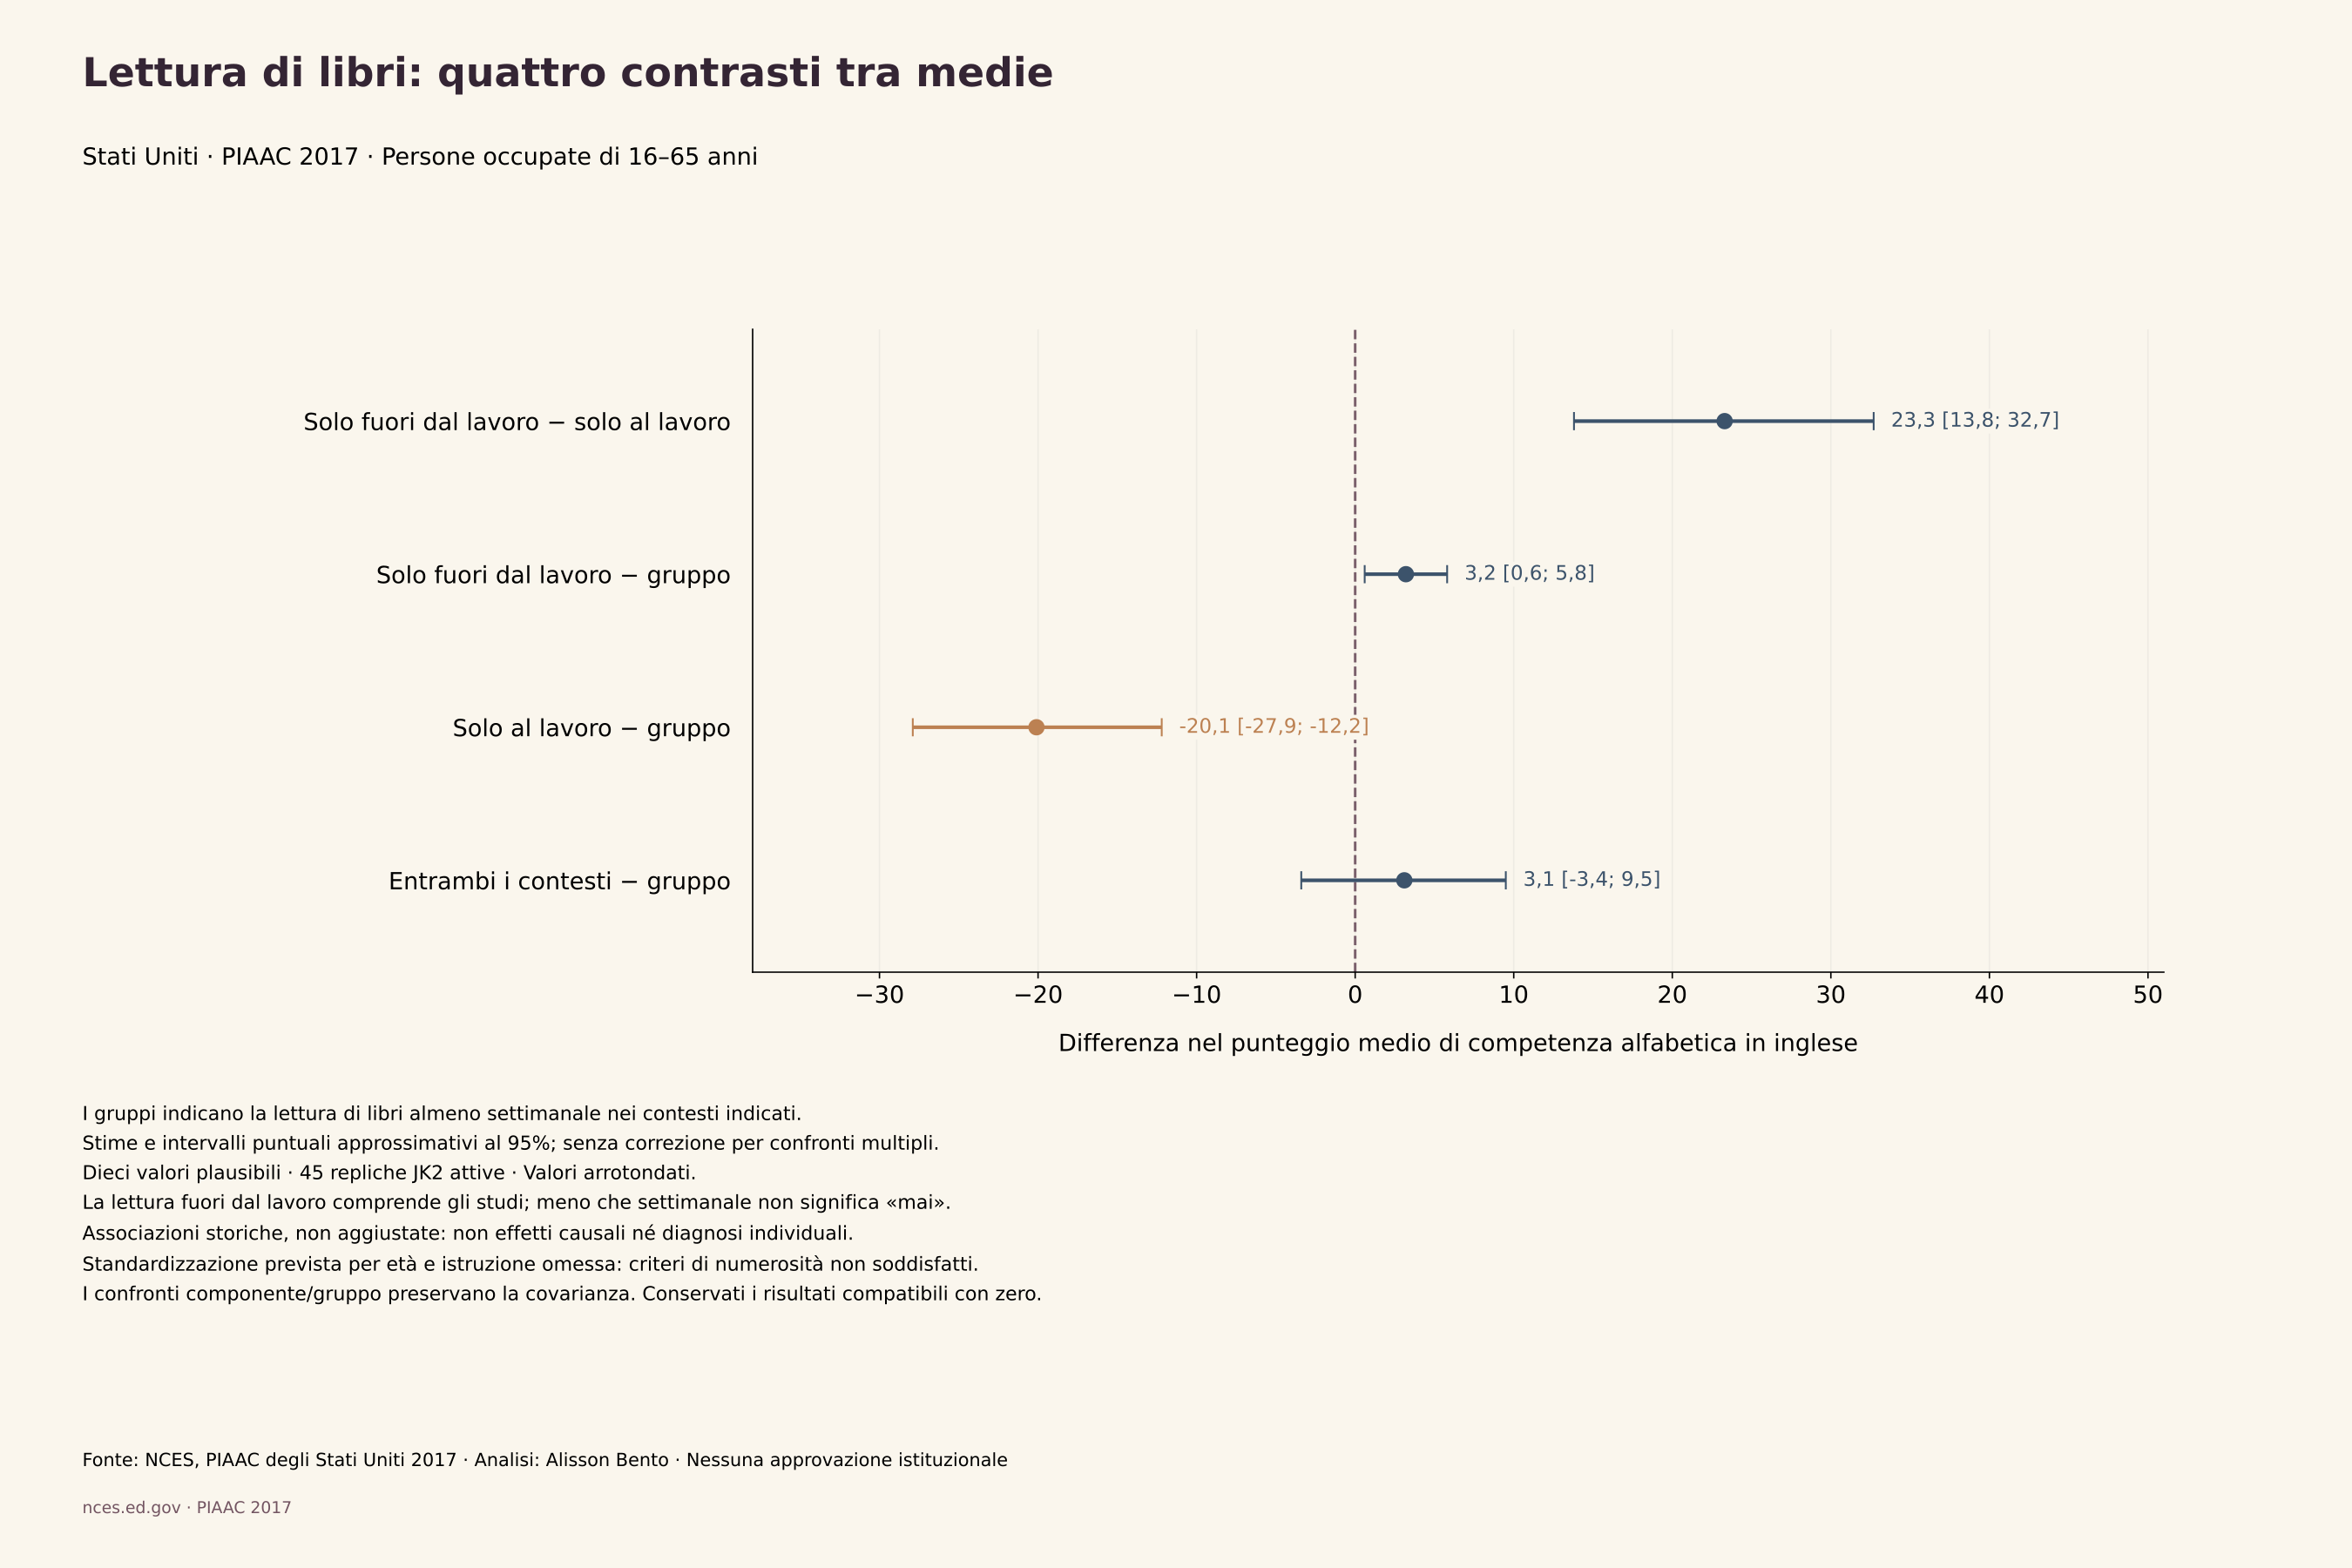
Scorri il grafico in orizzontale per esaminarlo. ↔
Grafico e valori
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Confronto | Differenza (punti di punteggio) | Errore standard | Limite inferiore 95 | Limite superiore 95 | Ampiezza dell’intervallo |
|---|---|---|---|---|---|
| Solo vita quotidiana meno solo lavoro | 23,3 | 4,8 | 13,8 | 32,7 | 18,9 |
| Solo vita quotidiana meno gruppo combinato | 3,2 | 1,3 | 0,6 | 5,8 | 5,1 |
| Solo lavoro meno gruppo combinato | −20,1 | 4,0 | −27,9 | −12,2 | 15,7 |
| Entrambi i contesti meno gruppo combinato | 3,1 | 3,3 | −3,4 | 9,5 | 12,9 |
I contrasti congiunti, calcolati in ogni replica e in ogni valore plausibile, conservano la covarianza, anche tra gruppi componente e gruppo combinato che si sovrappongono. Intervalli puntuali approssimati al 95%; si conservano i risultati compatibili con l’ipotesi nulla. Scala delle differenze, non sottrazione di intervalli indipendenti. Le ampiezze degli intervalli sono calcolate prima dell’arrotondamento: sottrarre gli estremi arrotondati può non dare l’ampiezza mostrata.

Dati e download
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Contesto di lettura | Record | Quota (%) | Errore standard (punti percentuali) | Limite inferiore 95 (%) | Limite superiore 95 (%) |
|---|---|---|---|---|---|
| Meno di una volta a settimana in entrambi i contesti | 1.234 | 53,3 | 1,1 | 51,2 | 55,4 |
| Almeno una volta a settimana solo nella vita quotidiana | 765 | 30,4 | 1,0 | 28,5 | 32,4 |
| Almeno una volta a settimana solo al lavoro | 157 | 6,4 | 0,6 | 5,3 | 7,5 |
| Almeno una volta a settimana in entrambi i contesti | 239 | 10,0 | 0,8 | 8,4 | 11,7 |
B: 2.395 persone occupate di 16–65 anni con entrambe le risposte di frequenza valide. «Meno di una volta a settimana» non significa mai. Percentuali ponderate e intervalli puntuali approssimati al 95%; i valori mostrati possono non sommare esattamente dopo l’arrotondamento. I conteggi non sono ponderati.
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Contesto di chi legge spesso | Quota B (%) | Limite inferiore B 95 (%) | Limite superiore B 95 (%) | Peso A nella miscela (%) |
|---|---|---|---|---|
| Almeno una volta a settimana solo nella vita quotidiana | 65,1 | 61,5 | 68,4 | 65,1 |
| Almeno una volta a settimana solo al lavoro | 13,6 | 11,4 | 16,2 | 13,6 |
| Almeno una volta a settimana in entrambi i contesti | 21,3 | 18,4 | 24,6 | 21,3 |
Quote condizionate tra chi legge spesso. I domini B (dati di contesto) e A (competenza misurata) hanno entrambi 1.161 record; le loro definizioni restano distinte. Le quote del dominio valutato sono i pesi che entrano nelle identità della miscela per la competenza.
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Contesto | Stima (punti di punteggio) | Errore standard | Limite inferiore 95 | Limite superiore 95 | Ampiezza dell’intervallo |
|---|---|---|---|---|---|
| Meno di una volta a settimana in entrambi i contesti | 269,4 | 1,8 | 265,9 | 272,9 | 6,9 |
| Almeno una volta a settimana solo nella vita quotidiana | 284,7 | 2,2 | 280,4 | 289,0 | 8,7 |
| Almeno una volta a settimana solo al lavoro | 261,5 | 4,7 | 252,3 | 270,6 | 18,3 |
| Almeno una volta a settimana in entrambi i contesti | 284,6 | 3,8 | 277,2 | 292,0 | 14,8 |
| Almeno una volta a settimana in uno dei due contesti (gruppo combinato) | 281,5 | 1,9 | 277,8 | 285,3 | 7,5 |
Dominio A, valutato. Dieci valori plausibili e 45 repliche JK2 attive; intervalli puntuali approssimati al 95%, non corretti per i confronti multipli. Nessuna diagnosi individuale né inferenza causale. La soglia di 226 si applica separatamente a ogni valore plausibile per la quota della parte bassa. Le ampiezze degli intervalli sono calcolate prima dell’arrotondamento: sottrarre gli estremi arrotondati può non dare l’ampiezza mostrata.
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Contesto | Stima (percentuale) | Errore standard | Limite inferiore 95 | Limite superiore 95 | Ampiezza dell’intervallo |
|---|---|---|---|---|---|
| Meno di una volta a settimana in entrambi i contesti | 19,1 | 1,5 | 16,3 | 22,3 | 6,0 |
| Almeno una volta a settimana solo nella vita quotidiana | 11,8 | 1,5 | 9,2 | 15,2 | 6,0 |
| Almeno una volta a settimana solo al lavoro | 23,3 | 4,9 | 15,0 | 34,3 | 19,3 |
| Almeno una volta a settimana in entrambi i contesti | 11,3 | 2,6 | 7,1 | 17,5 | 10,4 |
| Almeno una volta a settimana in uno dei due contesti (gruppo combinato) | 13,3 | 1,5 | 10,6 | 16,5 | 5,9 |
Dominio A, valutato. Dieci valori plausibili e 45 repliche JK2 attive; intervalli puntuali approssimati al 95%, non corretti per i confronti multipli. Nessuna diagnosi individuale né inferenza causale. La soglia di 226 si applica separatamente a ogni valore plausibile per la quota della parte bassa. Le ampiezze degli intervalli sono calcolate prima dell’arrotondamento: sottrarre gli estremi arrotondati può non dare l’ampiezza mostrata.
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Confronto | Differenza (punti di punteggio) | Errore standard | Limite inferiore 95 | Limite superiore 95 | Ampiezza dell’intervallo |
|---|---|---|---|---|---|
| Solo vita quotidiana meno solo lavoro | 23,3 | 4,8 | 13,8 | 32,7 | 18,9 |
| Solo vita quotidiana meno gruppo combinato | 3,2 | 1,3 | 0,6 | 5,8 | 5,1 |
| Solo lavoro meno gruppo combinato | −20,1 | 4,0 | −27,9 | −12,2 | 15,7 |
| Entrambi i contesti meno gruppo combinato | 3,1 | 3,3 | −3,4 | 9,5 | 12,9 |
I contrasti congiunti, calcolati in ogni replica e in ogni valore plausibile, conservano la covarianza, anche tra gruppi componente e gruppo combinato che si sovrappongono. Intervalli puntuali approssimati al 95%; si conservano i risultati compatibili con l’ipotesi nulla. Scala delle differenze, non sottrazione di intervalli indipendenti. Le ampiezze degli intervalli sono calcolate prima dell’arrotondamento: sottrarre gli estremi arrotondati può non dare l’ampiezza mostrata.
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Confronto | Differenza (punti percentuali) | Errore standard | Limite inferiore 95 | Limite superiore 95 | Ampiezza dell’intervallo |
|---|---|---|---|---|---|
| Solo vita quotidiana meno solo lavoro | −11,5 | 5,0 | −21,2 | −1,8 | 19,4 |
| Solo vita quotidiana meno gruppo combinato | −1,4 | 1,1 | −3,5 | 0,6 | 4,1 |
| Solo lavoro meno gruppo combinato | 10,0 | 4,1 | 1,9 | 18,1 | 16,2 |
| Entrambi i contesti meno gruppo combinato | −2,0 | 2,2 | −6,3 | 2,3 | 8,7 |
I contrasti congiunti, calcolati in ogni replica e in ogni valore plausibile, conservano la covarianza, anche tra gruppi componente e gruppo combinato che si sovrappongono. Intervalli puntuali approssimati al 95%; si conservano i risultati compatibili con l’ipotesi nulla. Scala delle differenze, non sottrazione di intervalli indipendenti. Le ampiezze degli intervalli sono calcolate prima dell’arrotondamento: sottrarre gli estremi arrotondati può non dare l’ampiezza mostrata.
Dati e metodo
Come abbiamo calcolato
- File storico a uso pubblico delle famiglie statunitensi del 2017; persone occupate di 16–65 anni con due risposte valide sulla frequenza di lettura di libri e peso completo positivo.
- Il dominio B delle risposte sulla lettura e il dominio A valutato con tutti e dieci i valori plausibili sono definiti separatamente; qui entrambi contano 2.395 record, senza alcuna perdita aggiuntiva di valutazioni.
- Almeno una volta a settimana = risposte 4–5; meno di una volta a settimana = risposte 1–3. La lettura nella vita quotidiana, fuori dal lavoro, include lo studio; l’instradamento sul lavoro attuale è verificato.
- Tutte le 45 repliche JK2 attive, somma degli scarti al quadrato; dieci valori plausibili, con la media della varianza entro i valori più 1,1 volte la varianza campionaria tra i valori.
- Media e quota con valore plausibile inferiore a 226 per tutti e quattro gli stati e per il gruppo combinato di chi legge spesso; contrasti fissi (solo vita quotidiana contro solo lavoro e componente contro gruppo combinato) calcolati congiuntamente.
- 920 identità della miscela tra riepiloghi, valori plausibili e repliche; la standardizzazione fissa su 27 celle non ha superato il criterio ed è stata omessa per intero.
- Applicati i criteri dello studio su sostegno, precisione e tutela della riservatezza; risultati pubblici arrotondati solo dopo il calcolo; nessuna ridistribuzione di dati dei rispondenti.
Cosa non possiamo dedurre dai dati
- Persone occupate selezionate, in un campione storico: non tutti gli adulti né le condizioni attuali. Le frequenze sono dichiarate; «meno di una volta a settimana» non significa non leggere.
- «Vita quotidiana» non significa solo lettura per piacere né necessariamente a casa; non si identificano libro, genere, quantità di materiale né lingua di lettura.
- Valutazione della competenza in inglese; i valori plausibili servono a stimare la popolazione, non a diagnosticare le persone.
- I confronti non corretti non distinguono età, istruzione, richieste del lavoro, selezione, esperienze linguistiche o altre spiegazioni.
- Il gruppo combinato è un obiettivo combinato valido, non una distorsione da aggregazione. Due riepiloghi non sono distribuzioni complete.
- Gli intervalli puntuali approssimati non sono corretti per i confronti multipli; contrasti compatibili con l’ipotesi nulla non stabiliscono equivalenza.
- Dieci celle di standardizzazione non superano il criterio; nessun risultato corretto, nessun accorpamento di celle né salvataggio con regressione. Nessuna raccomandazione causale sugli effetti della lettura.
Fonti originali
- NCES: PIAAC 2017 original ASCII public-use archive
L’archivio originale fornisce lo schema DAT e SAS. Impronte della fonte e delle singole voci verificate; la riproduzione pubblica richiede l’archivio originale consentito, in possesso di chi legge. Nessun dato dei rispondenti ridistribuito.
Consultato il 30 ottobre 2026
- NCES: U.S. PIAAC 2012/2014/2017 technical report
Il capitolo 8 e l’Appendice E stabiliscono 45 repliche JK2 attive, pesi segnaposto, dieci valori plausibili e la combinazione delle varianze; il limite continuo del livello 1 è inferiore a 226.
Consultato il 30 ottobre 2026
- NCES: 2017 household background questionnaire
L’instradamento per le persone occupate seleziona il lavoro attuale; la lettura nella vita quotidiana esclude il lavoro ma include lo studio per chi è iscritto a un percorso di istruzione. Il contesto non è solo il piacere né un luogo fisico.
Consultato il 30 ottobre 2026
- NCES PIAAC data usage agreement
Solo uso statistico; nessun tentativo di identificazione né collegamento a record identificabili individualmente. I risultati pubblici contengono aggregati controllati, non record dei rispondenti.
Consultato il 30 ottobre 2026
- NCES: 2017 background compendium
Le stime marginali ponderate ufficiali e i relativi errori standard offrono controlli di riferimento separati per l’occupazione e per entrambe le domande sulla frequenza di lettura di libri. Non forniscono i nuovi risultati di competenza per contesto congiunto.
Consultato il 30 ottobre 2026
- NCES: PIAAC data files
L’elenco ufficiale delle fonti pubbliche distingue i file sulle famiglie accessibili per l’analisi statistica dai file con licenza a uso riservato.
Consultato il 30 ottobre 2026
- Reder, Gauly and Lechner (2020): Practice makes perfect
Una precedente ricerca longitudinale combina le frequenze dei compiti nei contesti di lavoro e fuori dal lavoro. Questa verifica storica descrittiva dell’accorpamento non confuta quella scelta e non stabilisce un effetto causale della pratica.
Consultato il 30 ottobre 2026
- Tighe and colleagues (2024): Profiles of skills-use engagement
Un precedente studio statunitense sui profili di bassa competenza alfabetica combina indici di lavoro e di casa e discute la ricerca specifica per contesto e per voce. La separazione dei contesti non è presentata come una lacuna di ricerca appena scoperta.
Consultato il 30 ottobre 2026
- Kyröläinen and Kuperman (2021): Predictors of literacy in adulthood
Una precedente ricerca internazionale include indici separati di lettura al lavoro e a casa. Questo studio si concentra su una ricodifica esplicita della domanda sui libri, non sulla prima prova che i contesti di lettura differiscono.
Consultato il 30 ottobre 2026
Citare e riutilizzare lo studio
Alisson Bento. Che cosa lascia fuori una media di chi legge libri ogni settimana: lavoro e vita quotidiana. Analisi secondaria dei microdati a uso pubblico del PIAAC (NCES) sulle famiglie statunitensi, 2017. Fonti consultate il 30 ottobre 2026. https://alissonbento.com/it/research/us-book-reading-context-coarsening-and-literacy-2017/
Informazioni sulla fonte: National Center for Education Statistics, file a uso pubblico PIAAC sulle famiglie statunitensi del 2017. Valgono le condizioni di solo uso statistico e di non identificazione. Selezione, calcolo e spiegazione originali: Alisson Bento. Non si implica alcun avallo di NCES o OECD; non sono riprodotti insegne di agenzie, record dei rispondenti né figure di articoli di terzi.
Correzioni o domande editoriali