
Ein nützlicher Mittelwert kann seine Bestandteile verdecken
Betrachtet werden US-Erwachsene im Alter von sechzehn bis fünfundsechzig Jahren, die zum Zeitpunkt der PIAAC-Haushaltserhebung 2017 erwerbstätig waren. Bei ihnen fasst ein einziger Indikator für Bücherlesen mindestens einmal pro Woche bei der Arbeit oder im Alltag drei verschiedene Gruppen zusammen. Der gemeinsame Mittelwert der gemessenen Lesekompetenz beträgt 281,5 Punkte. Dieser Wert beschreibt die zusammengefasste Gruppe korrekt und ist kein fehlerhafter Durchschnitt. Er macht aber nicht sichtbar, dass die Teilgruppe, die nur bei der Arbeit wöchentlich liest, einen Mittelwert von 261,5 erreicht. Die Gruppen, die nur außerhalb der Arbeit oder in beiden Kontexten lesen, liegen bei 284,7 beziehungsweise 284,6. Das sind historische, unbereinigte Gruppenwerte, keine Bewertungen einzelner Personen und keine Wirkungen des Lesens.
Es geht nicht bloß um die allgemeine Feststellung, dass ein nationaler Durchschnitt Unterschiede verdeckt. Die Regel für die Zusammenfassung ist ausdrücklich festgelegt: Wöchentliches Bücherlesen in mindestens einem von zwei getrennt erfragten Kontexten ergibt eine einzige positive Kategorie. In dieser Kategorie entfallen 65,1 % auf Lesen nur außerhalb der Arbeit, 13,6 % auf Lesen nur bei der Arbeit und 21,3 % auf beide Kontexte. Der gemeinsame Wert liegt deshalb zahlenmäßig deutlich näher an den beiden größeren Teilgruppen mit höheren Mittelwerten als an der kleineren Teilgruppe der Lesenden bei der Arbeit. Die Bezeichnung „häufig Buchlesende“ bewahrt die Häufigkeit in irgendeinem Kontext, lässt aber den jeweiligen Kontext verschwinden.
Die Studie untersucht diese beschreibende Vergröberung, also das Zusammenfassen mehrerer Gruppen zu einer, anhand vorab festgelegter Vergleiche. Sie behält alle vier gemeinsamen Lesekategorien bei, berichtet ihre Zusammensetzung und betrachtet einen Mittelwert sowie einen Anteil am unteren Ende der Kompetenzskala. Sie schätzt keine vollständige Verteilung der Kompetenz und erfindet keinen allgemeinen Index für Informationsverlust. Ebenso wenig fordert sie, Kontexte grundsätzlich nie zusammenzufassen. Gefragt wird vielmehr: Welche Information vermittelt eine bestimmte zusammengefasste Kennzahl nicht mehr? Und wie unsicher sind die ergänzenden Beschreibungen ihrer Teilgruppen? Die feinere Darstellung soll die Zielgruppe des gültigen Gesamtwerts nicht nachträglich ersetzen.
Zwei Fragen zum Bücherlesen und eine historische Gruppe von Erwerbstätigen
Die Quelle ist die öffentlich zugängliche US-Haushaltsdatei des Programms zur internationalen Beurteilung der Kompetenzen Erwachsener (PIAAC) von 2017. Ausgewählt sind Erwerbstätige zwischen sechzehn und fünfundsechzig Jahren, die auf beide Fragen zur Häufigkeit des Bücherlesens gültig geantwortet haben und ein positives, endliches endgültiges Befragungsgewicht haben. Diese Gruppe umfasst 2.395 Datensätze. Sie beschreibt weder alle US-Erwachsenen noch heutige Verhältnisse, Schulkinder, Arbeitslose oder alle, die irgendwann gearbeitet haben. Die Definition von Erwerbstätigkeit schließt auch entsprechende selbstständige Tätigkeiten und die Mitarbeit in Familienunternehmen ein. Sie ist also nicht auf abhängig Beschäftigte beschränkt.
Die Frage zur Arbeit heißt G_Q01E. Sie fragt, wie oft jemand im Beruf Bücher liest. Die offizielle Fragebogenführung ordnet die ausgewählten aktuell Erwerbstätigen ihrer gegenwärtigen und nicht einer früheren Tätigkeit zu. Die Frage zum Alltag heißt H_Q01E. Sie betrifft das Lesen von Büchern außerhalb der Arbeit, sowohl Belletristik als auch Sachliteratur. Bei Menschen in Ausbildung beziehen die Anweisungen das Lesen für Lern- und Studienzwecke ausdrücklich ein. „Alltag“ bedeutet daher weder ausschließlich Vergnügen noch zwingend Lesen zu Hause oder ohne Bezug zur Bildung. Beide Kontexte können Texte am Bildschirm einschließen. Keine Frage bezeichnet ein bestimmtes Buch, ein Genre, eine Sprache oder die gelesene Textmenge.
Beide Fragen bieten fünf Antwortkategorien zur Häufigkeit. Die Studie legt „mindestens wöchentlich“ als die beiden höchsten Antworten fest und „seltener als wöchentlich“ als die übrigen drei gültigen Antworten. Die zweite Gruppe enthält „nie“, ist damit aber nicht gleichzusetzen. Fehlende Antworten, Verweigerungen, unbekannte Angaben und durch die Fragebogenführung ausgelassene Antworten werden nicht als Nichtlesen gewertet. Die Variable H_Q01E_T ist eine zusammengefasste Trendkodierung der Alltagsfrage und keine zweite, unabhängige Angabe. Würde man sie wie ein eigenes Erhebungsinstrument behandeln, entstünde ein Vergleich, den die zugrunde liegenden Beobachtungen gar nicht hergeben.
Die vier Kategorien und die Zusammensetzung der Gesamtgruppe
In der ausgewählten Gruppe der Erwerbstätigen berichten 53,3 % Bücherlesen seltener als wöchentlich in beiden Kontexten. 30,4 % lesen mindestens wöchentlich nur außerhalb der Arbeit, 6,4 % nur bei der Arbeit und 10,0 % in beiden Kontexten. Das sind gewichtete Beschreibungen der Bevölkerung, keine ungewichteten Anteile der Stichprobe. Wegen der Rundung müssen die angezeigten Anteile nicht genau hundert ergeben. Die vier Gruppen beschreiben eine gemeinsame Einteilung nach Häufigkeit. Sie zeigen weder lebenslang Lesende noch dauerhaft Nichtlesende, weder die Qualität des Lesens noch eine unveränderliche persönliche Eigenschaft. Solche weitergehenden Bedeutungen lassen sich aus den Antworten nicht ableiten.
Die Beschränkung auf mindestens wöchentliches Lesen in irgendeinem Kontext verändert den Bezugsrahmen (den Nenner). Innerhalb dieser Gesamtgruppe beträgt der geschätzte Anteil derer, die nur außerhalb der Arbeit lesen, 65,1 %, mit einem näherungsweisen 95-%-Konfidenzintervall von 61,5 bis 68,4 %. Wer nur bei der Arbeit liest, kommt auf 13,6 % (Konfidenzintervall 11,4 bis 16,2 %), wer in beiden Kontexten liest, auf 21,3 % (Konfidenzintervall 18,4 bis 24,6 %). Diese bedingten Anteile erklären die Mischung hinter der gemeinsamen Kennzahl für die Lesekompetenz. Sie dürfen nicht mit den jeweiligen Anteilen an allen zulässigen Erwerbstätigen verwechselt werden.
Die ungewichteten Gruppengrößen betragen 1.234 für seltener als wöchentlich in beiden Kontexten, 765 für nur außerhalb der Arbeit, 157 für nur bei der Arbeit und 239 für beide Kontexte. Die Gesamtgruppe, die in mindestens einem Kontext wöchentlich liest, umfasst somit 1.161 Datensätze. Jede Gruppe erfüllt die vorab festgelegten Mindestanforderungen: zweiundsechzig Datensätze, eine effektive Fallzahl nach Kish von mindestens dreißig und positive Nenner bei allen aktiven Replikationsgewichten. Das Kish-Maß beschreibt die Streuung der Gewichte. Es garantiert keine vollständig an das Stichprobendesign angepasste Genauigkeit. Diese Prüfungen erlauben die Schätzung. Sie machen aber weder alle Teilgruppen gleich genau noch die Angabe von Konfidenzintervallen überflüssig.
Was die Mittelwerte der gemessenen Lesekompetenz beschreiben
Der Mittelwert für alle, die nur außerhalb der Arbeit lesen, beträgt 284,7 Punkte, mit einem näherungsweisen 95-%-Konfidenzintervall (für jeden Wert einzeln) von 280,4 bis 289,0. Bei denen, die nur bei der Arbeit lesen, sind es 261,5 Punkte mit einem Konfidenzintervall von 252,3 bis 270,6. Wöchentliches Lesen in beiden Kontexten geht mit einem Mittelwert von 284,6 einher, das Konfidenzintervall reicht von 277,2 bis 292,0. Der gemeinsame Wert für wöchentliches Lesen in mindestens einem Kontext beträgt 281,5 (Konfidenzintervall 277,8 bis 285,3). Die Vergleichsgruppe, die in beiden Kontexten seltener als wöchentlich liest, liegt bei 269,4 (Konfidenzintervall 265,9 bis 272,9).
Diese Zahlen fassen die auf Englisch gemessene Lesekompetenz zusammen. Sie sagen nichts über Intelligenz, persönlichen Wert, literarischen Geschmack oder die Qualität der gewählten Bücher. PIAAC untersucht mit einer strukturierten Erhebung, wie gut Erwachsene schriftliche Informationen verstehen und nutzen können. Die Fragen zum Kontext erfassen selbstberichtete Häufigkeiten. Sie sind kein Experiment, in dem Bücher oder Lesebedingungen zugewiesen werden. Unterschiede können Bildungsbiografien, Spracherfahrungen, berufliche Auswahlprozesse, Arbeitsaufgaben und weitere Merkmale widerspiegeln. Ein niedrigerer Gruppenmittelwert belegt nicht, dass Lesen bei der Arbeit die Kompetenz verringert. Ein höherer Mittelwert belegt ebenso wenig einen Nutzen, den Lesen in der Freizeit verursacht hätte.
Auch die Breiten der Konfidenzintervalle für die Mittelwerte unterscheiden sich deutlich: 8,7 Punkte für alle, die nur außerhalb der Arbeit lesen, 18,3 für alle, die nur bei der Arbeit lesen, und 14,8 für beide Kontexte. Die Teilgruppe, die nur bei der Arbeit liest, ist die kleinste der drei und hat das breiteste Konfidenzintervall. Das Konfidenzintervall der Gesamtgruppe ist mit 7,5 Punkten schmaler. Diese Genauigkeit gilt aber für die zusammengefasste Zielgruppe und nicht für jede darin enthaltene Teilgruppe. Wer jede Teilgruppe durch den Mittelwert der Gesamtgruppe ersetzt, beantwortet eine andere beschreibende Frage genauer. Die Unsicherheit über die einzelne Teilgruppe ist damit nicht behoben.
Eine Kennzahl am unteren Ende der Skala ergänzt die Perspektive
Die zweite Kennzahl zur Kompetenz ist der Anteil unter 226 Punkten. Das entspricht Kompetenzstufe 1 oder darunter nach der offiziellen kontinuierlichen Grenzziehung. Der Schwellenwert wird auf jeden plausiblen Wert einzeln angewandt, bevor die Schätzungen für die Bevölkerung zusammengeführt werden. Plausible Werte sind zehn mögliche Kompetenzwerte je Person, die die Unsicherheit der Messung abbilden. Der Schwellenwert wird nicht auf den persönlichen Durchschnitt der plausiblen Werte angewandt, und keine Person erhält damit eine diagnostizierte Kompetenzstufe. Diese einzelne Kennzahl für den unteren Bereich ergänzt den Mittelwert. Zusammen beschreiben beide weiterhin keine vollständige Verteilung und zeigen nicht, wie sich alle Bereiche der Kompetenzskala zwischen den Gruppen unterscheiden.
Der geschätzte Anteil auf Stufe 1 oder darunter beträgt 11,8 % für alle, die nur außerhalb der Arbeit lesen, mit einem näherungsweisen Konfidenzintervall von 9,2 bis 15,2 %. Für alle, die nur bei der Arbeit lesen, sind es 23,3 % (Konfidenzintervall 15,0 bis 34,3 %), für beide Kontexte 11,3 % (Konfidenzintervall 7,1 bis 17,5 %). In der Gesamtgruppe der häufig Lesenden sind es 13,3 % (Konfidenzintervall 10,6 bis 16,5 %). In der Vergleichsgruppe, die in beiden Kontexten seltener als wöchentlich liest, beträgt der Anteil 19,1 % (Konfidenzintervall 16,3 bis 22,3 %).
Das Konfidenzintervall für den unteren Kompetenzbereich ist bei denen, die nur bei der Arbeit lesen, erheblich breiter als in den anderen häufig lesenden Teilgruppen. Diese Unsicherheit bleibt sichtbar, auch wenn sich ihr Schätzwert von dem der Gesamtgruppe unterscheidet. Die beschreibende Spanne der Teilgruppen reicht von 11,3 % bis 23,3 %. Sie ist weder ein Konfidenzintervall noch ein Verfahren zur Rangfolge noch ein unabhängig ausgewählter Endpunkt. Alle vorgesehenen Ergebnisse der Teilgruppen bleiben enthalten. Nach dem Blick auf die Ergebnisse werden keine zusätzlichen Grenzwerte, Altersgruppen, Berufe oder Erhebungsjahre durchsucht, um einen stärkeren Unterschied zu finden. Die festgelegte Menge an Vergleichen bleibt unverändert.
Festgelegte Vergleiche enthalten auch Ergebnisse, die mit null vereinbar sind
Der vorab bestimmte Vergleich „nur außerhalb der Arbeit“ minus „nur bei der Arbeit“ ergibt 23,3 Punkte, mit einem näherungsweisen Konfidenzintervall von 13,8 bis 32,7. Beim Anteil auf Stufe 1 oder darunter beträgt die entsprechende Differenz −11,5 Prozentpunkte, mit einem Konfidenzintervall von −21,2 bis −1,8. Das sind beschreibende Vergleiche innerhalb der ausgewählten Gruppe der Erwerbstätigen. Ihre Konfidenzintervalle berücksichtigen die Unsicherheit aus den Replikationsgewichten und den plausiblen Werten. Sie sind aber nicht für Mehrfachvergleiche korrigiert. Sie erlauben weder eine bestätigende Aussage über alle Vergleiche zusammen noch eine ursächliche Deutung. Auch ein deutlicher Unterschied der Schätzwerte ersetzt diese Einschränkungen nicht.
Der Vergleich jeder Teilgruppe mit der Gesamtgruppe der häufig Lesenden beantwortet die Frage nach der Zusammenfassung unmittelbarer. Wer nur außerhalb der Arbeit liest, liegt 3,2 Punkte über der Gesamtgruppe (Konfidenzintervall 0,6 bis 5,8). Der Anteil im unteren Kompetenzbereich liegt 1,4 Prozentpunkte darunter (Konfidenzintervall −3,5 bis 0,6). Wer nur bei der Arbeit liest, liegt 20,1 Punkte unter der Gesamtgruppe (Konfidenzintervall −27,9 bis −12,2). Der Anteil im unteren Bereich ist 10,0 Prozentpunkte höher (Konfidenzintervall 1,9 bis 18,1). Diese letzte Teilgruppe wird schlecht beschrieben, wenn die gemeinsamen Schätzwerte so dargestellt werden, als gälten sie für jeden Kontext gleichermaßen.
Die Teilgruppe mit beiden Kontexten liegt 3,1 Punkte über der Gesamtgruppe (Konfidenzintervall −3,4 bis 9,5). Beim Anteil im unteren Kompetenzbereich liegt sie 2,0 Prozentpunkte darunter (Konfidenzintervall −6,3 bis 2,3). Diese Konfidenzintervalle enthalten null, ebenso wie das Konfidenzintervall für den Anteil im unteren Bereich bei allen, die nur außerhalb der Arbeit lesen. Wir berichten sie und verwerfen sie nicht als unpassend. Ein Konfidenzintervall, das null einschließt, beweist keine Gleichwertigkeit. Ein Konfidenzintervall ohne null beweist keinen Wirkungszusammenhang. Das vollständige Muster sagt mehr aus als eine Überschrift, die nur besonders unterschiedlich wirkende Vergleiche auswählt und die übrigen Ergebnisse unsichtbar macht.
Zusammenfassen ist an sich kein statistischer Fehler
Bei jeder Kennzahl zur Kompetenz entspricht die gemeinsame Schätzung den Schätzungen der Teilgruppen, gewichtet mit ihren Anteilen an der getesteten Gesamtgruppe der häufig Lesenden. Diese Gleichung gilt vor der Rundung. Wir prüfen sie für alle zehn plausiblen Werte und für jede Berechnung mit dem vollständigen Gewicht beziehungsweise mit jedem Replikationsgewicht, nicht nur für den endgültigen Mittelwert. So wird verständlich, warum eine gültige Gesamtgruppe nahe an manchen Teilgruppen und weit von einer anderen liegen kann. Die gemeinsame Schätzung wird dadurch nicht verzerrt. Ebenso wenig wird eine einzelne Teilgruppe zur richtigen Zielgruppe für alle Forschungsfragen erklärt.
Für diese Gleichung ist der Nenner entscheidend. Die Anteile der Häufigkeiten beziehen sich auf zulässige Befragte mit gültigen Antworten auf beide Lesefragen (Gruppe B). Die Kennzahlen zur Kompetenz und die Mischungsgewichte beziehen sich auf Personen, für die zusätzlich alle zehn plausiblen Werte zur Lesekompetenz vorliegen (Gruppe A). In der ausgewählten Stichprobe enthalten beide Gruppen dieselben 2.395 Datensätze. Weder insgesamt noch in einem Kontext entsteht also ein zusätzlicher Ausfall durch die Kompetenzdaten. Diese beobachtete Gleichheit rechtfertigt es nicht, die Definitionen gleichzusetzen. In einer anderen Datei oder bei einer anderen Gruppe von Personen könnten die Anteile aus der umfassenderen Gruppe B ungeeignet sein, um die Mittelwerte der getesteten Gruppe A zu rekonstruieren.
Eine Teilgruppe und die Gesamtgruppe teilen Datensätze, deshalb hängen ihre Schätzfehler voneinander ab. Die Analyse berechnet jeden Vergleich „Teilgruppe minus Gesamtgruppe“ innerhalb jedes Replikationsgewichts und jedes plausiblen Werts. So bleibt die gemeinsame Schwankung (Kovarianz) erhalten, bevor die Unsicherheit zusammengeführt wird. Zwei Standardfehler wie unabhängige Größen zu behandeln, würde den tatsächlichen Vergleich nicht abbilden. Besonders wichtig ist das, wenn eine große Teilgruppe die Gesamtgruppe stark prägt. Ziel ist eine nachvollziehbare Beschreibung der gewählten Umkodierung. Die Studie behauptet nicht, feinere Einteilungen seien grundsätzlich besser oder jeder denkbare Unterschied brauche eine eigene Studie.
Die geplante Bereinigung um die Zusammensetzung war nicht tragfähig
Vor der Untersuchung der Kompetenzwerte sah der Plan eine beschreibende Standardisierung nach drei Altersgruppen und drei Bildungsgruppen vor. Standardisieren heißt hier, die Gruppen rechnerisch auf dieselbe Zusammensetzung zu bringen. Die Altersgrenzen lagen bei sechzehn bis vierunddreißig, fünfunddreißig bis vierundfünfzig und fünfundfünfzig bis fünfundsechzig Jahren. Die Bildungsgruppen folgten den auf ISCED (der internationalen Bildungsklassifikation) beruhenden EDCAT6-Codes der Quelle, ohne unterstellte Entsprechungen zu amerikanischen Abschlüssen. Als Ziel war die gemeinsame Verteilung nach Alter und Bildung der getesteten häufig Lesenden mit gültiger Bildungsangabe vorgesehen. Damit wären die drei Kontexte bei gleicher beobachteter Zusammensetzung verglichen worden. Auch eine solche Standardisierung hätte den Vergleich nicht ursächlich gemacht und unbeobachtete Auswahlprozesse nicht beseitigt.
Jede der siebenundzwanzig Kombinationen aus Kontext und Alters-Bildungs-Gruppe sollte mindestens zwanzig Datensätze, eine effektive Fallzahl nach Kish von mindestens zehn und positive Nenner bei den Replikationsgewichten aufweisen. Zehn Gruppen verfehlten diese festgelegten Kriterien. Deshalb wurde die gesamte standardisierte Zusatzanalyse (Sensitivitätsanalyse) ausgelassen. Es wurden weder Gruppen zusammengelegt noch eine Regression als Ersatz eingeführt, und nachträglich wurde auch kein Vergleich nur nach Alter ergänzt. Die internen Gruppengrößen dienten der Entscheidung, ob das geplante Verfahren ausreichend gestützt war. Sie dienten nicht dazu, Ergebnisse zur Kompetenz aus kleinen Gruppen zu veröffentlichen oder nachträglich eine günstigere Auswertung zu suchen.
Die berichteten Unterschiede bleiben folglich nach Alter und Bildung unbereinigt. Die Studie kann nicht bestimmen, wie viel diese Merkmale vom Muster der Kontexte erklären, und erst recht keinen direkten Zusammenhang mit dem Lesekontext herauslösen. Dass die Standardisierung fehlt, gehört zur inhaltlichen Deutung und ist keine bloße Verwaltungsnotiz. Die unzureichend gestützte Zusatzanalyse beseitigt die tragfähige unbereinigte Beschreibung nicht. Sie begrenzt aber Aussagen darüber, ob sich die Teilgruppen bei gleicher Zusammensetzung weiterhin unterscheiden würden. Es wird weder ein bereinigtes noch ein von der Zusammensetzung unabhängiges Ergebnis angedeutet.
Replikationsgewichte und plausible Werte erfüllen verschiedene Aufgaben
Die Datei enthält achtzig Felder für Replikationsgewichte, aber nur fünfundvierzig sind für dieses US-Design aktiv. Die übrigen fünfunddreißig entsprechen genau dem vollständigen Stichprobengewicht. Replikationsgewichte dienen dazu, die Unsicherheit durch die Stichprobe zu berechnen. Die Varianz nach dem gepaarten Jackknife-Verfahren (JK2) verwendet die Summe der quadrierten Abweichungen der Schätzungen mit den aktiven Replikationsgewichten von der Schätzung mit vollständigem Gewicht. Sie verwendet weder deren Durchschnitt noch eine Bootstrap-Formel mit achtzig Replikaten. Als Kontrolle gegen die Quelle reproduzieren getrennte Berechnungen veröffentlichte Anteile zur Beschäftigung und zur Häufigkeit des Bücherlesens samt Standardfehlern. Diese Vergleichswerte prüfen die grundlegende Umsetzung der Gewichtung, bevor die neuen gemeinsamen Kennzahlen zu den Kontexten gedeutet werden. Sie liefern nicht selbst die neuen gemeinsamen Ergebnisse zur Kompetenz.
Für die Lesekompetenz werden zusätzlich zehn plausible Werte verwendet. Jeder eignet sich für Schätzungen über die Bevölkerung; keiner sollte als endgültiger persönlicher Testwert aufgefasst werden. Für jeden plausiblen Wert werden alle Schätzungen und Vergleiche mit dem vollständigen Gewicht und fünfundvierzig Replikationsgewichten neu berechnet. Die Gesamtvarianz verbindet die durchschnittliche Stichprobenvarianz innerhalb der plausiblen Werte mit der Stichprobenvarianz zwischen ihnen, multipliziert mit 1,1. Die Konfidenzintervalle für Anteile beruhen auf einer Logit-Transformation mit der Delta-Methode. Differenzen von Anteilen bleiben auf ihrer Differenzskala. Mittelwerte und Mittelwertvergleiche erhalten näherungsweise symmetrische Konfidenzintervalle in Skalenpunkten. Diese getrennten Schritte berücksichtigen unterschiedliche Quellen der Unsicherheit.
Angezeigte Schätzwerte, Standardfehler und Grenzen der Konfidenzintervalle werden erst nach der Berechnung gerundet. Mindestfallzahlen, Kish-Schwellen und Hinweise zur Genauigkeit sind festgelegte Regeln dieser Studie. Sie sind keine allgemeingültige offizielle Garantie. Positive Anteile erhalten einen Warnhinweis, wenn der relative Standardfehler über dreißig Prozent liegt; sehr breite Konfidenzintervalle für Anteile werden als ungenau gekennzeichnet. Keine dieser Regeln unterdrückt einen Vergleich, dessen Wert nahe null liegt, allein deshalb, weil ein relativer Fehler dort wenig hilfreich ist. Konfidenzintervalle am Rand des möglichen Wertebereichs oder mit nur einem Wert würden als nicht verfügbar gekennzeichnet, statt als völlig sichere Ergebnisse zu erscheinen.
Bestehende Forschung erweitern, mit klar begrenztem Umfang der Nachrechnung
Forschende kombinieren und trennen Lesen bei der Arbeit und im Alltag bereits für unterschiedliche Zwecke. Die Längsschnittarbeit von Reder, Gauly und Lechner aus dem Jahr 2020 verwendet für Maße des Engagements jeweils die höhere Häufigkeit der Aufgaben über beide Kontexte. Tighe und Mitarbeitende verbinden 2024 Indizes für Arbeit und Zuhause in Profilen von US-Erwachsenen mit niedriger Lesekompetenz. Sie sprechen ausdrücklich weiterführende Analysen für einzelne Kontexte an. Kyröläinen und Kuperman berücksichtigen 2021 in einer internationalen Untersuchung getrennte Leseindizes für Arbeit und Zuhause. Diese Studie entdeckt die Trennung der Kontexte nicht neu, widerlegt jene Forschungsdesigns nicht und beansprucht keine erstmalige Verbindung zwischen Lesepraktiken und Kompetenz.
Der engere Beitrag dieser Studie ist die vollständig festgelegte Prüfung einer Umkodierung der Buchhäufigkeit in einer historischen Stichprobe von Erwerbstätigen: Welche Teilgruppen bilden die Gesamtgruppe, wie unterscheiden sich zwei Kennzahlen zur Kompetenz von diesem Gesamtwert, und wie unsicher sind die festgelegten Vergleiche? Die Fragen zu Alltag und Arbeit messen weder die Qualität des Lesens noch die Sprache oder den Inhalt eines Buchs. Die Kompetenz wird auf Englisch gemessen. Wer in welche Arbeit und in welche Lesepraxis gelangt (Auswahl), bleibt ungeklärt. Aus diesen Querschnittsdaten folgt deshalb keine Empfehlung, dass ein Wechsel des Lesekontexts einen bestimmten Kompetenzzuwachs erzeugen würde. Der beschreibende Befund darf nicht in ein Wirkungsversprechen umgedeutet werden.
Das öffentliche Programm zur Nachrechnung verarbeitet das zulässige Originalarchiv der NCES und erzeugt ausschließlich geprüfte, gerundete Zusammenfassungen. Prüfsummen der Quellen, Methoden und Quellenangaben begleiten den Code. Einzelne Datensätze, Gewichte und individuelle plausible Werte werden nicht weitergegeben. Die praktische Schlussfolgerung lautet: Ein Mittelwert für wöchentliches Lesen in mindestens einem Kontext kann nützlich sein und dennoch inhaltlich verschiedene Teilgruppen unsichtbar lassen. Sorgfältige Leserinnen und Leser sollten prüfen, was der Indikator zusammenfasst, und seine gültige gemeinsame Zielgruppe beibehalten. Sie sollten die festgelegten Vergleiche der Teilgruppen samt Konfidenzintervallen betrachten und berücksichtigen, dass die geplante Bereinigung um die Zusammensetzung mit diesen Daten nicht tragfähig war.
Bücherlesen: Kontexte und gemessene Lesekompetenz
USA · PIAAC 2017 · Aktuell Erwerbstätige von 16 bis 65 Jahren
Vollständige Grafik und Quelle

Diagramm seitlich scrollen, um alle Details zu sehen. ↔
Grafik und Werte
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Kontext | Schätzwert (Skalenpunkte) | Standardfehler | Untere Grenze des 95-%-Konfidenzintervalls | Obere Grenze des 95-%-Konfidenzintervalls | Breite des Konfidenzintervalls |
|---|---|---|---|---|---|
| In beiden Kontexten seltener als wöchentlich | 269,4 | 1,8 | 265,9 | 272,9 | 6,9 |
| Wöchentlich nur außerhalb der Arbeit | 284,7 | 2,2 | 280,4 | 289,0 | 8,7 |
| Wöchentlich nur bei der Arbeit | 261,5 | 4,7 | 252,3 | 270,6 | 18,3 |
| Wöchentlich in beiden Kontexten | 284,6 | 3,8 | 277,2 | 292,0 | 14,8 |
| Wöchentlich in mindestens einem Kontext (Gesamtgruppe) | 281,5 | 1,9 | 277,8 | 285,3 | 7,5 |
Gruppe A (getestet). Zehn plausible Werte und 45 aktive JK2-Replikationsgewichte; näherungsweise 95-%-Konfidenzintervalle für jeden Wert einzeln, ohne Korrektur für Mehrfachvergleiche. Keine individuelle Diagnose und keine ursächliche Aussage. Der Schwellenwert unter 226 wird für den unteren Anteil auf jeden plausiblen Wert einzeln angewandt. Die Breiten der Konfidenzintervalle werden vor der Rundung der Anzeige berechnet; die Differenz der gerundeten Grenzen muss deshalb nicht die angezeigte Breite ergeben.

Bücherlesen: vier festgelegte Vergleiche der Mittelwerte
USA · PIAAC 2017 · Aktuell Erwerbstätige von 16 bis 65 Jahren
Vollständige Grafik und Quelle
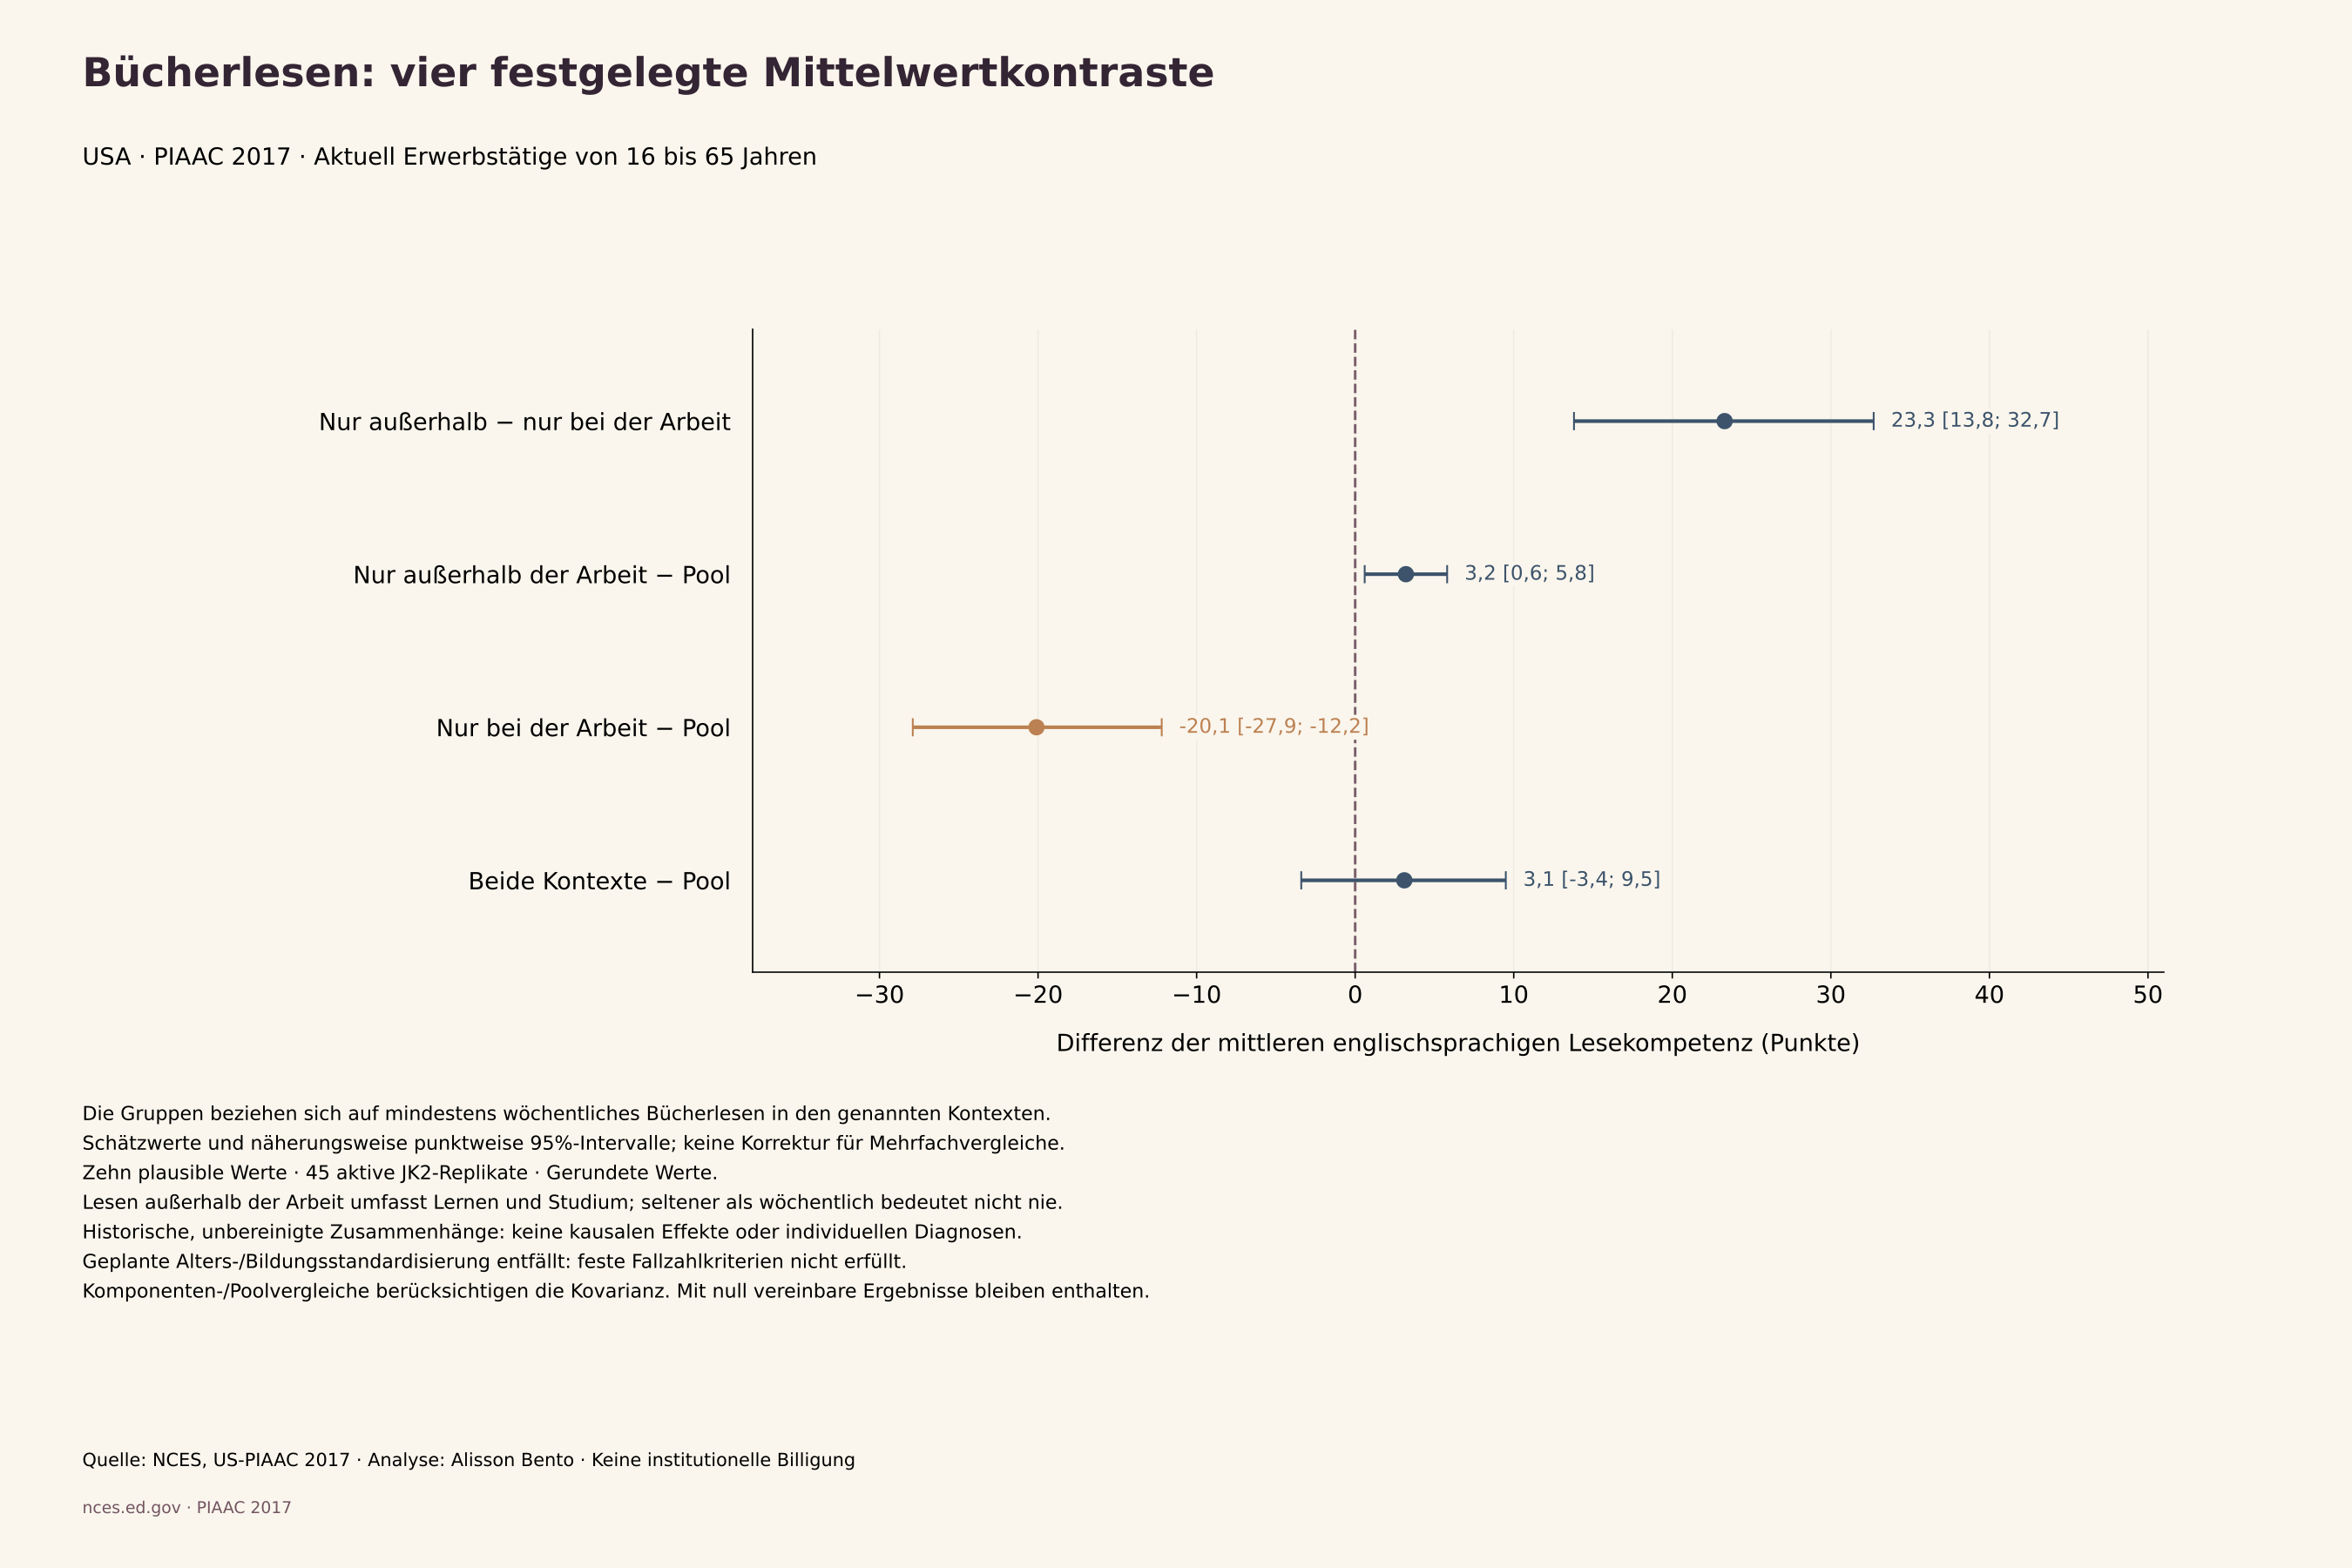
Diagramm seitlich scrollen, um alle Details zu sehen. ↔
Grafik und Werte
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Vergleich | Differenz (Skalenpunkte) | Standardfehler | Untere Grenze des 95-%-Konfidenzintervalls | Obere Grenze des 95-%-Konfidenzintervalls | Breite des Konfidenzintervalls |
|---|---|---|---|---|---|
| Nur außerhalb der Arbeit minus nur bei der Arbeit | 23,3 | 4,8 | 13,8 | 32,7 | 18,9 |
| Nur außerhalb der Arbeit minus Gesamtgruppe | 3,2 | 1,3 | 0,6 | 5,8 | 5,1 |
| Nur bei der Arbeit minus Gesamtgruppe | −20,1 | 4,0 | −27,9 | −12,2 | 15,7 |
| Beide Kontexte minus Gesamtgruppe | 3,1 | 3,3 | −3,4 | 9,5 | 12,9 |
Die gemeinsamen Vergleiche innerhalb jedes Replikationsgewichts und plausiblen Werts berücksichtigen die gemeinsame Schwankung (Kovarianz), auch wenn sich Teilgruppen und Gesamtgruppe überlappen. Näherungsweise 95-%-Konfidenzintervalle für jeden Wert einzeln; mit null vereinbare Ergebnisse bleiben erhalten. Differenzskala, keine Subtraktion unabhängiger Konfidenzintervalle. Die Breiten werden vor der Rundung berechnet; die Differenz gerundeter Grenzen kann abweichen.

Daten und Downloads
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Lesekontext | Datensätze | Anteil (%) | Standardfehler (Prozentpunkte) | Untere Grenze des 95-%-Konfidenzintervalls (%) | Obere Grenze des 95-%-Konfidenzintervalls (%) |
|---|---|---|---|---|---|
| In beiden Kontexten seltener als wöchentlich | 1.234 | 53,3 | 1,1 | 51,2 | 55,4 |
| Wöchentlich nur außerhalb der Arbeit | 765 | 30,4 | 1,0 | 28,5 | 32,4 |
| Wöchentlich nur bei der Arbeit | 157 | 6,4 | 0,6 | 5,3 | 7,5 |
| Wöchentlich in beiden Kontexten | 239 | 10,0 | 0,8 | 8,4 | 11,7 |
Gruppe B: 2.395 aktuell Erwerbstätige von 16 bis 65 Jahren mit beiden gültigen Antworten zur Häufigkeit. „Seltener als wöchentlich“ bedeutet nicht „nie“. Gewichtete Prozentwerte und näherungsweise 95-%-Konfidenzintervalle für jeden Wert einzeln; angezeigte Werte summieren sich nach der Rundung eventuell nicht exakt. Die Zahlen der Datensätze sind ungewichtet.
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Kontext des wöchentlichen Lesens | Anteil in Gruppe B (%) | Untere Grenze des 95-%-Konfidenzintervalls, Gruppe B (%) | Obere Grenze des 95-%-Konfidenzintervalls, Gruppe B (%) | Mischungsgewicht in Gruppe A (%) |
|---|---|---|---|---|
| Wöchentlich nur außerhalb der Arbeit | 65,1 | 61,5 | 68,4 | 65,1 |
| Wöchentlich nur bei der Arbeit | 13,6 | 11,4 | 16,2 | 13,6 |
| Wöchentlich in beiden Kontexten | 21,3 | 18,4 | 24,6 | 21,3 |
Bedingte Anteile unter den häufig Lesenden. Gruppe B (gültige Antworten auf beide Lesefragen) und Gruppe A (zusätzlich alle plausiblen Werte zur Kompetenz) enthalten hier jeweils 1.161 Datensätze; ihre Definitionen bleiben getrennt. Die Anteile in Gruppe A dienen als Gewichte für die Mischung der Kompetenzwerte.
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Kontext | Schätzwert (Skalenpunkte) | Standardfehler | Untere Grenze des 95-%-Konfidenzintervalls | Obere Grenze des 95-%-Konfidenzintervalls | Breite des Konfidenzintervalls |
|---|---|---|---|---|---|
| In beiden Kontexten seltener als wöchentlich | 269,4 | 1,8 | 265,9 | 272,9 | 6,9 |
| Wöchentlich nur außerhalb der Arbeit | 284,7 | 2,2 | 280,4 | 289,0 | 8,7 |
| Wöchentlich nur bei der Arbeit | 261,5 | 4,7 | 252,3 | 270,6 | 18,3 |
| Wöchentlich in beiden Kontexten | 284,6 | 3,8 | 277,2 | 292,0 | 14,8 |
| Wöchentlich in mindestens einem Kontext (Gesamtgruppe) | 281,5 | 1,9 | 277,8 | 285,3 | 7,5 |
Gruppe A (getestet). Zehn plausible Werte und 45 aktive JK2-Replikationsgewichte; näherungsweise 95-%-Konfidenzintervalle für jeden Wert einzeln, ohne Korrektur für Mehrfachvergleiche. Keine individuelle Diagnose und keine ursächliche Aussage. Der Schwellenwert unter 226 wird für den unteren Anteil auf jeden plausiblen Wert einzeln angewandt. Die Breiten der Konfidenzintervalle werden vor der Rundung der Anzeige berechnet; die Differenz der gerundeten Grenzen muss deshalb nicht die angezeigte Breite ergeben.
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Kontext | Schätzwert (%) | Standardfehler | Untere Grenze des 95-%-Konfidenzintervalls | Obere Grenze des 95-%-Konfidenzintervalls | Breite des Konfidenzintervalls |
|---|---|---|---|---|---|
| In beiden Kontexten seltener als wöchentlich | 19,1 | 1,5 | 16,3 | 22,3 | 6,0 |
| Wöchentlich nur außerhalb der Arbeit | 11,8 | 1,5 | 9,2 | 15,2 | 6,0 |
| Wöchentlich nur bei der Arbeit | 23,3 | 4,9 | 15,0 | 34,3 | 19,3 |
| Wöchentlich in beiden Kontexten | 11,3 | 2,6 | 7,1 | 17,5 | 10,4 |
| Wöchentlich in mindestens einem Kontext (Gesamtgruppe) | 13,3 | 1,5 | 10,6 | 16,5 | 5,9 |
Gruppe A (getestet). Zehn plausible Werte und 45 aktive JK2-Replikationsgewichte; näherungsweise 95-%-Konfidenzintervalle für jeden Wert einzeln, ohne Korrektur für Mehrfachvergleiche. Keine individuelle Diagnose und keine ursächliche Aussage. Der Schwellenwert unter 226 wird für den unteren Anteil auf jeden plausiblen Wert einzeln angewandt. Die Breiten der Konfidenzintervalle werden vor der Rundung der Anzeige berechnet; die Differenz der gerundeten Grenzen muss deshalb nicht die angezeigte Breite ergeben.
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Vergleich | Differenz (Skalenpunkte) | Standardfehler | Untere Grenze des 95-%-Konfidenzintervalls | Obere Grenze des 95-%-Konfidenzintervalls | Breite des Konfidenzintervalls |
|---|---|---|---|---|---|
| Nur außerhalb der Arbeit minus nur bei der Arbeit | 23,3 | 4,8 | 13,8 | 32,7 | 18,9 |
| Nur außerhalb der Arbeit minus Gesamtgruppe | 3,2 | 1,3 | 0,6 | 5,8 | 5,1 |
| Nur bei der Arbeit minus Gesamtgruppe | −20,1 | 4,0 | −27,9 | −12,2 | 15,7 |
| Beide Kontexte minus Gesamtgruppe | 3,1 | 3,3 | −3,4 | 9,5 | 12,9 |
Die gemeinsamen Vergleiche innerhalb jedes Replikationsgewichts und plausiblen Werts berücksichtigen die gemeinsame Schwankung (Kovarianz), auch wenn sich Teilgruppen und Gesamtgruppe überlappen. Näherungsweise 95-%-Konfidenzintervalle für jeden Wert einzeln; mit null vereinbare Ergebnisse bleiben erhalten. Differenzskala, keine Subtraktion unabhängiger Konfidenzintervalle. Die Breiten werden vor der Rundung berechnet; die Differenz gerundeter Grenzen kann abweichen.
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Vergleich | Differenz (Prozentpunkte) | Standardfehler | Untere Grenze des 95-%-Konfidenzintervalls | Obere Grenze des 95-%-Konfidenzintervalls | Breite des Konfidenzintervalls |
|---|---|---|---|---|---|
| Nur außerhalb der Arbeit minus nur bei der Arbeit | −11,5 | 5,0 | −21,2 | −1,8 | 19,4 |
| Nur außerhalb der Arbeit minus Gesamtgruppe | −1,4 | 1,1 | −3,5 | 0,6 | 4,1 |
| Nur bei der Arbeit minus Gesamtgruppe | 10,0 | 4,1 | 1,9 | 18,1 | 16,2 |
| Beide Kontexte minus Gesamtgruppe | −2,0 | 2,2 | −6,3 | 2,3 | 8,7 |
Die gemeinsamen Vergleiche innerhalb jedes Replikationsgewichts und plausiblen Werts berücksichtigen die gemeinsame Schwankung (Kovarianz), auch wenn sich Teilgruppen und Gesamtgruppe überlappen. Näherungsweise 95-%-Konfidenzintervalle für jeden Wert einzeln; mit null vereinbare Ergebnisse bleiben erhalten. Differenzskala, keine Subtraktion unabhängiger Konfidenzintervalle. Die Breiten werden vor der Rundung berechnet; die Differenz gerundeter Grenzen kann abweichen.
Daten und Methode
So haben wir gerechnet
- Historische US-Haushaltsdatei von 2017 zur öffentlichen Nutzung; aktuell Erwerbstätige von 16 bis 65 Jahren mit zwei gültigen Angaben zur Häufigkeit des Bücherlesens und positivem vollständigem Gewicht.
- Gruppe B (Antworten) und Gruppe A (getestet, mit allen zehn plausiblen Werten) sind getrennt definiert; beide umfassen hier 2.395 Datensätze, ohne zusätzliche Ausfälle bei den Kompetenzdaten.
- Wöchentlich = Antworten 4–5; seltener als wöchentlich = Antworten 1–3. Lesen außerhalb der Arbeit umfasst Lern- und Studienzwecke; die Fragebogenführung zur aktuellen Tätigkeit wurde geprüft.
- Alle 45 aktiven JK2-Replikationsgewichte, Summe der quadrierten Abweichungen; zehn plausible Werte mit durchschnittlicher Varianz innerhalb der Werte plus 1,1-facher Stichprobenvarianz zwischen ihnen.
- Mittelwert und Anteil der plausiblen Werte unter 226 für alle vier Kategorien und die Gesamtgruppe der häufig Lesenden; feste Vergleiche (außerhalb der Arbeit gegen Arbeit sowie Teilgruppe gegen Gesamtgruppe) gemeinsam berechnet.
- 920 Mischungsgleichungen über Kennzahlen, plausible Werte und Replikationsgewichte geprüft; die feste Standardisierung mit 27 Gruppen verfehlt die Kriterien und entfällt vollständig.
- Studieneigene Regeln zu Fallzahl, Genauigkeit und Offenlegung angewandt; öffentliche Ergebnisse erst nach der Berechnung gerundet, keine Weitergabe einzelner Datensätze.
Was die Daten nicht aussagen
- Historische, ausgewählte Erwerbstätige, nicht alle Erwachsenen und nicht die heutigen Verhältnisse. Selbstberichtete Häufigkeiten; „seltener als wöchentlich“ heißt nicht „Nichtlesen“.
- „Alltag“ bedeutet weder ausschließlich Vergnügen noch zwingend zu Hause. Weder ein bestimmtes Buch oder Genre noch Textmenge oder Lesesprache sind erfasst.
- Die Kompetenz wird auf Englisch gemessen. Plausible Werte dienen der Schätzung für die Bevölkerung, nicht der Diagnose einzelner Personen.
- Unbereinigte Vergleiche können Alter, Bildung, berufliche Anforderungen, Auswahlprozesse, Spracherfahrungen und andere Erklärungen nicht trennen.
- Die Gesamtgruppe ist eine gültige gemeinsame Zielgruppe und keine Verzerrung durch Zusammenfassen. Zwei Kennzahlen sind keine vollständigen Verteilungen.
- Näherungsweise Konfidenzintervalle für jeden Wert einzeln, ohne Korrektur für Mehrfachvergleiche; mit null vereinbare Vergleiche belegen keine Gleichwertigkeit.
- Zehn Gruppen reichen für die Standardisierung nicht aus; es gibt keine bereinigten Ergebnisse, keine Zusammenlegung von Gruppen und keine Ersatzregression. Keine Empfehlung zu ursächlichen Wirkungen des Lesens.
Originalquellen
- NCES: PIAAC 2017 original ASCII public-use archive
Das Originalarchiv enthält die DAT-Datei und das SAS-Schema. Die Prüfsummen der Quelle und der Einträge wurden geprüft; die öffentliche Nachrechnung setzt voraus, dass Nutzende das zulässige Originalarchiv selbst bereitstellen. Es werden keine Einzeldatensätze weitergegeben.
Abgerufen am 30. Oktober 2026
- NCES: U.S. PIAAC 2012/2014/2017 technical report
Kapitel 8 und Anhang E erläutern 45 aktive JK2-Replikationsgewichte, Platzhaltergewichte, zehn plausible Werte und das Zusammenführen der Varianzen; die kontinuierliche Grenze für Stufe 1 liegt unter 226.
Abgerufen am 30. Oktober 2026
- NCES: 2017 household background questionnaire
Die Fragebogenführung für aktuell Erwerbstätige wählt die aktuelle Tätigkeit. „Alltag“ schließt Arbeit aus, umfasst bei Teilnehmenden an Bildung aber Lern- und Studienzwecke. Der Kontext ist weder ausschließlich Vergnügen noch ein physischer Ort.
Abgerufen am 30. Oktober 2026
- NCES PIAAC data usage agreement
Nur statistische Nutzung; keine Versuche der Identifizierung und keine Verknüpfung mit individuell identifizierbaren Datensätzen. Öffentlich bereitgestellte Ergebnisse enthalten geprüfte Zusammenfassungen, keine Einzeldatensätze.
Abgerufen am 30. Oktober 2026
- NCES: 2017 background compendium
Offizielle gewichtete Randverteilungen und Standardfehler dienen als getrennte Vergleichswerte für die Erwerbstätigkeit und beide Fragen zur Häufigkeit des Bücherlesens. Sie liefern nicht die neuen gemeinsamen Ergebnisse zu Kontext und Kompetenz.
Abgerufen am 30. Oktober 2026
- NCES: PIAAC data files
Die offizielle Liste der Quelldateien unterscheidet öffentlich zugängliche Haushaltsdateien für statistische Analysen von lizenzpflichtigen Dateien mit eingeschränktem Zugang.
Abgerufen am 30. Oktober 2026
- Reder, Gauly and Lechner (2020): Practice makes perfect
Frühere Längsschnittforschung kombiniert die Häufigkeit von Aufgaben bei und außerhalb der Arbeit. Diese historische, beschreibende Prüfung der Zusammenfassung widerlegt diese Entscheidung nicht und belegt keinen ursächlichen Übungseffekt.
Abgerufen am 30. Oktober 2026
- Tighe and colleagues (2024): Profiles of skills-use engagement
Eine frühere US-Studie zu Profilen bei niedriger Lesekompetenz kombiniert Indizes für Arbeit und Zuhause und bespricht Forschung zu einzelnen Kontexten und Aufgaben. Die Trennung der Kontexte wird nicht als neu entdeckte Forschungslücke behauptet.
Abgerufen am 30. Oktober 2026
- Kyröläinen and Kuperman (2021): Predictors of literacy in adulthood
Frühere internationale Forschung enthält getrennte Leseindizes für Arbeit und Zuhause. Diese Studie untersucht eine ausdrückliche Umkodierung einer Frage zu Büchern und nicht den erstmaligen Nachweis, dass sich Lesekontexte unterscheiden.
Abgerufen am 30. Oktober 2026
Studie zitieren und weiterverwenden
Alisson Bento. Was ein Durchschnitt wöchentlich Buchlesender ausblendet: Arbeit und Alltag. Sekundäranalyse der öffentlich nutzbaren US-Haushaltsmikrodaten NCES PIAAC 2017. Quellen abgerufen am 30. Oktober 2026. https://alissonbento.com/de/research/us-book-reading-context-coarsening-and-literacy-2017/
Quelle: National Center for Education Statistics, US-Haushaltsdatei PIAAC 2017 zur öffentlichen Nutzung. Es gelten die Bedingungen für statistische Nutzung und gegen Identifizierung. Eigene Auswahl, Berechnungen und Erläuterungen: Alisson Bento. Keine Billigung durch die NCES oder die OECD; es werden keine Behördenzeichen, Einzeldatensätze oder Abbildungen fremder Fachartikel reproduziert.
Korrekturen oder redaktionelle Fragen