
Una decisión real, con una respuesta deliberadamente acotada
El programa literario de educación infantil PNLD 2022 permite distinguir entre recibir una cantidad de colecciones y elegir cuántos títulos distintos contienen esas colecciones. Su manual oficial de registro muestra a una escuela que elige dos colecciones diferentes de un menú de veintitrés. Ese ejemplo define la decisión que se estudia aquí. No demuestra que todas las escuelas tengan la misma asignación, que cualquier combinación sea adecuada desde el punto de vista pedagógico ni que las colecciones elegidas se entregaran después. El análisis se limita al menú documentado y a la información disponible para comparar dos opciones distintas.
En los 253 pares sin orden de la guía consultada, la variedad conjunta va de 95 a 110 códigos distintos del programa, con una mediana de 100. No son recuentos de obras literarias canónicas, de niños atendidos ni de libros leídos. Tampoco toda esa diferencia de quince códigos se debe a repeticiones: las propias colecciones tienen un número distinto de entradas. Por eso es esencial separar el tamaño de la colección de los códigos que se repiten. Describir cada diferencia como una repetición innecesaria falsearía la aritmética y también la finalidad educativa de tener varios ejemplares.
La pregunta práctica es igual de modesta. Una vez elegida la primera colección por razones educativas, ¿cuánto puede variar el número de códigos que añade cada una de las otras veintidós? La respuesta da un dato más para decidir, sin sustituir con aritmética el criterio profesional. Un incremento numérico menor puede acompañar a historias, lenguaje, ilustraciones u oportunidades de trabajo en el aula más adecuados. Las tablas recogen todas las comparaciones a partir de cada primera colección, en lugar de escoger unas pocas combinaciones especialmente llamativas. Nada de lo que sigue recomienda maximizar el recuento a costa de una selección coherente desde el punto de vista educativo.
Qué identifica la fuente y qué no
La fuente es la guía literaria oficial completa del PNLD 2022 Educação Infantil, obtenida del repositorio de publicaciones de la UFAL. Sus tablas de colecciones indican la editorial, el título de cada entrada con su código del programa y un código de género. Los veintitrés menús se clasifican como mixtos, de guardería o de preescolar. Este estudio conserva cada código impreso como texto exacto, con los ceros iniciales y el sufijo completo. No descifra la estructura del código ni une entradas con códigos distintos porque sus títulos se parezcan. La unidad de análisis es el título bibliográfico que el programa incluye en su lista, no una obra literaria identificada de forma independiente.
Esta distinción importa en los dos sentidos. Códigos distintos podrían corresponder a ediciones, formatos o variantes del programa de una misma obra. Y títulos idénticos pueden corresponder a obras distintas. Esta auditoría no resuelve ninguna de las dos posibilidades adivinando a partir de las palabras. En las apariciones de un mismo código exacto se comprobó que el título, la editorial y el género impresos fueran coherentes; en las tablas extraídas no se encontró ningún conflicto. Esa comprobación justifica unir un mismo identificador entre colecciones, pero no lo convierte en una definición general de qué es una misma obra literaria fuera de esta fuente.
Las tablas consultadas contienen colecciones de 49 a 55 entradas con código. El manual oficial indica el mismo rango, mientras que el aviso de elección del FNDE que se conservó habla de 53 a 55 obras. Se mantienen las dos afirmaciones, sin armonizarlas en silencio. El archivo de la guía indica que se generó en julio de 2025, pero eso no prueba que el catálogo se revisara oficialmente: un manual creado en octubre de 2023 ya da el rango más amplio. Los resultados identifican la versión exacta consultada y su huella digital. No deben presentarse como una reconstrucción comprobada de todos los detalles que se mostraban en la fecha original de la elección.
Separar entradas totales, códigos distintos y repeticiones
Para dos colecciones, A es el total de entradas listadas, que resulta de sumar el tamaño de cada una. B es el número de códigos distintos que hay entre las dos. La diferencia D = A − B es el número de entradas repetidas en el par. Como ninguna colección repite un código por dentro, D coincide con el número de códigos que las dos colecciones tienen en común. Es una contabilidad de conjuntos sencilla, pero evita un atajo de interpretación frecuente: dos colecciones no son dos libros sueltos, y tampoco aportan necesariamente tantos identificadores distintos como entradas suman.
La proporción de entradas repetidas usa A como denominador. Si un código aparece una vez en cada una de las dos colecciones elegidas, suma dos entradas a A, un código a B y una entrada repetida a D. Esta proporción mide cuánto supera el total de entradas a la variedad de códigos distintos. No significa que el ejemplar físico repetido no sirva para nada. Los ejemplares repetidos pueden permitir lecturas simultáneas, espacios separados, relecturas o reposiciones, y los listados del menú no miden nada de eso. Llamar a D «desperdicio», «pérdida de aprendizaje» o «privación» sería añadir un juicio de valor sin base a una cantidad puramente contable.
Entre todos los pares posibles, la proporción de entradas repetidas va de cero a una de cada trece, aproximadamente el 7,7 %, con una mediana de una de cada treinta y cinco, aproximadamente el 2,9 %. Con esta definición, la repetición es pequeña, y no prueba que el programa reparta sobre todo el mismo material. El rango de variedad conjunta debe leerse también junto a la diferencia de tamaño de las colecciones de partida, de 49 a 55 entradas. Más entradas pueden aumentar la variedad, y los códigos compartidos reducen el incremento respecto del total de entradas. La relación entre A, B y D informa más que presentar el máximo y el mínimo de variedad como un efecto exclusivo de la repetición.
Enumerar todo el menú de dos colecciones
Hay veintitrés opciones para una colección y veintidós opciones distintas para la otra. Su producto, dividido entre dos, da 253 pares sin orden, porque elegir A con B da el mismo conjunto de códigos que elegir B con A. Cada par aparece una sola vez en la tabla de pares, con los empates incluidos. Esta enumeración completa no es una muestra de decisiones de escuelas. No necesita un intervalo de confianza por error de muestreo, y su mediana no estima lo que eligió o recibió la escuela típica.
La mediana de 100 códigos distintos es el resultado del par central cuando se ordenan los 253 valores. El mínimo de 95 y el máximo de 110 acotan la comparación matemática documentada. No garantizan nada sobre lo que cada escuela puede o desea elegir. El ejemplo de dos selecciones del manual da el caso práctico, y las categorías de las colecciones siguen siendo un contexto importante. Este análisis no establece que toda combinación sirva para cualquier edad o proyecto educativo. El menú común permite comparar información; no sustituye las instrucciones del programa ni recomienda a los docentes que ignoren la idoneidad pedagógica.
Tratar todos los pares de la misma forma, de manera descriptiva, es útil porque evita escoger combinaciones después de ver sus resultados. No hay que confundirlo con un modelo de comportamiento en el que las escuelas eligen al azar con la misma probabilidad. Algunas combinaciones pueden ser mucho más atractivas o adecuadas que otras, pero la fuente no da ningún dato sobre las preferencias reales. Tampoco hay una evolución en el tiempo: todos los resultados salen de un único menú consultado. La descarga con todos los pares permite revisar la contabilidad sin fingir que estas alternativas sean observaciones independientes de adopción, entrega o lectura reales.
Por qué importa qué colección se elige primero
Un mismo par sin orden admite dos puntos de partida. Si ya se ha elegido una colección, la ganancia de la otra es el número de sus códigos que no están en la primera. Esa ganancia es igual al tamaño de la segunda colección candidata menos los códigos que comparte con la elegida. Si se invierte el punto de partida, la ganancia puede cambiar, aunque la variedad conjunta sea la misma. Al conservar las dos direcciones resultan 506 comparaciones con orden. Son dos miradas a los mismos 253 pares; no son otro conjunto de datos ni una confirmación independiente de los resultados.
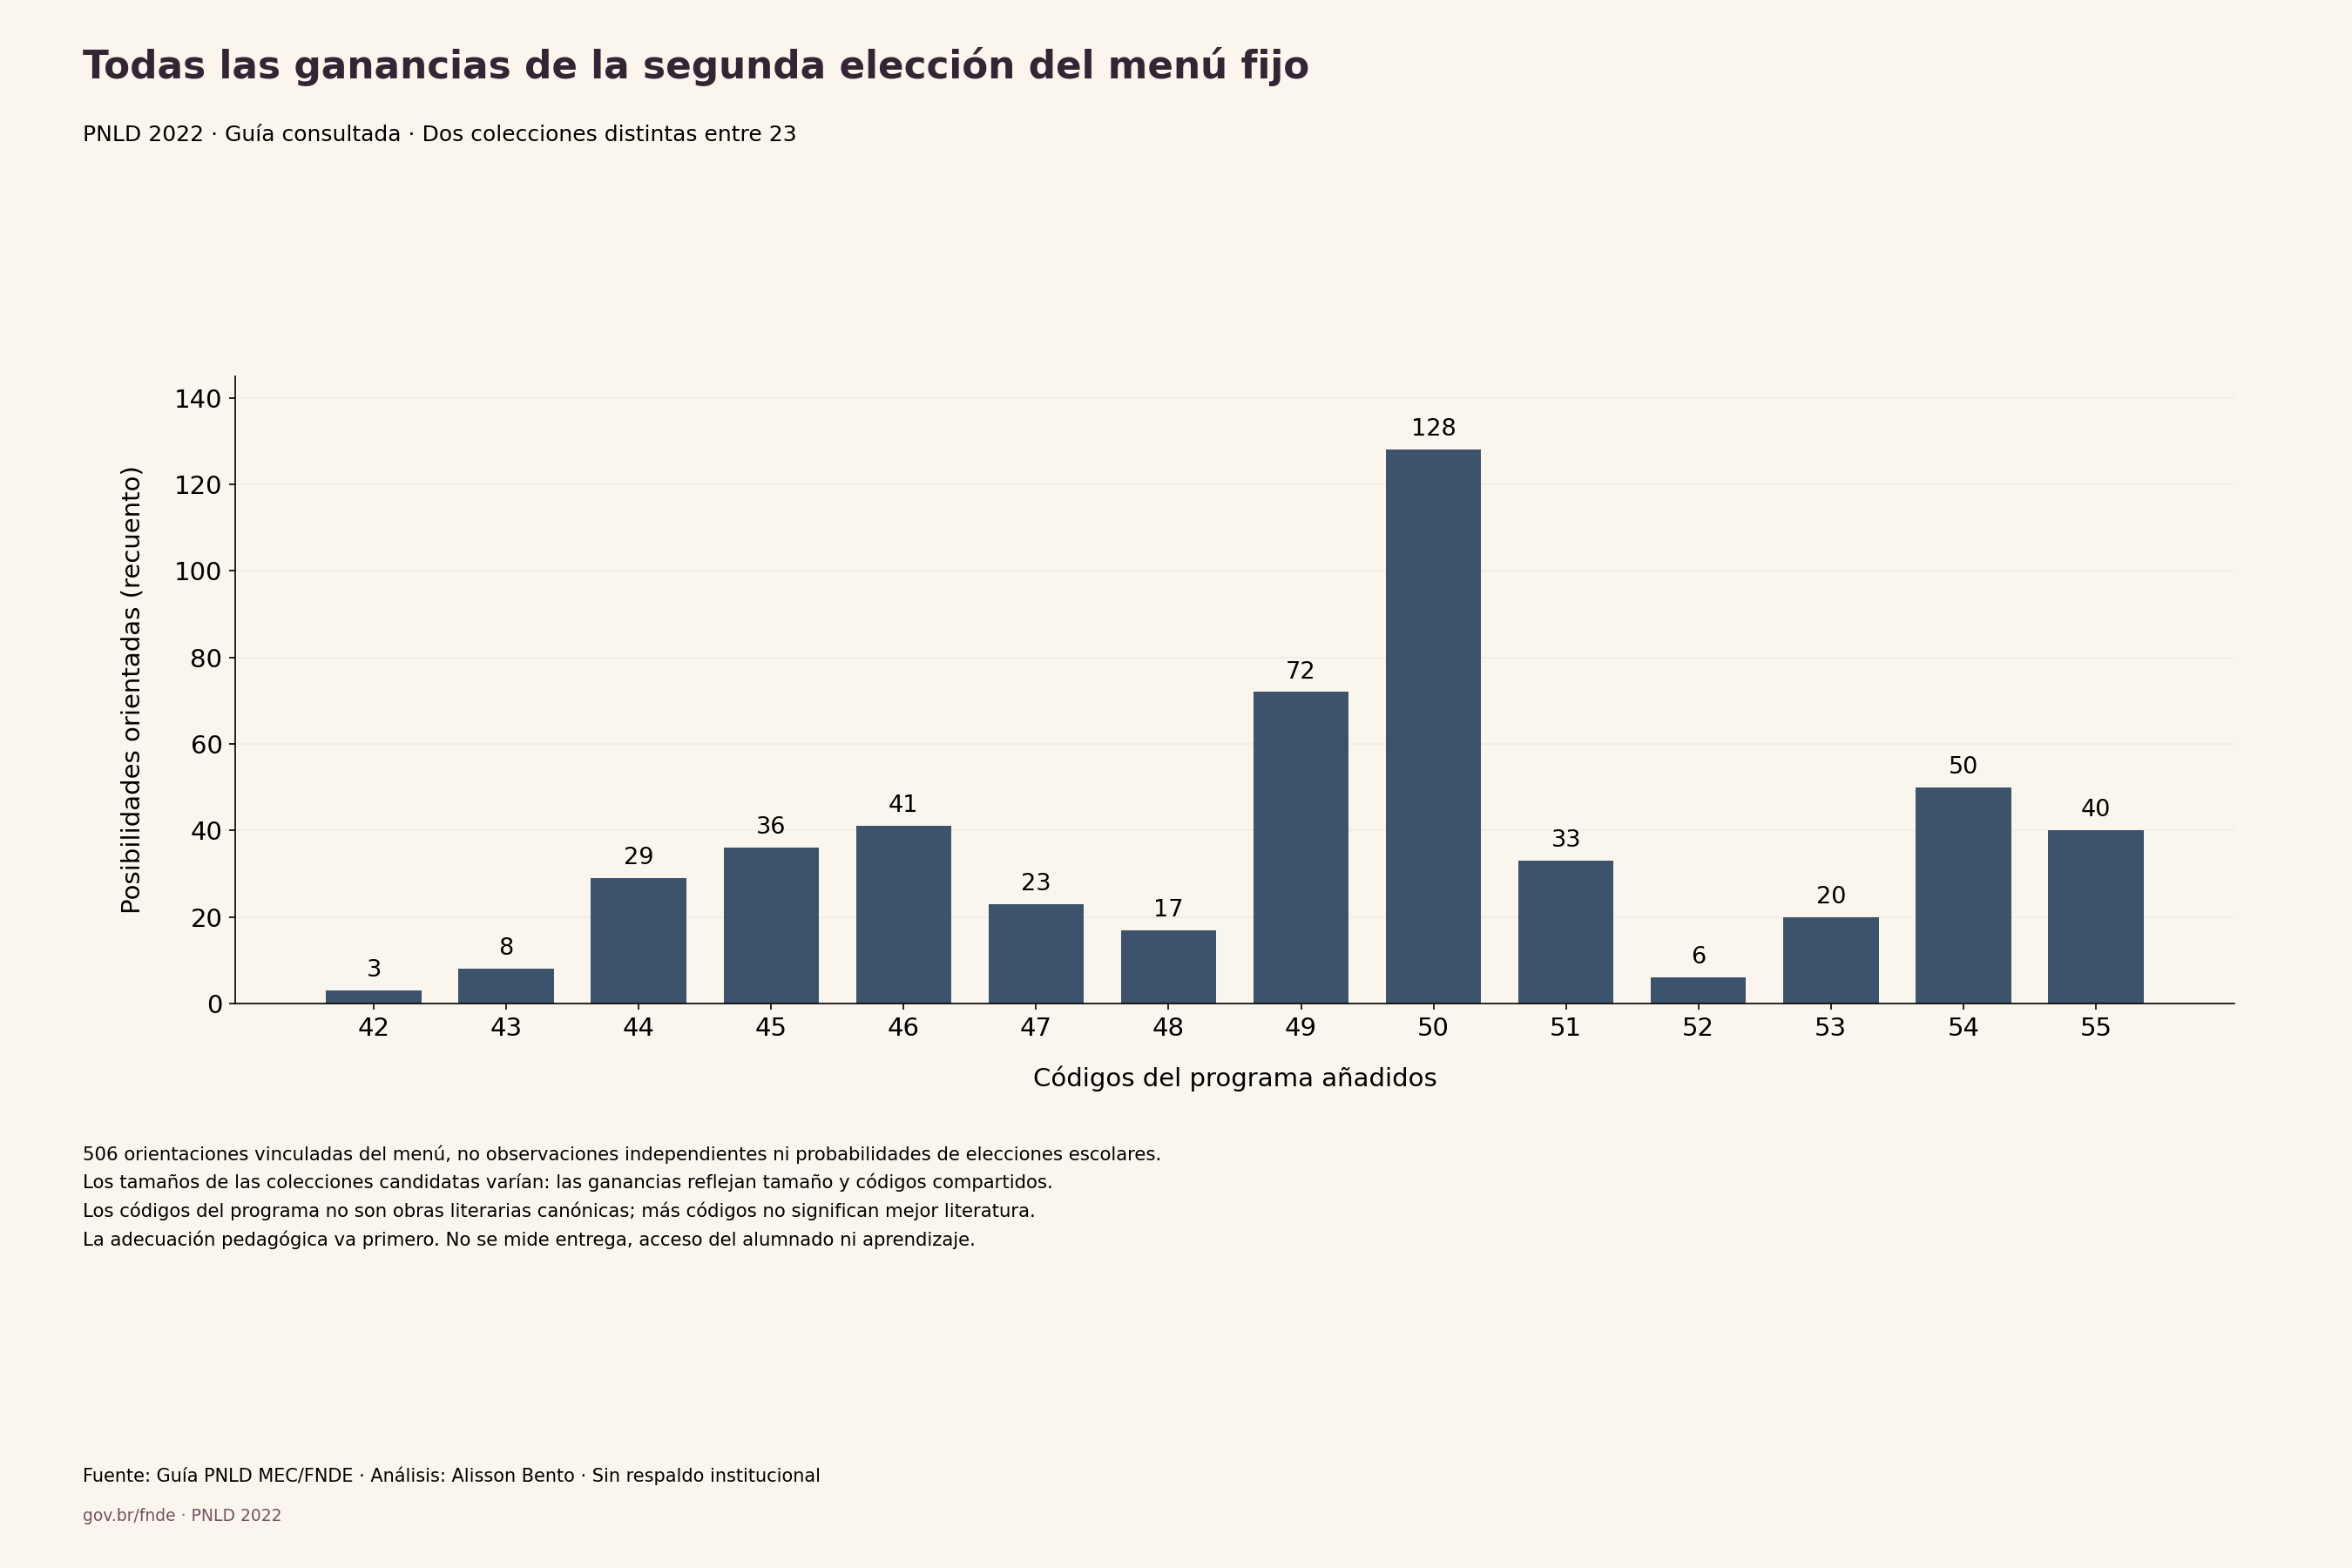
En las 506 comparaciones, la segunda elección añade entre 42 y 55 códigos del programa, con una mediana de 50. La distribución completa de números enteros se presenta sin suavizar y sin agrupar en tramos escogidos según los resultados. Para cada primera colección posible, la tabla condicional conserva además las veintidós alternativas restantes, con sus frecuencias exactas y con el mínimo, la mediana y el máximo. Estas distribuciones son especialmente útiles cuando la primera decisión ya está justificada por razones educativas. Muestran cuánto varía la cantidad de códigos disponibles sin pedir que esa decisión se cambie por la colección que dé el total más alto.
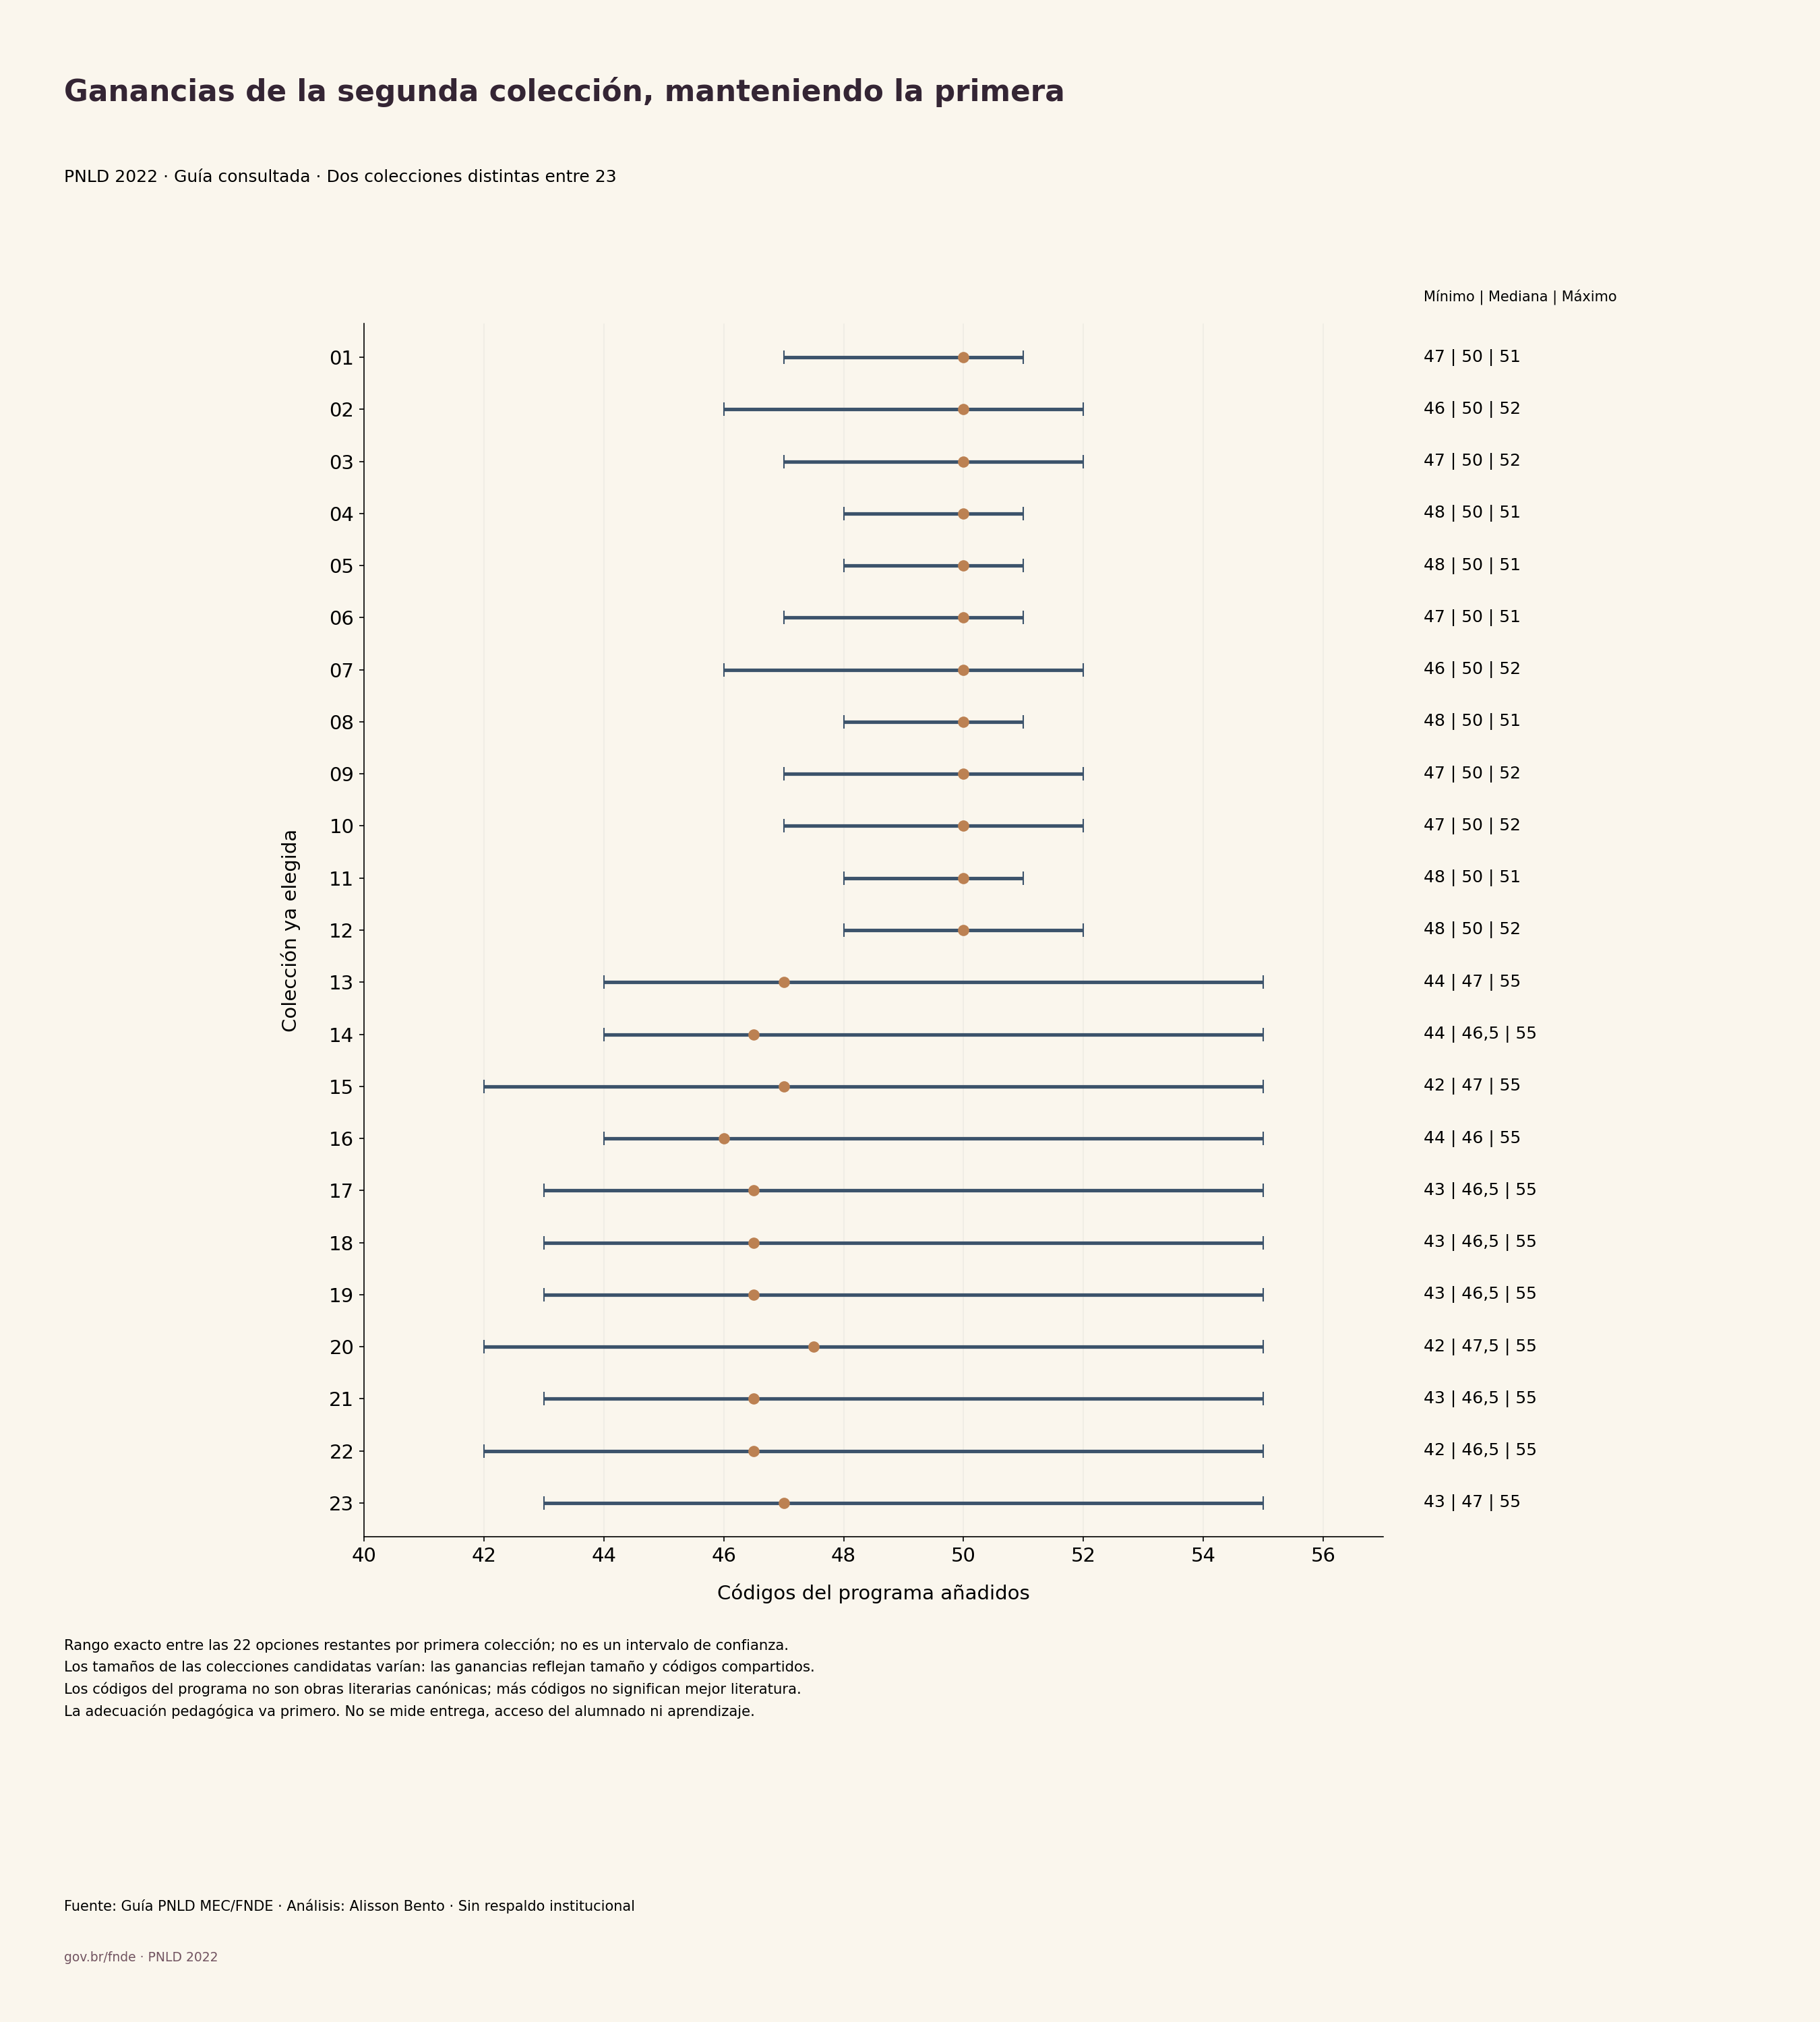
Los rangos condicionales no son todos iguales. Por ejemplo, la colección 05 tiene 50 códigos de partida y sus alternativas añaden de 48 a 51, con una mediana de 50. La colección 15 tiene 54 códigos de partida y sus alternativas añaden de 42 a 55, con una mediana de 47. Los dos ejemplos forman parte de la tabla completa de veintitrés filas y no son clasificaciones de calidad. Incluso con la primera colección fijada, las candidatas se distinguen por su propio tamaño y también por los códigos que comparten. Por eso, un rango de ganancias más amplio no puede atribuirse solo al solapamiento, y una ganancia menor no demuestra que una alternativa sea peor.
Poner la idoneidad pedagógica por delante del recuento
La fuente clasifica las colecciones como mixtas, de guardería o de preescolar. Esas etiquetas describen contextos educativos previstos, no valores que este estudio convierta en puntuaciones. El análisis no compara una colección mixta con una de preescolar ni supone que las categorías sean intercambiables para todas las escuelas. La comparación principal usa el caso documentado de dos colecciones distintas. No se analizan las asignaciones mayores que se mencionan en otras partes de la guía. Extender el cálculo a tres, seis o doce colecciones exigiría un modelo de decisión justificado por separado, en lugar de suponer que un ejemplo de la pantalla de elección fija todas las reglas de asignación posibles.
Un uso sensato de la tabla condicional empieza por las alternativas adecuadas desde el punto de vista educativo, y no por el máximo de su última columna. Los recuentos de códigos sirven después para explicar en qué se diferencian esas alternativas en un solo aspecto: el número de identificadores listados que añaden. La idoneidad puede depender de los niños concretos, de las actividades previstas, de las necesidades de accesibilidad, del idioma, del diseño del material o de los fondos que ya existan. Aquí no se mide ninguno de esos factores. El análisis aporta información junto al criterio profesional. No afirma que un recuento exacto de códigos recoja los beneficios de una colección ni toda la variedad de experiencias de lectura que puede ofrecer.
Los fondos que ya tiene la escuela son otro límite importante. Una segunda colección del programa puede añadir códigos respecto de la primera elegida y, a la vez, añadir pocos títulos nuevos al conjunto de la biblioteca de la escuela. La pregunta inversa, cuántos códigos no tiene ya una escuela, exige un inventario comprobado e identificadores compatibles. A estas tablas no se ha unido ningún inventario así. Del mismo modo, el acceso a una biblioteca compartida o a libros comprados fuera del programa puede cambiar las oportunidades de un niño sin alterar ningún resultado de esta auditoría. La variedad del menú del programa es un objeto de medición concreto, no una descripción completa del acceso a la literatura.
En qué se diferencia de los estudios de cobertura temática
Ya hay investigaciones sobre la representación y la cobertura dentro de estas colecciones. El trabajo de Mirian Daniela Faustino Faria trata los temas indígenas y su presencia en las colecciones. Un material oficial indexado identifica una correspondencia de ocho obras entre colecciones. La tesis completa no estaba disponible para consultarla, así que no se afirma haber descartado como antecedente todo lo que contiene. Su preocupación central, de todos modos, es importante: la composición de una colección puede importar más allá de la cantidad total de libros. Este artículo no pretende descubrir esa cuestión por primera vez.
El estudio de Manfré y Rozzi, de 2026, examina obras narrativas seleccionadas de las colecciones de preescolar en relación con la formación humana y cultural de los niños. Esa investigación cualitativa plantea preguntas que un recuento exacto de códigos no puede responder. Una bibliografía con más identificadores no es necesariamente más rica en una perspectiva cultural concreta, ni más apropiada para un grupo, ni mejor como literatura. Cambiar el tema en un análisis de cobertura ya existente sería, además, una tarea distinta del cálculo que se presenta aquí. La aportación de este trabajo es la contabilidad de todos los pares del menú y la información sobre la segunda elección condicionada a la primera. No es una nueva valoración del mérito temático o literario.
Los dos enfoques pueden complementarse sin ser intercambiables. Un estudio temático puede señalar obras de especial importancia educativa. Esta tabla puede describir cómo cambia el conjunto de códigos listados cuando se combinan dos colecciones. No da significado temático a los demás códigos ni deduce la cobertura a partir de las editoriales o de las palabras de los títulos. Mantener esta separación hace útil el resultado y evita exagerar su novedad.
Una auditoría de la fuente que se puede comprobar
La sección de tablas de colecciones ocupa las páginas 59–120 del PDF. Se revisaron los veintitrés encabezados y todas las páginas de continuación, y dos métodos de extracción independientes llegaron al mismo resultado en las 1.192 apariciones listadas. La comparación incluyó la colección, la categoría, el código del programa, el título, la editorial, el género y la página de origen. Cada código se trató como texto durante todo el proceso. Se comprobaron de forma expresa las repeticiones dentro de una misma colección y las discrepancias en los datos descriptivos de los códigos repetidos, en lugar de resolverlas eliminando filas o uniendo títulos parecidos. En la extracción auditada que se usó para los cálculos no quedó ningún conflicto de ese tipo.
El archivo público de pertenencia contiene a propósito solo el número de colección, el código del programa y la página de origen. Las celdas de las editoriales de la guía pueden incluir identificadores que no hacen falta para reproducir esta pregunta, y la guía contiene además reseñas e ilustraciones protegidas que no se necesitan para el cálculo. Esos materiales no se redistribuyen aquí. Un manifiesto de la fuente identifica los archivos concretos de la guía y del manual por su dirección, su tamaño en bytes y su huella digital, de modo que cualquiera puede comprobar la fuente por su cuenta. El archivo reducido basta para reproducir las uniones y las diferencias de conjuntos sin reproducir el contenido creativo de la guía.
El programa de cálculo enumera los pares y las direcciones fijados, conserva todos los empates y publica las tablas completas de frecuencias condicionales. Las proporciones y las medianas se calculan con aritmética exacta con fracciones antes de redondear para mostrarlas. Una implementación independiente, que partió de otra extracción y no usó las funciones del cálculo original, reprodujo todos los valores numéricos publicados. Esto protege frente a errores de transcripción y de programación, pero no elimina las limitaciones de las propias definiciones de la fuente ni de su cobertura histórica. Los archivos descargables dejan ver esas diferencias, en lugar de presentar la reproducibilidad como si el menú midiera todo lo que a un lector le pueda interesar.
Por qué no son estadísticas de entregas ni de alumnado
Una etiqueta de programa y un menú de selección no son registros de envíos. Este estudio no une a la guía identificadores de escuelas, fechas de entrega, cantidades recibidas ni datos de matrícula. Por eso no puede mostrar qué escuelas obtuvieron una colección, si los envíos llegaron completos, cómo se registraron las entregas repetidas ni cuántos ejemplares había por niño. Que falte un registro de envío no probaría por sí solo que no hubo acceso, y un título del programa en una tabla de logística no identificaría necesariamente un libro concreto. Esas preguntas exigen otras definiciones y otros cruces de datos que aquí no se hacen.
Esta distinción también evita una lectura equivocada del año que aparece en el título. PNLD 2022 identifica el programa al que corresponden la guía y el manual. No es un censo comprobado de entregas ni de lecturas de ese año natural. La versión de la fuente se consultó en octubre de 2026. La fecha de generación del archivo, los datos de creación del manual y las fechas del aviso son datos de procedencia, no períodos de observación intercambiables. Sin una cadena documentada de versiones históricas, las diferencias entre los rangos publicados deben seguir siendo discrepancias. No deben convertirse en un relato inventado sobre retiradas, incorporaciones o cambios en lo que las escuelas recibieron de verdad.
La aritmética de esta versión, enumerada por completo, no tiene un intervalo de incertidumbre estadística. Pero sí hay mucha incertidumbre sobre las cuestiones que quedan fuera de ella. La identidad exacta de los códigos, la estabilidad histórica del catálogo, la idoneidad por edades, los fondos que ya tienen las escuelas y el uso real marcan, cada uno, un límite distinto. Un intervalo de confianza no resolvería esos problemas de definición. Lo adecuado es decir con precisión qué se mide y no afirmar nada sobre lo que no se ha medido. Por eso los resultados se refieren a un menú de elección documentado, y no a la igualdad de oportunidades educativas, a la eficacia del programa ni a cambios en la lectura de los niños.
Usar la contabilidad como una capa más de información para decidir
Quien compare dos colecciones adecuadas puede seguir una secuencia sencilla: identificar la colección de partida, tener en cuenta las alternativas pertinentes y distinguir las entradas añadidas en total de los códigos que ya estaban representados. La tabla condicional da el rango y las frecuencias exactas de las veintidós alternativas del menú publicado. El archivo de pares da el recuento conjunto correspondiente y la proporción de entradas repetidas. Estos archivos sirven para revisar la aritmética, no para fijar una regla automática de selección. Las razones educativas para elegir un título concreto quedan fuera del cálculo y no deberían quedar anuladas por un máximo numérico.
El resultado central es, por tanto, equilibrado. Elegir dos colecciones distintas puede dar una variedad de códigos exactos diferente, y la ganancia depende de la colección de partida, del tamaño de la candidata y de lo que se solape. Al mismo tiempo, la repetición medida es pequeña y puede cumplir fines legítimos que el menú no permite evaluar. Dar los dos datos evita convertir una pequeña diferencia contable en una acusación de desperdicio, y evita también la suposición contraria de que todos los pares ofrecen necesariamente la misma lista de títulos. La cantidad de entradas y la variedad de códigos responden a preguntas relacionadas, pero distintas.
La enumeración completa permite examinar esas diferencias en una decisión documentada, de una guía concreta del programa. No dice cuál es la mejor literatura, no establece resultados de las escuelas ni resuelve la pregunta más amplia de quién tiene acceso a los libros. Su valor está en que hace exacta una comparación limitada: se mantienen separados el número de colecciones, el de entradas, el de códigos distintos y el de códigos añadidos, y siguen a la vista las incertidumbres de la fuente. Junto con las descripciones educativas de la guía y las necesidades reales de cada escuela, esa distinción puede ayudar a entender mejor la información disponible, sin pretender sustituir el resto de la decisión.
Ganancias de la segunda colección, manteniendo la primera
PNLD 2022 · Guía consultada · Dos colecciones distintas entre 23
Gráfico completo y fuente

Desplaza el gráfico horizontalmente para examinarlo. ↔
Gráfico y valores
Desplaza la tabla horizontalmente para ver todas las columnas.
| Primera colección | Categoría | Códigos de la primera colección | Alternativas | Mínimo añadido | Mediana añadida | Máximo añadido | Códigos añadidos: número de opciones |
|---|---|---|---|---|---|---|---|
| 01 | Mixta | 50 | 22 | 47 | 50,0 | 51 | 47: 2; 49: 7; 50: 8; 51: 5 |
| 02 | Mixta | 49 | 22 | 46 | 50,0 | 52 | 46: 1; 48: 1; 49: 5; 50: 11; 51: 3; 52: 1 |
| 03 | Mixta | 50 | 22 | 47 | 50,0 | 52 | 47: 1; 48: 1; 49: 7; 50: 10; 51: 2; 52: 1 |
| 04 | Mixta | 49 | 22 | 48 | 50,0 | 51 | 48: 1; 49: 6; 50: 13; 51: 2 |
| 05 | Mixta | 50 | 22 | 48 | 50,0 | 51 | 48: 1; 49: 8; 50: 11; 51: 2 |
| 06 | Mixta | 50 | 22 | 47 | 50,0 | 51 | 47: 1; 48: 1; 49: 5; 50: 13; 51: 2 |
| 07 | Mixta | 50 | 22 | 46 | 50,0 | 52 | 46: 1; 47: 1; 48: 1; 49: 6; 50: 7; 51: 5; 52: 1 |
| 08 | Mixta | 50 | 22 | 48 | 50,0 | 51 | 48: 1; 49: 8; 50: 11; 51: 2 |
| 09 | Mixta | 50 | 22 | 47 | 50,0 | 52 | 47: 1; 48: 2; 49: 4; 50: 13; 51: 1; 52: 1 |
| 10 | Mixta | 49 | 22 | 47 | 50,0 | 52 | 47: 1; 48: 2; 49: 4; 50: 11; 51: 3; 52: 1 |
| 11 | Mixta | 50 | 22 | 48 | 50,0 | 51 | 48: 2; 49: 7; 50: 10; 51: 3 |
| 12 | Mixta | 49 | 22 | 48 | 50,0 | 52 | 48: 3; 49: 5; 50: 10; 51: 3; 52: 1 |
| 13 | Guardería | 53 | 22 | 44 | 47,0 | 55 | 44: 5; 45: 2; 46: 2; 47: 3; 53: 1; 54: 5; 55: 4 |
| 14 | Guardería | 55 | 22 | 44 | 46,5 | 55 | 44: 4; 45: 4; 46: 3; 47: 1; 53: 2; 54: 5; 55: 3 |
| 15 | Guardería | 54 | 22 | 42 | 47,0 | 55 | 42: 1; 44: 4; 45: 2; 46: 1; 47: 4; 53: 2; 54: 4; 55: 4 |
| 16 | Guardería | 55 | 22 | 44 | 46,0 | 55 | 44: 4; 45: 3; 46: 5; 53: 2; 54: 5; 55: 3 |
| 17 | Guardería | 54 | 22 | 43 | 46,5 | 55 | 43: 1; 44: 2; 45: 4; 46: 4; 47: 1; 53: 2; 54: 4; 55: 4 |
| 18 | Guardería | 55 | 22 | 43 | 46,5 | 55 | 43: 1; 44: 2; 45: 5; 46: 3; 47: 1; 53: 2; 54: 5; 55: 3 |
| 19 | Preescolar | 54 | 22 | 43 | 46,5 | 55 | 43: 1; 44: 3; 45: 2; 46: 5; 47: 1; 53: 2; 54: 4; 55: 4 |
| 20 | Preescolar | 53 | 22 | 42 | 47,5 | 55 | 42: 1; 44: 3; 45: 2; 46: 4; 47: 1; 48: 1; 53: 1; 54: 5; 55: 4 |
| 21 | Preescolar | 55 | 22 | 43 | 46,5 | 55 | 43: 2; 44: 1; 45: 4; 46: 4; 47: 1; 53: 2; 54: 5; 55: 3 |
| 22 | Preescolar | 54 | 22 | 42 | 46,5 | 55 | 42: 1; 43: 1; 45: 4; 46: 5; 47: 1; 53: 2; 54: 4; 55: 4 |
| 23 | Preescolar | 54 | 22 | 43 | 47,0 | 55 | 43: 2; 44: 1; 45: 4; 46: 3; 47: 2; 53: 2; 54: 4; 55: 4 |
Cada fila fija la primera colección y conserva las 22 alternativas distintas. La última columna se lee «códigos añadidos: número de colecciones candidatas que añaden esa cantidad». La categoría es un dato de contexto de la fuente, no una clasificación ni una regla de idoneidad general. Varían el tamaño de las candidatas y también el solapamiento.
Todas las ganancias de la segunda elección del menú fijo
PNLD 2022 · Guía consultada · Dos colecciones distintas entre 23
Gráfico completo y fuente

Desplaza el gráfico horizontalmente para examinarlo. ↔
Gráfico y valores
Desplaza la tabla horizontalmente para ver todas las columnas.
| Códigos del programa añadidos | Posibilidades con orden |
|---|---|
| 42 | 3 |
| 43 | 8 |
| 44 | 29 |
| 45 | 36 |
| 46 | 41 |
| 47 | 23 |
| 48 | 17 |
| 49 | 72 |
| 50 | 128 |
| 51 | 33 |
| 52 | 6 |
| 53 | 20 |
| 54 | 50 |
| 55 | 40 |
Las 506 elecciones con orden (de la primera a la segunda colección), un registro por cada orden, sin suavizar ni agrupar en tramos. Son frecuencias dentro del menú, no probabilidades de las decisiones reales de las escuelas.
Datos y descargas
Desplaza la tabla horizontalmente para ver todas las columnas.
| Medida | Posibilidades | Mínimo | Mediana | Máximo |
|---|---|---|---|---|
| Códigos distintos del programa en un par | 253 | 95 | 100 | 110 |
| Entradas repetidas, como proporción de A (%) | 253 | 0,0 | 2,9 | 7,7 |
| Códigos añadidos por la segunda colección | 506 | 42 | 50 | 55 |
Menú finito y exacto, no probabilidades de elección de las escuelas. Las proporciones usan el total de entradas A de cada par; los porcentajes se redondean a un decimal. El rango de variedad combina tamaños de colección distintos y códigos repetidos.
Desplaza la tabla horizontalmente para ver todas las columnas.
| Primera colección | Categoría | Códigos de la primera colección | Alternativas | Mínimo añadido | Mediana añadida | Máximo añadido | Códigos añadidos: número de opciones |
|---|---|---|---|---|---|---|---|
| 01 | Mixta | 50 | 22 | 47 | 50,0 | 51 | 47: 2; 49: 7; 50: 8; 51: 5 |
| 02 | Mixta | 49 | 22 | 46 | 50,0 | 52 | 46: 1; 48: 1; 49: 5; 50: 11; 51: 3; 52: 1 |
| 03 | Mixta | 50 | 22 | 47 | 50,0 | 52 | 47: 1; 48: 1; 49: 7; 50: 10; 51: 2; 52: 1 |
| 04 | Mixta | 49 | 22 | 48 | 50,0 | 51 | 48: 1; 49: 6; 50: 13; 51: 2 |
| 05 | Mixta | 50 | 22 | 48 | 50,0 | 51 | 48: 1; 49: 8; 50: 11; 51: 2 |
| 06 | Mixta | 50 | 22 | 47 | 50,0 | 51 | 47: 1; 48: 1; 49: 5; 50: 13; 51: 2 |
| 07 | Mixta | 50 | 22 | 46 | 50,0 | 52 | 46: 1; 47: 1; 48: 1; 49: 6; 50: 7; 51: 5; 52: 1 |
| 08 | Mixta | 50 | 22 | 48 | 50,0 | 51 | 48: 1; 49: 8; 50: 11; 51: 2 |
| 09 | Mixta | 50 | 22 | 47 | 50,0 | 52 | 47: 1; 48: 2; 49: 4; 50: 13; 51: 1; 52: 1 |
| 10 | Mixta | 49 | 22 | 47 | 50,0 | 52 | 47: 1; 48: 2; 49: 4; 50: 11; 51: 3; 52: 1 |
| 11 | Mixta | 50 | 22 | 48 | 50,0 | 51 | 48: 2; 49: 7; 50: 10; 51: 3 |
| 12 | Mixta | 49 | 22 | 48 | 50,0 | 52 | 48: 3; 49: 5; 50: 10; 51: 3; 52: 1 |
| 13 | Guardería | 53 | 22 | 44 | 47,0 | 55 | 44: 5; 45: 2; 46: 2; 47: 3; 53: 1; 54: 5; 55: 4 |
| 14 | Guardería | 55 | 22 | 44 | 46,5 | 55 | 44: 4; 45: 4; 46: 3; 47: 1; 53: 2; 54: 5; 55: 3 |
| 15 | Guardería | 54 | 22 | 42 | 47,0 | 55 | 42: 1; 44: 4; 45: 2; 46: 1; 47: 4; 53: 2; 54: 4; 55: 4 |
| 16 | Guardería | 55 | 22 | 44 | 46,0 | 55 | 44: 4; 45: 3; 46: 5; 53: 2; 54: 5; 55: 3 |
| 17 | Guardería | 54 | 22 | 43 | 46,5 | 55 | 43: 1; 44: 2; 45: 4; 46: 4; 47: 1; 53: 2; 54: 4; 55: 4 |
| 18 | Guardería | 55 | 22 | 43 | 46,5 | 55 | 43: 1; 44: 2; 45: 5; 46: 3; 47: 1; 53: 2; 54: 5; 55: 3 |
| 19 | Preescolar | 54 | 22 | 43 | 46,5 | 55 | 43: 1; 44: 3; 45: 2; 46: 5; 47: 1; 53: 2; 54: 4; 55: 4 |
| 20 | Preescolar | 53 | 22 | 42 | 47,5 | 55 | 42: 1; 44: 3; 45: 2; 46: 4; 47: 1; 48: 1; 53: 1; 54: 5; 55: 4 |
| 21 | Preescolar | 55 | 22 | 43 | 46,5 | 55 | 43: 2; 44: 1; 45: 4; 46: 4; 47: 1; 53: 2; 54: 5; 55: 3 |
| 22 | Preescolar | 54 | 22 | 42 | 46,5 | 55 | 42: 1; 43: 1; 45: 4; 46: 5; 47: 1; 53: 2; 54: 4; 55: 4 |
| 23 | Preescolar | 54 | 22 | 43 | 47,0 | 55 | 43: 2; 44: 1; 45: 4; 46: 3; 47: 2; 53: 2; 54: 4; 55: 4 |
Cada fila fija la primera colección y conserva las 22 alternativas distintas. La última columna se lee «códigos añadidos: número de colecciones candidatas que añaden esa cantidad». La categoría es un dato de contexto de la fuente, no una clasificación ni una regla de idoneidad general. Varían el tamaño de las candidatas y también el solapamiento.
Desplaza la tabla horizontalmente para ver todas las columnas.
| Códigos del programa añadidos | Posibilidades con orden |
|---|---|
| 42 | 3 |
| 43 | 8 |
| 44 | 29 |
| 45 | 36 |
| 46 | 41 |
| 47 | 23 |
| 48 | 17 |
| 49 | 72 |
| 50 | 128 |
| 51 | 33 |
| 52 | 6 |
| 53 | 20 |
| 54 | 50 |
| 55 | 40 |
Las 506 elecciones con orden (de la primera a la segunda colección), un registro por cada orden, sin suavizar ni agrupar en tramos. Son frecuencias dentro del menú, no probabilidades de las decisiones reales de las escuelas.
Desplaza la tabla horizontalmente para ver todas las columnas.
| Concepto | Alcance auditado |
|---|---|
| Colecciones | 23 |
| Páginas con tablas de la fuente | 62 (PDF 59–120) |
| Apariciones de códigos listadas | 1.192 |
| Campos de la fuente comparados por aparición | 7 |
| Pares sin orden de colecciones distintas | 253 |
| Segundas elecciones con orden | 506 |
| Alternativas para cada primera colección | 22 |
| Códigos repetidos dentro de una misma colección | 0 |
| Discrepancias en los datos descriptivos de códigos repetidos | 0 |
Lo que se mide es la versión consultada de la guía, no los libros entregados ni las matrículas. El número de páginas y de apariciones describe qué parte de la fuente se extrajo, no aprendizaje ni acceso.
Evidencia y método
Cómo lo calculamos
- Se fijó el ejemplo documentado en el manual de elegir dos colecciones distintas de un menú de 23. No se calculan resultados para cantidades mayores.
- Se conservaron los códigos del programa completos, sin unir títulos, sin descifrar sufijos y sin deducir cuáles son obras literarias canónicas.
- Se auditaron todas las páginas de tablas de colecciones. Dos métodos de extracción independientes coincidieron en las 1.192 apariciones, comparadas en siete campos.
- Se enumeraron los 253 pares sin orden y las 506 direcciones. La proporción de entradas repetidas D/A y las medianas, calculadas con fracciones exactas, conservan los empates.
- Se publicaron las 23 distribuciones condicionales y los datos mínimos de colección, código y página para reproducirlas, con una réplica numérica independiente.
Lo que los datos no permiten concluir
- La versión consultada de la guía no es una reconstrucción histórica comprobada del catálogo tal como estaba en la fecha original de elección.
- Los códigos de la fuente identifican títulos bibliográficos del programa, no necesariamente obras distintas en sentido literario.
- El ejemplo de dos elecciones de la fuente no prueba que todas las escuelas tengan esa asignación ni que todos los pares sean adecuados desde el punto de vista pedagógico.
- Los tamaños de las colecciones varían entre 49 y 55. Ni el rango conjunto ni la variación de la ganancia condicional se deben solo al solapamiento.
- No hay selecciones observadas, envíos, ejemplares recibidos, inventarios de escuelas, cruces con matrículas, ni datos de acceso o de resultados de aprendizaje.
- La diferencia entre 49–55 entradas en la guía y en el manual de 2023, y 53–55 en el aviso, sigue sin explicación. La fecha de generación del PDF no es una fecha de revisión comprobada.
- Se reconocen los estudios temáticos previos. La tesis completa de Faria no estaba disponible, por lo que no se afirma que este trabajo sea totalmente nuevo.
Fuentes originales
- MEC/FNDE: complete PNLD 2022 Educação Infantil literary guide
Guía completa consultada; tablas de colecciones en las páginas 59–120 del PDF. La fecha de generación del archivo, julio de 2025, no es una revisión comprobada. Códigos exactos del programa, no identidades de obras literarias canónicas.
Consultado 30 de octubre de 2026
- FNDE: manual for registering PNLD 2022 early-childhood literary choices
Las páginas 12 y 17–18 del PDF identifican los campos de código, el rango de 49–55 entradas y el ejemplo ilustrativo de marcar dos colecciones distintas de 23. No prueban que todas las escuelas puedan elegir dos colecciones ni que sean adecuadas.
Consultado 30 de octubre de 2026
- FNDE: PNLD 2022 literary choice notice
Aviso publicado el 8 de septiembre de 2023 y modificado el 7 de noviembre de 2023: describe de 53 a 55 obras, frente a 49–55 en la guía y en el manual de 2023. Se conserva como discrepancia de la fuente, no como una revisión probada con el tiempo.
Consultado 30 de octubre de 2026
- CEFET-MG: Faria dissertation defence abstract on indigenous representation in PNLD 2022
El resumen oficial indexado y los extractos de la tesis acreditan una investigación temática previa muy próxima. La tesis completa no estaba disponible para consultarla; no se afirma haber descartado todo lo que contiene.
Consultado 30 de octubre de 2026
- Manfré and Rozzi 2026: PNLD 2022 literary collections and young children’s formation
Estudio cualitativo de obras narrativas seleccionadas de las colecciones de preescolar 19–23. Es una investigación previa pertinente, pero no un análisis de todos los pares del menú por códigos exactos.
Consultado 30 de octubre de 2026
Cómo citar y reutilizar
Alisson Bento. “Dos colecciones del PNLD: cuánto cambia la variedad de códigos del programa.” Investigación original, 2026. Versión consultada de la guía oficial PNLD 2022 Educação Infantil; consultada el 30 de octubre de 2026. https://alissonbento.com/es/research/brazil-pnld-two-collection-code-breadth-2022/
Información de origen: guía oficial y manual de elección del PNLD 2022, MEC/FNDE, con enlaces a las fuentes y huellas digitales de los archivos. Extracción original de la pertenencia por código, cálculos y explicación: Alisson Bento. No se sugiere ningún respaldo institucional. No se redistribuyen reseñas, ilustraciones, textos literarios, identificadores personales de las editoriales, registros de escuelas ni registros de niños.
Correcciones o consultas editoriales