
Una scelta reale, con una risposta volutamente circoscritta
Il programma letterario PNLD 2022 per l’educazione dell’infanzia permette di distinguere tra ricevere un certo numero di raccolte e scegliere quanti elementi diversi esse contengano. Il manuale ufficiale di registrazione mostra una scuola che sceglie due raccolte diverse da un elenco di ventitré. Questo esempio definisce la decisione studiata qui. Non dimostra che tutte le scuole abbiano lo stesso numero di raccolte a disposizione, che ogni combinazione sia adatta dal punto di vista pedagogico o che le raccolte scelte siano poi state consegnate. L’analisi resta sull’elenco documentato e sulle informazioni disponibili per confrontare due scelte diverse.
In tutte le 253 coppie non ordinate della guida consultata, l’ampiezza complessiva va da 95 a 110 codici del programma distinti, con mediana 100. Non sono conteggi di opere letterarie canoniche, di bambini raggiunti o di libri letti. Anche il campo di variazione complessivo, di quindici codici, non dipende solo dalle duplicazioni: le singole raccolte contengono già numeri diversi di elementi elencati. Per questo è essenziale tenere separate la dimensione delle raccolte e la presenza ripetuta degli stessi codici. Descrivere ogni differenza come ripetizione inutile darebbe un’immagine distorta sia dell’aritmetica sia dello scopo educativo di avere più copie.
La domanda pratica è altrettanto circoscritta. Dopo aver scelto una prima raccolta per ragioni educative, quanto può variare l’ampiezza aggiunta in codici tra le altre ventidue? La risposta dà un’informazione in più per decidere, senza sostituire il giudizio professionale con l’aritmetica. Un incremento numerico minore può comunque accompagnare storie, linguaggio, illustrazioni o occasioni di lavoro in classe più adatte. Le tabelle riportano i confronti per ogni prima raccolta, senza scegliere poche combinazioni particolarmente appariscenti. Niente di quanto segue invita a massimizzare il numero a scapito di una scelta coerente sul piano educativo.
Che cosa identifica la fonte e che cosa non identifica
La fonte è la guida letteraria ufficiale completa del PNLD 2022 Educação Infantil, scaricata dall’archivio delle pubblicazioni della UFAL. Le sue tabelle indicano per ogni raccolta l’editore, il titolo di un elemento con il suo codice del programma e un codice di genere. Le ventitré raccolte sono classificate come miste, per il nido o per la scuola dell’infanzia. Lo studio conserva ogni codice stampato come stringa esatta, con gli zeri iniziali e il suffisso completo. Non ne decodifica la struttura e non unisce voci con codici diversi solo perché i titoli si somigliano. L’unità di lavoro è un elemento bibliografico elencato dal programma, non un’opera letteraria stabilita in modo indipendente.
Questa distinzione conta in entrambe le direzioni. Codici diversi potrebbero rappresentare edizioni, formati o distinzioni del programma legate a una stessa opera. Al contrario, titoli identici possono appartenere a opere diverse. L’analisi non risolve né l’uno né l’altro caso con congetture basate sulle parole. Per le occorrenze dello stesso codice esatto sono stati controllati titolo, editore e genere stampati: nelle tabelle estratte non sono emersi conflitti. Il controllo giustifica il collegamento dello stesso codice tra raccolte diverse, ma non lo trasforma in una definizione universale di identità letteraria valida oltre questa fonte.
Nelle tabelle consultate le raccolte contengono da 49 a 55 voci con codice. Lo stesso intervallo è indicato dal manuale ufficiale, mentre l’avviso di scelta del FNDE conservato parla di 53–55 opere. Si riportano entrambe le indicazioni, senza uniformarle in silenzio. Il file della guida porta una data di generazione del luglio 2025, ma questo non dimostra una revisione ufficiale del catalogo: un manuale creato nell’ottobre 2023 indicava già l’intervallo più ampio. I risultati si riferiscono alla copia esatta della guida consultata e alla sua impronta digitale. Non vanno presentati come una ricostruzione verificata di ogni dettaglio mostrato alla data della scelta originale.
Separare voci nominali, codici distinti e presenze ripetute
Per due raccolte, sia A il totale delle voci elencate, ottenuto sommando le dimensioni delle due raccolte, e sia B il numero di codici diversi nella loro unione. La differenza D = A − B è il numero di voci ripetute nella coppia. Poiché dentro ogni raccolta nessun codice compare due volte, D è anche il numero di codici in comune tra le due raccolte (la dimensione dell’intersezione). È una semplice contabilità tra insiemi, ma evita una scorciatoia interpretativa diffusa: due raccolte non sono due singoli libri e non offrono necessariamente tanti codici distinti quanti ne risultano sommando le loro voci.
La quota di voci duplicate ha A come denominatore. Se un codice compare una volta in ciascuna delle due raccolte scelte, aggiunge due voci ad A, un codice a B e una voce ripetuta a D. La quota misura quindi di quanto il conteggio nominale complessivo supera l’ampiezza in codici distinti. Non significa che la copia fisica ripetuta sia inutile. Le copie possono servire per letture contemporanee, spazi separati, incontri ripetuti con lo stesso libro o sostituzioni, aspetti che i dati dell’elenco non misurano. Chiamare D spreco, perdita di apprendimento o privazione attribuirebbe un giudizio di valore infondato a una grandezza contabile.
Nell’insieme completo delle coppie, la quota di voci duplicate va da zero a un tredicesimo, circa il 7,7%, con mediana di un trentacinquesimo, circa il 2,9%. Con questa definizione la duplicazione è modesta e non prova che il programma ripeta per lo più lo stesso materiale. Il campo di variazione dell’ampiezza congiunta va letto insieme alla variazione di 49–55 voci nelle raccolte di partenza. Più voci nominali possono far crescere l’ampiezza, mentre i codici in comune ne riducono l’aumento rispetto al totale nominale. Il rapporto tra A, B e D dice più che presentare il massimo e il minimo dell’ampiezza come puro effetto della duplicazione.
Elencare tutte le scelte possibili di due raccolte
Ci sono ventitré scelte possibili per una raccolta e ventidue scelte diverse rimanenti per l’altra. Dividendo il loro prodotto per due si ottengono 253 coppie non ordinate, perché scegliere A con B dà lo stesso insieme di codici che scegliere B con A. Ogni coppia compare una sola volta nella tabella delle coppie, compresi i risultati uguali tra loro. Questa enumerazione completa non è un campione di decisioni delle scuole. Non serve un intervallo di confidenza per l’errore campionario, e la mediana non stima che cosa la scuola tipica abbia scelto o ricevuto.
La mediana di 100 codici distinti è il risultato centrale quando i 253 valori sono messi in ordine. Il minimo di 95 e il massimo di 110 delimitano il confronto matematico documentato; non garantiscono nulla su quali scelte siano ammissibili o auspicabili per ogni scuola. L’esempio del manuale con due scelte offre il caso pratico, mentre le categorie delle raccolte restano un contesto importante. L’analisi non stabilisce che ogni combinazione sia adatta a ogni fascia d’età o a ogni progetto educativo. L’elenco comune permette un confronto informativo: non sostituisce le istruzioni del programma e non invita gli educatori a ignorare l’adeguatezza pedagogica.
Trattare tutte le coppie allo stesso modo, in senso descrittivo, è utile perché evita di scegliere le combinazioni dopo averne visto i risultati. Non va confuso con un modello di comportamento in cui le scuole scelgano a caso con uguale probabilità. Alcune combinazioni potrebbero essere molto più attraenti o appropriate di altre, ma la fonte non offre pesi di preferenza osservati. Non c’è nemmeno un andamento nel tempo: tutti i risultati vengono da un solo elenco consultato. Il file completo delle coppie permette di controllare i calcoli, senza fingere che queste alternative siano osservazioni indipendenti di adozione, consegna o lettura reali.
Perché conta la direzione della seconda scelta
La stessa coppia non ordinata ha due possibili punti di partenza. Se una raccolta è già stata scelta, l’ampiezza aggiunta dall’altra è il numero dei suoi codici assenti nella prima. Questo incremento è uguale alla dimensione della seconda raccolta candidata meno i codici che ha in comune con quella già scelta. Se si inverte il punto di partenza, l’incremento può cambiare, anche se l’ampiezza combinata resta la stessa. Tenere entrambe le direzioni dà 506 confronti ordinati. Sono due modi di guardare le stesse 253 coppie, non un insieme di dati in più né una conferma indipendente dei risultati.
Nelle 506 combinazioni ordinate, gli incrementi della seconda scelta vanno da 42 a 55 codici del programma, con mediana 50. La distribuzione completa delle frequenze, per valori interi, è riportata senza smussature né classi scelte dopo aver visto i risultati. Per ogni possibile prima raccolta, la tabella condizionale conserva inoltre tutte le ventidue alternative, con le frequenze esatte e con il minimo, la mediana e il massimo. Queste distribuzioni sono utili soprattutto quando la prima scelta è già motivata sul piano educativo. Mostrano la variazione disponibile nell’ampiezza in codici, senza chiedere di rimpiazzare quella prima decisione con la raccolta che dà il totale numerico più alto.
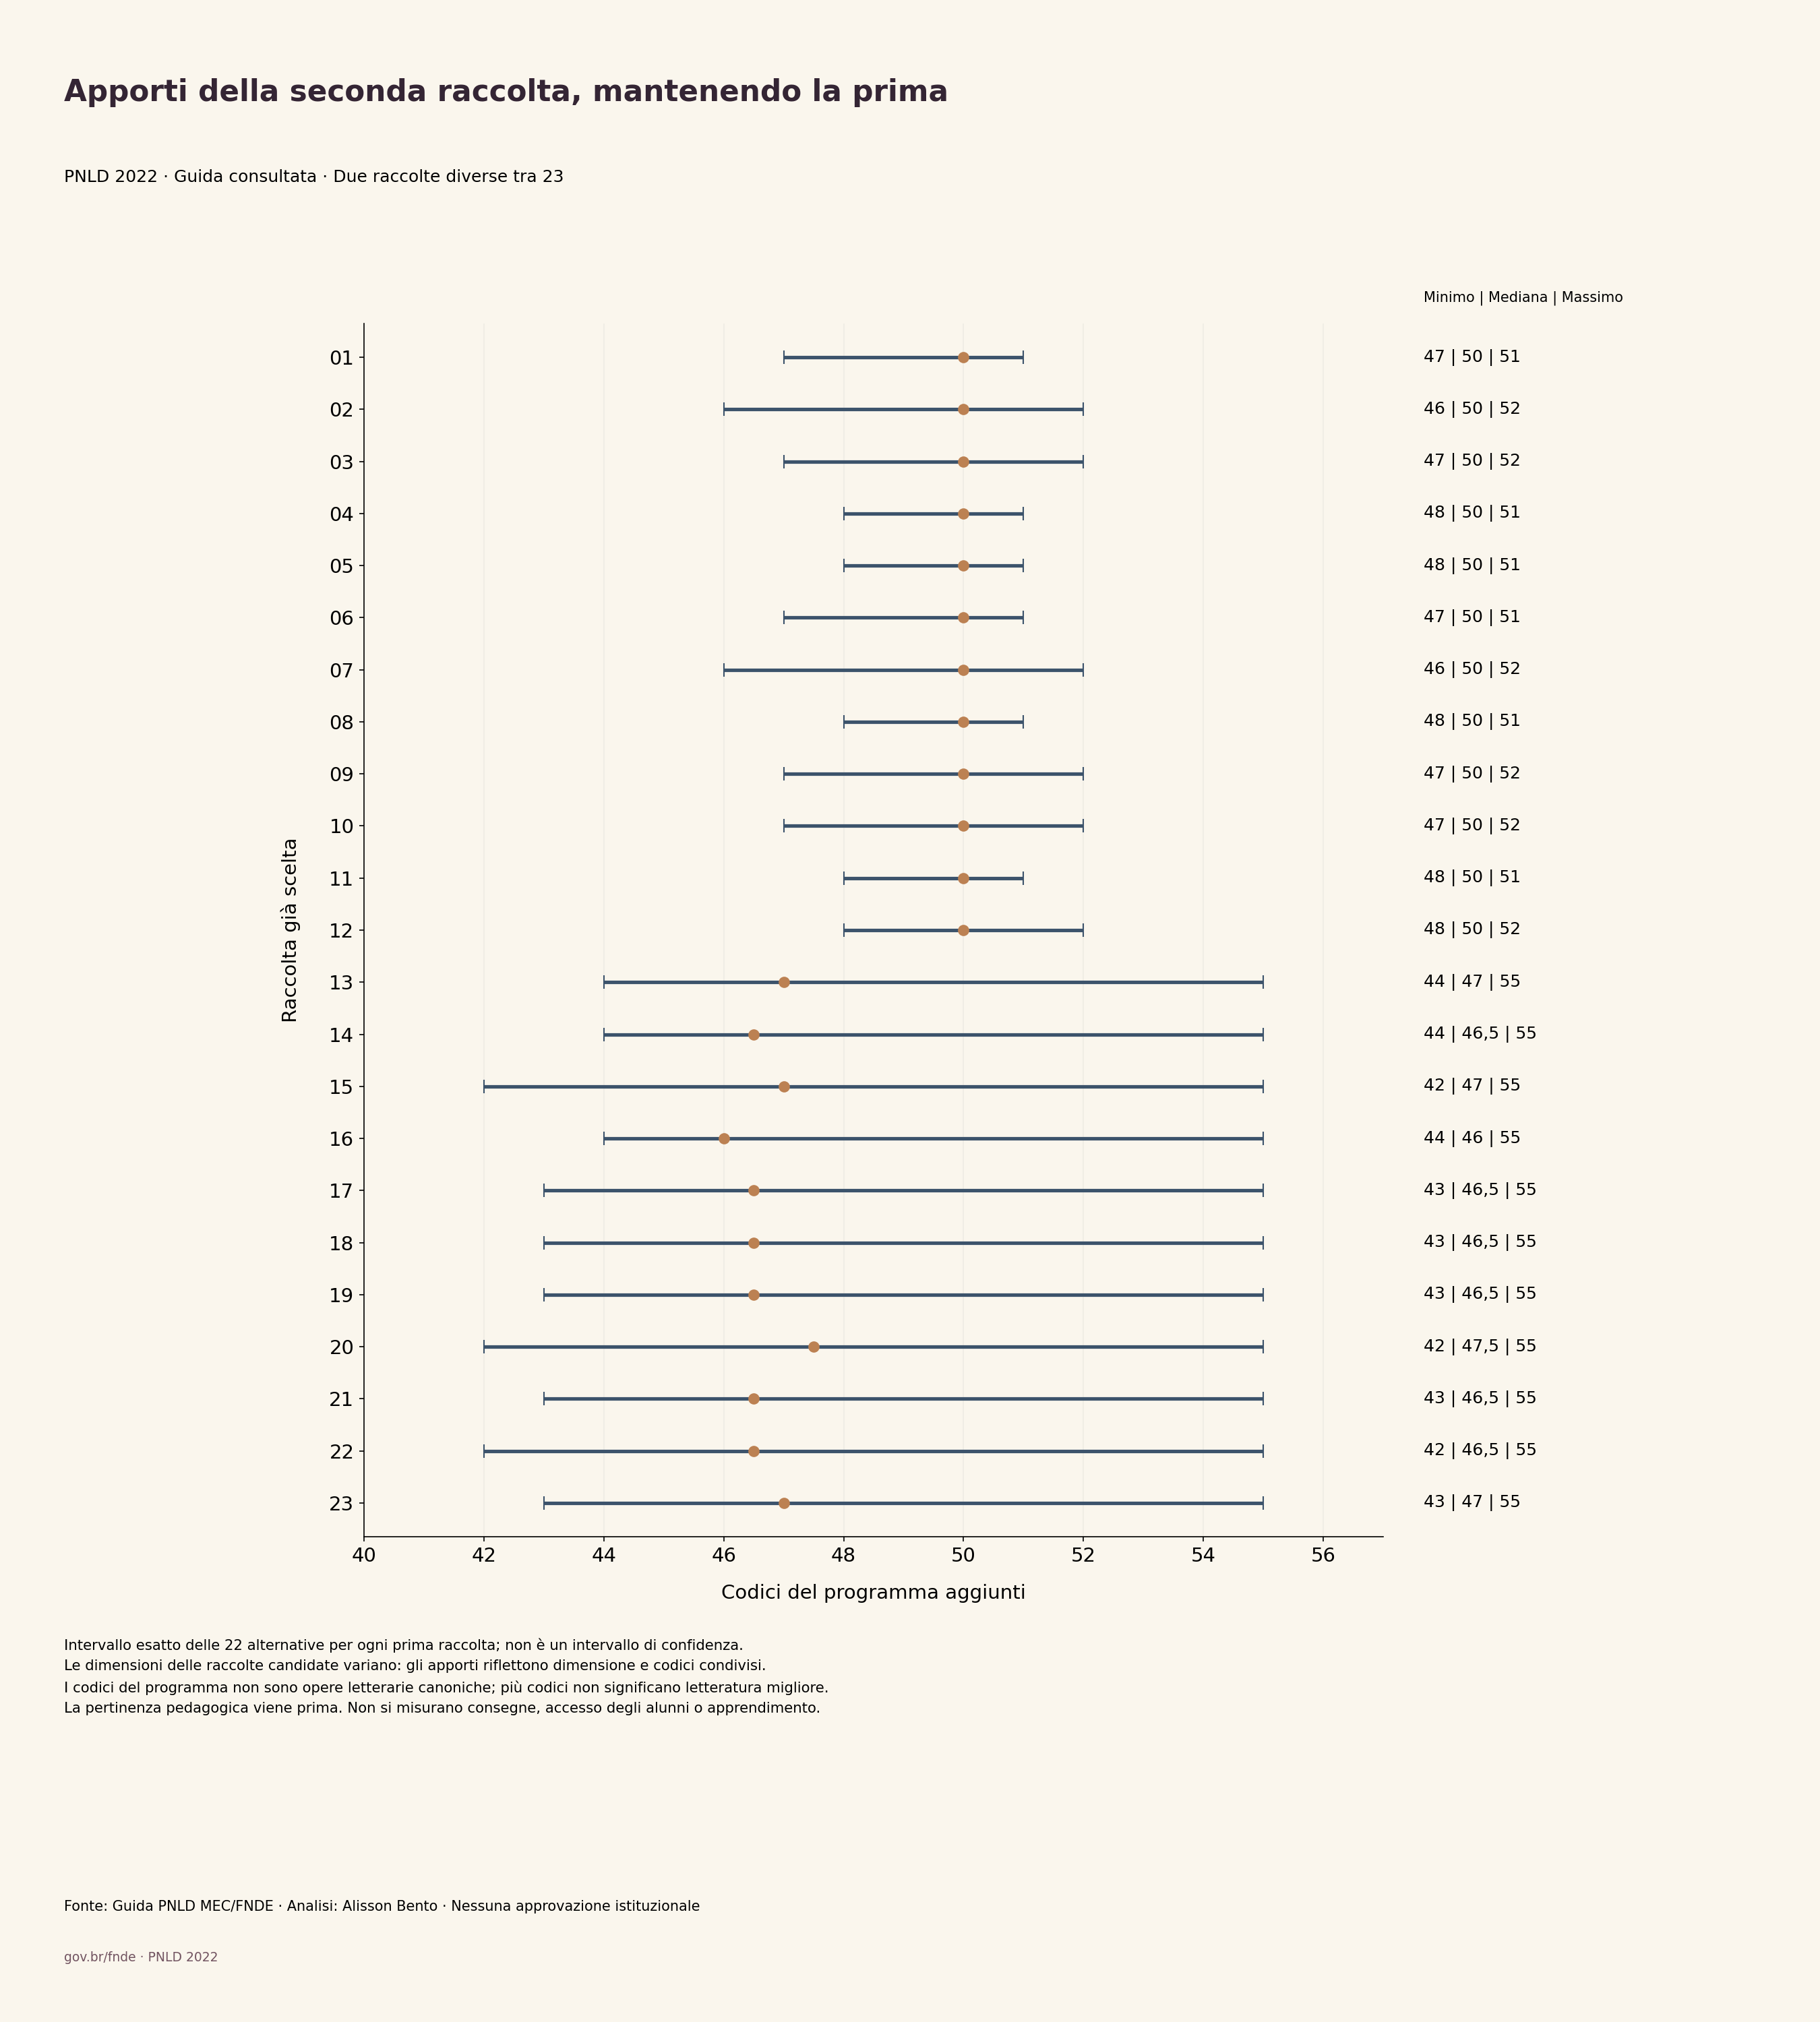
I campi di variazione condizionali non sono tutti uguali. Per esempio, la raccolta 05 ha 50 codici di partenza e le sue alternative ne aggiungono 48–51, con mediana 50; la raccolta 15 ha 54 codici di partenza e le sue alternative ne aggiungono 42–55, con mediana 47. Entrambi gli esempi fanno parte della tabella completa di ventitré righe e non sono graduatorie di qualità. Anche con la prima raccolta fissa, le candidate differiscono per dimensione propria oltre che per i codici in comune. Un campo di variazione degli incrementi più ampio non si può quindi attribuire solo alla sovrapposizione, e un incremento minore non dimostra che un’alternativa sia inferiore.
L’adeguatezza pedagogica viene prima del conteggio
La fonte classifica le raccolte come miste, per il nido o per la scuola dell’infanzia. Queste etichette indicano i contesti educativi previsti; lo studio non le trasforma in punteggi. L’analisi non mette in graduatoria una raccolta mista rispetto a una per la scuola dell’infanzia e non deduce che le categorie siano intercambiabili per ogni scuola. Il confronto principale usa il caso documentato di due raccolte diverse; le assegnazioni più numerose citate altrove nella guida non sono analizzate. Estendere il calcolo a tre, sei o dodici raccolte richiederebbe un modello di decisione giustificato a parte: non basta un esempio mostrato nell’interfaccia di registrazione per ricavarne ogni possibile regola di assegnazione.
Un uso sensato della tabella condizionale parte dalle alternative adatte sul piano educativo, non dal massimo nell’ultima colonna. I conteggi dei codici possono poi spiegare in che cosa quelle alternative differiscono su un solo aspetto, molto limitato: il numero di codici in più elencati. L’adeguatezza può dipendere dai bambini concreti, dalle attività previste, dalle esigenze di accessibilità, dalla lingua, dalla veste dei materiali o da ciò che la scuola possiede già. Nessuno di questi fattori è misurato qui. L’analisi offre informazioni da affiancare al giudizio professionale; non sostiene che un conteggio esatto di codici esprima i benefici di una raccolta o la varietà delle esperienze di lettura che può offrire.
Il patrimonio già posseduto è un altro limite importante. Una seconda raccolta del programma può aggiungere codici rispetto alla prima raccolta scelta, ma portare meno titoli nuovi nell’intera biblioteca della scuola. La domanda opposta, cioè quanti codici una scuola non possieda ancora, richiede un inventario verificato e codici compatibili. Nessun inventario di questo tipo è collegato alle tabelle. Allo stesso modo, l’accesso a una biblioteca condivisa o a libri acquistati fuori dal programma potrebbe cambiare le occasioni di un bambino senza modificare alcun risultato di questa verifica. L’ampiezza dell’elenco del programma è un oggetto di misura preciso, non un quadro completo dell’accesso alla letteratura.
Differenze rispetto alla ricerca sulla copertura tematica
Altri studi hanno già esaminato la rappresentazione e la copertura dei temi in queste raccolte. Il lavoro di Mirian Daniela Faustino Faria riguarda i temi indigeni e la loro presenza nelle raccolte. Materiale ufficiale indicizzato rimanda a una tabella di corrispondenze per otto opere; la tesi completa non era disponibile per la consultazione, quindi non si afferma di aver escluso che qualche sua analisi anticipi questo lavoro. Il suo interesse centrale resta comunque importante: la composizione di una raccolta può contare più del numero complessivo di libri. Questo articolo non pretende di aver scoperto per primo la questione.
Lo studio di Manfré e Rozzi del 2026 esamina alcune opere narrative delle raccolte per la scuola dell’infanzia in relazione alla formazione umana e culturale dei bambini. Un’indagine qualitativa di questo tipo pone domande a cui il conteggio dei codici esatti non può rispondere. Una bibliografia con più codici non è necessariamente più ricca di una certa prospettiva culturale, più adatta a un gruppo o migliore come letteratura. Inoltre, applicare a un altro tema un’analisi di copertura già esistente sarebbe un lavoro diverso dal calcolo presentato qui. Il contributo di questo studio è il conteggio su tutte le coppie dell’elenco e l’informazione condizionale sulla seconda scelta, non una nuova valutazione del valore tematico o letterario.
I due approcci possono completarsi senza essere intercambiabili. Uno studio tematico può individuare opere di particolare importanza educativa; la tabella di questo studio può descrivere come cambia la composizione in codici quando si combinano due raccolte. Non attribuisce un significato tematico agli altri codici e non deduce la copertura dagli editori o dalle parole dei titoli. Mantenere questa separazione rende utile il risultato ed evita di esagerarne la novità.
Un controllo della fonte che può essere verificato
La sezione delle tabelle con le raccolte occupa le pagine 59–120 del PDF. Sono state controllate tutte le ventitré intestazioni e ogni pagina di continuazione, e due metodi di estrazione indipendenti hanno riconciliato tutte le 1.192 occorrenze elencate. Il confronto riguardava raccolta, categoria, codice del programma, titolo, editore, genere e pagina della fonte. Ogni codice è rimasto una stringa di testo durante tutta l’elaborazione. Le duplicazioni dentro una stessa raccolta e le discordanze nei campi descrittivi legati ai codici ripetuti sono state controllate in modo esplicito, senza eliminare righe né unire titoli simili. Nell’estrazione controllata usata per i calcoli non è rimasto alcun conflitto di questo tipo.
Il file pubblico di appartenenza contiene volutamente solo il numero della raccolta, il codice del programma e la pagina della fonte. Le celle degli editori nella guida possono contenere identificativi non necessari per riprodurre questa domanda, e la guida comprende anche recensioni e illustrazioni protette che non servono al calcolo. Questi materiali non vengono ridistribuiti. Un elenco delle fonti indica i file effettivi della guida e del manuale con indirizzo web, dimensione in byte e impronta digitale, così chi legge può controllare la fonte per conto proprio. Il file ridotto basta a riprodurre le unioni e le differenze tra insiemi senza riprodurre il contenuto creativo della guida.
Il programma di calcolo enumera le coppie e le direzioni fissate, conserva tutti i risultati uguali e riporta le tabelle complete delle frequenze condizionali. Rapporti e mediane sono calcolati con aritmetica razionale esatta prima di qualsiasi arrotondamento per la visualizzazione. Un’implementazione indipendente, partita da un’estrazione separata e senza importare le funzioni di calcolo, ha riprodotto tutti i valori numerici riportati. Questo protegge da errori di trascrizione e di programmazione, ma non elimina i limiti delle definizioni della fonte né della sua copertura storica. I file scaricabili rendono visibili queste distinzioni, invece di presentare la riproducibilità come se l’elenco misurasse tutto ciò che un lettore vorrebbe sapere.
Perché non sono statistiche di consegna o sugli alunni
Un’etichetta di programma e un elenco di scelta non sono registri di spedizione. Questo studio non collega alla guida identificativi delle scuole, date di consegna, quantità ricevute o dati sulle iscrizioni. Perciò non può mostrare quali scuole abbiano ottenuto una raccolta, se le spedizioni fossero complete, come siano state registrate consegne ripetute o quante copie fossero disponibili per ciascun bambino. L’assenza di un registro di spedizione non dimostrerebbe da sola un accesso pari a zero, e il titolo di un programma in una tabella logistica non identificherebbe necessariamente un singolo libro. Queste domande richiedono altre definizioni di fonte e altri collegamenti tra dati, che qui non sono stati fatti.
La distinzione evita anche una lettura fuorviante dell’anno che compare nel titolo. PNLD 2022 indica il programma rappresentato dalla guida e dal manuale, non un censimento verificato delle consegne o delle letture in un anno solare. La copia della fonte è stata scaricata nell’ottobre 2026. La data di generazione del file, le informazioni sulla creazione del manuale e le date dell’avviso sono dettagli sulla provenienza, non periodi di osservazione intercambiabili. Senza una catena documentata delle versioni storiche, le differenze tra gli intervalli pubblicati devono restare discrepanze. Non vanno trasformate in un racconto inventato di eliminazioni, aggiunte o cambiamenti in ciò che le scuole hanno realmente ricevuto.
Attorno all’aritmetica di questa copia, enumerata per intero, non c’è alcun intervallo di incertezza statistica, ma c’è molta incertezza sulle questioni che ne restano fuori. L’identità esatta dei codici, la stabilità storica del catalogo, l’adeguatezza per fasce d’età, le dotazioni già presenti nelle scuole e l’uso effettivo pongono ciascuno un limite diverso. Un intervallo di confidenza non risolverebbe questi problemi di definizione. La risposta giusta è indicare con precisione che cosa si è misurato e non attribuire risultati che non si sono misurati. Per questo i risultati riguardano un elenco documentato di scelte, e non la parità di opportunità educative, l’efficacia del programma o i cambiamenti nella lettura dei bambini.
Usare i calcoli come un livello di informazione per decidere
Per chi confronta due raccolte adatte, la sequenza è semplice: individuare la raccolta di partenza, considerare le alternative rilevanti e distinguere le voci nominali aggiunte dai codici già presenti. La tabella condizionale riporta il campo di variazione e le frequenze esatte per le ventidue alternative dell’elenco pubblicato. Il file delle coppie riporta il conteggio combinato e la quota di voci ripetute di ciascuna. Questi file servono a controllare l’aritmetica; non sono una regola automatica di scelta. Le ragioni educative per scegliere un elemento restano fuori dal calcolo e non vanno cancellate da un massimo numerico.
Il risultato principale è quindi equilibrato. Scegliere due raccolte diverse può dare un’ampiezza in codici esatti diversa, e l’incremento dipende dalla raccolta di partenza, dalla dimensione della candidata e da quanto si sovrappongono. Allo stesso tempo, la duplicazione misurata è modesta e può avere scopi legittimi che l’elenco non permette di valutare. Riportare entrambi gli aspetti evita di trasformare una piccola differenza contabile in un’accusa di spreco, ma evita anche l’ipotesi opposta, cioè che ogni coppia offra necessariamente lo stesso elenco di elementi. Quantità e ampiezza in codici rispondono a domande collegate ma diverse.
L’enumerazione completa rende controllabili queste differenze per una decisione documentata, in una guida del programma consultata. Non indica la letteratura migliore, non stabilisce risultati a livello di scuola e non risolve la questione più ampia di chi abbia accesso ai libri. Il suo valore sta nel rendere esatto un confronto limitato: numero di raccolte, voci, codici distinti e codici aggiunti restano separati, e le incertezze della fonte restano visibili. Usata insieme alle descrizioni educative della guida e ai bisogni reali di una scuola, questa distinzione può aiutare a capire meglio le informazioni disponibili, senza pretendere di sostituire il resto della decisione.
Codici aggiunti dalla seconda raccolta, a prima raccolta fissata
PNLD 2022 · Copia della guida consultata · Due raccolte diverse tra 23
Grafico completo e fonte
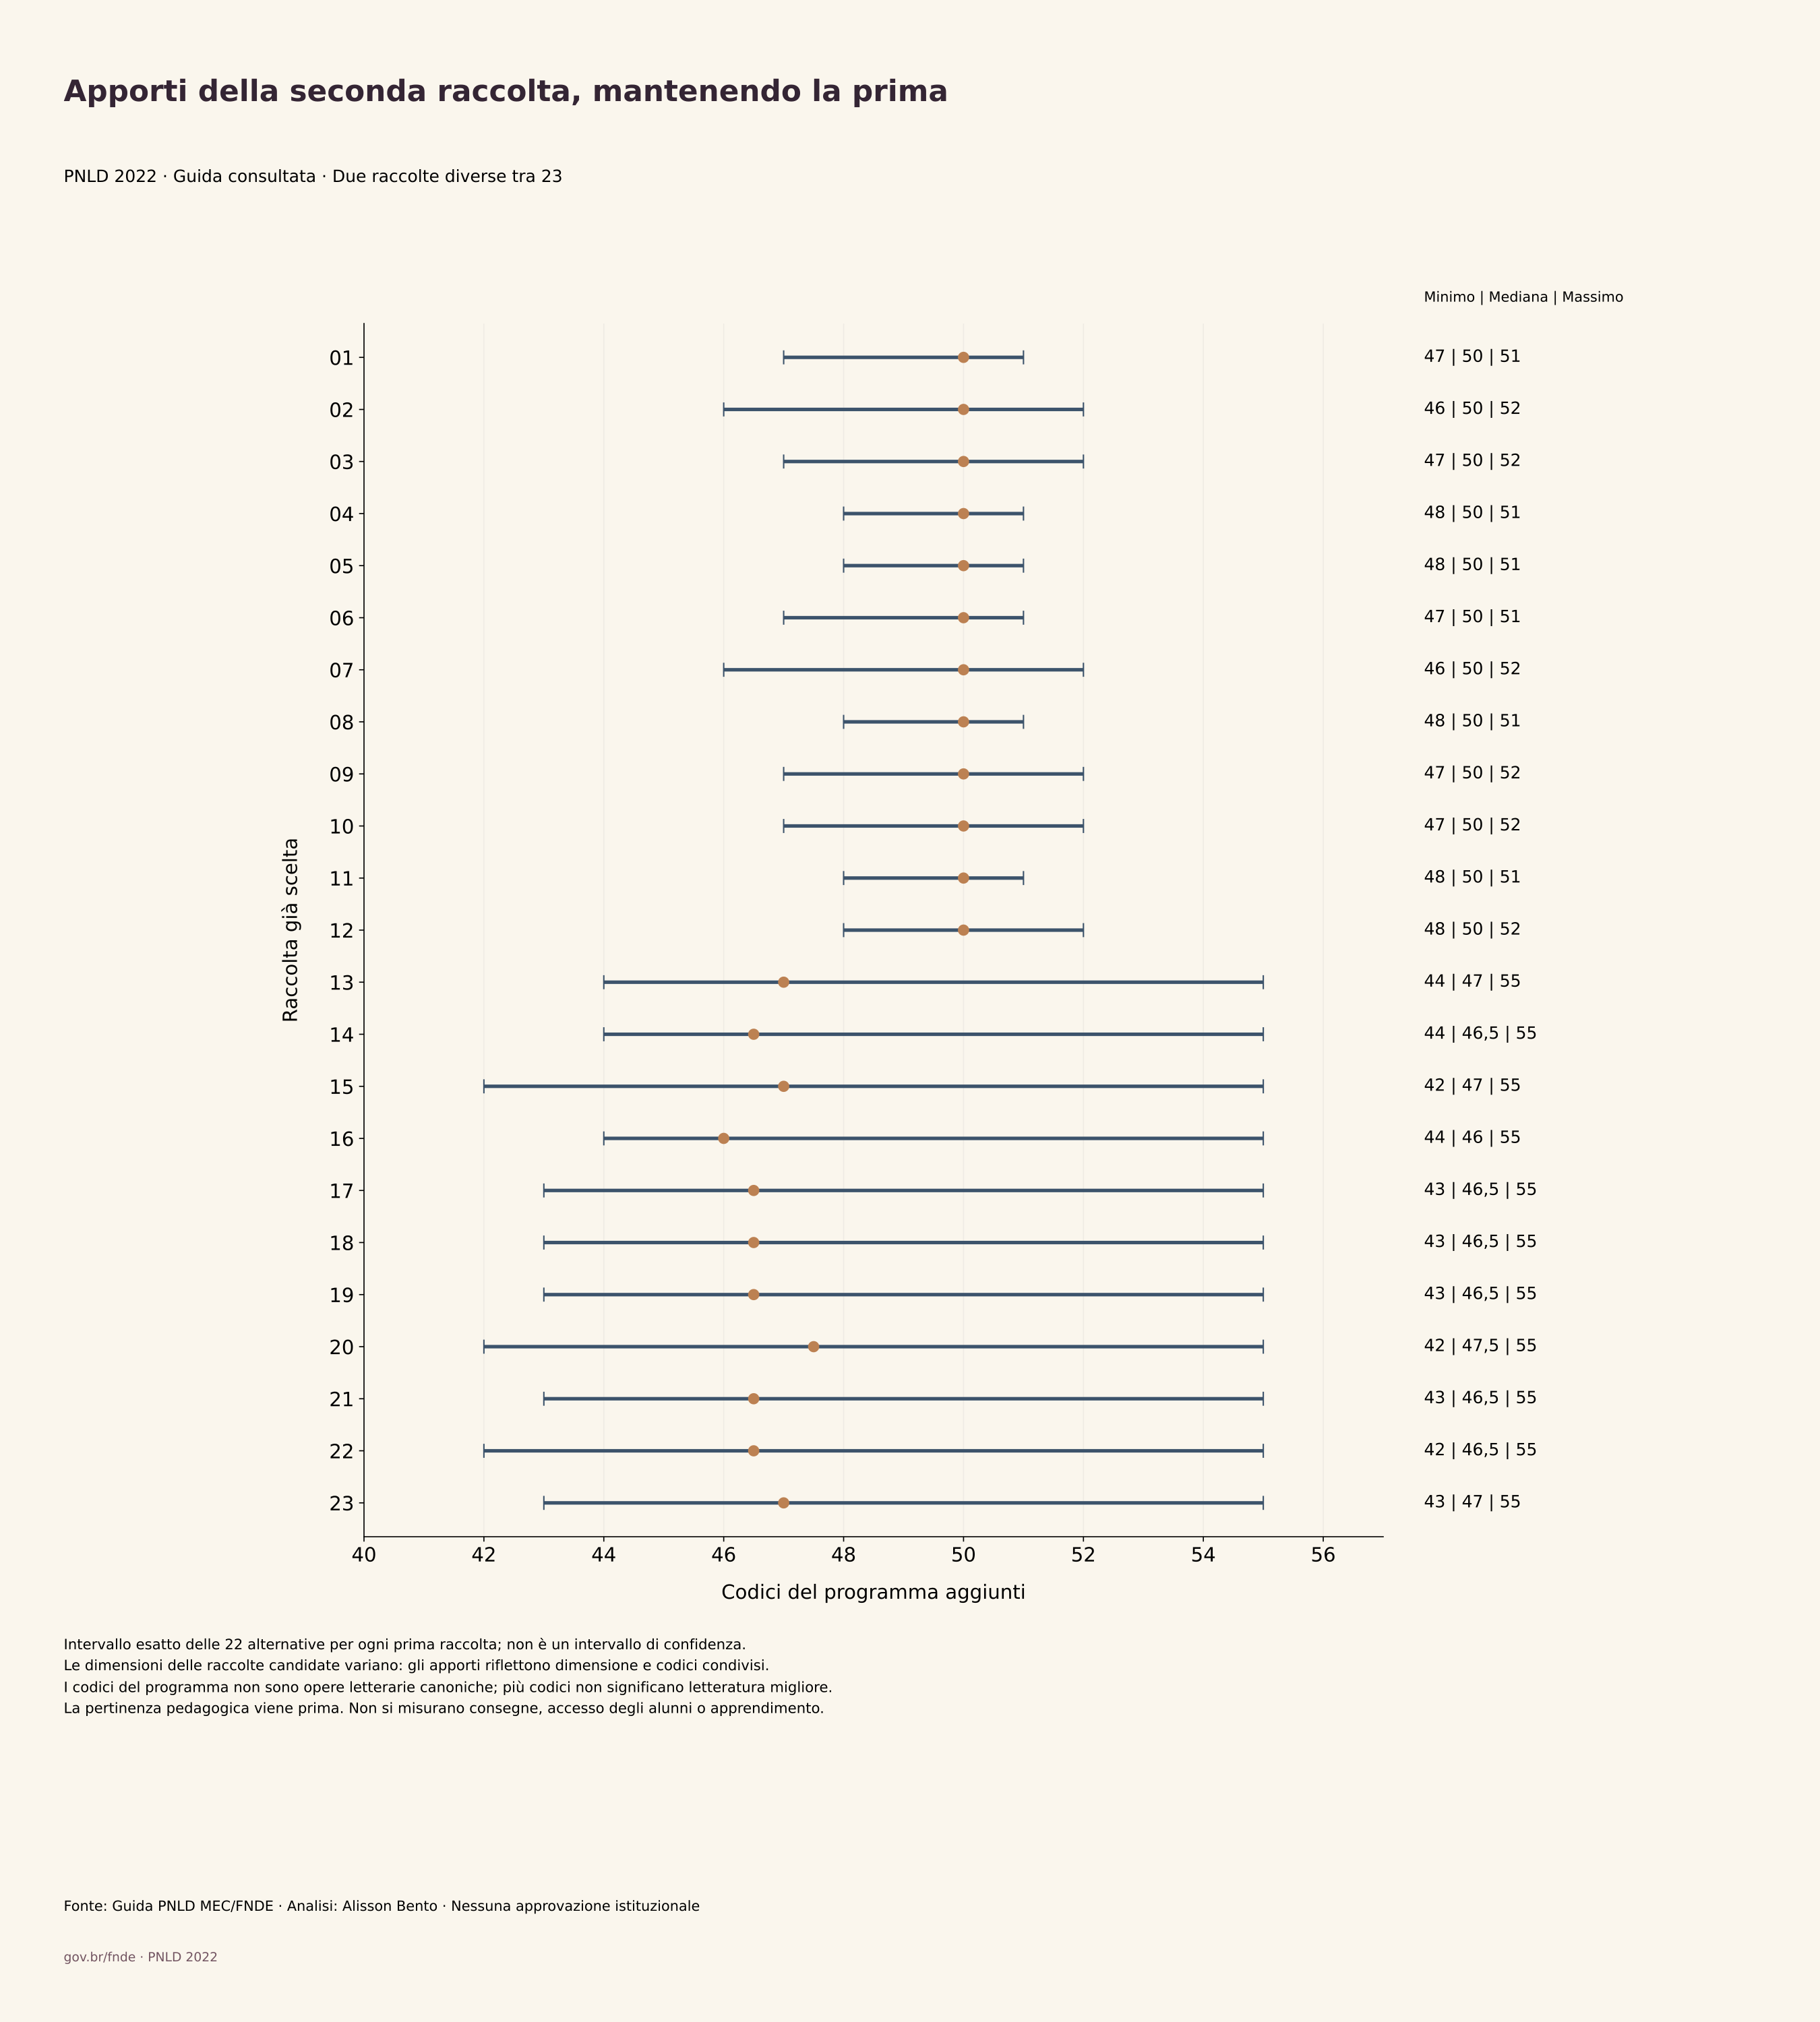
Scorri il grafico in orizzontale per esaminarlo. ↔
Grafico e valori
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Prima raccolta | Categoria | Codici di partenza | Alternative | Minimo aggiunto | Mediana aggiunta | Massimo aggiunto | Codici aggiunti: scelte |
|---|---|---|---|---|---|---|---|
| 01 | Mista | 50 | 22 | 47 | 50,0 | 51 | 47: 2; 49: 7; 50: 8; 51: 5 |
| 02 | Mista | 49 | 22 | 46 | 50,0 | 52 | 46: 1; 48: 1; 49: 5; 50: 11; 51: 3; 52: 1 |
| 03 | Mista | 50 | 22 | 47 | 50,0 | 52 | 47: 1; 48: 1; 49: 7; 50: 10; 51: 2; 52: 1 |
| 04 | Mista | 49 | 22 | 48 | 50,0 | 51 | 48: 1; 49: 6; 50: 13; 51: 2 |
| 05 | Mista | 50 | 22 | 48 | 50,0 | 51 | 48: 1; 49: 8; 50: 11; 51: 2 |
| 06 | Mista | 50 | 22 | 47 | 50,0 | 51 | 47: 1; 48: 1; 49: 5; 50: 13; 51: 2 |
| 07 | Mista | 50 | 22 | 46 | 50,0 | 52 | 46: 1; 47: 1; 48: 1; 49: 6; 50: 7; 51: 5; 52: 1 |
| 08 | Mista | 50 | 22 | 48 | 50,0 | 51 | 48: 1; 49: 8; 50: 11; 51: 2 |
| 09 | Mista | 50 | 22 | 47 | 50,0 | 52 | 47: 1; 48: 2; 49: 4; 50: 13; 51: 1; 52: 1 |
| 10 | Mista | 49 | 22 | 47 | 50,0 | 52 | 47: 1; 48: 2; 49: 4; 50: 11; 51: 3; 52: 1 |
| 11 | Mista | 50 | 22 | 48 | 50,0 | 51 | 48: 2; 49: 7; 50: 10; 51: 3 |
| 12 | Mista | 49 | 22 | 48 | 50,0 | 52 | 48: 3; 49: 5; 50: 10; 51: 3; 52: 1 |
| 13 | Nido | 53 | 22 | 44 | 47,0 | 55 | 44: 5; 45: 2; 46: 2; 47: 3; 53: 1; 54: 5; 55: 4 |
| 14 | Nido | 55 | 22 | 44 | 46,5 | 55 | 44: 4; 45: 4; 46: 3; 47: 1; 53: 2; 54: 5; 55: 3 |
| 15 | Nido | 54 | 22 | 42 | 47,0 | 55 | 42: 1; 44: 4; 45: 2; 46: 1; 47: 4; 53: 2; 54: 4; 55: 4 |
| 16 | Nido | 55 | 22 | 44 | 46,0 | 55 | 44: 4; 45: 3; 46: 5; 53: 2; 54: 5; 55: 3 |
| 17 | Nido | 54 | 22 | 43 | 46,5 | 55 | 43: 1; 44: 2; 45: 4; 46: 4; 47: 1; 53: 2; 54: 4; 55: 4 |
| 18 | Nido | 55 | 22 | 43 | 46,5 | 55 | 43: 1; 44: 2; 45: 5; 46: 3; 47: 1; 53: 2; 54: 5; 55: 3 |
| 19 | Scuola dell’infanzia | 54 | 22 | 43 | 46,5 | 55 | 43: 1; 44: 3; 45: 2; 46: 5; 47: 1; 53: 2; 54: 4; 55: 4 |
| 20 | Scuola dell’infanzia | 53 | 22 | 42 | 47,5 | 55 | 42: 1; 44: 3; 45: 2; 46: 4; 47: 1; 48: 1; 53: 1; 54: 5; 55: 4 |
| 21 | Scuola dell’infanzia | 55 | 22 | 43 | 46,5 | 55 | 43: 2; 44: 1; 45: 4; 46: 4; 47: 1; 53: 2; 54: 5; 55: 3 |
| 22 | Scuola dell’infanzia | 54 | 22 | 42 | 46,5 | 55 | 42: 1; 43: 1; 45: 4; 46: 5; 47: 1; 53: 2; 54: 4; 55: 4 |
| 23 | Scuola dell’infanzia | 54 | 22 | 43 | 47,0 | 55 | 43: 2; 44: 1; 45: 4; 46: 3; 47: 2; 53: 2; 54: 4; 55: 4 |
Ogni riga fissa la prima raccolta e conserva tutte le 22 alternative diverse. Notazione delle frequenze: codici aggiunti: numero di scelte candidate. La categoria è un’informazione di contesto della fonte, non una graduatoria né una regola di adeguatezza universale. Variano sia le dimensioni delle candidate sia la sovrapposizione.
Tutti gli incrementi della seconda scelta nell’elenco fissato
PNLD 2022 · Copia della guida consultata · Due raccolte diverse tra 23
Grafico completo e fonte
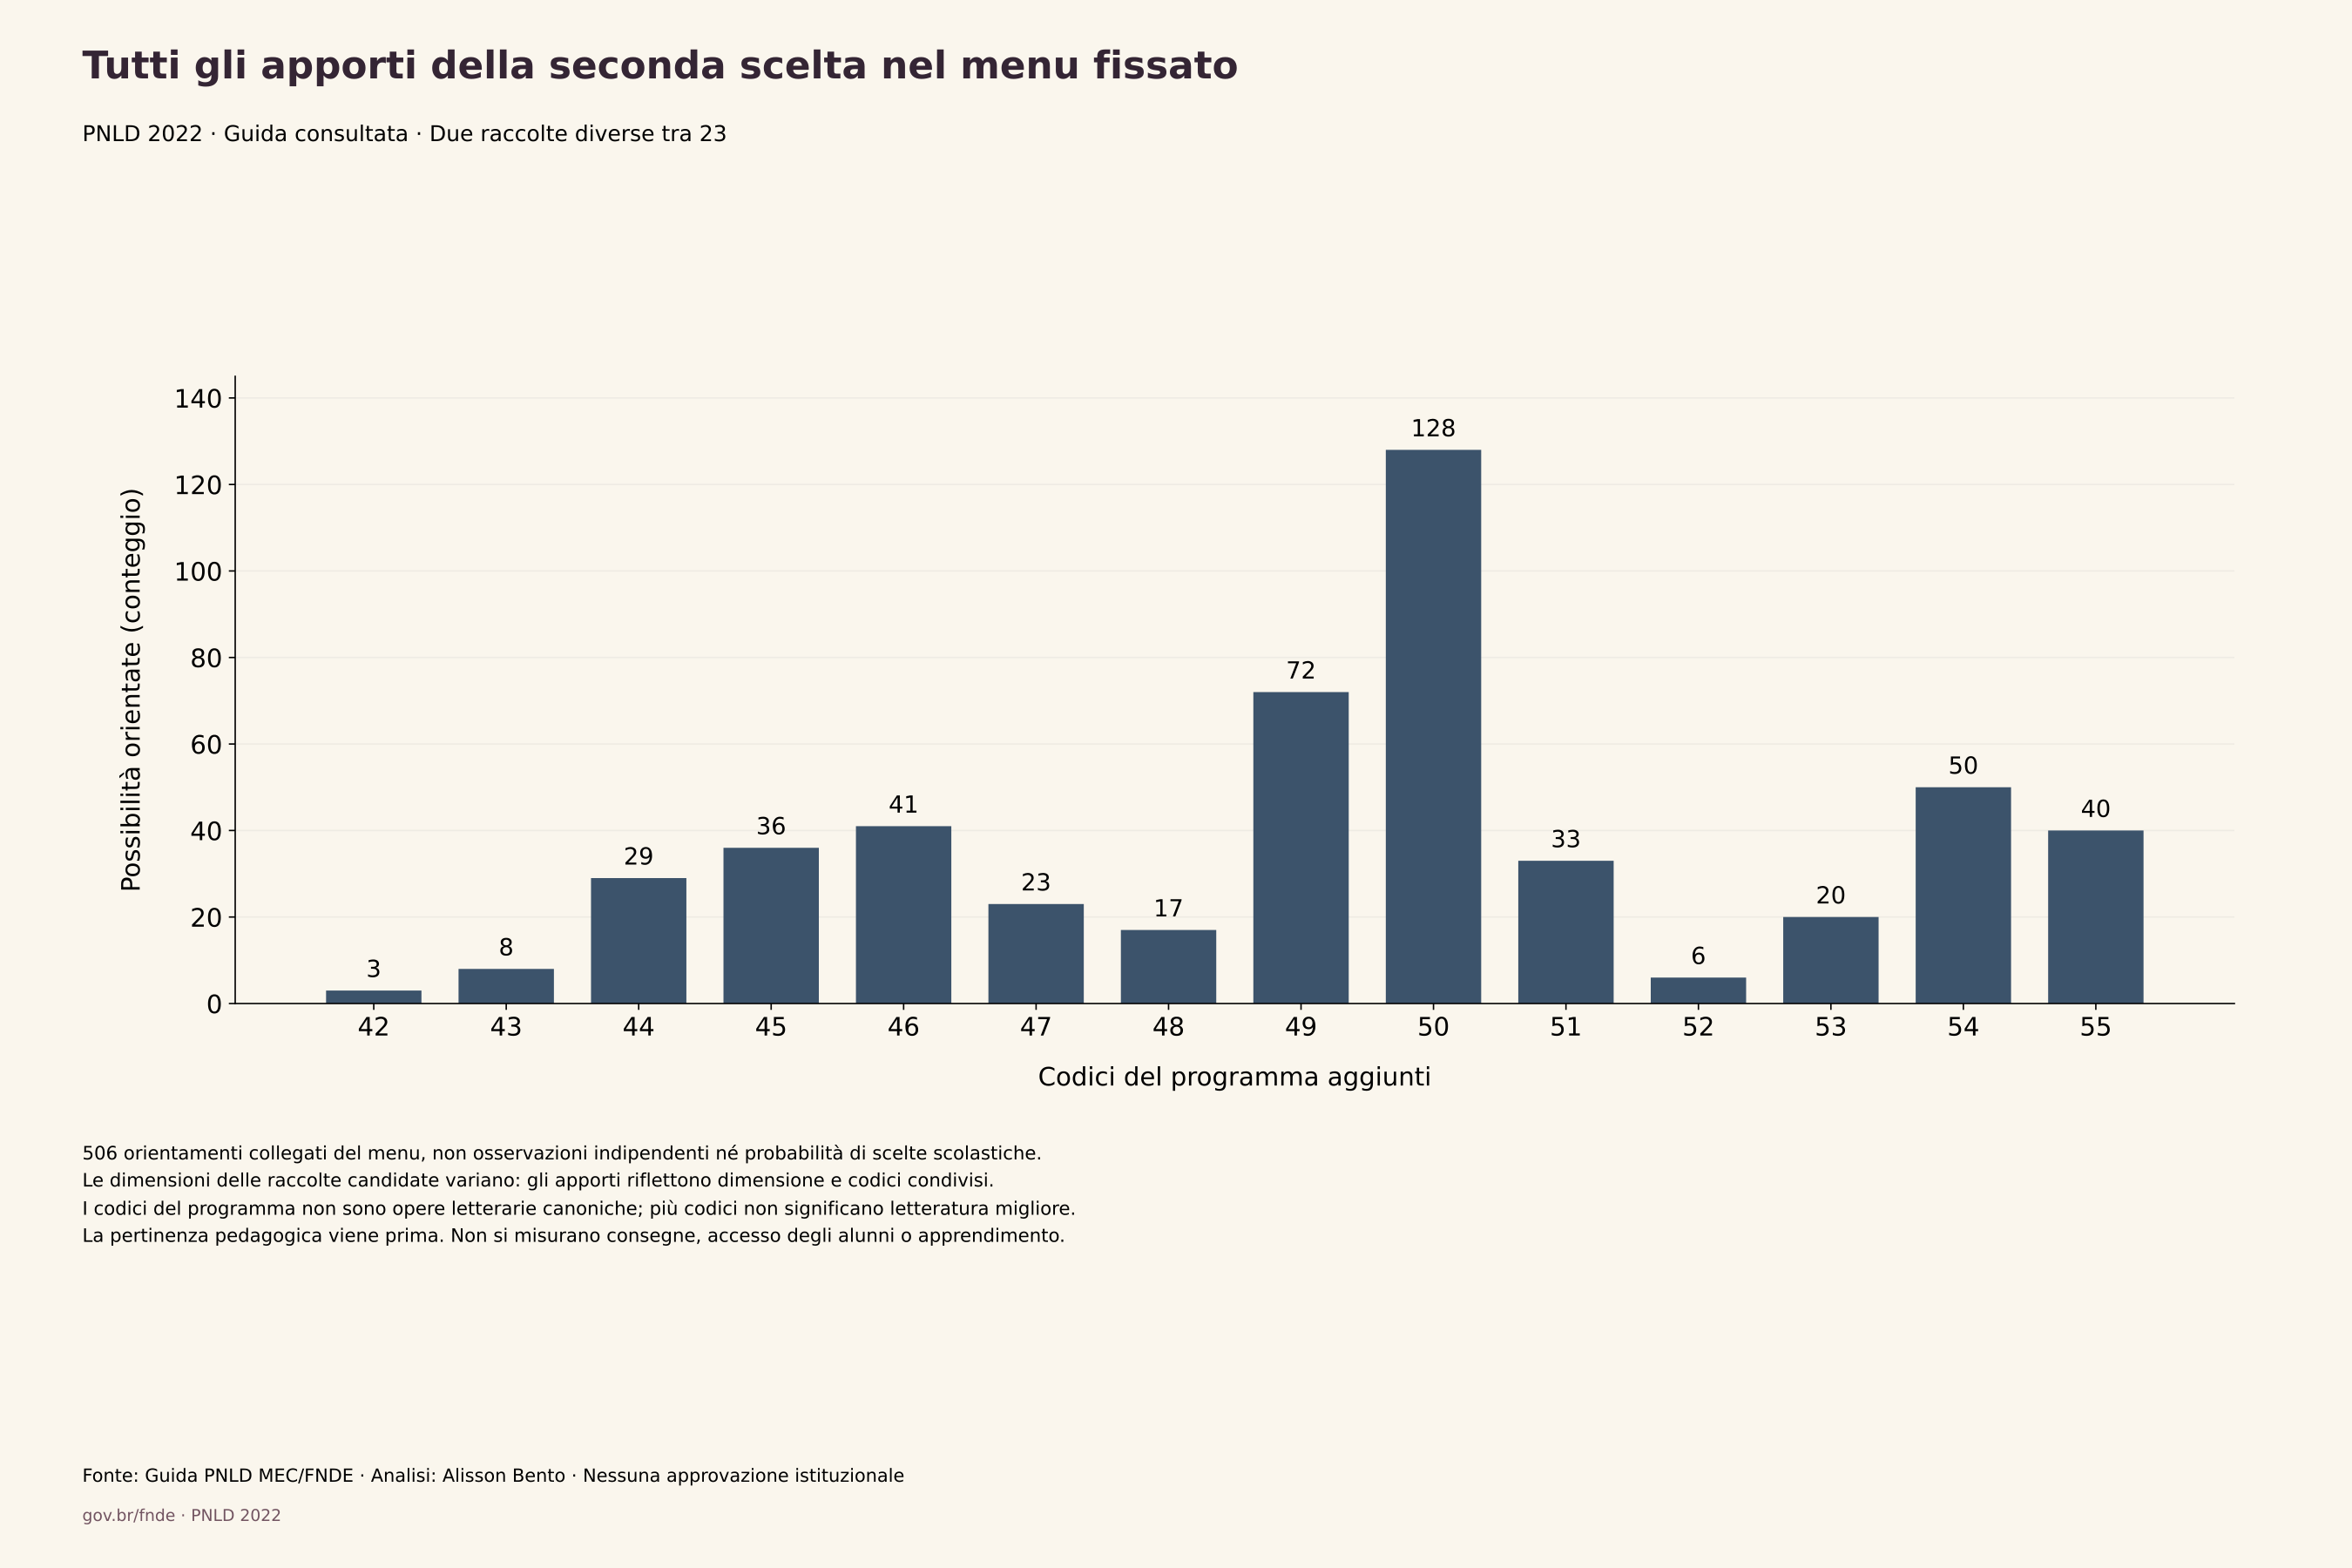
Scorri il grafico in orizzontale per esaminarlo. ↔
Grafico e valori
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Codici del programma aggiunti | Combinazioni ordinate |
|---|---|
| 42 | 3 |
| 43 | 8 |
| 44 | 29 |
| 45 | 36 |
| 46 | 41 |
| 47 | 23 |
| 48 | 17 |
| 49 | 72 |
| 50 | 128 |
| 51 | 33 |
| 52 | 6 |
| 53 | 20 |
| 54 | 50 |
| 55 | 40 |
Tutte le 506 scelte ordinate (prima e seconda), un record per ciascuna, senza smussature né classi. Sono frequenze dell’elenco, non probabilità di scelte reali delle scuole.
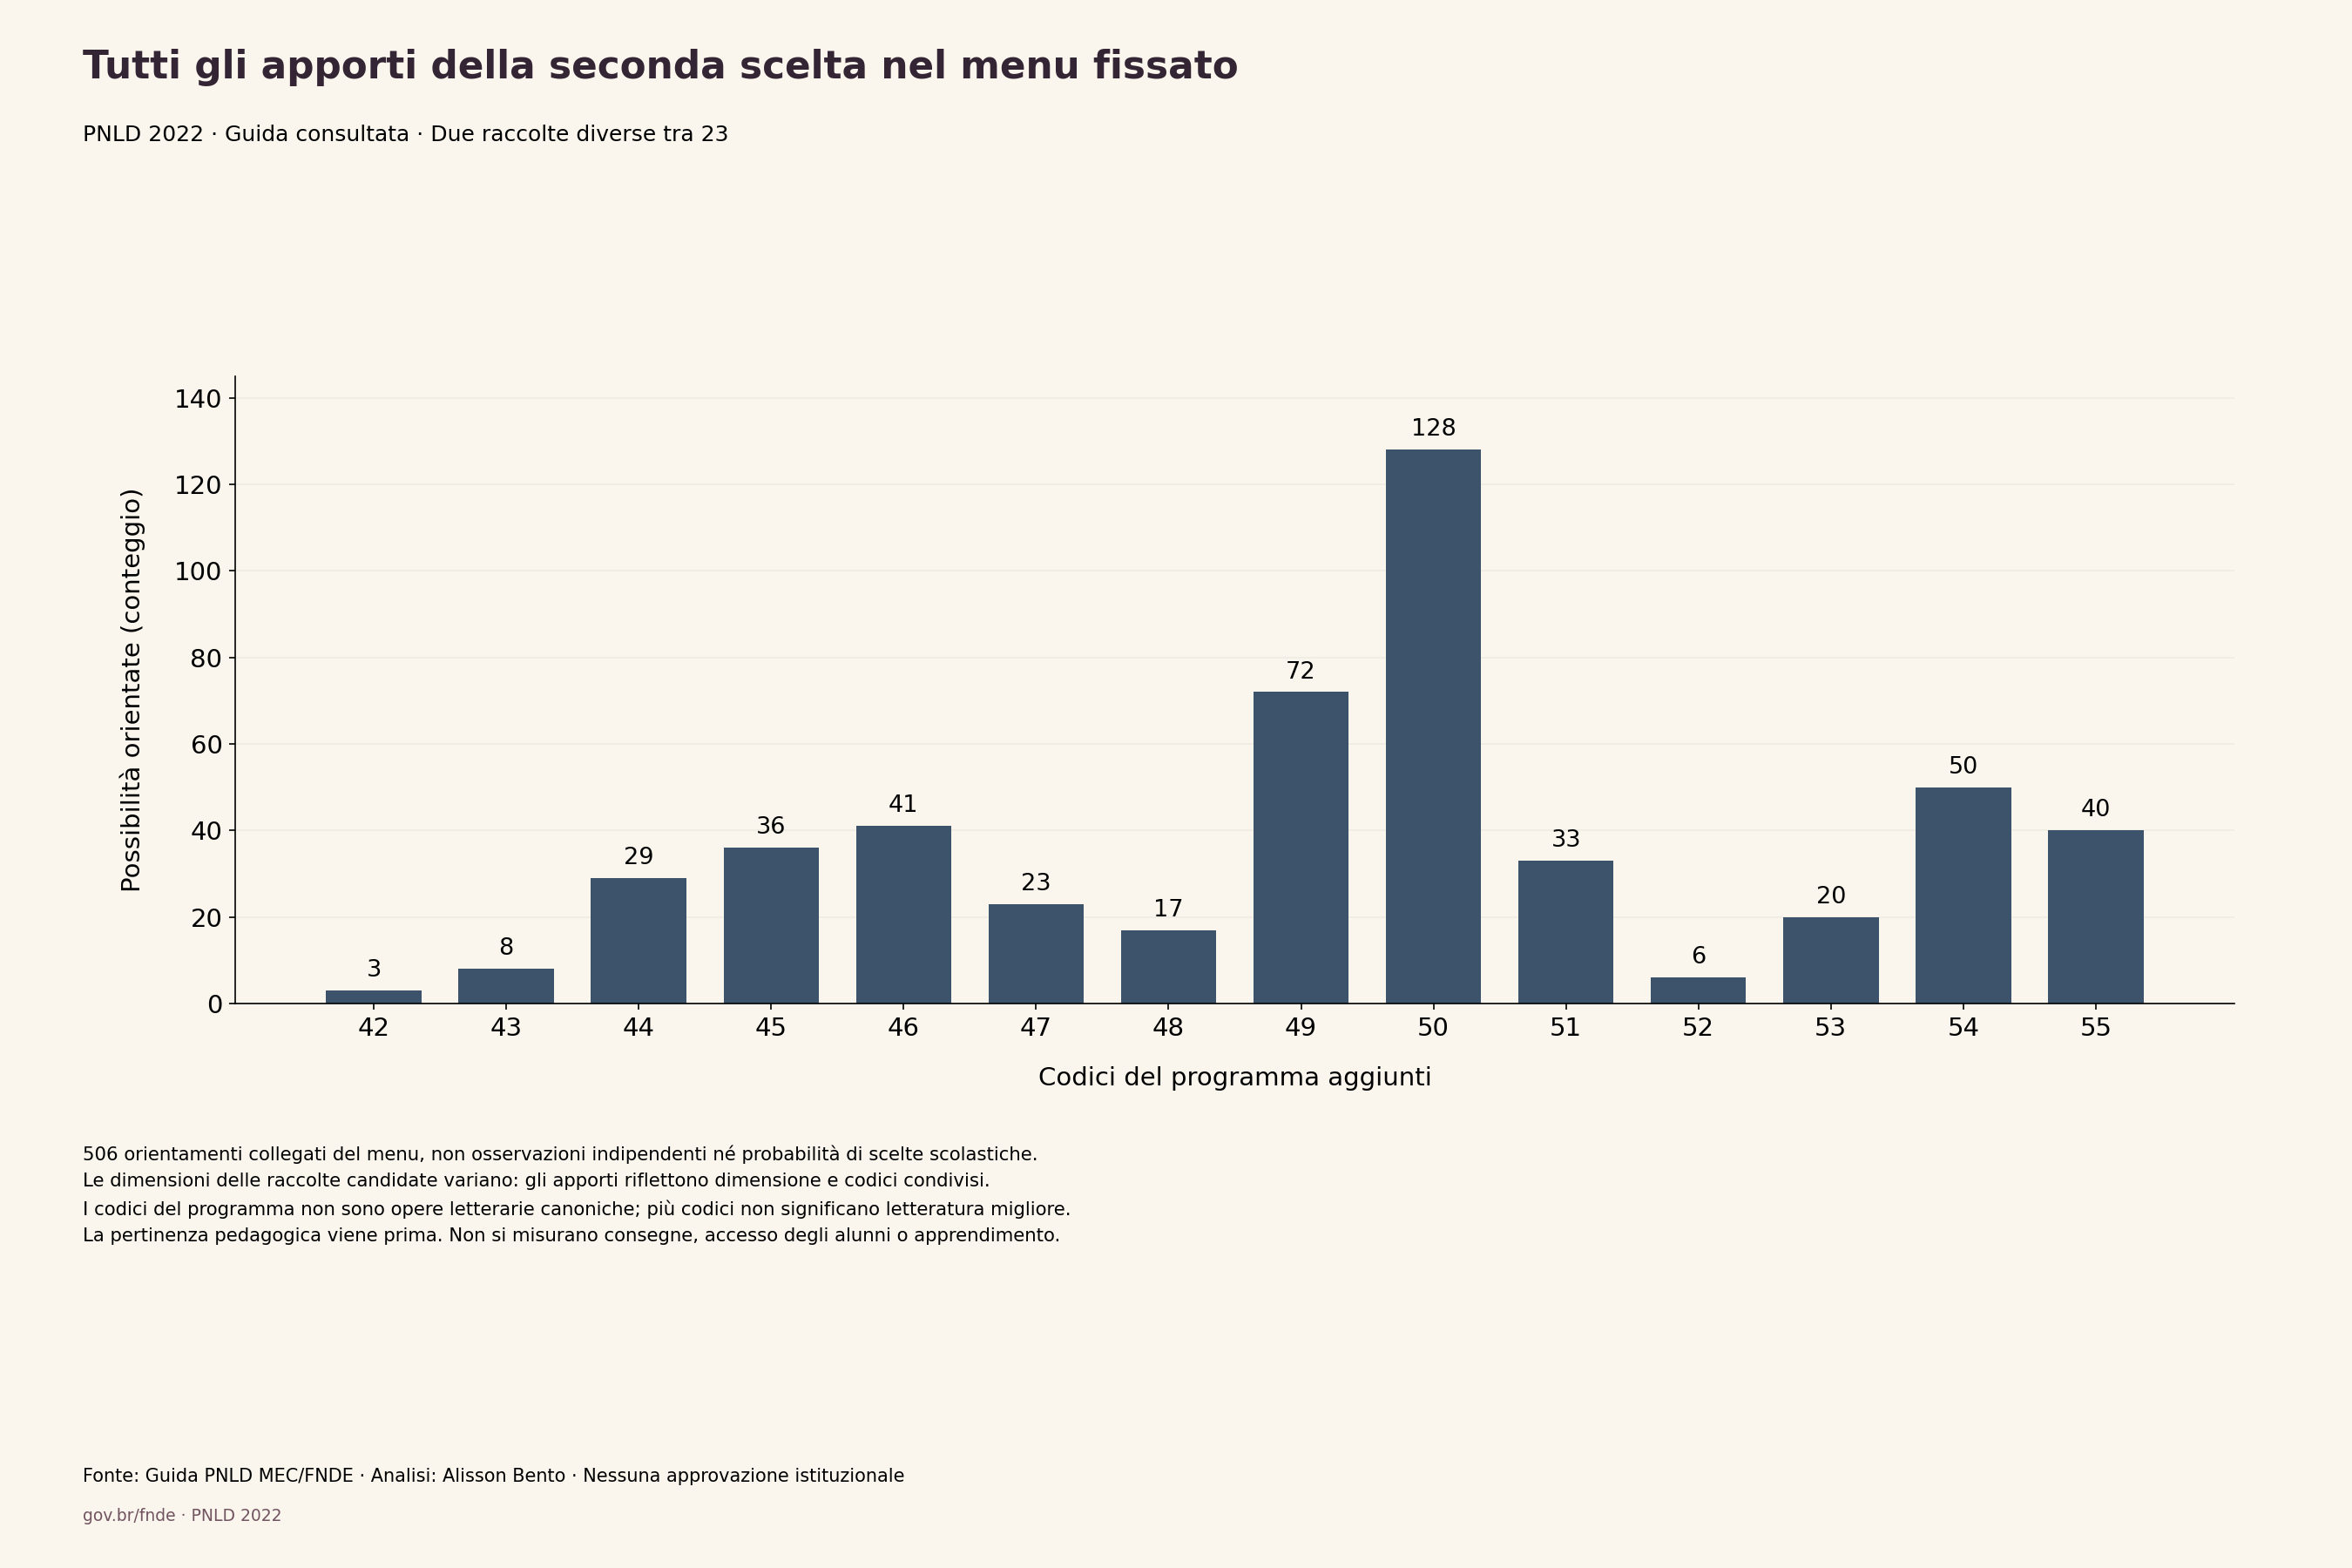
Dati e download
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Misura | Possibilità | Minimo | Mediana | Massimo |
|---|---|---|---|---|
| Codici distinti del programma in una coppia | 253 | 95 | 100 | 110 |
| Voci duplicate come quota di A (%) | 253 | 0,0 | 2,9 | 7,7 |
| Codici aggiunti dalla seconda raccolta | 506 | 42 | 50 | 55 |
Elenco completo e finito, non probabilità di scelta delle scuole. Le quote usano le voci nominali A; le percentuali sono arrotondate a un decimale. Il campo di variazione dell’ampiezza combina dimensioni diverse delle raccolte e codici duplicati.
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Prima raccolta | Categoria | Codici di partenza | Alternative | Minimo aggiunto | Mediana aggiunta | Massimo aggiunto | Codici aggiunti: scelte |
|---|---|---|---|---|---|---|---|
| 01 | Mista | 50 | 22 | 47 | 50,0 | 51 | 47: 2; 49: 7; 50: 8; 51: 5 |
| 02 | Mista | 49 | 22 | 46 | 50,0 | 52 | 46: 1; 48: 1; 49: 5; 50: 11; 51: 3; 52: 1 |
| 03 | Mista | 50 | 22 | 47 | 50,0 | 52 | 47: 1; 48: 1; 49: 7; 50: 10; 51: 2; 52: 1 |
| 04 | Mista | 49 | 22 | 48 | 50,0 | 51 | 48: 1; 49: 6; 50: 13; 51: 2 |
| 05 | Mista | 50 | 22 | 48 | 50,0 | 51 | 48: 1; 49: 8; 50: 11; 51: 2 |
| 06 | Mista | 50 | 22 | 47 | 50,0 | 51 | 47: 1; 48: 1; 49: 5; 50: 13; 51: 2 |
| 07 | Mista | 50 | 22 | 46 | 50,0 | 52 | 46: 1; 47: 1; 48: 1; 49: 6; 50: 7; 51: 5; 52: 1 |
| 08 | Mista | 50 | 22 | 48 | 50,0 | 51 | 48: 1; 49: 8; 50: 11; 51: 2 |
| 09 | Mista | 50 | 22 | 47 | 50,0 | 52 | 47: 1; 48: 2; 49: 4; 50: 13; 51: 1; 52: 1 |
| 10 | Mista | 49 | 22 | 47 | 50,0 | 52 | 47: 1; 48: 2; 49: 4; 50: 11; 51: 3; 52: 1 |
| 11 | Mista | 50 | 22 | 48 | 50,0 | 51 | 48: 2; 49: 7; 50: 10; 51: 3 |
| 12 | Mista | 49 | 22 | 48 | 50,0 | 52 | 48: 3; 49: 5; 50: 10; 51: 3; 52: 1 |
| 13 | Nido | 53 | 22 | 44 | 47,0 | 55 | 44: 5; 45: 2; 46: 2; 47: 3; 53: 1; 54: 5; 55: 4 |
| 14 | Nido | 55 | 22 | 44 | 46,5 | 55 | 44: 4; 45: 4; 46: 3; 47: 1; 53: 2; 54: 5; 55: 3 |
| 15 | Nido | 54 | 22 | 42 | 47,0 | 55 | 42: 1; 44: 4; 45: 2; 46: 1; 47: 4; 53: 2; 54: 4; 55: 4 |
| 16 | Nido | 55 | 22 | 44 | 46,0 | 55 | 44: 4; 45: 3; 46: 5; 53: 2; 54: 5; 55: 3 |
| 17 | Nido | 54 | 22 | 43 | 46,5 | 55 | 43: 1; 44: 2; 45: 4; 46: 4; 47: 1; 53: 2; 54: 4; 55: 4 |
| 18 | Nido | 55 | 22 | 43 | 46,5 | 55 | 43: 1; 44: 2; 45: 5; 46: 3; 47: 1; 53: 2; 54: 5; 55: 3 |
| 19 | Scuola dell’infanzia | 54 | 22 | 43 | 46,5 | 55 | 43: 1; 44: 3; 45: 2; 46: 5; 47: 1; 53: 2; 54: 4; 55: 4 |
| 20 | Scuola dell’infanzia | 53 | 22 | 42 | 47,5 | 55 | 42: 1; 44: 3; 45: 2; 46: 4; 47: 1; 48: 1; 53: 1; 54: 5; 55: 4 |
| 21 | Scuola dell’infanzia | 55 | 22 | 43 | 46,5 | 55 | 43: 2; 44: 1; 45: 4; 46: 4; 47: 1; 53: 2; 54: 5; 55: 3 |
| 22 | Scuola dell’infanzia | 54 | 22 | 42 | 46,5 | 55 | 42: 1; 43: 1; 45: 4; 46: 5; 47: 1; 53: 2; 54: 4; 55: 4 |
| 23 | Scuola dell’infanzia | 54 | 22 | 43 | 47,0 | 55 | 43: 2; 44: 1; 45: 4; 46: 3; 47: 2; 53: 2; 54: 4; 55: 4 |
Ogni riga fissa la prima raccolta e conserva tutte le 22 alternative diverse. Notazione delle frequenze: codici aggiunti: numero di scelte candidate. La categoria è un’informazione di contesto della fonte, non una graduatoria né una regola di adeguatezza universale. Variano sia le dimensioni delle candidate sia la sovrapposizione.
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Codici del programma aggiunti | Combinazioni ordinate |
|---|---|
| 42 | 3 |
| 43 | 8 |
| 44 | 29 |
| 45 | 36 |
| 46 | 41 |
| 47 | 23 |
| 48 | 17 |
| 49 | 72 |
| 50 | 128 |
| 51 | 33 |
| 52 | 6 |
| 53 | 20 |
| 54 | 50 |
| 55 | 40 |
Tutte le 506 scelte ordinate (prima e seconda), un record per ciascuna, senza smussature né classi. Sono frequenze dell’elenco, non probabilità di scelte reali delle scuole.
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Elemento | Ambito verificato |
|---|---|
| Raccolte | 23 |
| Pagine delle tabelle della fonte | 62 (PDF 59–120) |
| Occorrenze di codici elencate | 1.192 |
| Campi riconciliati per occorrenza | 7 |
| Coppie non ordinate di raccolte distinte | 253 |
| Seconde scelte ordinate | 506 |
| Alternative per ogni prima raccolta | 22 |
| Codici duplicati nella stessa raccolta | 0 |
| Conflitti nei campi descrittivi dei codici ripetuti | 0 |
L’oggetto misurato è la copia della guida, non i libri consegnati né le iscrizioni. Il numero di pagine e di occorrenze descrive la copertura dell’estrazione, non l’apprendimento né l’accesso.
Dati e metodo
Come abbiamo calcolato
- Si è fissato l’esempio documentato nel manuale: scegliere due raccolte diverse tra le 23 dell’elenco; nessun risultato per numeri di raccolte maggiori.
- Si sono conservate le stringhe complete dei codici del programma; nessuna unione di titoli, nessuna decodifica dei suffissi, nessuna deduzione su opere letterarie canoniche.
- Si è controllata ogni pagina delle tabelle con le raccolte; due metodi di estrazione indipendenti hanno riconciliato 1.192 occorrenze su sette campi.
- Si sono enumerate tutte le 253 coppie non ordinate e le 506 combinazioni ordinate; la quota di duplicati D/A e le mediane, calcolate come frazioni esatte, mantengono i risultati uguali.
- Si pubblicano tutte le 23 distribuzioni condizionali e i dati minimi (raccolta, codice, pagina) per la riproduzione, con una replica numerica indipendente.
Cosa non possiamo dedurre dai dati
- Questa copia consultata della guida non è una ricostruzione storica verificata del catalogo al momento della scelta originale.
- I codici identificano elementi bibliografici elencati dal programma, non necessariamente opere letterarie canoniche diverse.
- L’esempio di due scelte nella fonte non dimostra che tutte le scuole abbiano la stessa assegnazione né che ogni coppia sia adatta sul piano pedagogico.
- Le dimensioni delle raccolte variano da 49 a 55: né il campo di variazione complessivo né quello degli incrementi condizionali dipendono solo dalla sovrapposizione.
- Nessuna scelta osservata, spedizione, copia ricevuta, inventario scolastico, collegamento con le iscrizioni, misura di accesso o risultato di apprendimento.
- La differenza tra 49–55 (guida e manuale del 2023) e 53–55 (avviso) resta una discrepanza; la data di generazione del PDF non è una data di revisione accertata.
- Gli studi tematici precedenti sono riconosciuti; la tesi completa di Faria non era disponibile, quindi non si avanza alcuna pretesa esaustiva di novità.
Fonti originali
- MEC/FNDE: complete PNLD 2022 Educação Infantil literary guide
Guida completa consultata; tabelle delle raccolte alle pagine 59–120 del PDF. La generazione del file nel luglio 2025 non è una data di revisione accertata. Codici esatti del programma, non identità di opere letterarie canoniche.
Consultato il 30 ottobre 2026
- FNDE: manual for registering PNLD 2022 early-childhood literary choices
Le pagine 12, 17–18 del PDF effettivo indicano i campi dei codici, l’intervallo 49–55 e l’esempio illustrativo di selezione di due raccolte diverse su 23. Non provano che tutte le scuole abbiano due raccolte né che siano adatte.
Consultato il 30 ottobre 2026
- FNDE: PNLD 2022 literary choice notice
Avviso pubblicato l’8 settembre 2023 e modificato il 7 novembre 2023: descrive 53–55 opere, a differenza di 49–55 nella guida e nel manuale del 2023. Si mantiene come discrepanza tra fonti, non come revisione nel tempo dimostrata.
Consultato il 30 ottobre 2026
- CEFET-MG: Faria dissertation defence abstract on indigenous representation in PNLD 2022
Il riassunto ufficiale indicizzato e gli estratti della tesi mostrano una ricerca precedente molto vicina sulla copertura tematica. La tesi completa non era disponibile per la consultazione; non si afferma di aver escluso ogni analisi che contiene.
Consultato il 30 ottobre 2026
- Manfré and Rozzi 2026: PNLD 2022 literary collections and young children’s formation
Studio qualitativo su opere narrative selezionate dalle raccolte per la scuola dell’infanzia 19–23; ricerca precedente pertinente, non un’analisi di tutte le coppie per codici esatti.
Consultato il 30 ottobre 2026
Citare e riutilizzare lo studio
Alisson Bento. “Due raccolte PNLD: quanto cambia l’ampiezza in codici del programma.” Ricerca originale, 2026. Copia consultata della guida ufficiale PNLD 2022 Educação Infantil; accesso il 30 ottobre 2026. https://alissonbento.com/it/research/brazil-pnld-two-collection-code-breadth-2022/
Informazioni di origine: guida ufficiale e manuale di scelta PNLD 2022 del MEC/FNDE, con collegamenti alle fonti e impronte digitali dei file. Estrazione originale dell’appartenenza per codice, calcoli e spiegazione: Alisson Bento. Non si implica alcuna approvazione istituzionale. Recensioni della guida, illustrazioni, testi letterari, identificativi personali degli editori, registri scolastici e dati sui bambini non vengono ridistribuiti.
Correzioni o domande editoriali