Un vrai choix, une réponse volontairement étroite
Le programme littéraire PNLD 2022 pour la petite enfance permet de distinguer deux choses : recevoir un certain nombre de collections, et choisir combien de références différentes ces collections contiennent. Son manuel officiel d’inscription donne l’exemple d’une école qui choisit deux collections différentes dans un menu de vingt-trois. Cet exemple fournit la décision étudiée ici. Il ne prouve pas que toutes les écoles ont le même droit de choix, que toutes les combinaisons conviennent sur le plan pédagogique, ni que les collections choisies ont ensuite été livrées. L’analyse s’en tient au menu documenté et aux informations disponibles pour comparer deux choix distincts.
Sur les 253 paires sans ordre du guide récupéré, le nombre de codes du programme différents va de 95 à 110, avec une médiane de 100. Ce ne sont pas des nombres d’œuvres littéraires reconnues comme telles, d’enfants touchés ou de livres lus. Les quinze codes d’écart ne viennent pas non plus tous des doublons : les collections elles-mêmes contiennent des nombres de références différents. Il est donc essentiel de séparer la taille des collections et les codes présents dans les deux. Présenter chaque différence comme une répétition inutile fausserait à la fois le calcul et l’intérêt pédagogique d’avoir plusieurs exemplaires.
La question pratique est donc modeste. Une fois une première collection choisie pour des raisons éducatives, de combien peut varier le nombre de codes ajoutés selon l’une des vingt-deux autres collections ? La réponse donne une information pour décider, sans remplacer le jugement professionnel par un calcul. Un ajout plus faible peut très bien accompagner des histoires, une langue, des illustrations ou des occasions de travail en classe mieux adaptées. Les tableaux donnent toutes les comparaisons pour chaque première collection, au lieu de ne retenir que quelques combinaisons qui impressionnent. Rien ici ne recommande de maximiser le nombre de codes au détriment d’un choix pédagogique cohérent.
Ce que la source permet d’identifier, et ce qu’elle ne permet pas
La source est le guide littéraire officiel complet du PNLD 2022 pour l’éducation de la petite enfance (Educação Infantil), récupéré sur le stockage de publications de l’UFAL. Ses tableaux de collections donnent un éditeur, le titre d’une référence avec son code du programme, et un code de genre. Les vingt-trois menus sont étiquetés « mixte », « crèche » ou « préscolaire ». L’étude garde chaque code du programme imprimé comme une chaîne de caractères exacte, avec les zéros initiaux et le suffixe complet. Elle ne décode pas la structure des codes et ne réunit pas des entrées codées différemment parce que leurs titres se ressemblent. L’unité de travail est une référence bibliographique inscrite au programme, pas une œuvre établie de façon indépendante.
Cette distinction compte dans les deux sens. Des codes différents peuvent désigner des éditions, des formats ou des variantes du programme liés à une même œuvre. À l’inverse, des titres identiques peuvent appartenir à des œuvres différentes. Cet audit ne tranche ni l’un ni l’autre en devinant d’après les mots. Pour les occurrences d’un même code exact, le titre, l’éditeur et le genre imprimés ont été comparés : les tableaux extraits ne montrent aucun conflit. Cette vérification justifie de rapprocher le même identifiant listé d’une collection à l’autre. Elle ne fait pas de l’identifiant une définition générale de l’identité d’une œuvre en dehors de cette source.
Les tableaux récupérés contiennent des collections de 49 à 55 entrées codées. Le manuel officiel indique aussi cette fourchette, alors que l’avis conservé du FNDE parle de 53 à 55 œuvres. Les deux affirmations sont gardées, sans les harmoniser en silence. Le fichier du guide porte une date de génération de juillet 2025, mais ce n’est pas la preuve d’une révision officielle du catalogue : un manuel créé en octobre 2023 donne déjà la fourchette la plus large. Les résultats désignent la version exacte du guide récupérée et son empreinte. On ne doit pas les présenter comme la reconstitution vérifiée de tout ce qui était affiché à la date du choix initial.
Séparer les entrées affichées, les codes différents et les codes répétés
Pour deux collections, notons A le nombre total d’entrées listées, c’est-à-dire la somme de leurs tailles. Notons B le nombre de codes du programme différents dans leur réunion. La différence D = A − B est le nombre d’entrées répétées d’une collection à l’autre. Comme aucune collection ne contient un code deux fois, D est aussi la taille de l’intersection des deux ensembles de codes. C’est de la simple comptabilité d’ensembles, mais elle évite un raccourci courant : deux collections ne sont pas deux livres isolés, et leur contenu n’est pas forcément la somme de leurs identifiants listés distincts.
La part d’entrées en double a A pour dénominateur. Si un code apparaît une fois dans chacune des deux collections choisies, il compte deux entrées dans A, un code dans B et une entrée répétée dans D. Cette part mesure donc de combien le total d’entrées affichées dépasse le nombre de codes différents. Elle ne veut pas dire que l’exemplaire répété est inutile. Des exemplaires en double peuvent permettre des lectures simultanées, des lieux séparés, des rencontres répétées ou des remplacements, et les données du menu ne mesurent rien de cela. Qualifier D de gaspillage, de perte d’apprentissage ou de privation attacherait un jugement de valeur sans fondement à une grandeur comptable.
Sur toutes les paires possibles, la part d’entrées en double va de zéro à un treizième, soit environ 7,7 %, avec une médiane d’un trente-cinquième, soit environ 2,9 %. Avec cette définition, la duplication est modeste ; ce n’est pas la preuve que le programme répète surtout le même matériel. L’écart du nombre de codes différents doit aussi se lire avec la variation de 49 à 55 des tailles de départ. Plus d’entrées affichées peut augmenter le nombre de codes, tandis que les codes communs réduisent l’ajout par rapport à ce total. La relation entre A, B et D est plus instructive que de présenter le maximum et le minimum comme un pur effet de duplication.
Énumérer tout le menu de deux collections
On a vingt-trois choix pour une collection et vingt-deux choix différents pour l’autre. Le produit divisé par deux donne 253 paires sans ordre, car choisir A avec B donne le même ensemble de codes que choisir B avec A. Chaque paire figure une fois dans le tableau des paires, y compris quand les résultats sont à égalité. Cette énumération est finie ; ce n’est pas un échantillon de décisions d’écoles. Elle n’a pas besoin d’un intervalle de confiance pour l’erreur d’échantillonnage, et sa médiane n’estime pas ce que l’école typique a choisi ou reçu.
La médiane de 100 codes différents est le résultat de la paire du milieu quand on trie les 253 valeurs. Le minimum de 95 et le maximum de 110 encadrent la comparaison mathématique documentée ; ils ne garantissent rien sur les choix admissibles ou souhaitables pour chaque école. L’exemple de deux choix du manuel fournit le cas pratique, et les étiquettes des collections restent un contexte important. Rien dans cette analyse n’établit que chaque combinaison conviendrait à chaque tranche d’âge ou à chaque projet éducatif. Le menu commun permet une comparaison d’information. Il ne remplace pas les instructions du programme et ne conseille pas aux éducateurs d’ignorer l’adéquation pédagogique.
Traiter toutes les paires de la même façon est utile, car cela évite de choisir des combinaisons après avoir vu leurs résultats. Il ne faut pas y voir un modèle de comportement où les écoles choisiraient au hasard, avec la même probabilité. Certaines combinaisons peuvent être bien plus attrayantes ou appropriées que d’autres, mais la source ne donne aucun poids de préférence observé. Il n’y a pas non plus de tendance dans le temps : tous les résultats viennent d’un seul menu récupéré. Le téléchargement complet des paires rend la comptabilité vérifiable, sans prétendre que ces possibilités sont des observations indépendantes de choix réels, de livraisons ou de lectures.
Pourquoi le sens du second choix compte
Une même paire sans ordre a deux points de départ possibles. Si une collection est déjà choisie, l’apport de l’autre est le nombre de ses codes absents de la première. Cet apport est égal à la taille de la seconde collection candidate moins les codes qu’elle partage avec la collection choisie. Inverser le point de départ peut changer l’apport, alors que le nombre total de codes différents reste le même. Garder les deux sens donne 506 comparaisons orientées. Ce sont des vues liées des mêmes 253 paires, et non un jeu de données supplémentaire ni une confirmation indépendante des résultats.
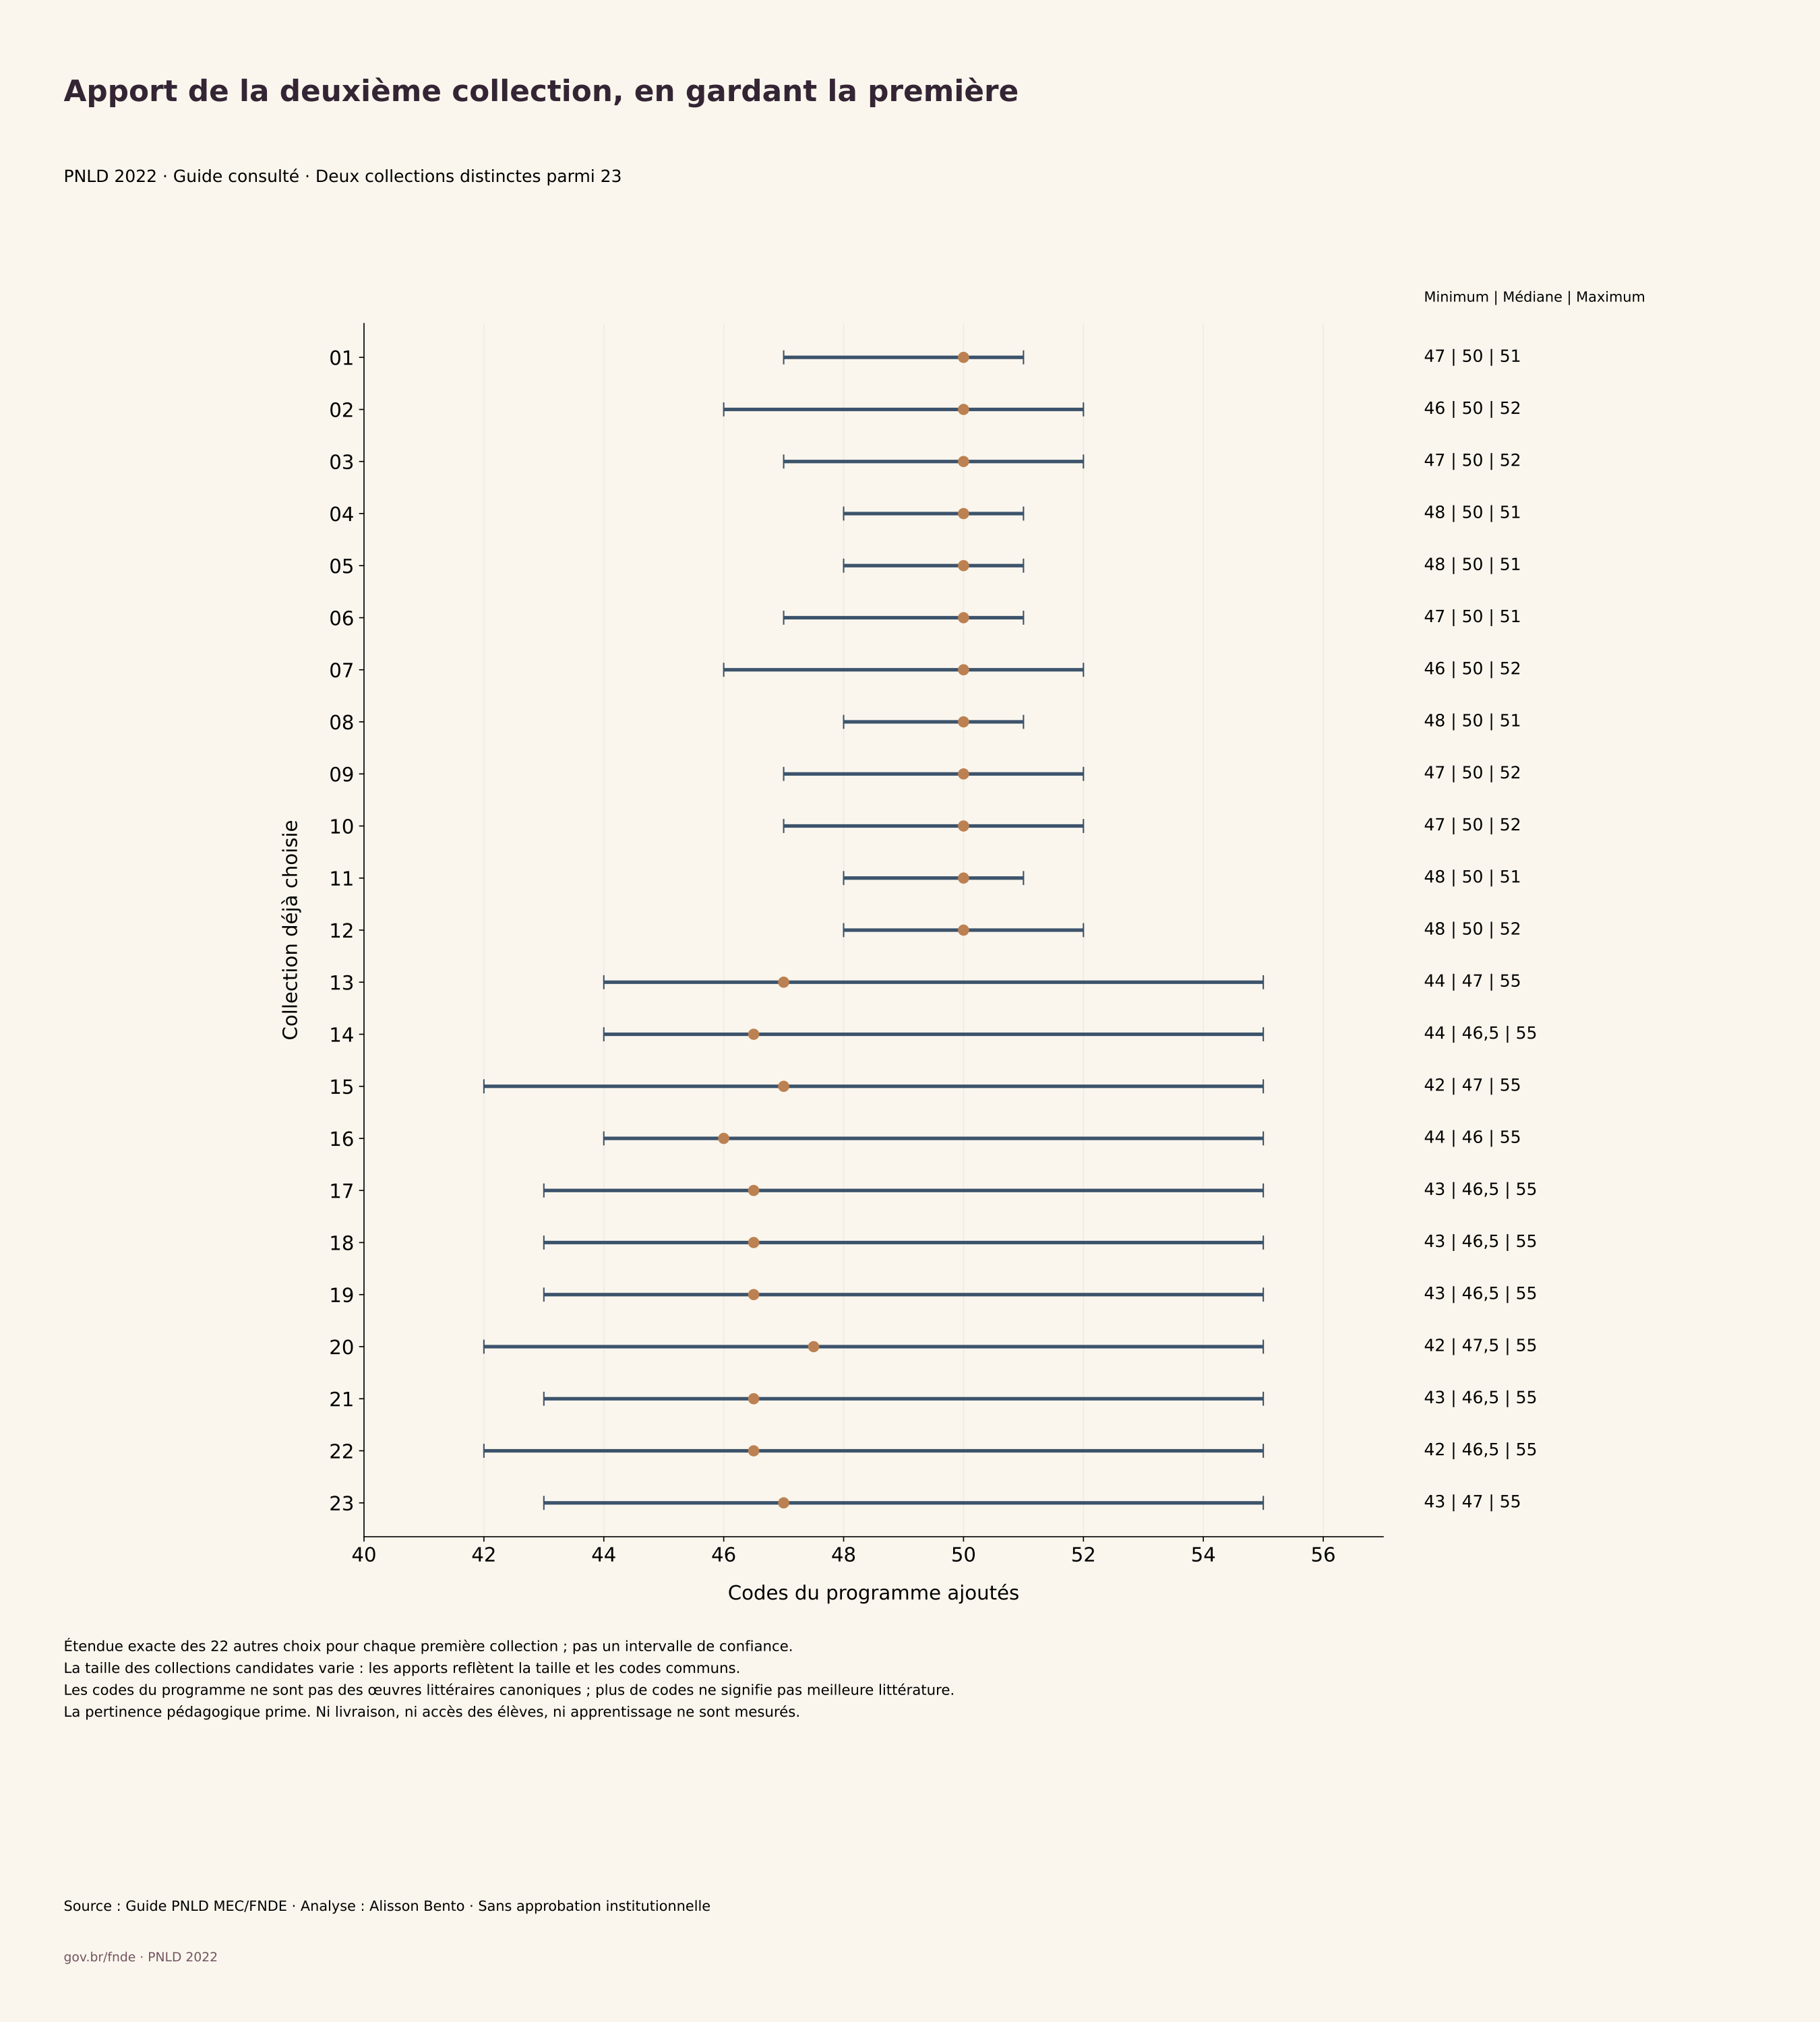
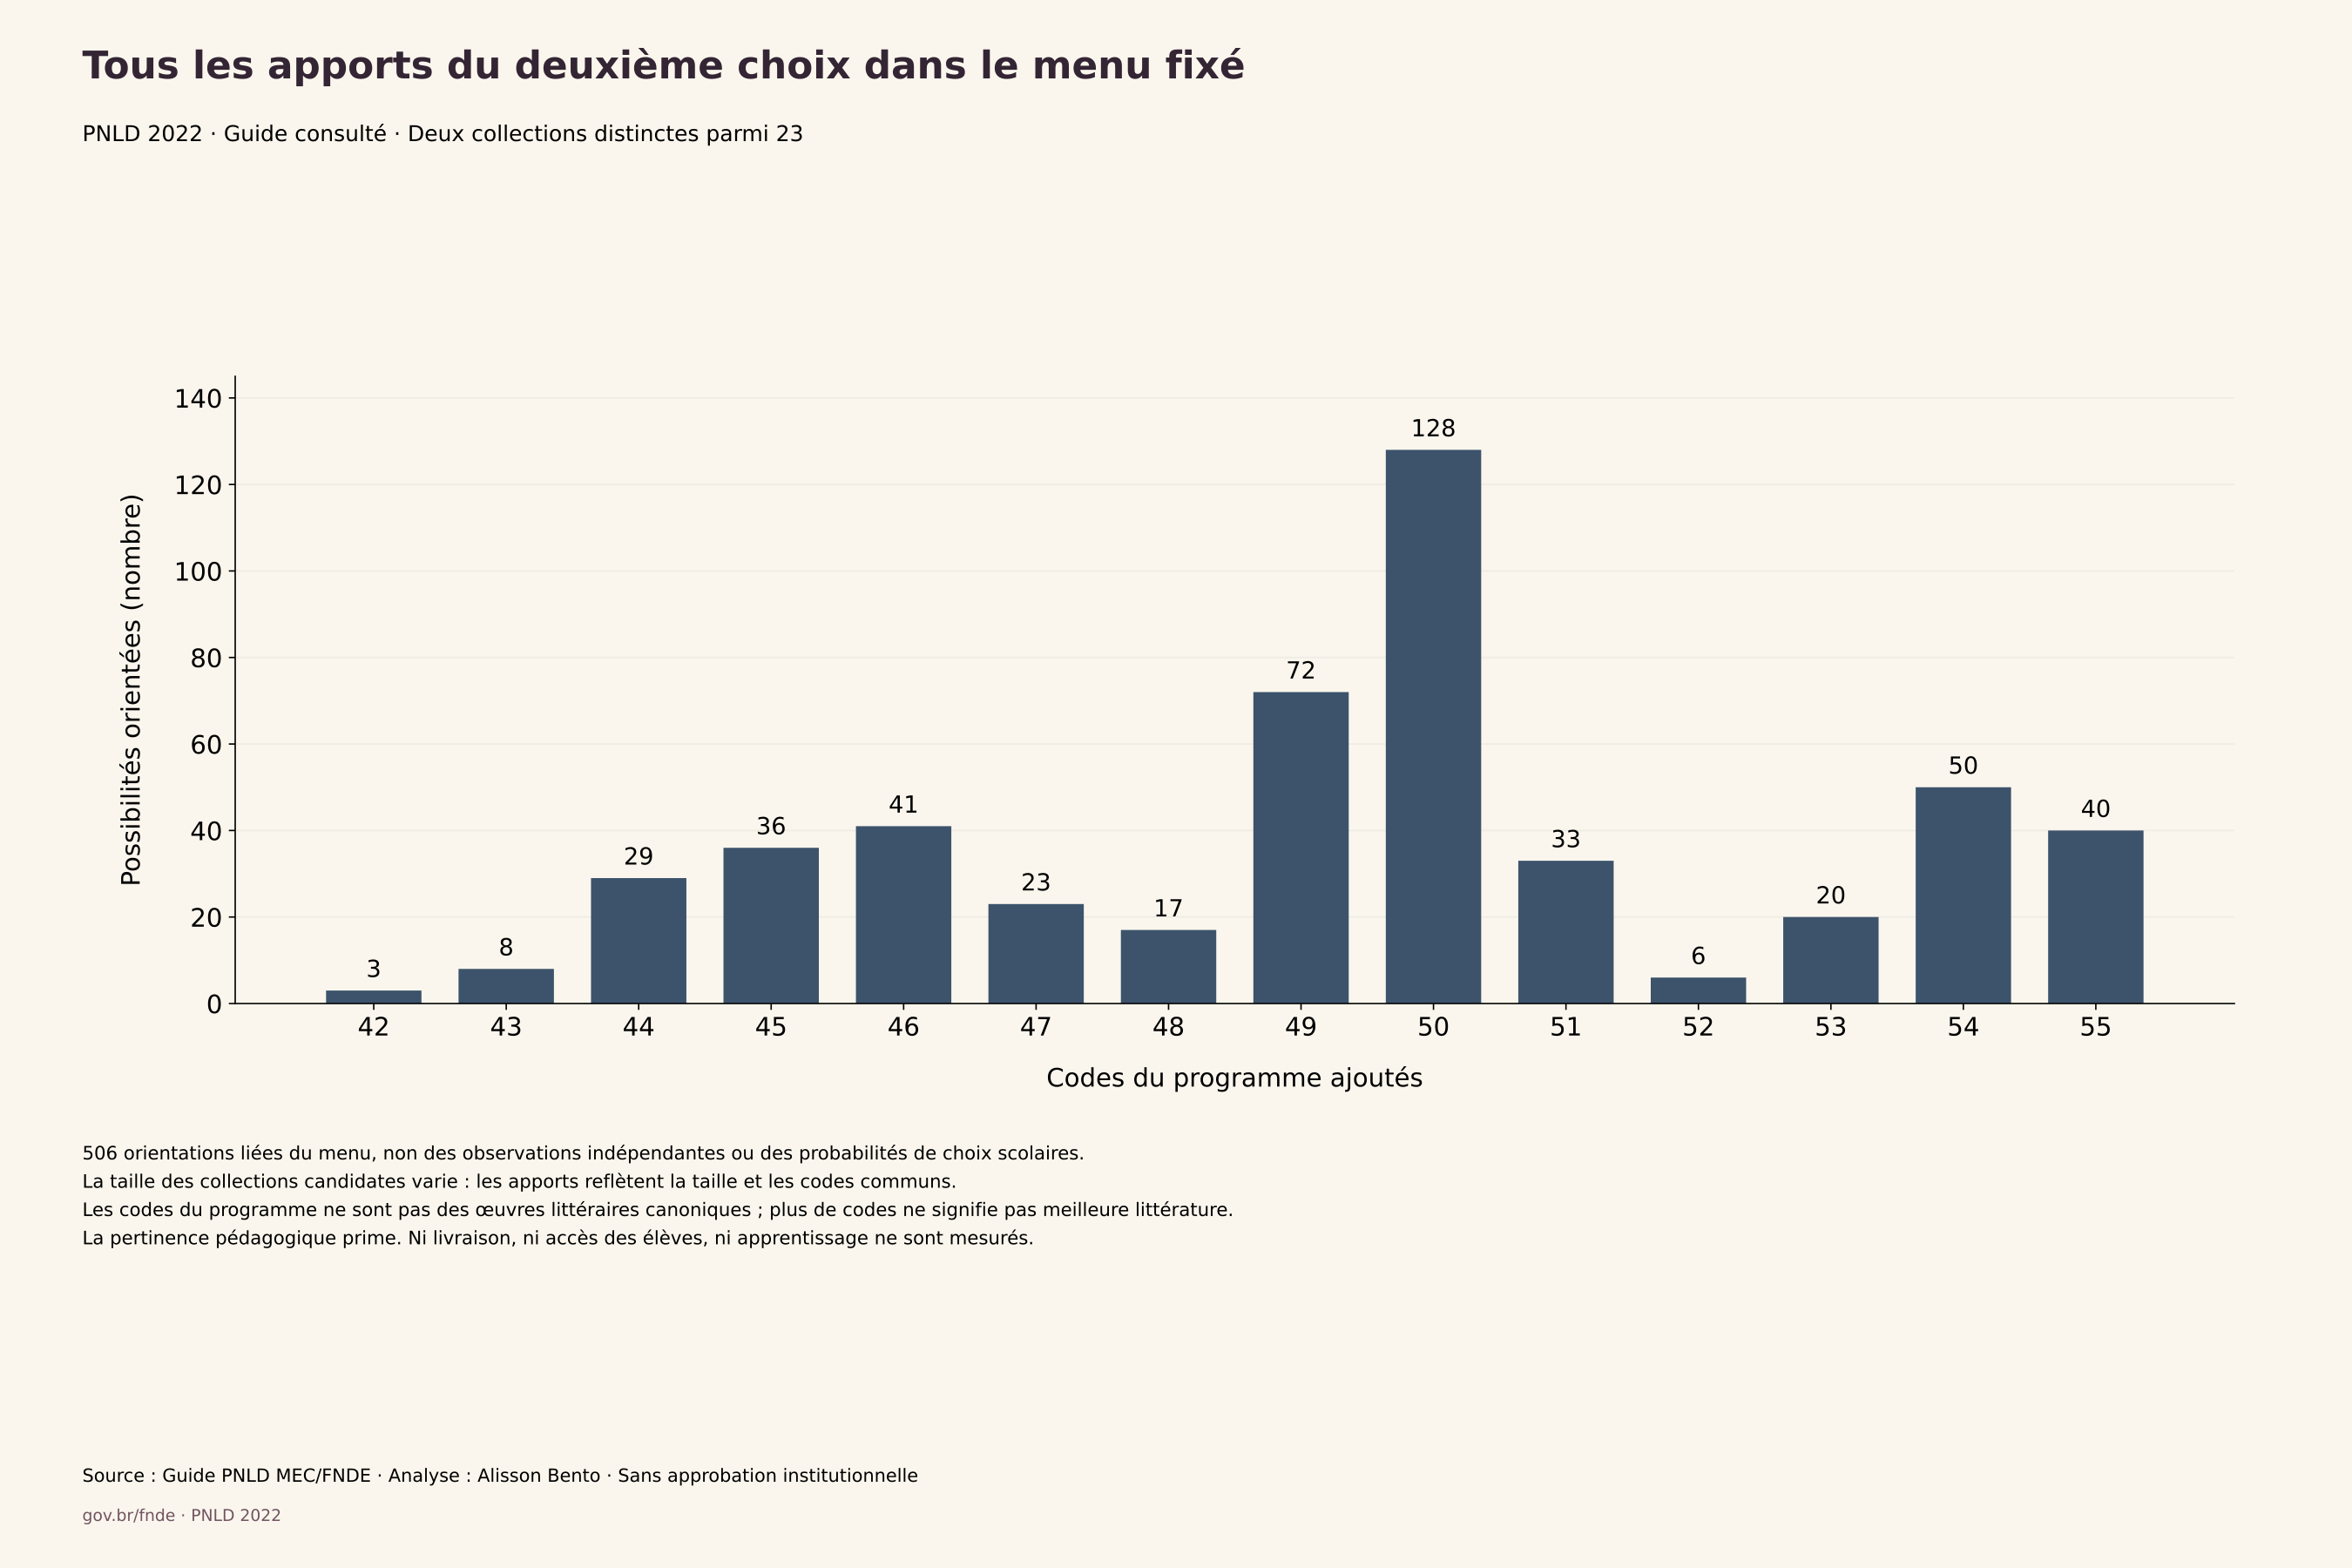
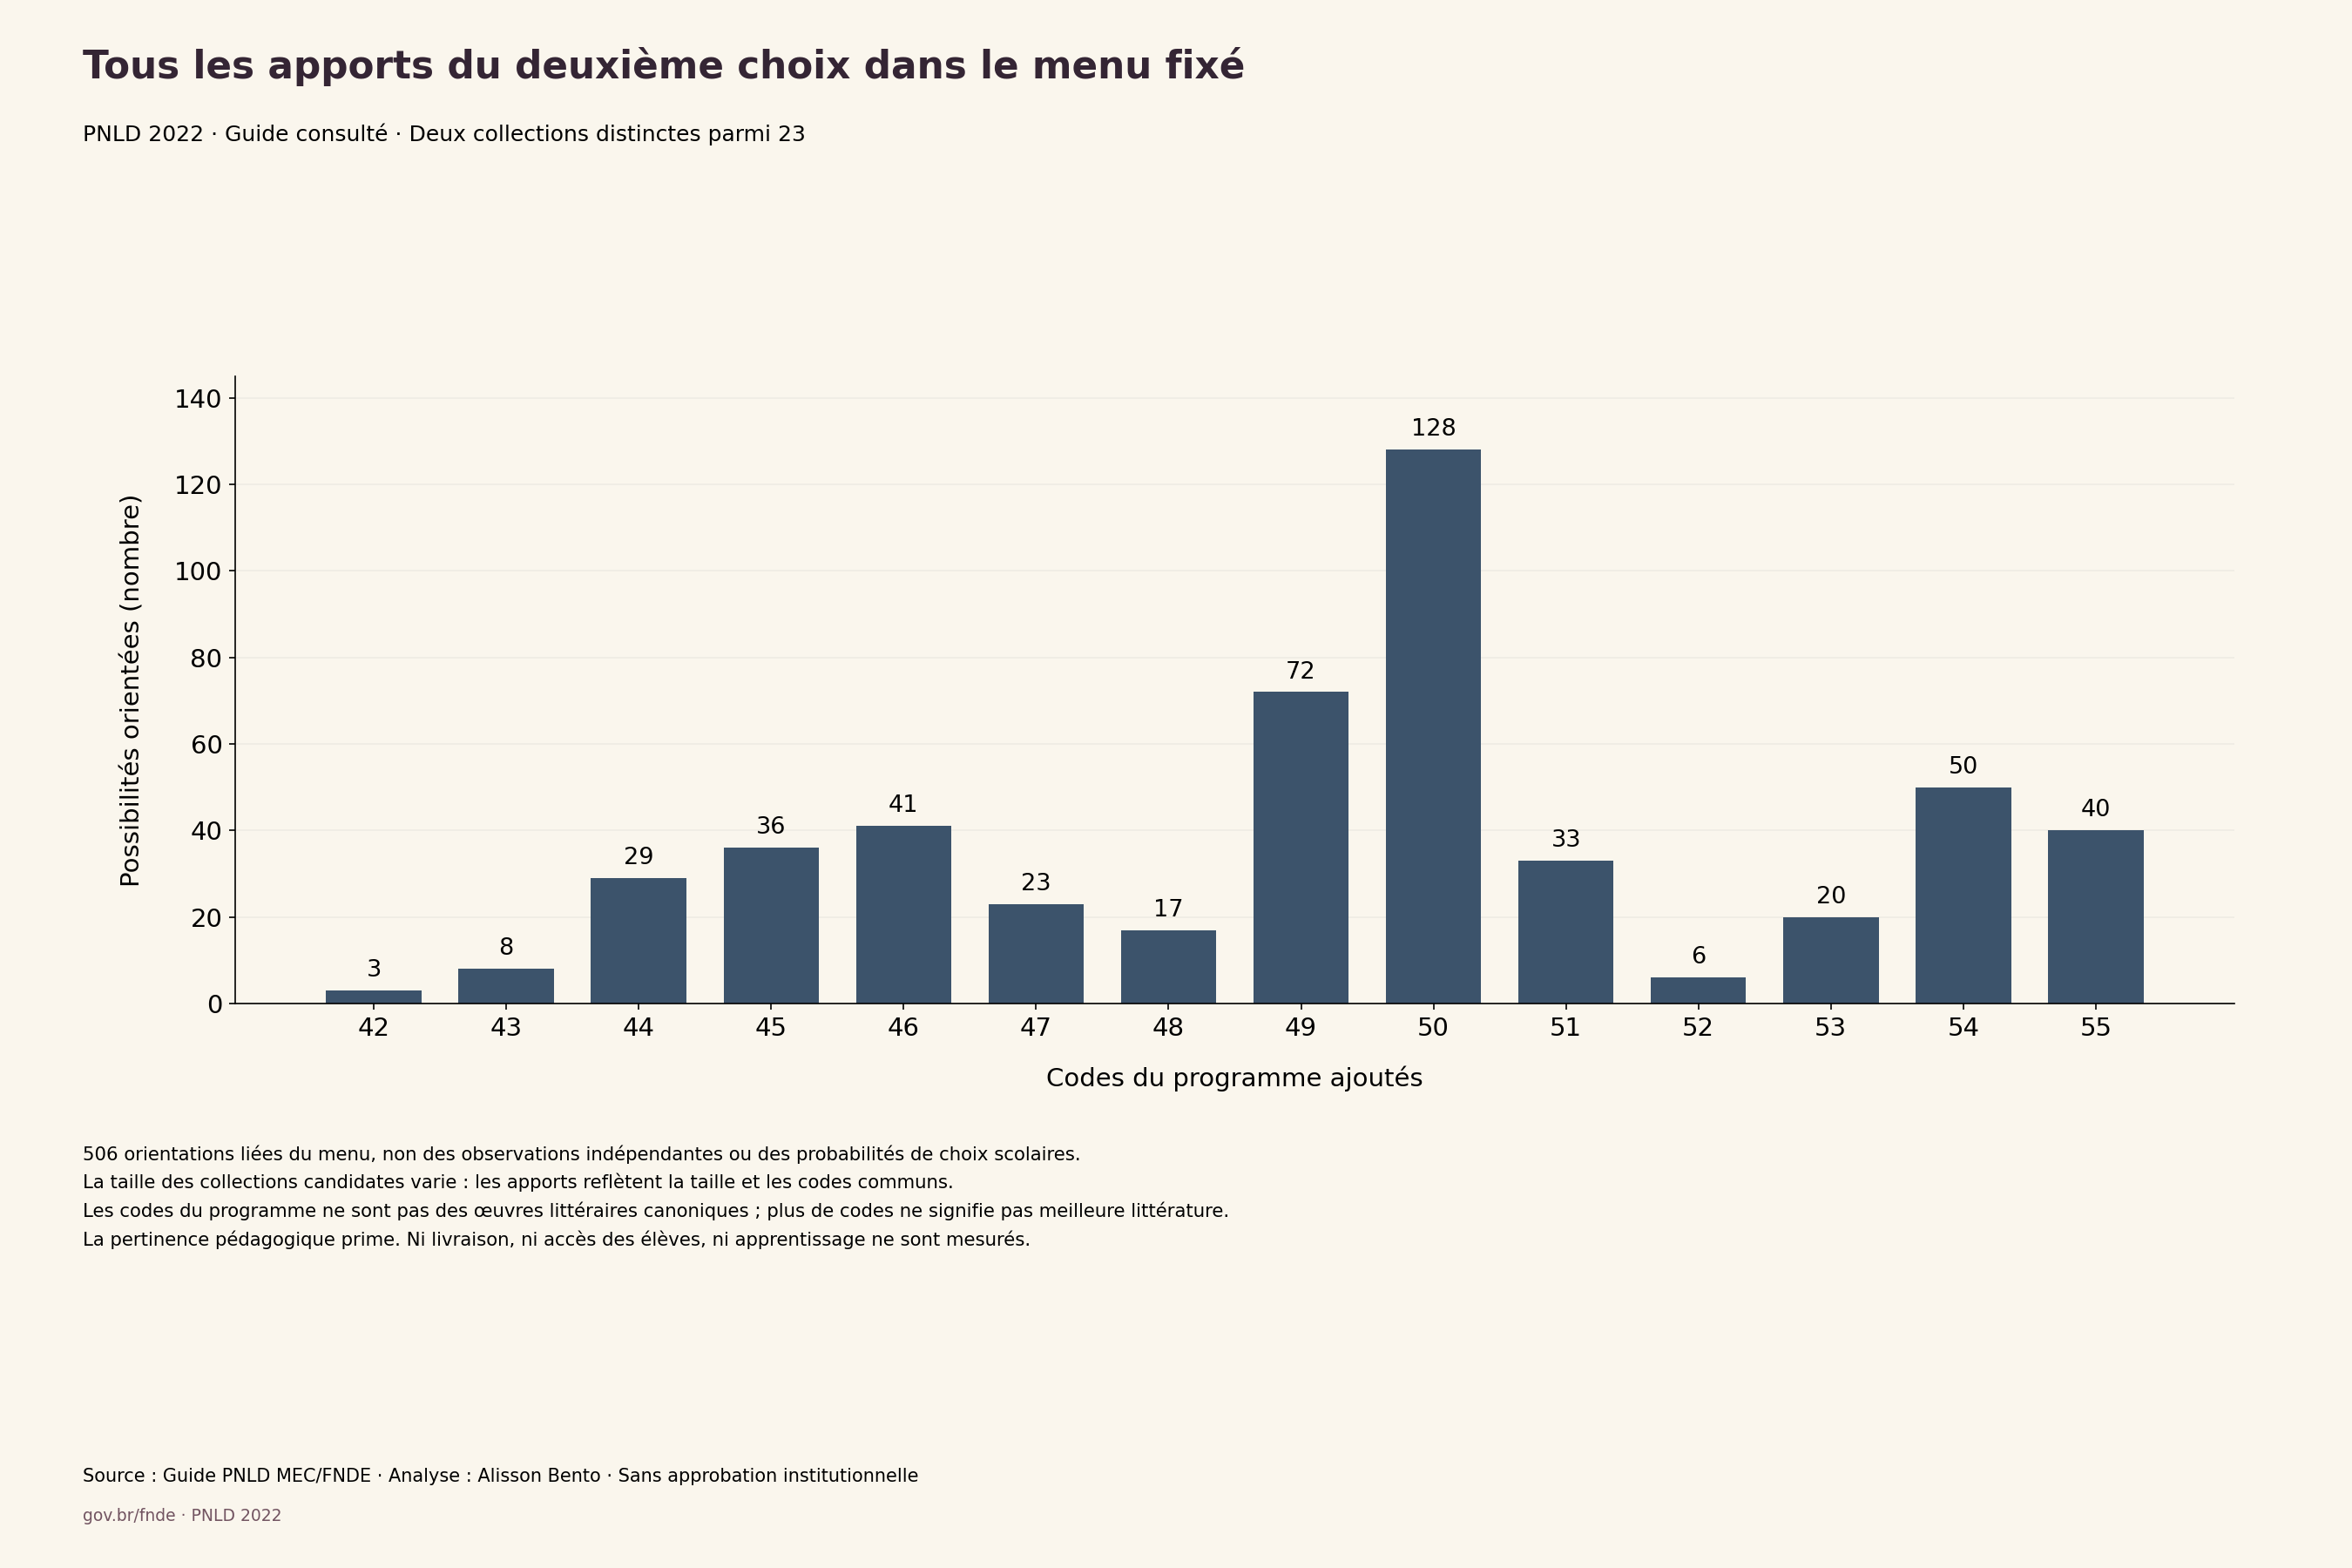
Dans les 506 sens, les codes ajoutés par le second choix vont de 42 à 55, avec une médiane de 50. La distribution complète des fréquences entières est présentée, sans lissage ni classes choisies après coup. Pour chaque première collection possible, le tableau conditionnel garde aussi les vingt-deux autres choix, avec leurs fréquences exactes, leur minimum, leur médiane et leur maximum. Ces distributions sont surtout utiles quand la première collection est déjà justifiée sur le plan éducatif. Elles montrent la variation possible du nombre de codes sans demander de remplacer cette première décision par la collection qui donne le total le plus élevé.
Les fourchettes conditionnelles ne sont pas toutes semblables. Par exemple, la collection 05 compte 50 codes au départ et ses alternatives ajoutent de 48 à 51 codes, avec une médiane de 50 ; la collection 15 compte 54 codes au départ et ses alternatives ajoutent de 42 à 55 codes, avec une médiane de 47. Ces deux exemples figurent dans le tableau complet de vingt-trois lignes et ne sont pas des classements de qualité. Même avec une première collection fixée, les candidates diffèrent par leur propre taille autant que par leurs codes communs. Une fourchette d’apport plus large ne peut donc pas être attribuée uniquement au recoupement, et un apport plus petit n’établit pas qu’une alternative soit inférieure.
Placer l’adéquation pédagogique avant le nombre de codes
La source étiquette les collections « mixte », « crèche » ou « préscolaire ». Ces étiquettes décrivent des contextes éducatifs visés ; l’étude n’en fait pas des notes. Elle ne classe pas une collection mixte par rapport à une collection préscolaire et ne suppose pas que les catégories soient interchangeables pour toutes les écoles. La comparaison principale utilise le cas documenté du menu de deux collections distinctes ; les droits de choix plus larges mentionnés ailleurs dans le guide ne sont pas analysés. Étendre le calcul à trois, six ou douze collections demanderait un modèle de décision justifié à part, et non l’hypothèse qu’un exemple tiré d’une interface établit toutes les règles d’attribution possibles.
Pour bien utiliser le tableau conditionnel, on commence par les alternatives adaptées sur le plan éducatif, et non par le maximum de sa dernière colonne. Le nombre de codes explique ensuite en quoi ces alternatives diffèrent sur une seule dimension étroite : le nombre d’identifiants listés en plus. L’adéquation peut dépendre des enfants concernés, des activités prévues, des besoins d’accessibilité, de la langue, de la conception des ouvrages ou du fonds déjà présent. Rien de cela n’est mesuré ici. L’analyse apporte donc une information qui s’ajoute au jugement professionnel. Elle ne prétend pas qu’un nombre exact de codes rende compte des bienfaits d’une collection ou de la variété des expériences de lecture qu’elle permet.
Le fonds existant est une autre limite importante. Une seconde collection du programme peut ajouter des codes par rapport à la première collection choisie, tout en ajoutant moins de nouveautés à l’ensemble de la bibliothèque de l’école. La question inverse, combien de codes l’école ne possède pas déjà, demande un inventaire vérifié et des identifiants compatibles. Aucun inventaire de ce type n’est rapproché de ces tableaux. De même, l’accès à une bibliothèque partagée ou à des livres acquis hors du programme pourrait changer les possibilités d’un enfant sans changer aucun résultat de cet audit. La variété du menu du programme est un objet de mesure précis, pas un tableau complet de l’accès à la littérature.
En quoi cette étude diffère des recherches sur la couverture thématique
Des recherches ont déjà examiné la représentation et la couverture thématique dans ces collections. Le travail de Mirian Daniela Faustino Faria porte sur les thèmes autochtones et leur présence dans les collections. Un document officiel indexé présente une correspondance entre collections pour huit œuvres ; la thèse complète n’était pas disponible pour examen ici, et l’on ne prétend donc pas avoir écarté toutes les analyses qu’elle contient comme travaux antérieurs. Sa préoccupation centrale est néanmoins importante : la composition d’une collection proposée peut compter autant que le nombre de livres annoncé. Cet article ne prétend pas découvrir cette question pour la première fois.
L’étude de Manfré et Rozzi, publiée en 2026, examine des œuvres narratives choisies dans les collections préscolaires, au regard de la formation humaine et culturelle des enfants. Cette recherche qualitative pose des questions auxquelles un comptage de codes exacts ne peut pas répondre. Une bibliographie qui compte plus d’identifiants n’est pas forcément plus riche dans une perspective culturelle donnée, plus adaptée à un groupe ou meilleure comme littérature. Mettre un autre thème à la place dans une analyse de couverture existante serait aussi une tout autre entreprise que le calcul présenté ici. L’apport de cette étude est la comptabilité de toutes les paires du menu et l’information conditionnelle sur le second choix, pas une nouvelle évaluation thématique ou littéraire.
Les deux approches peuvent se compléter sans être interchangeables. Une étude thématique peut repérer des œuvres d’une importance éducative particulière ; le tableau présenté ici peut décrire comment l’ensemble des codes listés autour d’elles change quand on combine deux collections. Il ne donne pas de sens thématique aux autres codes et ne déduit aucune couverture à partir des éditeurs ou des mots des titres. Garder cette séparation rend le résultat utile sans exagérer sa nouveauté.
Un audit de la source que l’on peut vérifier
La section des tableaux de collections occupe les pages 59 à 120 du PDF. Les vingt-trois titres de collection et chaque page de suite ont été examinés, et deux méthodes d’extraction indépendantes ont fait concorder l’ensemble des 1 192 occurrences listées. La comparaison portait sur la collection, la catégorie, le code du programme, le titre, l’éditeur, le genre et la page source. Chaque code est resté une chaîne de caractères pendant tout le traitement. Les doublons au sein d’une collection et les désaccords entre les champs descriptifs d’un code répété ont été contrôlés explicitement, sans écarter de lignes ni fusionner des titres semblables. Aucun conflit de ce type ne subsiste dans l’extraction auditée utilisée pour les calculs.
Le fichier public d’appartenance ne contient volontairement que le numéro de collection, le code du programme et la page source. Les cellules d’éditeur du guide peuvent contenir des identifiants inutiles pour reproduire cette question, et le guide contient aussi des notices critiques et des illustrations protégées dont le calcul n’a pas besoin. Ces éléments ne sont pas redistribués ici. Un manifeste des sources identifie le guide et le manuel réels par leur adresse, leur taille en octets et leur empreinte, ce qui permet de vérifier la source de façon indépendante. Le fichier d’appartenance réduit suffit pour reproduire les réunions et les différences d’ensembles, sans reproduire le contenu créatif du guide.
Le programme de calcul énumère les paires et les sens fixés, garde tous les résultats à égalité et donne toutes les tables de fréquences conditionnelles. Les rapports et les médianes sont calculés en fractions exactes avant tout arrondi d’affichage. Une implémentation indépendante, partie d’une extraction distincte et sans réutiliser les fonctions de calcul, a reproduit toutes les valeurs numériques indiquées. Cela protège contre les erreurs de transcription et de programmation ; cela ne supprime pas les limites des définitions de la source ni de sa couverture historique. Les fichiers à télécharger rendent ces distinctions visibles, au lieu de faire de la reproductibilité l’affirmation que le menu mesure tout ce qu’un lecteur voudrait savoir.
Pourquoi ce ne sont pas des statistiques de livraison ou d’élèves
Une étiquette de programme et un menu de sélection ne sont pas des enregistrements d’expédition. Cette étude ne relie au guide ni identifiants d’écoles, ni dates de livraison, ni quantités reçues, ni données d’effectifs d’élèves. Elle ne peut donc pas montrer quelles écoles ont obtenu une collection, si les envois étaient complets, comment les livraisons répétées ont été enregistrées, ni combien d’exemplaires étaient disponibles par enfant. L’absence d’un enregistrement d’expédition ne prouverait pas à elle seule un accès nul, et un titre de programme dans un tableau logistique n’identifierait pas forcément un livre individuel. Ces questions demandent d’autres définitions de sources et des rapprochements distincts, qui ne sont pas faits ici.
Cette distinction évite aussi une mauvaise lecture de l’année du titre. PNLD 2022 désigne le programme représenté par le guide et le manuel, pas un recensement vérifié, par année civile, des livraisons ou de la lecture. La version de la source a été récupérée en octobre 2026. La date de génération du fichier, les informations de création du manuel et les dates de l’avis de choix sont des éléments de provenance, pas des périodes d’observation interchangeables. Sans chaîne de versions historiques documentée, les écarts entre les fourchettes publiées doivent rester des divergences. On ne doit pas en tirer un récit inventé de retraits, d’ajouts ou de changements dans ce que les écoles ont réellement reçu.
Il n’y a pas d’intervalle d’incertitude statistique autour de l’arithmétique de cette version entièrement énumérée, mais l’incertitude est grande pour les questions qui sortent de son cadre. L’identité exacte des codes, la stabilité historique du catalogue, l’adéquation selon l’âge, les fonds déjà présents dans les écoles et l’usage réel posent chacun une limite différente. Un intervalle de confiance ne résoudrait pas ces questions de définition. La bonne réponse est d’énoncer précisément l’objet mesuré et de ne rien affirmer sur ce qui n’est pas mesuré. C’est pourquoi les résultats portent sur un menu de choix documenté, et non sur l’égalité des chances éducatives, l’efficacité du programme ou l’évolution de la lecture des enfants.
Utiliser ce décompte comme une couche d’information pour décider
Pour un lecteur qui compare deux collections adaptées, la marche à suivre est simple : repérer la collection de départ, considérer les alternatives pertinentes parmi les autres, et distinguer les entrées ajoutées affichées des codes déjà présents. Le tableau conditionnel donne la fourchette et les fréquences exactes pour les vingt-deux alternatives du menu publié. Le téléchargement des paires donne le nombre total correspondant et la part d’entrées en double. Ces fichiers servent à vérifier l’arithmétique ; ils ne sont pas une règle de sélection automatique. Les raisons éducatives de choisir tel ou tel ouvrage restent en dehors du calcul et ne doivent pas être écrasées par un maximum chiffré.
Le résultat central est donc équilibré. Choisir deux collections différentes peut donner un nombre différent de codes exacts, et l’ajout dépend de la collection de départ ainsi que de la taille et du recoupement de la candidate. En même temps, la duplication mesurée est modeste et peut servir des objectifs légitimes que le menu ne peut pas évaluer. Dire les deux évite de transformer une petite différence comptable en accusation de gaspillage, et évite aussi l’hypothèse inverse selon laquelle chaque paire offrirait forcément la même liste d’ouvrages. La quantité et le nombre de codes répondent à des questions voisines mais distinctes.
L’énumération complète rend ces différences vérifiables pour une décision documentée dans un guide de programme récupéré. Elle ne prescrit pas la meilleure littérature, n’établit aucun résultat au niveau des écoles et ne règle pas la question plus large de qui a accès aux livres. Sa valeur est de rendre exacte une comparaison limitée : nombre de collections, nombre d’entrées, codes différents et codes ajoutés restent séparés, et les incertitudes de la source restent visibles. Utilisée avec les descriptions éducatives du guide et les besoins réels d’une école, cette distinction peut améliorer la compréhension de l’information disponible, sans prétendre remplacer le reste de la décision.
Codes ajoutés par la deuxième collection, première collection fixée
PNLD 2022 · Version récupérée du guide · Deux collections différentes sur 23
Graphique complet et source
Faites défiler le graphique horizontalement pour le consulter. ↔
Graphique et valeurs
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Première collection | Catégorie | Codes de départ | Alternatives | Minimum ajouté | Médiane ajoutée | Maximum ajouté | Codes ajoutés : nombre de choix |
|---|---|---|---|---|---|---|---|
| 01 | Mixte | 50 | 22 | 47 | 50,0 | 51 | 47: 2; 49: 7; 50: 8; 51: 5 |
| 02 | Mixte | 49 | 22 | 46 | 50,0 | 52 | 46: 1; 48: 1; 49: 5; 50: 11; 51: 3; 52: 1 |
| 03 | Mixte | 50 | 22 | 47 | 50,0 | 52 | 47: 1; 48: 1; 49: 7; 50: 10; 51: 2; 52: 1 |
| 04 | Mixte | 49 | 22 | 48 | 50,0 | 51 | 48: 1; 49: 6; 50: 13; 51: 2 |
| 05 | Mixte | 50 | 22 | 48 | 50,0 | 51 | 48: 1; 49: 8; 50: 11; 51: 2 |
| 06 | Mixte | 50 | 22 | 47 | 50,0 | 51 | 47: 1; 48: 1; 49: 5; 50: 13; 51: 2 |
| 07 | Mixte | 50 | 22 | 46 | 50,0 | 52 | 46: 1; 47: 1; 48: 1; 49: 6; 50: 7; 51: 5; 52: 1 |
| 08 | Mixte | 50 | 22 | 48 | 50,0 | 51 | 48: 1; 49: 8; 50: 11; 51: 2 |
| 09 | Mixte | 50 | 22 | 47 | 50,0 | 52 | 47: 1; 48: 2; 49: 4; 50: 13; 51: 1; 52: 1 |
| 10 | Mixte | 49 | 22 | 47 | 50,0 | 52 | 47: 1; 48: 2; 49: 4; 50: 11; 51: 3; 52: 1 |
| 11 | Mixte | 50 | 22 | 48 | 50,0 | 51 | 48: 2; 49: 7; 50: 10; 51: 3 |
| 12 | Mixte | 49 | 22 | 48 | 50,0 | 52 | 48: 3; 49: 5; 50: 10; 51: 3; 52: 1 |
| 13 | Crèche | 53 | 22 | 44 | 47,0 | 55 | 44: 5; 45: 2; 46: 2; 47: 3; 53: 1; 54: 5; 55: 4 |
| 14 | Crèche | 55 | 22 | 44 | 46,5 | 55 | 44: 4; 45: 4; 46: 3; 47: 1; 53: 2; 54: 5; 55: 3 |
| 15 | Crèche | 54 | 22 | 42 | 47,0 | 55 | 42: 1; 44: 4; 45: 2; 46: 1; 47: 4; 53: 2; 54: 4; 55: 4 |
| 16 | Crèche | 55 | 22 | 44 | 46,0 | 55 | 44: 4; 45: 3; 46: 5; 53: 2; 54: 5; 55: 3 |
| 17 | Crèche | 54 | 22 | 43 | 46,5 | 55 | 43: 1; 44: 2; 45: 4; 46: 4; 47: 1; 53: 2; 54: 4; 55: 4 |
| 18 | Crèche | 55 | 22 | 43 | 46,5 | 55 | 43: 1; 44: 2; 45: 5; 46: 3; 47: 1; 53: 2; 54: 5; 55: 3 |
| 19 | Préscolaire | 54 | 22 | 43 | 46,5 | 55 | 43: 1; 44: 3; 45: 2; 46: 5; 47: 1; 53: 2; 54: 4; 55: 4 |
| 20 | Préscolaire | 53 | 22 | 42 | 47,5 | 55 | 42: 1; 44: 3; 45: 2; 46: 4; 47: 1; 48: 1; 53: 1; 54: 5; 55: 4 |
| 21 | Préscolaire | 55 | 22 | 43 | 46,5 | 55 | 43: 2; 44: 1; 45: 4; 46: 4; 47: 1; 53: 2; 54: 5; 55: 3 |
| 22 | Préscolaire | 54 | 22 | 42 | 46,5 | 55 | 42: 1; 43: 1; 45: 4; 46: 5; 47: 1; 53: 2; 54: 4; 55: 4 |
| 23 | Préscolaire | 54 | 22 | 43 | 47,0 | 55 | 43: 2; 44: 1; 45: 4; 46: 3; 47: 2; 53: 2; 54: 4; 55: 4 |
Chaque ligne fixe la première collection ; les 22 autres choix, tous différents, sont conservés. Notation des fréquences : codes ajoutés : nombre de choix candidats. La catégorie est un contexte de la source, pas un classement ni une règle d’adéquation valable pour tous. La taille des candidates varie, pas seulement les recoupements.
Télécharger le graphique (SVG) ↓ · Télécharger le graphique (PNG) ↓

Tous les ajouts du second choix dans le menu fixé
PNLD 2022 · Version récupérée du guide · Deux collections différentes sur 23
Graphique complet et source
Faites défiler le graphique horizontalement pour le consulter. ↔
Graphique et valeurs
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Codes du programme ajoutés | Choix orientés |
|---|---|
| 42 | 3 |
| 43 | 8 |
| 44 | 29 |
| 45 | 36 |
| 46 | 41 |
| 47 | 23 |
| 48 | 17 |
| 49 | 72 |
| 50 | 128 |
| 51 | 33 |
| 52 | 6 |
| 53 | 20 |
| 54 | 50 |
| 55 | 40 |
Les 506 choix orientés, de la première vers la seconde collection, un enregistrement par sens, sans lissage ni classes. Ce sont des fréquences du menu, pas des probabilités de choix réels des écoles.
Télécharger le graphique (SVG) ↓ · Télécharger le graphique (PNG) ↓
Données et téléchargements
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Mesure | Possibilités | Minimum | Médiane | Maximum |
|---|---|---|---|---|
| Codes du programme différents dans une paire | 253 | 95 | 100 | 110 |
| Entrées en double, en part de A (%) | 253 | 0,0 | 2,9 | 7,7 |
| Codes ajoutés par une seconde collection | 506 | 42 | 50 | 55 |
Menu fini et exact, pas des probabilités de choix des écoles. Les parts ont pour dénominateur les entrées affichées A ; pourcentages arrondis à une décimale. L’écart du nombre de codes combine des tailles de collection variables et des codes communs.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Première collection | Catégorie | Codes de départ | Alternatives | Minimum ajouté | Médiane ajoutée | Maximum ajouté | Codes ajoutés : nombre de choix |
|---|---|---|---|---|---|---|---|
| 01 | Mixte | 50 | 22 | 47 | 50,0 | 51 | 47: 2; 49: 7; 50: 8; 51: 5 |
| 02 | Mixte | 49 | 22 | 46 | 50,0 | 52 | 46: 1; 48: 1; 49: 5; 50: 11; 51: 3; 52: 1 |
| 03 | Mixte | 50 | 22 | 47 | 50,0 | 52 | 47: 1; 48: 1; 49: 7; 50: 10; 51: 2; 52: 1 |
| 04 | Mixte | 49 | 22 | 48 | 50,0 | 51 | 48: 1; 49: 6; 50: 13; 51: 2 |
| 05 | Mixte | 50 | 22 | 48 | 50,0 | 51 | 48: 1; 49: 8; 50: 11; 51: 2 |
| 06 | Mixte | 50 | 22 | 47 | 50,0 | 51 | 47: 1; 48: 1; 49: 5; 50: 13; 51: 2 |
| 07 | Mixte | 50 | 22 | 46 | 50,0 | 52 | 46: 1; 47: 1; 48: 1; 49: 6; 50: 7; 51: 5; 52: 1 |
| 08 | Mixte | 50 | 22 | 48 | 50,0 | 51 | 48: 1; 49: 8; 50: 11; 51: 2 |
| 09 | Mixte | 50 | 22 | 47 | 50,0 | 52 | 47: 1; 48: 2; 49: 4; 50: 13; 51: 1; 52: 1 |
| 10 | Mixte | 49 | 22 | 47 | 50,0 | 52 | 47: 1; 48: 2; 49: 4; 50: 11; 51: 3; 52: 1 |
| 11 | Mixte | 50 | 22 | 48 | 50,0 | 51 | 48: 2; 49: 7; 50: 10; 51: 3 |
| 12 | Mixte | 49 | 22 | 48 | 50,0 | 52 | 48: 3; 49: 5; 50: 10; 51: 3; 52: 1 |
| 13 | Crèche | 53 | 22 | 44 | 47,0 | 55 | 44: 5; 45: 2; 46: 2; 47: 3; 53: 1; 54: 5; 55: 4 |
| 14 | Crèche | 55 | 22 | 44 | 46,5 | 55 | 44: 4; 45: 4; 46: 3; 47: 1; 53: 2; 54: 5; 55: 3 |
| 15 | Crèche | 54 | 22 | 42 | 47,0 | 55 | 42: 1; 44: 4; 45: 2; 46: 1; 47: 4; 53: 2; 54: 4; 55: 4 |
| 16 | Crèche | 55 | 22 | 44 | 46,0 | 55 | 44: 4; 45: 3; 46: 5; 53: 2; 54: 5; 55: 3 |
| 17 | Crèche | 54 | 22 | 43 | 46,5 | 55 | 43: 1; 44: 2; 45: 4; 46: 4; 47: 1; 53: 2; 54: 4; 55: 4 |
| 18 | Crèche | 55 | 22 | 43 | 46,5 | 55 | 43: 1; 44: 2; 45: 5; 46: 3; 47: 1; 53: 2; 54: 5; 55: 3 |
| 19 | Préscolaire | 54 | 22 | 43 | 46,5 | 55 | 43: 1; 44: 3; 45: 2; 46: 5; 47: 1; 53: 2; 54: 4; 55: 4 |
| 20 | Préscolaire | 53 | 22 | 42 | 47,5 | 55 | 42: 1; 44: 3; 45: 2; 46: 4; 47: 1; 48: 1; 53: 1; 54: 5; 55: 4 |
| 21 | Préscolaire | 55 | 22 | 43 | 46,5 | 55 | 43: 2; 44: 1; 45: 4; 46: 4; 47: 1; 53: 2; 54: 5; 55: 3 |
| 22 | Préscolaire | 54 | 22 | 42 | 46,5 | 55 | 42: 1; 43: 1; 45: 4; 46: 5; 47: 1; 53: 2; 54: 4; 55: 4 |
| 23 | Préscolaire | 54 | 22 | 43 | 47,0 | 55 | 43: 2; 44: 1; 45: 4; 46: 3; 47: 2; 53: 2; 54: 4; 55: 4 |
Chaque ligne fixe la première collection ; les 22 autres choix, tous différents, sont conservés. Notation des fréquences : codes ajoutés : nombre de choix candidats. La catégorie est un contexte de la source, pas un classement ni une règle d’adéquation valable pour tous. La taille des candidates varie, pas seulement les recoupements.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Codes du programme ajoutés | Choix orientés |
|---|---|
| 42 | 3 |
| 43 | 8 |
| 44 | 29 |
| 45 | 36 |
| 46 | 41 |
| 47 | 23 |
| 48 | 17 |
| 49 | 72 |
| 50 | 128 |
| 51 | 33 |
| 52 | 6 |
| 53 | 20 |
| 54 | 50 |
| 55 | 40 |
Les 506 choix orientés, de la première vers la seconde collection, un enregistrement par sens, sans lissage ni classes. Ce sont des fréquences du menu, pas des probabilités de choix réels des écoles.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Élément | Périmètre audité |
|---|---|
| Collections | 23 |
| Pages de tableaux de la source | 62 (PDF 59–120) |
| Occurrences de codes listées | 1 192 |
| Champs de la source rapprochés pour chaque occurrence | 7 |
| Paires sans ordre de collections différentes | 253 |
| Seconds choix selon le sens | 506 |
| Alternatives pour chaque première collection | 22 |
| Codes en double dans une même collection | 0 |
| Conflits entre champs descriptifs pour les codes répétés | 0 |
L’objet mesuré est la version récupérée du guide, pas les livres livrés ni les inscriptions. Les nombres de pages et d’occurrences décrivent la couverture de l’extraction, pas l’apprentissage ou l’accès.
Données et méthode
Notre méthode de calcul
- Cas fixé sur l’exemple documenté du manuel : choisir deux collections différentes dans le menu de 23 ; aucun résultat pour un nombre plus grand de collections.
- Chaînes complètes des codes du programme conservées ; aucune fusion de titres, aucun décodage de suffixes, aucune déduction d’une œuvre littéraire reconnue.
- Chaque page des tableaux de collections auditée ; deux méthodes d’extraction indépendantes ont fait concorder 1 192 occurrences sur sept champs.
- Énumération des 253 paires sans ordre et des 506 sens ; part d’entrées en double D/A et médianes fractionnaires exactes, avec les égalités conservées.
- Les 23 distributions conditionnelles et les données minimales (collection, code, page) sont publiées pour reproduire les calculs, avec une reproduction numérique indépendante.
Ce que les données ne permettent pas de conclure
- Cette version récupérée du guide n’est pas une reconstitution historique vérifiée du catalogue au moment du choix.
- Les codes de la source identifient des références bibliographiques inscrites au programme, pas forcément des œuvres différentes au sens littéraire.
- L’exemple de deux choix de la source ne prouve ni un droit identique pour toutes les écoles ni l’adéquation pédagogique de chaque paire.
- Les tailles de collection varient de 49 à 55 ; ni l’écart global ni la variation des ajouts conditionnels ne s’expliquent seulement par le recoupement.
- Aucun choix observé, aucune expédition, aucun exemplaire reçu, aucun inventaire d’école, aucun rapprochement avec les inscriptions, aucune mesure d’accès ou de résultats d’apprentissage.
- Le guide et le manuel de 2023 (49–55) et l’avis (53–55) restent en désaccord ; l’heure de génération du PDF n’est pas une date de révision établie.
- Les études thématiques antérieures sont reconnues ; la thèse complète de Faria n’était pas disponible, aucune affirmation exhaustive de nouveauté n’est donc faite.
Sources originales
- MEC/FNDE: complete PNLD 2022 Educação Infantil literary guide
Guide complet récupéré ; tableaux des collections aux pages 59–120 du PDF. La date de génération du fichier, juillet 2025, n’est pas une date de révision vérifiée. Codes exacts du programme, pas identités d’œuvres littéraires reconnues.
Consulté le 30 octobre 2026
- FNDE: manual for registering PNLD 2022 early-childhood literary choices
Les pages 12, 17–18 du PDF indiquent les champs de code, la fourchette 49–55 et un exemple de sélection par cases à cocher de deux collections distinctes parmi 23. Ce n’est pas la preuve d’un droit général à deux collections ni d’une adéquation.
Consulté le 30 octobre 2026
- FNDE: PNLD 2022 literary choice notice
L’avis publié le 8 septembre 2023 et modifié le 7 novembre 2023 décrit 53–55 œuvres, contre 49–55 dans le guide et le manuel de 2023. Divergence de sources conservée, pas une révision dans le temps démontrée.
Consulté le 30 octobre 2026
- CEFET-MG: Faria dissertation defence abstract on indigenous representation in PNLD 2022
Le résumé officiel indexé et des extraits de thèse établissent l’existence d’une recherche antérieure proche sur la couverture thématique. La thèse complète n’était pas disponible pour examen ; on ne prétend pas avoir écarté toutes les analyses qu’elle contient.
Consulté le 30 octobre 2026
- Manfré and Rozzi 2026: PNLD 2022 literary collections and young children’s formation
Étude qualitative d’œuvres narratives choisies dans les collections préscolaires 19–23 ; recherche antérieure pertinente, pas une analyse par paires de codes exacts de tout le menu.
Consulté le 30 octobre 2026
Citer et réutiliser cette étude
Alisson Bento. « Deux collections du PNLD : de combien varie le nombre de codes différents ». Recherche originale, 2026. Version récupérée du guide officiel PNLD 2022 Educação Infantil ; consultée le 30 octobre 2026. https://alissonbento.com/fr/research/brazil-pnld-two-collection-code-breadth-2022/
Informations de la source : guide officiel et manuel de choix du PNLD 2022 (MEC/FNDE), avec liens et empreintes des fichiers. Extraction originale de l’appartenance des codes, calculs et explications : Alisson Bento. Aucune approbation institutionnelle n’est sous-entendue. Les notices critiques du guide, les illustrations, les textes littéraires, les identifiants personnels d’éditeurs, les dossiers d’écoles et les données d’enfants ne sont pas redistribués.
Corrections ou questions éditoriales