
Contar capítulos também é uma decisão sobre limites
Um romance pode ter um tamanho total estável e, ainda assim, dar distribuições diferentes do tamanho dos capítulos. A diferença não precisa vir de mudar as palavras. Pode vir da decisão de incluir ou não uma moldura narrativa externa no último capítulo numerado, de contar ou não as cartas iniciais como capítulos e de a medição cobrir ou não todas as seções mantidas. Este estudo examina essas decisões em duas transcrições fixas do Project Gutenberg: Pride and Prejudice, item 1342, e a versão de 1831 de Frankenstein, item 42324. O objetivo não é classificar as autoras nem caracterizar seus gêneros. É mostrar com exatidão como uma convenção estrutural declarada muda um resultado descritivo.
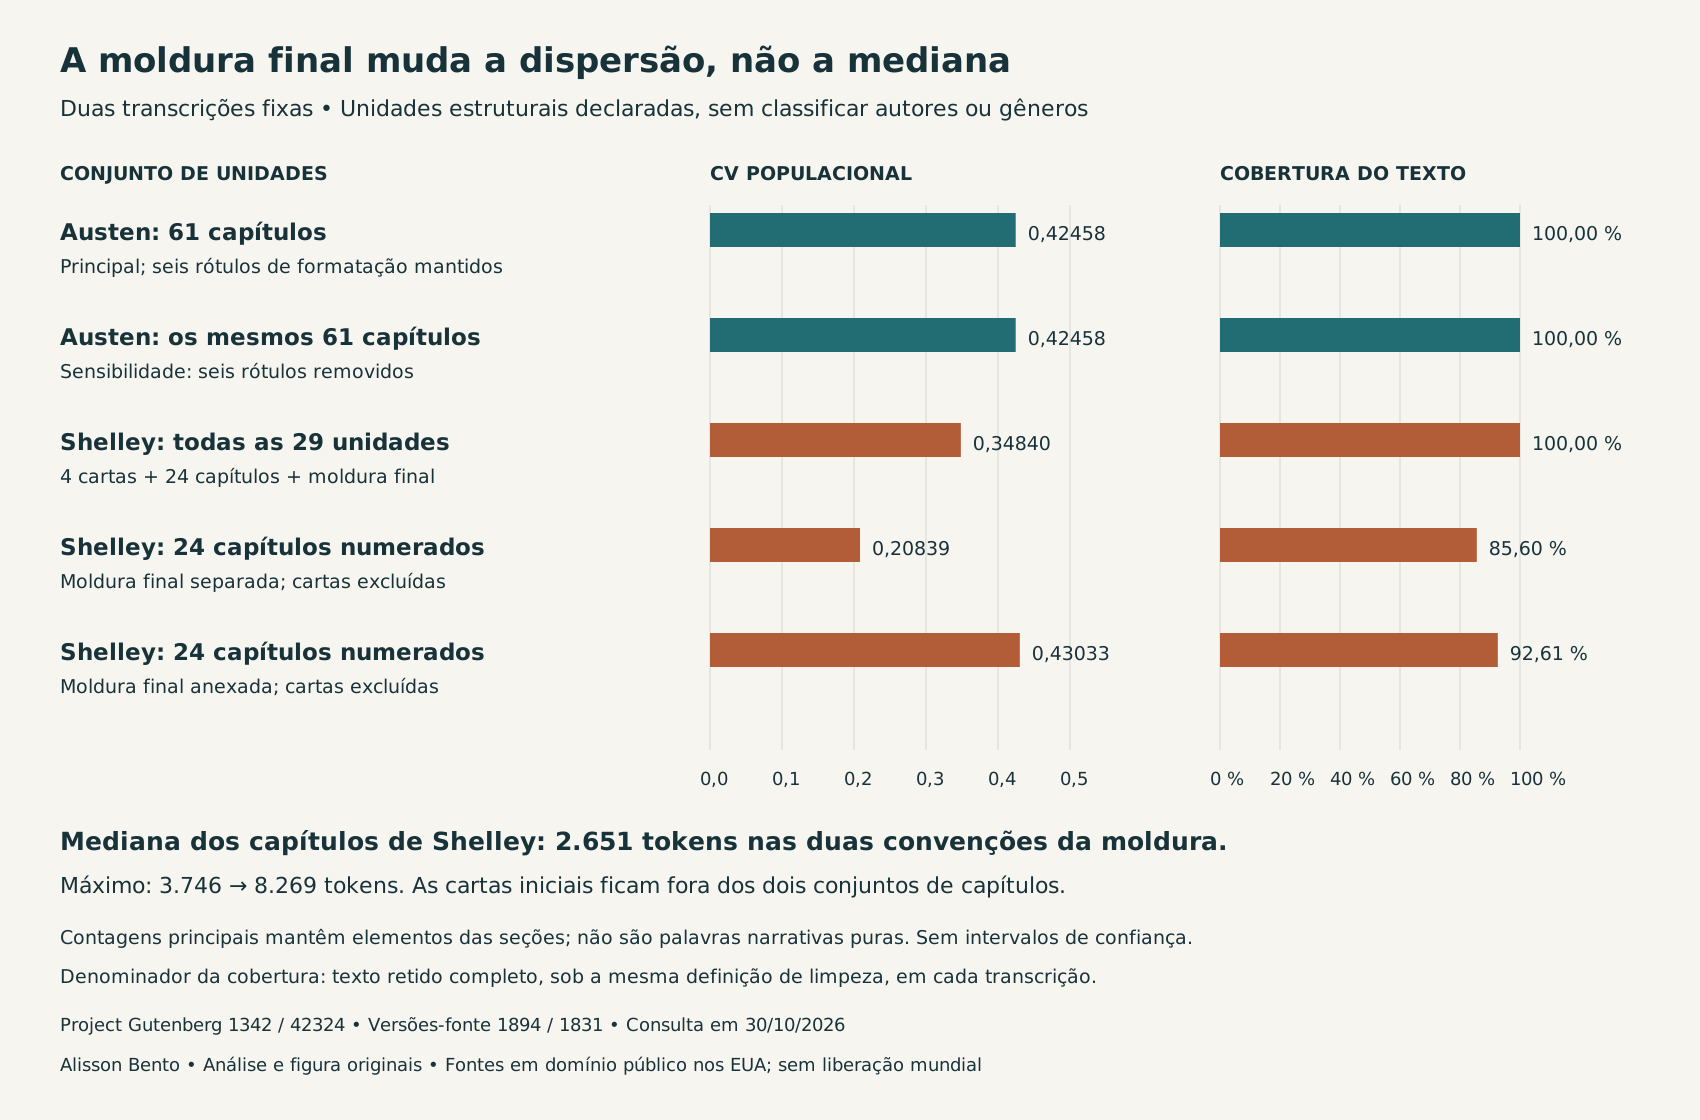
O exemplo central é a continuação final de Walton na transcrição de Frankenstein. Quando essa seção fica separada, os 24 capítulos nomeados têm coeficiente de variação da população de 0,20839. Juntar a mesma seção ao capítulo XXIV eleva o coeficiente para 0,43033. A mediana continua em 2.651 tokens, mas o máximo sobe de 3.746 para 8.269. Uma mediana que não muda, portanto, não significa que a distribuição não mudou. A cobertura também muda, porque esses conjuntos de capítulos incluem partes diferentes do texto mantido. As quatro cartas iniciais ficam fora das duas definições que só consideram capítulos.
São cálculos determinísticos para dois arquivos específicos, e não estimativas a partir de uma amostra representativa de ficção. Os mesmos bytes de origem já serviram antes a outra pergunta, sobre o texto contido entre aspas. Aqui, o que se mede são unidades estruturais com nome, seus tamanhos relativos e sua cobertura de um denominador completo de texto mantido. Nem as porcentagens de citação nem o total de tokens, sozinhos, mostram a distribuição que depende da moldura, relatada aqui. A contribuição é um cálculo de caso que se pode auditar, e não a afirmação de que o problema geral de dividir um texto em partes tenha sido descoberto agora.
Duas transcrições, não duas versões universais
O corpus foi fixado antes de calcular o tamanho dos capítulos. Ele contém exatamente os dois arquivos já congelados antes, sem trocas escolhidas depois de ver os resultados. A transcrição de Austen identifica uma fonte de 1894, da George Allen, com prefácio de George Saintsbury e ilustrações de Hugh Thomson. Esses materiais acrescentados ficam fora do corpo medido. O arquivo de Shelley identifica a versão de 1831 de H. Colburn e R. Bentley, por meio de uma reimpressão fotográfica não especificada. A identidade bibliográfica exata dessa reimpressão não foi estabelecida. Por isso, chamar o texto de versão de origem de 1831 é mais preciso do que dizer que se teve acesso a um exemplar físico original específico.
A identidade da edição importa porque a apresentação dos capítulos, o material editorial, a tipografia e a prática de transcrição podem afetar os limites usados no cálculo. O próprio Project Gutenberg avisa que suas transcrições não precisam reproduzir de forma idêntica uma edição impressa específica. Os resultados descrevem estas transcrições, e não todas as edições, manuscritos, traduções ou adaptações de cada obra. Não se reconstrói a estrutura dos volumes originais onde os arquivos analisados não a trazem dentro do corpo medido. Os créditos das fontes identificam os colaboradores históricos, sem transferir a autoria deles a quem analisa.
Os arquivos foram baixados em 30 de outubro de 2026. Essa data identifica a obtenção, não a composição nem a publicação original dos romances. O catálogo de Austen informa hoje uma atualização em 29 de setembro de 2026, enquanto o cabeçalho do arquivo congelado informa 1º de setembro. Em vez de tratar essas datas como intercambiáveis, a análise identifica a entrada pelo tamanho exato em bytes e pela impressão digital SHA256. O catálogo e o cabeçalho de Shelley informam, os dois, 23 de outubro de 2026. Um arquivo substituto posterior, mesmo com o mesmo número do Gutenberg, não é aceito em silêncio como a entrada congelada.
O que o tokenizador mede
Todo tamanho informado é uma contagem de tokens produzidos pela expressão fixa [A-Za-z]+(?:['’][A-Za-z]+)*. Ela reconhece sequências de letras latinas básicas, com apóstrofos retos ou curvos opcionais no meio. Expressões com hífen se dividem em tokens separados, e algarismos não contam como palavras. Letras acentuadas e ligaduras não são reconhecidas por essa expressão como palavras alfabéticas completas. Manter a regra fixa torna os cálculos reproduzíveis, mas não faz do resultado uma definição linguística universal de palavra. Por isso, as expressões “tokens do texto mantido” e “tokens das seções” são mais exatas do que “palavras da narrativa”.
Antes da tokenização, os bytes brutos ficam inalterados e são conferidos com as impressões digitais (hashes) congeladas. Uma cópia de trabalho é decodificada e tem os fins de linha uniformizados. Os blocos de ilustração com colchetes balanceados são trocados por espaços em branco, o que preserva as posições dos caracteres normalizados mesmo quando uma legenda tem colchetes aninhados. Isso remove 154 blocos de ilustração dentro do corpo em Austen e dois em Shelley. Três blocos numerados de notas de rodapé de Shelley também são excluídos. A contagem deles pelo tokenizador, incluindo os rótulos Footnote, é 11. Os números de chamada que sobram não dão nenhum token alfabético. Páginas iniciais, introduções, prefácios, material final e a licença do Gutenberg ficam fora dos limites escolhidos.
Datas, saudações, assinaturas, versos e cartas inseridas continuam nas seções que as contêm. A primeira carta de Shelley começa no próprio cabeçalho; por isso, o destinatário e a data do começo dão oito tokens que seriam omitidos por um ponto de partida na primeira frase narrativa. Essas escolhas definem o texto das seções, e não um corpo idealizado só de prosa. Tirar todo o aparato das cartas ou todos os blocos de formatação responderia a outra pergunta e poderia descartar correspondência com significado. A análise, portanto, declara o material incluído em vez de supor que tudo entre a primeira e a última frase seja linguisticamente homogêneo.
Estabelecer as noventa unidades estruturais
A divisão principal de Austen tem 61 capítulos. O primeiro exige tratamento especial, porque o rótulo Chapter I está dentro de uma ilustração que vem antes da frase narrativa inicial. A primeira unidade começa nessa frase, já conferida; os demais títulos vão de II a LXI. Os capítulos XIII e XIV não têm pontuação final, e XLVI mistura maiúsculas e minúsculas. Um analisador que exigisse um único padrão exato, em maiúsculas e com pontuação, perderia limites genuínos. Por outro lado, procurar a palavra chapter em qualquer lugar recolheria referências a ilustrações e outros materiais que não são limites. Nenhum desses atalhos é usado como evidência suficiente.
A divisão de Shelley tem quatro cartas iniciais, 24 capítulos nomeados e uma continuação final de Walton: 29 unidades no total. As cartas têm títulos explícitos e transições com assinaturas, destinatários e datas. A continuação final tem título próprio, depois da quebra narrativa anterior, e volta à narração externa datada. As cartas inseridas e a narrativa encaixada da criatura continuam dentro dos capítulos nomeados em que aparecem. As datas dentro da continuação final não criam novas unidades de capítulo. Isso preserva a distinção entre uma seção com nome dado pela edição, uma história inserida e uma mudança de interlocutor ou de ocasião no nível do parágrafo.
Cada limite candidato foi conferido com o contexto mantido ao lado e registrado em um arquivo separado de observações, um por limite. As sequências completas de numeração, os pontos de partida e os pontos finais da narrativa também foram conferidos. Os diagnósticos trazem posições na fonte e impressões digitais, em vez de trechos desnecessários. São verificações documentadas de contexto do texto e de cálculo; não são uma alegação de anotação humana, de concordância entre anotadores nem de anotação semântica de referência. As divisões completas não têm seções sobrepostas, e a soma das contagens delas é igual à tokenização direta do corpo mantido depois de excluir os títulos. Essa igualdade testa a aritmética da cobertura, enquanto as observações registradas tratam de por que os limites fazem sentido.
Divisões completas e cobertura só dos capítulos
A divisão de Austen tem 122.174 tokens principais em seus 61 capítulos. Dentro desse corpo declarado de texto mantido, a divisão em capítulos é completa: a cobertura é de 100%. A divisão completa de Shelley tem 75.228 tokens em 29 unidades. Seus 24 capítulos, com a continuação de Walton separada, têm 64.397 tokens. Isso é 85,6024% do denominador completo de texto mantido. A parte que falta não é perda de dados nem falha de extração. É o conjunto, excluído de forma explícita, das quatro cartas iniciais e da moldura final, que juntas têm 10.831 tokens.
As cartas iniciais dão 5.563 tokens, e a continuação final dá 5.268. Juntar esta última ao capítulo XXIV leva o total do conjunto de capítulos a 69.665 e a cobertura a 92,6051%. As quatro cartas iniciais continuam de fora. Seria, portanto, incorreto chamar de romance inteiro esse conjunto de capítulos com a moldura junta, ou dividir o tamanho dos capítulos por um denominador que fingisse que as cartas não existem. A divisão completa em 29 unidades dá o denominador comum com que se pode avaliar qualquer uma das duas convenções de capítulos.
Cobertura e distribuição respondem a perguntas diferentes. A cobertura pergunta quanto do texto mantido pertence ao conjunto de unidades escolhido. A mediana pergunta o que está no meio dos tamanhos ordenados, dando o mesmo peso a cada unidade escolhida. Uma não substitui a outra. Uma distribuição pode parecer regular e deixar de fora um material de moldura considerável, e acrescentar uma seção longa a uma unidade que já existe pode mudar o extremo superior sem mudar o meio. Apresentar as duas medidas impede que um resumo de capítulos conveniente vire, sem aviso, a descrição de apenas parte do texto.
As distribuições além dos totais
Nos 61 capítulos principais de Austen, a mediana é de 1.835 tokens. O primeiro e o terceiro quartis são 1.563 e 2.335, e as menores e maiores unidades têm 676 e 5.188 tokens. O coeficiente de variação da população é 0,42458. Esses resumos distinguem o centro, a metade intermediária e os limites externos dos tamanhos observados. Os extremos são o mínimo e o máximo reais, e não limites de confiança. O maior capítulo responde por 4,2464% do total mantido dos capítulos, outra descrição, baseada no denominador, de quanto o texto se concentra em sua maior unidade.
Na divisão completa de Shelley, com 29 unidades, a mediana é de 2.616 tokens, os quartis são 2.074 e 3.015, e o intervalo vai de 299 a 5.268. O coeficiente de variação da população é 0,34840. Esse conjunto inclui as cartas e a moldura final; por isso, sua distribuição não deve ser chamada de distribuição de 29 capítulos. Só para os 24 capítulos, com a moldura separada, a mediana é 2.651, os quartis são 2.223 e 3.038, e o mínimo e o máximo são 1.784 e 3.746. São populações de unidades diferentes, tiradas da mesma transcrição congelada.
O total maior de Austen convive com uma mediana menor do tamanho dos capítulos nesses dois casos. A observação mostra que o tamanho total não determina o tamanho dos capítulos, mas duas transcrições escolhidas de propósito não bastam para estabelecer uma relação geral entre o tamanho do romance e o dos capítulos. Não se estima regressão, correlação populacional, efeito de autoria nem comparação de gêneros. A tabela completa com a contagem por unidade permite examinar a distribuição de base, sem depender só de estatísticas resumidas, e o corpus fixo impede que um exemplo favorável seja trocado depois do cálculo.
Uma moldura final muda o extremo superior
A sensibilidade que junta a moldura muda uma unidade de capítulo que já existe em Shelley, em vez de acrescentar um vigésimo quinto capítulo. A continuação de 5.268 tokens se une ao último capítulo nomeado e forma uma unidade de 8.269 tokens. O número de capítulos continua em 24, e as cartas iniciais seguem fora do conjunto. Por isso, o máximo sobe de 3.746 para 8.269, e o terceiro quartil vai de 3.038 para 3.133,5. A mediana continua em 2.651, porque a unidade alterada não é uma das duas observações centrais usadas para calcular a mediana deste conjunto de tamanho par.
O coeficiente de variação sobe de 0,20839 para 0,43033. Ele usa o desvio-padrão da população dividido pela média, com peso igual para as 24 unidades de capítulo. Somar uma quantidade grande a uma unidade que já existe aumenta a média, mas também cria um extremo superior muito mais longo. A dispersão relativa sobe, em vez de ser neutralizada pela média maior. Por isso, informar só a média ou a mediana esconderia uma consequência importante da convenção de limites. A mudança é determinística, dada a reatribuição especificada; não é uma flutuação de amostragem nem um efeito causal estimado.
O coeficiente principal de Austen, 0,42458, fica entre os das duas convenções de capítulos de Shelley. Assim, a ordem aparente da dispersão dos capítulos das duas autoras se inverte quando a continuação de Walton é juntada. Esse quase cruzamento é um alerta contra tratar um resumo sem rótulo como característica de uma autora. Não é evidência de que uma das escritoras seja mais variável em algum sentido geral. A decisão estrutural é visível na transcrição, e as duas convenções podem ser apresentadas com transparência. Nenhuma deve se passar pela resposta mais natural sem explicar o que acontece com a moldura e com as cartas iniciais.
Formatação mantida e uma sensibilidade bem delimitada
Uma inspeção separada identificou seis tokens de rótulos de formatação mantidos em Austen: três rótulos NIND e três RIGHT. Dois aparecem no capítulo VII; um aparece em cada um dos capítulos XIII, XLVII, XLIX e LII. A presença deles significa que o total principal congelado, de 122.174, não pode ser descrito como uma contagem perfeitamente limpa de palavras da narrativa. Os rótulos ficam dentro de blocos de formatação que também têm saudações ou datas. Remover cada bloco inteiro descartaria texto legítimo das seções e não seria uma correção proporcional ao problema identificado.
Por isso, a sensibilidade declarada remove apenas os seis tokens de rótulo, nas posições de caracteres normalizadas registradas. Ela não substitui a extração principal congelada, não muda o tokenizador nem reescreve o protocolo original depois de ver os resultados. Com essa mudança limitada, o total de Austen passa a 122.168 e o coeficiente de variação, a 0,4245761045, em vez de 0,4245847284. A mediana, os quartis, o mínimo e o máximo não mudam. A ordem da dispersão que depende da convenção, descrita acima, também continua. Os resultados principais e os de sensibilidade são mantidos, para que o efeito numérico pequeno fique visível, e não seja apagado em silêncio.
Essa verificação não deve ser tomada como prova de que todo artefato possível de transcrição foi eliminado. Ela trata de um conjunto específico de rótulos observados, e não de uma busca sem limites pela contagem preferida. Uma limpeza linguística mais ambiciosa exigiria regras e validação próprias, em especial para abreviações, hifenização, letras acentuadas e o aparato das cartas. A conclusão atual é mais estreita: o problema identificado dos seis rótulos não explica o resultado de juntar a moldura. Manter essa distinção separa uma verificação de robustez medida de uma alegação de perfeição textual completa.
Os limites dos capítulos e as regras de identificação de trechos entre aspas são escolhas de medição distintas; seus efeitos não determinam ritmo narrativo, prevalência de diálogo ou qualidade literária. Como as regras de aspas mudam a medição em duas transcrições de romances
Reproduzir os cálculos sem redistribuir os romances
O caminho compacto de reprodução parte das contagens por unidade que acompanham o estudo. Ele recalcula os resumos completos e só de capítulos, a sensibilidade com a moldura junta, a cobertura, os quartis inclusivos e os coeficientes de variação da população. Esse caminho não exige baixar os romances e produz apenas dados derivados. Torna a aritmética acessível e mantém separadas da tarefa numérica as questões de direitos autorais e de jurisdição sobre a redistribuição dos textos de origem. Um segundo caminho, opcional, confere os arquivos brutos exatos com as impressões digitais registradas antes de repetir a extração, com pastas de entrada e de saída explícitas.
As verificações de extração usam duas implementações com abordagens estruturais diferentes. Uma preserva as posições mascarando os blocos excluídos e identifica os títulos nomeados; a outra remove, de forma iterativa, os blocos de colchetes aninhados e agrupa as linhas em seções. As contagens por unidade das duas coincidem nas 90 unidades. A segunda implementação verifica diretamente as divisões completas. Um recálculo separado dos resumos também confere as estatísticas só dos capítulos e com a moldura junta. A coincidência dá apoio à implementação para essas entradas, mas não cria um padrão independente de anotação semântica. Os registros de observação e a convenção declarada da moldura continuam sendo evidência necessária, ao lado da aritmética que coincide.
Os quartis usam interpolação linear inclusiva, e o coeficiente de variação usa o desvio-padrão da população, e não o da amostra. Não se inventa nenhum intervalo de incerteza em torno de contagens exatas de arquivos congelados. As incertezas relevantes dizem respeito às edições, à definição de token, à formatação mantida e à interpretação estrutural, e não a erro de amostragem nesses conjuntos completos de unidades. A documentação da reprodução diz o que recebe impressão digital e como as posições normalizadas são definidas. Uma impressão digital do corpo depois do mascaramento por espaços em branco não é apresentada, por engano, como a impressão digital de um trecho bruto. Bytes de origem alterados falham na verificação, em vez de dar um resultado aparentemente comparável sob um nome de arquivo que não mudou.
Alcance, direitos e a conclusão que permanece
Os dois registros atuais dos itens do Gutenberg indicam as obras como de domínio público nos Estados Unidos. Os cabeçalhos recebidos avisam quem está fora dos Estados Unidos para verificar a lei aplicável. A análise não transforma essas declarações em liberação jurídica no mundo todo, licença de marca nem permissão para publicar qualquer material de origem em qualquer lugar. Os materiais públicos têm contagens derivadas compactas, cálculos, diagnósticos de limites e referências, e não romances completos, ilustrações ou prefácios. A atribuição distingue as autoras originais e os colaboradores das fontes dos cálculos e da explicação originais de Alisson Bento.
Várias perguntas ficam fora da evidência. A amostra não representa autores, gêneros, literaturas nacionais nem a publicação contemporânea. O tamanho em tokens não mede tempo de leitura, ritmo percebido, envolvimento, qualidade literária, gosto de quem lê nem dificuldade. A identidade não especificada da reimpressão fotográfica de Shelley limita a precisão bibliográfica, e os arquivos de origem são transcrições, e não fac-símiles garantidos. As figuras comparam medidas declaradas, e não realizações literárias concorrentes. Essas limitações fazem parte da interpretação; não são motivo para suprimir um resultado estrutural reproduzível.
A conclusão sustentada é que uma distribuição do tamanho dos capítulos exige dizer de forma explícita o que conta como capítulo e o que fica de fora. Na transcrição de Shelley, separar ou juntar a moldura final muda bastante o extremo superior e a dispersão relativa, e deixa a mediana igual. A divisão completa e os valores de cobertura mostram as cartas iniciais que as duas convenções de capítulos omitem. Austen traz uma divisão completa em contraste e uma sensibilidade pequena e transparente sobre a formatação, mas não um grupo de controle representativo. Juntos, os casos mostram por que distribuições, cobertura, identidade da fonte e convenções de limites devem constar do mesmo relatório de medição.
A dispersão dos capítulos depende da convenção da moldura
Os cinco conjuntos de unidades declarados; coeficiente de variação (CV) da população e cobertura do texto mantido completo.
Gráfico completo e fonte
Role para os lados para examinar o gráfico. ↔
Gráfico e valores
Role a tabela para os lados para ver todas as colunas.
| Conjunto de unidades | Unidades | Tokens | Mínimo | 1º quartil | Mediana | 3º quartil | Máximo | CV da população | Cobertura (%) |
|---|---|---|---|---|---|---|---|---|---|
| Austen: 61 capítulos (principal) | 61 | 122.174 | 676 | 1.563,0 | 1.835,0 | 2.335,0 | 5.188 | 0,42458 | 100,0000 |
| Austen: sem os seis rótulos | 61 | 122.168 | 676 | 1.563,0 | 1.835,0 | 2.335,0 | 5.188 | 0,42458 | 100,0000 |
| Shelley: as 29 unidades estruturais | 29 | 75.228 | 299 | 2.074,0 | 2.616,0 | 3.015,0 | 5.268 | 0,34840 | 100,0000 |
| Shelley: 24 capítulos; moldura separada | 24 | 64.397 | 1.784 | 2.223,0 | 2.651,0 | 3.038,0 | 3.746 | 0,20839 | 85,6024 |
| Shelley: 24 capítulos; moldura junta | 24 | 69.665 | 1.784 | 2.223,0 | 2.651,0 | 3.133,5 | 8.269 | 0,43033 | 92,6051 |
Tokens do tokenizador fixo de letras latinas básicas, não palavras puras da narrativa. O CV (coeficiente de variação) usa o desvio-padrão da população. O denominador da cobertura é o texto mantido completo, com a mesma definição de limpeza; sem intervalos de amostragem. A linha dos seis rótulos de Austen é uma sensibilidade à parte, não uma substituição. As duas linhas de Shelley só com capítulos omitem as quatro cartas iniciais.

Dados e downloads
Role a tabela para os lados para ver todas as colunas.
| Conjunto de unidades | Unidades | Tokens | Mínimo | 1º quartil | Mediana | 3º quartil | Máximo | CV da população | Cobertura (%) |
|---|---|---|---|---|---|---|---|---|---|
| Austen: 61 capítulos (principal) | 61 | 122.174 | 676 | 1.563,0 | 1.835,0 | 2.335,0 | 5.188 | 0,42458 | 100,0000 |
| Austen: sem os seis rótulos | 61 | 122.168 | 676 | 1.563,0 | 1.835,0 | 2.335,0 | 5.188 | 0,42458 | 100,0000 |
| Shelley: as 29 unidades estruturais | 29 | 75.228 | 299 | 2.074,0 | 2.616,0 | 3.015,0 | 5.268 | 0,34840 | 100,0000 |
| Shelley: 24 capítulos; moldura separada | 24 | 64.397 | 1.784 | 2.223,0 | 2.651,0 | 3.038,0 | 3.746 | 0,20839 | 85,6024 |
| Shelley: 24 capítulos; moldura junta | 24 | 69.665 | 1.784 | 2.223,0 | 2.651,0 | 3.133,5 | 8.269 | 0,43033 | 92,6051 |
Tokens do tokenizador fixo de letras latinas básicas, não palavras puras da narrativa. O CV (coeficiente de variação) usa o desvio-padrão da população. O denominador da cobertura é o texto mantido completo, com a mesma definição de limpeza; sem intervalos de amostragem. A linha dos seis rótulos de Austen é uma sensibilidade à parte, não uma substituição. As duas linhas de Shelley só com capítulos omitem as quatro cartas iniciais.
Role a tabela para os lados para ver todas as colunas.
| Componente ou conjunto | Unidades | Tokens |
|---|---|---|
| Cartas iniciais | 4 | 5.563 |
| Capítulos nomeados, moldura separada | 24 | 64.397 |
| Continuação final de Walton | 1 | 5.268 |
| Divisão completa | 29 | 75.228 |
| Capítulos nomeados, moldura junta | 24 | 69.665 |
A moldura final é uma unidade principal explícita, e não um capítulo por omissão. O conjunto de capítulos com a moldura junta continua sem as cartas iniciais.
Evidências e método
Como calculamos
- Corpus fixo, com impressões digitais exatas, PG1342 e PG42324; limites das seções e tokenizador congelados antes dos cálculos de tamanho.
- 90 observações de limite por unidade, conferências completas da numeração e pontos de início e fim explícitos; sem alegação de anotação humana de referência.
- Mascaramento de ilustrações com colchetes balanceados, exclusão das notas de rodapé numeradas e manutenção do aparato das seções; a contagem principal de Austen inclui seis rótulos de formatação documentados.
- Quartis interpolados inclusivos e CV da população; os conjuntos completo, de capítulos nomeados e com a moldura junta usam denominadores de cobertura explícitos.
- Reprodução padrão só com agregados; extração bruta opcional com conferência exata das impressões digitais; uma implementação diferente coincide nas 90 contagens por unidade, e conferências aritméticas separadas cobrem todos os conjuntos de resumo.
O que os dados não permitem concluir
- Duas transcrições escolhidas de propósito não representam autores, gêneros, épocas nem populações; não se infere relação populacional de tamanhos.
- A contagem de tokens não mede qualidade literária, gosto, ritmo percebido, envolvimento nem tempo de leitura.
- O tokenizador de letras latinas básicas e o aparato mantido das seções impedem a leitura como palavras puras da narrativa; a sensibilidade dos seis rótulos é restrita e não é uma limpeza completa.
- As transcrições do PG não são fac-símiles impressos garantidos; a identidade da reimpressão fotográfica de Shelley não está especificada.
- Declarações de domínio público nos EUA não estabelecem direitos fora dos EUA, licença para o mundo todo nem permissão para redistribuir o texto de origem em qualquer lugar.
Fontes originais
- Project Gutenberg 1342: Pride and Prejudice
Project Gutenberg 1342: Pride and Prejudice: a folha de rosto da transcrição congelada identifica George Allen 1894, prefácio de Saintsbury e ilustrações de Thomson; materiais acrescentados excluídos. O registro oficial indica domínio público nos EUA. A atualização de 1º de setembro no cabeçalho bruto difere da de 29 de setembro de 2026 no catálogo; a impressão digital exata dos bytes identifica a entrada.
Acesso em 30 de outubro de 2026
- Project Gutenberg 42324: Frankenstein
Project Gutenberg 42324: Frankenstein: versão de 1831 de H. Colburn e R. Bentley, por reimpressão fotográfica não especificada, e não a versão de 1818. Introdução excluída; a identidade da reimpressão continua não especificada. O registro oficial indica domínio público nos EUA; cabeçalho e catálogo atualizados em 23 de outubro de 2026.
Acesso em 30 de outubro de 2026
- Project Gutenberg Permission How-to
Orientações de permissão do Project Gutenberg: explicam os limites de jurisdição fora dos EUA e avisam que as transcrições não precisam coincidir com uma edição impressa específica. Não se infere liberação universal de direitos nem endosso.
Acesso em 30 de outubro de 2026
Como citar e reutilizar
Alisson Bento. Quando a moldura final muda a distribuição do tamanho dos capítulos. Medição estrutural das transcrições 1342 e 42324 do Project Gutenberg, obtidas em 30 de outubro de 2026; versões de origem de 1894 e 1831. https://alissonbento.com/pt/research/chapter-frame-length-two-transcriptions/
Análise, cálculos e explicação originais: Alisson Bento. Romances originais: Jane Austen e Mary Wollstonecraft Shelley. Prefácio de Saintsbury e ilustrações de Thomson na fonte de Austen excluídos; a fonte de Shelley é de 1831, por reimpressão fotográfica não especificada. Itens do Gutenberg marcados como domínio público nos EUA; não se afirma liberação jurídica universal nem endosso. Só dados derivados compactos e código, sem romances completos.
Correções ou dúvidas editoriais