Contar capítulos también exige decidir dónde están sus límites
Una novela puede tener una extensión total estable y, aun así, dar distribuciones distintas de la longitud de sus capítulos. La diferencia no tiene por qué venir de cambiar las palabras. Puede venir de decidir si un marco narrativo exterior pertenece al último capítulo numerado, si las cartas iniciales cuentan como capítulos y si la medición abarca todas las secciones retenidas. Este estudio examina esas decisiones en dos transcripciones fijas del Project Gutenberg: Pride and Prejudice, ítem 1342, y la versión de 1831 de Frankenstein, ítem 42324. No se trata de clasificar a las autoras ni de caracterizar sus géneros. Se trata de mostrar con exactitud cómo una convención estructural declarada cambia un resultado descriptivo.
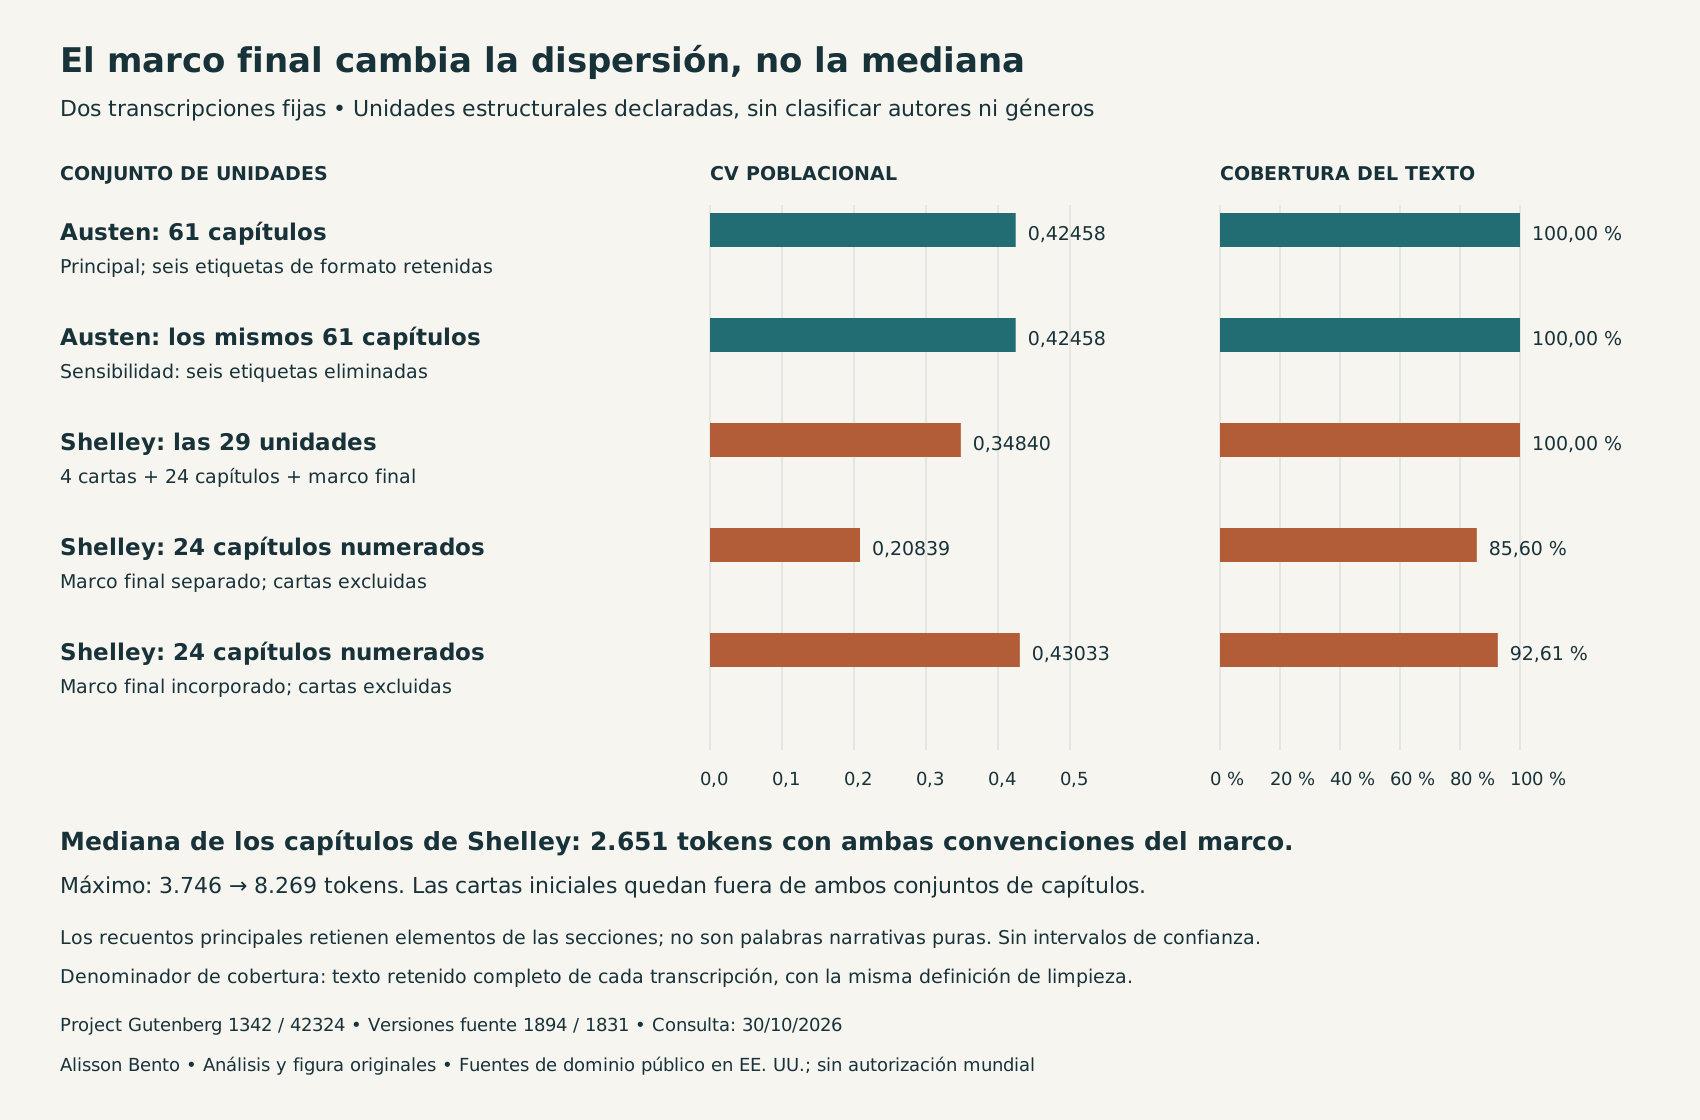
El ejemplo central es la continuación final de Walton en la transcripción de Frankenstein. Cuando esa sección se mantiene aparte, los 24 capítulos con nombre tienen un coeficiente de variación poblacional de 0,20839. Si la misma sección se añade al capítulo XXIV, el coeficiente sube a 0,43033. La mediana sigue en 2.651 tokens, pero el máximo pasa de 3.746 a 8.269. Una mediana que no cambia no significa, por tanto, que la distribución no cambie. También cambia la cobertura, porque los dos conjuntos de capítulos incluyen partes distintas del texto retenido. Las cuatro cartas iniciales quedan fuera de las dos definiciones que se limitan a los capítulos.
Son cálculos deterministas sobre dos archivos concretos, no estimaciones a partir de una muestra representativa de ficción. Los mismos bytes de la fuente se usaron antes para otra pregunta, sobre qué parte del texto está entre comillas. Aquí se miden unidades estructurales con nombre, su tamaño relativo y cuánto cubren de un denominador completo, el texto retenido. Ni los porcentajes de texto entre comillas ni los totales de tokens revelan por sí solos la distribución que depende del marco y que se presenta aquí. La aportación es un cálculo de caso que se puede auditar. No se afirma haber descubierto el problema general de segmentar textos.
Dos transcripciones, no dos versiones universales
El corpus se fijó antes de calcular la longitud de los capítulos. Contiene exactamente los dos archivos ya fijados antes, sin sustituciones elegidas después de ver los resultados. La transcripción de Austen identifica una fuente de George Allen de 1894, con prefacio de George Saintsbury e ilustraciones de Hugh Thomson. Esos materiales añadidos quedan fuera del texto medido. El archivo de Shelley identifica la versión de H. Colburn y R. Bentley de 1831 a través de una reimpresión fotográfica sin especificar. No se ha establecido la identidad bibliográfica exacta de esa reimpresión. Por eso es más preciso hablar de la versión fuente de 1831 que afirmar que se tuvo acceso a un ejemplar físico original concreto.
La identidad de la edición importa porque la presentación de los capítulos, el material editorial, la tipografía y las prácticas de transcripción pueden afectar a los límites que se calculan. El propio Project Gutenberg advierte de que sus transcripciones no tienen por qué reproducir de forma idéntica una edición impresa concreta. Los resultados describen estas transcripciones, no todas las ediciones, manuscritos, traducciones o adaptaciones de las dos obras. No se reconstruye la estructura de los volúmenes originales cuando los archivos analizados no la dan dentro del texto medido. Los créditos señalan a los colaboradores históricos sin atribuir su autoría a quien analiza.
Los archivos se obtuvieron el 30 de octubre de 2026. Esa fecha indica cuándo se descargaron, no cuándo se escribió ni se publicó por primera vez cada novela. El catálogo de Austen indica ahora una actualización del 29 de septiembre de 2026, mientras que la cabecera del archivo fijado indica el 1 de septiembre. En lugar de tratar esas fechas como intercambiables, el análisis identifica la entrada por su tamaño exacto en bytes y por su huella digital SHA256. El catálogo y la cabecera de Shelley indican los dos el 23 de octubre de 2026. Un archivo de reemplazo posterior, aunque tenga el mismo número de Gutenberg, no se acepta en silencio como la entrada fijada.
Qué mide el separador de palabras
Toda longitud que se indica es un recuento de tokens, que son las unidades que produce la expresión fija [A-Za-z]+(?:['’][A-Za-z]+)*. Esta reconoce secuencias de letras latinas básicas, con apóstrofos internos opcionales, rectos o curvos. Las expresiones con guion se dividen en varios tokens y los dígitos no cuentan como palabras. Las letras con acento y las ligaduras no se reconocen con esta expresión como palabras completas. Mantener fija la regla hace que los cálculos sean reproducibles, pero no convierte el resultado en una definición lingüística universal de «palabra». Por eso, «tokens del texto retenido» y «tokens de sección» son denominaciones más exactas que «palabras narrativas puras».
Antes de separar las palabras, los bytes originales se mantienen sin cambios y se comparan con sus huellas fijadas. Se descodifica una copia de trabajo y se normalizan sus finales de línea. Los bloques de ilustración con corchetes equilibrados se sustituyen por espacios, de modo que las posiciones de los caracteres normalizados no cambian, incluso cuando un pie de ilustración contiene corchetes anidados. Así se eliminan 154 bloques de ilustración en Austen y dos en Shelley. También se excluyen tres bloques de notas numeradas de Shelley; su recuento, con las etiquetas Footnote incluidas, es de 11 tokens. Las llamadas numéricas que quedan no aportan tokens alfabéticos. Las páginas preliminares, las introducciones, los prefacios, el material final y la licencia de Gutenberg quedan fuera de los límites elegidos.
Las fechas, los saludos, las firmas, los versos y la correspondencia incluida dentro de un capítulo se quedan en la sección que los contiene. La primera carta de Shelley empieza en su encabezado, de modo que el destinatario y la fecha iniciales aportan ocho tokens que se perderían si el punto de partida fuera la primera frase narrativa. Estas decisiones definen el texto de una sección, no un texto idealizado de pura prosa. Quitar todo el aparato de las cartas o todos los bloques de formato respondería a otra pregunta y podría descartar correspondencia que tiene sentido. Por eso se indica expresamente qué material se incluye, en lugar de suponer que todo lo que hay entre la primera y la última frase es homogéneo desde el punto de vista lingüístico.
Establecer las noventa unidades estructurales
La división principal de Austen tiene 61 capítulos. El primero necesita un tratamiento especial, porque la etiqueta «Chapter I» está dentro de una ilustración anterior a la primera frase narrativa. La primera unidad empieza en esa frase, ya comprobada; los demás encabezados van de II a LXI. Los capítulos XIII y XIV no llevan puntuación final, y XLVI mezcla mayúsculas y minúsculas. Un programa que exigiera un único patrón exacto, en mayúsculas y con puntuación, pasaría por alto límites reales. En cambio, buscar la palabra inglesa «chapter» en cualquier lugar reuniría referencias de ilustraciones y otro material que no marca límites. Ninguno de los dos atajos se considera prueba suficiente.
La división de Shelley tiene cuatro cartas iniciales, 24 capítulos con nombre y una continuación final de Walton: 29 unidades en total. Las cartas tienen encabezados explícitos y transiciones con firmas, destinatarios y fechas. La continuación final tiene su propio encabezado, después de la ruptura narrativa anterior, y vuelve a la narración exterior con fechas. La correspondencia incluida y el relato interior de la criatura quedan dentro de los capítulos donde aparecen. Las fechas dentro de la continuación final no crean capítulos nuevos. Así se mantiene la distinción entre una sección con nombre editorial, un relato incluido dentro de otro y un cambio de hablante o de ocasión dentro de un párrafo.
Cada posible límite se comprobó con el contexto retenido que lo rodea y se anotó en un archivo aparte de observaciones por límite. También se comprobaron las secuencias completas de numeración, los puntos de partida del texto y los finales narrativos. Los diagnósticos contienen posiciones y huellas, y no pasajes que no hacen falta. Son comprobaciones documentadas de contexto y de cálculo, no una afirmación de anotación hecha por personas, de acuerdo entre anotadores ni de una referencia validada sobre el significado. Las divisiones completas no tienen secciones que se solapen, y la suma de sus tokens es igual al recuento directo del texto retenido, una vez excluidos los encabezados. Esa igualdad comprueba la aritmética de la cobertura. Las observaciones registradas explican por qué los límites tienen sentido.
Divisiones completas y cobertura de los capítulos
La división de Austen contiene 122.174 tokens principales en sus 61 capítulos. Dentro de este texto retenido declarado, la división en capítulos es completa: cubre el 100 por ciento. La división completa de Shelley contiene 75.228 tokens en 29 unidades. Sus 24 capítulos, con la continuación de Walton aparte, contienen 64.397 tokens. Eso es el 85,6024 por ciento del texto retenido completo. La parte que falta no son datos perdidos ni un fallo de extracción. Es el conjunto excluido expresamente de las cuatro cartas iniciales y el marco final, que suman 10.831 tokens.
Las cartas iniciales aportan 5.563 tokens y la continuación final, 5.268. Al añadir esta última al capítulo XXIV, el total del conjunto de capítulos sube a 69.665 y la cobertura al 92,6051 por ciento. Las cuatro cartas iniciales siguen fuera. Sería incorrecto, por tanto, llamar «la novela entera» a este conjunto de capítulos con el marco incorporado, o dividir sus longitudes entre un denominador que fingiera que las cartas no existen. La división completa en 29 unidades da el denominador común con el que se puede evaluar cualquiera de las dos convenciones de capítulos.
La cobertura y la distribución responden a preguntas distintas. La cobertura dice cuánto del texto retenido pertenece al conjunto de unidades elegido. La mediana dice qué hay en el centro de las longitudes ordenadas, dando el mismo peso a cada unidad elegida. Ninguna de las dos puede sustituir a la otra. Una distribución puede parecer regular y omitir una parte importante del material de encuadre. Y añadir una sección larga a una unidad que ya existe puede cambiar la cola superior sin cambiar el centro. Dar las dos medidas evita que un resumen cómodo de los capítulos se convierta, sin avisar, en la descripción de solo una parte del texto.
Las distribuciones más allá de los totales
En los 61 capítulos principales de Austen, la mediana es de 1.835 tokens. El primer y el tercer cuartil son 1.563 y 2.335, y las unidades más corta y más larga tienen 676 y 5.188 tokens. El coeficiente de variación poblacional es 0,42458. Estos resúmenes distinguen el centro, la mitad central y los extremos de las longitudes observadas. Los extremos son el mínimo y el máximo reales, no límites de confianza. El capítulo más largo aporta el 4,2464 por ciento del total retenido de los capítulos. Es otra descripción, con su propio denominador, de cuánto se concentra el texto en la unidad mayor.
En la división completa de Shelley en 29 unidades, la mediana es de 2.616 tokens, los cuartiles son 2.074 y 3.015 y el rango va de 299 a 5.268. Su coeficiente de variación poblacional es 0,34840. Este conjunto incluye las cartas y el marco final, así que no debe llamarse distribución de 29 capítulos. Para los 24 capítulos solos, con el marco aparte, la mediana es 2.651, los cuartiles son 2.223 y 3.038, y el mínimo y el máximo son 1.784 y 3.746. Son poblaciones de unidades distintas, sacadas de la misma transcripción fija.
En estos dos casos, el total mayor es el de Austen, y su mediana de longitud de capítulo es menor. Esto ilustra por qué la longitud total no determina por sí sola el tamaño de los capítulos. Pero dos transcripciones elegidas a propósito no permiten establecer una relación general entre la longitud de una novela y la de sus capítulos. No se estima ninguna regresión, ninguna correlación en una población, ningún efecto del autor ni ninguna comparación de géneros. La tabla con todos los recuentos por unidad permite examinar la distribución de fondo, en lugar de depender solo de estadísticas resumidas. Y el corpus fijo impide cambiar un ejemplo por otro más favorable después de calcular.
Un marco final cambia la cola superior
La prueba de sensibilidad con el marco incorporado cambia una unidad de capítulo de Shelley que ya existía, en lugar de añadir un capítulo veinticinco. La continuación de 5.268 tokens se une al último capítulo con nombre y da una unidad combinada de 8.269 tokens. El número de capítulos sigue siendo 24, y las cartas iniciales siguen fuera del conjunto. El máximo sube, por tanto, de 3.746 a 8.269, y el tercer cuartil pasa de 3.038 a 3.133,5. La mediana se mantiene en 2.651 porque la unidad modificada no es una de las dos observaciones centrales con las que se calcula la mediana en un conjunto de tamaño par.
El coeficiente de variación sube de 0,20839 a 0,43033. Se calcula dividiendo la desviación estándar poblacional entre la media, dando el mismo peso a las 24 unidades. Añadir una cantidad grande a una unidad que ya existe sube la media, pero también crea una cola superior mucho más larga. La dispersión relativa aumenta, en lugar de quedar neutralizada por una media mayor. Por eso, dar solo el promedio o la mediana ocultaría una consecuencia importante de la convención sobre los límites. El cambio es determinista con la reasignación indicada. No es una fluctuación de muestreo ni un efecto causal estimado.
El coeficiente principal de Austen, 0,42458, queda entre las dos convenciones de capítulos de Shelley. Así, el orden aparente de la dispersión de sus capítulos se invierte cuando se añade la continuación de Walton. Que casi se crucen es una advertencia contra tratar un resumen sin etiquetar como una característica de la autora. No prueba que una de las dos escritoras sea más variable en un sentido general. La decisión estructural se ve en la transcripción, y las dos convenciones pueden presentarse con transparencia. Ninguna debe pasar por la respuesta única y natural sin explicar qué ocurre con el marco y con las cartas iniciales.
Formato retenido y una sensibilidad acotada
Una inspección aparte identificó seis tokens de etiquetas de formato que quedan en Austen: tres etiquetas NIND y tres RIGHT. Dos aparecen en el capítulo VII, y una en cada uno de los capítulos XIII, XLVII, XLIX y LII. Su presencia impide describir el total principal fijado, de 122.174, como un recuento perfectamente depurado de palabras narrativas. Las etiquetas están dentro de bloques de formato que también contienen saludos o fechas. Quitar cada bloque entero descartaría texto legítimo de la sección y no sería una corrección proporcionada al problema detectado.
La prueba de sensibilidad declarada quita, por eso, solo los seis tokens de etiqueta, en las posiciones de caracteres normalizadas que se registraron. No sustituye la extracción principal, no cambia el separador de palabras ni reescribe el protocolo original después de ver los resultados. Con este cambio limitado, el total de Austen pasa a 122.168 y su coeficiente de variación pasa a 0,4245761045, en lugar de 0,4245847284. La mediana, los cuartiles, el mínimo y el máximo no cambian. También se mantiene el orden de la dispersión que depende de la convención, descrito antes. Se conservan los resultados principales y los de la prueba de sensibilidad, para que el pequeño efecto numérico se vea y no se borre en silencio.
Esta comprobación no debe tomarse como una prueba de que se han eliminado todos los posibles restos de la transcripción. Se refiere a un conjunto concreto de etiquetas observadas, no a una búsqueda sin límites de un recuento que se prefiera. Una limpieza lingüística más ambiciosa necesitaría sus propias reglas y su validación, sobre todo para abreviaturas, guiones de división, letras con acento y material de las cartas. La conclusión actual es más limitada: las seis etiquetas identificadas no explican el resultado de añadir el marco. Mantener esta distinción separa una comprobación de robustez medida de la afirmación de que el texto es perfecto.
Los límites de los capítulos y las reglas de identificación de texto entre comillas son decisiones de medición distintas; sus efectos no determinan el ritmo narrativo, la prevalencia del diálogo ni la calidad literaria. Cómo cambian la medición las reglas de comillas en dos transcripciones de novelas
Reproducir los cálculos sin redistribuir las novelas
La vía de reproducción breve parte de los recuentos por unidad que se suministran. Recalcula los resúmenes completos y los de solo capítulos, la prueba de sensibilidad con el marco incorporado, la cobertura, los cuartiles inclusivos y los coeficientes de variación poblacionales. No hace falta descargar ninguna novela, y solo produce datos derivados. Así la aritmética es accesible, y las cuestiones de derechos y de jurisdicción sobre redistribuir textos fuente quedan separadas de la tarea numérica. Una segunda vía, opcional, comprueba los archivos originales exactos con las huellas registradas antes de repetir la extracción, con carpetas de entrada y salida indicadas de forma expresa.
Las comprobaciones de la extracción usan dos implementaciones con enfoques estructurales distintos. Una conserva las posiciones enmascarando los bloques excluidos e identifica los encabezados con nombre. La otra elimina de forma repetida los bloques con corchetes anidados y agrupa las líneas en secciones. Sus recuentos por unidad coinciden en las 90 unidades. Esa segunda implementación comprueba directamente las divisiones completas. Un nuevo cálculo de los resúmenes comprueba además las estadísticas de solo capítulos y de marco incorporado. Que coincidan respalda la implementación para estas entradas, pero no crea una referencia independiente de anotación del significado. Los registros de observación y la convención declarada del marco siguen siendo una prueba necesaria junto con la coincidencia aritmética.
Los cuartiles usan interpolación lineal inclusiva, y el coeficiente de variación usa la desviación estándar poblacional, no la muestral. No se inventa ningún intervalo de incertidumbre alrededor de recuentos exactos de archivos fijados. Las incertidumbres que importan son las de las ediciones, la definición de token, el formato retenido y la interpretación estructural, no el error de muestreo de estos conjuntos completos de unidades. La documentación de reproducción indica qué se calcula con huella y cómo se definen las posiciones normalizadas. La huella del texto tras enmascarar con espacios no se presenta por error como la huella de un fragmento del archivo original. Si cambian los bytes de la fuente, la verificación falla, en lugar de dar un resultado que parezca comparable con el mismo nombre de archivo.
Alcance, derechos y la conclusión que se mantiene
Los registros actuales de los dos ítems de Gutenberg marcan sus obras como de dominio público en Estados Unidos. Las cabeceras recibidas advierten a quienes están fuera de Estados Unidos de que comprueben la ley que les sea aplicable. Este análisis no convierte esas declaraciones en una autorización legal válida en todo el mundo, ni en una licencia de marca, ni en un permiso para publicar material de la fuente en cualquier lugar. Los materiales públicos contienen recuentos derivados compactos, cálculos, diagnósticos de los límites y referencias, no novelas completas, ilustraciones ni prefacios. La atribución distingue a las autoras originales y a quienes contribuyeron a las fuentes de los cálculos y las explicaciones originales de Alisson Bento.
Varias preguntas quedan fuera de lo que muestran los datos. La muestra no representa a autores, géneros, literaturas nacionales ni la edición actual. La longitud en tokens no mide el tiempo de lectura, el ritmo que se percibe, el interés, la calidad literaria, el gusto del lector ni la dificultad. La identidad sin especificar de la reimpresión fotográfica de Shelley limita la precisión bibliográfica, y los archivos fuente son transcripciones, no facsímiles garantizados. Las cifras comparan mediciones declaradas, no logros literarios que compitan entre sí. Estas limitaciones forman parte de la interpretación. No son razones para ocultar un resultado estructural reproducible.
La conclusión que se sostiene es que una distribución de la longitud de los capítulos necesita explicar qué cuenta como capítulo y qué queda fuera. En la transcripción de Shelley, separar o añadir el marco final cambia mucho la cola superior y la dispersión relativa, y deja igual la mediana. La división completa y las cifras de cobertura muestran las cartas iniciales que omiten las dos convenciones de capítulos. Austen aporta una división completa en capítulos como contraste y una pequeña prueba de sensibilidad de formato transparente, no un grupo de control representativo. En conjunto, los casos muestran por qué la distribución, la cobertura, la identidad de la fuente y las convenciones sobre los límites deben ir en un mismo informe de medición.
La dispersión de los capítulos depende de la convención del marco
Los cinco conjuntos declarados; coeficiente de variación poblacional y cobertura del texto retenido completo.
Gráfico completo y fuente
Desplaza el gráfico horizontalmente para examinarlo. ↔
Gráfico y valores
Desplaza la tabla horizontalmente para ver todas las columnas.
| Conjunto de unidades | Unidades | Tokens | Mínimo | Primer cuartil (Q1) | Mediana | Tercer cuartil (Q3) | Máximo | CV poblacional | Cobertura (%) |
|---|---|---|---|---|---|---|---|---|---|
| Austen: 61 capítulos (principal) | 61 | 122.174 | 676 | 1.563,0 | 1.835,0 | 2.335,0 | 5.188 | 0,42458 | 100,0000 |
| Austen: seis etiquetas eliminadas | 61 | 122.168 | 676 | 1.563,0 | 1.835,0 | 2.335,0 | 5.188 | 0,42458 | 100,0000 |
| Shelley: las 29 unidades estructurales | 29 | 75.228 | 299 | 2.074,0 | 2.616,0 | 3.015,0 | 5.268 | 0,34840 | 100,0000 |
| Shelley: 24 capítulos; marco separado | 24 | 64.397 | 1.784 | 2.223,0 | 2.651,0 | 3.038,0 | 3.746 | 0,20839 | 85,6024 |
| Shelley: 24 capítulos; marco incorporado | 24 | 69.665 | 1.784 | 2.223,0 | 2.651,0 | 3.133,5 | 8.269 | 0,43033 | 92,6051 |
Tokens de un separador de palabras fijo, limitado al alfabeto latino básico; no son palabras narrativas puras. El CV usa la desviación estándar poblacional. El denominador de la cobertura es el texto retenido completo con la misma definición de limpieza; no hay intervalos de muestreo. La fila de Austen con seis etiquetas es una prueba de sensibilidad aparte, no un reemplazo. Las dos filas de Shelley limitadas a capítulos omiten las cuatro cartas iniciales.

Datos y descargas
Desplaza la tabla horizontalmente para ver todas las columnas.
| Conjunto de unidades | Unidades | Tokens | Mínimo | Primer cuartil (Q1) | Mediana | Tercer cuartil (Q3) | Máximo | CV poblacional | Cobertura (%) |
|---|---|---|---|---|---|---|---|---|---|
| Austen: 61 capítulos (principal) | 61 | 122.174 | 676 | 1.563,0 | 1.835,0 | 2.335,0 | 5.188 | 0,42458 | 100,0000 |
| Austen: seis etiquetas eliminadas | 61 | 122.168 | 676 | 1.563,0 | 1.835,0 | 2.335,0 | 5.188 | 0,42458 | 100,0000 |
| Shelley: las 29 unidades estructurales | 29 | 75.228 | 299 | 2.074,0 | 2.616,0 | 3.015,0 | 5.268 | 0,34840 | 100,0000 |
| Shelley: 24 capítulos; marco separado | 24 | 64.397 | 1.784 | 2.223,0 | 2.651,0 | 3.038,0 | 3.746 | 0,20839 | 85,6024 |
| Shelley: 24 capítulos; marco incorporado | 24 | 69.665 | 1.784 | 2.223,0 | 2.651,0 | 3.133,5 | 8.269 | 0,43033 | 92,6051 |
Tokens de un separador de palabras fijo, limitado al alfabeto latino básico; no son palabras narrativas puras. El CV usa la desviación estándar poblacional. El denominador de la cobertura es el texto retenido completo con la misma definición de limpieza; no hay intervalos de muestreo. La fila de Austen con seis etiquetas es una prueba de sensibilidad aparte, no un reemplazo. Las dos filas de Shelley limitadas a capítulos omiten las cuatro cartas iniciales.
Desplaza la tabla horizontalmente para ver todas las columnas.
| Componente o conjunto | Unidades | Tokens |
|---|---|---|
| Cartas iniciales | 4 | 5.563 |
| Capítulos con nombre, marco separado | 24 | 64.397 |
| Continuación final de Walton | 1 | 5.268 |
| Partición completa | 29 | 75.228 |
| Capítulos con nombre, marco incorporado | 24 | 69.665 |
El marco final es una unidad principal explícita, no un capítulo implícito. El conjunto de capítulos con el marco incorporado sigue excluyendo las cartas iniciales.
Evidencia y método
Cómo lo calculamos
- Corpus fijo con las huellas exactas de PG1342 y PG42324. Los límites de las secciones y el separador de palabras se fijaron antes de calcular las longitudes.
- 90 observaciones de límites, una por unidad; comprobación completa de la numeración; puntos de partida y de final del texto indicados de forma expresa. No se afirma que haya una referencia validada de anotación humana.
- Enmascarado de ilustraciones con corchetes equilibrados, exclusión de las notas numeradas y conservación del aparato de las secciones. El cálculo principal de Austen incluye seis etiquetas de formato documentadas.
- Cuartiles con interpolación inclusiva y CV poblacional. Los conjuntos completo, de capítulos con nombre y de marco incorporado usan denominadores de cobertura explícitos.
- Reproducción por defecto solo con datos agregados; extracción opcional a partir de los archivos originales con huellas exactas. Una implementación distinta coincide en los 90 recuentos por unidad, y comprobaciones aritméticas aparte cubren todos los conjuntos resumidos.
Lo que los datos no permiten concluir
- Dos transcripciones elegidas a propósito no representan a autores, géneros, épocas ni poblaciones. No se deduce ninguna relación de longitudes para una población.
- El número de tokens no mide la calidad literaria, el gusto, el ritmo que se percibe, el interés ni el tiempo de lectura.
- El separador de palabras de alfabeto latino básico y el aparato de las secciones que se conserva impiden interpretar los recuentos como palabras narrativas puras. La prueba de sensibilidad de seis etiquetas es limitada, no una limpieza completa.
- Las transcripciones del Project Gutenberg no son facsímiles impresos garantizados. La identidad de la reimpresión fotográfica de Shelley no está especificada.
- Las declaraciones de dominio público en Estados Unidos no establecen derechos fuera de ese país, ni una licencia mundial, ni permiso para redistribuir el texto fuente en todas partes.
Fuentes originales
- Project Gutenberg 1342: Pride and Prejudice
Project Gutenberg 1342: Pride and Prejudice. Las páginas preliminares de la transcripción fijada identifican a George Allen, 1894, el prefacio de Saintsbury y las ilustraciones de Thomson; esos añadidos se excluyen. El registro oficial indica dominio público en Estados Unidos. La actualización de la cabecera del archivo, del 1 de septiembre, difiere de la del catálogo, del 29 de septiembre de 2026; la huella exacta de los bytes identifica la entrada.
Consultado 30 de octubre de 2026
- Project Gutenberg 42324: Frankenstein
Project Gutenberg 42324: Frankenstein. Versión de 1831 de H. Colburn y R. Bentley a través de una reimpresión fotográfica sin especificar, no la versión de 1818. Se excluye la introducción; la identidad de la reimpresión sigue sin especificarse. El registro oficial indica dominio público en Estados Unidos; la actualización de la cabecera y la del catálogo son del 23 de octubre de 2026.
Consultado 30 de octubre de 2026
- Project Gutenberg Permission How-to
Guía de permisos del Project Gutenberg: explica los límites según la jurisdicción fuera de Estados Unidos y advierte de que las transcripciones pueden no coincidir con una edición impresa concreta. No se deduce ninguna autorización general ni respaldo institucional.
Consultado 30 de octubre de 2026
Cómo citar y reutilizar
Alisson Bento. Cuando el marco final modifica la distribución de la longitud de los capítulos. Medición estructural de las transcripciones 1342 y 42324 del Project Gutenberg, obtenidas el 30 de octubre de 2026; versiones fuente de 1894 y 1831. https://alissonbento.com/es/research/chapter-frame-length-two-transcriptions/
Análisis, cálculos y explicación originales: Alisson Bento. Novelas originales: Jane Austen y Mary Wollstonecraft Shelley. Se excluyen el prefacio de Saintsbury y las ilustraciones de Thomson de la fuente de Austen; la fuente de Shelley es de 1831, a través de una reimpresión fotográfica sin especificar. Los ítems de Gutenberg están marcados como dominio público en Estados Unidos; no se afirma ninguna autorización legal general ni respaldo institucional. Solo se ofrecen datos derivados compactos y código, sin novelas completas.
Correcciones o consultas editoriales