
Compter des chapitres, c’est aussi décider de leurs frontières
Un roman peut conserver une longueur totale stable tout en donnant des distributions différentes des longueurs de chapitre. Il n’est pas nécessaire de changer les mots pour obtenir cette différence. Il suffit parfois de décider si un récit-cadre extérieur appartient au dernier chapitre numéroté, si les lettres initiales comptent comme des chapitres et si la mesure couvre chaque section retenue. Cette étude examine ces décisions dans deux transcriptions figées de Project Gutenberg : Pride and Prejudice, numéro 1342, et la version de 1831 de Frankenstein, numéro 42324. L’objectif n’est pas de classer les auteurs ou de caractériser leurs genres, mais de montrer précisément comment une convention structurelle déclarée modifie un résultat descriptif.
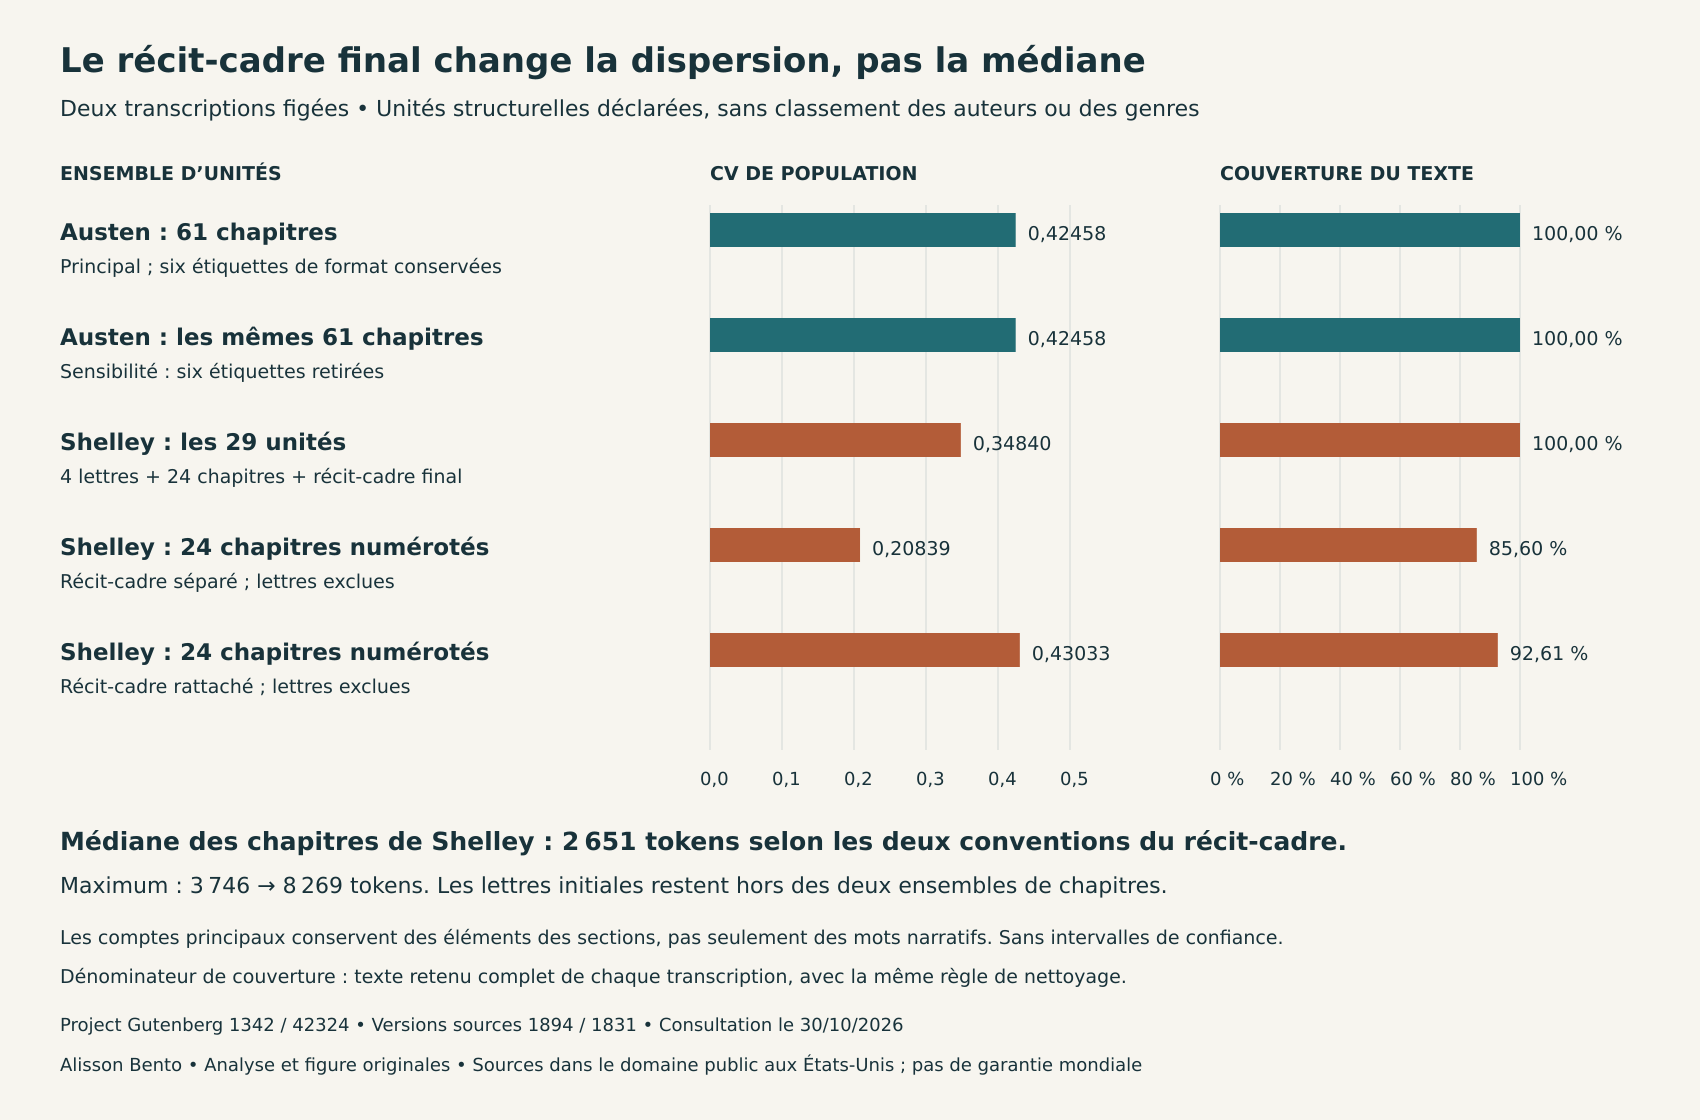
L’exemple central est la continuation finale de Walton dans la transcription de Frankenstein. Quand cette section est séparée, les 24 chapitres nommés présentent un coefficient de variation de population de 0,20839. Rattacher cette même section au chapitre XXIV porte le coefficient à 0,43033. La médiane reste de 2 651 unités lexicales, mais le maximum passe de 3 746 à 8 269. Une médiane inchangée n’implique donc pas une distribution inchangée. La couverture varie également, car ces ensembles de chapitres comprennent différentes parties du texte retenu. Les quatre lettres initiales restent hors des deux définitions limitées aux chapitres.
Il s’agit de calculs déterministes portant sur deux fichiers spécifiés, non d’estimations issues d’un échantillon représentatif de la fiction. Les mêmes octets sources avaient déjà servi à une question différente sur la délimitation des citations. Ici, les objets mesurés sont des unités structurelles nommées, leurs tailles relatives et leur couverture d’un dénominateur constitué du texte retenu complet. Ni les pourcentages de citations ni les seuls nombres totaux de unités lexicales ne révèlent la distribution dépendante du récit-cadre étudiée ici. La contribution est un calcul de cas contrôlable, sans prétendre découvrir le problème général de la segmentation des textes.
Deux transcriptions, pas deux versions universelles
Le corpus a été fixé avant le calcul des longueurs. Il contient exactement les deux fichiers précédemment figés, sans substitution choisie après examen des résultats. La transcription d’Austen identifie une source George Allen de 1894, avec une préface de George Saintsbury et des illustrations de Hugh Thomson. Ces ajouts sont exclus du corps mesuré. Le fichier de Shelley identifie la version H. Colburn et R. Bentley de 1831, transmise par une réimpression photographique non précisée. L’identité bibliographique exacte de cette réimpression n’est pas établie. Parler de version source de 1831 est donc plus précis que revendiquer l’accès à un exemplaire physique original particulier.
L’identité de l’édition importe, car la présentation des chapitres, les éléments éditoriaux, la typographie et les pratiques de transcription peuvent influer sur les frontières informatiques. Project Gutenberg avertit que ses transcriptions ne reproduisent pas nécessairement à l’identique une édition imprimée donnée. Les résultats décrivent ces transcriptions, non toutes les éditions, tous les manuscrits, traductions ou adaptations des œuvres. Aucune structure originale en volumes n’est reconstruite lorsque les fichiers analysés n’en fournissent pas à l’intérieur du corps mesuré. Les crédits identifient les contributeurs historiques sans transférer leur qualité d’auteur à l’analyste.
Les fichiers ont été récupérés le 30 octobre 2026. Cette date désigne leur acquisition, non la composition ou la première publication des romans. Le catalogue d’Austen indique une mise à jour le 29 septembre 2026, tandis que l’en-tête du fichier figé mentionne le 1er septembre. Plutôt que de considérer ces dates comme interchangeables, l’analyse identifie l’entrée par son nombre exact d’octets et son empreinte SHA256. Pour Shelley, catalogue et en-tête indiquent tous deux le 23 octobre 2026. Un fichier ultérieurement remplacé, même sous le même numéro Gutenberg, n’est pas accepté silencieusement comme l’entrée figée.
Ce que mesure le découpage en unités lexicales
Chaque longueur est un nombre d’unités lexicales (« tokens ») produites par l’expression fixe [A-Za-z]+(?:['’][A-Za-z]+)*. Elle reconnaît des suites de lettres latines de base, avec éventuellement des apostrophes droites ou courbes internes. Les expressions avec traits d’union sont divisées en plusieurs unités lexicales, et les chiffres ne comptent pas comme des mots. Cette expression ne couvre pas les lettres accentuées et les ligatures comme des mots alphabétiques complets. Maintenir la règle fixe rend le calcul reproductible, sans donner une définition linguistique universelle du mot. Les expressions « unités lexicales du texte retenu » ou « unités lexicales des sections » sont donc plus exactes que « mots purement narratifs ».
Avant le découpage en unités lexicales, les octets bruts restent inchangés et sont comparés aux empreintes figées. Une copie de travail est décodée et ses fins de ligne normalisées. Les blocs d’illustration à crochets équilibrés sont remplacés par des espaces, ce qui préserve les positions normalisées des caractères même lorsqu’une légende contient des crochets imbriqués. L’opération retire 154 blocs d’illustration du corps d’Austen et deux de celui de Shelley. Trois blocs de notes numérotées de Shelley sont également exclus. Leur décompte, incluant les étiquettes Footnote, est de 11 unités lexicales. Les appels numériques restants ne produisent aucun token alphabétique. Pages liminaires, introductions, préfaces, éléments finaux et licence Gutenberg sont hors des limites choisies.
Dates, salutations, signatures, vers et correspondance insérée restent dans leurs sections respectives. La première lettre de Shelley commence à son titre ; son destinataire et sa date initiaux ajoutent donc huit unités lexicales qui seraient omises avec un ancrage sur la première phrase narrative. Ces choix définissent un texte de sections, plutôt qu’un corps idéalisé de prose seule. Supprimer tous les éléments des lettres ou tous les blocs de mise en forme répondrait à une autre question et pourrait éliminer une correspondance significative. L’analyse explicite ainsi les éléments inclus, sans supposer que tout ce qui figure entre la première et la dernière phrase est linguistiquement homogène.
Établir les quatre-vingt-dix unités structurelles
La partition principale d’Austen comporte 61 chapitres. Le premier nécessite un traitement particulier, car l’étiquette Chapter I se trouve dans une illustration précédant la phrase narrative initiale. La première unité commence à cette phrase vérifiée ; les titres suivants vont de II à LXI. Les chapitres XIII et XIV n’ont pas de ponctuation terminale et XLVI utilise une casse mixte. Un analyseur exigeant un unique motif ponctué en majuscules manquerait de véritables frontières. À l’inverse, chercher partout le mot chapter recueillerait des références d’illustration et d’autres éléments sans fonction de frontière. Aucun de ces raccourcis n’est considéré comme une preuve suffisante.
La partition de Shelley comprend quatre lettres initiales, 24 chapitres nommés et une continuation finale de Walton, soit 29 unités au total. Les lettres possèdent des titres explicites et des transitions faisant intervenir signatures, destinataires et dates. La continuation finale possède son propre titre après une rupture narrative et revient à une narration extérieure datée. La correspondance insérée et le récit enchâssé de la créature restent dans les chapitres où ils apparaissent. Les dates internes à la continuation finale ne créent pas de nouvelles unités de chapitre. Cette approche distingue une section explicitement nommée d’un récit enchâssé ou d’un changement de locuteur ou d’occasion au niveau du paragraphe.
Chaque frontière candidate a été contrôlée par rapport au contexte adjacent conservé et consignée dans un fichier séparé d’observations par frontière. Les séquences complètes de numérotation, les ancrages initiaux et les fins narratives ont aussi été vérifiés. Les diagnostics contiennent des positions et des empreintes plutôt que des passages inutiles. Ce sont des contrôles documentés du contexte textuel et du calcul, sans revendication d’annotation humaine, d’accord entre annotateurs ou d’étalon sémantique. Les partitions exhaustives ne se chevauchent pas ; la somme de leurs unités lexicales égale le décompte direct des unités lexicales du corps retenu après exclusion des titres. Cette identité contrôle la couverture arithmétique ; les observations consignées documentent le sens des frontières.
Partitions complètes et couverture des seuls chapitres
La partition d’Austen compte 122 174 unités lexicales principaux dans ses 61 chapitres. Dans le corps textuel retenu selon la définition déclarée, cette partition est exhaustive : sa couverture est de 100 %. Celle de Shelley contient 75 228 unités lexicales répartis entre 29 unités. Les 24 chapitres, lorsque la continuation de Walton reste séparée, contiennent 64 397 unités lexicales. Cela représente 85,6024 % du dénominateur complet. La portion absente n’est ni une perte de données ni un échec d’extraction. Elle correspond aux quatre lettres initiales et au récit-cadre final explicitement exclus, qui totalisent 10 831 unités lexicales.
Les lettres initiales contribuent 5 563 unités lexicales et la continuation finale 5 268. Rattacher cette dernière au chapitre XXIV porte le total de l’ensemble des chapitres à 69 665 et sa couverture à 92,6051 %. Les quatre lettres initiales restent omises. Il serait donc incorrect de qualifier cet ensemble à récit-cadre rattaché de roman entier, ou de rapporter ses longueurs à un dénominateur faisant comme si les lettres n’existaient pas. La partition complète en 29 unités fournit le dénominateur commun permettant d’évaluer les deux conventions de chapitre.
Couverture et distribution répondent à des questions différentes. La couverture indique quelle part du texte retenu appartient à l’ensemble sélectionné. La médiane indique le centre des longueurs classées, chaque unité sélectionnée recevant le même poids. Aucune mesure ne remplace l’autre. Une distribution peut paraître régulière tout en omettant une part substantielle du récit-cadre ; ajouter une longue section à une unité existante peut modifier la partie haute de la distribution sans déplacer le centre. Présenter les deux mesures évite qu’un résumé commode des chapitres décrive implicitement le roman alors qu’il n’en couvre qu’une partie.
Les distributions au-delà de leurs totaux
Pour les 61 chapitres principaux d’Austen, la médiane est de 1 835 unités lexicales. Les premier et troisième quartiles sont de 1 563 et 2 335 ; les unités extrêmes contiennent 676 et 5 188 unités lexicales. Le coefficient de variation de population vaut 0,42458. Ces résumés distinguent le centre, la moitié centrale et les limites observées des longueurs. Les extrémités sont les minimum et maximum effectifs, non des bornes de confiance. Le chapitre le plus long représente 4,2464 % du total retenu, autre manière, avec son dénominateur propre, de décrire la concentration du texte dans sa plus grande unité.
Pour la partition exhaustive de Shelley en 29 unités, la médiane est de 2 616 unités lexicales, les quartiles de 2 074 et 3 015, et les extrêmes de 299 et 5 268. Le coefficient de variation de population vaut 0,34840. Cet ensemble comprend les lettres et le récit-cadre final ; sa distribution ne doit donc pas être appelée distribution de 29 chapitres. Pour les 24 chapitres seuls, récit-cadre séparé, la médiane vaut 2 651, les quartiles 2 223 et 3 038, et les minimum et maximum 1 784 et 3 746. Ce sont des populations d’unités différentes issues de la même transcription figée.
Le total plus élevé d’Austen coexiste avec une longueur médiane de chapitre plus faible dans ces deux cas. Cette observation illustre que la longueur totale ne détermine pas à elle seule la taille des chapitres. Deux transcriptions choisies à dessein ne permettent toutefois pas d’établir une relation générale entre longueur des romans et longueur des chapitres. Aucune régression, corrélation de population, influence de l’auteur ou comparaison de genres n’est estimée. Le tableau complet des décomptes par unité permet d’examiner la distribution sous-jacente au lieu de dépendre uniquement des statistiques condensées ; le corpus figé empêche de substituer un exemple favorable après les calculs.
Le récit-cadre final modifie la partie haute de la distribution
L’analyse de sensibilité au rattachement modifie une unité de chapitre existante de Shelley, sans ajouter un vingt-cinquième chapitre. La continuation de 5 268 unités lexicales rejoint le dernier chapitre nommé et forme une unité de 8 269 unités lexicales. Le nombre de chapitres reste de 24 et les lettres initiales restent hors de l’ensemble. Le maximum passe ainsi de 3 746 à 8 269 et le troisième quartile de 3 038 à 3 133,5. La médiane demeure à 2 651, car l’unité modifiée n’est pas l’une des deux observations centrales utilisées pour calculer la médiane d’un ensemble de taille paire.
Le coefficient de variation passe de 0,20839 à 0,43033. Il utilise l’écart-type de population divisé par la moyenne, avec le même poids pour chacun des 24 chapitres. Ajouter une quantité importante à une unité existante augmente la moyenne, mais crée aussi une partie haute beaucoup plus étirée. La dispersion relative augmente au lieu d’être neutralisée par la hausse de la moyenne. C’est pourquoi ne présenter que la moyenne ou la médiane masquerait une conséquence importante de la convention de délimitation. Le changement est déterministe sous la réaffectation spécifiée, et non une fluctuation d’échantillonnage ou un effet causal estimé.
Le coefficient principal d’Austen, 0,42458, se situe entre ceux des deux conventions de Shelley. L’ordre apparent de dispersion des chapitres s’inverse donc quand la continuation de Walton est rattachée. Ce croisement proche met en garde contre l’attribution à un auteur d’un résumé dont la définition n’est pas précisée. Il ne démontre pas que l’un des écrivains serait généralement plus variable. La décision structurelle est visible dans la transcription, et les deux conventions peuvent être exposées clairement. Aucune ne doit passer pour la seule réponse naturelle sans expliquer le traitement du récit-cadre et des lettres initiales.
Mise en forme conservée et sensibilité précisément délimitée
Une inspection distincte a identifié six unités lexicales d’étiquettes de mise en forme conservés chez Austen : trois NIND et trois RIGHT. Deux figurent au chapitre VII, puis un dans chacun des chapitres XIII, XLVII, XLIX et LII. Leur présence signifie que le total principal figé de 122 174 ne peut être décrit comme un décompte parfaitement nettoyé de mots narratifs. Ces étiquettes apparaissent dans des blocs contenant aussi des salutations ou des dates. Supprimer chaque bloc entier éliminerait des éléments légitimes des sections et ne constituerait pas une correction proportionnée au problème identifié.
La sensibilité déclarée ne retire donc que les six étiquettes aux positions normalisées enregistrées. Elle ne remplace pas l’extraction principale figée, ne change pas le découpage en unités lexicales et ne réécrit pas le protocole initial après observation des résultats. Avec cette modification limitée, le total d’Austen devient 122 168 et son coefficient de variation 0,4245761045, contre 0,4245847284. Médiane, quartiles, minimum et maximum restent inchangés. L’inversion de classement descriptif liée à la convention du récit-cadre persiste également. Résultats principaux et sensibilité sont tous deux conservés afin de rendre visible le petit effet numérique, plutôt que de l’effacer silencieusement.
Ce contrôle ne prouve pas que tous les artefacts possibles de transcription ont été éliminés. Il traite un ensemble particulier d’étiquettes observées, et non une recherche sans limite d’un décompte préféré. Un nettoyage linguistique plus ambitieux demanderait ses propres règles et validations, notamment pour les abréviations, les traits d’union, les caractères accentués et les éléments des lettres. La conclusion présente est plus étroite : les six étiquettes identifiées n’expliquent pas le résultat du rattachement. Maintenir cette distinction sépare une vérification de robustesse mesurée d’une revendication de perfection textuelle générale.
Les limites des chapitres et les règles de repérage du texte entre guillemets sont des choix de mesure distincts ; leurs effets ne déterminent ni le rythme narratif, ni la prévalence du dialogue, ni la qualité littéraire. Comment les règles de guillemets changent la mesure dans deux transcriptions de romans
Reproduire les calculs sans redistribuer les romans
La voie de reproduction compacte part des décomptes fournis par unité. Elle recalcule les résumés exhaustifs et ceux des seuls chapitres, la sensibilité au rattachement du récit-cadre, la couverture, les quartiles inclusifs et les coefficients de variation de population. Cette voie n’exige aucun téléchargement de roman et ne produit que des données dérivées. Elle rend l’arithmétique accessible tout en séparant de la tâche numérique les questions de droits et de juridiction liées à la redistribution des textes. Une seconde voie, facultative, vérifie les fichiers bruts exacts contre leurs empreintes avant de répéter l’extraction avec des répertoires d’entrée et de sortie explicites.
Les vérifications d’extraction reposent sur deux implémentations structurellement différentes. L’une conserve les positions en masquant les blocs exclus et identifie les titres ; l’autre retire itérativement les blocs à crochets imbriqués et regroupe les lignes en sections. Leurs décomptes concordent pour les 90 unités. La seconde implémentation contrôle directement les partitions exhaustives. Un recalcul distinct vérifie aussi les statistiques des seuls chapitres et du récit-cadre rattaché. L’accord étaye l’implémentation sur ces entrées, mais ne crée pas une référence indépendante d’annotation sémantique. Les observations documentées et la convention déclarée restent nécessaires à côté de l’arithmétique concordante.
Les quartiles utilisent une interpolation linéaire inclusive ; le coefficient de variation utilise l’écart-type de population, et non celui d’échantillon. Aucun intervalle d’incertitude n’est inventé autour de décomptes exacts de fichiers figés. Les incertitudes pertinentes concernent les éditions, la définition des unités lexicales, la mise en forme conservée et l’interprétation structurelle, non l’erreur d’échantillonnage de ces ensembles complets. La documentation précise ce que couvre chaque empreinte et la définition des positions normalisées. Une empreinte du corps après masquage par espaces n’est pas présentée comme celle d’une sous-chaîne brute. Des octets modifiés font échouer la vérification au lieu de produire un résultat apparemment comparable sous un nom de fichier inchangé.
Champ, droits et conclusion soutenue
Les fiches Gutenberg actuelles indiquent que les deux œuvres relèvent du domaine public aux États-Unis. Les en-têtes reçus invitent les utilisateurs hors des États-Unis à vérifier le droit applicable. L’analyse ne transforme pas ces indications en autorisation juridique mondiale, licence de marque ou permission de publier tout matériau partout. Les éléments publics contiennent des décomptes dérivés compacts, des calculs, des diagnostics de frontières et des références, non les romans complets, illustrations ou préfaces. L’attribution distingue les auteurs et contributeurs sources des calculs et explications originaux d’Alisson Bento.
Plusieurs questions restent hors du champ des preuves. L’échantillon ne représente ni les auteurs, ni les genres, ni les littératures nationales, ni l’édition contemporaine. Les longueurs en unités lexicales ne mesurent pas le temps de lecture, le rythme ressenti, l’engagement, la qualité littéraire, les goûts ou la difficulté. L’identité non précisée de la réimpression photographique de Shelley limite la précision bibliographique, et les fichiers sont des transcriptions plutôt que des fac-similés garantis. Les figures comparent des mesures déclarées, non des accomplissements littéraires concurrents. Ces limites font partie de l’interprétation sans justifier la suppression d’un résultat structurel reproductible.
La conclusion soutenue est qu’une distribution des longueurs de chapitre exige une description explicite de ce qui constitue un chapitre et de ce qui reste en dehors. Dans la transcription de Shelley, séparer ou rattacher le récit-cadre final change fortement la partie haute de la distribution et la dispersion relative, sans modifier la médiane. La partition exhaustive et les taux de couverture révèlent les lettres initiales omises dans les deux conventions. Austen fournit une partition complète contrastante et une petite sensibilité de mise en forme transparente, non un groupe témoin représentatif. Ensemble, ces cas montrent pourquoi distributions, couverture, identité des sources et conventions de délimitation doivent figurer dans le même rapport de mesure.
La dispersion des chapitres dépend de la convention du récit-cadre
Les cinq ensembles déclarés ; coefficient de variation de population et couverture du texte retenu complet.
Graphique complet et source

Faites défiler le graphique horizontalement pour le consulter. ↔
Graphique et valeurs
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Ensemble d’unités | Unités | Unités lexicales | Minimum | Q1 | Médiane | Q3 | Maximum | CV de population | Couverture (%) |
|---|---|---|---|---|---|---|---|---|---|
| Austen : 61 chapitres (mesure principale) | 61 | 122 174 | 676 | 1 563,0 | 1 835,0 | 2 335,0 | 5 188 | 0,42458 | 100,0000 |
| Austen : six étiquettes retirées | 61 | 122 168 | 676 | 1 563,0 | 1 835,0 | 2 335,0 | 5 188 | 0,42458 | 100,0000 |
| Shelley : les 29 unités structurelles | 29 | 75 228 | 299 | 2 074,0 | 2 616,0 | 3 015,0 | 5 268 | 0,34840 | 100,0000 |
| Shelley : 24 chapitres, récit-cadre séparé | 24 | 64 397 | 1 784 | 2 223,0 | 2 651,0 | 3 038,0 | 3 746 | 0,20839 | 85,6024 |
| Shelley : 24 chapitres, récit-cadre rattaché | 24 | 69 665 | 1 784 | 2 223,0 | 2 651,0 | 3 133,5 | 8 269 | 0,43033 | 92,6051 |
Unités lexicales de la règle fixe en lettres latines de base, non mots purement narratifs. Le CV (coefficient de variation) utilise l’écart-type de population. Dénominateur de couverture : texte retenu complet selon la même règle de nettoyage ; sans intervalles d’échantillonnage. La ligne d’Austen sans six étiquettes est une sensibilité séparée, non un remplacement. Les deux ensembles de chapitres de Shelley omettent quatre lettres initiales.
Télécharger le graphique (SVG) ↓ · Télécharger le graphique (PNG) ↓
Données et téléchargements
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Ensemble d’unités | Unités | Unités lexicales | Minimum | Q1 | Médiane | Q3 | Maximum | CV de population | Couverture (%) |
|---|---|---|---|---|---|---|---|---|---|
| Austen : 61 chapitres (mesure principale) | 61 | 122 174 | 676 | 1 563,0 | 1 835,0 | 2 335,0 | 5 188 | 0,42458 | 100,0000 |
| Austen : six étiquettes retirées | 61 | 122 168 | 676 | 1 563,0 | 1 835,0 | 2 335,0 | 5 188 | 0,42458 | 100,0000 |
| Shelley : les 29 unités structurelles | 29 | 75 228 | 299 | 2 074,0 | 2 616,0 | 3 015,0 | 5 268 | 0,34840 | 100,0000 |
| Shelley : 24 chapitres, récit-cadre séparé | 24 | 64 397 | 1 784 | 2 223,0 | 2 651,0 | 3 038,0 | 3 746 | 0,20839 | 85,6024 |
| Shelley : 24 chapitres, récit-cadre rattaché | 24 | 69 665 | 1 784 | 2 223,0 | 2 651,0 | 3 133,5 | 8 269 | 0,43033 | 92,6051 |
Unités lexicales de la règle fixe en lettres latines de base, non mots purement narratifs. Le CV (coefficient de variation) utilise l’écart-type de population. Dénominateur de couverture : texte retenu complet selon la même règle de nettoyage ; sans intervalles d’échantillonnage. La ligne d’Austen sans six étiquettes est une sensibilité séparée, non un remplacement. Les deux ensembles de chapitres de Shelley omettent quatre lettres initiales.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Composante ou ensemble | Unités | Unités lexicales |
|---|---|---|
| Lettres initiales | 4 | 5 563 |
| Chapitres nommés, récit-cadre séparé | 24 | 64 397 |
| Continuation finale de Walton | 1 | 5 268 |
| Partition complète | 29 | 75 228 |
| Chapitres nommés, récit-cadre rattaché | 24 | 69 665 |
Le récit-cadre final est une unité principale explicite, non un chapitre implicite. L’ensemble avec récit-cadre rattaché exclut toujours les lettres initiales.
Données et méthode
Notre méthode de calcul
- Corpus fixe PG1342 et PG42324 identifié par empreintes exactes ; frontières de sections et règle de découpage en unités lexicales figées avant les calculs de longueur.
- 90 observations de frontières par unité, vérification complète de la numérotation et ancrages initiaux et finaux explicites ; aucune revendication d’étalon d’annotation humaine.
- Masquage des illustrations à crochets équilibrés, exclusion des notes numérotées et maintien des éléments internes aux sections ; la mesure principale d’Austen conserve six étiquettes documentées.
- Quartiles inclusifs interpolés et CV de population ; ensembles exhaustifs, chapitres nommés et récit-cadre rattaché associés à des dénominateurs de couverture explicites.
- Reproduction par défaut à partir des agrégats seulement ; extraction brute facultative avec empreinte exacte ; implémentation distincte concordante pour les 90 unités et contrôles arithmétiques séparés pour tous les ensembles de résumés.
Ce que les données ne permettent pas de conclure
- Deux transcriptions choisies à dessein ne représentent ni auteurs, genres, périodes ou populations ; aucune relation de longueur en population n’est inférée.
- Les décomptes de unités lexicales ne mesurent ni qualité littéraire, goûts, rythme ressenti, engagement ou temps de lecture.
- Le découpage en lettres latines de base et les éléments conservés des sections excluent une interprétation en mots purement narratifs ; la sensibilité aux six étiquettes reste limitée, sans nettoyage exhaustif.
- Les transcriptions Gutenberg ne sont pas des fac-similés imprimés garantis ; l’identité de la réimpression photographique de Shelley n’est pas précisée.
- Le domaine public aux États-Unis n’établit ni droits hors des États-Unis, licence mondiale ou permission universelle de redistribution des textes sources.
Sources originales
- Project Gutenberg 1342: Pride and Prejudice
Project Gutenberg 1342, Pride and Prejudice : les pages de titre de la transcription figée identifient George Allen 1894, la préface de Saintsbury et les illustrations de Thomson ; ces ajouts sont exclus. La fiche officielle indique le domaine public aux États-Unis. La mise à jour du 1er septembre dans l’en-tête diffère de celle du 29 septembre 2026 au catalogue ; l’empreinte exacte des octets identifie l’entrée.
Consulté le 30 octobre 2026
- Project Gutenberg 42324: Frankenstein
Project Gutenberg 42324, Frankenstein : version H. Colburn/R. Bentley de 1831 via une réimpression photographique non précisée, et non version de 1818. Introduction exclue ; identité de la réimpression toujours non précisée. La fiche officielle indique le domaine public aux États-Unis ; en-tête et catalogue mentionnent une mise à jour du 23 octobre 2026.
Consulté le 30 octobre 2026
- Project Gutenberg Permission How-to
Guide des permissions de Project Gutenberg : explique les limites selon les juridictions hors États-Unis et avertit que les transcriptions peuvent ne pas correspondre à une édition imprimée précise. Aucune autorisation juridique universelle ou approbation n’est déduite.
Consulté le 30 octobre 2026
Citer et réutiliser cette étude
Alisson Bento. Quand le récit-cadre final modifie la distribution des longueurs de chapitre. Mesure structurelle des transcriptions Project Gutenberg 1342 et 42324, récupérées le 30 octobre 2026 ; versions sources de 1894 et 1831. https://alissonbento.com/fr/research/chapter-frame-length-two-transcriptions/
Analyse, calculs et explications originaux : Alisson Bento. Romans originaux : Jane Austen et Mary Wollstonecraft Shelley. Préface de Saintsbury et illustrations de Thomson de la source d’Austen exclues ; source de Shelley de 1831 via une réimpression photographique non précisée. Fiches Gutenberg indiquant le domaine public aux États-Unis ; aucune autorisation juridique universelle ou approbation revendiquée. Uniquement données dérivées compactes et code, sans romans complets.
Corrections ou questions éditoriales