O que estes números ajudam a escolher
Encontrar um título e encontrar uma forma adequada de lê-lo são etapas diferentes. Uma pessoa pode preferir abrir o texto no navegador; outra pode procurar EPUB para seu aplicativo; uma terceira pode precisar de um PDF já listado. Esta análise organiza essas perguntas a partir do catálogo do Project Gutenberg, uma iniciativa sem fins lucrativos. A fonte é um catálogo público mantido pela organização, e não uma pesquisa governamental sobre hábitos de leitura.
A pergunta é específica: quantos registros que o catálogo classifica exclusivamente como Text apresentam cada formato em seus metadados? O levantamento não escolheu romances, autores conhecidos ou apenas registros com título preenchido. Aplicou a mesma regra a todos os IDs do arquivo congelado. Assim, o resultado oferece um ponto de partida para leitores, bibliotecários e desenvolvedores, sem transformar uma informação de catálogo em promessa sobre a experiência de leitura.
Para uma escolha concreta, comece pelo registro do título desejado e confira as opções atuais no próprio Project Gutenberg. Depois, avalie o arquivo e a edição conforme sua necessidade. A tabela agregada ajuda a entender o conjunto; não substitui essa verificação individual. Uma necessidade de fonte ampliada, navegação por títulos ou compatibilidade com determinado leitor de tela exige observação própria, ausente deste levantamento.
Quase todos listavam três caminhos; PDF era outra pergunta
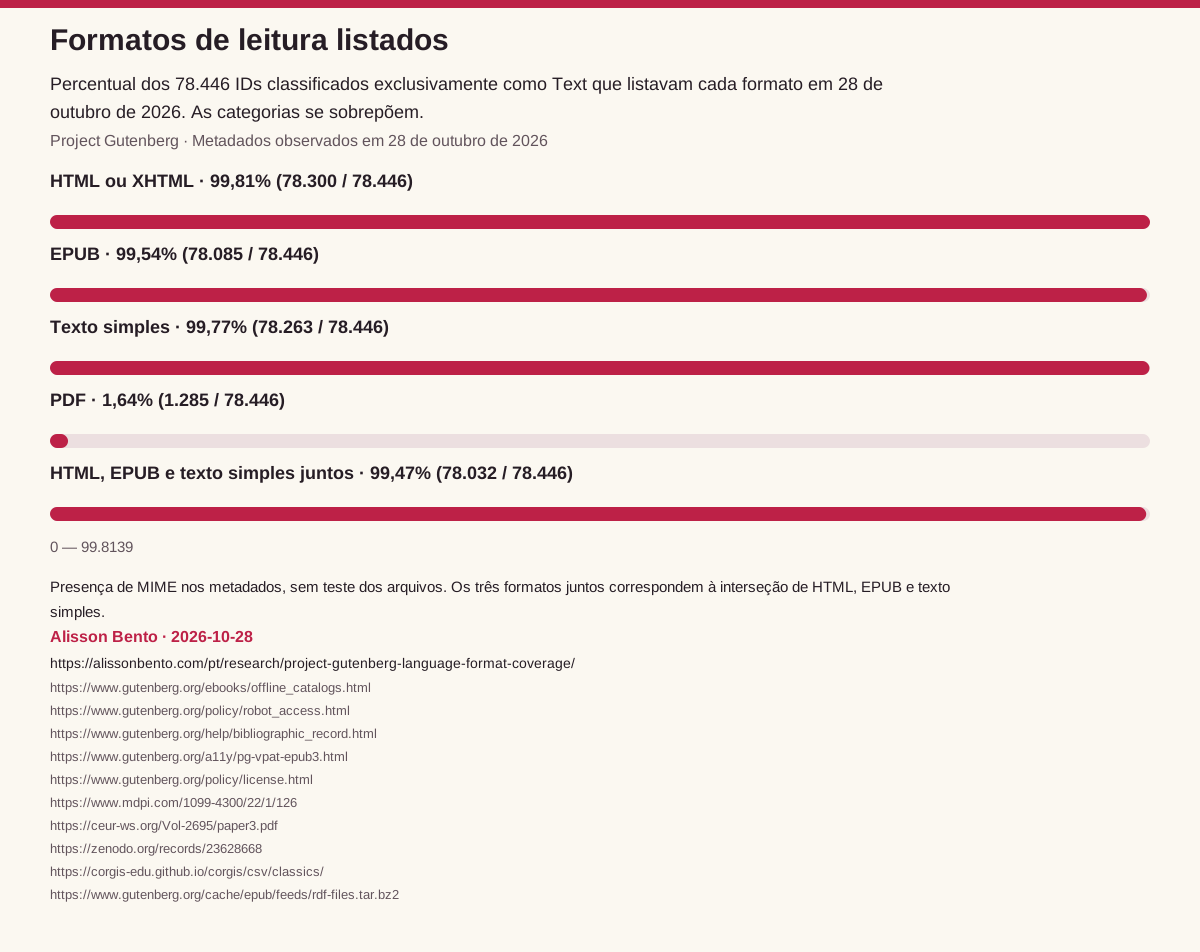
HTML ou XHTML aparecia em 78.300 registros, ou 99,81% do denominador textual. EPUB aparecia em 78.085, ou 99,54%, e texto simples em 78.263, ou 99,77%. O indicador dos três formatos juntos exige que o mesmo ID tenha as três categorias: 78.032 registros, ou 99,47%. Não se trata de somar arquivos, nem de somar os três percentuais.
Um registro pode ter vários arquivos de um mesmo formato e também arquivos de formatos diferentes. Ele conta uma única vez em cada categoria. Por isso, as linhas da tabela se sobrepõem. Ler os percentuais como fatias de um gráfico de pizza produziria uma interpretação errada: eles respondem a perguntas independentes sobre o mesmo conjunto de 78.446 registros.
PDF era listado em 1.285 registros, ou 1,64%. Isso delimita uma busca por PDF já declarado no catálogo. Não demonstra que os demais textos não possam ser impressos, convertidos ou encontrados em outra edição. Nenhuma dessas alternativas foi testada. A distinção importa para quem monta uma lista de leitura: um filtro restrito a PDF seleciona um conjunto muito diferente daquele encontrado com HTML ou EPUB.
Também separamos texto simples em qualquer codificação registrada de texto simples explicitamente marcado como UTF-8. Essa marcação apareceu em 78.154 IDs, ou 99,63%. A diferença não permite diagnosticar erros de caracteres: ela descreve apenas o parâmetro informado no MIME. A classificação não abriu os conteúdos para verificar acentos, integridade do texto ou correspondência com uma edição impressa.
Idiomas: tamanho do conjunto e cobertura são medidas diferentes
O conjunto textual continha 68 códigos de idioma distintos e nenhum ID sem código de idioma. Havia 218 IDs associados a mais de um código. Por isso, os 78.446 registros produziram 78.670 associações entre registro e idioma. A tabela completa mantém os 68 códigos observados, sem traduzir ou substituir os identificadores científicos. Um mesmo ID pode aparecer em mais de uma linha.
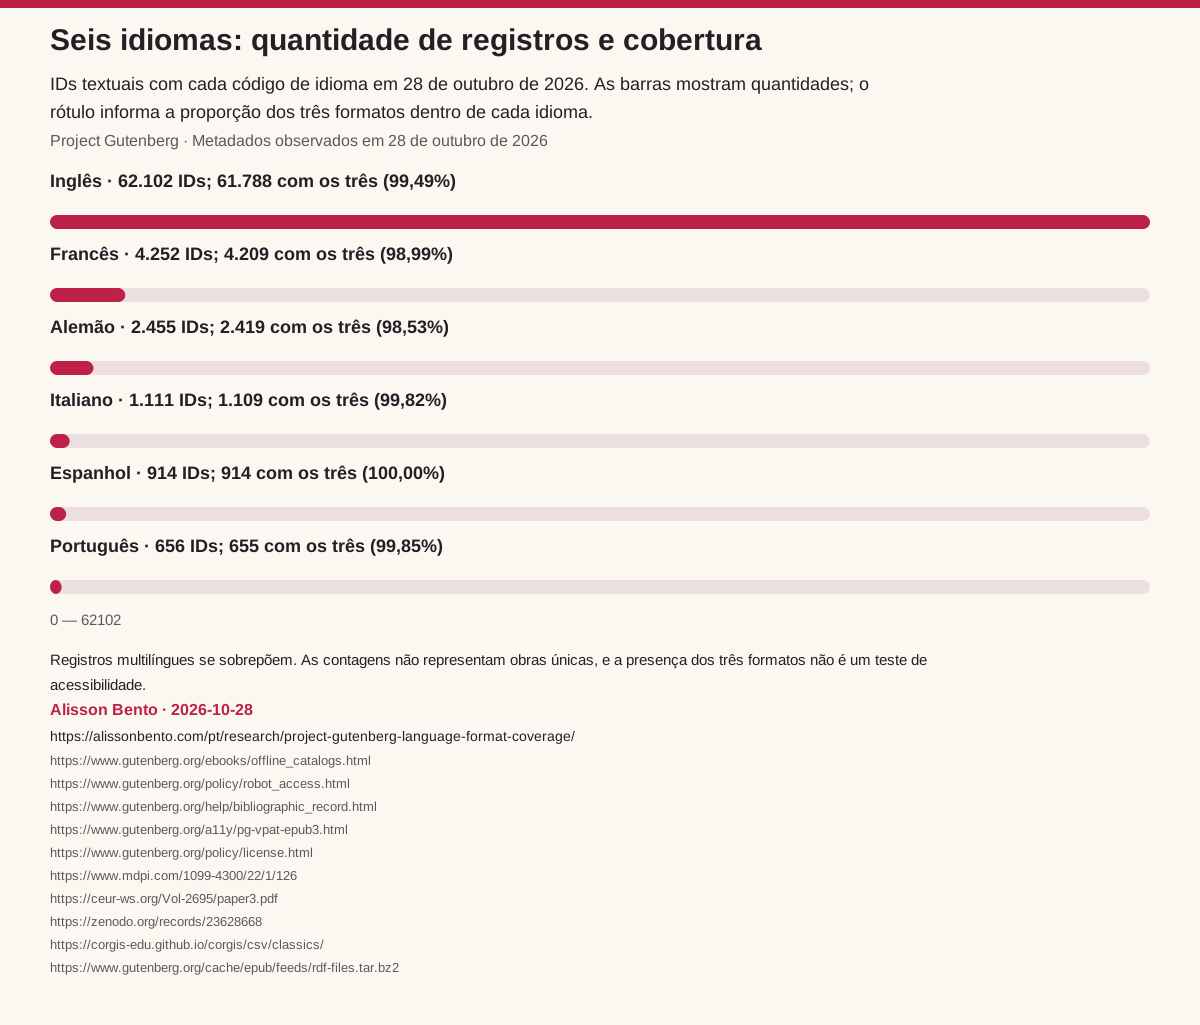
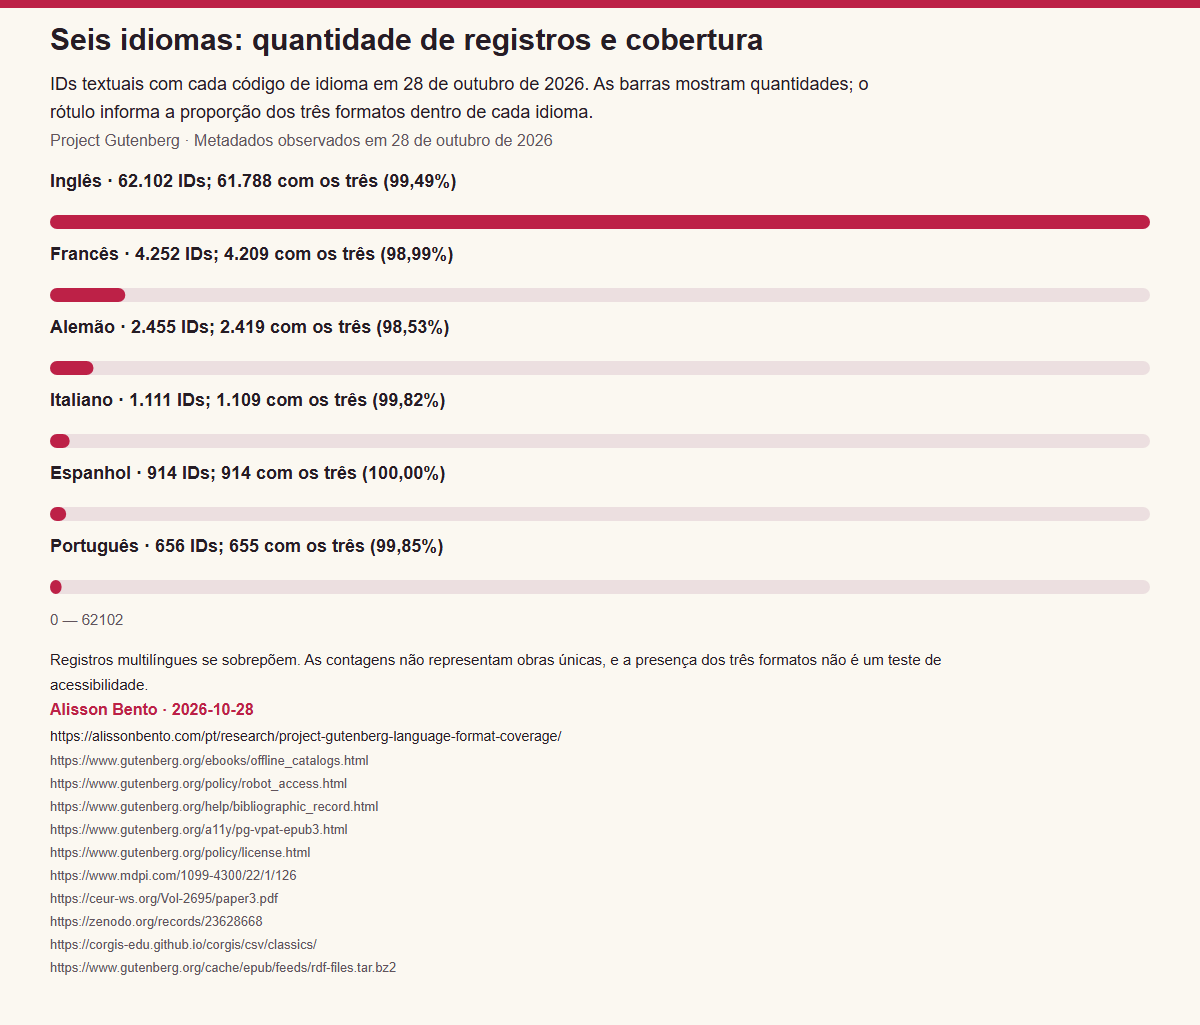
A comparação entre seis idiomas mostra por que quantidade e percentual precisam ser lidos juntos. A marcação en aparecia em 62.102 registros; pt, em 656; es, em 914; fr, em 4.252; it, em 1.111; e de, em 2.455. São tamanhos de conjuntos de registros com determinada marcação, não totais de obras únicas, traduções disponíveis ou edições nacionais.
Entre os 656 IDs com pt, 655 listavam os três formatos, correspondendo a 99,85%. Entre os 914 com es, todos os 914 os listavam. Isso não significa que o espanhol ofereça um serviço comprovadamente melhor ou que todos os seus arquivos funcionem. A marca de 100% descreve a presença das categorias nos metadados daquele conjunto e naquela data.
Nos demais recortes, os três formatos apareciam em 61.788 dos 62.102 IDs com en, 4.209 dos 4.252 com fr, 1.109 dos 1.111 com it e 2.419 dos 2.455 com de. Os percentuais respectivos são 99,49%, 98,99%, 99,82% e 98,53%. Cada divisão usa seu próprio denominador, sem comparar quantidades absolutas como se fossem taxas.
As linhas pequenas da tabela merecem cuidado adicional. Um único registro pode alterar bastante a porcentagem de um grupo de poucos IDs. Uma cobertura de 100% em um grupo minúsculo não equivale a uma oferta ampla. Além disso, o código não prova que todas as passagens estejam naquele idioma, nem informa nacionalidade do autor, país de publicação ou direção de uma tradução.
Uma observação exploratória sobre registros recentes
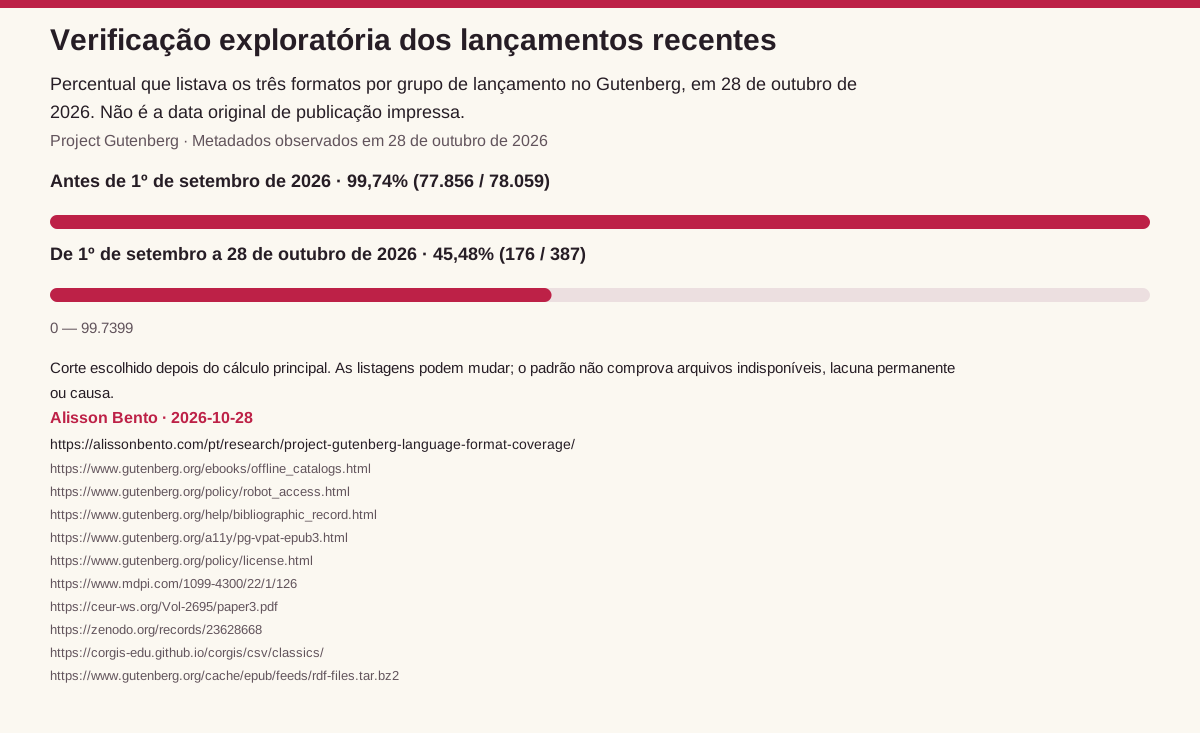
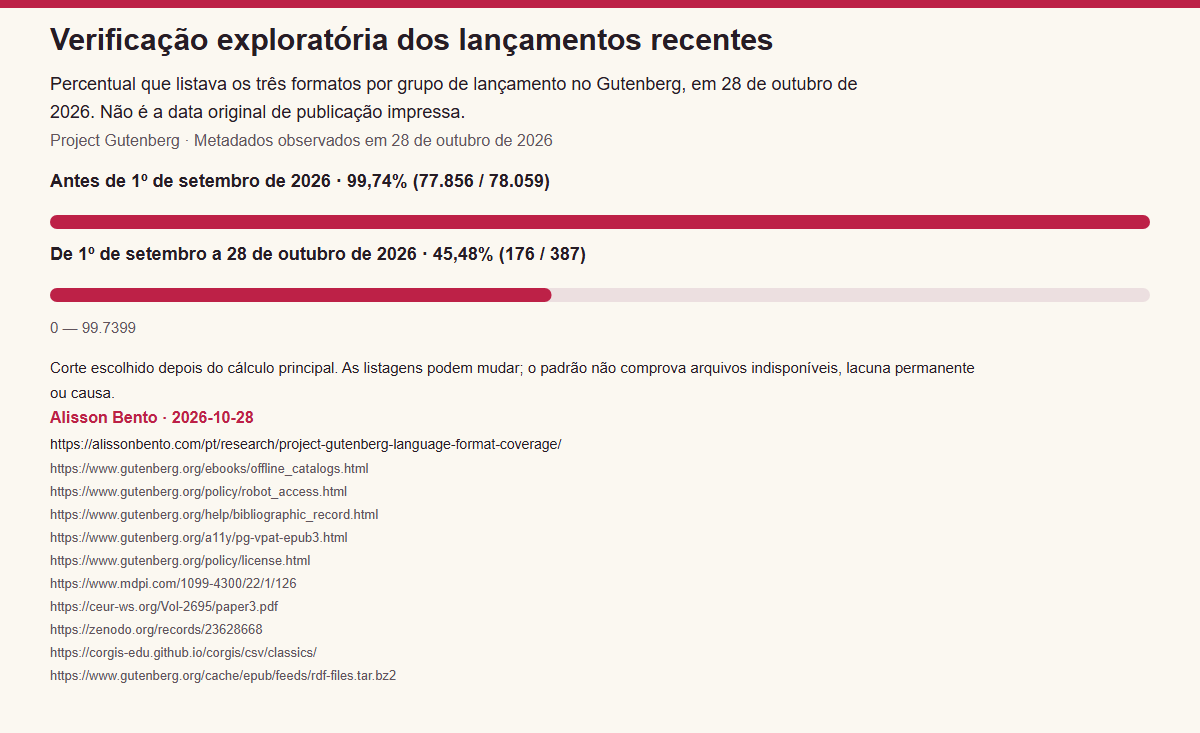
Depois da tabela principal, examinamos a data de lançamento registrada pelo Gutenberg. Entre 78.059 IDs textuais lançados antes de 1º de setembro de 2026, 77.856 listavam HTML, EPUB e texto simples juntos: 99,74%. Entre os 387 lançados de 1º de setembro a 28 de outubro de 2026, 176 os listavam: 45,48%. O corte temporal foi escolhido durante a exploração, e não definido como hipótese principal antes do cálculo.
O grupo recente concentrava 211 dos 361 registros sem uma listagem EPUB observada. É uma pista sobre como a composição temporal afeta este retrato dos metadados. Não identifica a causa do padrão, não comprova arquivos ausentes e não sustenta uma conclusão sobre falha técnica. A documentação Bibliographic Record explica que registros novos começam com informações mínimas e recebem complementos depois; formatos gerados e descrições podem mudar.
A conclusão adequada permanece ligada a 28 de outubro de 2026. Antes de usar esse contraste em uma notícia, apresentação ou comunicação sobre a situação atual, é preciso refazer a observação em um novo arquivo datado. A data de lançamento do Gutenberg também não é o ano da publicação impressa original. Misturar os dois transformaria um diagnóstico de catálogo em uma história literária que estes dados não medem.
Por que contamos registros, sem prometer obras únicas
O arquivo completo tinha 79.697 IDs distintos, sem repetição de IDs ou falhas de leitura identificadas. A regra de inclusão selecionou apenas os 78.446 cujo conjunto de tipos era exatamente Text. Ficaram fora 1.114 registros Sound, 89 Dataset, 33 Image, oito MovingImage, quatro Collection e três StillImage. Esses nomes são valores da fonte; não foram convertidos em categorias de gênero literário.
Um ID textual pode representar volume, edição, fascículo ou outra unidade editorial. Identificadores diferentes não provam obras diferentes. Uma verificação auxiliar de títulos, criadores e idiomas normalizados encontrou 400 grupos candidatos a correspondência, contendo 902 registros. Esses candidatos não foram tratados como duplicatas confirmadas e nenhum foi removido. Comparações exatas de campos também podem agrupar rótulos incompletos, tornando a deduplicação automática inadequada para uma afirmação sobre obras.
Mantivemos um registro textual com título vazio e 130 sem nenhuma das três categorias MIME principais observadas. A inclusão depende do tipo declarado, não da conveniência do resultado. Excluir silenciosamente esses casos reduziria o denominador e mudaria a pergunta. O critério explícito permite que outra pessoa reproduza o cálculo e, se desejar adotar outra pergunta, publique uma comparação claramente identificada.
Usos práticos para leitura, bibliotecas e catálogos
Para quem lê, a utilidade é reconhecer que o formato desejado deve ser uma pergunta explícita. A presença quase universal das três categorias no conjunto observado torna HTML, EPUB e texto simples bons campos para explorar no catálogo, mas a escolha final continua vinculada ao título. Não é necessário interpretar uma ausência no retrato como uma impossibilidade permanente: procure a informação atual no registro original.
Para uma biblioteca ou um professor que prepara referências, cada indicação pode manter o endereço do registro, o idioma informado e a opção de formato verificada no momento da seleção. O estudo ajuda a justificar esses campos em uma planilha de trabalho. Não comprova adequação etária, qualidade da tradução, integridade editorial ou direitos de uso em uma atividade específica. Esses aspectos exigem avaliação própria.
Para desenvolvedores, o arquivo RDF em lote é a rota documentada para trabalhar com os metadados. O modelo de dados deve permitir vários idiomas e vários formatos por ID. Uma coluna única de idioma ou uma escolha exclusiva entre HTML e EPUB apagaria relações reais do catálogo. Convém armazenar também a data da observação e diferenciar “listado no catálogo” de “verificado por nosso sistema”, caso um serviço faça testes separados.
Para jornalistas e pesquisadores, os downloads permitem conferir denominadores e reutilizar resultados agregados sem reconstruir uma tabela a partir da imagem. Preserve a data e as ressalvas no texto que acompanha o gráfico. Um número compartilhado sem sua unidade, como “78 mil livros disponíveis”, perde as distinções entre registro, obra, formato listado e arquivo efetivamente testado.
O que este retrato acrescenta a pesquisas anteriores
O Project Gutenberg já foi estudado como corpus e como estrutura de metadados. Gerlach e Font-Clos apresentaram em 2020 o Standardized Project Gutenberg Corpus, com caracterização de textos e idiomas. Egloff, Adamou e Picca examinaram em 2020 o acesso ao catálogo por ontologias, incluindo sua estrutura RDF. O conjunto Classics, do projeto CORGIS, também disponibilizou campos relacionados a formatos para usos educacionais.
O Gutenberg Atlas de Timm, publicado em 24 de outubro de 2026, trata de metadados de ano de publicação e autoria de registros em inglês. Seu recorte ajuda a lembrar que diferentes campos respondem a diferentes perguntas. Esta página não reivindica a descoberta da concentração linguística do catálogo nem a primeira análise de seus formatos.
A contribuição aqui é reunir uma observação datada, uma regra de inclusão verificável, contagens por MIME e uma tabela completa por código de idioma em linguagem acessível. O leitor pode distinguir a evidência principal da exploração sobre registros recentes e consultar os cálculos. Trata-se de uma análise descritiva independente dos metadados, sem afiliação ou endosso do Project Gutenberg.
Resumo pronto para citar, com a data e o limite
No catálogo RDF do Project Gutenberg observado em 28 de outubro de 2026, 78.032 de 78.446 IDs classificados exclusivamente como Text, ou 99,47%, listavam HTML, EPUB e texto simples juntos. Os metadados incluíam 68 códigos de idioma, com sobreposição entre registros multilíngues. As listagens podem mudar, sobretudo em registros recentes; o levantamento não testou arquivos e não contou obras únicas.
Ao reutilizar esse resumo, mantenha o nome da fonte, o crédito dos cálculos a Alisson Bento e o link desta análise. Para atualizar a data, recalcule os resultados com um novo arquivo e documente a mudança. Alterar apenas o ano da legenda faria o retrato antigo parecer uma medição nova.
Formatos de leitura listados
Percentual dos 78.446 IDs classificados exclusivamente como Text que listavam cada formato em 28 de outubro de 2026. As categorias se sobrepõem.
Gráfico completo e fonte
Role para os lados para examinar o gráfico. ↔
Gráfico e valores
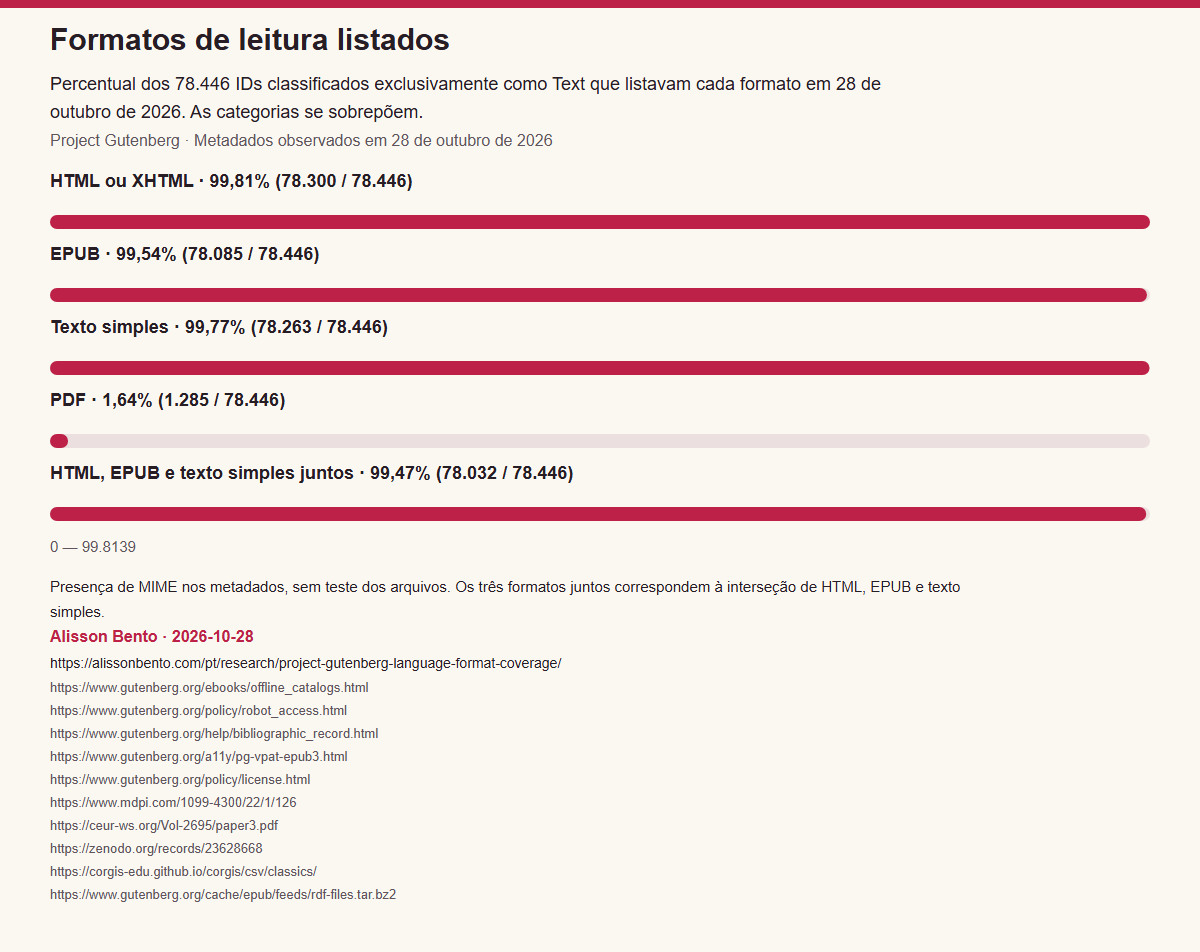
Seis idiomas: quantidade de registros e cobertura
IDs textuais com cada código de idioma em 28 de outubro de 2026. As barras mostram quantidades; o rótulo informa a proporção dos três formatos dentro de cada idioma.
Gráfico completo e fonte
Role para os lados para examinar o gráfico. ↔
Gráfico e valores
Verificação exploratória dos lançamentos recentes
Percentual que listava os três formatos por grupo de lançamento no Gutenberg, em 28 de outubro de 2026. Não é a data original de publicação impressa.
Gráfico completo e fonte
Role para os lados para examinar o gráfico. ↔
Gráfico e valores
Dados e downloads
Role a tabela para os lados para ver todas as colunas.
| Formato listado | Registros | Proporção (%) |
|---|---|---|
| HTML ou XHTML | 78.300 | 99,81 |
| EPUB | 78.085 | 99,54 |
| Texto simples | 78.263 | 99,77 |
| Texto simples com UTF-8 explícito | 78.154 | 99,63 |
| 1.285 | 1,64 | |
| HTML, EPUB e texto simples juntos | 78.032 | 99,47 |
Retrato de 28 de outubro de 2026. O denominador de cada linha é 78.446 IDs exclusivamente Text. As categorias se sobrepõem e não devem ser somadas.
Role a tabela para os lados para ver todas as colunas.
| Código de idioma | IDs exclusivamente Text | HTML listado | EPUB listado | Texto simples listado | Os três listados | Os três (%) | PDF listado |
|---|---|---|---|---|---|---|---|
| en | 62.102 | 62.000 | 61.835 | 61.960 | 61.788 | 99,49 | 1.102 |
| fr | 4.252 | 4.234 | 4.213 | 4.230 | 4.209 | 98,99 | 36 |
| fi | 3.689 | 3.680 | 3.680 | 3.689 | 3.680 | 99,76 | 0 |
| de | 2.455 | 2.436 | 2.420 | 2.435 | 2.419 | 98,53 | 68 |
| nl | 1.120 | 1.120 | 1.114 | 1.120 | 1.114 | 99,46 | 1 |
| it | 1.111 | 1.111 | 1.109 | 1.111 | 1.109 | 99,82 | 58 |
| es | 914 | 914 | 914 | 914 | 914 | 100,00 | 9 |
| pt | 656 | 656 | 655 | 656 | 655 | 99,85 | 1 |
| hu | 655 | 655 | 655 | 655 | 655 | 100,00 | 1 |
| zh | 443 | 443 | 443 | 442 | 442 | 99,77 | 3 |
| sv | 257 | 257 | 257 | 257 | 257 | 100,00 | 0 |
| el | 221 | 221 | 221 | 221 | 221 | 100,00 | 6 |
| eo | 145 | 145 | 145 | 145 | 145 | 100,00 | 3 |
| la | 144 | 144 | 144 | 144 | 144 | 100,00 | 2 |
| ca | 97 | 97 | 95 | 97 | 95 | 97,94 | 0 |
| da | 85 | 85 | 85 | 85 | 85 | 100,00 | 0 |
| tl | 60 | 60 | 60 | 60 | 60 | 100,00 | 0 |
| pl | 31 | 31 | 31 | 31 | 31 | 100,00 | 2 |
| no | 23 | 23 | 23 | 23 | 23 | 100,00 | 0 |
| fy | 22 | 22 | 22 | 22 | 22 | 100,00 | 0 |
| ja | 21 | 21 | 21 | 21 | 21 | 100,00 | 0 |
| af | 17 | 17 | 17 | 17 | 17 | 100,00 | 0 |
| cy | 15 | 15 | 15 | 15 | 15 | 100,00 | 0 |
| cs | 12 | 12 | 12 | 12 | 12 | 100,00 | 1 |
| fur | 7 | 7 | 7 | 7 | 7 | 100,00 | 0 |
| ga | 7 | 7 | 5 | 7 | 5 | 71,43 | 0 |
| is | 7 | 7 | 7 | 7 | 7 | 100,00 | 0 |
| bg | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| enm | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| he | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| te | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| ro | 5 | 5 | 5 | 5 | 5 | 100,00 | 0 |
| ru | 5 | 5 | 5 | 5 | 5 | 100,00 | 1 |
| sl | 5 | 5 | 5 | 5 | 5 | 100,00 | 0 |
| ang | 4 | 4 | 4 | 4 | 4 | 100,00 | 0 |
| gla | 4 | 4 | 4 | 4 | 4 | 100,00 | 1 |
| sr | 4 | 4 | 4 | 3 | 3 | 75,00 | 0 |
| ceb | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| gl | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| grc | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| ilo | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| myn | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| nah | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| nai | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| nav | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| arp | 2 | 2 | 2 | 2 | 2 | 100,00 | 0 |
| brx | 2 | 2 | 2 | 2 | 2 | 100,00 | 0 |
| mi | 2 | 2 | 2 | 2 | 2 | 100,00 | 1 |
| oc | 2 | 2 | 2 | 2 | 2 | 100,00 | 0 |
| ale | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| ar | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| bgs | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| bo | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| br | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| csb | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| et | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| fa | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| hai | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| ia | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| iu | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| kha | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| kld | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| ko | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| nap | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| oji | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| rmq | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| sa | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| sco | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
Retrato de 28 de outubro de 2026. Cada denominador reúne os IDs textuais que trazem aquele código. Registros multilíngues aparecem em várias linhas; não some as linhas. Os arquivos listados não foram testados.
Role a tabela para os lados para ver todas as colunas.
| Código de idioma | IDs exclusivamente Text | Os três listados | Os três (%) |
|---|---|---|---|
| en | 62.102 | 61.788 | 99,49 |
| pt | 656 | 655 | 99,85 |
| es | 914 | 914 | 100,00 |
| fr | 4.252 | 4.209 | 98,99 |
| it | 1.111 | 1.109 | 99,82 |
| de | 2.455 | 2.419 | 98,53 |
Associações de idioma sobrepostas. A proporção dos três formatos usa o denominador do próprio idioma. Retrato de 28 de outubro de 2026.
Role a tabela para os lados para ver todas as colunas.
| Grupo de lançamento | IDs exclusivamente Text | Os três listados | Os três (%) |
|---|---|---|---|
| Antes de 1º de setembro de 2026 | 78.059 | 77.856 | 99,74 |
| De 1º de setembro a 28 de outubro de 2026 | 387 | 176 | 45,48 |
Data de lançamento no Gutenberg, não de publicação impressa original. Corte escolhido após a análise principal. Observação pontual de metadados, sem conclusão causal ou permanente.
Evidências e método
Como calculamos
- Fonte e preservação: o levantamento usou o arquivo rdf-files.tar.bz2 disponibilizado pelo Project Gutenberg por sua rota oficial de catálogo em lote. Foram baixados apenas metadados, sem textos de ebooks e sem rastrear páginas comuns de livros ou buscas. O arquivo preservado tem 126.835.043 bytes e SHA-256 c5ee946cea46fb32ffb2d55af670384064ccd818ab59d900c362a63b6bb29a65.
- Datas distintas: o cabeçalho HTTP Last-Modified informa 28 de outubro de 2026, às 14:35:54 UTC. O download terminou no mesmo dia, às 21:44:48,970368 UTC. A análise foi registrada às 21:47:05,820155 UTC. Esses horários documentam modificação da fonte, obtenção e cálculo; não representam a data original de publicação impressa das obras nem substituem a data editorial desta página.
- Unidade e seleção: cada arquivo RDF foi lido no fluxo do arquivo compactado, sem extrair seus caminhos para o disco. A análise identificou o ID e o conjunto completo de valores dcterms:type. Somente o conjunto exatamente igual a {Text} entrou no denominador principal. Todos os IDs elegíveis foram preservados, sem unir volumes ou versões e sem deduplicação por título.
- Idiomas: para cada ID incluído, a análise leu os valores distintos de idioma e atribuiu uma associação por código. A proporção de cada linha divide o número de IDs com o formato pelo número de IDs que trazem aquele código. Os registros multilíngues participam de mais de uma linha; a soma dessas linhas não fornece um total de registros únicos.
- Formatos: os valores MIME foram lidos em dcterms:hasFormat/pgterms:file, removendo parâmetros para comparar o tipo-base. HTML inclui text/html e application/xhtml+xml; EPUB corresponde a application/epub+zip; texto simples, a text/plain; e PDF, a application/pdf. A marca UTF-8 exige o parâmetro charset=utf-8, normalizado quanto a espaços e maiúsculas. Imagens de capa, contêineres ZIP e arquivos RDF não foram usados como substitutos de formatos de leitura.
- Contagem e conferência: cada categoria foi contada no máximo uma vez por ID. O indicador dos três formatos exige HTML, EPUB e texto simples simultaneamente. Não foram encontradas URLs de arquivo repetidas nem arquivos listados sem MIME no subconjunto textual. As exportações CSV foram reconciliadas com os totais JSON, os 68 denominadores por idioma e a divisão dos grupos de lançamento. Uma recomputação independente do RDF confirmou os resultados principais.
- Reprodução: os downloads incluem código, resultados, definição do método e identificação do arquivo-fonte. Preserve o arquivo congelado e seu hash ao repetir a análise; uma cópia mais recente pode gerar resultados diferentes. O código de análise usa a biblioteca padrão do Python; a produção das figuras usa também matplotlib. Copie os materiais para uma pasta de trabalho separada antes de executá-los, pois os scripts gravam resultados derivados.
- Precisão e incerteza: as tabelas de leitura mostram percentuais com duas casas decimais; os resultados estruturados preservam quatro. Este é um levantamento completo do arquivo fornecido sob uma regra declarada, não uma amostra probabilística da literatura. Portanto, intervalos de confiança amostrais não descrevem a incerteza relevante. Erros de metadados, seleção do catálogo e mudanças posteriores continuam sendo limites reais.
O que os dados não permitem concluir
- Registro não é obra única. O tipo Text abrange mais que romances, e IDs diferentes podem representar volumes, versões ou edições relacionadas. Nenhuma estimativa do total de obras únicas foi produzida.
- Presença de MIME não é teste de arquivo. Não foram verificados funcionamento dos links, integridade do conteúdo, fidelidade editorial, segurança ou compatibilidade com tecnologia assistiva. A documentação de acessibilidade do próprio Gutenberg deve ser consultada para compreender o escopo de suas avaliações.
- Um catálogo não representa toda a leitura ou toda a publicação. Estes resultados não estimam demanda dos leitores, todos os ebooks gratuitos, todas as obras em domínio público, o mercado global ou a oferta de romances contemporâneos.
- Códigos de idioma podem se sobrepor e não determinam país, nacionalidade ou idioma predominante de cada passagem. Os grupos pequenos não sustentam classificações robustas de qualidade a partir de diferenças percentuais.
- O retrato é temporal. Datas dcterms:issued se referem ao lançamento no Gutenberg, não à publicação impressa original. O contraste entre grupos recentes é exploratório e pode mudar com a atualização dos metadados; não prova causa, falha ou lacuna permanente.
- Direitos são uma questão separada. A permissão de reutilizar metadados não determina a situação jurídica de cada ebook em todos os países. O Gutenberg inclui obras protegidas disponibilizadas com autorização e orienta usuários fora dos Estados Unidos a verificar os direitos aplicáveis. Este estudo não fornece uma autorização geral para reproduzir textos.
Fontes originais
- Project Gutenberg: Offline Catalogs and Feeds
Documentação oficial da rota de metadados RDF em lote; retrato do catálogo preservado em 28 de outubro de 2026.
Acesso em 28 de outubro de 2026
- Project Gutenberg: Robot Access
Permissão de domínio público para dados do catálogo e orientação sobre acesso em lote. Essa permissão não cobre automaticamente textos de ebooks.
Acesso em 28 de outubro de 2026
- Project Gutenberg: Bibliographic Record
Explicação dos campos bibliográficos, das datas de lançamento e do enriquecimento progressivo de registros e formatos gerados.
Acesso em 28 de outubro de 2026
- Project Gutenberg: EPUB3 Accessibility Conformance Report
Escopo da avaliação de acessibilidade de EPUB3. Presença de um MIME no catálogo não constitui teste de acessibilidade.
Acesso em 28 de outubro de 2026
- Project Gutenberg: License
Orientações sobre direitos de ebooks e marcas. A permissão relativa aos metadados não estabelece direitos mundiais sobre os textos.
Acesso em 28 de outubro de 2026
- Gerlach and Font-Clos (2020): A Standardized Project Gutenberg Corpus
Caracterização anterior do corpus Gutenberg e de seus idiomas, por Gerlach e Font-Clos (2020). DOI: 10.3390/e22010126.
Acesso em 28 de outubro de 2026
- Egloff, Adamou and Picca (2020): Enabling Ontology-Based Data Access to Project Gutenberg
Estudo anterior de Egloff, Adamou e Picca (2020) sobre RDF do Gutenberg, incluindo metadados de idioma e formato.
Acesso em 28 de outubro de 2026
- Timm (2026): Gutenberg Atlas
Metadados de ano de publicação e autoria para registros em inglês; versão 1.0.0 publicada em 24 de outubro de 2026. DOI: 10.5281/zenodo.23628668.
Acesso em 28 de outubro de 2026
- CORGIS Datasets Project: Classics
Conjunto educacional anterior com campos de formatos do catálogo. Esta análise não reivindica pioneirismo nesses indicadores.
Acesso em 28 de outubro de 2026
- Project Gutenberg bulk RDF catalogue
Arquivo-fonte SHA-256 c5ee946cea46fb32ffb2d55af670384064ccd818ab59d900c362a63b6bb29a65; modificado em 28 de outubro de 2026 às 14:35:54 UTC e obtido às 21:44:48 UTC.
Acesso em 28 de outubro de 2026
Como citar e reutilizar
Bento, Alisson. Project Gutenberg: idiomas e formatos de leitura no catálogo de outubro de 2026. Análise independente do catálogo RDF do Project Gutenberg, retrato de 28 de outubro de 2026. https://alissonbento.com/pt/research/project-gutenberg-language-format-coverage/ https://alissonbento.com/pt/research/project-gutenberg-language-format-coverage/
Os metadados do catálogo são oferecidos pelo Project Gutenberg em domínio público; a amostra RDF preservada contém uma referência CC0. A análise original, os textos explicativos, os gráficos e o código de reprodução são materiais de Alisson Bento: ao reutilizá-los, atribua o crédito, inclua o link do estudo e a data do retrato de 28 de outubro de 2026 e indique alterações, conforme o arquivo de direitos e reutilização. Atribuição não implica afiliação ou endosso do Project Gutenberg. Esses termos não licenciam textos de ebooks nem estabelecem direitos universais sobre as obras.
Correções ou dúvidas editoriais