
Welche Frage die Auswertung beantwortet
Wer einen Text lesen möchte, braucht mehr als eine Trefferzahl. Entscheidend ist auch, welchen Weg der Katalog zur gewünschten Ausgabe verzeichnet: eine Darstellung im Browser, ein EPUB für ein Lesegerät oder eine einfache Textdatei. Diese Untersuchung trennt deshalb zwei Fragen. Wie viele Katalogeinträge tragen eine bestimmte Sprachkennung? Und bei wie vielen dieser Einträge sind die untersuchten Formate in den Metadaten aufgeführt? Die Antworten helfen bei der Orientierung, ersetzen aber nicht die Prüfung der konkreten Ausgabe.
Project Gutenberg ist eine gemeinnützige Quelle, keine staatliche Statistikstelle. Grundlage ist sein eigener maschinenlesbarer Katalog, nicht eine Befragung von Leserinnen und Lesern. Die Auswertung beschreibt damit einen bestimmten Bestand unter einer klaren Auswahlregel. Sie misst weder die Nachfrage nach einer Sprache noch die Zahl aller frei zugänglichen Bücher im Internet. Auch die Verfügbarkeit aktueller Romane oder die Qualität einzelner Übersetzungen lässt sich daraus nicht ableiten.
Für die Nutzung der folgenden Ergebnisse ist ein Begriff besonders wichtig: verzeichnet. Ein Format gilt hier als verzeichnet, wenn der Datensatz mindestens eine entsprechende MIME-Angabe enthält. MIME ist die technische Bezeichnung für einen Dateityp. Es wurde nicht untersucht, ob die zugehörige Adresse erreichbar ist, ob die Datei vollständig ist oder ob sie mit einem bestimmten Gerät gut funktioniert. Die Unterscheidung gehört deshalb bereits zur Kernaussage und nicht erst in eine Fußnote.
Was die hohen Formatanteile tatsächlich aussagen
Im untersuchten Textbestand verzeichneten 78.300 Einträge HTML oder XHTML, 78.085 EPUB und 78.263 Klartext. Bezogen auf jeweils 78.446 Text-IDs entsprechen diese Werte 99,81 %, 99,54 % und 99,77 %. Bei 78.154 Einträgen war Klartext ausdrücklich mit der Zeichenkodierung UTF-8 gekennzeichnet; das sind 99,63 %. Die allgemeinen Klartextzahlen schließen andere verzeichnete Kodierungen ein und dürfen nicht mit der engeren UTF-8-Kategorie gleichgesetzt werden.
Die gemeinsame Abdeckung der drei Grundformate beträgt 78.032 Einträge oder 99,47 %. Gemeint ist die Schnittmenge: Derselbe Eintrag muss HTML, EPUB und Klartext verzeichnen. Eine ID wird dabei nur einmal gezählt, auch wenn mehrere passende Dateien oder Varianten aufgeführt sind. Die einzelnen Formatzeilen sind folglich keine Anteile, die sich zu 100 % ergänzen. Ein Eintrag kann in mehreren Zeilen vorkommen; ein gestapeltes Diagramm mit einer gemeinsamen Gesamtsumme wäre irreführend.
Für Leserinnen und Leser bedeutet dieses Ergebnis zunächst, dass der eingefrorene Katalog bei einem sehr großen Teil der ausgewählten Einträge mehrere Lesewege ausweist. Es bedeutet nicht, dass diese Wege gleichwertig geprüft wurden. Die konkrete Auswahl sollte weiterhin beim einzelnen Datensatz beginnen. Wer beispielsweise eine bestimmte Übersetzung oder einen bestimmten Band sucht, muss diese Merkmale gesondert abgleichen. Ein passender Dateityp beantwortet noch nicht die Frage nach der passenden Ausgabe.
Warum eine PDF-Suche eine andere Auswahl erzeugt
PDF war bei 1.285 der 78.446 Text-IDs verzeichnet, entsprechend 1,64 %. Dieser deutlich kleinere Anteil ist für eine klar abgegrenzte Nutzung relevant: Wer ausschließlich nach bereits aufgeführten PDF-Dateien sucht, betrachtet nur einen kleinen Teil der hier gezählten Einträge. Wer auch HTML, EPUB oder Klartext verwenden kann, stellt eine andere Suchbedingung. Die Zahlen beschreiben diese unterschiedlichen Bedingungen innerhalb desselben Katalogs.
Aus dem geringen PDF-Anteil folgt weder ein allgemeines Urteil über den Bestand noch eine Empfehlung, jede Datei umzuwandeln. Die Analyse hat weder Browserdruck noch Konvertierung ausprobiert. Sie kann deshalb nicht beziffern, wie viele brauchbare PDFs sich auf anderem Weg herstellen ließen. Ebenso wenig zeigt sie, ob ein vorhandenes PDF ein Faksimile, ein neu gesetztes Dokument oder eine für einen bestimmten Zweck geeignete Ausgabe ist.
Ein sinnvoller praktischer Schritt ist, die eigene Anforderung vor der Suche zu benennen: Geht es um einen bestimmten Dateityp, um eine bestimmte Ausgabe oder um eine bestimmte Bedienmöglichkeit? Die Formatstatistik unterstützt nur den ersten Teil dieser Entscheidung. Für einen Lesekreis, Unterricht oder ein persönliches Lesevorhaben bleibt anschließend die Kontrolle des ausgewählten Eintrags und seiner tatsächlichen Datei notwendig.
Sprachkennungen zählen Zuordnungen, keine getrennten Bücherregale
Der Textbestand enthält 68 unterschiedliche Sprachkennungen. Keine der 78.446 einbezogenen IDs hatte eine fehlende Sprachangabe. 218 IDs trugen jedoch mehr als eine Kennung. Dadurch entstehen insgesamt 78.670 Sprachzuordnungen. Diese Summe ist größer als die Zahl der Text-IDs, ohne dass ein Rechenfehler vorliegt: Ein mehrsprachiger Eintrag gehört zu mehreren Sprachzeilen.
Die vollständige Tabelle zeigt alle 68 Kennungen, einschließlich sehr kleiner Gruppen. Der Nenner jeder Zeile ist die Zahl der Text-IDs mit genau dieser Kennung, nicht die Gesamtzahl aller Sprachzuordnungen. Die Kennungen bleiben unverändert erhalten, damit sich die Tabelle mit den herunterladbaren Daten verbinden lässt. Sie bezeichnen Metadatenfelder und sind keine Aussage über die Staatsangehörigkeit eines Autors, das Land einer Ausgabe oder die Sprache jeder einzelnen Textpassage.
Kleine Gruppen verdienen besondere Vorsicht. Ein Anteil von 100 % kann bei einer sehr kleinen Zahl von Einträgen entstehen und ist kein Qualitätszertifikat. Bereits ein einzelner anders verzeichneter Eintrag kann einen solchen Anteil deutlich verändern. Die Tabelle eignet sich daher zum Nachschlagen von Bestandsgrößen und Formatangaben, nicht für eine Rangliste der vermeintlich besten oder schlechtesten Sprachen. Auch eine häufige Sprachkennung belegt keine entsprechende Lesernachfrage.
Die sechs Sprachgruppen dieser Website im Vergleich
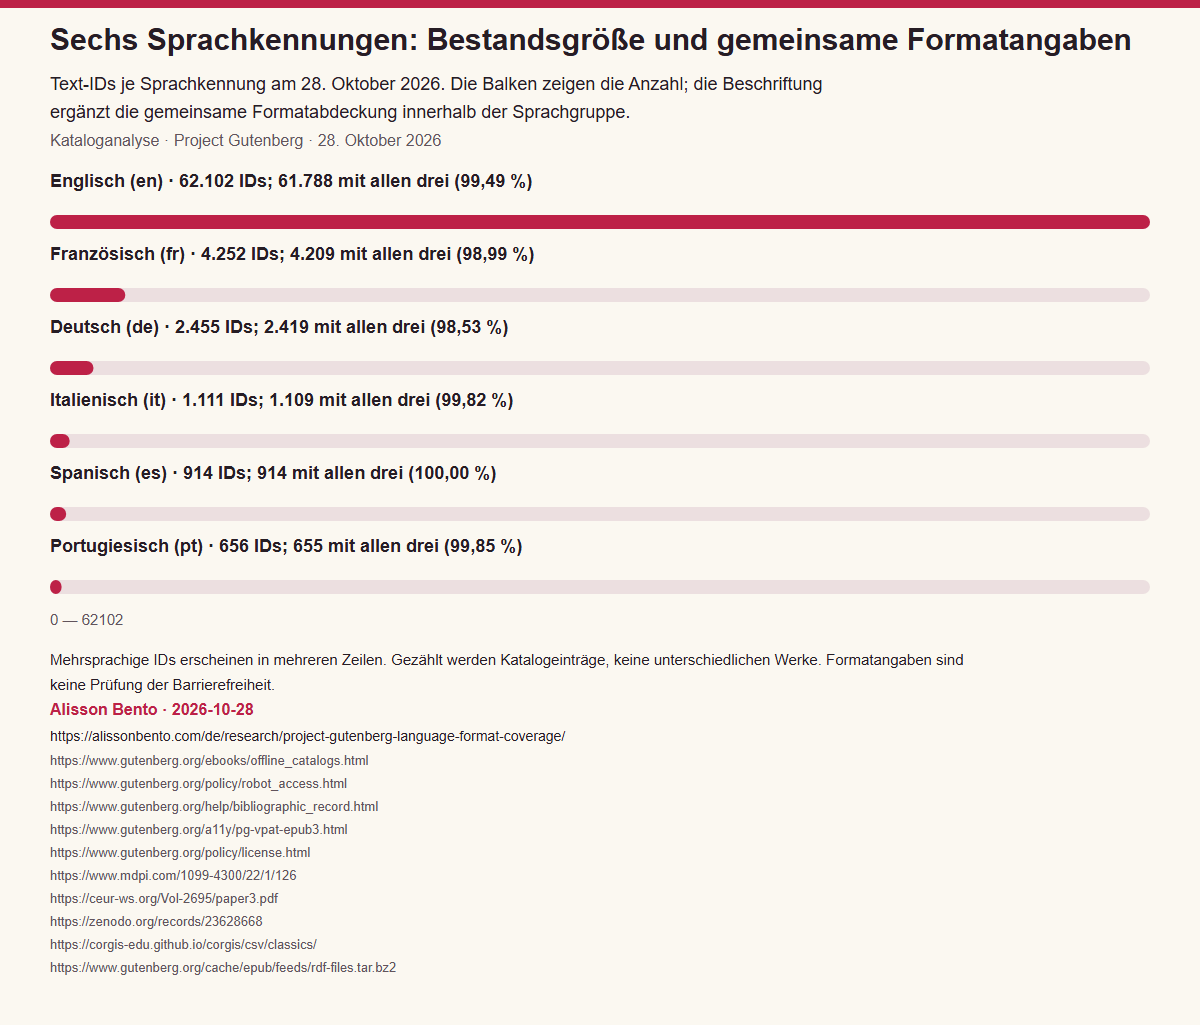
Für die sechs Sprachen dieser Website bietet eine zusätzliche Tabelle einen überschaubaren Einstieg. Die Kennung en steht bei 62.102 Text-IDs, fr bei 4.252, de bei 2.455, it bei 1.111, es bei 914 und pt bei 656. Diese Bestandszahlen und die jeweiligen Formatanteile beantworten unterschiedliche Fragen. Die Größe einer Sprachgruppe sagt noch nicht, welcher Anteil ihrer Einträge die drei untersuchten Grundformate gemeinsam verzeichnet.
Bei den deutsch gekennzeichneten Einträgen verzeichneten 2.419 von 2.455 IDs alle drei Formate, entsprechend 98,53 %. Für Englisch waren es 61.788 von 62.102 beziehungsweise 99,49 %, für Französisch 4.209 von 4.252 beziehungsweise 98,99 %. Die italienische Gruppe erreichte 1.109 von 1.111 beziehungsweise 99,82 %, die spanische 914 von 914 beziehungsweise 100,00 % und die portugiesische 655 von 656 beziehungsweise 99,85 %.
Diese Unterschiede beschreiben ausschließlich die eingefrorenen Metadaten vom 28. Oktober 2026. Sie erlauben keine Aussage darüber, welche Sprachgruppe dauerhaft besser versorgt ist oder weshalb einzelne Angaben fehlen. Das Diagramm trennt deshalb die Anzahl der IDs von der innerhalb einer Sprachgruppe berechneten gemeinsamen Formatabdeckung. Die sechs Zeilen sind weiterhin überlappende Sprachzuordnungen und dürfen nicht zu einer Zahl unterschiedlicher Bücher addiert werden.
Ein ergänzender Blick auf neuere Katalogeinträge
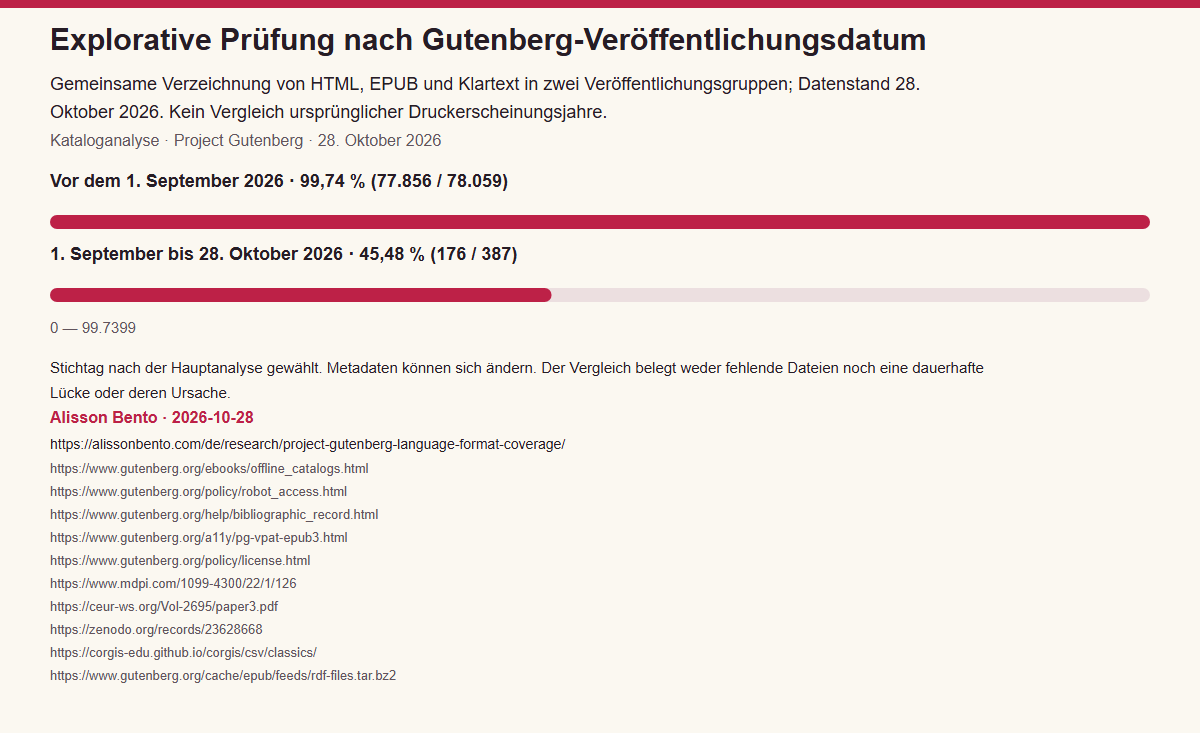
Nach der Hauptauswertung wurde zusätzlich geprüft, wie die gemeinsame Formatangabe mit dem Veröffentlichungsdatum bei Gutenberg zusammenfällt. Von 78.059 Text-IDs mit einem Gutenberg-Datum vor dem 1. September 2026 verzeichneten 77.856 alle drei Formate: 99,74 %. Bei den 387 Einträgen vom 1. September bis zum 28. Oktober 2026 waren es 176 oder 45,48 %. Von insgesamt 361 IDs ohne beobachtete EPUB-MIME-Angabe gehörten 211 zu dieser jüngeren Gruppe.
Dieser Vergleich ist eine explorative Zusatzprüfung. Der Stichtag wurde nach Berechnung der Haupttabelle gewählt; es handelt sich nicht um eine vorab registrierte Hypothese. Das Feld dcterms:issued beschreibt außerdem die Veröffentlichung bei Gutenberg und nicht das ursprüngliche Erscheinungsjahr eines gedruckten Werks. Die zwei Gruppen dürfen daher weder als literaturhistorische Zeiträume noch als Beleg für eine Veränderung des Buchmarkts interpretiert werden.
Gutenbergs Erläuterung zum bibliografischen Datensatz beschreibt, dass neue Einträge zunächst wenige Metadaten enthalten und später ergänzt werden. Auch erzeugte Formate und ihre Katalogangaben können sich ändern. Das macht die beobachtete Verteilung zeitabhängig, erklärt aber nicht nachweislich jeden einzelnen Fall. Die Auswertung belegt weder fehlende Dateien noch eine technische Störung oder eine dauerhafte Lücke. Für einen aktuellen Hinweis an Dritte sollte dieser Teil vorab erneut mit einem neuen, getrennt dokumentierten Datenstand geprüft werden.
Welcher Datenstand eingefroren wurde
Die Ausgangsdatei ist das von Project Gutenberg bereitgestellte Sammelarchiv rdf-files.tar.bz2. Die offizielle Seite Offline Catalogs and Feeds verweist auf diesen Weg für maschinenlesbare Katalogdaten. Die Hinweise unter Robot Access erlauben die entsprechende Nutzung des Gesamtkatalogs. Es wurden ausschließlich Metadaten heruntergeladen; keine E-Book-Texte, gewöhnlichen Buchseiten oder Suchergebnisse wurden für diese Auswertung gesammelt.
Drei Zeitangaben werden getrennt dokumentiert. Der HTTP-Header Last-Modified nennt den 28. Oktober 2026 um 14:35:54 UTC. Der Download war am selben Tag um 21:44:48,970368 UTC abgeschlossen. Die Analyse trägt den Zeitstempel 21:47:05,820155 UTC. Das Archiv umfasst 126.835.043 Bytes. Sein SHA-256-Prüfwert steht im Quellenmanifest, damit eine spätere Nachrechnung genau diese Ausgangsdatei identifizieren kann.
Der Datenstand 28. Oktober 2026 ist somit das Datum der Katalogbeobachtung. Er ist weder das Erscheinungsdatum aller enthaltenen Werke noch automatisch das Veröffentlichungsdatum dieses Artikels. Eine spätere Aktualisierung muss ein neues Archiv und einen neuen Beobachtungszeitpunkt ausweisen. Werden alte und neue Werte verglichen, müssen außerdem Auswahlregel, Dateityperkennung und Sprachzuordnung gleich bleiben oder ihre Änderungen ausdrücklich erklärt werden.
Wie aus dem Archiv vergleichbare Zahlen entstehen
Das Archiv wurde fortlaufend gelesen, ohne seine internen Pfade als Dateien zu entpacken. Für jeden RDF-Datensatz wurde die Katalog-ID ermittelt. Insgesamt wurden 79.697 reguläre Archivdateien und ebenso viele unterschiedliche IDs erfasst; es gab keine Parsefehler oder wiederholten IDs. Anschließend wurde die vollständige Menge der Typangaben geprüft. Ein Eintrag gelangte nur dann in den Textbestand, wenn diese Menge genau aus Text bestand.
Ausgeschlossen wurden 1.114 Einträge des Typs Sound, 89 Dataset, 33 Image, acht MovingImage, vier Collection und drei StillImage. Zusammen sind das 1.251 IDs. Diese Auswahl verhindert, dass etwa Tonaufnahmen oder Bildmaterial wie Text-E-Book-Einträge gezählt werden. Die verbliebenen 78.446 IDs wurden nicht nach literarischen Werken zusammengeführt: Bände, Ausgaben, Fortsetzungen und andere Katalogeinheiten behalten ihre eigene ID.
Für die Formate wurden die MIME-Werte der verzeichneten Dateien gelesen. HTML umfasst text/html und application/xhtml+xml; EPUB entspricht application/epub+zip; Klartext text/plain; PDF application/pdf. Zusätzliche MIME-Parameter werden für diese Grundzuordnung entfernt. Die besondere UTF-8-Kategorie verlangt dagegen ausdrücklich einen Klartextwert mit charset=utf-8, unabhängig von Großschreibung und Leerzeichen. Coverbilder, ZIP-Container und RDF-Dateien dienen nicht als Ersatzindikatoren für ein Leseformat.
Pro ID wird jeder Formatindikator höchstens einmal gezählt. Für die gemeinsame Abdeckung müssen HTML, EPUB und Klartext gleichzeitig vorkommen. Danach werden die Zähler sowohl insgesamt als auch je Sprachkennung durch den passenden Nenner geteilt. Die exportierten CSV-Werte wurden mit den JSON-Ergebnissen abgeglichen; Formatgesamtzahlen, alle 68 Sprachnenner und die Aufteilung nach dem ergänzenden Datumsstichtag stimmen überein.
So lassen sich Tabelle und Downloads sinnvoll einsetzen
Für eine persönliche Suche genügt oft die Sprachzeile als erster Überblick. Danach sollte die Auswahl auf einen konkreten Katalogeintrag eingegrenzt werden. Wer eine Leseliste erstellt, kann die Unterscheidung zwischen verzeichnetem Format und geprüftem Exemplar direkt übernehmen: Die Tabelle liefert den Überblick, eine eigene Prüfung der ausgewählten Dateien liefert erst die Grundlage für eine konkrete Nutzungsempfehlung. So bleiben Kataloganalyse und praktische Erprobung nachvollziehbar getrennt.
Bibliotheken oder Bildungsangebote können die Zahlen als datierten Hintergrund für eine Erklärung unterschiedlicher Lesewege verwenden. Dabei sollte jede Prozentangabe ihren Nenner behalten. Für einen deutschsprachigen Hinweis ist beispielsweise 2.419 von 2.455 IDs mit der Kennung de genauer als eine isolierte Prozentzahl. Bei einer mehrsprachigen Zusammenstellung muss zusätzlich erklärt werden, dass dieselbe ID in mehreren Sprachgruppen erscheinen kann.
Für eigene Auswertungen stehen aggregierte CSV-Dateien, die maschinenlesbaren Ergebnisse, ein Quellenmanifest und der Reproduktionscode bereit. Die unveränderten Sprachcodes und Feldnamen ermöglichen den Abgleich zwischen den Dateien. Eine Nachrechnung sollte in einem eigenen Arbeitsordner erfolgen, weil die Skripte dort neue abgeleitete Dateien schreiben. Das eingefrorene Originalarchiv bleibt die Referenz; ein später heruntergeladenes Archiv mit anderem Prüfwert ist eine neue Beobachtung, keine identische Wiederholung.
Was diese Analyse zu bestehenden Arbeiten beiträgt
Project Gutenberg ist bereits Gegenstand umfangreicher Forschung. Gerlach und Font-Clos beschrieben 2020 im Standardized Project Gutenberg Corpus Sprachen und Texte des Bestands. Egloff, Adamou und Picca untersuchten ebenfalls 2020 den Zugang zu Gutenberg-Daten über Ontologien und behandelten dabei RDF-Strukturen sowie Sprach- und Formatmetadaten. Formatfelder finden sich außerdem im Classics-Datensatz des CORGIS Datasets Project.
Gutenberg Atlas von Timm, veröffentlicht am 24. Oktober 2026 in Version 1.0.0, befasst sich mit Erscheinungsjahr- und Autorenmetadaten englischsprachiger Gutenberg-Bücher. Diese Arbeiten sind wichtige Bezugspunkte. Die vorliegende Auswertung beansprucht weder die erstmalige Entdeckung einer sprachlichen Konzentration noch die erstmalige Nutzung der Formatfelder. Ihr Beitrag ist eine neu datierte, nachrechenbare Darstellung für Leserinnen, Leser und Vermittler.
Dieser Beitrag besteht vor allem in den offengelegten Entscheidungen: ausschließlich als Text gekennzeichnete IDs, klar definierte MIME-Regeln, überlappende Sprachzuordnungen, eine vollständige Tabelle aller beobachteten Kennungen und eine ausdrücklich explorative Prüfung neuerer Einträge. Die verständliche Darstellung soll helfen, Aussagen aus einem Katalog angemessen einzuordnen. Sie verwandelt die zugrunde liegenden Metadaten nicht in einen geprüften Bestand funktionsfähiger oder rechtlich überall nutzbarer Dateien.
Kernaussage zum Weitergeben
Nach einer Auswertung von Alisson Bento verzeichneten am 28. Oktober 2026 insgesamt 78.032 von 78.446 ausschließlich als Text gekennzeichneten Project-Gutenberg-IDs HTML, EPUB und Klartext gemeinsam, entsprechend 99,47 %. Gezählt wurden Katalogeinträge, keine eindeutig unterschiedlichen Werke. Das Ergebnis beschreibt verzeichnete MIME-Angaben; Downloads und Barrierefreiheit wurden nicht geprüft. Insbesondere bei neu aufgenommenen Einträgen können sich die Angaben noch ändern.
Bei einer Weiterverwendung sollte diese zeitliche und sachliche Einordnung erhalten bleiben. Eine verkürzte Aussage wie „99,47 % aller Bücher sind in drei Formaten verfügbar“ würde die untersuchte Grundgesamtheit ausweiten und eine tatsächliche Verfügbarkeit behaupten, die nicht getestet wurde. Die präzise Formulierung ist auch für Bildunterschriften geeignet: Quelle sind die Project-Gutenberg-Katalogmetadaten, Berechnung und Darstellung stammen von Alisson Bento, Datenstand ist der 28. Oktober 2026.
Welche Leseformate im Katalog verzeichnet sind
Anteil an 78.446 ausschließlich als Text gekennzeichneten IDs am 28. Oktober 2026. Die Formatgruppen überlappen sich.
Vollständige Grafik und Quelle
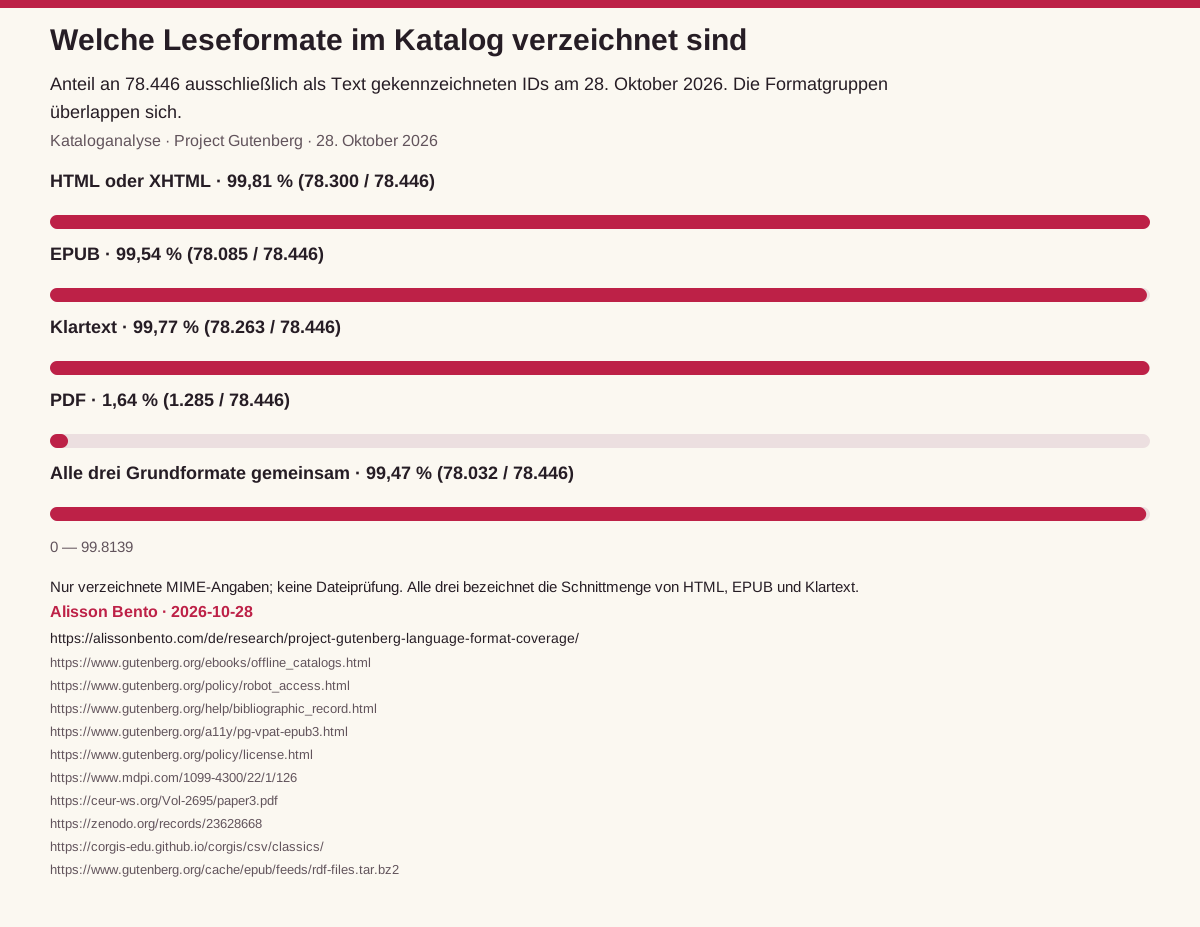
Diagramm seitlich scrollen, um alle Details zu sehen. ↔
Grafik und Werte
Sechs Sprachkennungen: Bestandsgröße und gemeinsame Formatangaben
Text-IDs je Sprachkennung am 28. Oktober 2026. Die Balken zeigen die Anzahl; die Beschriftung ergänzt die gemeinsame Formatabdeckung innerhalb der Sprachgruppe.
Vollständige Grafik und Quelle

Diagramm seitlich scrollen, um alle Details zu sehen. ↔
Grafik und Werte
Explorative Prüfung nach Gutenberg-Veröffentlichungsdatum
Gemeinsame Verzeichnung von HTML, EPUB und Klartext in zwei Veröffentlichungsgruppen; Datenstand 28. Oktober 2026. Kein Vergleich ursprünglicher Druckerscheinungsjahre.
Vollständige Grafik und Quelle

Diagramm seitlich scrollen, um alle Details zu sehen. ↔
Grafik und Werte
Daten und Downloads
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Verzeichnetes Format | Einträge | Anteil (%) |
|---|---|---|
| HTML oder XHTML | 78.300 | 99,81 |
| EPUB | 78.085 | 99,54 |
| Klartext | 78.263 | 99,77 |
| Klartext mit ausdrücklicher UTF-8-Angabe | 78.154 | 99,63 |
| 1.285 | 1,64 | |
| Alle drei Grundformate gemeinsam | 78.032 | 99,47 |
Datenstand 28. Oktober 2026. Nenner jeder Zeile: 78.446 Text-IDs. Die Formatgruppen überlappen sich und dürfen nicht addiert werden.
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Sprachkennung | Text-IDs | HTML verzeichnet | EPUB verzeichnet | Klartext verzeichnet | Alle drei verzeichnet | Alle drei (%) | PDF verzeichnet |
|---|---|---|---|---|---|---|---|
| en | 62.102 | 62.000 | 61.835 | 61.960 | 61.788 | 99,49 | 1.102 |
| fr | 4.252 | 4.234 | 4.213 | 4.230 | 4.209 | 98,99 | 36 |
| fi | 3.689 | 3.680 | 3.680 | 3.689 | 3.680 | 99,76 | 0 |
| de | 2.455 | 2.436 | 2.420 | 2.435 | 2.419 | 98,53 | 68 |
| nl | 1.120 | 1.120 | 1.114 | 1.120 | 1.114 | 99,46 | 1 |
| it | 1.111 | 1.111 | 1.109 | 1.111 | 1.109 | 99,82 | 58 |
| es | 914 | 914 | 914 | 914 | 914 | 100,00 | 9 |
| pt | 656 | 656 | 655 | 656 | 655 | 99,85 | 1 |
| hu | 655 | 655 | 655 | 655 | 655 | 100,00 | 1 |
| zh | 443 | 443 | 443 | 442 | 442 | 99,77 | 3 |
| sv | 257 | 257 | 257 | 257 | 257 | 100,00 | 0 |
| el | 221 | 221 | 221 | 221 | 221 | 100,00 | 6 |
| eo | 145 | 145 | 145 | 145 | 145 | 100,00 | 3 |
| la | 144 | 144 | 144 | 144 | 144 | 100,00 | 2 |
| ca | 97 | 97 | 95 | 97 | 95 | 97,94 | 0 |
| da | 85 | 85 | 85 | 85 | 85 | 100,00 | 0 |
| tl | 60 | 60 | 60 | 60 | 60 | 100,00 | 0 |
| pl | 31 | 31 | 31 | 31 | 31 | 100,00 | 2 |
| no | 23 | 23 | 23 | 23 | 23 | 100,00 | 0 |
| fy | 22 | 22 | 22 | 22 | 22 | 100,00 | 0 |
| ja | 21 | 21 | 21 | 21 | 21 | 100,00 | 0 |
| af | 17 | 17 | 17 | 17 | 17 | 100,00 | 0 |
| cy | 15 | 15 | 15 | 15 | 15 | 100,00 | 0 |
| cs | 12 | 12 | 12 | 12 | 12 | 100,00 | 1 |
| fur | 7 | 7 | 7 | 7 | 7 | 100,00 | 0 |
| ga | 7 | 7 | 5 | 7 | 5 | 71,43 | 0 |
| is | 7 | 7 | 7 | 7 | 7 | 100,00 | 0 |
| bg | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| enm | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| he | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| te | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| ro | 5 | 5 | 5 | 5 | 5 | 100,00 | 0 |
| ru | 5 | 5 | 5 | 5 | 5 | 100,00 | 1 |
| sl | 5 | 5 | 5 | 5 | 5 | 100,00 | 0 |
| ang | 4 | 4 | 4 | 4 | 4 | 100,00 | 0 |
| gla | 4 | 4 | 4 | 4 | 4 | 100,00 | 1 |
| sr | 4 | 4 | 4 | 3 | 3 | 75,00 | 0 |
| ceb | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| gl | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| grc | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| ilo | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| myn | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| nah | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| nai | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| nav | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| arp | 2 | 2 | 2 | 2 | 2 | 100,00 | 0 |
| brx | 2 | 2 | 2 | 2 | 2 | 100,00 | 0 |
| mi | 2 | 2 | 2 | 2 | 2 | 100,00 | 1 |
| oc | 2 | 2 | 2 | 2 | 2 | 100,00 | 0 |
| ale | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| ar | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| bgs | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| bo | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| br | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| csb | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| et | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| fa | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| hai | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| ia | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| iu | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| kha | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| kld | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| ko | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| nap | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| oji | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| rmq | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| sa | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| sco | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
Datenstand 28. Oktober 2026. Nenner ist jeweils die Zahl der Text-IDs mit dieser Sprachkennung. Mehrsprachige IDs erscheinen in mehreren Zeilen; Zeilen nicht addieren. Keine Prüfung der verlinkten Dateien.
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Sprachkennung | Text-IDs | Alle drei verzeichnet | Alle drei (%) |
|---|---|---|---|
| en | 62.102 | 61.788 | 99,49 |
| pt | 656 | 655 | 99,85 |
| es | 914 | 914 | 100,00 |
| fr | 4.252 | 4.209 | 98,99 |
| it | 1.111 | 1.109 | 99,82 |
| de | 2.455 | 2.419 | 98,53 |
Überlappende Sprachzuordnungen. Der Anteil mit allen drei Grundformaten verwendet den jeweiligen Sprachnenner. Datenstand 28. Oktober 2026.
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Gutenberg-Veröffentlichungsgruppe | Text-IDs | Alle drei verzeichnet | Alle drei (%) |
|---|---|---|---|
| Vor dem 1. September 2026 | 78.059 | 77.856 | 99,74 |
| 1. September bis 28. Oktober 2026 | 387 | 176 | 45,48 |
Gutenberg-Veröffentlichungsdatum, nicht ursprüngliches Druckerscheinungsjahr. Stichtag nach der Hauptanalyse gewählt. Momentaufnahme der Metadaten ohne Aussage über Ursachen oder Dauerhaftigkeit.
Daten und Methode
So haben wir gerechnet
- Vollerhebung des eingefrorenen Project-Gutenberg-RDF-Archivs unter der Auswahlregel: vollständige Typmenge genau {Text}. Analyseeinheit ist die unterschiedliche Katalog-ID. 79.697 IDs insgesamt, 78.446 einbezogen, 1.251 nach Typ ausgeschlossen. Keine Parsefehler und keine mehrfachen IDs im Ausgangsarchiv.
- Sprachgruppen enthalten jede einbezogene ID mit der jeweiligen Kennung genau einmal. 218 mehrsprachige IDs erzeugen Überschneidungen; 78.670 Sprachzuordnungen dürfen nicht mit 78.446 unterschiedlichen Text-IDs verwechselt werden. Die Formatanteile je Sprache verwenden den jeweiligen Sprachnenner.
- Formate werden ausschließlich aus verzeichneten MIME-Werten ermittelt. HTML umfasst text/html und application/xhtml+xml, EPUB application/epub+zip, Klartext text/plain und PDF application/pdf. Die gemeinsame Abdeckung verlangt HTML, EPUB und Klartext zugleich; die gesonderte UTF-8-Zahl verlangt eine ausdrückliche charset=utf-8-Angabe.
- Im Textbestand wurden keine wiederholten Datei-URLs und keine aufgeführten Dateien ohne MIME-Wert festgestellt. Das schließt andere Metadatenfehler nicht aus. Ein fehlender Treffer für eine MIME-Kategorie bedeutet lediglich, dass diese Kategorie in den ausgewerteten Angaben nicht beobachtet wurde.
- Die ergänzende Datumsprüfung verwendet dcterms:issued als Gutenberg-Veröffentlichungsdatum und den nach der Hauptanalyse gewählten Stichtag 1. September 2026. Sie ist explorativ. Beschreibende Werte dieser vollständigen Archivzählung erhalten keine Stichproben-Konfidenzintervalle; Auswahl- und Metadatenfehler bleiben möglich.
- Angezeigte Prozentwerte sind auf zwei Dezimalstellen gerundet. CSV und JSON bewahren vier Dezimalstellen, soweit für den jeweiligen berechneten Wert erforderlich. Zähler und Nenner ermöglichen eine eigene Nachrechnung. Quellenmanifest und Methodenbeschreibung halten Archivprüfwert und getrennte Zeitangaben fest.
Was die Daten nicht aussagen
- Katalogeinträge sind keine eindeutig unterschiedlichen Werke. Eine Prüfung normalisierter Titel-, Urheber- und Sprachkombinationen ergab 400 mögliche Übereinstimmungsgruppen mit 902 Einträgen. Das sind keine bestätigten Dubletten; sie wurden nicht zusammengelegt. Auch übereinstimmende Platzhalter für fehlende Titel können solche Gruppen erzeugen.
- Ein Text-Eintrag hatte einen leeren Titel; 130 Text-IDs verzeichneten keines der drei untersuchten Grundformate. Sie bleiben im festgelegten Nenner. Ein nachträglicher Ausschluss solcher Fälle würde die Fragestellung und die Prozentwerte verändern.
- Es wurde keine E-Book-Datei auf Erreichbarkeit, Vollständigkeit, Editionsgenauigkeit, Schadsoftware oder Bedienbarkeit geprüft. Auch Bildschirmleseprogramme und Anforderungen an Barrierefreiheit wurden nicht getestet. Gutenbergs eigener EPUB3 Accessibility Conformance Report beschreibt einen anderen Prüfgegenstand.
- Der ausgewählte Katalog repräsentiert weder sämtliche gemeinfreien Werke noch alle kostenlosen E-Books, den weltweiten Buchmarkt oder die Nachfrage nach einzelnen Sprachen. Sprachkennungen erlauben keine unmittelbaren Aussagen über Länder, Hauptsprachen oder Übersetzungsrichtungen.
- Die Freigabe der Katalogmetadaten ist keine pauschale Lizenz für die E-Book-Texte. Project Gutenberg enthält auch mit Erlaubnis bereitgestellte urheberrechtlich geschützte Werke und verweist auf unterschiedliche rechtliche Bedingungen außerhalb der Vereinigten Staaten. Die Rechte der konkreten Ausgabe müssen gesondert betrachtet werden.
- Die Werte gelten für den eingefrorenen Datenstand vom 28. Oktober 2026. Später ergänzte Metadaten oder erzeugte Formate können die Ergebnisse ändern. Die ergänzende Betrachtung jüngerer Einträge belegt weder einen dauerhaften Unterschied noch dessen Ursache.
Originalquellen
- Project Gutenberg: Offline Catalogs and Feeds
Offizielle Dokumentation des Sammelabrufs maschinenlesbarer RDF-Katalogdaten; verwendeter Datenstand: 28. Oktober 2026.
Abgerufen am 28. Oktober 2026
- Project Gutenberg: Robot Access
Offizielle Richtlinie zum automatisierten Zugriff mit Gemeinfreiheitsfreigabe für die Katalogmetadaten. Diese Freigabe betrifft nicht pauschal die E-Book-Texte.
Abgerufen am 28. Oktober 2026
- Project Gutenberg: Bibliographic Record
Erläuterung bibliografischer Felder, Gutenberg-Veröffentlichungsdaten sowie nachträglich ergänzter Metadaten und erzeugter Formate.
Abgerufen am 28. Oktober 2026
- Project Gutenberg: EPUB3 Accessibility Conformance Report
Bericht zum Umfang einer EPUB3-Barrierefreiheitsbewertung. Eine verzeichnete MIME-Angabe ersetzt keine solche Prüfung.
Abgerufen am 28. Oktober 2026
- Project Gutenberg: License
Hinweise zu Rechten an E-Books und Marken. Aus der Nutzungserlaubnis für Metadaten folgen keine weltweit einheitlichen Rechte an den Texten.
Abgerufen am 28. Oktober 2026
- Gerlach and Font-Clos (2020): A Standardized Project Gutenberg Corpus
Frühere Beschreibung des Gutenberg-Korpus und seiner Sprachen durch Gerlach und Font-Clos (2020); DOI 10.3390/e22010126.
Abgerufen am 28. Oktober 2026
- Egloff, Adamou and Picca (2020): Enabling Ontology-Based Data Access to Project Gutenberg
Frühere Untersuchung der Gutenberg-RDF-Struktur einschließlich Sprach- und Formatmetadaten durch Egloff, Adamou und Picca (2020).
Abgerufen am 28. Oktober 2026
- Timm (2026): Gutenberg Atlas
Gutenberg Atlas von Timm: Erscheinungsjahr- und Autorenmetadaten englischsprachiger Bücher; Version 1.0.0 vom 24. Oktober 2026; DOI 10.5281/zenodo.23628668.
Abgerufen am 28. Oktober 2026
- CORGIS Datasets Project: Classics
Früherer Lehrdatensatz mit Katalog-Formatfeldern. Die vorliegende Auswertung beansprucht keine erstmalige Analyse dieser Merkmale.
Abgerufen am 28. Oktober 2026
- Project Gutenberg bulk RDF catalogue
Eingefrorener RDF-Gesamtkatalog. SHA-256: c5ee946cea46fb32ffb2d55af670384064ccd818ab59d900c362a63b6bb29a65. HTTP-Änderungszeit: 28. Oktober 2026, 14:35:54 UTC; Abruf abgeschlossen: 21:44:48 UTC.
Abgerufen am 28. Oktober 2026
Studie zitieren und weiterverwenden
Alisson Bento. Project Gutenberg: Sprachen und verzeichnete Leseformate im Oktober 2026. Katalogdatenstand: 28. Oktober 2026. Quelle: Project Gutenberg, RDF-Gesamtkatalog; eigene Berechnungen. https://alissonbento.com/de/research/project-gutenberg-language-format-coverage/ https://alissonbento.com/de/research/project-gutenberg-language-format-coverage/
Die eigenen Auswertungen, Erläuterungen, Diagramme und der Reproduktionscode können mit Nennung von Alisson Bento, Verweis auf diese Studie, Datenstand 28. Oktober 2026 und Kennzeichnung etwaiger Änderungen weiterverwendet werden. Die zugrunde liegenden Katalogmetadaten stellt Project Gutenberg laut seiner Richtlinie gemeinfrei bereit; das gesicherte RDF-Beispiel nennt CC0. Diese Ebenen sind von den Rechten an E-Book-Texten zu trennen. Es wird weder eine Verbindung zu Project Gutenberg noch dessen Zustimmung zur Auswertung behauptet.
Korrekturen oder redaktionelle Fragen