
Ce que ces chiffres changent pour choisir un format de lecture
Une recherche de livre numérique comporte au moins deux questions : le catalogue contient-il une notice qui correspond au texte recherché, et quels formats cette notice indique-t-elle ? Cette étude répond à la seconde à l’échelle du catalogue, puis la décline par langue. Elle fournit un point de départ pour préparer une lecture, une sélection documentaire ou un outil de recherche. La vérification d’un titre précis reste une étape distincte.
Le résultat principal est simple : dans cette archive, les mentions HTML, EPUB et texte brut coexistent pour presque toutes les notices textuelles incluses. Un lecteur qui peut utiliser plusieurs de ces formats dispose donc, au niveau des métadonnées, de davantage de pistes qu’un lecteur qui exige un PDF déjà répertorié. Ce constat ne choisit pas un format à sa place. Il ne permet pas davantage de garantir qu’une version précise conviendra à son appareil ou à ses besoins.
Prenons un cas pratique hypothétique : une bibliothèque prépare une courte liste de lectures accessibles depuis son catalogue. Elle peut utiliser les indicateurs de formats pour repérer des notices à examiner, puis contrôler les liens et les éditions qu’elle souhaite recommander. Elle doit conserver la date du contrôle individuel. Le pourcentage global ne remplace pas cette vérification et ne constitue pas une certification applicable à chaque ressource.
Comprendre les pourcentages avant de comparer les formats
Chaque pourcentage global prend pour dénominateur les mêmes 78 446 identifiants de catalogue dont l’ensemble complet des types est exactement Text. HTML ou XHTML apparaît pour 78 300 identifiants, soit 99,81 % ; EPUB pour 78 085, soit 99,54 % ; et texte brut pour 78 263, soit 99,77 %. Le texte brut explicitement déclaré en UTF-8 concerne 78 154 identifiants, soit 99,63 %. Les tableaux donnent les effectifs afin que l’arrondi ne masque jamais le calcul.
Ces catégories se recoupent. Une notice peut indiquer plusieurs fichiers HTML, un EPUB et un fichier de texte brut, tout en ne comptant qu’une fois dans chacun des trois indicateurs. Les 78 032 notices de la catégorie « les trois formats » appartiennent simultanément aux catégories HTML, EPUB et texte brut. Ce nombre est une intersection ; il ne résulte pas de l’addition des trois effectifs. Les pourcentages ne doivent donc pas être empilés pour former un total de 100 %.
Le contraste avec le PDF est marqué dans les métadonnées : 1 285 notices sur 78 446 en indiquent un. Il serait pourtant erroné de transformer les 77 161 autres notices en autant de livres impossibles à imprimer ou à convertir. L’étude ne réalise aucune conversion et n’examine pas les fonctions d’impression des navigateurs. Elle se limite au type de fichier déclaré par la source, ce qui rend sa question plus précise et son résultat reproductible.
Les langues : distinguer la taille du catalogue et la couverture des formats
Le catalogue textuel comporte 68 valeurs distinctes de langue. Une valeur est ici une étiquette enregistrée dans une notice, pas une nationalité, un pays de publication ni une garantie sur la langue de chaque passage. Toutes les notices incluses possèdent au moins une valeur de langue. Parmi elles, 218 en possèdent plusieurs : on obtient ainsi 78 670 appartenances linguistiques pour seulement 78 446 identifiants. Additionner les lignes du tableau ferait compter certaines notices plusieurs fois.
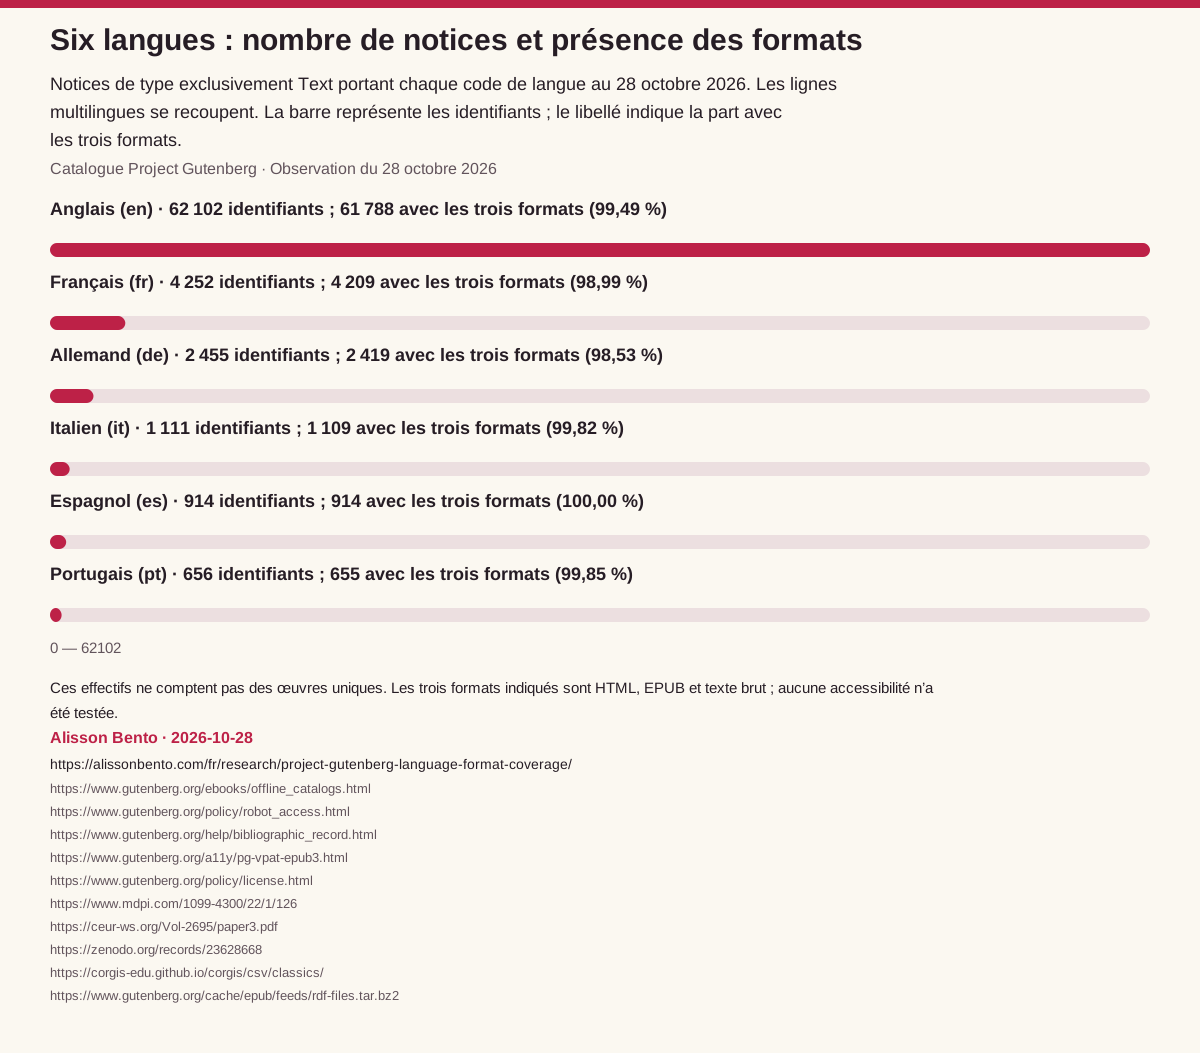
La ligne fr regroupe 4 252 notices portant le code du français. Parmi elles, 4 209 indiquent les trois formats, soit 98,99 %. La ligne en comprend 62 102 notices, dont 61 788 avec les trois formats, soit 99,49 %. Ces deux comparaisons répondent à des questions différentes : l’effectif décrit la présence d’un code de langue dans ce catalogue ; le pourcentage décrit la fréquence d’une combinaison de formats à l’intérieur de ce groupe.
Pour les quatre autres langues de référence de cette page, les résultats sont les suivants : 655 notices sur 656 pour pt, soit 99,85 % ; 914 sur 914 pour es, soit 100,00 % ; 1 109 sur 1 111 pour it, soit 99,82 % ; et 2 419 sur 2 455 pour de, soit 98,53 %. Un résultat de 100 % signifie seulement que chaque notice du groupe indique les trois catégories MIME recherchées dans cette archive. Il ne certifie ni le fonctionnement des fichiers ni leur accessibilité.
Le tableau complet conserve les 68 codes et leurs effectifs, y compris les groupes très petits. Cette transparence évite de transformer une sélection de six langues en description de l’ensemble du catalogue. Elle invite aussi à ne pas dresser un classement de qualité à partir de faibles écarts de pourcentage : une seule notice peut modifier fortement le résultat d’un groupe de quelques identifiants. Les codes scientifiques sont conservés pour faciliter le rapprochement avec les fichiers de données.
Comment utiliser les tableaux et les graphiques
Le premier tableau compare les formats avec un dénominateur commun. Le tableau des 68 langues change de dénominateur à chaque ligne : la colonne des notices Text indique alors la base de calcul. Pour vérifier la ligne française, il suffit par exemple de diviser 4 209 par 4 252 et de multiplier le résultat par 100. Les résultats affichés sont arrondis à deux décimales ; les exports de calcul conservent les pourcentages à quatre décimales.
Le graphique des six langues distingue visuellement le nombre de notices et le taux de présence des trois formats. La longueur de la barre représente des identifiants, tandis que son libellé fournit le résultat de couverture correspondant. Ces deux mesures ne sont pas interchangeables. Un groupe peut être beaucoup plus grand qu’un autre et afficher un taux très proche ; il peut aussi contenir des notices qui figurent dans une autre ligne en raison du multilinguisme.
Pour citer un résultat, conservez ensemble la mesure, son numérateur, son dénominateur et la date du 28 octobre 2026. Pour créer un tableau personnel, partez du CSV complet et documentez tout filtre supplémentaire. Écarter des langues ou sélectionner uniquement les notices avec EPUB produit une nouvelle population d’analyse. Un pourcentage calculé sur cette sélection ne doit pas être présenté comme celui du catalogue textuel étudié ici.
Une vérification exploratoire sur les notices récentes
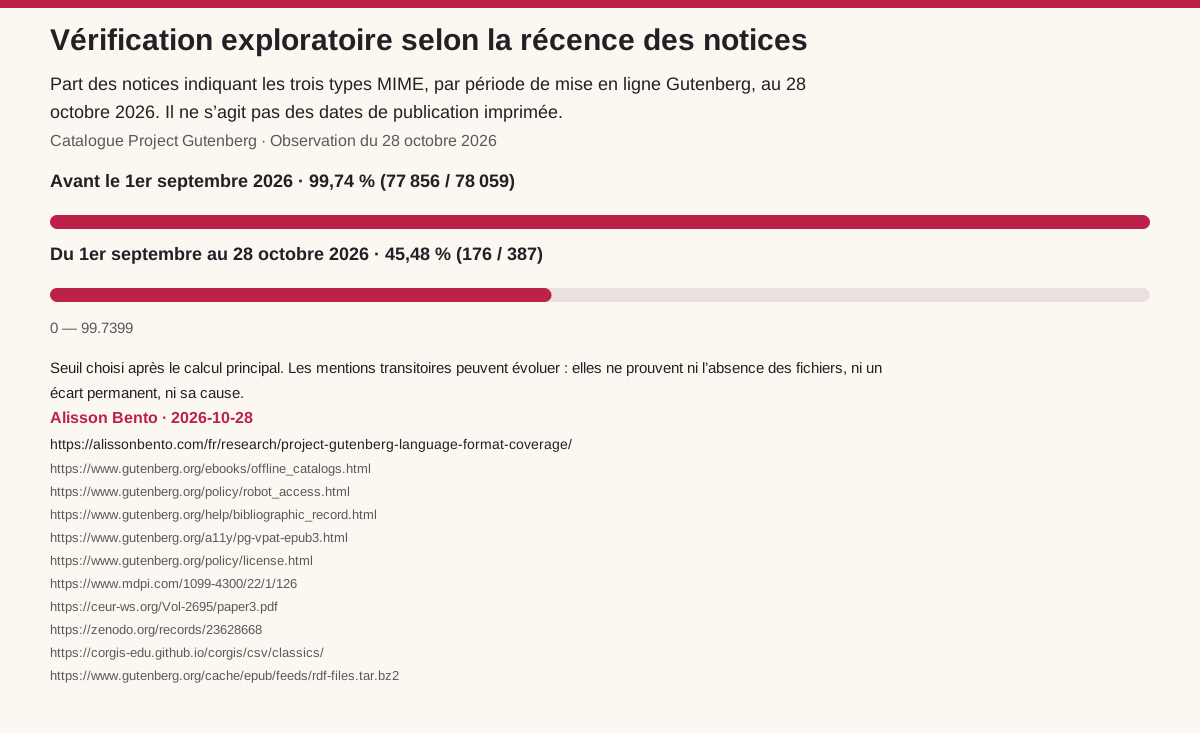
Après le calcul principal, une vérification complémentaire a séparé les notices selon leur date de mise à disposition dans Project Gutenberg. Parmi les 78 059 notices Text mises en ligne avant le 1er septembre 2026, 77 856 indiquaient les trois formats, soit 99,74 %. Parmi les 387 notices mises en ligne du 1er septembre au 28 octobre 2026, 176 le faisaient, soit 45,48 %. Ce découpage utilise la date Gutenberg, et non l’année de première publication imprimée.
Les notices de la période récente représentent également 211 des 361 notices sans mention MIME EPUB observée. Le rapprochement mérite d’être signalé, mais il ne démontre ni que des fichiers manquent réellement ni qu’un problème technique explique la différence. La documentation Bibliographic Record de Project Gutenberg décrit des notices initialement minimales, enrichies après leur publication, ainsi que des formats générés. Ces informations rendent nécessaire une lecture prudente ; elles ne prouvent pas la cause du résultat observé pour chaque notice.
La date du 1er septembre a été choisie pendant l’exploration, après le tableau principal. Ce n’était pas une hypothèse enregistrée à l’avance. Le résultat sert donc de test de sensibilité descriptif : il montre combien une moyenne peut dépendre de l’ancienneté des notices présentes dans une photographie du catalogue. Toute reprise liée à l’actualité devrait d’abord consulter un nouvel état de la source, en conservant séparément l’archive historique et le nouveau calcul.
Une source associative et trois horodatages à ne pas confondre
La source est Project Gutenberg, projet à but non lucratif, et non une administration publique. L’analyse utilise son archive RDF intégrale, proposée dans sa documentation Offline Catalogs and Feeds. La politique Robot Access oriente les utilisateurs du catalogue vers ce téléchargement groupé et précise les conditions de réutilisation des métadonnées. Aucun texte de livre n’a été téléchargé pour cette étude et les pages ordinaires de livres ou de recherche n’ont pas été parcourues automatiquement.
L’en-tête HTTP Last-Modified de l’archive indique le 28 octobre 2026 à 14 h 35 min 54 s UTC. Le téléchargement s’est achevé ce même jour à 21 h 44 min 48,970368 s UTC. Le calcul est horodaté à 21 h 47 min 05,820155 s UTC. Ces trois indications décrivent respectivement la modification annoncée par le serveur, la récupération de la copie et son analyse. Aucune ne doit être assimilée à la date de publication de tous les livres répertoriés.
L’archive contient 126 835 043 octets. Son empreinte SHA-256 est conservée dans le manifeste téléchargeable, ce qui permet de vérifier que deux calculs partent des mêmes octets. Une analyse future peut donner d’autres chiffres parce que le catalogue évolue. Cette possibilité ne justifie pas de remplacer silencieusement la copie utilisée ici : une comparaison dans le temps doit garder une trace distincte de chaque source, de sa date et des règles appliquées.
Des usages concrets pour les lecteurs, bibliothèques et développeurs
Pour un lecteur, le tableau aide à formuler une recherche réaliste : choisir une langue, repérer un titre, puis regarder les formats effectivement indiqués dans sa notice actuelle. Si le PDF est indispensable, il faut le rechercher explicitement plutôt que supposer sa présence à partir de celle d’un EPUB. Si plusieurs formats conviennent, les résultats invitent à examiner ces différentes pistes sans conclure que leurs contenus ou leurs possibilités de lecture sont identiques.
Pour une équipe documentaire, les effectifs peuvent aider à préparer une sélection de ressources à contrôler. Ils ne suffisent pas à dimensionner une offre nationale ni à mesurer les besoins d’un public. Une liste de lecture utile exige encore des choix de titres, de versions et de contexte. Lorsqu’elle mentionne ce travail, elle doit présenter les chiffres comme une analyse indépendante de métadonnées Project Gutenberg, sans suggérer que le projet approuve la sélection ou la publication.
Pour un développeur, l’intérêt principal est la séparation des unités : conserver l’identifiant de notice, représenter les langues comme un ensemble et calculer les formats comme des indicateurs de présence. Cette structure évite de multiplier les effectifs à chaque fichier ou à chaque langue. Un outil construit sur ces données devrait également distinguer « format indiqué dans les métadonnées » d’un éventuel résultat de contrôle technique ultérieur. Les deux observations portent sur des faits différents et peuvent dater de moments différents.
Ce que cette étude ajoute aux travaux déjà disponibles
Project Gutenberg a déjà fait l’objet de travaux sur les corpus, les langues et les métadonnées. Gerlach et Font-Clos ont présenté en 2020 le Standardized Project Gutenberg Corpus, ou SPGC, pour l’analyse statistique du langage. Egloff, Adamou et Picca ont étudié la même année l’accès aux données RDF de Gutenberg fondé sur une ontologie, notamment leur structure et leurs champs. Le jeu pédagogique Classics du projet CORGIS expose lui aussi des informations de format.
Le Gutenberg Atlas de Timm, version 1.0.0 publiée le 24 octobre 2026, porte sur les années de publication et les métadonnées d’auteurs des livres anglophones. Ces travaux sont des précédents à reconnaître, même lorsque leurs questions et leurs périmètres diffèrent de ceux de cette page. La présence de langues inégalement représentées, tout comme l’existence de champs de format, n’est pas une découverte revendiquée ici.
La contribution de cette étude est un relevé daté et reproductible, expliqué pour un usage concret : une règle explicite d’inclusion des notices Text, des définitions MIME vérifiables, les 68 lignes linguistiques et une vérification exploratoire sur la récence. Le texte accompagne les chiffres pour rendre leurs dénominateurs et leurs limites compréhensibles. Il ne s’agit pas d’un article évalué par les pairs ni d’une démonstration de supériorité d’un catalogue ou d’une langue.
Réutiliser les données sans élargir leur portée
Les téléchargements séparent les résultats agrégés, la méthode, le manifeste de source et le code de reproduction. Le fichier des langues donne l’ensemble des 68 lignes ; le fichier de référence à six langues facilite les comparaisons présentées dans cette page. Le contrôle des types rend visible la différence entre l’archive complète et la population analysée. La vérification de récence dispose de son propre export afin de rester identifiable comme analyse exploratoire.
Une réutilisation fidèle doit créditer Project Gutenberg pour les métadonnées et Alisson Bento pour l’analyse originale, préciser la date de l’observation et signaler les modifications apportées. La permission de réutiliser les données du catalogue concerne ces métadonnées. Elle ne constitue pas une autorisation générale portant sur le texte des livres, ni une décision sur leur statut juridique dans tous les pays. La documentation License de Project Gutenberg reste la référence de la source pour ces questions distinctes.
Pour reproduire le calcul, utilisez une copie de travail séparée, placez l’archive figée à l’emplacement indiqué dans le manifeste et vérifiez son empreinte avant de lancer les scripts. Le code d’analyse fonctionne hors ligne à partir de cette archive ; la production des figures nécessite également la bibliothèque graphique indiquée dans la méthode. Les fichiers bruts de livres ne sont nécessaires à aucune étape de cet audit des métadonnées.
Un résultat à reprendre avec sa date et sa réserve
Dans l’archive RDF Project Gutenberg du 28 octobre 2026, 78 032 des 78 446 notices de type exclusivement Text, soit 99,47 %, indiquaient simultanément HTML, EPUB et texte brut. Il s’agit de formats répertoriés dans les métadonnées, sans test des fichiers. Les notices et les formats générés peuvent évoluer, particulièrement après une mise en ligne récente.
Pour une citation centrée sur le français : parmi les 4 252 notices Text portant le code fr dans cette même archive, 4 209, soit 98,99 %, indiquaient les trois formats. Les langues se recoupent lorsque les notices sont multilingues ; ce décompte ne représente donc ni un nombre d’œuvres françaises uniques ni une certification de leur lecture. Conserver ces précisions avec le chiffre rend la reprise vérifiable et évite de transformer un état du catalogue en promesse permanente.
Formats de lecture indiqués dans les notices
Part des 78 446 identifiants de type exclusivement Text indiquant chaque format au 28 octobre 2026. Les catégories se recoupent.
Graphique complet et source

Faites défiler le graphique horizontalement pour le consulter. ↔
Graphique et valeurs
Télécharger le graphique (SVG) ↓ · Télécharger le graphique (PNG) ↓

Six langues : nombre de notices et présence des formats
Notices de type exclusivement Text portant chaque code de langue au 28 octobre 2026. Les lignes multilingues se recoupent. La barre représente les identifiants ; le libellé indique la part avec les trois formats.
Graphique complet et source
Faites défiler le graphique horizontalement pour le consulter. ↔
Graphique et valeurs
Télécharger le graphique (SVG) ↓ · Télécharger le graphique (PNG) ↓

Vérification exploratoire selon la récence des notices
Part des notices indiquant les trois types MIME, par période de mise en ligne Gutenberg, au 28 octobre 2026. Il ne s’agit pas des dates de publication imprimée.
Graphique complet et source
Faites défiler le graphique horizontalement pour le consulter. ↔
Graphique et valeurs
Télécharger le graphique (SVG) ↓ · Télécharger le graphique (PNG) ↓
Données et téléchargements
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Format indiqué | Notices | Part (%) |
|---|---|---|
| HTML ou XHTML | 78 300 | 99,81 |
| EPUB | 78 085 | 99,54 |
| Texte brut | 78 263 | 99,77 |
| Texte brut explicitement UTF-8 | 78 154 | 99,63 |
| 1 285 | 1,64 | |
| Les trois formats ensemble | 78 032 | 99,47 |
Observation du 28 octobre 2026. Chaque dénominateur comprend 78 446 identifiants de type exclusivement Text. Les lignes de formats se recoupent et ne doivent pas être additionnées.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Code de langue | Identifiants Text | HTML indiqué | EPUB indiqué | Texte brut indiqué | Trois formats indiqués | Trois formats (%) | PDF indiqué |
|---|---|---|---|---|---|---|---|
| en | 62 102 | 62 000 | 61 835 | 61 960 | 61 788 | 99,49 | 1 102 |
| fr | 4 252 | 4 234 | 4 213 | 4 230 | 4 209 | 98,99 | 36 |
| fi | 3 689 | 3 680 | 3 680 | 3 689 | 3 680 | 99,76 | 0 |
| de | 2 455 | 2 436 | 2 420 | 2 435 | 2 419 | 98,53 | 68 |
| nl | 1 120 | 1 120 | 1 114 | 1 120 | 1 114 | 99,46 | 1 |
| it | 1 111 | 1 111 | 1 109 | 1 111 | 1 109 | 99,82 | 58 |
| es | 914 | 914 | 914 | 914 | 914 | 100,00 | 9 |
| pt | 656 | 656 | 655 | 656 | 655 | 99,85 | 1 |
| hu | 655 | 655 | 655 | 655 | 655 | 100,00 | 1 |
| zh | 443 | 443 | 443 | 442 | 442 | 99,77 | 3 |
| sv | 257 | 257 | 257 | 257 | 257 | 100,00 | 0 |
| el | 221 | 221 | 221 | 221 | 221 | 100,00 | 6 |
| eo | 145 | 145 | 145 | 145 | 145 | 100,00 | 3 |
| la | 144 | 144 | 144 | 144 | 144 | 100,00 | 2 |
| ca | 97 | 97 | 95 | 97 | 95 | 97,94 | 0 |
| da | 85 | 85 | 85 | 85 | 85 | 100,00 | 0 |
| tl | 60 | 60 | 60 | 60 | 60 | 100,00 | 0 |
| pl | 31 | 31 | 31 | 31 | 31 | 100,00 | 2 |
| no | 23 | 23 | 23 | 23 | 23 | 100,00 | 0 |
| fy | 22 | 22 | 22 | 22 | 22 | 100,00 | 0 |
| ja | 21 | 21 | 21 | 21 | 21 | 100,00 | 0 |
| af | 17 | 17 | 17 | 17 | 17 | 100,00 | 0 |
| cy | 15 | 15 | 15 | 15 | 15 | 100,00 | 0 |
| cs | 12 | 12 | 12 | 12 | 12 | 100,00 | 1 |
| fur | 7 | 7 | 7 | 7 | 7 | 100,00 | 0 |
| ga | 7 | 7 | 5 | 7 | 5 | 71,43 | 0 |
| is | 7 | 7 | 7 | 7 | 7 | 100,00 | 0 |
| bg | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| enm | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| he | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| te | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| ro | 5 | 5 | 5 | 5 | 5 | 100,00 | 0 |
| ru | 5 | 5 | 5 | 5 | 5 | 100,00 | 1 |
| sl | 5 | 5 | 5 | 5 | 5 | 100,00 | 0 |
| ang | 4 | 4 | 4 | 4 | 4 | 100,00 | 0 |
| gla | 4 | 4 | 4 | 4 | 4 | 100,00 | 1 |
| sr | 4 | 4 | 4 | 3 | 3 | 75,00 | 0 |
| ceb | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| gl | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| grc | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| ilo | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| myn | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| nah | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| nai | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| nav | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| arp | 2 | 2 | 2 | 2 | 2 | 100,00 | 0 |
| brx | 2 | 2 | 2 | 2 | 2 | 100,00 | 0 |
| mi | 2 | 2 | 2 | 2 | 2 | 100,00 | 1 |
| oc | 2 | 2 | 2 | 2 | 2 | 100,00 | 0 |
| ale | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| ar | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| bgs | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| bo | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| br | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| csb | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| et | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| fa | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| hai | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| ia | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| iu | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| kha | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| kld | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| ko | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| nap | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| oji | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| rmq | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| sa | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| sco | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
Observation du 28 octobre 2026. Chaque dénominateur correspond aux notices Text portant le code de langue concerné. Une notice multilingue figure dans plusieurs lignes ; ne pas additionner les lignes. Les fichiers n’ont pas été testés.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Code de langue | Identifiants Text | Trois formats indiqués | Trois formats (%) |
|---|---|---|---|
| en | 62 102 | 61 788 | 99,49 |
| pt | 656 | 655 | 99,85 |
| es | 914 | 914 | 100,00 |
| fr | 4 252 | 4 209 | 98,99 |
| it | 1 111 | 1 109 | 99,82 |
| de | 2 455 | 2 419 | 98,53 |
Les appartenances linguistiques se recoupent. Chaque part des trois formats utilise le dénominateur de sa propre langue. Observation du 28 octobre 2026.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Période de mise en ligne | Identifiants Text | Trois formats indiqués | Trois formats (%) |
|---|---|---|---|
| Avant le 1er septembre 2026 | 78 059 | 77 856 | 99,74 |
| Du 1er septembre au 28 octobre 2026 | 387 | 176 | 45,48 |
Date de mise à disposition par Gutenberg, et non année de première publication imprimée. Seuil choisi après l’analyse principale. Observation ponctuelle des métadonnées, sans conclusion causale ou permanente.
Données et méthode
Notre méthode de calcul
- L’archive officielle est figée et contrôlée par son empreinte SHA-256 : c5ee946cea46fb32ffb2d55af670384064ccd818ab59d900c362a63b6bb29a65. Ses 79 697 fichiers ordinaires ont été parcourus en flux, sans extraire leurs chemins sur disque. L’analyse RDF retrouve 79 697 identifiants distincts, sans erreur de lecture ni identifiant répété.
- La règle d’inclusion exige que l’ensemble distinct des valeurs dcterms:type soit exactement {Text}. Les 1 251 exclusions se répartissent ainsi : Sound, 1 114 ; Dataset, 89 ; Image, 33 ; MovingImage, 8 ; Collection, 4 ; StillImage, 3. Aucun cas sans type n’a été observé. Les libellés techniques restent inchangés pour permettre la vérification dans la source.
- L’unité est l’identifiant de catalogue. Les volumes, éditions, numéros de périodiques et versions ne sont pas regroupés en œuvres uniques. Une recherche exploratoire sur la combinaison normalisée titre-créateur-langue a trouvé 400 groupes candidats réunissant 902 notices. Ces correspondances, qui peuvent aussi impliquer des titres absents, ne constituent pas des doublons confirmés et n’ont entraîné aucune suppression.
- Chaque identifiant inclus est associé une seule fois à chacune de ses valeurs distinctes de langue. Les dénominateurs linguistiques comptent ces identifiants portant le code concerné. Aucune notice Text ne manque de valeur linguistique ; les 218 notices multilingues expliquent que les 78 670 appartenances dépassent les 78 446 notices.
- Pour chaque fichier référencé par dcterms:hasFormat/pgterms:file, le type MIME de base est obtenu en séparant les paramètres. HTML correspond à text/html ou application/xhtml+xml ; EPUB à application/epub+zip ; texte brut à text/plain ; PDF à application/pdf. Le sous-indicateur UTF-8 exige un paramètre explicite charset=utf-8, après normalisation des espaces et de la casse. Aucune version EPUB n’est déduite de son seul type MIME.
- Chaque indicateur est compté au plus une fois par identifiant. La présence simultanée exige les trois indicateurs HTML, EPUB et texte brut. Les images de couverture, conteneurs ZIP et fichiers RDF ne servent pas de substituts à ces formats. Dans le sous-ensemble Text audité, aucune URL de fichier répétée ni aucun fichier référencé sans type MIME n’a été observé.
- Les totaux des six indicateurs, les 68 dénominateurs linguistiques et la partition des deux périodes de mise en ligne ont été rapprochés des exports. L’étude décrit exhaustivement l’archive sous cette règle d’inclusion ; elle ne repose pas sur un échantillon probabiliste de la littérature. Des intervalles de confiance d’échantillonnage ne conviennent donc pas à ces comptages, tandis que les erreurs de métadonnées et les effets de sélection restent possibles.
Ce que les données ne permettent pas de conclure
- Une notice n’est pas une œuvre unique, et Text ne signifie pas nécessairement roman. Une notice Text avait un titre vide ; 130 n’indiquaient aucune des trois catégories MIME principales. Elles restent dans le dénominateur déclaré au lieu d’être retirées pour améliorer les pourcentages.
- Aucun fichier de livre n’a été ouvert pour contrôler son téléchargement, sa fidélité éditoriale, son intégralité, sa sécurité, sa lecture par une technologie d’assistance ou sa conformité d’accessibilité. Le rapport d’accessibilité EPUB3 de Project Gutenberg possède son propre périmètre ; cet audit ne remplace pas ses évaluations.
- Project Gutenberg est un catalogue sélectionné. Ses effectifs ne mesurent ni tous les livres gratuits, ni tout le domaine public, ni le marché mondial du livre, ni la demande des lecteurs, ni l’offre de romance contemporaine. Une étiquette linguistique n’établit pas non plus une nationalité ou une direction de traduction.
- Les dates dcterms:issued décrivent la mise à disposition par Gutenberg, pas la première publication imprimée. Les métadonnées et les formats générés évoluent. La comparaison exploratoire de récence ne mesure pas une dégradation durable et n’établit aucune cause.
- Les droits sur les métadonnées sont distincts des droits sur les textes. Gutenberg comprend aussi des œuvres diffusées avec autorisation et renvoie les utilisateurs hors des États-Unis à la vérification des règles applicables. Cette étude n’établit pas le statut juridique individuel des livres et ne fournit pas d’avis juridique.
Sources originales
- Project Gutenberg: Offline Catalogs and Feeds
Documentation officielle du téléchargement groupé RDF ; catalogue figé au 28 octobre 2026.
Consulté le 28 octobre 2026
- Project Gutenberg: Robot Access
Mise dans le domaine public des métadonnées du catalogue et voie autorisée de téléchargement groupé ; ne concerne pas les droits sur les textes.
Consulté le 28 octobre 2026
- Project Gutenberg: Bibliographic Record
Description des champs, des dates de mise à disposition et de l’enrichissement progressif des notices et des formats générés.
Consulté le 28 octobre 2026
- Project Gutenberg: EPUB3 Accessibility Conformance Report
Périmètre des évaluations d’accessibilité ; une mention MIME ne constitue pas un test d’accessibilité.
Consulté le 28 octobre 2026
- Project Gutenberg: License
Indications sur les droits des livres numériques et la marque ; l’autorisation concernant les métadonnées n’établit pas les droits sur les livres dans tous les pays.
Consulté le 28 octobre 2026
- Gerlach and Font-Clos (2020): A Standardized Project Gutenberg Corpus
Travail antérieur sur le corpus Gutenberg et ses langues ; DOI 10.3390/e22010126.
Consulté le 28 octobre 2026
- Egloff, Adamou and Picca (2020): Enabling Ontology-Based Data Access to Project Gutenberg
Travail antérieur sur les données RDF de Gutenberg, notamment les métadonnées de langue et de format.
Consulté le 28 octobre 2026
- Timm (2026): Gutenberg Atlas
Métadonnées des années de publication et des auteurs anglophones ; version 1.0.0 publiée le 24 octobre 2026, DOI 10.5281/zenodo.23628668.
Consulté le 28 octobre 2026
- CORGIS Datasets Project: Classics
Jeu pédagogique antérieur comprenant des champs de format du catalogue ; aucune primauté de cette analyse n’est revendiquée.
Consulté le 28 octobre 2026
- Project Gutenberg bulk RDF catalogue
Archive source : SHA-256 c5ee946cea46fb32ffb2d55af670384064ccd818ab59d900c362a63b6bb29a65 ; dernière modification annoncée le 28 octobre 2026 à 14:35:54 UTC, récupération à 21:44:48 UTC.
Consulté le 28 octobre 2026
Citer et réutiliser cette étude
Alisson Bento. « Project Gutenberg : langues et formats de lecture dans le catalogue du 28 octobre 2026 ». Analyse indépendante du catalogue RDF Project Gutenberg, observation du 28 octobre 2026. https://alissonbento.com/fr/research/project-gutenberg-language-format-coverage/ . Source des métadonnées : Project Gutenberg ; calculs et commentaire : Alisson Bento. https://alissonbento.com/fr/research/project-gutenberg-language-format-coverage/
Les métadonnées sources sont placées dans le domaine public par Project Gutenberg ; l’exemple RDF figé mentionne CC0. Pour réutiliser l’analyse originale, le code et les graphiques, créditez Alisson Bento, liez cette étude, indiquez la date du 28 octobre 2026 et signalez vos modifications, conformément au fichier des conditions de réutilisation. Ces dispositions ne portent pas sur le texte des livres et ne déterminent pas leurs droits dans chaque pays. Aucune affiliation ni approbation de Project Gutenberg n’est revendiquée.
Corrections ou questions éditoriales