La domanda utile prima di scegliere un file
Chi cerca una lettura digitale può avere esigenze molto diverse: aprire una pagina, trasferire un file a un lettore, lavorare su un testo senza impaginazione oppure trovare un PDF già elencato. Il numero totale delle voci di un catalogo non risponde da solo a nessuna di queste esigenze. Occorre distinguere la presenza della scheda, la lingua registrata e i formati che quella scheda indica. Qui misuriamo proprio quest’ultimo passaggio, senza trasformarlo in una promessa sul funzionamento dei file.
La fonte è Project Gutenberg, un progetto senza fini di lucro, non un’amministrazione pubblica. Abbiamo analizzato il suo archivio RDF distribuito in blocco attraverso il canale ufficiale. La domanda è circoscritta: tra gli ID classificati esclusivamente come Text, quanti presentavano almeno un riferimento MIME a ciascun formato? MIME è l’etichetta tecnica con cui il catalogo descrive il tipo di un file. Un riferimento a EPUB, per esempio, segnala la presenza di quel tipo nei metadati; non racconta che cosa accade quando una persona prova a usarlo.
La risposta principale è ampia ma precisa: quasi tutti i record del sottoinsieme indicavano tutti e tre i percorsi HTML, EPUB e testo semplice. Per cercare un PDF già registrato, invece, la base osservata era molto più piccola. Il dato può orientare una ricerca iniziale o il progetto di un filtro, ma la scelta finale richiede ancora la consultazione della scheda e del file specifico. La data deve accompagnare questa indicazione: descriviamo il 28 ottobre 2026, non uno stato permanente del servizio.
Come leggere le percentuali dei formati
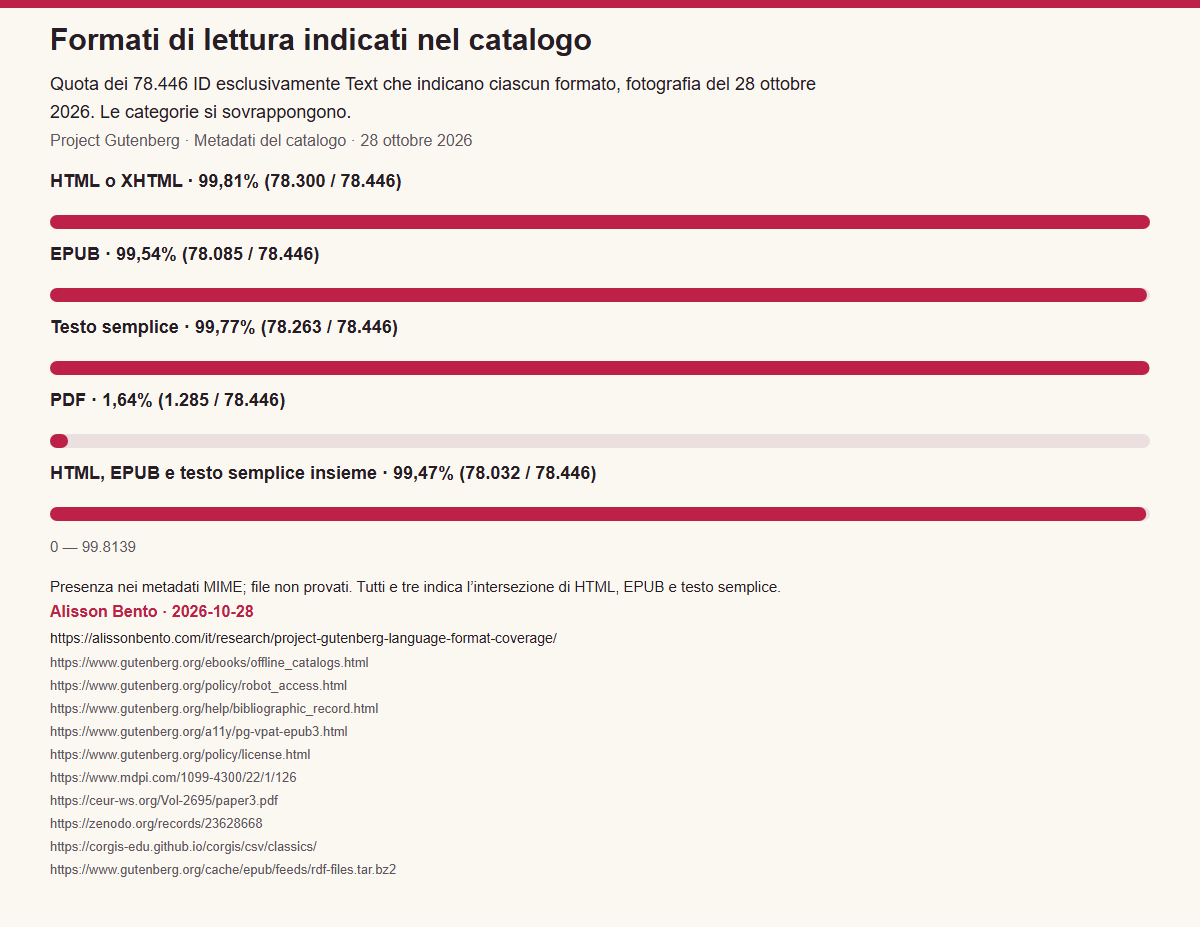
La tabella dei formati usa sempre lo stesso denominatore: 78.446 ID testuali. HTML o XHTML compare in 78.300 record, il 99,81%; EPUB in 78.085, il 99,54%; il testo semplice in 78.263, il 99,77%. La riga del testo semplice esplicitamente marcato UTF-8 conta 78.154 record, il 99,63%. Questa riga più specifica distingue un parametro effettivamente dichiarato da un’ipotesi sulla codifica. Non abbiamo dedotto UTF-8 dal titolo, dalla lingua o dall’aspetto del file.
La misura «tutti e tre» richiede che uno stesso ID presenti HTML, EPUB e testo semplice. Il risultato è 78.032, cioè il 99,47% del denominatore. Non è la somma delle tre colonne e non significa che esistano soltanto tre file per scheda: un record può indicare più versioni dello stesso formato. Contiamo la presenza una sola volta per ID, così una scheda con numerosi file non pesa più di una scheda con un solo riferimento pertinente.
Il PDF è indicato in 1.285 record, l’1,64%. Questo valore descrive un formato registrato, senza includere eventuali conversioni, esportazioni o stampe. Non autorizza a dire che tutti gli altri record siano impossibili da leggere come PDF. Allo stesso modo, le percentuali delle righe non devono totalizzare cento: un ID può comparire contemporaneamente nelle righe HTML, EPUB, testo semplice e PDF. Un grafico a barre separate rende visibile questa sovrapposizione; una ripartizione in fette darebbe una lettura sbagliata.
Una lingua registrata non è un insieme separato di libri
I 78.446 record testuali contengono 68 codici linguistici distinti e nessuno è privo di un codice. Tuttavia, 218 ID riportano più lingue. Attribuendo a ogni ID una sola appartenenza per ciascun codice distinto, otteniamo 78.670 appartenenze complessive. È un conteggio corretto, ma risponde a una domanda diversa dal numero di record. Sommare le righe linguistiche come se fossero raccolte disgiunte conterebbe più volte alcuni ID.
Per l’italiano, il codice it è presente in 1.111 record: 1.109 indicano tutti e tre i formati, pari al 99,82%. HTML e testo semplice sono indicati in tutti i 1.111; EPUB in 1.109; PDF in 58. Questa è una descrizione dei record contrassegnati it, non un censimento della letteratura italiana, delle edizioni pubblicate in Italia o delle opere di autori italiani. Il codice non garantisce neppure che ogni passaggio del documento sia nella stessa lingua.
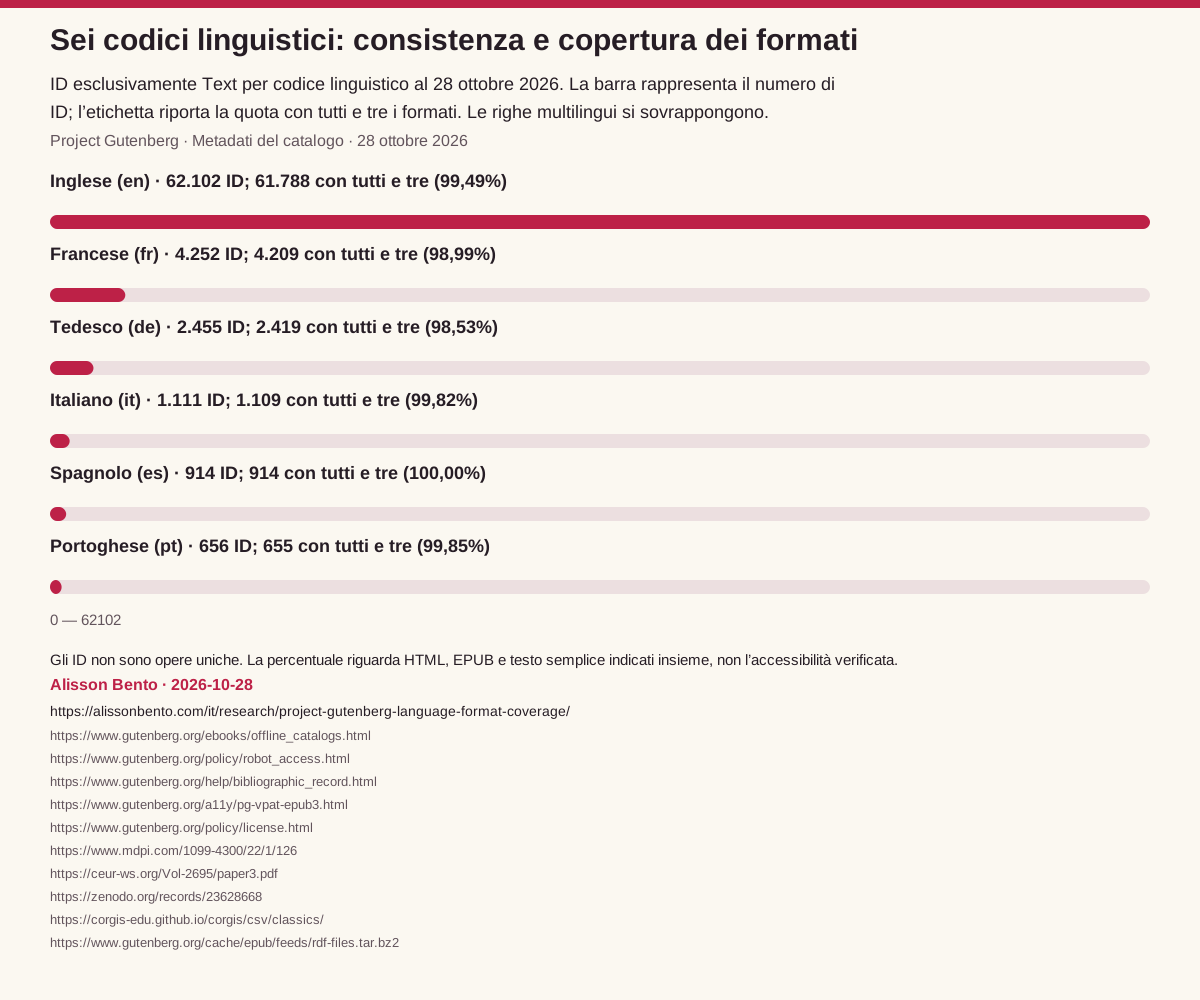
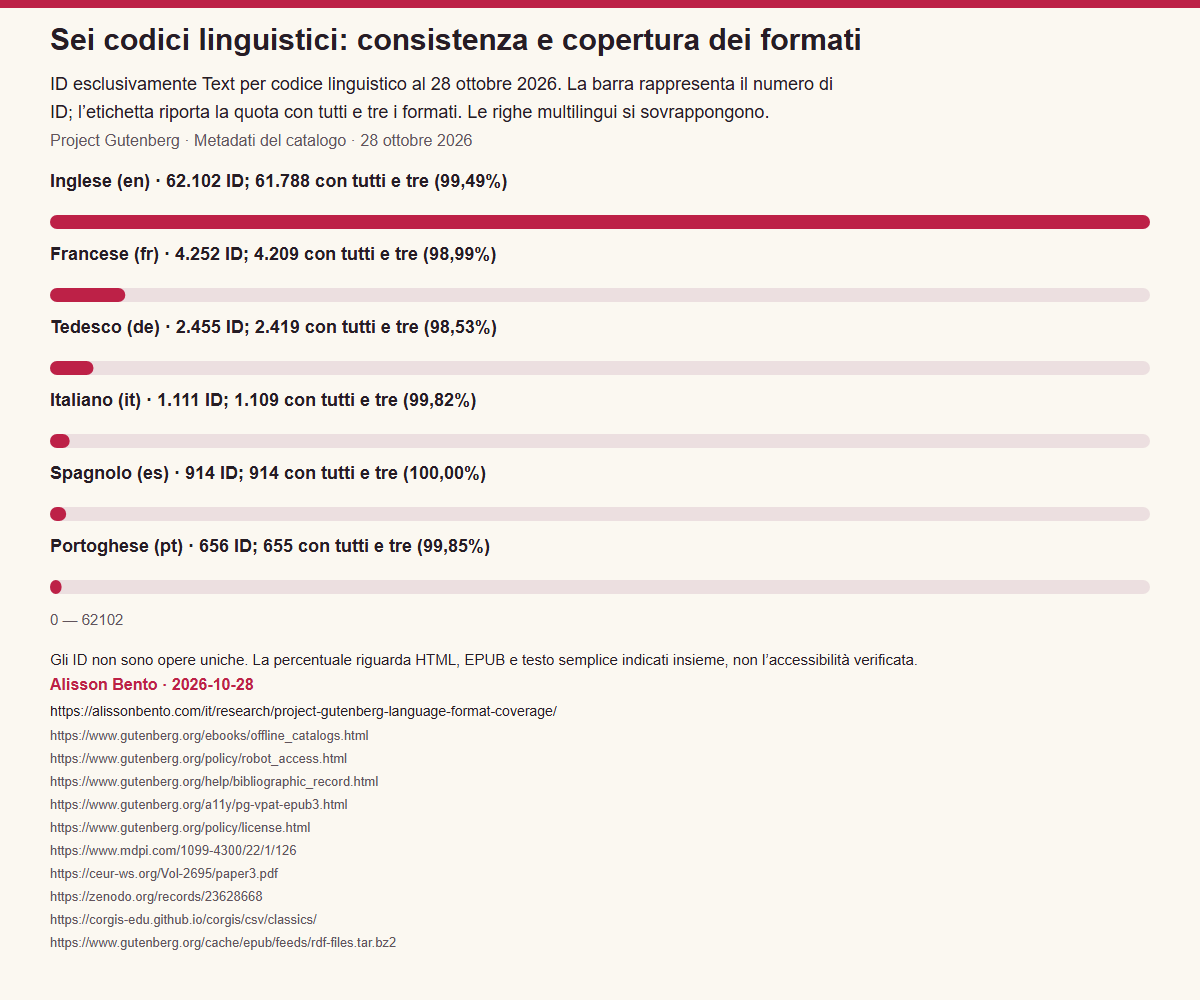
Il confronto nelle sei lingue del sito separa dimensione e copertura: l’inglese conta 62.102 ID, il francese 4.252, il tedesco 2.455, l’italiano 1.111, lo spagnolo 914 e il portoghese 656. Le rispettive quote con tutti e tre i formati sono 99,49%, 98,99%, 98,53%, 99,82%, 100,00% e 99,85%. Una percentuale più alta non significa una raccolta più vasta. La tabella completa conserva tutti i 68 codici, compresi quelli con pochissimi record: con denominatori minuscoli, il cambiamento di una sola scheda può spostare molto la percentuale.
Tre modi concreti per utilizzare questi risultati
Per un lettore, l’uso più semplice è partire dal formato necessario e verificare il singolo risultato. Se l’obiettivo è una lettura in italiano, la riga it offre un quadro iniziale delle opzioni registrate. Non seleziona però l’edizione più adatta, non confronta traduzioni e non controlla note, illustrazioni o completezza. Queste domande riguardano il documento effettivo. Il nostro risultato riduce l’ambiguità del conteggio, senza sostituire la valutazione del contenuto.
Per una biblioteca o un insegnante che prepara una pagina di risorse, una formulazione accurata è «record che indicano EPUB nel catalogo osservato», seguita dalla data e dal collegamento alla fonte. Evita che una lista informativa venga letta come una certificazione. Un percorso didattico può inoltre mostrare la differenza tra il numero di schede in una lingua e la percentuale che indica un formato. Il medesimo esempio italiano permette di discutere numeratore, denominatore e sovrapposizione senza introdurre stime sulla popolazione dei lettori.
Per chi sviluppa un catalogo, i CSV aggregati offrono un riferimento verificabile per controllare i filtri. Occorre conservare gli ID, usare una relazione tra un record e più lingue e trattare ogni formato come una presenza indipendente. Un filtro «HTML oppure EPUB» risponde a una domanda diversa da «HTML ed EPUB e testo semplice». Nel primo caso basta una delle condizioni; nel secondo servono tutte. Questa analisi pubblica misura l’intersezione dei tre formati, quindi non va rinominata come una generica quota di file leggibili.
Nessuno di questi impieghi richiede di presentare il catalogo come rappresentativo del mercato editoriale. Non abbiamo misurato richieste, prestiti, vendite, letture concluse o preferenze linguistiche. Il vantaggio pratico consiste nel sapere esattamente che cosa conta una tabella prima di riutilizzarla. Per un’informazione destinata a essere aggiornata nel tempo, la stessa procedura può essere ripetuta su un nuovo archivio, conservando distintamente la precedente fotografia.
Le schede recenti: una verifica esplorativa da leggere con cautela
Dopo il calcolo principale abbiamo esaminato la data di rilascio registrata da Gutenberg. Fra i 78.059 ID testuali rilasciati prima del 1° settembre 2026, 77.856 indicavano tutti e tre i formati, il 99,74%. Fra i 387 rilasciati dal 1° settembre al 28 ottobre 2026, lo facevano 176, il 45,48%. Inoltre, 211 dei 361 record senza un riferimento EPUB osservato appartenevano al gruppo più recente. Il grafico dedicato espone sia le percentuali sia i denominatori, perché le dimensioni dei gruppi sono molto diverse.
La soglia del 1° settembre è stata scelta durante l’esplorazione, dopo la tabella principale. Non era un’ipotesi preregistrata. Questa verifica serve a riconoscere quanto una fotografia dei metadati possa dipendere dalla recenza delle schede. La documentazione Bibliographic Record di Gutenberg spiega che i record nuovi possono iniziare con informazioni minime ed essere arricchiti dopo il rilascio. È un contesto pertinente, ma non dimostra quale meccanismo abbia prodotto ogni assenza osservata nel nostro archivio.
Non abbiamo verificato che i file mancassero, che i collegamenti fossero interrotti o che esistesse un guasto. Non possiamo neppure trasformare il confronto in una differenza permanente fra lingue o periodi. La data dcterms:issued riguarda il rilascio su Gutenberg, non l’uscita originale a stampa. Chi cita il risultato recente deve riportare la fotografia del 28 ottobre 2026 e la natura esplorativa del controllo; prima di usarlo per descrivere una situazione attuale serve una nuova osservazione.
Una fonte congelata e tre orari distinti
La riproducibilità comincia dal file effettivamente analizzato. L’archivio rdf-files.tar.bz2 fornito da Project Gutenberg misura 126.835.043 byte. Il suo identificatore SHA-256 è c5ee946cea46fb32ffb2d55af670384064ccd818ab59d900c362a63b6bb29a65. Il codice di controllo permette di distinguere questa copia da un successivo archivio distribuito allo stesso indirizzo. Scaricare domani un file con lo stesso nome non garantisce di riprodurre la fotografia qui descritta.
Il server indicava come ultima modifica il 28 ottobre 2026 alle 14:35:54 UTC. Il download si è concluso alle 21:44:48,970368 UTC e l’analisi è stata registrata alle 21:47:05,820155 UTC dello stesso giorno. Questi momenti hanno funzioni diverse: modifica comunicata dalla fonte, acquisizione della copia e calcolo. La data di pubblicazione dell’articolo è un ulteriore dato editoriale. Nessuno di questi orari è la data originaria di pubblicazione delle opere contenute nel catalogo.
Abbiamo utilizzato il percorso ufficiale per il catalogo in blocco, indicato nelle pagine Offline Catalogs and Feeds e Robot Access. L’acquisizione riguarda metadati: non include il testo degli ebook e non deriva da una scansione delle normali pagine di ricerca o delle singole schede. La finestra temporale dello studio è pertanto una sola data di osservazione, 28 ottobre 2026, non un intervallo storico che copra la produzione letteraria rappresentata.
Dal record RDF a una tabella controllabile
Il programma legge l’archivio in sequenza e interpreta ciascun elemento RDF. Sono stati trovati 79.697 file regolari e altrettanti ID distinti, senza errori di parsing o ID ripetuti. La selezione legge l’insieme completo dei valori dcterms:type e include soltanto gli ID per cui tale insieme è esattamente {Text}. Restano esclusi 1.114 Sound, 89 Dataset, 33 Image, 8 MovingImage, 4 Collection e 3 StillImage: in tutto 1.251 record. Non si è verificata una categoria con tipo mancante.
Per ogni ID incluso, il programma legge i codici linguistici distinti e i riferimenti dcterms:hasFormat/pgterms:file. Le etichette MIME vengono ricondotte al tipo di base eliminando i parametri per il confronto generale. HTML comprende text/html e application/xhtml+xml; EPUB richiede application/epub+zip; testo semplice richiede text/plain; PDF richiede application/pdf. Il controllo UTF-8 è separato e cerca il parametro charset=utf-8 con normalizzazione di maiuscole, minuscole e spazi. Copertine, contenitori ZIP e file RDF non sostituiscono un formato di lettura.
Ogni presenza viene contata al massimo una volta per ID. La quota linguistica divide il numero pertinente per gli ID inclusi che portano quel codice. Nel sottoinsieme testuale non sono stati rilevati URL di file ripetuti né file elencati senza un valore MIME. Sono controlli sulla struttura dei metadati, non una prova delle risorse collegate. I totali esportati sono stati riconciliati con i risultati JSON, inclusi i 68 denominatori linguistici e la divisione nei due gruppi di recenza.
Abbiamo mantenuto gli ID anziché tentare di ricostruire opere uniche. Un confronto esatto basato su titolo normalizzato, autore e lingua ha individuato 400 gruppi candidati, con 902 record complessivi. Non sono duplicati confermati: anche etichette con titolo mancante possono coincidere. Non sono stati quindi eliminati dal denominatore. Un record Text con titolo vuoto e 130 senza nessuna delle tre categorie MIME principali sono rimasti inclusi secondo la regola dichiarata, evitando una selezione retroattiva dei soli record più completi.
Che cosa aggiunge lo studio rispetto ai lavori precedenti
Project Gutenberg è già una fonte di ricerca. Il lavoro di Gerlach e Font-Clos del 2020, A Standardized Project Gutenberg Corpus for Statistical Analysis of Natural Language and Quantitative Linguistics, descrive un corpus standardizzato e le sue caratteristiche linguistiche. Nello stesso anno Egloff, Adamou e Picca, in Enabling Ontology-Based Data Access to Project Gutenberg, hanno esaminato la struttura RDF e i metadati di lingue e formati. La presenza di questi campi non è una scoperta di questa analisi.
Anche il dataset didattico Classics del progetto CORGIS espone informazioni sui formati. Gutenberg Atlas di Timm, nella versione 1.0.0 pubblicata il 24 ottobre 2026, riguarda metadati di autori e anni di pubblicazione per libri in lingua inglese. Il contributo qui è più circoscritto: rendere consultabile una nuova fotografia, esplicitare il filtro per tipo, distinguere gli ID dalle appartenenze linguistiche e fornire una matrice riproducibile dei formati con un controllo esplorativo sulla recenza.
Questa collocazione conta anche per chi riutilizza i risultati. Una nuova data di estrazione non rende automaticamente nuova ogni domanda scientifica. Il valore del lavoro sta nella trasparenza della procedura e nell’utilità della presentazione per una decisione concreta. Si può controllare quale archivio sia stato usato, quale denominatore sostenga ogni percentuale e quali inferenze restino fuori dalla portata dei dati. Non rivendichiamo una prima analisi assoluta di Gutenberg.
Riutilizzare dati e grafici senza perdere il significato
I file scaricabili includono le tabelle aggregate per formato, per tutti i codici linguistici e per le sei lingue del sito, oltre al riepilogo dei tipi esclusi e ai controlli per periodo di rilascio. I risultati JSON mantengono le percentuali a quattro decimali; il testo e le tabelle di lettura le arrotondano a due. I numeratori interi permettono di ricalcolare le quote e di evitare conclusioni basate soltanto su arrotondamenti visivamente uguali.
Il codice di analisi e quello per costruire i materiali derivati accompagnano un documento metodologico e un manifesto della fonte. Per riprodurre il lavoro occorre la copia dell’archivio con l’impronta indicata, non soltanto un download corrente dal medesimo indirizzo. Conviene lavorare in una cartella separata perché gli script scrivono i risultati accanto ai propri file. La disponibilità del codice rende verificabile la procedura; non elimina automaticamente possibili errori dei metadati di partenza.
Per citare o adattare un grafico, conservare il credito a Project Gutenberg per i metadati e ad Alisson Bento per l’elaborazione originale, il collegamento allo studio e la data della fotografia. Se si modifica la selezione o si aggiorna l’archivio, indicare la modifica. La concessione al pubblico dominio riguarda i dati del catalogo; l’attribuzione per il riuso delle elaborazioni originali è distinta. Nessuna di queste condizioni concede diritti sui testi degli ebook o implica un’affiliazione con Project Gutenberg.
Un risultato pronto da citare, con il suo limite
Nella fotografia del catalogo RDF di Project Gutenberg del 28 ottobre 2026, 78.032 dei 78.446 ID classificati esclusivamente come Text, pari al 99,47%, indicavano insieme HTML, EPUB e testo semplice. Il risultato misura riferimenti MIME nei metadati: non verifica apertura, completezza, accessibilità o diritti dei file. Le indicazioni possono cambiare, soprattutto per le schede recenti. Fonte dei metadati: Project Gutenberg; elaborazione originale: Alisson Bento.
Per l’italiano, nella stessa fotografia, 1.109 dei 1.111 ID con codice it indicavano tutti e tre i formati, il 99,82%. Il codice identifica un’appartenenza linguistica registrata, non necessariamente un documento interamente in italiano. Gli ID multilingui possono comparire in più righe e le schede non equivalgono a opere uniche. Anche questo risultato è datato e descrive indicazioni del catalogo soggette ad aggiornamento, senza certificare i file.
Formati di lettura indicati nel catalogo
Quota dei 78.446 ID esclusivamente Text che indicano ciascun formato, fotografia del 28 ottobre 2026. Le categorie si sovrappongono.
Grafico completo e fonte

Scorri il grafico in orizzontale per esaminarlo. ↔
Grafico e valori
Sei codici linguistici: consistenza e copertura dei formati
ID esclusivamente Text per codice linguistico al 28 ottobre 2026. La barra rappresenta il numero di ID; l’etichetta riporta la quota con tutti e tre i formati. Le righe multilingui si sovrappongono.
Grafico completo e fonte
Scorri il grafico in orizzontale per esaminarlo. ↔
Grafico e valori
Controllo esplorativo sulla recenza del rilascio
Quota con tutti e tre i riferimenti MIME per periodo di rilascio su Gutenberg, al 28 ottobre 2026. Non è la data originale di pubblicazione a stampa.
Grafico completo e fonte

Scorri il grafico in orizzontale per esaminarlo. ↔
Grafico e valori

Dati e download
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Formato indicato | Record | Quota (%) |
|---|---|---|
| HTML o XHTML | 78.300 | 99,81 |
| EPUB | 78.085 | 99,54 |
| Testo semplice | 78.263 | 99,77 |
| Testo semplice con UTF-8 esplicito | 78.154 | 99,63 |
| 1.285 | 1,64 | |
| HTML, EPUB e testo semplice insieme | 78.032 | 99,47 |
Fotografia del 28 ottobre 2026. Il denominatore di ogni riga è 78.446 ID esclusivamente Text. Le righe si sovrappongono e non devono essere sommate.
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Codice linguistico | ID esclusivamente Text | HTML indicato | EPUB indicato | Testo semplice indicato | Tutti e tre indicati | Tutti e tre (%) | PDF indicato |
|---|---|---|---|---|---|---|---|
| en | 62.102 | 62.000 | 61.835 | 61.960 | 61.788 | 99,49 | 1.102 |
| fr | 4.252 | 4.234 | 4.213 | 4.230 | 4.209 | 98,99 | 36 |
| fi | 3.689 | 3.680 | 3.680 | 3.689 | 3.680 | 99,76 | 0 |
| de | 2.455 | 2.436 | 2.420 | 2.435 | 2.419 | 98,53 | 68 |
| nl | 1.120 | 1.120 | 1.114 | 1.120 | 1.114 | 99,46 | 1 |
| it | 1.111 | 1.111 | 1.109 | 1.111 | 1.109 | 99,82 | 58 |
| es | 914 | 914 | 914 | 914 | 914 | 100,00 | 9 |
| pt | 656 | 656 | 655 | 656 | 655 | 99,85 | 1 |
| hu | 655 | 655 | 655 | 655 | 655 | 100,00 | 1 |
| zh | 443 | 443 | 443 | 442 | 442 | 99,77 | 3 |
| sv | 257 | 257 | 257 | 257 | 257 | 100,00 | 0 |
| el | 221 | 221 | 221 | 221 | 221 | 100,00 | 6 |
| eo | 145 | 145 | 145 | 145 | 145 | 100,00 | 3 |
| la | 144 | 144 | 144 | 144 | 144 | 100,00 | 2 |
| ca | 97 | 97 | 95 | 97 | 95 | 97,94 | 0 |
| da | 85 | 85 | 85 | 85 | 85 | 100,00 | 0 |
| tl | 60 | 60 | 60 | 60 | 60 | 100,00 | 0 |
| pl | 31 | 31 | 31 | 31 | 31 | 100,00 | 2 |
| no | 23 | 23 | 23 | 23 | 23 | 100,00 | 0 |
| fy | 22 | 22 | 22 | 22 | 22 | 100,00 | 0 |
| ja | 21 | 21 | 21 | 21 | 21 | 100,00 | 0 |
| af | 17 | 17 | 17 | 17 | 17 | 100,00 | 0 |
| cy | 15 | 15 | 15 | 15 | 15 | 100,00 | 0 |
| cs | 12 | 12 | 12 | 12 | 12 | 100,00 | 1 |
| fur | 7 | 7 | 7 | 7 | 7 | 100,00 | 0 |
| ga | 7 | 7 | 5 | 7 | 5 | 71,43 | 0 |
| is | 7 | 7 | 7 | 7 | 7 | 100,00 | 0 |
| bg | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| enm | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| he | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| te | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| ro | 5 | 5 | 5 | 5 | 5 | 100,00 | 0 |
| ru | 5 | 5 | 5 | 5 | 5 | 100,00 | 1 |
| sl | 5 | 5 | 5 | 5 | 5 | 100,00 | 0 |
| ang | 4 | 4 | 4 | 4 | 4 | 100,00 | 0 |
| gla | 4 | 4 | 4 | 4 | 4 | 100,00 | 1 |
| sr | 4 | 4 | 4 | 3 | 3 | 75,00 | 0 |
| ceb | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| gl | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| grc | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| ilo | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| myn | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| nah | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| nai | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| nav | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| arp | 2 | 2 | 2 | 2 | 2 | 100,00 | 0 |
| brx | 2 | 2 | 2 | 2 | 2 | 100,00 | 0 |
| mi | 2 | 2 | 2 | 2 | 2 | 100,00 | 1 |
| oc | 2 | 2 | 2 | 2 | 2 | 100,00 | 0 |
| ale | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| ar | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| bgs | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| bo | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| br | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| csb | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| et | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| fa | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| hai | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| ia | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| iu | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| kha | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| kld | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| ko | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| nap | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| oji | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| rmq | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| sa | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| sco | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
Fotografia del 28 ottobre 2026. Ogni denominatore comprende gli ID esclusivamente Text con quel codice linguistico. Gli ID multilingui compaiono in più righe: non sommare le righe. I file non sono stati provati.
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Codice linguistico | ID esclusivamente Text | Tutti e tre indicati | Tutti e tre (%) |
|---|---|---|---|
| en | 62.102 | 61.788 | 99,49 |
| pt | 656 | 655 | 99,85 |
| es | 914 | 914 | 100,00 |
| fr | 4.252 | 4.209 | 98,99 |
| it | 1.111 | 1.109 | 99,82 |
| de | 2.455 | 2.419 | 98,53 |
Appartenenze linguistiche sovrapposte; le quote con tutti e tre i formati usano il denominatore del rispettivo codice. Fotografia del 28 ottobre 2026.
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Periodo di rilascio | ID esclusivamente Text | Tutti e tre indicati | Tutti e tre (%) |
|---|---|---|---|
| Prima del 1° settembre 2026 | 78.059 | 77.856 | 99,74 |
| Dal 1° settembre al 28 ottobre 2026 | 387 | 176 | 45,48 |
Data di rilascio su Gutenberg, non anno originale di pubblicazione a stampa. Soglia scelta dopo l’analisi principale. Il risultato descrive i metadati in una sola data, non una causa o condizione permanente.
Dati e metodo
Come abbiamo calcolato
- Unità di analisi: ID distinto del catalogo Project Gutenberg con insieme completo dei tipi esattamente {Text}. L’archivio contiene 79.697 ID; 78.446 soddisfano la regola e 1.251 restano esclusi. Volumi, edizioni e versioni mantengono i rispettivi ID.
- Fonte congelata al 28 ottobre 2026: archivio RDF ufficiale, SHA-256 c5ee946cea46fb32ffb2d55af670384064ccd818ab59d900c362a63b6bb29a65. Ultima modifica HTTP 14:35:54 UTC; acquisizione 21:44:48,970368 UTC; analisi 21:47:05,820155 UTC. Gli orari non indicano la pubblicazione originale delle opere.
- Presenza del formato ricavata soltanto dai tipi MIME elencati; un massimo di un conteggio per formato e ID. HTML include XHTML. Tutti e tre significa intersezione di HTML, EPUB e testo semplice. L’indicatore UTF-8 richiede un parametro esplicito normalizzato.
- Denominatore linguistico: ID testuali che riportano il codice considerato. Le 78.670 appartenenze derivano da 78.446 ID, inclusi 218 multilingui. Nessun ID testuale è privo di codice linguistico. I risultati percentuali sono arrotondati a due decimali nella pagina e a quattro nei dati.
- L’analisi descrive tutti i record dell’archivio fornito secondo la regola dichiarata; non è un campione probabilistico della letteratura. Non sono quindi calcolati intervalli di confidenza da campionamento. La verifica per rilascio precedente o successivo al 1° settembre 2026 è esplorativa e successiva al calcolo principale.
Cosa non possiamo dedurre dai dati
- I record non equivalgono a opere uniche, romanzi o edizioni nazionali. Il catalogo può includere più volumi o versioni; il confronto di titoli, autori e lingue non è stato usato per deduplicare opere.
- I file collegati non sono stati aperti per verificarne funzionamento, completezza, fedeltà dell’edizione, sicurezza o accessibilità. Un tipo MIME presente e un risultato del 100% non certificano queste proprietà.
- L’assenza di un riferimento MIME osservato non dimostra l’assenza del file. La documentazione di Gutenberg descrive l’arricchimento progressivo delle schede; questa fotografia non stabilisce cause né condizioni permanenti.
- I codici linguistici possono sovrapporsi e non determinano nazionalità dell’autore, paese di pubblicazione, direzione della traduzione o lingua principale di ogni passaggio. I piccoli denominatori richiedono particolare cautela.
- Un solo catalogo selezionato non rappresenta tutti i libri di pubblico dominio, gli ebook gratuiti, il mercato editoriale mondiale o la domanda dei lettori. Restano possibili errori di metadati e distorsioni di selezione.
- I diritti dei metadati sono distinti da quelli degli ebook. Gutenberg comprende anche opere protette distribuite con autorizzazione e invita chi si trova fuori dagli Stati Uniti a verificare i diritti applicabili. Questa analisi non costituisce una valutazione legale dei singoli testi.
Fonti originali
- Project Gutenberg: Offline Catalogs and Feeds
Documentazione ufficiale del catalogo RDF in blocco; fotografia congelata del 28 ottobre 2026.
Consultato il 28 ottobre 2026
- Project Gutenberg: Robot Access
Concessione al pubblico dominio dei metadati del catalogo e percorso di acquisizione consentito. Non disciplina i diritti sui testi degli ebook.
Consultato il 28 ottobre 2026
- Project Gutenberg: Bibliographic Record
Descrizione dei campi bibliografici, delle date di rilascio e dell’arricchimento progressivo dei metadati e dei formati generati.
Consultato il 28 ottobre 2026
- Project Gutenberg: EPUB3 Accessibility Conformance Report
Ambito della valutazione di accessibilità. Un riferimento MIME presente non equivale a una verifica di accessibilità.
Consultato il 28 ottobre 2026
- Project Gutenberg: License
Indicazioni sui diritti degli ebook e sul marchio. Il permesso per i metadati non stabilisce diritti mondiali sui testi.
Consultato il 28 ottobre 2026
- Gerlach and Font-Clos (2020): A Standardized Project Gutenberg Corpus
Precedente caratterizzazione del corpus Gutenberg e delle sue lingue; DOI 10.3390/e22010126.
Consultato il 28 ottobre 2026
- Egloff, Adamou and Picca (2020): Enabling Ontology-Based Data Access to Project Gutenberg
Precedente analisi dei dati RDF di Gutenberg, inclusi i metadati linguistici e dei formati.
Consultato il 28 ottobre 2026
- Timm (2026): Gutenberg Atlas
Metadati di autori e anni di pubblicazione per libri in inglese; versione 1.0.0, pubblicata il 24 ottobre 2026; DOI 10.5281/zenodo.23628668.
Consultato il 28 ottobre 2026
- CORGIS Datasets Project: Classics
Dataset didattico precedente che include campi relativi ai formati del catalogo. Non rivendichiamo la prima analisi di questi dati.
Consultato il 28 ottobre 2026
- Project Gutenberg bulk RDF catalogue
Archivio sorgente SHA-256 c5ee946cea46fb32ffb2d55af670384064ccd818ab59d900c362a63b6bb29a65. Ultima modifica: 28 ottobre 2026, 14:35:54 UTC; acquisizione: 21:44:48 UTC.
Consultato il 28 ottobre 2026
Citare e riutilizzare lo studio
Alisson Bento. Project Gutenberg: lingue e formati di lettura nel catalogo del 28 ottobre 2026. Metadati: Project Gutenberg; elaborazione originale di Alisson Bento. Fotografia del catalogo: 28 ottobre 2026. https://alissonbento.com/it/research/project-gutenberg-language-format-coverage/ https://alissonbento.com/it/research/project-gutenberg-language-format-coverage/
I metadati del catalogo sono concessi al pubblico dominio da Project Gutenberg; il campione RDF congelato indica CC0. Per riutilizzare l’analisi, il testo, i grafici e il codice originali, citare Alisson Bento, collegare lo studio, mantenere la data della fotografia del 28 ottobre 2026 e indicare eventuali modifiche. Queste condizioni non concedono diritti sui testi degli ebook. Non è implicata alcuna affiliazione o approvazione da parte di Project Gutenberg.
Correzioni o domande editoriali