Qué puede decirnos el catálogo antes de elegir un libro
Buscar una lectura digital implica varias decisiones. Quizá se quiera abrir el texto en un navegador, llevarlo a una aplicación de lectura o trabajar con una versión de texto plano. El número total de registros de una biblioteca digital no responde por sí solo a esas preguntas. Para orientarse también hace falta saber qué formatos declara cada entrada y qué idioma tiene registrado. Esta investigación separa esas dos dimensiones y muestra los recuentos que permiten comprobarlas.
El punto de partida es Project Gutenberg, una iniciativa sin fines de lucro, no un organismo gubernamental. Se utilizó su catálogo público de metadatos RDF, suministrado para descarga masiva. La pregunta es concreta: entre los identificadores cuyo conjunto de tipos es exactamente Text, ¿con qué frecuencia aparecen referencias a HTML, EPUB y texto plano? Después se repite el cálculo para cada etiqueta de idioma. El resultado describe este archivo conservado y esta regla de inclusión.
Un registro funciona aquí como una ficha identificada dentro del catálogo. Puede corresponder a una edición, un volumen u otro elemento textual; no equivale necesariamente a una obra literaria única. Por eso las cifras sirven para preparar una búsqueda o un catálogo derivado, pero no para anunciar cuántas novelas diferentes existen, cuántas personas las leen o qué parte de la literatura mundial representa Gutenberg. Tampoco permiten deducir el tamaño de la oferta actual de un género como la novela romántica.
Tres formatos muy extendidos y un PDF mucho menos frecuente
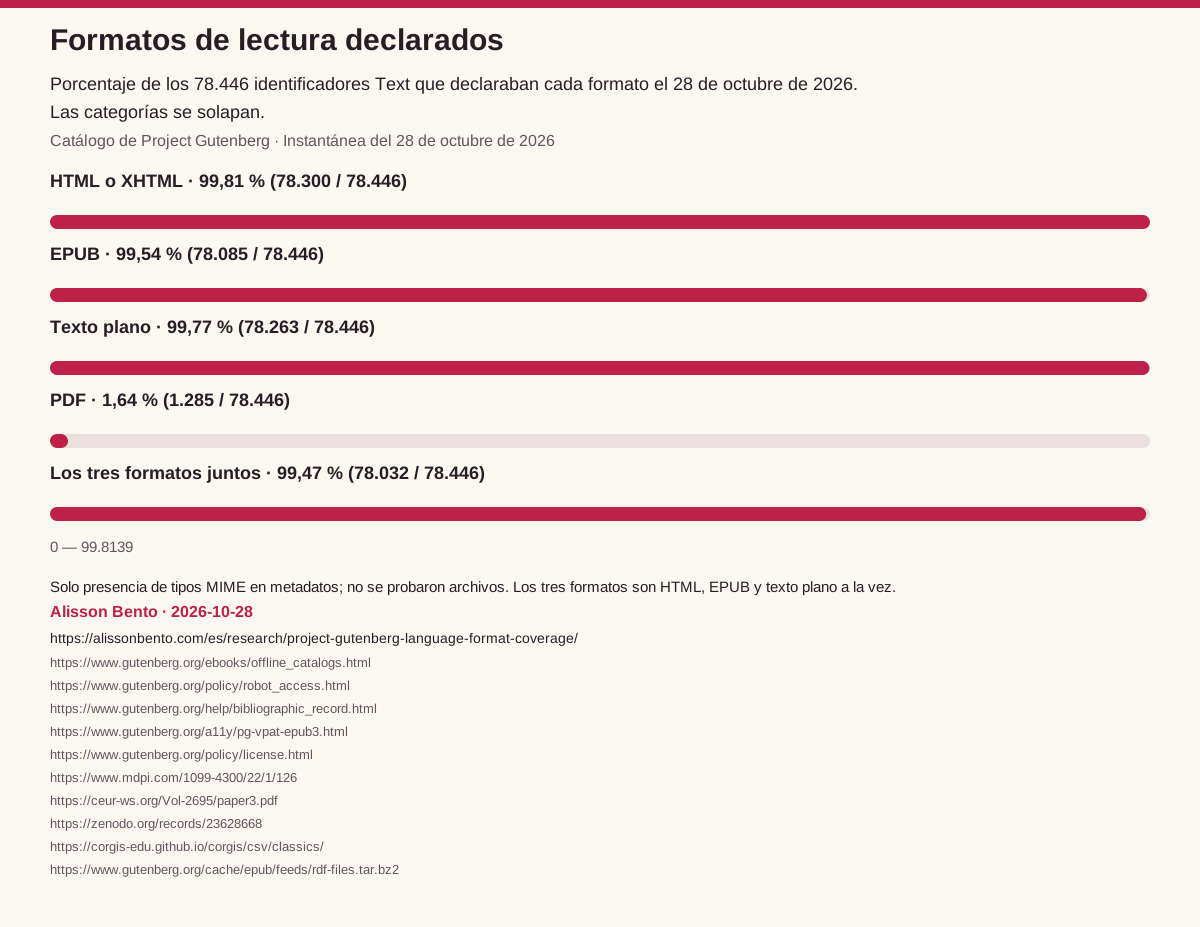
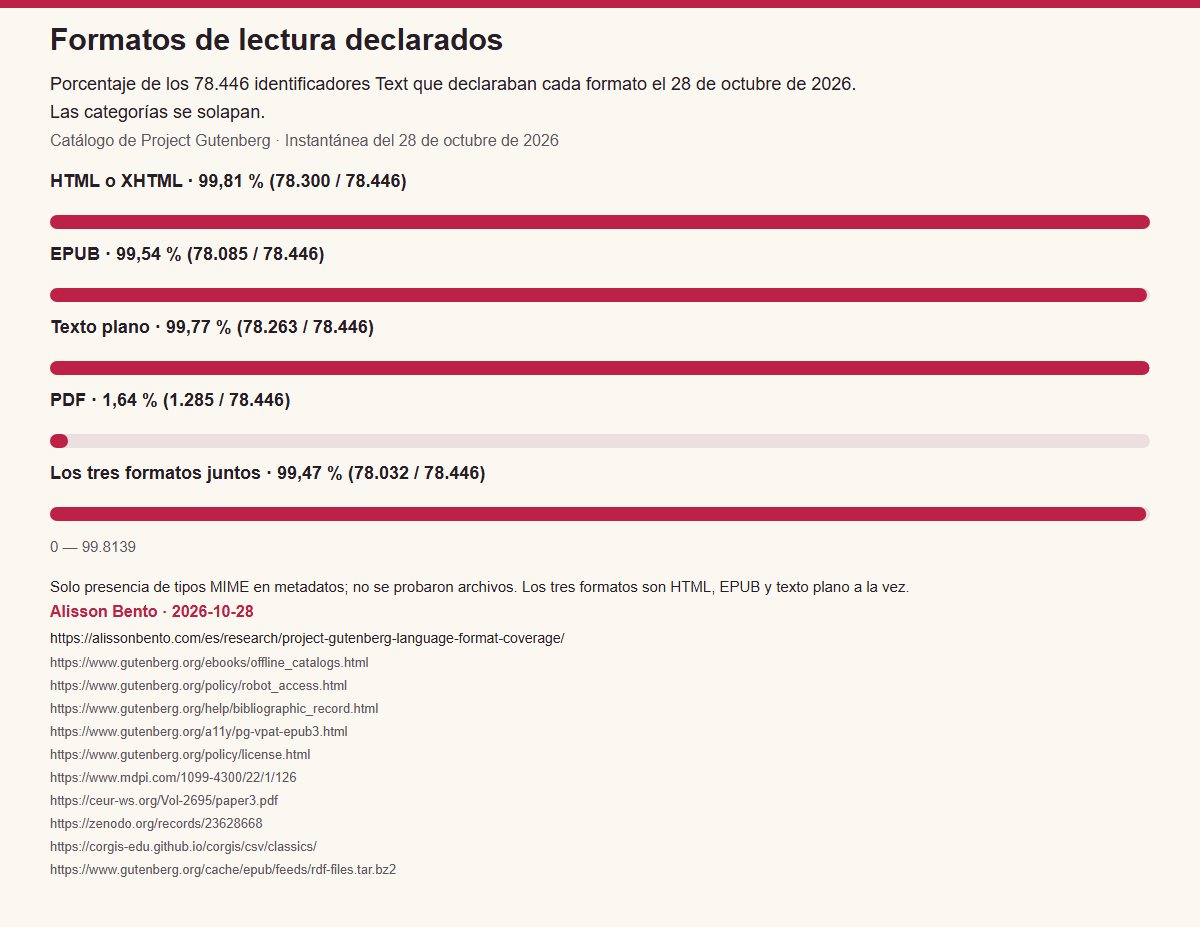
La tabla de formatos usa siempre el mismo denominador: 78.446 identificadores Text. HTML o XHTML aparecía en 78.300 registros, EPUB en 78.085 y texto plano en 78.263. Sus proporciones eran, respectivamente, 99,81 %, 99,54 % y 99,77 %. La coincidencia de los tres formatos alcanzaba 78.032 registros, el 99,47 %. Esta última medida exige que estén presentes las tres categorías en una misma ficha; no resulta de sumar sus porcentajes.
Las categorías se solapan. Una sola entrada puede contar en HTML, EPUB, texto plano y PDF a la vez, e incluso puede declarar varios archivos de un mismo formato. En el cálculo cada indicador se cuenta una sola vez por identificador. Leer las barras como partes de un total que debe sumar cien produciría una interpretación equivocada. El gráfico compara la frecuencia de cada opción declarada, no la distribución exclusiva de los registros entre opciones.
PDF figuraba en 1.285 entradas, el 1,64 %. La diferencia ayuda a precisar la consulta del lector: exigir una referencia PDF ya presente es una condición distinta de aceptar HTML o EPUB. No se intentó generar archivos PDF, imprimir páginas ni convertir otros formatos. En consecuencia, el recuento no mide todos los documentos que podrían obtenerse mediante una conversión; mide únicamente las referencias PDF que estaban declaradas en el catálogo observado.
El texto plano con una etiqueta explícita UTF-8 se presenta por separado: 78.154 registros, el 99,63 %. Es un subconjunto definido por el parámetro de codificación registrado, no una inspección de los caracteres del archivo. La ausencia de ese parámetro no demuestra que el texto sea ilegible o que use una codificación incorrecta. Para una tarea que dependa de los caracteres, el recuento orienta la selección inicial, pero la comprobación del archivo sigue siendo un paso diferente.
Cómo leer las 68 filas de idiomas sin contar dos veces
El subconjunto Text contenía 68 etiquetas de idioma distintas y ningún registro sin etiqueta. Había 218 identificadores multilingües. Al asignar una pertenencia por idioma e identificador se obtuvieron 78.670 pertenencias, una cifra superior a los 78.446 registros incluidos. No es una discrepancia: una ficha que declare dos idiomas aparece en ambas filas. Sumar las filas como si fueran conjuntos separados de libros duplicaría parte del catálogo.
La tabla completa conserva los códigos registrados y muestra, para cada uno, el número de entradas y las referencias de formato. El denominador del porcentaje de los tres formatos es el total de identificadores que llevan esa etiqueta. No se divide entre el catálogo completo ni entre el conjunto de pertenencias. Así puede distinguirse el tamaño de un grupo de la cobertura de formatos dentro de ese grupo.
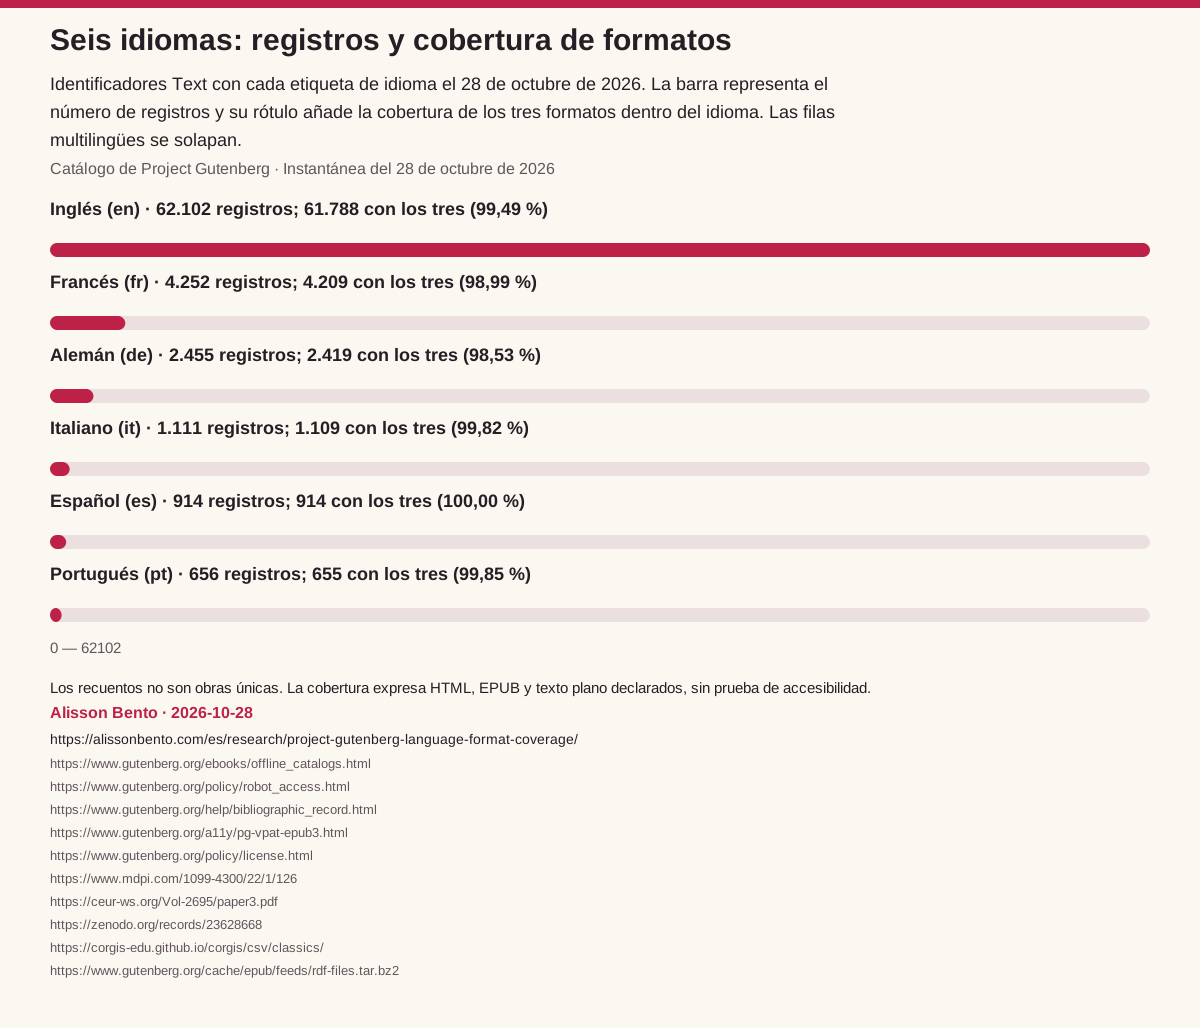
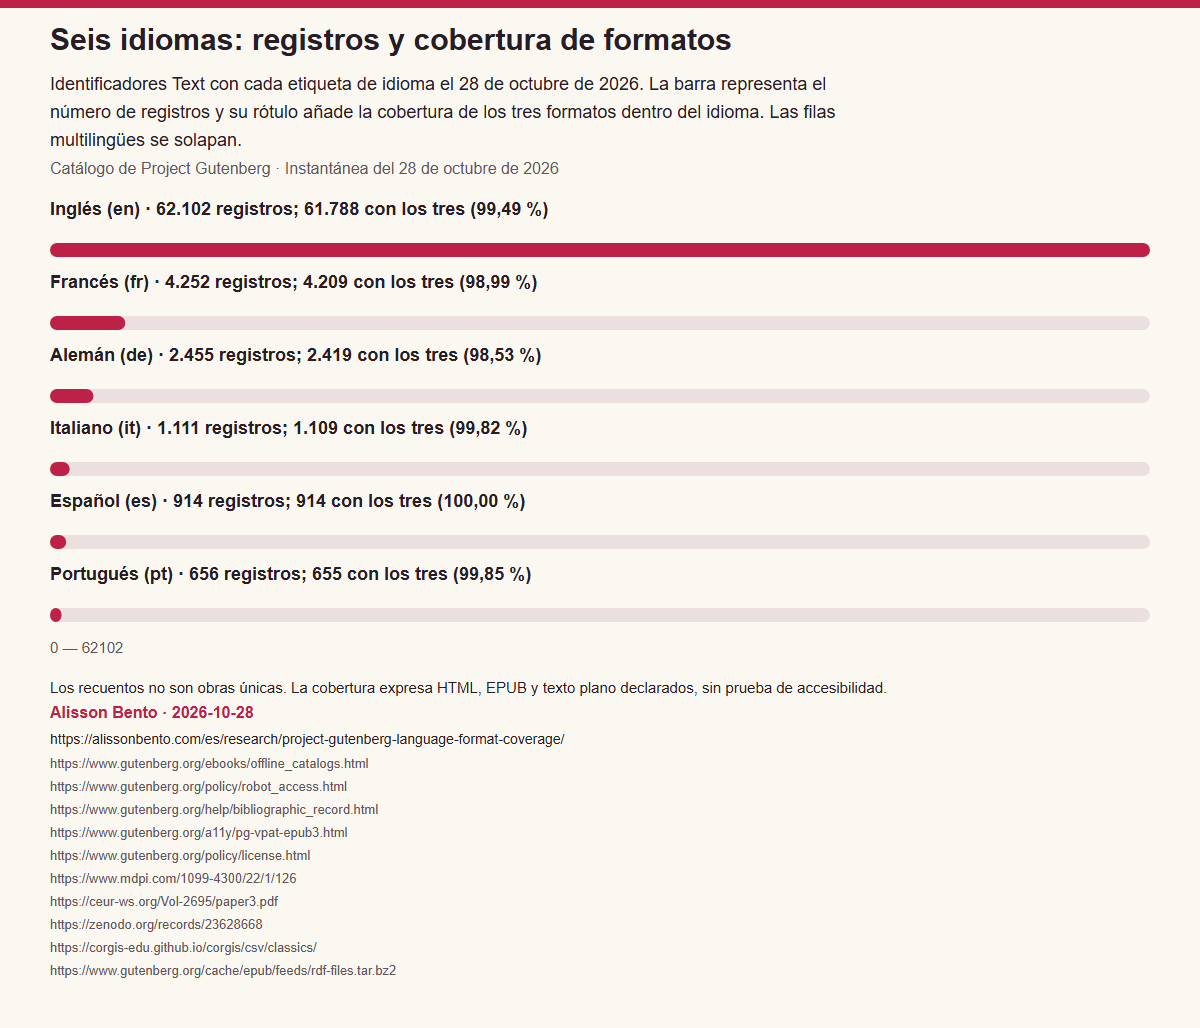
En las seis lenguas de esta publicación, la etiqueta en reunía 62.102 registros, frente a 4.252 con fr, 2.455 con de, 1.111 con it, 914 con es y 656 con pt. La proporción con los tres formatos era del 99,49 %, 98,99 %, 98,53 %, 99,82 %, 100,00 % y 99,85 %, respectivamente. El gráfico mantiene separados el recuento representado por la barra y el porcentaje indicado junto a ella. Una proporción similar puede corresponder a cantidades muy distintas.
Los 914 registros etiquetados es declaraban los tres formatos. Ese 100,00 % describe exactamente esas fichas en esa fecha, sin garantizar que cada archivo funcionara o cumpliera criterios de accesibilidad. Las etiquetas tampoco identifican países, nacionalidades de autores ni lenguas principales de todas las páginas. En grupos pequeños, una sola ficha cambia mucho el porcentaje: conviene leer siempre el numerador y el denominador antes de convertir una diferencia en una clasificación de calidad.
Por qué la fecha de la instantánea importa
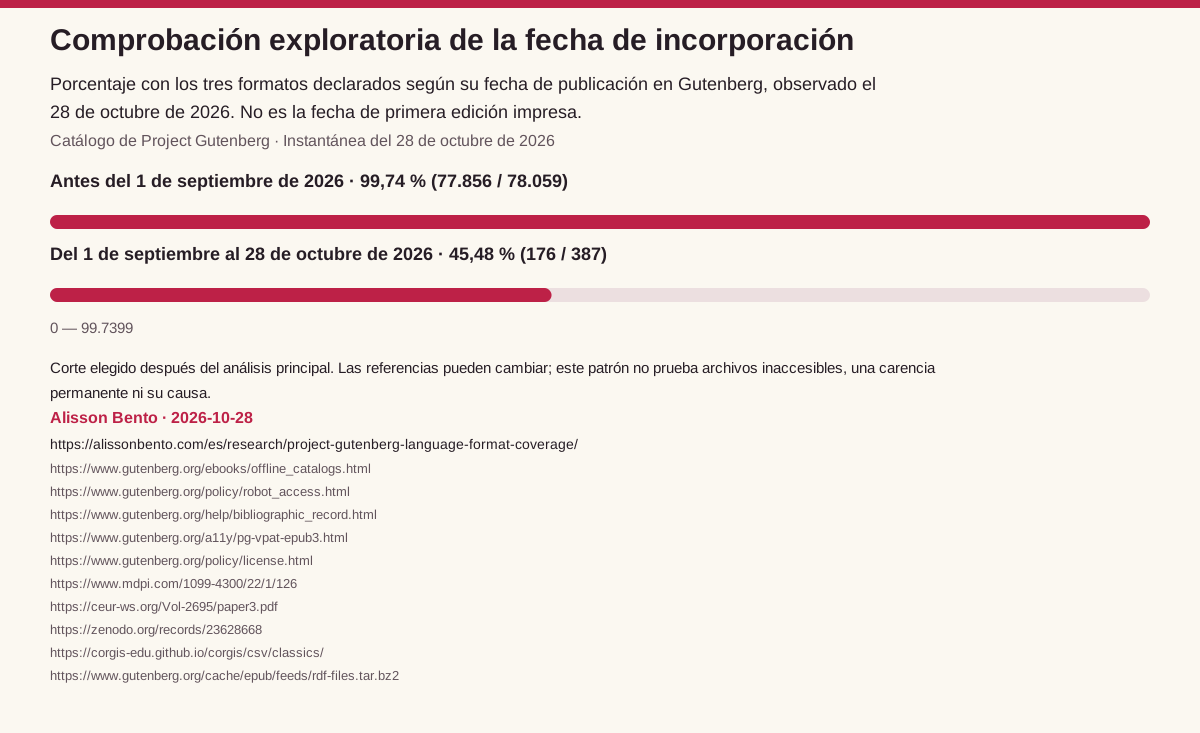
Tras elaborar la tabla principal, se examinó de manera exploratoria la fecha de incorporación a Gutenberg. Entre los 78.059 registros Text con fecha anterior al 1 de septiembre de 2026, 77.856 declaraban los tres formatos, el 99,74 %. En los 387 incorporados entre el 1 de septiembre y el 28 de octubre, eran 176, el 45,48 %. Los registros recientes concentraban 211 de las 361 entradas sin una referencia MIME EPUB observada.
La diferencia es una señal para interpretar y actualizar los metadatos, no una prueba de libros ausentes o enlaces rotos. La documentación Bibliographic Record de Gutenberg explica que los registros nuevos comienzan con información mínima y se enriquecen después. También pueden cambiar los formatos generados. Esa documentación ofrece contexto para una posible variación temporal, pero el análisis no demuestra qué mecanismo produjo cada caso ni cuánto tardaría en cambiar.
El corte del 1 de septiembre se eligió después del cálculo principal, durante la exploración. No era una hipótesis preregistrada y no debe presentarse como una prueba causal. Además, dcterms:issued describe la fecha de publicación en Gutenberg, no la primera edición impresa de la obra. Si se utiliza este resultado en una noticia, una presentación o una comparación posterior, hay que mantener su fecha y advertir que las referencias son transitorias. Una nueva descarga sería otra observación y debería conservarse por separado.
Tres formas de utilizar estos resultados
Para un lector, la utilidad es acotar la búsqueda. Primero puede localizar una ficha en el idioma deseado y después revisar sus opciones de lectura actuales. La abundancia de referencias HTML y EPUB en esta instantánea ayuda a formular esa búsqueda; la menor frecuencia de PDF permite anticipar que ese requisito reducirá el conjunto observado. La tabla no sustituye abrir la ficha concreta y verificar que la edición y el formato responden a la necesidad personal.
Para una biblioteca o una persona que prepara materiales docentes, los datos ofrecen una base reproducible para explicar el catálogo. Es posible citar el total Text, usar la fila de un idioma y acompañar la cifra con su denominador. Si se prepara una selección para un grupo, corresponde revisar por separado las ediciones elegidas, su contenido y sus condiciones de uso. Este estudio no evaluó fidelidad editorial, integridad de los textos, adecuación pedagógica ni funcionamiento con lectores de pantalla.
Para quien desarrolla un buscador o una página de consulta, el modelo ayuda a evitar etiquetas engañosas. Un filtro puede indicar que EPUB consta en los metadatos y conservar la fecha de actualización, en lugar de afirmar que se ha comprobado la descarga. Conviene mantener el identificador original, permitir varios idiomas por ficha y conservar los formatos como indicadores independientes. Esas decisiones hacen que la interfaz refleje la unidad realmente contada y facilitan comparar futuras instantáneas sin reescribir silenciosamente la anterior.
De dónde salen las cifras y cómo conservar su trazabilidad
La fuente es el archivo rdf-files.tar.bz2 enlazado por Offline Catalogs and Feeds. Su cabecera HTTP Last-Modified indicaba el 28 de octubre de 2026 a las 14:35:54 UTC. La descarga terminó ese día a las 21:44:48,970368 UTC y el análisis quedó fechado a las 21:47:05,820155 UTC. Son momentos distintos: actualización declarada por el servidor, obtención de la copia y ejecución del análisis. Ninguno debe confundirse con una fecha de primera publicación literaria.
El archivo conservado tenía 126.835.043 bytes. Su huella SHA-256 permite comprobar que una reproducción usa exactamente la misma entrada: c5ee946cea46fb32ffb2d55af670384064ccd818ab59d900c362a63b6bb29a65. El proceso recorrió el archivo comprimido sin extraer sus rutas al disco y encontró 79.697 archivos regulares con 79.697 identificadores distintos. No se registraron errores de lectura RDF ni identificadores repetidos. Esas comprobaciones verifican la coherencia del procesamiento, no la exactitud de cada dato bibliográfico.
Las descargas públicas reúnen resultados agregados, el desglose de tipos excluidos, las tablas por idioma y período, el método, el manifiesto de la fuente y el código. Los archivos CSV y JSON conservan más precisión que los porcentajes redondeados de la página. Para reproducir el trabajo debe obtenerse la fuente correspondiente y comprobar su huella; el archivo masivo congelado no forma parte de estas descargas derivadas. El código debe ejecutarse en una carpeta de trabajo separada, pues escribe allí los resultados.
Qué aporta este análisis respecto de trabajos anteriores
El estudio de Gutenberg tiene antecedentes que deben acompañar cualquier reutilización de estas cifras. Gerlach y Font-Clos publicaron en 2020 A Standardized Project Gutenberg Corpus for Statistical Analysis of Natural Language and Quantitative Linguistics, que caracteriza textos e idiomas del corpus. Egloff, Adamou y Picca estudiaron también en 2020 el acceso basado en ontologías a los datos de Gutenberg, incluida su estructura RDF y los campos de formato e idioma. CORGIS ofrece además un conjunto docente Classics con información sobre formatos.
Gutenberg Atlas, de Timm, publicado el 24 de octubre de 2026, aborda metadatos de años de publicación y autores de libros en inglés. Su objeto no debe confundirse con esta matriz de idiomas y formatos. La aportación de la presente página es una instantánea reciente y explicada para lectores, con una regla de inclusión explícita, normalización MIME reproducible, los 68 grupos observados y una comprobación exploratoria de recencia. No se reivindica el descubrimiento de la concentración por idioma ni el primer análisis de esos campos.
Resumen listo para citar, con su alcance
Alisson Bento analizó los metadatos masivos de Project Gutenberg correspondientes al 28 de octubre de 2026. De 78.446 identificadores clasificados exclusivamente como Text, 78.032, el 99,47 %, declaraban HTML, EPUB y texto plano; 1.285, el 1,64 %, declaraban PDF. El subconjunto contenía 68 etiquetas de idioma con filas solapadas. Se midieron referencias en metadatos, no archivos probados ni obras únicas. Las referencias pueden cambiar, especialmente en registros recientes, por lo que los resultados deben conservar la fecha de la instantánea.
Al reutilizar una tabla o un gráfico, debe mantenerse junto a él la fuente, el denominador y esa advertencia temporal. Recortar la cifra principal y eliminar el alcance transforma una descripción verificable en una afirmación más amplia que los datos. La atribución recomendada distingue dos contribuciones: Project Gutenberg proporciona los metadatos del catálogo y Alisson Bento firma el cálculo y la explicación originales. No existe aquí una afirmación de afiliación ni de aprobación por parte de Project Gutenberg.
Formatos de lectura declarados
Porcentaje de los 78.446 identificadores Text que declaraban cada formato el 28 de octubre de 2026. Las categorías se solapan.
Gráfico completo y fuente
Desplaza el gráfico horizontalmente para examinarlo. ↔
Gráfico y valores
Seis idiomas: registros y cobertura de formatos
Identificadores Text con cada etiqueta de idioma el 28 de octubre de 2026. La barra representa el número de registros y su rótulo añade la cobertura de los tres formatos dentro del idioma. Las filas multilingües se solapan.
Gráfico completo y fuente
Desplaza el gráfico horizontalmente para examinarlo. ↔
Gráfico y valores
Comprobación exploratoria de la fecha de incorporación
Porcentaje con los tres formatos declarados según su fecha de publicación en Gutenberg, observado el 28 de octubre de 2026. No es la fecha de primera edición impresa.
Gráfico completo y fuente
Desplaza el gráfico horizontalmente para examinarlo. ↔
Gráfico y valores
Datos y descargas
Desplaza la tabla horizontalmente para ver todas las columnas.
| Formato declarado | Registros | Porcentaje (%) |
|---|---|---|
| HTML o XHTML | 78.300 | 99,81 |
| EPUB | 78.085 | 99,54 |
| Texto plano | 78.263 | 99,77 |
| Texto plano con UTF-8 explícito | 78.154 | 99,63 |
| 1.285 | 1,64 | |
| Los tres formatos juntos | 78.032 | 99,47 |
Instantánea del 28 de octubre de 2026. El denominador es siempre 78.446 identificadores Text. Las filas se solapan y no deben sumarse.
Desplaza la tabla horizontalmente para ver todas las columnas.
| Etiqueta de idioma | Identificadores Text | HTML declarado | EPUB declarado | Texto plano declarado | Los tres declarados | Los tres (%) | PDF declarado |
|---|---|---|---|---|---|---|---|
| en | 62.102 | 62.000 | 61.835 | 61.960 | 61.788 | 99,49 | 1.102 |
| fr | 4.252 | 4.234 | 4.213 | 4.230 | 4.209 | 98,99 | 36 |
| fi | 3.689 | 3.680 | 3.680 | 3.689 | 3.680 | 99,76 | 0 |
| de | 2.455 | 2.436 | 2.420 | 2.435 | 2.419 | 98,53 | 68 |
| nl | 1.120 | 1.120 | 1.114 | 1.120 | 1.114 | 99,46 | 1 |
| it | 1.111 | 1.111 | 1.109 | 1.111 | 1.109 | 99,82 | 58 |
| es | 914 | 914 | 914 | 914 | 914 | 100,00 | 9 |
| pt | 656 | 656 | 655 | 656 | 655 | 99,85 | 1 |
| hu | 655 | 655 | 655 | 655 | 655 | 100,00 | 1 |
| zh | 443 | 443 | 443 | 442 | 442 | 99,77 | 3 |
| sv | 257 | 257 | 257 | 257 | 257 | 100,00 | 0 |
| el | 221 | 221 | 221 | 221 | 221 | 100,00 | 6 |
| eo | 145 | 145 | 145 | 145 | 145 | 100,00 | 3 |
| la | 144 | 144 | 144 | 144 | 144 | 100,00 | 2 |
| ca | 97 | 97 | 95 | 97 | 95 | 97,94 | 0 |
| da | 85 | 85 | 85 | 85 | 85 | 100,00 | 0 |
| tl | 60 | 60 | 60 | 60 | 60 | 100,00 | 0 |
| pl | 31 | 31 | 31 | 31 | 31 | 100,00 | 2 |
| no | 23 | 23 | 23 | 23 | 23 | 100,00 | 0 |
| fy | 22 | 22 | 22 | 22 | 22 | 100,00 | 0 |
| ja | 21 | 21 | 21 | 21 | 21 | 100,00 | 0 |
| af | 17 | 17 | 17 | 17 | 17 | 100,00 | 0 |
| cy | 15 | 15 | 15 | 15 | 15 | 100,00 | 0 |
| cs | 12 | 12 | 12 | 12 | 12 | 100,00 | 1 |
| fur | 7 | 7 | 7 | 7 | 7 | 100,00 | 0 |
| ga | 7 | 7 | 5 | 7 | 5 | 71,43 | 0 |
| is | 7 | 7 | 7 | 7 | 7 | 100,00 | 0 |
| bg | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| enm | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| he | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| te | 6 | 6 | 6 | 6 | 6 | 100,00 | 0 |
| ro | 5 | 5 | 5 | 5 | 5 | 100,00 | 0 |
| ru | 5 | 5 | 5 | 5 | 5 | 100,00 | 1 |
| sl | 5 | 5 | 5 | 5 | 5 | 100,00 | 0 |
| ang | 4 | 4 | 4 | 4 | 4 | 100,00 | 0 |
| gla | 4 | 4 | 4 | 4 | 4 | 100,00 | 1 |
| sr | 4 | 4 | 4 | 3 | 3 | 75,00 | 0 |
| ceb | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| gl | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| grc | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| ilo | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| myn | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| nah | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| nai | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| nav | 3 | 3 | 3 | 3 | 3 | 100,00 | 0 |
| arp | 2 | 2 | 2 | 2 | 2 | 100,00 | 0 |
| brx | 2 | 2 | 2 | 2 | 2 | 100,00 | 0 |
| mi | 2 | 2 | 2 | 2 | 2 | 100,00 | 1 |
| oc | 2 | 2 | 2 | 2 | 2 | 100,00 | 0 |
| ale | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| ar | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| bgs | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| bo | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| br | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| csb | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| et | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| fa | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| hai | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| ia | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| iu | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| kha | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| kld | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| ko | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| nap | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| oji | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| rmq | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| sa | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
| sco | 1 | 1 | 1 | 1 | 1 | 100,00 | 0 |
Instantánea del 28 de octubre de 2026. El denominador de cada fila son los identificadores Text con esa etiqueta. Un registro multilingüe aparece en varias filas; no deben sumarse. No se probaron los archivos declarados.
Desplaza la tabla horizontalmente para ver todas las columnas.
| Etiqueta de idioma | Identificadores Text | Los tres declarados | Los tres (%) |
|---|---|---|---|
| en | 62.102 | 61.788 | 99,49 |
| pt | 656 | 655 | 99,85 |
| es | 914 | 914 | 100,00 |
| fr | 4.252 | 4.209 | 98,99 |
| it | 1.111 | 1.109 | 99,82 |
| de | 2.455 | 2.419 | 98,53 |
Pertenencias a idiomas solapadas; cada porcentaje usa su propio denominador por etiqueta. Instantánea del 28 de octubre de 2026.
Desplaza la tabla horizontalmente para ver todas las columnas.
| Período de incorporación | Identificadores Text | Los tres declarados | Los tres (%) |
|---|---|---|---|
| Antes del 1 de septiembre de 2026 | 78.059 | 77.856 | 99,74 |
| Del 1 de septiembre al 28 de octubre de 2026 | 387 | 176 | 45,48 |
Fecha de publicación en Gutenberg, no año de primera edición impresa. Corte elegido después del análisis principal. Patrón de una instantánea que no establece causas ni condiciones permanentes.
Evidencia y método
Cómo lo calculamos
- Se conservó el archivo oficial y se comprobó su SHA-256 antes del análisis. Se leyó cada miembro RDF y se mantuvo el identificador de catálogo como unidad. Solo se incluyeron registros cuyo conjunto completo de valores dcterms:type era exactamente {Text}; no bastaba con encontrar la palabra Text entre otros tipos.
- Se excluyeron 1.251 identificadores: Sound, 1.114; Dataset, 89; Image, 33; MovingImage, 8; Collection, 4; y StillImage, 3. No hubo una categoría sin tipo. Los identificadores incluidos no se fusionaron por edición, volumen, título o autor. Una comparación auxiliar de título normalizado, creador e idioma encontró 400 grupos candidatos con 902 entradas, pero no confirmó duplicados y no alteró el denominador.
- Se asignó una pertenencia por cada etiqueta de idioma distinta de un registro incluido. Para los formatos se leyeron los valores MIME de dcterms:hasFormat/pgterms:file y se retiraron sus parámetros al comparar tipos base. HTML comprende text/html y application/xhtml+xml; EPUB, application/epub+zip; texto plano, text/plain; y PDF, application/pdf. UTF-8 explícito exige el parámetro charset=utf-8 en texto plano, normalizando mayúsculas y espacios.
- Cada indicador cuenta como máximo una vez por identificador. La intersección de los tres exige HTML, EPUB y texto plano simultáneamente. No se trataron las imágenes de portada, los contenedores ZIP o los archivos RDF como formatos de lectura, ni se dedujo una versión de EPUB a partir de su tipo MIME. En el subconjunto Text no se encontraron URL de archivo repetidas ni archivos declarados sin valor MIME.
- Cada porcentaje por idioma divide su numerador entre los identificadores Text que llevan esa etiqueta. Se conciliaron los totales de formatos, los 68 denominadores y la partición por recencia con las salidas tabulares. La enumeración cubre el archivo suministrado bajo esta regla; no es una muestra probabilística de la literatura. Por ello no se presentan intervalos de confianza muestrales, aunque persisten posibles errores de metadatos y sesgos de selección.
Lo que los datos no permiten concluir
- Los identificadores son entradas de catálogo, no obras únicas ni necesariamente novelas. Se retuvieron un registro Text con título vacío y 130 que no declaraban ninguna de las tres categorías principales, para no modificar el denominador mediante exclusiones posteriores.
- La presencia de un tipo MIME no acredita una descarga correcta, un archivo íntegro, fidelidad de edición, ausencia de riesgos informáticos ni accesibilidad. No se abrieron los libros para evaluar esas propiedades. El informe EPUB3 Accessibility Conformance Report de Gutenberg tiene su propio alcance y no se sustituye por estos recuentos.
- Un catálogo seleccionado no representa todos los libros gratuitos, todas las obras de dominio público, la producción editorial mundial o los hábitos de lectura. Las etiquetas de idioma no identifican países ni establecen direcciones de traducción.
- La autorización para reutilizar metadatos no determina los derechos de cada texto en todos los territorios. Gutenberg incluye también obras protegidas distribuidas con permiso y remite a la comprobación de las normas aplicables fuera de Estados Unidos. Debe consultarse su guía de licencia y la situación de cada obra; esta página no ofrece una evaluación jurídica individual.
- Los datos describen una instantánea del 28 de octubre de 2026. Las referencias de formato y los registros recientes pueden evolucionar. El análisis exploratorio por fecha de incorporación no prueba causas, carencias permanentes ni cambios históricos observados mediante una serie de instantáneas.
Fuentes originales
- Project Gutenberg: Offline Catalogs and Feeds
Ruta oficial del catálogo RDF masivo; instantánea conservada del 28 de octubre de 2026.
Consultado 28 de octubre de 2026
- Project Gutenberg: Robot Access
Cesión al dominio público de los metadatos del catálogo y vía autorizada de acceso masivo. No determina los derechos de los textos.
Consultado 28 de octubre de 2026
- Project Gutenberg: Bibliographic Record
Campos bibliográficos, fechas de incorporación y enriquecimiento progresivo de metadatos y formatos generados.
Consultado 28 de octubre de 2026
- Project Gutenberg: EPUB3 Accessibility Conformance Report
Alcance de la evaluación de accesibilidad. La presencia de un tipo MIME no constituye una prueba de accesibilidad.
Consultado 28 de octubre de 2026
- Project Gutenberg: License
Orientación sobre derechos de los libros y marcas. El permiso relativo a metadatos no establece derechos de los textos en todo el mundo.
Consultado 28 de octubre de 2026
- Gerlach and Font-Clos (2020): A Standardized Project Gutenberg Corpus
Caracterización previa del corpus Gutenberg y sus idiomas; DOI 10.3390/e22010126.
Consultado 28 de octubre de 2026
- Egloff, Adamou and Picca (2020): Enabling Ontology-Based Data Access to Project Gutenberg
Análisis previo del RDF de Gutenberg, incluidos los metadatos de idioma y formato.
Consultado 28 de octubre de 2026
- Timm (2026): Gutenberg Atlas
Metadatos de año de publicación y autor para libros en inglés; versión 1.0.0, publicada el 24 de octubre de 2026; DOI 10.5281/zenodo.23628668.
Consultado 28 de octubre de 2026
- CORGIS Datasets Project: Classics
Conjunto de datos docente anterior con campos de formato del catálogo. No se afirma que este sea el primer análisis de esos campos.
Consultado 28 de octubre de 2026
- Project Gutenberg bulk RDF catalogue
Archivo fuente SHA-256 c5ee946cea46fb32ffb2d55af670384064ccd818ab59d900c362a63b6bb29a65; última modificación declarada: 28 de octubre de 2026, 14:35:54 UTC; descarga completada a las 21:44:48 UTC.
Consultado 28 de octubre de 2026
Cómo citar y reutilizar
Alisson Bento. Project Gutenberg: idiomas y formatos de lectura en el catálogo de octubre de 2026. Análisis original del catálogo RDF de Project Gutenberg, instantánea del 28 de octubre de 2026. https://alissonbento.com/es/research/project-gutenberg-language-format-coverage/ https://alissonbento.com/es/research/project-gutenberg-language-format-coverage/
Los metadatos de origen se ofrecen al dominio público conforme a la política de Project Gutenberg; la muestra RDF conservada incluye una referencia CC0. El análisis, la explicación, el código y los gráficos originales corresponden a Alisson Bento: pueden reutilizarse con atribución, enlace al estudio, fecha de la instantánea del 28 de octubre de 2026 e indicación de cambios, conservando sus límites. No se implica afiliación ni aprobación de Project Gutenberg. Estas condiciones no licencian los textos de los libros ni establecen sus derechos en todos los países.
Correcciones o consultas editoriales