Wer gehört in den Nenner?
Eine Statistik über Belletristik kann sehr unterschiedliche Gruppen beschreiben: alle Erwachsenen, Menschen mit Buchlektüre, Menschen mit Romanlektüre oder Käufer eines bestimmten Genres. Diese Gruppen überschneiden sich, sind jedoch nicht austauschbar. Die vorliegende Studie stellt eine klar begrenzte Frage: Wie viele Erwachsene, die nach eigener oder stellvertretender Auskunft während der vergangenen zwölf Monate ein Buch gelesen hatten, berichteten zugleich von Romanen oder Kurzgeschichten? Die Antwort beschreibt die Zusammensetzung einer durch Erhebungsfragen definierten Leserschaft. Sie misst weder Buchnachfrage noch Genretreue oder die Wahrscheinlichkeit, dass jemand einem Lesekreis beitritt.
Grundlage sind personenbezogene Antworten aus der Survey of Public Participation in the Arts von 2017 und 2022. Das U.S. Census Bureau erhebt diese Zusatzbefragung im Rahmen der Current Population Survey für das National Endowment for the Arts. Für jede Schätzung werden die Antworten zur Buch- und Belletristiklektüre derselben Person miteinander verknüpft. Das ist entscheidend, weil die Belletristikfrage auch Texte außerhalb von Büchern erfasst. Das Ergebnis ist eine Überschneidungskennzahl, kein Quotient aus zwei getrennten Schlagzeilenwerten. Tabellen nach Alter und Bildung erweitern diese Berechnung mit unveränderter Nennerregel. Alle Ergebnisse betreffen die Erhebungsjahre, nicht das aktuelle Lesen im Jahr 2026. Die beiden Wellen untersuchen unterschiedliche Stichproben und verfolgen nicht dieselben Lesenden.
Was die beiden Fragen tatsächlich erfassen
Die allgemeine Buchfrage bezieht sich auf Bücher, die während der vergangenen zwölf Monate gelesen wurden; für Arbeit oder Ausbildung vorgeschriebene Bücher werden ausgeschlossen. Die gesonderte Belletristikfrage betrifft Romane oder Kurzgeschichten und schließt Material in Büchern, Zeitschriften, Zeitungen, auf Papier und online ein. Eine Kurzgeschichte auf einer Website kann daher als Belletristik zählen, obwohl die Person keine Buchlektüre angibt. Umgekehrt kann jemand historische, praktische oder religiöse Bücher lesen, ohne einen Roman oder eine Kurzgeschichte zu nennen. Eine abweichende Antwort auf die jeweils andere Frage ist für sich genommen kein Fehler.
Der Wortlaut setzt wichtige Grenzen. Die Belletristikfrage wiederholt den Ausschluss arbeits- oder ausbildungsbezogener Lektüre aus der allgemeinen Buchfrage nicht. Die Analyse überträgt diesen Ausschluss deshalb nicht stillschweigend auf sämtliche Belletristikangaben. Gesonderte Fragen zum Hören werden dem Zähler nicht hinzugefügt, auch wenn Befragte Lesen möglicherweise weit verstanden haben. Der Fragebogen von 2022 nennt ausdrücklich gedruckte und elektronische Bücher; das Instrument von 2017 enthält dagegen eine Erläuterung zu religiösen Texten. Diese Änderung ist neben den veränderten Regeln für Stellvertreterinterviews zu beachten. Nicht isoliert erfasst werden Liebesromane, literarische Belletristik, vollständig gelesene Romane, Käufe, Bibliotheksausleihen, Seiten oder Lesedauer. Schon eine einzige berichtete Kurzgeschichte genügt für eine positive Teilnahmeangabe.
Die gesamte Überschneidung und ihre Vergleichsgrenzen
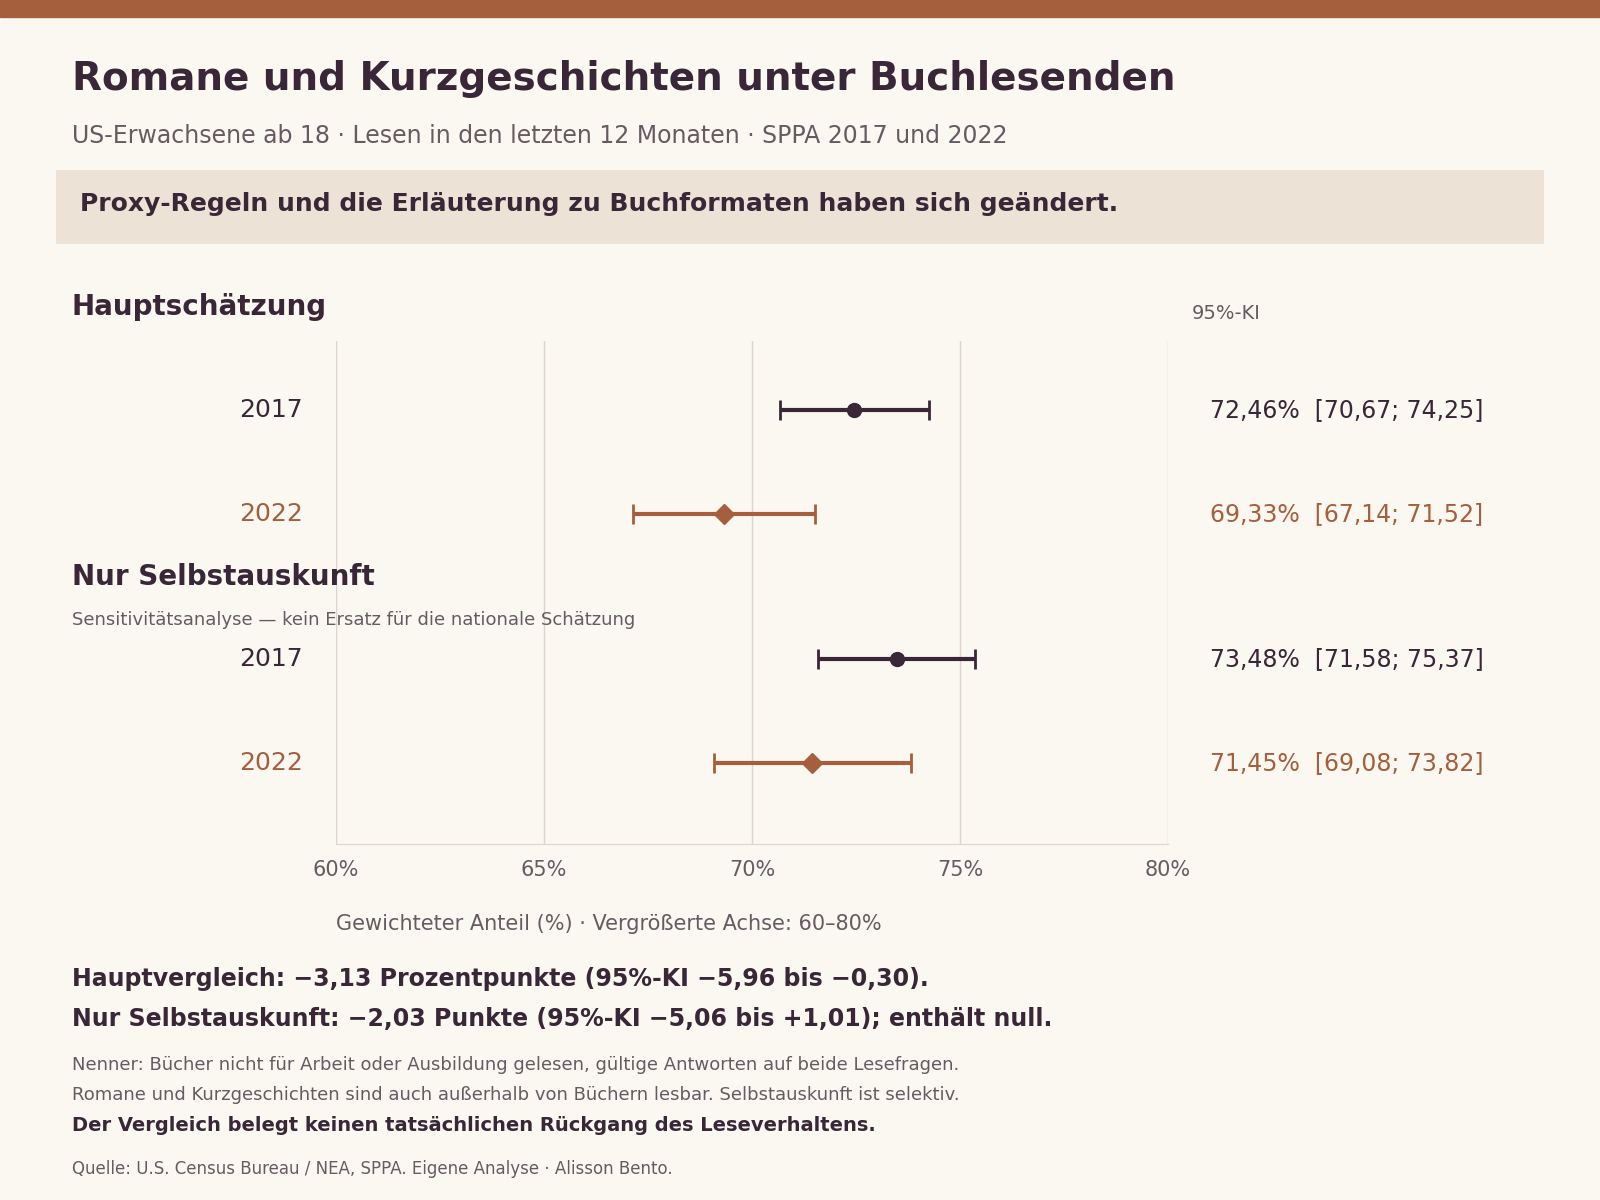
Unter Buchlesenden mit gültiger Ja- oder Nein-Antwort zur Belletristik betrug der gewichtete Belletristikanteil 2017 72,46% und 2022 69,33%. Die ungewichteten Nenner umfassten 4.813 beziehungsweise 3.336 Personen. Davon berichteten 3.561 beziehungsweise 2.372 beide Aktivitäten. Die 95%-Konfidenzintervalle reichen 2017 von 70,67% bis 74,25% und 2022 von 67,14% bis 71,52%. Sie verwenden die bereitgestellten Replikatgewichte der Zusatzbefragung, statt eine unabhängige Auswahl jeder Person mit gleicher Auswahlwahrscheinlichkeit zu unterstellen.
Die Gesamtdifferenz beträgt minus 3,13 Prozentpunkte; ihr 95%-Konfidenzintervall reicht von minus 5,96 bis minus 0,30. Das ist eine deskriptive Differenz zwischen zwei gewichteten Erhebungsschätzungen. Sie sollte nicht ohne Vorbehalt als Rückgang des zugrunde liegenden menschlichen Verhaltens dargestellt werden. Die Zulässigkeit von Stellvertreterantworten änderte sich, deren Anteil nahm zu, und die Buchfrage erhielt einen Hinweis auf elektronische Formate. Beschränkt man die Sensitivitätsanalyse auf Selbstauskünfte, beträgt die Differenz minus 2,03 Punkte und das Intervall enthält null. Jede Zusammenfassung des Gesamtvergleichs muss diese Einschränkung unmittelbar nennen. Eine rechnerisch korrekte Schätzung kann in ihrer Interpretation zwischen Erhebungswellen dennoch durch veränderte Erhebungsbedingungen begrenzt sein.
Warum die Division getrennter Gesamtanteile nicht funktioniert
Ein bedingter Prozentsatz benötigt die Zahl der Menschen, die beide Bedingungen erfüllen. Der Anteil der Belletristiklesenden geteilt durch den Anteil der Buchlesenden wäre nur dann geeignet, wenn jede Person mit Belletristik zugleich zur Buchleserschaft gehörte und auch die übrigen Nenner übereinstimmten. Beides darf nicht allein aus den Bezeichnungen abgeleitet werden. Tatsächlich antworten einige Personen bei Büchern ausdrücklich mit Nein und bei Romanen oder Kurzgeschichten mit Ja. Der Fragebogen lässt diese Kombination zu, weil Geschichten außerhalb von Büchern gelesen werden können. Der richtige Zähler für Belletristik unter Buchlesenden ist daher die gewichtete Schnittmenge beider Ja-Antworten.
Die beobachteten Antworten machen den Unterschied konkret. Unter Nichtbuchlesenden mit gültigen Antworten auf beide Fragen berichteten 2017 7,92% und 2022 7,65% Belletristik. Diese Personen tragen zum allgemeinen Belletristikanteil bei, gehören aber nicht in den Zähler einer Aussage über Belletristik innerhalb der Buchleserschaft. Die öffentlichen Ergebnistabellen erhalten beide bedingten Kennzahlen, damit der Unterschied überprüfbar bleibt. Sie dürfen nicht addiert werden, denn sie haben unterschiedliche Nenner. Ebenso wenig kann eine breitere Kennzahl literarischer Lektüre, die möglicherweise Romane, Geschichten, Gedichte und Theaterstücke vereint, automatisch die hier verwendete Belletristikdefinition ersetzen. Vor jeder solchen Quotientenbildung müssen die zugehörigen Personengruppen präzise definiert werden.
Stellvertreterantworten beeinflussen die Interpretation wesentlich
Die Interviewanweisungen zeigen, unter welchen Umständen Antworten im Namen einer anderen Person zulässig waren. Im Jahr 2017 war dies auf bestimmte Rückruf- und Abschlussfälle oder Situationen drohender Verärgerung im Haushalt beschränkt. Die Anweisung von 2022 erlaubte Stellvertreterantworten bei Nichtverfügbarkeit der Zielperson. Unter den hier verwendeten Buchlesenden mit vollständigen Antworten stieg der gewichtete Stellvertreteranteil von 19,60% auf 28,22%. Drei vollständige Buchlesefälle von 2022 hatten einen unbekannten Stellvertreterstatus und verbleiben in der Gesamtschätzung. Änderungen des Antwortmodus und der Erreichbarkeit können einen Vergleich beeinflussen, selbst wenn die inhaltlichen Lesefragen ähnlich erscheinen.
Bei ausschließlicher Verwendung von Selbstauskünften ergeben sich Belletristikanteile von 73,48% für 2017 und 71,45% für 2022. Die Nenner umfassen 4.124 beziehungsweise 2.660 Personen. Die Differenz von minus 2,03 Prozentpunkten hat ein 95%-Intervall von minus 5,06 bis plus 1,01. Auf diesem Konfidenzniveau lässt sich die Veränderung daher nicht von null unterscheiden. Selbstauskünfte sind nicht automatisch die bessere Bevölkerungsschätzung: Wer selbst erreichbar ist, kann sich systematisch von den durch andere vertretenen Menschen unterscheiden. Die Sensitivitätsprüfung zeigt vielmehr eine echte Interpretationsgrenze. Aus den Daten lässt sich nicht ermitteln, welcher Teil der Gesamtdifferenz auf Verhalten, Fragewortlaut, Antwortmodus, Stichprobenzusammensetzung oder andere unbeobachtete Faktoren zurückgeht.
Altersunterschiede sind Beschreibungen, keine Generationendiagnosen
Die Alterstabelle wendet dieselbe Berechnung innerhalb der Buchleserschaft auf sieben Altersgruppen an, beginnend mit 18–24 Jahren bis zur Gruppe ab 75 Jahren. So bleibt der Vergleich auf Menschen mit berichteter Buchlektüre konzentriert, statt durch die allgemeine Häufigkeit des Buchlesens bestimmt zu werden. Die Schätzungen verfolgen keine Geburtskohorte. Wer 2017 einer Altersgruppe angehörte, kann 2022 bereits in eine andere gewechselt sein; zudem handelt es sich um unterschiedliche Stichproben. Bezeichnungen wie Generation Z würden eine zusätzliche Definition einführen, die diese Analyse nicht festgelegt hat.
Die jüngste Gruppe weist einen Belletristikanteil von 70,84% für 2017 und 63,81% für 2022 auf. Das Intervall ihrer Veränderung ist jedoch breit und enthält null. Ihr Nenner 2022 umfasst lediglich 183 Buchlesende mit vollständigen Antworten. Für die 65- bis 74-Jährigen lauten die Schätzwerte 75,87% und 67,51%; auch dieser beobachtete Kontrast unterliegt den allgemeinen Vorbehalten zu Stellvertreterantworten und Wortlaut. Die vollständige Tabelle ist nützlicher als eine Rangliste von Punktschätzungen, weil sie Stichprobenumfänge und Unsicherheit enthält. Mehrere Altersgruppen zeigen unterschiedliche numerische Richtungen. Kleine Unterschiede sind nicht als zuverlässige Abstände zu behandeln. Eine Korrektur für mehrfache Teilgruppenvergleiche wurde nicht vorgenommen; die Alterskontraste sind explorativ und keine Sammlung unabhängig bestätigter Generationenbefunde.
Bildung beschreibt Zusammenhänge, nicht die Wirkung von Schulbildung
Die Bildungstabelle unterscheidet nach angegebenem Abschluss: unterhalb eines Highschool-Abschlusses, Highschool-Abschluss, Collegebesuch ohne Bachelor oder Associate-Abschluss, Bachelor und weiterführender Hochschulabschluss. In jeder Kategorie besteht der Nenner weiterhin aus Personen, die Bücher und eine gültige Belletristikantwort berichten. Dies beantwortet nicht die Frage, ob höher gebildete Menschen überhaupt häufiger Bücher lesen. Die Bedingung der Buchlektüre verengt die Fragestellung bewusst. Ein unter dieser Bedingung beobachteter Zusammenhang lässt sich nicht zu einer Wirkung von Bildung auf die gesamte erwachsene Bevölkerung verallgemeinern.
Im Jahr 2022 reichen die Belletristikanteile innerhalb der Buchleserschaft von 58,85% bei Personen ohne Highschool-Abschluss bis 76,33% bei Personen mit weiterführendem Hochschulabschluss. Der erste Wert beruht auf 112 vollständigen Buchlesefällen und ist unsicherer als die Schätzungen größerer Gruppen. Die Kategorie Collegebesuch oder Associate-Abschluss zeigt 73,05% für 2017 und 64,00% für 2022. Dieser explorative numerische Unterschied erlaubt keine Aussage über konkrete Lehrveranstaltungen, Einrichtungen oder Lesefähigkeiten. Alter, Haushaltssituation, Einkommen, Beruf und Antwortmodus können sich zwischen Bildungsgruppen unterscheiden. Die Studie schätzt kein Kausalmodell und isoliert deren Beiträge nicht. Die Tabellen dokumentieren beobachtete Erhebungszusammenhänge und liefern Details, die vor selbstsicheren, mit diesen Messgrößen nicht prüfbaren Erklärungen schützen.
Eine begrenzte Prüfung veränderter Zusammensetzung
Die Verteilung von Alter und Bildungsabschlüssen unter Buchlesenden kann sich zwischen Erhebungen verschieben. Um dies deskriptiv zu untersuchen, halten ergänzende Berechnungen jeweils eine Verteilung auf dem Stand der vollständigen Buchlesefälle von 2017 fest. Bei der Altersstandardisierung werden dieselben Altersgruppenanteile von 2017 auf die gruppenspezifischen Schätzwerte beider Wellen angewendet. Die Bildungsstandardisierung wiederholt dies für Bildungsgruppen. Beide Anpassungen beantworten getrennte Fragen. Sie kontrollieren Alter und Bildung nicht gemeinsam und berücksichtigen keineswegs sämtliche möglichen Unterschiede in der Zusammensetzung.
Mit der Altersverteilung von 2017 als Referenz beträgt der Belletristikanteil 2022 69,36% und liegt damit nahe am unbereinigten Wert von 69,33%. Wird stattdessen die Bildungsverteilung von 2017 verwendet, ergeben sich 68,89%. Jede dieser einzelnen Anpassungen beseitigt für sich genommen den numerischen Gesamtunterschied also nicht. Sie löst aber auch die Probleme veränderter Stellvertreteranweisungen und Buchformulierungen nicht. Die ausgewiesenen Standardfehler behandeln die Referenzanteile als fest, obwohl sie selbst aus einer Erhebung geschätzt wurden. Deshalb sind die standardisierten Werte deskriptive Sensitivitätsergebnisse, kein neuer bereinigter Signifikanztest. Eine unbedingte Unsicherheitsanalyse müsste zusätzlich die Schätzung der Referenzverteilung und die relevanten Kovarianzen berücksichtigen.
Fehlende Belletristikantworten bleiben sichtbar
Der Hauptnenner schließt Buchlesende aus, deren Belletristikantwort fehlt, verweigert wurde oder unbekannt ist. Solche Angaben werden nicht als Nein umcodiert. Im Jahr 2017 wurden 4.848 Buchlesende beobachtet, darunter 35 ohne gültige Belletristikantwort; 2022 waren es 3.359, darunter 23 ohne gültige Antwort. Gewichtet entsprachen diese fehlenden Angaben 1,38% beziehungsweise 0,97% der beobachteten Buchleserschaft. Strukturelle Auslassungen infolge der Zuordnung zum anderen Kernmodul werden von diesen fehlenden Einzelantworten getrennt. Menschen, denen eine Frage nicht gestellt wurde, sind kein Beleg für Nichtteilnahme.
Eine einfache Sensitivitätsprüfung setzt sämtliche fehlenden Belletristikantworten zunächst auf Nein und anschließend auf Ja. Daraus ergeben sich Grenzen von 71,46% bis 72,84% für 2017 sowie 68,66% bis 69,62% für 2022. Sie zeigen die maximal mögliche Wirkung der beobachteten fehlenden Belletristikantworten unter diesen Zuordnungen. Es sind keine Konfidenzintervalle. Fehlende Buchantworten, gesamte Erhebungsausfälle und unzutreffende Angaben werden dadurch nicht behandelt. Die Forderung nach zwei gültigen Antworten kann außerdem dazu führen, dass ein Randanteil aus der Analysestichprobe von einer offiziellen Veröffentlichung mit anderem Antwortnenner abweicht. Solche Unterschiede müssen erklärt werden, statt eigene Berechnungen stillschweigend an eine gerundete offizielle Schlagzeile anzugleichen.
Wie Gewichte und Konfidenzintervalle berechnet wurden
Beide Lesevariablen gehören in beiden Erhebungen zu Core One. Verwendet wird das SPPA-Zusatzbefragungsgewicht, nicht ein allgemeines Arbeitskräftegewicht. Für jede Kennzahl wird die gewichtete Zahl der Personen im Zähler durch die gewichtete Zahl im Nenner geteilt. Der kernmodulspezifische Bevölkerungsskalierungsfaktor kürzt sich dabei heraus, ebenso die gemeinsame implizite Dezimalskalierung der heruntergeladenen Gewichtsfelder. Die Studie berichtet Prozentsätze und Stichprobenzahlen, keine hochgerechneten landesweiten Personenzahlen. Diagnostische rohe Gewichtssummen in der Prüfdatei dürfen daher nicht als Bevölkerungszahlen dargestellt werden.
Zur Unsicherheitsberechnung wird der gesamte Quotient mit jedem der 160 bereitgestellten Replikatgewichte der Zusatzbefragung erneut berechnet. Die Varianz beträgt vier geteilt durch 160, multipliziert mit der Summe der quadrierten Abweichungen zwischen Replikatschätzungen und Vollstichprobenschätzung. Normalverteilungsbasierte Intervalle verwenden auf jeder Seite 1,96 Standardfehler. Bei Unterschieden zwischen Wellen wird die Quadratwurzel der Summe beider geschätzter Varianzen verwendet; die fünf Jahre auseinanderliegenden Erhebungen gelten dabei als unabhängige Querschnitte. Eine unabhängige Implementierung reproduzierte die Gesamtergebnisse sowie alle 24 Alters- und Bildungszellen der primären bedingten Kennzahl einschließlich Fallzahlen und Standardfehlern. Replikation prüft Rechenweg und Programmierung; Erinnerungsfehler, soziale Erwünschtheit, Stellvertreterunsicherheit und andere nicht stichprobenbedingte Verzerrungen kann sie nicht beseitigen.
Was diese Analyse zu anderen Lesestatistiken beiträgt
Zeitverwendungstagebücher, Buchverkaufszahlen und jährliche Teilnahmeerhebungen beantworten unterschiedliche Fragen. Ein Tagebuch kann zeigen, ob an einem bestimmten Tag gelesen wurde und wie lange. Eine Verkaufsreihe erfasst Transaktionen gemäß ihren eigenen Abdeckungsregeln. Die SPPA fragt nach Teilnahme während zwölf Monaten und erlaubt Selbst- wie Stellvertreterantworten. Die vorliegende Untersuchung ergänzt deshalb eine Studie über Lesetage, ohne eine weitere Version derselben Kennzahl zu liefern. Eine Person kann eine einzige Begegnung mit Belletristik im Jahr berichten und zugleich an einem konkreten Tagebuchtag keine Lektüre verzeichnen. Zwischen beiden Beobachtungen besteht kein Widerspruch.
Für Bibliotheken, Lesekreise und Forschung liegt der Beitrag in einem sachlich begründeten Nenner und einer Erklärung, wie Definitionen das Ergebnis prägen. Der verbleibende Anteil der Buchlesenden ohne Belletristikangabe sollte nicht als unerschlossenes Verkaufspublikum bezeichnet werden. Manche bevorzugen andere Inhalte, erkennen ihre Lektüre nicht als Belletristik oder berichten unvollkommen. Die Befragung fragt nicht, ob sie mehr Belletristik wünschen, ein empfohlenes Buch kaufen oder auf eine Kampagne reagieren würden. Ebenso wenig lassen sich daraus literarische Qualität, Verständnis oder persönlicher Wert ablesen. Eine praktische Nutzung beginnt bei der tatsächlich beobachteten Frage und Population, statt einen bedingten Prozentsatz in ein unbelegtes Marketingurteil oder Kultururteil umzudeuten.
Quellen, Reproduzierbarkeit und verantwortliche Weiterverwendung
Die Quelldateien wurden unmittelbar von den öffentlichen SPPA-Datenseiten des Census Bureau für 2017 und 2022 heruntergeladen. Beobachtungen, Replikatgewichte und technische Dokumentation waren dort ohne Konto, institutionelle Mitgliedschaft oder API-Schlüssel verfügbar. Offizielle NEA-Berichte lieferten den methodischen Kontext. Quellen-URLs, Dateilängen in Bytes und kryptografische Hashwerte bleiben im Manifest erhalten, sodass andere Forschende die exakten Eingaben identifizieren können. Die öffentlichen Reproduktionsskripte laden diese offiziellen Dateien in ein lokales Arbeitsverzeichnis und berechnen die veröffentlichten Aggregate. Das Herunterladen zur Reproduktion ist von der Weiterverbreitung der Rohdaten auf dieser Website zu unterscheiden.
Zum öffentlichen Studienpaket gehören ausschließlich aggregierte Ergebnisse, Methoden, Quellenverweise und Programmcode. Personenbezogene Rohdatensätze und Replikatgewichtsdateien bleiben außerhalb des Veröffentlichungsrepositorys. Wer Tabellen weiterverwendet, sollte Erhebungsjahre, erwachsene Haushaltsbevölkerung, bedingten Nenner, Unsicherheit sowie den Vorbehalt zu Stellvertreterantworten und Wortlaut erhalten. Die inhaltlichen Aussagen gelten für die zivile, nicht institutionalisierte Bevölkerung ab 18 Jahren in Privathaushalten, nicht für Kinder oder Menschen in Einrichtungen. Die Ergebnisse sind eine eigene Sekundäranalyse und bedeuten keine Billigung durch das Census Bureau oder das National Endowment for the Arts. Künftige Erhebungen können neue Vergleiche ermöglichen, sollten vor einer Anfügung an die Reihe aber auf Änderungen der Fragen und Erhebung geprüft werden. Zur Reproduzierbarkeit gehört, diese Interpretationsgrenzen ebenso sorgfältig zu erhalten wie die Zahlen.
Romane und Kurzgeschichten unter Buchlesenden
US-Erwachsene ab 18 · Lesen in den letzten 12 Monaten · SPPA 2017 und 2022. Schätzwert und 95%-Konfidenzintervall.
Vollständige Grafik und Quelle
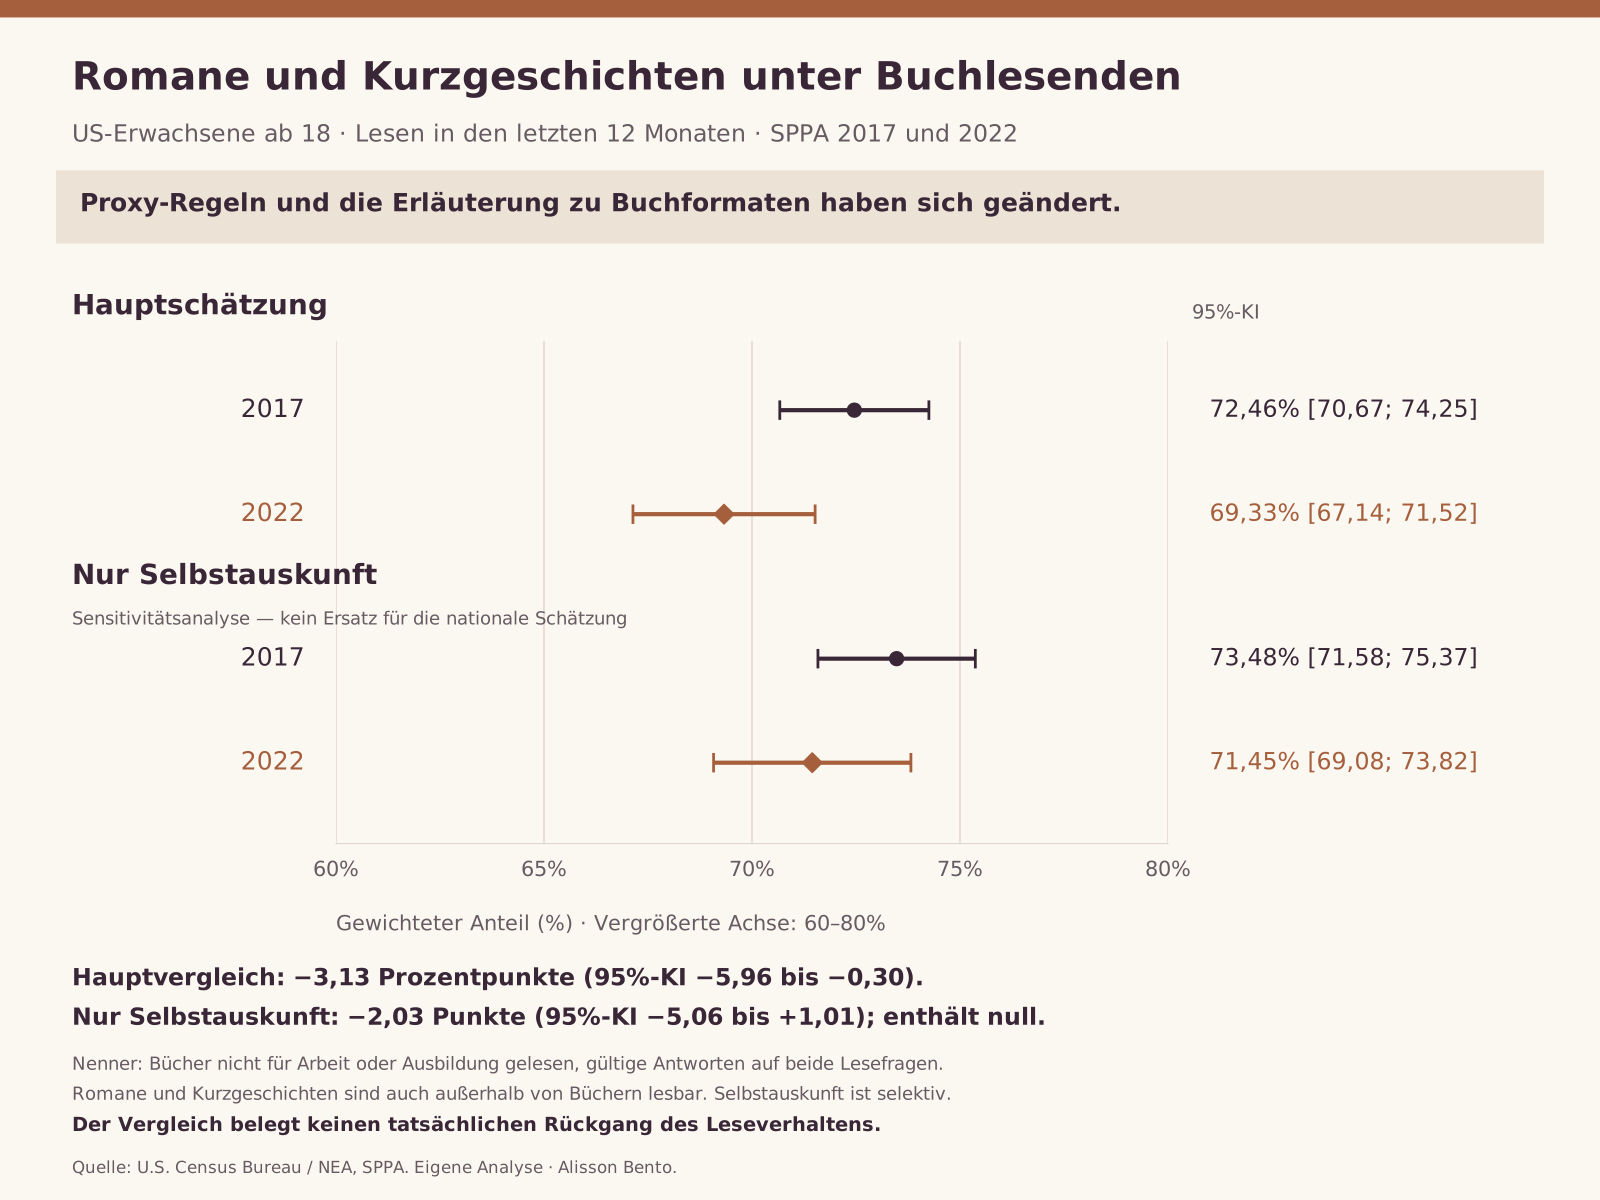
Diagramm seitlich scrollen, um alle Details zu sehen. ↔
Grafik und Werte
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Jahr | Antwortumfang | Nenner n | Beide Antworten Ja n | Gewichteter Anteil (%) | 95%-KI Untergrenze | 95%-KI Obergrenze |
|---|---|---|---|---|---|---|
| 2017 | Alle Antworten | 4813 | 3561 | 72.46 | 70.67 | 74.25 |
| 2022 | Alle Antworten | 3336 | 2372 | 69.33 | 67.14 | 71.52 |
| 2017 | Nur Selbstauskünfte | 4124 | 3085 | 73.48 | 71.58 | 75.37 |
| 2022 | Nur Selbstauskünfte | 2660 | 1919 | 71.45 | 69.08 | 73.82 |
Bedingt auf berichtete Buchlektüre und gültige Belletristikantwort; gewichtete Schätzungen, ungewichtete Fallzahlen. Stellvertreteranweisungen und Buchwortlaut änderten sich. Das Intervall der Veränderung nur bei Selbstauskünften enthält null; der Gesamtvergleich ist keine kausale Verhaltensschätzung.
Daten und Downloads
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Jahr | Antwortumfang | Nenner n | Beide Antworten Ja n | Gewichteter Anteil (%) | 95%-KI Untergrenze | 95%-KI Obergrenze |
|---|---|---|---|---|---|---|
| 2017 | Alle Antworten | 4813 | 3561 | 72.46 | 70.67 | 74.25 |
| 2022 | Alle Antworten | 3336 | 2372 | 69.33 | 67.14 | 71.52 |
| 2017 | Nur Selbstauskünfte | 4124 | 3085 | 73.48 | 71.58 | 75.37 |
| 2022 | Nur Selbstauskünfte | 2660 | 1919 | 71.45 | 69.08 | 73.82 |
Bedingt auf berichtete Buchlektüre und gültige Belletristikantwort; gewichtete Schätzungen, ungewichtete Fallzahlen. Stellvertreteranweisungen und Buchwortlaut änderten sich. Das Intervall der Veränderung nur bei Selbstauskünften enthält null; der Gesamtvergleich ist keine kausale Verhaltensschätzung.
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Jahr | Gruppe | Nenner n | Beide Antworten Ja n | Gewichteter Anteil (%) | 95%-KI Untergrenze | 95%-KI Obergrenze |
|---|---|---|---|---|---|---|
| 2017 | 18-24 | 295 | 219 | 70.84 | 64.34 | 77.34 |
| 2017 | 25-34 | 808 | 596 | 73.62 | 69.82 | 77.43 |
| 2017 | 35-44 | 769 | 571 | 72.58 | 68.61 | 76.56 |
| 2017 | 45-54 | 702 | 504 | 70.64 | 66.52 | 74.77 |
| 2017 | 55-64 | 875 | 650 | 71.60 | 67.88 | 75.32 |
| 2017 | 65-74 | 823 | 622 | 75.87 | 71.79 | 79.95 |
| 2017 | 75+ | 541 | 399 | 71.58 | 66.76 | 76.40 |
| 2022 | 18-24 | 183 | 121 | 63.81 | 53.84 | 73.79 |
| 2022 | 25-34 | 515 | 380 | 73.48 | 68.92 | 78.03 |
| 2022 | 35-44 | 578 | 428 | 66.79 | 61.36 | 72.21 |
| 2022 | 45-54 | 474 | 339 | 74.28 | 69.97 | 78.59 |
| 2022 | 55-64 | 526 | 358 | 67.56 | 62.34 | 72.78 |
| 2022 | 65-74 | 634 | 448 | 67.51 | 62.75 | 72.26 |
| 2022 | 75+ | 426 | 298 | 69.17 | 63.61 | 74.73 |
Explorative Teilgruppenschätzungen mit vollständigen Antworten und allen Antwortmodi. Keine Korrektur für Mehrfachvergleiche. Fallzahlen, Intervalle und die Grenzen durch veränderte Stellvertreterregeln und Formulierungen müssen erhalten bleiben.
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Jahr | Gruppe | Nenner n | Beide Antworten Ja n | Gewichteter Anteil (%) | 95%-KI Untergrenze | 95%-KI Obergrenze |
|---|---|---|---|---|---|---|
| 2017 | Unter Highschool-Abschluss | 221 | 115 | 55.90 | 46.97 | 64.82 |
| 2017 | Highschool-Abschluss | 1010 | 679 | 65.21 | 61.42 | 69.00 |
| 2017 | Collegebesuch/Associate-Abschluss | 1383 | 1031 | 73.05 | 70.10 | 76.00 |
| 2017 | Bachelor | 1307 | 1009 | 76.41 | 73.33 | 79.50 |
| 2017 | Weiterführender Hochschulabschluss | 892 | 727 | 79.45 | 76.13 | 82.78 |
| 2022 | Unter Highschool-Abschluss | 112 | 60 | 58.85 | 47.06 | 70.65 |
| 2022 | Highschool-Abschluss | 553 | 349 | 63.25 | 57.03 | 69.46 |
| 2022 | Collegebesuch/Associate-Abschluss | 948 | 646 | 64.00 | 59.79 | 68.20 |
| 2022 | Bachelor | 1005 | 764 | 75.80 | 72.48 | 79.12 |
| 2022 | Weiterführender Hochschulabschluss | 718 | 553 | 76.33 | 72.89 | 79.77 |
Explorative Teilgruppenschätzungen mit vollständigen Antworten und allen Antwortmodi. Keine Korrektur für Mehrfachvergleiche. Fallzahlen, Intervalle und die Grenzen durch veränderte Stellvertreterregeln und Formulierungen müssen erhalten bleiben.
Daten und Methode
So haben wir gerechnet
- Eigene Sekundäranalyse der tatsächlich heruntergeladenen öffentlichen Census-SPPA-Dateien für Juli 2017 und Juli 2022. Beide Lesefragen gehören zu Core 1; berücksichtigt werden Personen ab 18 Jahren mit positivem Zusatzbefragungsgewicht.
- Der primäre Zähler ist PEC1Q14A=1 und PEC1Q15A=1. Sein Nenner ist PEC1Q14A=1 und PEC1Q15A in {1,2}. Fehlende Belletristikantworten werden ausgeschlossen, nicht als Nein behandelt. Belletristik- und Buchmengen werden nicht als ineinander verschachtelt angenommen.
- PWSUPWGT ist das Gewicht der Punktschätzung. Jeder bedingte Quotient wird mit 160 zugeordneten Replikatgewichten der Zusatzbefragung neu berechnet; die Varianz ist 4/160 mal der Summe quadrierter Abweichungen. Normale 95%-Intervalle verwenden 1,96 Standardfehler. Für Veränderungsintervalle werden unabhängige Varianzen der Wellen addiert.
- PUNXTPR3 identifiziert die Selbst-/Stellvertretergruppen der Sensitivitätsanalyse. Getrennte eindimensionale Standardisierungen verwenden feste Alters- oder Bildungsanteile der vollständigen Buchlesefälle von 2017. Sie sind deskriptiv, keine gemeinsame Bereinigung und keine unbedingte bereinigte Inferenz.
- Eine unabhängige Implementierung anhand der Rohdateien reproduzierte die Gesamtschätzungen und alle 24 Alters-/Bildungszellen der Hauptkennzahl mit Toleranz 1e-9. Untersuchungsdesign und Prüfungen entstanden während dieser Analyse; die Studie wurde nicht prospektiv präregistriert.
Was die Daten nicht aussagen
- Die Regeln für Stellvertreterantworten wurden 2022 großzügiger und deren Anteil nahm zu. Das Veränderungsintervall nur für Selbstauskünfte enthält null. Der Gesamtunterschied ist kein kausaler oder messinvarianter Verhaltensrückgang.
- Die Buchfrage 2022 erwähnt gedruckte/elektronische Formate ausdrücklich; 2017 enthält eine Klarstellung zu religiösen Texten. Belletristik umfasst Inhalte außerhalb von Büchern und wiederholt den Arbeits-/Ausbildungsausschluss nicht. Hörfragen werden nicht hinzugefügt.
- Jährliche Erinnerung, Wissen der Stellvertreter, Antwortausfälle und soziale Erwünschtheit können verzerren. Replikatintervalle erfassen nicht alle nicht stichprobenbedingten Verzerrungen. Die Abdeckung gilt für zivile, nicht institutionalisierte Erwachsene ab 18 Jahren in Privathaushalten, nicht alle Einwohner.
- Kleine Teilgruppen sind unpräzise; Vergleiche sind explorativ und ohne Multiplizitätskorrektur. Altersgruppen sind keine Generationen. Bildungszusammenhänge sind keine Bildungswirkungen.
- Kaufabsicht, Liebesromanlektüre, Buchabschluss, Dauer, Lesequalität oder Marketingpotenzial werden nicht gemessen. Dies ist eine eigene Studie mit übersetzten Ausgaben, keine getrennten Studien nach Sprache oder Teilgruppe.
Originalquellen
- jul22pub.csv
Öffentliche Census-CSV des SPPA 2022: liefert individuelle Antworten zu Büchern und fiktionalen Texten, Alter, Bildungsabschluss, Kennzeichnung von Selbst- oder Stellvertreterauskunft sowie das Ergänzungsgewicht für die Schätzungen von 2022. Die individuellen Rohdaten sind nicht in den öffentlichen Downloads dieser Studie enthalten.
Abgerufen am 30. Oktober 2026
- jul22rep.csv
Census-CSV mit Replikationsgewichten des SPPA 2022: 160 Ergänzungsgewichte werden über QSTNUM und OCCURNUM verknüpft und zur Berechnung der Standardfehler der Quotienten verwendet. Replikationsgewicht null wird mit dem Hauptgewicht abgeglichen; rohe Gewichtswerte sind keine Bevölkerungszahlen.
Abgerufen am 30. Oktober 2026
- jul17pub.zip
Öffentliches Census-ZIP des SPPA 2017: Personendatensätze mit fester Feldbreite liefern die Antworten und Merkmale von 2017. Das Feld für fiktionale Texte liegt an den Positionen 1050–1051; ein mit 2022 identischer Aufbau darf nicht vorausgesetzt werden. Die Rohdaten bleiben außerhalb des öffentlichen Studienpakets.
Abgerufen am 30. Oktober 2026
- jul17rep.zip
Census-ZIP mit Replikationsgewichten des SPPA 2017: Ergänzungsgewichte mit fester Feldbreite werden mit den Datensätzen von 2017 verknüpft, um jeden bedingten Quotienten über 160 Replikationen neu zu berechnen. Die Datei dient der Unsicherheitsschätzung, nicht einer zusätzlichen Lesekennzahl.
Abgerufen am 30. Oktober 2026
- cpsjul17.pdf
Technische Census-Dokumentation von 2017: Datensatzbeschreibungen und Fragebogen erläutern die beiden Lesefragen und die strengere Anweisung für Stellvertreterauskünfte. Die Bücherfrage enthält eine Klarstellung zu religiösen Texten; die Frage zu fiktionalen Texten umfasst auch Erzählungen außerhalb von Büchern.
Abgerufen am 30. Oktober 2026
- cpsjul22.pdf
Technische Census-Dokumentation von 2022: Fragebogen und Gewichtungsanweisungen erläutern die Teilnahmeberechtigung für Kern 1, die Ergänzungsgewichte und den Skalierungsfaktor des Kerns. Die Bücherfrage nennt ausdrücklich gedruckte und elektronische Bücher; bei Nichtverfügbarkeit der befragten Person sind Stellvertreterauskünfte erlaubt. Diese Änderungen begrenzen die Interpretation zwischen Erhebungswellen.
Abgerufen am 30. Oktober 2026
- SPPA_Comprehensive_Report_FINAL.pdf
Umfassender NEA-Bericht zum SPPA 2022: bietet amtlichen Kontext und veröffentlichte Teilnahmeschätzungen, nicht die individuellen Eingabedaten unserer bedingten Berechnungen. Seine veröffentlichten Randanteile dürfen nicht durcheinander geteilt werden, um die Lektüre fiktionaler Texte unter Buchlesenden zu schätzen.
Abgerufen am 30. Oktober 2026
- SPPA_2022_Technical_Appendix_FINAL.pdf
Technischer NEA-Anhang von 2022: begründet die replikationsbasierte Unsicherheitsschätzung, einschließlich BRR mit Fay-Faktor 0,5 und einer Varianz auf Grundlage des mittleren quadratischen Fehlers. Die Varianz unserer Quotienten über 160 Replikationen verwendet den entsprechenden Faktor 4/160.
Abgerufen am 30. Oktober 2026
- cps_ppa_repwgt_jul17.sas
SAS-Dateibeschreibung der Census-Replikationsdatei von 2017: dokumentiert die Kennungen QSTNUM/OCCURNUM, die Replikationsfelder 0–160 und vier implizite Dezimalstellen. Sie bestätigt das Einlesen der Felder und deren Skalierung; es handelt sich um Dokumentationscode, nicht um Personenbeobachtungen.
Abgerufen am 30. Oktober 2026
- cps_ppa_repwgt_jul22.sas
SAS-Dateibeschreibung der Census-Replikationsdatei von 2022: dokumentiert den Aufbau der Ergänzungs-Replikationsdatei und die Skalierung der Gewichte und ermöglicht so die Prüfung der Gewichte in der CSV von 2022. Die gemeinsame Skalierung kürzt sich in Quotienten heraus; rohe Gewichtssummen werden nicht als Personenzahlen angegeben.
Abgerufen am 30. Oktober 2026
Studie zitieren und weiterverwenden
Alisson Bento. Belletristik und Buchlektüre: Was die US-Erhebungen von 2017 und 2022 über ihre Überschneidung zeigen. Eigene Sekundäranalyse öffentlicher SPPA-Daten des Census Bureau / National Endowment for the Arts; abgerufen am 30. Oktober 2026. https://alissonbento.com/de/research/us-fiction-book-reading-overlap-2017-2022/
Eigene Berechnungen und Erläuterungen: Alisson Bento. Quelle: U.S. Census Bureau / National Endowment for the Arts, SPPA 2017 und 2022. Bedingten Nenner, Erhebungsjahre, erwachsene Haushaltsbevölkerung, Intervalle und Vorbehalte zu Stellvertreterantworten und Wortlaut erhalten. Keine offizielle Billigung wird behauptet. Öffentliche Downloads enthalten Aggregate und Code; personenbezogene Rohdateien und Replikatgewichte werden hier nicht weiterverbreitet. Abbildungen oder Logos fremder Berichte werden durch diese Analyse nicht lizenziert.
Korrekturen oder redaktionelle Fragen