Quels lecteurs figurent au dénominateur ?
Une statistique sur la fiction peut décrire plusieurs populations : tous les adultes, les lecteurs de livres, les lecteurs de romans ou encore les clients d’un genre éditorial. Ces ensembles se recoupent, mais ne sont pas interchangeables. L’étude pose une question précise : parmi les adultes déclarant avoir lu un livre au cours des douze derniers mois, combien déclarent aussi avoir lu des romans ou des nouvelles ? La réponse concerne la composition d’un public lecteur défini par enquête. Elle ne mesure ni la demande de livres, ni la fidélité à un genre, ni la probabilité d’adhérer à un groupe de lecture.
L’analyse utilise les réponses individuelles de la Survey of Public Participation in the Arts de 2017 et 2022, recueillies dans la Current Population Survey du U.S. Census Bureau pour le National Endowment for the Arts. Chaque estimation relie les réponses sur le livre et sur la fiction pour une même personne. Ce lien est indispensable, car la question sur la fiction englobe d’autres supports que les livres. Le résultat mesure donc un chevauchement, et non un rapport construit à partir de deux pourcentages publiés séparément. Les tableaux par âge et niveau d’études prolongent le même calcul sans changer la règle du dénominateur. Les résultats concernent les années d’enquête, pas les pratiques de 2026. Les deux vagues décrivent des échantillons différents plutôt qu’un suivi des mêmes lecteurs.
Ce que couvrent les deux questions
La question générale porte sur la lecture de livres pendant les douze derniers mois, hors ouvrages imposés par le travail ou les études. La question sur la fiction porte séparément sur les romans ou nouvelles, y compris ceux publiés dans des livres, magazines ou journaux, sur papier ou en ligne. Une nouvelle lue sur un site peut donc compter comme fiction même si la personne ne déclare aucune lecture de livre. Inversement, une personne peut lire des livres d’histoire, des ouvrages pratiques ou religieux sans déclarer de roman ni de nouvelle. Aucune des réponses n’est erronée simplement parce qu’elle diffère de l’autre.
La formulation comporte des limites importantes. La question sur la fiction ne reprend pas l’exclusion des lectures imposées par le travail ou les études ; l’analyse ne l’applique donc pas implicitement à toute la fiction déclarée. Les questions distinctes sur l’écoute ne sont pas ajoutées au numérateur, même si certains répondants ont pu comprendre la lecture au sens large. En 2022, le questionnaire cite explicitement les livres imprimés et électroniques ; celui de 2017 comporte plutôt une précision sur les textes religieux. Cette différence doit être examinée avec l’évolution des réponses par un tiers. Les résultats n’isolent ni la romance, ni la fiction littéraire, ni les romans achevés, achats, emprunts, pages ou durées. Une seule nouvelle déclarée suffit à répondre positivement à la question sur la fiction.
Le chevauchement global et les limites de sa comparaison
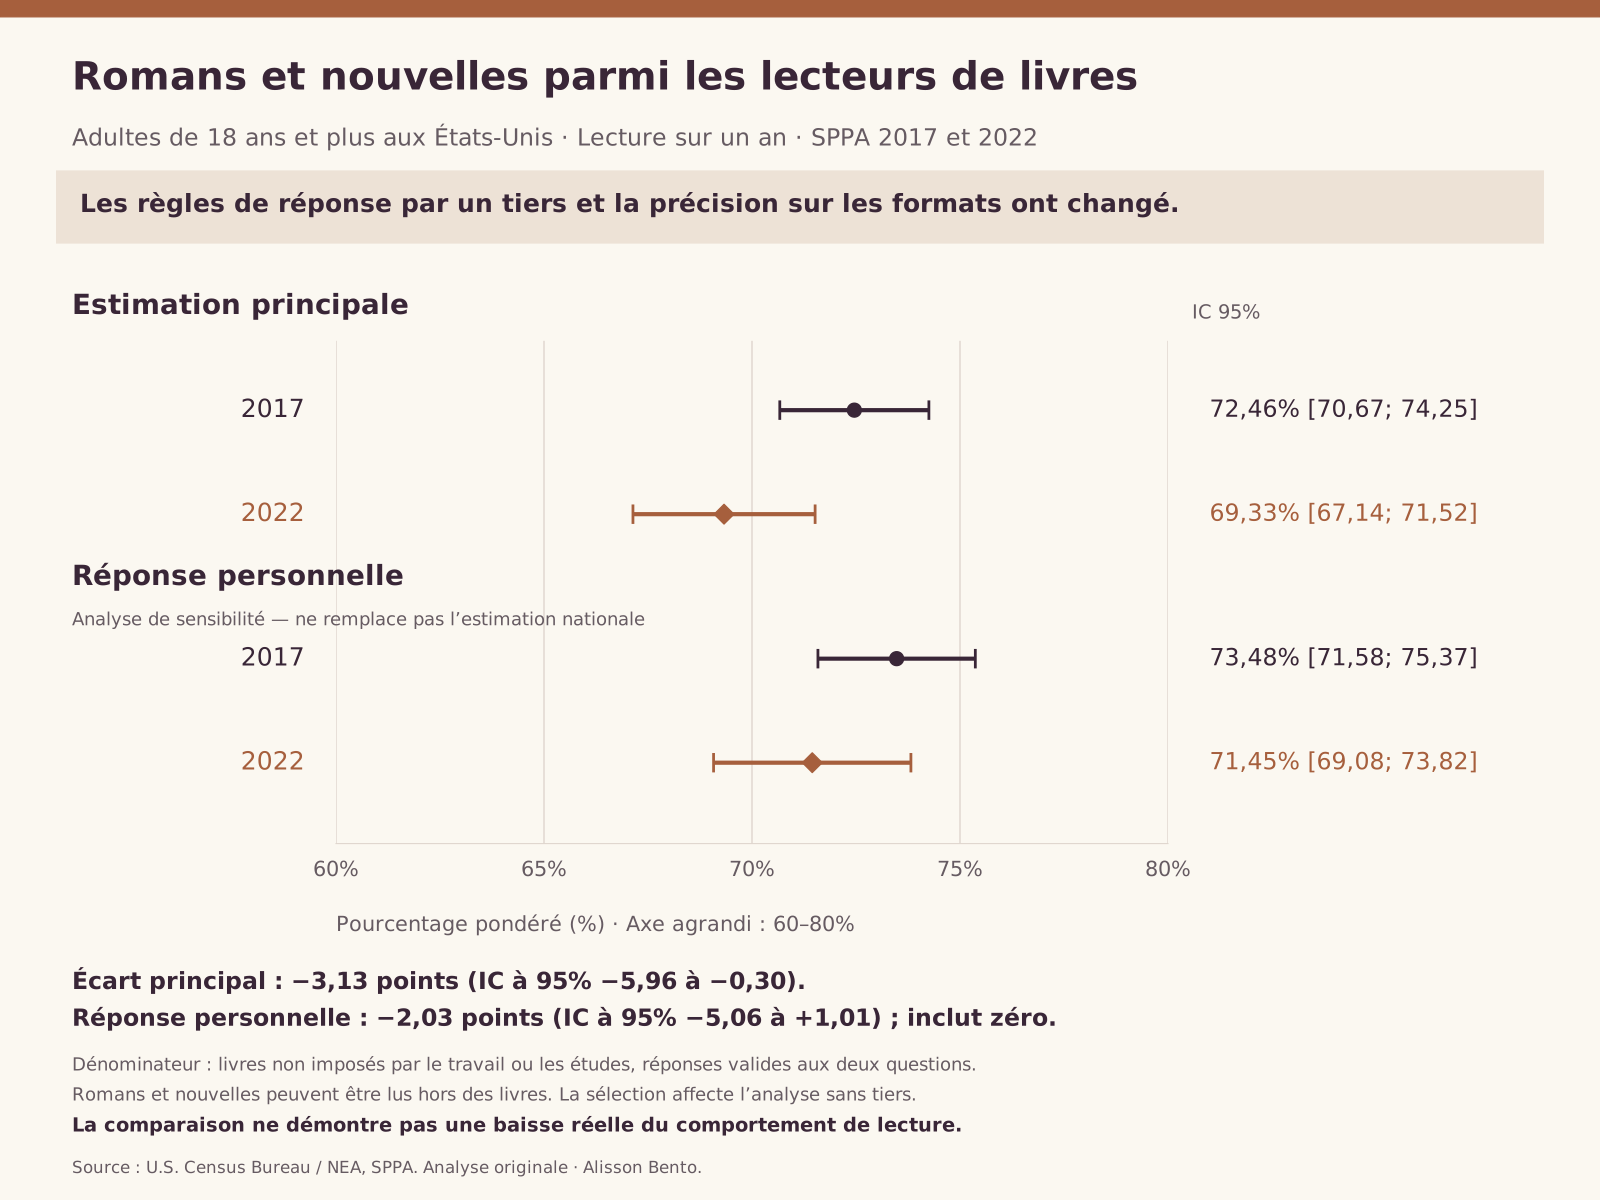
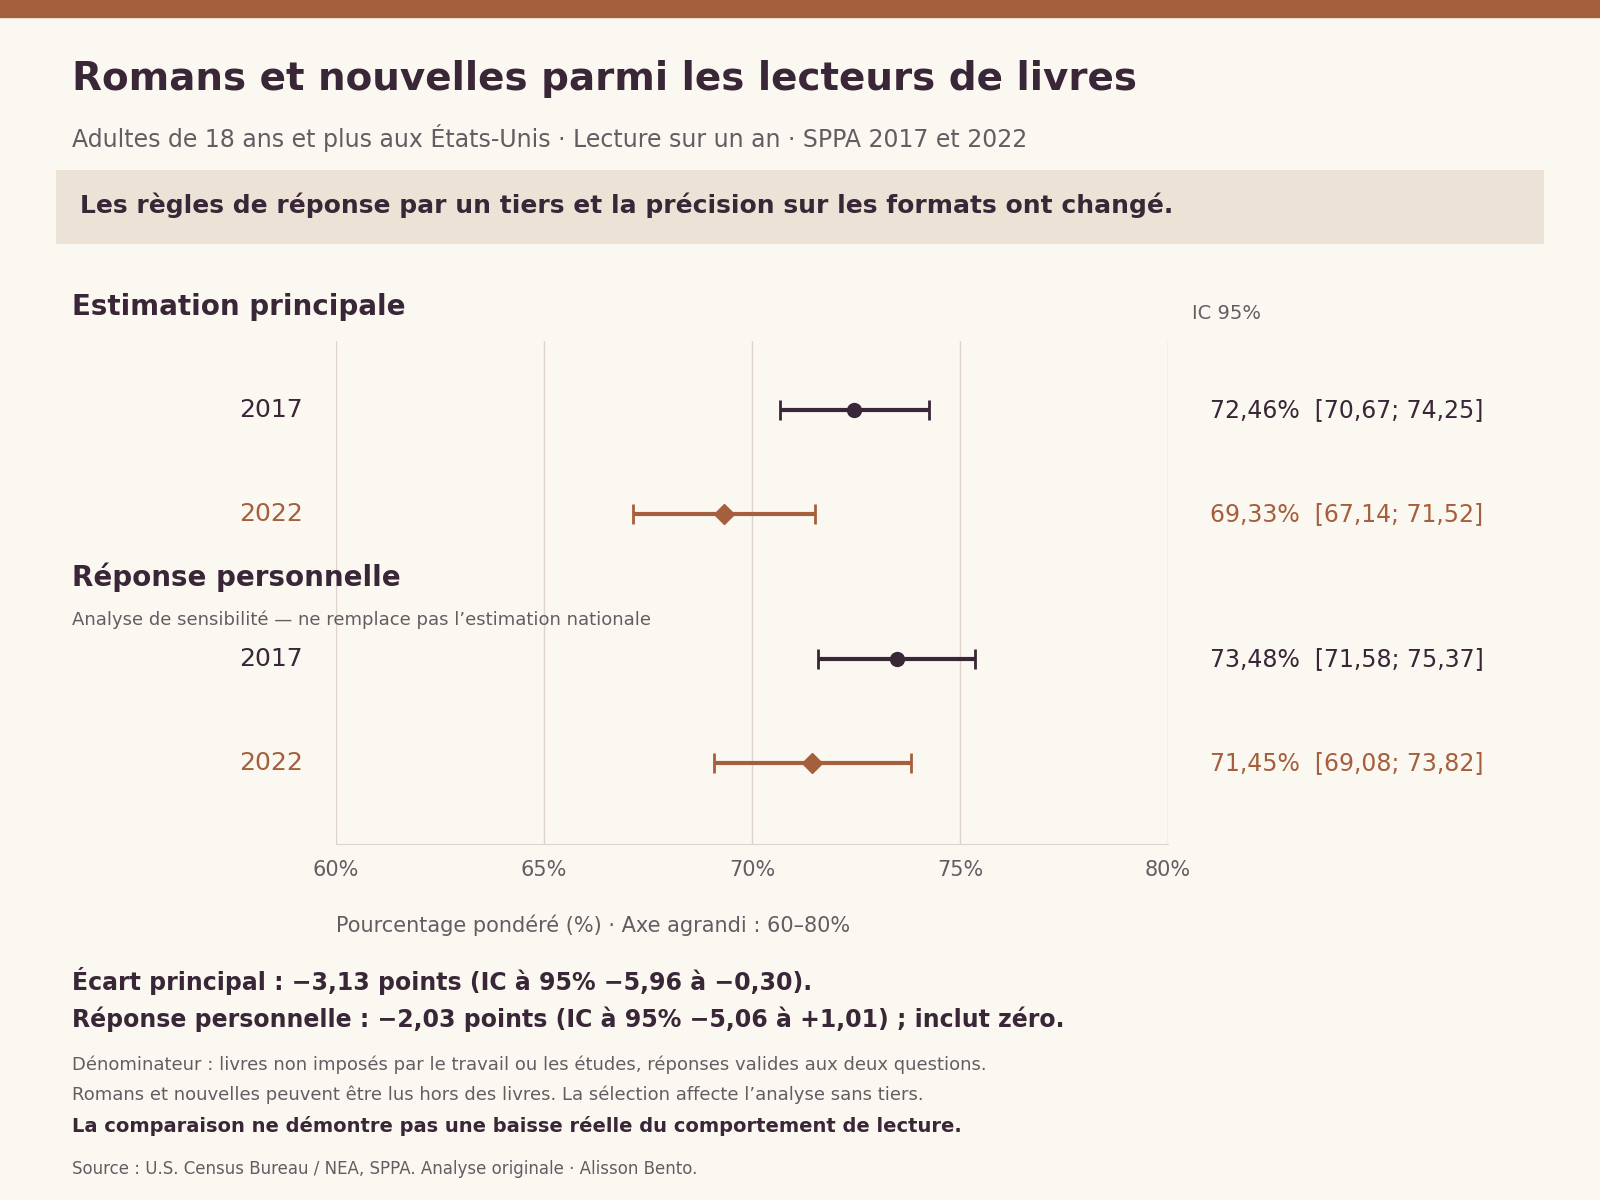
Parmi les lecteurs de livres ayant répondu valablement oui ou non à la question sur la fiction, la part pondérée de fiction atteint 72,46 % en 2017 et 69,33 % en 2022. Les dénominateurs non pondérés comptent respectivement 4 813 et 3 336 personnes. Dans ces échantillons, 3 561 et 2 372 répondants déclarent les deux activités. Les intervalles de confiance à 95 % vont de 70,67 % à 74,25 % pour 2017 et de 67,14 % à 71,52 % pour 2022. Ils utilisent les poids de réplication fournis pour le supplément, au lieu de supposer un échantillonnage indépendant et équiprobable de chaque personne.
L’écart global est de −3,13 points de pourcentage, avec un intervalle de confiance à 95 % de −5,96 à −0,30. Il décrit la différence entre deux estimations d’enquête pondérées. Il ne doit pas être présenté sans réserve comme une baisse du comportement sous-jacent. Les conditions autorisant une réponse par un tiers ont changé, la proportion de ces réponses a augmenté et la question sur les livres a gagné une précision sur le format électronique. Dans l’analyse de sensibilité limitée aux réponses personnelles, l’écart est de −2,03 points et son intervalle contient zéro. Toute synthèse de la comparaison globale doit placer cette réserve à côté du résultat. Un calcul peut être exact alors que son interprétation temporelle reste limitée par les conditions de collecte.
Pourquoi diviser deux pourcentages globaux donne une réponse incorrecte
Un pourcentage conditionnel exige le nombre de personnes satisfaisant simultanément les deux conditions. Diviser la proportion déclarant de la fiction par celle déclarant des livres ne fonctionnerait que si chaque lecteur de fiction appartenait aussi au groupe des lecteurs de livres, avec des dénominateurs autrement identiques. Les libellés ne permettent de supposer aucune de ces conditions. Certaines personnes répondent explicitement non aux livres et oui aux romans ou nouvelles. Le questionnaire le permet, car les récits peuvent se lire hors des livres. Le bon numérateur est donc l’intersection pondérée des deux réponses positives.
Les réponses observées rendent le problème concret. Parmi les non-lecteurs de livres ayant des réponses valides aux deux questions, 7,92 % déclarent de la fiction en 2017 et 7,65 % en 2022. Ces personnes contribuent à la prévalence générale de la fiction, mais ne doivent pas entrer au numérateur de la fiction parmi les lecteurs de livres. Les tableaux conservent les deux mesures conditionnelles pour rendre la distinction vérifiable. Il ne faut pas les additionner : leurs dénominateurs diffèrent. De même, une mesure large de lecture littéraire réunissant romans, récits, poésie et théâtre ne peut remplacer automatiquement notre mesure de fiction. Chaque rapport proposé demande d’abord de définir les ensembles de répondants concernés.
Les réponses par un tiers pèsent sur l’interprétation
Les consignes montrent une modification des circonstances dans lesquelles un enquêteur peut accepter une réponse au nom d’autrui. En 2017, cette possibilité est limitée à des situations définies de rappel, de clôture ou d’irritation du ménage. En 2022, elle est autorisée lorsque la personne est indisponible. Parmi les lecteurs de livres aux réponses complètes retenus ici, la part pondérée des réponses par un tiers passe de 19,60 % à 28,22 %. Trois cas complets de 2022 ont un indicateur de réponse par un tiers inconnu et restent inclus dans l’estimation globale. Le mode de réponse et la disponibilité des personnes peuvent affecter une comparaison malgré des questions de lecture apparemment proches.
En limitant le calcul aux réponses personnelles, les parts de fiction sont de 73,48 % en 2017 et 71,45 % en 2022. Les dénominateurs sont de 4 124 et 2 660 personnes. L’écart de −2,03 points possède un intervalle à 95 % allant de −5,06 à +1,01 : cette sensibilité ne distingue donc pas l’évolution de zéro à ce niveau de confiance. Ces estimations ne sont pas automatiquement meilleures pour la population : les personnes disponibles pour répondre elles-mêmes peuvent différer de celles représentées par un tiers. L’exercice révèle plutôt une véritable limite d’interprétation. Les données ne répartissent pas l’écart global entre comportements, formulation, mode de réponse, composition de l’échantillon ou autres facteurs non mesurés.
Les écarts d’âge ne constituent pas un diagnostic générationnel
Le tableau par âge applique le même calcul parmi les lecteurs de livres à sept tranches, de 18–24 ans à 75 ans et plus. La comparaison reste centrée sur les personnes déclarant des livres, sans laisser la fréquence de la lecture de livres elle-même définir le résultat. Les estimations ne suivent pas une cohorte de naissance. Une personne appartenant à une tranche en 2017 peut en avoir changé en 2022, et les échantillons sont différents. Employer une étiquette telle que « génération Z » introduirait une définition supplémentaire non établie par cette analyse.
La part de fiction du groupe le plus jeune est de 70,84 % en 2017 et de 63,81 % en 2022, mais l’intervalle de son évolution est large et contient zéro. Son dénominateur de 2022 ne compte que 183 lecteurs de livres aux réponses complètes. Pour les 65–74 ans, les estimations sont de 75,87 % et 67,51 % ; ce contraste exige lui aussi les réserves générales sur les tiers et la formulation. Le tableau complet est plus utile qu’un classement des estimations ponctuelles, car il montre les effectifs et l’incertitude. Les directions numériques diffèrent selon les groupes, et les petits écarts ne sont pas des séparations fiables. Aucune correction des comparaisons multiples n’est appliquée : ces contrastes sont exploratoires, non une série de résultats indépendamment confirmés sur les générations.
Le niveau d’études décrit une association, pas l’effet de la scolarité
Le tableau répartit les personnes selon leur niveau d’études déclaré : secondaire non achevé, diplôme de fin du secondaire, études supérieures partielles ou associate degree, bachelor et études supérieures après le bachelor (graduate). Dans chaque groupe, le dénominateur reste constitué des personnes déclarant des livres et répondant à la question sur la fiction. Cela diffère d’une question sur la probabilité de lire un livre quelconque selon le niveau d’études. Conditionner l’analyse à la lecture de livres restreint délibérément la question ; l’association ne peut être généralisée en effet de la scolarité dans toute la population adulte.
En 2022, les estimations de fiction parmi les lecteurs vont de 58,85 % chez les personnes sans diplôme de fin du secondaire à 76,33 % chez celles ayant poursuivi des études après le bachelor (graduate). La première repose sur 112 lecteurs de livres aux réponses complètes et demeure plus incertaine que celles des groupes plus nombreux. Le groupe études supérieures partielles ou associate degree présente 73,05 % en 2017 et 64,00 % en 2022. Cet écart exploratoire ne justifie aucune conclusion sur certains cours, établissements ou compétences de lecture. L’âge, le ménage, le revenu, l’activité professionnelle et le mode de réponse peuvent différer entre niveaux d’études. Aucun modèle causal n’est ajusté pour isoler leurs contributions. Les tableaux décrivent des associations et rendent visibles les éléments qui interdisent des explications trop assurées.
Un contrôle limité des changements de composition du lectorat
La répartition des âges et diplômes parmi les lecteurs de livres peut évoluer entre enquêtes. Pour l’examiner descriptivement, les calculs complémentaires maintiennent une distribution à la fois à sa composition de 2017 parmi les lecteurs aux réponses complètes. La standardisation par âge applique les mêmes parts de groupes d’âge de 2017 aux estimations internes à chaque groupe dans les deux vagues. La standardisation par niveau d’études répète l’opération avec les diplômes. Les deux ajustements répondent à des questions distinctes : ils ne contrôlent pas conjointement âge et diplôme, ni l’ensemble des différences de composition possibles.
Avec la répartition des âges de 2017 comme référence, la part de fiction de 2022 atteint 69,36 %, proche des 69,33 % non ajustés. Avec la distribution des diplômes de 2017, elle est de 68,89 %. Chaque ajustement pris séparément ne semble donc pas effacer le contraste global chiffré. Il ne résout toutefois ni les changements de consignes pour les tiers ni ceux de formulation. Les erreurs-types traitent les parts de référence comme fixes, bien qu’elles soient estimées par enquête. Les résultats standardisés sont donc des sensibilités descriptives, pas un nouveau test de significativité ajusté. Une analyse d’incertitude inconditionnelle devrait aussi intégrer l’estimation de la distribution de référence et les covariances pertinentes.
Les réponses manquantes restent visibles
Le dénominateur principal exclut les lecteurs de livres dont la réponse sur la fiction manque, est refusée ou demeure inconnue. Il ne recode pas ces réponses en non. En 2017, 4 848 lecteurs de livres sont observés, dont 35 sans réponse valide sur la fiction ; en 2022, ils sont 3 359, dont 23 sans réponse valide. Après pondération, ces absences représentent respectivement 1,38 % et 0,97 % des lecteurs observés. Les sauts structurels liés à l’autre noyau du questionnaire sont distingués de ces exclusions pour non-réponse à un item. Ne pas avoir reçu une question ne constitue pas une preuve de non-participation.
Un contrôle simple attribue successivement non puis oui à toutes les réponses de fiction manquantes. Les bornes obtenues sont de 71,46 % à 72,84 % en 2017 et de 68,66 % à 69,62 % en 2022. Elles montrent l’effet maximal de cette non-réponse observée sous ces affectations. Ce ne sont pas des intervalles de confiance ; elles ne traitent ni les réponses manquantes sur les livres, ni la non-réponse générale, ni les déclarations inexactes. Exiger des réponses valides aux deux questions peut aussi produire un pourcentage marginal différent d’une publication officielle employant un autre dénominateur. Ces écarts doivent être expliqués, non corrigés silencieusement pour faire ressembler le calcul original à un chiffre arrondi déjà publié.
Calcul des poids et des intervalles de confiance
Les deux variables de lecture appartiennent au Core One dans chacune des enquêtes. Le calcul utilise le poids du supplément SPPA, et non un poids général de l’enquête sur la population active. Pour chaque estimation, l’effectif pondéré satisfaisant le numérateur est divisé par celui satisfaisant le dénominateur. Le facteur de mise à l’échelle de population propre au noyau s’annule dans ce rapport, tout comme l’échelle décimale implicite commune des champs de poids téléchargés. L’étude publie des pourcentages et effectifs d’échantillon, pas des nombres nationaux estimés de personnes. Les sommes brutes de poids du fichier de validation sont des diagnostics et ne doivent pas être présentées comme des totaux de population.
L’incertitude est calculée en répétant le rapport complet avec chacun des 160 poids de réplication du supplément. La variance vaut quatre divisés par 160, multipliés par la somme des carrés des écarts entre les estimations répliquées et l’estimation complète. Les intervalles normaux utilisent 1,96 erreur-type de chaque côté. Pour les différences entre vagues, l’erreur-type est la racine de la somme des deux variances, les enquêtes espacées de cinq ans étant traitées comme des coupes indépendantes. Une implémentation indépendante a reproduit les résultats globaux et les 24 cellules d’âge et d’études de l’indicateur principal, effectifs et erreurs-types compris. Cette réplication contrôle le calcul et le code, sans supprimer les biais de mémoire, de désirabilité sociale, de réponse par un tiers ou autres biais non liés à l’échantillonnage.
Ce que cette analyse apporte aux autres statistiques de lecture
Les carnets d’emploi du temps, les ventes de livres et les enquêtes annuelles de participation répondent à des questions différentes. Un carnet indique si la lecture a eu lieu un jour donné et combien de temps elle a duré. Une série de ventes enregistre des transactions dans son propre périmètre. La SPPA interroge la participation sur douze mois et accepte des réponses personnelles ou par un tiers. L’analyse complète donc une étude des jours de lecture sans fournir une version supplémentaire de la même mesure. Une personne peut déclarer un contact avec la fiction dans l’année sans noter aucune lecture un jour particulier, sans contradiction.
Pour les bibliothèques, groupes de lecture et chercheurs, l’apport est un dénominateur défendable et une explication du rôle des définitions. Le reste des lecteurs de livres, sans fiction déclarée, ne doit pas devenir un public commercial inexploité. Certains préfèrent d’autres textes, rencontrent de la fiction sans l’identifier ainsi ou déclarent imparfaitement leurs pratiques. L’enquête ne demande pas s’ils souhaitent davantage de fiction, achèteraient un livre conseillé ou répondraient à une campagne. La participation ne renseigne ici ni la qualité littéraire, ni la compréhension, ni la valeur personnelle. Un usage pratique doit partir de la question et de la population observées, sans transformer un pourcentage conditionnel en jugement commercial ou culturel non soutenu par la source.
Sources, reproductibilité et réutilisation responsable
Les fichiers sources ont été téléchargés directement depuis les pages publiques du Census Bureau pour la SPPA de 2017 et 2022. Ces accès fournissent les observations, les poids de réplication et la documentation technique sans compte, affiliation institutionnelle ni clé API. Les rapports officiels du NEA apportent le contexte méthodologique. Le manifeste conserve les URL, les tailles téléchargées en octets et les empreintes cryptographiques afin qu’un autre analyste identifie exactement les entrées. Les scripts publics récupèrent ces fichiers officiels dans un répertoire local et calculent les agrégats publiés. Télécharger les sources pour reproduire l’analyse est distinct de leur redistribution sur ce site.
Seuls les résultats agrégés, méthodes, références et code appartiennent au dossier public. Les enregistrements individuels et fichiers de poids restent hors du dépôt de publication. Toute réutilisation d’un tableau doit conserver les années, la population adulte vivant en ménage, le dénominateur conditionnel, l’incertitude et les réserves sur les tiers et la formulation. Les conclusions concernent les adultes civils non institutionnalisés de 18 ans et plus, pas les enfants ni les résidents d’institutions. Il s’agit d’une analyse secondaire originale, sans soutien implicite du Census Bureau ou du National Endowment for the Arts. De futures enquêtes pourront offrir une nouvelle comparaison, mais leurs questions et modes de collecte devront être vérifiés avant ajout à la série. Reproduire l’étude signifie préserver ses limites d’interprétation autant que ses chiffres.
Romans et nouvelles parmi les lecteurs de livres
Adultes de 18 ans et plus aux États-Unis · Lecture sur un an · SPPA 2017 et 2022. Estimation et intervalle de confiance à 95%.
Graphique complet et source
Faites défiler le graphique horizontalement pour le consulter. ↔
Graphique et valeurs
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Année | Périmètre des réponses | Effectif du dénominateur | Effectif des deux oui | Pourcentage pondéré | Borne inférieure de l’IC à 95 % | Borne supérieure de l’IC à 95 % |
|---|---|---|---|---|---|---|
| 2017 | Toutes réponses | 4813 | 3561 | 72.46 | 70.67 | 74.25 |
| 2022 | Toutes réponses | 3336 | 2372 | 69.33 | 67.14 | 71.52 |
| 2017 | Réponses personnelles seules | 4124 | 3085 | 73.48 | 71.58 | 75.37 |
| 2022 | Réponses personnelles seules | 2660 | 1919 | 71.45 | 69.08 | 73.82 |
Condition : livres déclarés et réponse valide sur la fiction ; estimations pondérées, effectifs non pondérés. Les consignes pour les tiers et la formulation sur les livres ont changé. L’intervalle de l’évolution des réponses personnelles contient zéro ; la comparaison globale n’est pas une estimation causale du comportement.
Télécharger le graphique (SVG) ↓ · Télécharger le graphique (PNG) ↓
Données et téléchargements
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Année | Périmètre des réponses | Effectif du dénominateur | Effectif des deux oui | Pourcentage pondéré | Borne inférieure de l’IC à 95 % | Borne supérieure de l’IC à 95 % |
|---|---|---|---|---|---|---|
| 2017 | Toutes réponses | 4813 | 3561 | 72.46 | 70.67 | 74.25 |
| 2022 | Toutes réponses | 3336 | 2372 | 69.33 | 67.14 | 71.52 |
| 2017 | Réponses personnelles seules | 4124 | 3085 | 73.48 | 71.58 | 75.37 |
| 2022 | Réponses personnelles seules | 2660 | 1919 | 71.45 | 69.08 | 73.82 |
Condition : livres déclarés et réponse valide sur la fiction ; estimations pondérées, effectifs non pondérés. Les consignes pour les tiers et la formulation sur les livres ont changé. L’intervalle de l’évolution des réponses personnelles contient zéro ; la comparaison globale n’est pas une estimation causale du comportement.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Année | Groupe | Effectif du dénominateur | Effectif des deux oui | Pourcentage pondéré | Borne inférieure de l’IC à 95 % | Borne supérieure de l’IC à 95 % |
|---|---|---|---|---|---|---|
| 2017 | 18-24 | 295 | 219 | 70.84 | 64.34 | 77.34 |
| 2017 | 25-34 | 808 | 596 | 73.62 | 69.82 | 77.43 |
| 2017 | 35-44 | 769 | 571 | 72.58 | 68.61 | 76.56 |
| 2017 | 45-54 | 702 | 504 | 70.64 | 66.52 | 74.77 |
| 2017 | 55-64 | 875 | 650 | 71.60 | 67.88 | 75.32 |
| 2017 | 65-74 | 823 | 622 | 75.87 | 71.79 | 79.95 |
| 2017 | 75+ | 541 | 399 | 71.58 | 66.76 | 76.40 |
| 2022 | 18-24 | 183 | 121 | 63.81 | 53.84 | 73.79 |
| 2022 | 25-34 | 515 | 380 | 73.48 | 68.92 | 78.03 |
| 2022 | 35-44 | 578 | 428 | 66.79 | 61.36 | 72.21 |
| 2022 | 45-54 | 474 | 339 | 74.28 | 69.97 | 78.59 |
| 2022 | 55-64 | 526 | 358 | 67.56 | 62.34 | 72.78 |
| 2022 | 65-74 | 634 | 448 | 67.51 | 62.75 | 72.26 |
| 2022 | 75+ | 426 | 298 | 69.17 | 63.61 | 74.73 |
Estimations exploratoires par sous-groupe aux réponses complètes, tous modes de réponse. Sans correction des comparaisons multiples. Conserver effectifs, intervalles et limites liées aux tiers et à la formulation entre vagues.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Année | Groupe | Effectif du dénominateur | Effectif des deux oui | Pourcentage pondéré | Borne inférieure de l’IC à 95 % | Borne supérieure de l’IC à 95 % |
|---|---|---|---|---|---|---|
| 2017 | Secondaire non achevé | 221 | 115 | 55.90 | 46.97 | 64.82 |
| 2017 | Diplôme de fin du secondaire | 1010 | 679 | 65.21 | 61.42 | 69.00 |
| 2017 | Supérieur partiel / associate degree | 1383 | 1031 | 73.05 | 70.10 | 76.00 |
| 2017 | Bachelor | 1307 | 1009 | 76.41 | 73.33 | 79.50 |
| 2017 | Études supérieures après le bachelor (graduate) | 892 | 727 | 79.45 | 76.13 | 82.78 |
| 2022 | Secondaire non achevé | 112 | 60 | 58.85 | 47.06 | 70.65 |
| 2022 | Diplôme de fin du secondaire | 553 | 349 | 63.25 | 57.03 | 69.46 |
| 2022 | Supérieur partiel / associate degree | 948 | 646 | 64.00 | 59.79 | 68.20 |
| 2022 | Bachelor | 1005 | 764 | 75.80 | 72.48 | 79.12 |
| 2022 | Études supérieures après le bachelor (graduate) | 718 | 553 | 76.33 | 72.89 | 79.77 |
Estimations exploratoires par sous-groupe aux réponses complètes, tous modes de réponse. Sans correction des comparaisons multiples. Conserver effectifs, intervalles et limites liées aux tiers et à la formulation entre vagues.
Données et méthode
Notre méthode de calcul
- Analyse secondaire originale des fichiers publics réels de la SPPA du Census Bureau de juillet 2017 et juillet 2022. Les deux items de lecture relèvent du Core 1 ; les observations retenues ont au moins 18 ans et un poids de supplément positif.
- Numérateur principal : PEC1Q14A=1 et PEC1Q15A=1. Dénominateur : PEC1Q14A=1 et PEC1Q15A dans {1,2}. Les réponses de fiction manquantes sont exclues, non traitées comme Non. L’emboîtement des ensembles fiction et livres n’est pas supposé.
- PWSUPWGT est le poids ponctuel. Chaque rapport conditionnel est recalculé avec les 160 poids de réplication appariés ; variance = 4/160 fois la somme des écarts au carré. Les intervalles normaux à 95 % utilisent 1,96 erreur-type. Les variances indépendantes entre vagues sont additionnées pour les intervalles d’évolution.
- PUNXTPR3 identifie les groupes de sensibilité réponse personnelle/par un tiers. Des standardisations unidimensionnelles distinctes utilisent les parts fixes de 2017 par âge ou études parmi les lecteurs de livres aux réponses complètes. Elles sont descriptives, non conjointes, et ne constituent pas une inférence ajustée inconditionnelle.
- Une implémentation indépendante sur fichiers bruts a reproduit les résultats globaux et les 24 cellules principales âge/études à une tolérance de 1e-9. Le plan et les contrôles ont été élaborés pendant l’analyse ; l’étude n’a pas fait l’objet d’un préenregistrement prospectif.
Ce que les données ne permettent pas de conclure
- Les consignes de réponse par un tiers sont devenues plus permissives en 2022 et leur part a augmenté. L’intervalle d’évolution des réponses personnelles contient zéro. Le contraste global ne doit pas être interprété comme un recul causal des pratiques à mesure constante.
- La question sur les livres de 2022 précise les formats imprimé/électronique ; celle de 2017 précise les textes religieux. La fiction comprend des supports hors livres et ne répète pas l’exclusion travail/études. Les questions d’écoute ne sont pas ajoutées.
- Mémoire annuelle, connaissance du tiers, non-réponse et désirabilité sociale peuvent biaiser les estimations. Les intervalles par réplication ne mesurent pas tous les biais hors échantillonnage. Le périmètre couvre les adultes civils non institutionnalisés vivant en ménage, âgés de 18 ans et plus, pas tous les résidents.
- Les petits sous-groupes sont imprécis ; les contrastes restent exploratoires sans correction de multiplicité. Les tranches d’âge ne sont pas des générations. Les associations avec les études ne sont pas des effets de la scolarité.
- Aucune intention d’achat, lecture de romance, lecture achevée, durée, qualité ou opportunité commerciale n’est mesurée. Il s’agit d’une seule étude originale avec éditions traduites, non d’études distinctes par langue ou sous-groupe.
Sources originales
- jul22pub.csv
CSV public du SPPA 2022 du Census : fournit les réponses individuelles sur les livres et la fiction, l’âge, le niveau d’études, l’indicateur de réponse personnelle ou par procuration et le poids du supplément utilisés pour les estimations de 2022. Les données individuelles brutes ne figurent pas dans les téléchargements publics de l’étude.
Consulté le 30 octobre 2026
- jul22rep.csv
CSV des poids de réplication du SPPA 2022 du Census : 160 poids du supplément, appariés par QSTNUM et OCCURNUM, permettent de calculer les erreurs-types des rapports. Le poids de la réplication zéro est comparé au poids principal ; les poids bruts ne sont pas des effectifs de population.
Consulté le 30 octobre 2026
- jul17pub.zip
ZIP public du SPPA 2017 du Census : les enregistrements individuels à largeur fixe fournissent les réponses et caractéristiques de 2017. Le champ fiction occupe les positions 1050–1051 ; sa structure ne doit pas être supposée identique à celle de 2022. Les données brutes restent hors du dossier public de l’étude.
Consulté le 30 octobre 2026
- jul17rep.zip
ZIP des poids de réplication du SPPA 2017 du Census : les poids du supplément à largeur fixe sont appariés aux enregistrements de 2017 pour recalculer chaque rapport conditionnel sur 160 réplications. Ce fichier sert à estimer l’incertitude, et non à produire une autre mesure de lecture.
Consulté le 30 octobre 2026
- cpsjul17.pdf
Documentation technique du Census de 2017 : les structures d’enregistrement et le questionnaire définissent les deux questions de lecture et la consigne plus restrictive concernant les réponses par procuration. La question sur les livres précise l’inclusion des textes religieux ; celle sur la fiction inclut des récits hors des livres.
Consulté le 30 octobre 2026
- cpsjul22.pdf
Documentation technique du Census de 2022 : le questionnaire et les consignes de pondération définissent l’éligibilité au noyau 1, les poids du supplément et le facteur d’échelle du noyau. La question sur les livres mentionne explicitement les formats imprimé et électronique, et la réponse par procuration est admise lorsque la personne est indisponible ; ces changements limitent l’interprétation entre vagues.
Consulté le 30 octobre 2026
- SPPA_Comprehensive_Report_FINAL.pdf
Rapport complet de la NEA sur le SPPA 2022 : apporte un contexte officiel et des estimations publiées de participation, mais pas les données individuelles utilisées dans nos calculs conditionnels. Diviser ses pourcentages marginaux publiés ne permet pas d’estimer la lecture de fiction parmi les lecteurs de livres.
Consulté le 30 octobre 2026
- SPPA_2022_Technical_Appendix_FINAL.pdf
Annexe technique de la NEA de 2022 : étaye l’estimation de l’incertitude par réplication, notamment BRR avec un facteur de Fay de 0,5 et une variance fondée sur l’erreur quadratique moyenne. La variance de nos rapports sur 160 réplications utilise le facteur correspondant 4/160.
Consulté le 30 octobre 2026
- cps_ppa_repwgt_jul17.sas
Structure SAS du fichier de réplication du Census de 2017 : documente les identifiants QSTNUM/OCCURNUM, les champs de réplication 0–160 et quatre décimales implicites. Elle valide la lecture des champs et leur échelle ; il s’agit de code documentaire, pas d’observations individuelles.
Consulté le 30 octobre 2026
- cps_ppa_repwgt_jul22.sas
Structure SAS du fichier de réplication du Census de 2022 : documente la structure du fichier de réplication du supplément et l’échelle des poids, afin de vérifier l’interprétation des poids du CSV de 2022. L’échelle commune s’annule dans les rapports ; les sommes brutes des poids ne sont pas présentées comme des nombres de personnes.
Consulté le 30 octobre 2026
Citer et réutiliser cette étude
Alisson Bento. Fiction et lecture de livres : ce que révèlent les enquêtes américaines de 2017 et 2022. Analyse secondaire originale des données publiques SPPA du Census Bureau / National Endowment for the Arts ; consultation le 30 octobre 2026. https://alissonbento.com/fr/research/us-fiction-book-reading-overlap-2017-2022/
Calculs originaux et présentation explicative : Alisson Bento. Source : U.S. Census Bureau / National Endowment for the Arts, SPPA 2017 et 2022. Conserver dénominateur conditionnel, années, population adulte vivant en ménage, intervalles et réserves sur les tiers et la formulation. Aucun soutien officiel implicite. Les téléchargements publics contiennent agrégats et code ; les fichiers individuels et poids de réplication ne sont pas redistribués ici. L’analyse n’accorde aucun droit sur les illustrations ou logos des rapports tiers.
Corrections ou questions éditoriales