¿Qué lectores componen el denominador?
Una estadística sobre ficción puede describir grupos distintos: todas las personas adultas, quienes leen libros, quienes leen novelas o quienes compran determinado género. Esos grupos se superponen, pero no son intercambiables. El estudio plantea una pregunta concreta: entre las personas adultas que declararon haber leído un libro durante los doce meses anteriores, ¿cuántas declararon también leer novelas o cuentos? La respuesta describe la composición de un público lector definido por la encuesta. No mide demanda de libros, fidelidad a un género ni probabilidad de incorporarse a un club de lectura.
El análisis utiliza respuestas individuales de la Survey of Public Participation in the Arts de 2017 y 2022, recogida mediante la Current Population Survey del U.S. Census Bureau para el National Endowment for the Arts. Cada estimación enlaza las respuestas sobre libros y ficción correspondientes a la misma persona. Ese vínculo importa porque la pregunta sobre ficción abarca materiales que no son libros. El resultado mide una intersección, no un cociente armado con dos porcentajes destacados independientes. Las tablas de edad y educación amplían el mismo cálculo sin modificar la regla del denominador. Todos los resultados se refieren a los años de encuesta, no a la lectura actual en 2026, y ambas ediciones describen muestras diferentes, sin seguir a los mismos lectores.
Qué abarcan las dos preguntas
La pregunta general sobre libros consulta la lectura durante los doce meses anteriores y excluye los libros exigidos por el trabajo o los estudios. La pregunta sobre ficción consulta por separado novelas o cuentos e incluye materiales publicados en libros, revistas, periódicos, en papel o en línea. Un cuento leído en una página web puede contar como ficción aunque la persona no declare leer libros. A la inversa, una persona puede leer libros de historia, temas prácticos o religión sin declarar ninguna novela o cuento. Una respuesta no es errónea simplemente porque difiera de la otra.
La redacción impone límites importantes. La pregunta de ficción no repite la exclusión de trabajo o estudios de la pregunta general; por tanto, este análisis no la impone silenciosamente a toda la ficción declarada. No se añaden al numerador las preguntas separadas sobre escucha, aunque algunas personas puedan haber entendido la lectura en sentido amplio. El cuestionario de 2022 menciona expresamente libros impresos y electrónicos; el de 2017 incluye, en cambio, una aclaración sobre textos religiosos. Esa diferencia merece atención junto con el cambio de respuestas por terceros explicado más adelante. Los resultados no aíslan novela romántica, ficción literaria, novelas terminadas, compras, préstamos bibliotecarios, páginas ni tiempo de lectura. Basta declarar un solo cuento para responder afirmativamente sobre participación en ficción.
La coincidencia general y los límites de su comparación
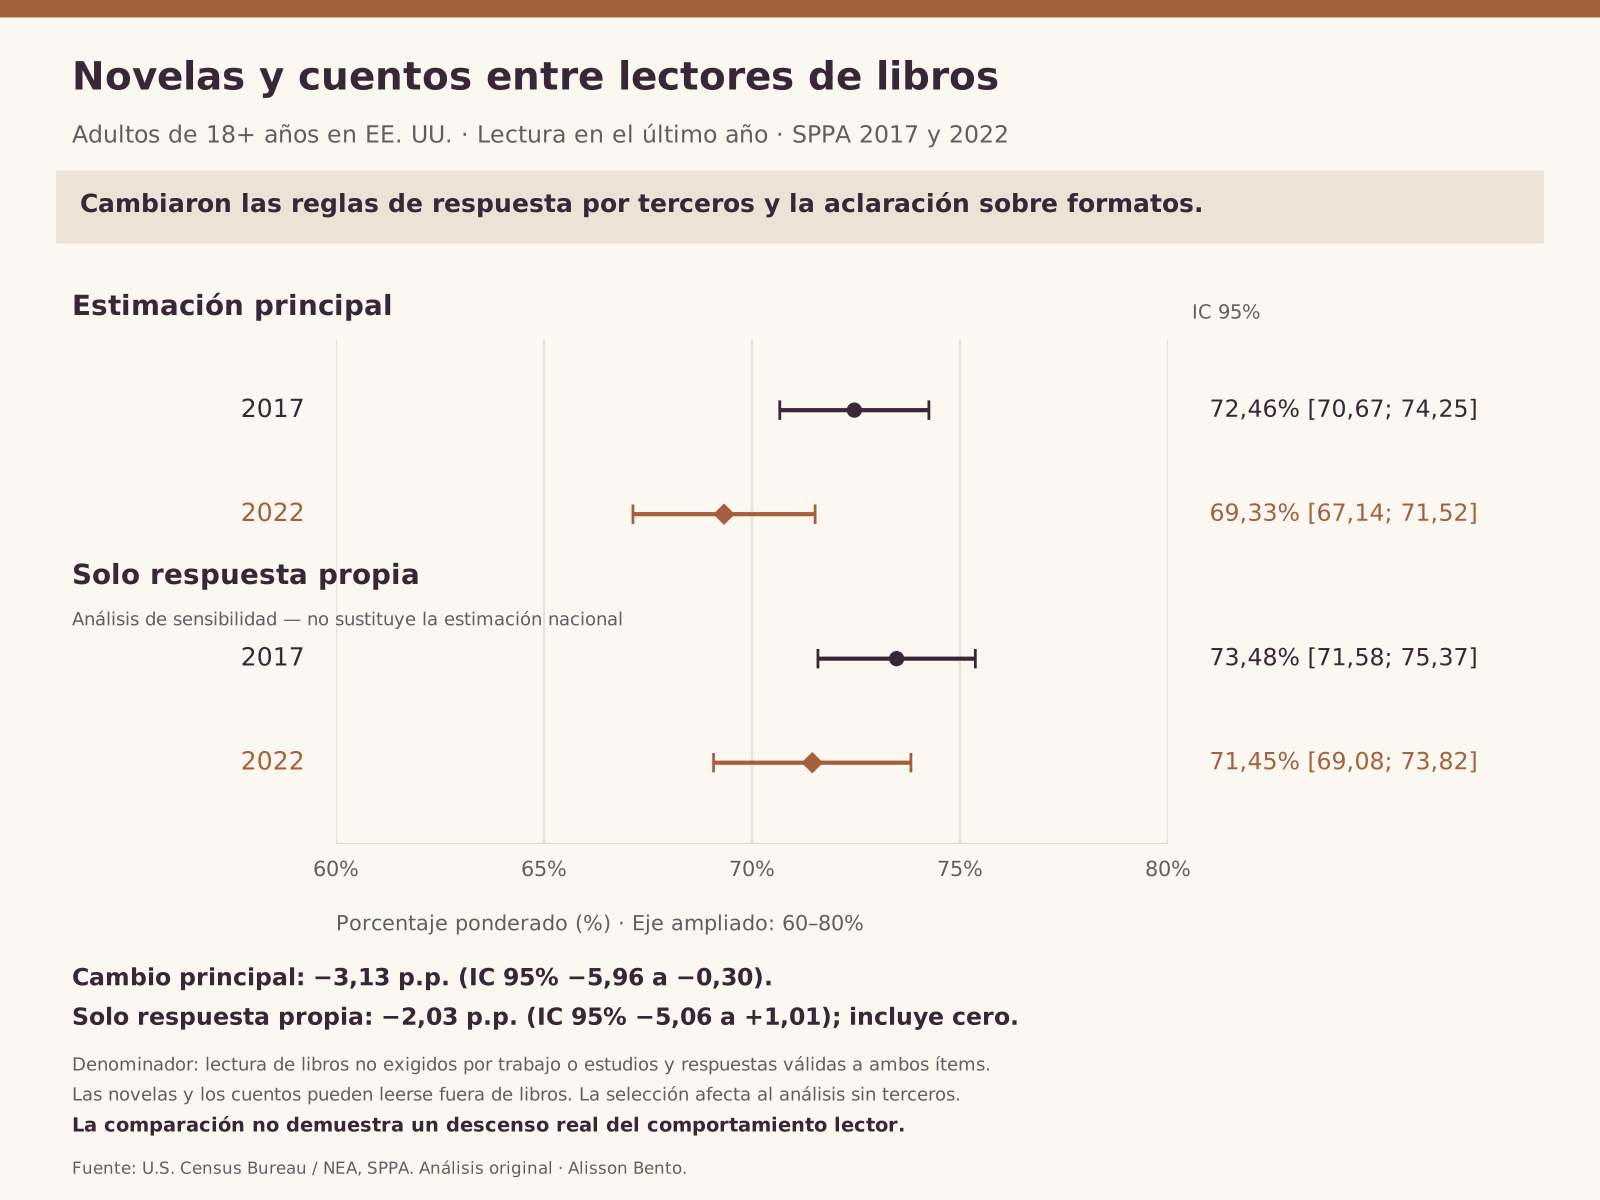
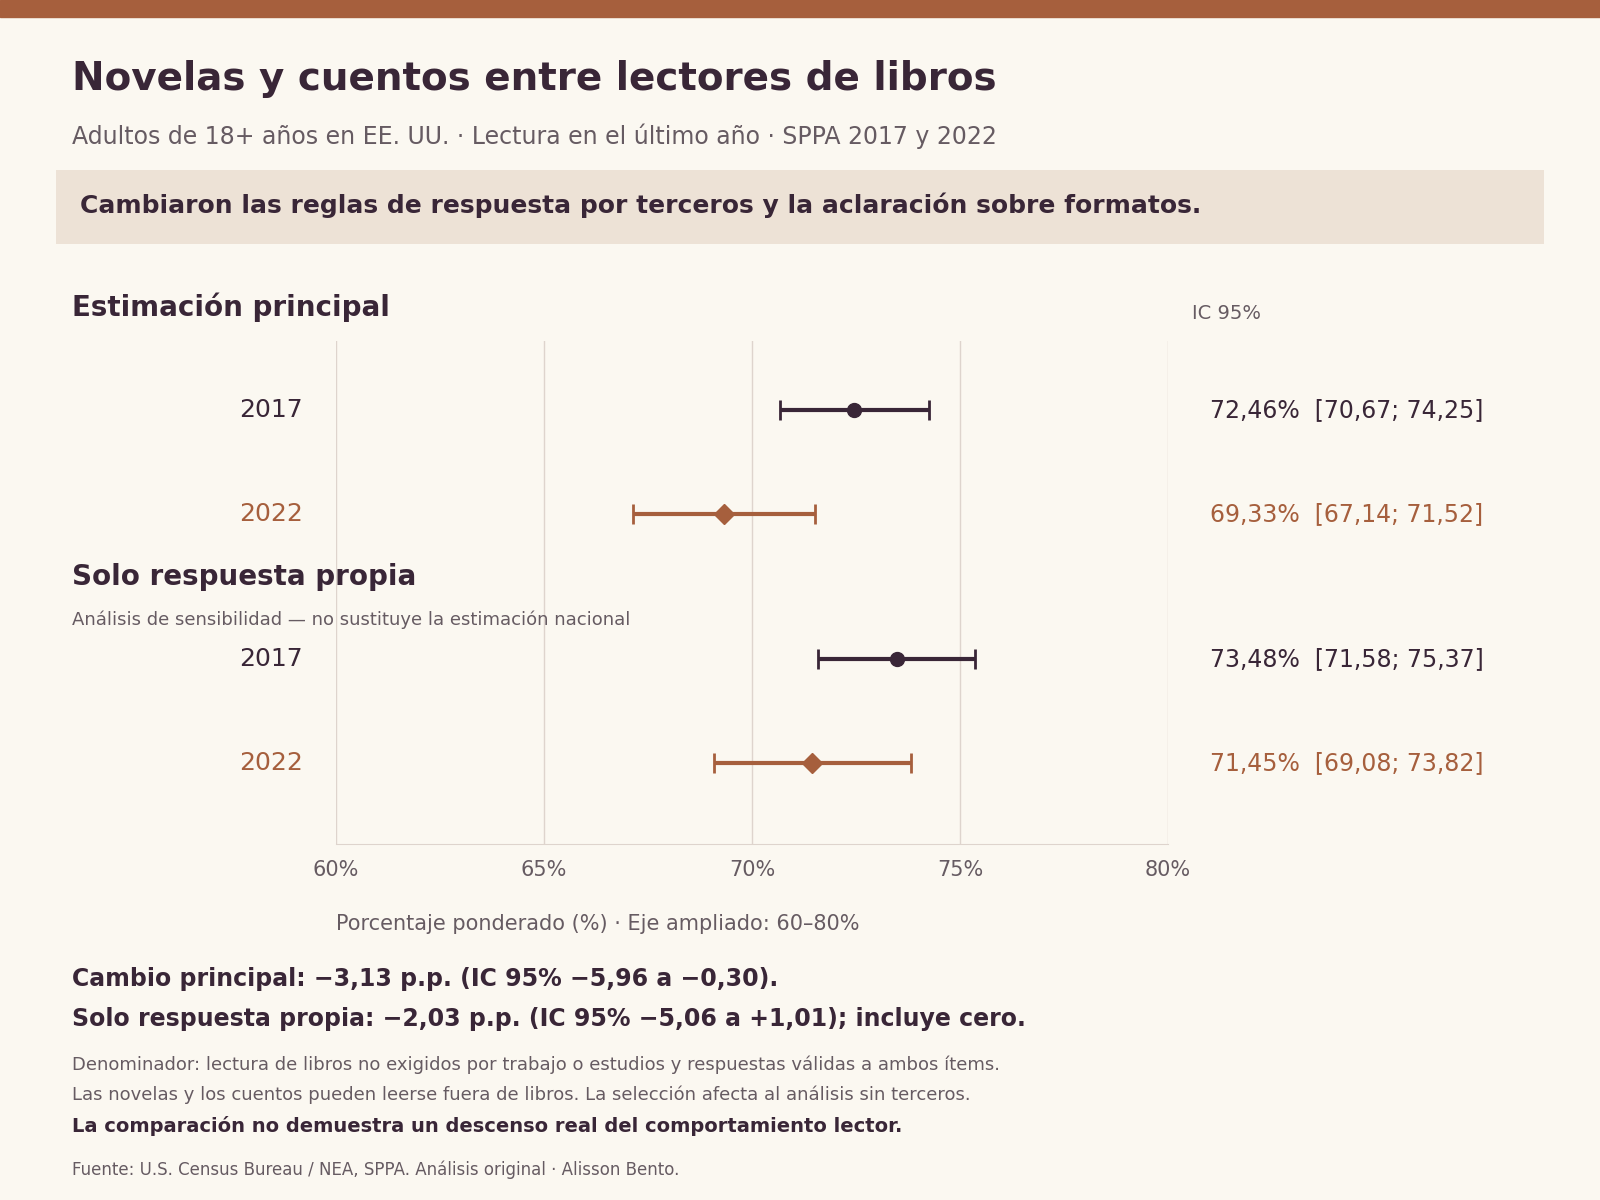
Entre lectores de libros con respuesta válida de sí o no a ficción, la proporción ponderada de ficción fue del 72,46% en 2017 y del 69,33% en 2022. Los denominadores sin ponderar fueron 4.813 y 3.336 personas. En esas muestras, respectivamente 3.561 y 2.372 declararon ambas actividades. Los intervalos de confianza del 95% fueron del 70,67% al 74,25% para 2017 y del 67,14% al 71,52% para 2022. Se calculan con las ponderaciones replicadas del suplemento, sin suponer que cada participante fue seleccionado de forma independiente y con igual probabilidad.
La diferencia general fue de −3,13 puntos porcentuales, con un intervalo del 95% entre −5,96 y −0,30. Es una diferencia descriptiva entre dos estimaciones ponderadas de encuesta. No debe presentarse como un descenso sin reservas del comportamiento subyacente. Cambió la admisibilidad de respuestas por terceros, aumentó su proporción y la pregunta sobre libros incorporó una aclaración del formato electrónico. En la sensibilidad limitada a respuestas propias, la diferencia fue de −2,03 puntos y su intervalo incluyó cero. Todo resumen de la comparación general necesita esa advertencia junto al resultado. Una estimación puede ser aritméticamente correcta y, al mismo tiempo, tener una interpretación entre encuestas limitada por cómo se recogieron las respuestas.
Por qué dividir porcentajes generales da una respuesta incorrecta
Un porcentaje condicional requiere el número de personas que cumplen ambas condiciones. Dividir el porcentaje que declara ficción entre el que declara libros solo funcionaría si cada lector de ficción perteneciera también al grupo lector de libros y los denominadores coincidieran en lo demás. Ninguna condición puede suponerse por las etiquetas. En estos datos hay personas que responden expresamente no a libros y sí a novelas o cuentos. El cuestionario permite esa combinación porque los relatos pueden leerse fuera de los libros. El numerador correcto de ficción entre lectores de libros es, por tanto, la intersección ponderada de las dos respuestas afirmativas.
Las respuestas observadas concretan el problema. Entre quienes no leían libros y respondieron válidamente a ambas preguntas, el 7,92% declaró ficción en 2017 y el 7,65% en 2022. Esas personas contribuyen a la prevalencia general de ficción, pero no deben entrar en un numerador que describe ficción dentro del público lector de libros. Las tablas públicas conservan ambas medidas condicionales para permitir comprobar la distinción. No deben sumarse: tienen denominadores diferentes. Por la misma razón, la lectura literaria amplia, que puede combinar novelas, cuentos, poesía y teatro, no sustituye automáticamente la medida de ficción del estudio. Cada cociente propuesto requiere definir sus conjuntos a nivel individual antes de calcularlo.
Las respuestas por terceros afectan sustancialmente a la interpretación
Las instrucciones del cuestionario muestran un cambio en cuándo podían aceptarse respuestas en nombre de otra persona. En 2017 se restringían a circunstancias especificadas de nuevas llamadas, cierre de entrevistas o molestias al hogar. En 2022 se permitían cuando la persona seleccionada no estaba disponible. Entre los lectores de libros con respuestas completas utilizados aquí, la proporción ponderada de respuestas por terceros aumentó del 19,60% al 28,22%. Tres casos completos de 2022 tenían un indicador desconocido de respuesta por terceros y permanecen en la estimación general. El modo de respuesta y la disponibilidad pueden influir en una comparación aunque las preguntas de lectura parezcan similares.
Al restringir el cálculo a respuestas propias se obtienen proporciones de ficción del 73,48% en 2017 y del 71,45% en 2022. Los denominadores son 4.124 y 2.660 personas. La diferencia de −2,03 puntos tiene un intervalo del 95% de −5,06 a +1,01: esta sensibilidad no distingue el cambio de cero con ese nivel de confianza. Las estimaciones de respuesta propia no son automáticamente mejores estimaciones poblacionales: quienes pueden contestar pueden diferir de quienes están representados por terceros. La comprobación identifica una limitación interpretativa real. Los datos no dicen cuánto de la diferencia general procede del comportamiento, la redacción, el modo de respuesta, la composición muestral u otros factores no medidos.
Las diferencias por edad son descriptivas, no diagnósticos generacionales
La tabla de edad aplica el mismo cálculo dentro de lectores de libros a siete franjas, desde 18–24 años hasta 75 o más. Mantiene así el foco en quienes declararon leer libros, sin dejar que la prevalencia de esa lectura defina el resultado. Las estimaciones no siguen una cohorte de nacimiento. Una persona en determinada franja en 2017 puede haber pasado a otra en 2022, y las muestras son diferentes. Etiquetas como generación Z introducirían una definición nueva que este análisis no ha establecido.
La proporción de ficción del grupo más joven fue del 70,84% en 2017 y del 63,81% en 2022, pero el intervalo del cambio fue amplio e incluyó cero. Su denominador de 2022 fue de solo 183 lectores de libros con respuestas completas. El grupo de 65–74 años presentó estimaciones del 75,87% y el 67,51%; ese contraste también requiere las advertencias generales sobre terceros y redacción. La tabla completa es más útil que una clasificación de estimaciones puntuales porque incluye tamaños muestrales e incertidumbre. Las direcciones numéricas varían entre grupos y las diferencias pequeñas no deben tratarse como separaciones fiables. No se aplicó corrección por comparaciones múltiples; los contrastes son exploratorios, no una serie de hallazgos confirmados independientemente sobre cómo leen las generaciones.
La educación describe la muestra, no el efecto de estudiar
La tabla educativa agrupa a las personas según el nivel declarado: secundaria no completada, secundaria completada, estudios superiores parciales o título de asociado, grado universitario y posgrado. En cada grupo, el denominador sigue siendo quienes declararon libros y respondieron a ficción. No equivale a preguntar si las personas con más educación tienen mayor probabilidad de leer algún libro. Condicionar a la lectura de libros acota deliberadamente la pregunta; la asociación resultante no puede generalizarse como un efecto de la escolarización sobre toda la población adulta.
En 2022, las estimaciones de ficción entre lectores iban del 58,85% entre quienes no completaron secundaria al 76,33% entre quienes tenían posgrado. La primera descansa en 112 lectores con respuestas completas y presenta mayor incertidumbre que grupos más grandes. La categoría de estudios superiores parciales o asociado pasó del 73,05% en 2017 al 64,00% en 2022: una diferencia numérica exploratoria que no debe convertirse en afirmación sobre cursos, instituciones o habilidades lectoras concretas. Edad, circunstancias del hogar, ingresos, ocupación y modo de respuesta pueden diferir entre niveles educativos. El estudio no ajusta un modelo causal ni aísla sus contribuciones. Las tablas describen asociaciones observadas y aportan detalle suficiente para evitar explicaciones seguras que las medidas no permiten comprobar.
Una comprobación limitada de la composición del público lector
La distribución de edades y titulaciones de los lectores de libros puede cambiar entre encuestas. Para examinarlo descriptivamente, los cálculos complementarios fijan una distribución cada vez a la composición de lectores con respuestas completas de 2017. La estandarización por edad aplica las mismas proporciones de grupos de 2017 a las estimaciones internas de cada año. La educativa repite el ejercicio con niveles educativos. Ambos ajustes responden a preguntas separadas: no controlan conjuntamente edad y educación ni abarcan todas las posibles diferencias de composición.
Con la distribución de edad de 2017 como referencia, la proporción de ficción de 2022 es del 69,36%, cercana al 69,33% sin ajustar. Con la distribución educativa de 2017 resulta del 68,89%. Sugieren que cada ajuste aislado no elimina el contraste numérico general, pero no resuelven los cambios de instrucciones sobre terceros ni de redacción. Sus errores estándar tratan las proporciones de referencia como fijas aunque se estimaron mediante encuesta. Por ello se presentan como sensibilidades descriptivas, no como una nueva prueba ajustada de significación. Un análisis incondicional de incertidumbre debería incorporar también la estimación de la distribución de referencia y la estructura de covarianzas correspondiente.
Las respuestas ausentes sobre ficción permanecen visibles
El denominador principal excluye lectores de libros cuya respuesta de ficción falta, fue rechazada o es desconocida. No recodifica esos casos como no. Se observaron 4.848 lectores en 2017, de los que 35 no tenían respuesta válida de ficción, y 3.359 en 2022, de los que 23 carecían de ella. En términos ponderados, representaban el 1,38% y el 0,97% de los lectores observados. Los saltos estructurales asociados al otro núcleo de la encuesta se mantienen separados de esas exclusiones por falta de respuesta: que una pregunta no se haya formulado no constituye evidencia de no participación.
Una comprobación sencilla asigna primero todas las respuestas ausentes a no y después a sí. Los límites resultantes son del 71,46% al 72,84% en 2017 y del 68,66% al 69,62% en 2022. Muestran el efecto máximo de la ausencia observada en el ítem de ficción bajo esas asignaciones. No son intervalos de confianza ni abordan respuestas ausentes sobre libros, falta de respuesta a la encuesta o declaraciones inexactas. Exigir respuestas válidas a ambas preguntas también permite que un porcentaje marginal de esta muestra analítica difiera de una publicación oficial con otro denominador. Debe explicarse esa diferencia, no corregirla silenciosamente para que un cálculo original se parezca a un titular redondeado.
Cómo se calcularon las ponderaciones y los intervalos
Ambas variables de lectura pertenecen al núcleo uno en las dos encuestas. Se utiliza el peso del suplemento SPPA, no uno general de la fuerza laboral. Para cada estimación se divide el número ponderado de personas que cumplen el numerador entre el número ponderado que cumple el denominador. El factor poblacional específico del núcleo se cancela en el cociente, al igual que la escala decimal implícita común de los campos de ponderación descargados. Se publican porcentajes y recuentos muestrales, no cantidades nacionales estimadas de personas. Las sumas brutas de pesos del archivo de validación son diagnósticas y no deben mostrarse como totales poblacionales.
La incertidumbre se calcula repitiendo todo el cociente con cada uno de los 160 pesos replicados del suplemento. La varianza es cuatro dividido entre 160 por la suma de diferencias cuadráticas entre estimaciones replicadas y estimación de la muestra completa. Los intervalos normales usan 1,96 errores estándar a cada lado. Las diferencias entre años utilizan la raíz cuadrada de la suma de las dos varianzas, tratando los cortes transversales separados por cinco años como independientes. Una implementación independiente reprodujo los resultados generales y las 24 celdas de edad y educación de la medida condicional principal, incluidos recuentos y errores estándar. La reproducción comprueba aritmética y código; no elimina errores de recuerdo, deseabilidad social, incertidumbre de terceros ni otros sesgos no muestrales.
Qué aporta frente a otras estadísticas de lectura
Los diarios de uso del tiempo, las ventas de libros y las encuestas anuales de participación responden a preguntas diferentes. Un diario puede mostrar si se leyó un día concreto y durante cuánto tiempo. Una serie de ventas registra transacciones bajo sus reglas de cobertura. La SPPA pregunta por participación durante doce meses y permite respuestas propias o por terceros. Este análisis complementa, por tanto, un estudio de días de lectura sin producir otra versión del mismo indicador. Una persona puede declarar un encuentro con ficción durante el año y no registrar lectura en un día concreto del diario, sin contradicción.
Para bibliotecas, clubes e investigadores, la contribución útil es un denominador defendible y una explicación de cómo las definiciones condicionan la respuesta. El resto de lectores que no declara ficción no debe describirse como público comercial sin explotar. Algunas personas prefieren otros materiales, encuentran ficción sin identificarla así o simplemente responden de forma imperfecta. La encuesta no pregunta si desean más ficción, comprarían una recomendación o responderían a una campaña. Tampoco dice aquí nada sobre calidad literaria, comprensión o valor personal. El uso práctico comienza por la pregunta y la población observadas, sin convertir un porcentaje condicional en un juicio comercial o cultural que la fuente no respalda.
Fuentes, reproducibilidad y reutilización responsable
Los archivos se descargaron directamente de las páginas públicas de datos SPPA de 2017 y 2022 del Census Bureau. Proporcionaron observaciones, pesos replicados y documentación técnica sin cuenta, afiliación institucional ni clave de API. Los informes oficiales de NEA aportaron contexto metodológico. El manifiesto conserva URL, tamaños en bytes y huellas criptográficas para que otro analista pueda identificar los insumos exactos. Los programas públicos de reproducción descargan esos archivos oficiales a un directorio local y calculan los agregados publicados. Descargar los datos para reproducir el análisis es distinto de redistribuirlos en este sitio.
El paquete público solo incluye resultados agregados, métodos, referencias y código. Los registros individuales y los archivos de pesos replicados permanecen fuera del repositorio de publicación. Al reutilizar una tabla deben conservarse años de encuesta, población adulta en hogares, denominador condicional, incertidumbre y advertencias sobre terceros y redacción. Las conclusiones se aplican a personas civiles no institucionalizadas de 18 años o más residentes en hogares, no a menores ni a residentes de instituciones. Son un análisis secundario original y no implican respaldo del Census Bureau ni del National Endowment for the Arts. Futuras publicaciones podrían permitir otra comparación, pero antes de añadirse deben revisarse cambios de preguntas y recogida. Reproducir también significa preservar los límites interpretativos, no solo los números.
Novelas y cuentos entre lectores de libros
Adultos de 18+ años en EE. UU. · Lectura en el último año · SPPA 2017 y 2022. Estimación e intervalo de confianza del 95%.
Gráfico completo y fuente
Desplaza el gráfico horizontalmente para examinarlo. ↔
Gráfico y valores
Desplaza la tabla horizontalmente para ver todas las columnas.
| Año | Ámbito de respuesta | n del denominador | n con ambos sí | Porcentaje ponderado | Límite inferior IC 95% | Límite superior IC 95% |
|---|---|---|---|---|---|---|
| 2017 | Todas las respuestas | 4813 | 3561 | 72.46 | 70.67 | 74.25 |
| 2022 | Todas las respuestas | 3336 | 2372 | 69.33 | 67.14 | 71.52 |
| 2017 | Solo respuestas propias | 4124 | 3085 | 73.48 | 71.58 | 75.37 |
| 2022 | Solo respuestas propias | 2660 | 1919 | 71.45 | 69.08 | 73.82 |
Condicionado a declarar libros y responder válidamente a ficción; estimaciones ponderadas y recuentos muestrales sin ponderar. Cambiaron las instrucciones sobre terceros y la pregunta de libros. El intervalo del cambio con respuesta propia incluye cero; la comparación general no es una estimación causal del comportamiento.
Datos y descargas
Desplaza la tabla horizontalmente para ver todas las columnas.
| Año | Ámbito de respuesta | n del denominador | n con ambos sí | Porcentaje ponderado | Límite inferior IC 95% | Límite superior IC 95% |
|---|---|---|---|---|---|---|
| 2017 | Todas las respuestas | 4813 | 3561 | 72.46 | 70.67 | 74.25 |
| 2022 | Todas las respuestas | 3336 | 2372 | 69.33 | 67.14 | 71.52 |
| 2017 | Solo respuestas propias | 4124 | 3085 | 73.48 | 71.58 | 75.37 |
| 2022 | Solo respuestas propias | 2660 | 1919 | 71.45 | 69.08 | 73.82 |
Condicionado a declarar libros y responder válidamente a ficción; estimaciones ponderadas y recuentos muestrales sin ponderar. Cambiaron las instrucciones sobre terceros y la pregunta de libros. El intervalo del cambio con respuesta propia incluye cero; la comparación general no es una estimación causal del comportamiento.
Desplaza la tabla horizontalmente para ver todas las columnas.
| Año | Grupo | n del denominador | n con ambos sí | Porcentaje ponderado | Límite inferior IC 95% | Límite superior IC 95% |
|---|---|---|---|---|---|---|
| 2017 | 18-24 | 295 | 219 | 70.84 | 64.34 | 77.34 |
| 2017 | 25-34 | 808 | 596 | 73.62 | 69.82 | 77.43 |
| 2017 | 35-44 | 769 | 571 | 72.58 | 68.61 | 76.56 |
| 2017 | 45-54 | 702 | 504 | 70.64 | 66.52 | 74.77 |
| 2017 | 55-64 | 875 | 650 | 71.60 | 67.88 | 75.32 |
| 2017 | 65-74 | 823 | 622 | 75.87 | 71.79 | 79.95 |
| 2017 | 75+ | 541 | 399 | 71.58 | 66.76 | 76.40 |
| 2022 | 18-24 | 183 | 121 | 63.81 | 53.84 | 73.79 |
| 2022 | 25-34 | 515 | 380 | 73.48 | 68.92 | 78.03 |
| 2022 | 35-44 | 578 | 428 | 66.79 | 61.36 | 72.21 |
| 2022 | 45-54 | 474 | 339 | 74.28 | 69.97 | 78.59 |
| 2022 | 55-64 | 526 | 358 | 67.56 | 62.34 | 72.78 |
| 2022 | 65-74 | 634 | 448 | 67.51 | 62.75 | 72.26 |
| 2022 | 75+ | 426 | 298 | 69.17 | 63.61 | 74.73 |
Estimaciones exploratorias de subgrupos con respuestas completas, todos los modos de respuesta. Sin ajuste por comparaciones múltiples. Conserve tamaños muestrales, intervalos y límites de terceros y redacción entre encuestas.
Desplaza la tabla horizontalmente para ver todas las columnas.
| Año | Grupo | n del denominador | n con ambos sí | Porcentaje ponderado | Límite inferior IC 95% | Límite superior IC 95% |
|---|---|---|---|---|---|---|
| 2017 | Secundaria no completada | 221 | 115 | 55.90 | 46.97 | 64.82 |
| 2017 | Secundaria completada | 1010 | 679 | 65.21 | 61.42 | 69.00 |
| 2017 | Estudios superiores parciales/asociado | 1383 | 1031 | 73.05 | 70.10 | 76.00 |
| 2017 | Grado universitario | 1307 | 1009 | 76.41 | 73.33 | 79.50 |
| 2017 | Posgrado | 892 | 727 | 79.45 | 76.13 | 82.78 |
| 2022 | Secundaria no completada | 112 | 60 | 58.85 | 47.06 | 70.65 |
| 2022 | Secundaria completada | 553 | 349 | 63.25 | 57.03 | 69.46 |
| 2022 | Estudios superiores parciales/asociado | 948 | 646 | 64.00 | 59.79 | 68.20 |
| 2022 | Grado universitario | 1005 | 764 | 75.80 | 72.48 | 79.12 |
| 2022 | Posgrado | 718 | 553 | 76.33 | 72.89 | 79.77 |
Estimaciones exploratorias de subgrupos con respuestas completas, todos los modos de respuesta. Sin ajuste por comparaciones múltiples. Conserve tamaños muestrales, intervalos y límites de terceros y redacción entre encuestas.
Evidencia y método
Cómo lo calculamos
- Análisis secundario original de los archivos públicos reales de SPPA del Census de julio de 2017 y julio de 2022. Ambos ítems de lectura pertenecen al núcleo 1; se exigen registros de personas de al menos 18 años y peso positivo del suplemento.
- El numerador principal es PEC1Q14A=1 y PEC1Q15A=1. El denominador es PEC1Q14A=1 y PEC1Q15A en {1,2}. Las respuestas ausentes de ficción se excluyen, no se tratan como No. No se supone que ficción y libros sean conjuntos anidados.
- PWSUPWGT es el peso de estimación puntual. Cada cociente condicional se recalcula con 160 pesos replicados emparejados del suplemento; varianza = 4/160 por la suma de desviaciones cuadráticas. Los intervalos normales del 95% usan 1,96 errores estándar. Se suman varianzas independientes entre años para los intervalos del cambio.
- PUNXTPR3 identifica los grupos de sensibilidad de respuesta propia o por terceros. Las estandarizaciones unidimensionales separadas fijan las proporciones de edad o educación de lectores con respuestas completas de 2017; son descriptivas, no ajustes conjuntos ni inferencia ajustada incondicional.
- Una implementación independiente con archivos originales reprodujo las estimaciones generales y las 24 celdas principales de edad y educación con tolerancia 1e-9. El diseño y las comprobaciones se desarrollaron durante el análisis; no es un estudio prerregistrado prospectivamente.
Lo que los datos no permiten concluir
- Las instrucciones sobre terceros fueron más permisivas en 2022 y su proporción aumentó. El intervalo del cambio con respuestas propias incluye cero. No interprete el contraste general como un descenso causal del comportamiento ni como una medición invariable.
- La pregunta de libros de 2022 menciona formatos impresos y electrónicos; la de 2017 incluye una aclaración sobre textos religiosos. Ficción incluye material fuera de libros y no repite la exclusión de trabajo o estudios. No se añaden preguntas de escucha.
- El recuerdo anual, el conocimiento de terceros, la falta de respuesta y la deseabilidad social pueden sesgar estimaciones. Los intervalos replicados no miden todo sesgo no muestral. Se cubren adultos civiles no institucionalizados de 18 años o más en hogares, no todos los residentes.
- Las estimaciones de subgrupos pequeños son imprecisas; los contrastes son exploratorios sin corrección por multiplicidad. Las franjas de edad no son generaciones. Las asociaciones educativas no son efectos de la escolarización.
- No se mide intención de compra, lectura romántica, finalización de libros, duración, calidad de lectura ni oportunidad comercial. Es un estudio original con ediciones traducidas, no estudios distintos por subgrupo o idioma.
Fuentes originales
- jul22pub.csv
CSV de uso público del SPPA 2022 del Census: aporta respuestas individuales sobre libros y ficción, edad, nivel educativo, indicador de respuesta propia o por otra persona y peso del suplemento para las estimaciones de 2022. Los registros individuales originales no se incluyen en las descargas públicas del estudio.
Consultado 30 de octubre de 2026
- jul22rep.csv
CSV de pesos replicados del SPPA 2022 del Census: 160 pesos del suplemento, vinculados mediante QSTNUM y OCCURNUM, permiten calcular los errores estándar de las razones. El peso de la réplica cero se comprueba frente al peso principal; los valores brutos de los pesos no son recuentos poblacionales.
Consultado 30 de octubre de 2026
- jul17pub.zip
ZIP de uso público del SPPA 2017 del Census: los registros individuales de ancho fijo aportan las respuestas y características de 2017. El campo de ficción ocupa las posiciones 1050–1051; no debe suponerse una estructura idéntica a la de 2022. Los registros originales quedan fuera del paquete público del estudio.
Consultado 30 de octubre de 2026
- jul17rep.zip
ZIP de pesos replicados del SPPA 2017 del Census: los pesos del suplemento de ancho fijo se vinculan a los registros de 2017 para recalcular cada razón condicional en 160 réplicas. El archivo sirve para estimar la incertidumbre, no como otra medida de lectura.
Consultado 30 de octubre de 2026
- cpsjul17.pdf
Documentación técnica del Census de 2017: las estructuras de registro y el cuestionario establecen los dos ítems de lectura y la instrucción más restrictiva para respuestas por otra persona. La pregunta sobre libros aclara la inclusión de textos religiosos; la de ficción incluye relatos fuera de los libros.
Consultado 30 de octubre de 2026
- cpsjul22.pdf
Documentación técnica del Census de 2022: el cuestionario y las instrucciones de ponderación establecen la elegibilidad para el Núcleo 1, los pesos del suplemento y el factor de escala del núcleo. La pregunta sobre libros menciona expresamente libros impresos y electrónicos, y se admite respuesta por otra persona cuando el entrevistado no está disponible; estos cambios limitan la interpretación entre ediciones.
Consultado 30 de octubre de 2026
- SPPA_Comprehensive_Report_FINAL.pdf
Informe completo de la NEA sobre el SPPA 2022: ofrece contexto oficial y estimaciones publicadas de participación, no los datos individuales utilizados en nuestros cálculos condicionales. No deben dividirse sus porcentajes marginales publicados para estimar la ficción entre lectores de libros.
Consultado 30 de octubre de 2026
- SPPA_2022_Technical_Appendix_FINAL.pdf
Apéndice técnico de la NEA de 2022: fundamenta el cálculo de incertidumbre por réplicas, incluido BRR con factor de Fay 0,5 y varianza basada en el error cuadrático medio. La varianza de nuestras razones con 160 réplicas utiliza el factor correspondiente 4/160.
Consultado 30 de octubre de 2026
- cps_ppa_repwgt_jul17.sas
Estructura SAS del archivo de réplicas del Census de 2017: documenta los identificadores QSTNUM/OCCURNUM, los campos de réplicas 0–160 y cuatro decimales implícitos. Valida la lectura de campos y la escala; es código de documentación, no observaciones de entrevistados.
Consultado 30 de octubre de 2026
- cps_ppa_repwgt_jul22.sas
Estructura SAS del archivo de réplicas del Census de 2022: documenta la estructura del archivo de réplicas del suplemento y la escala de los pesos, y permite comprobar la interpretación de los pesos del CSV de 2022. La escala común se cancela en las razones; los totales brutos de los pesos no se presentan como números de personas.
Consultado 30 de octubre de 2026
Cómo citar y reutilizar
Alisson Bento. Coincidencia entre lectura de ficción y de libros: qué permiten saber las encuestas estadounidenses de 2017 y 2022. Análisis secundario original de datos públicos SPPA del Census Bureau / National Endowment for the Arts; consultados el 30 de octubre de 2026. https://alissonbento.com/es/research/us-fiction-book-reading-overlap-2017-2022/
Cálculos originales y presentación explicativa: Alisson Bento. Fuente: U.S. Census Bureau / National Endowment for the Arts, SPPA 2017 y 2022. Conserve denominador condicional, años de encuesta, población adulta en hogares, intervalos y advertencias sobre terceros y redacción. No se implica respaldo oficial. Las descargas contienen agregados y código; no se redistribuyen registros individuales ni pesos replicados. Este análisis no concede licencias sobre ilustraciones o logotipos de informes ajenos.
Correcciones o consultas editoriales