
Um tamanho de arquivo, várias medidas
Um download de EPUB tem um único tamanho de arquivo. Esse número, porém, soma materiais que se comportam de modo diferente dentro do arquivo: documentos de leitura, imagens codificadas, navegação, folhas de estilo e a estrutura do pacote. O peso de cada um depende de a medida usar o arquivo recebido ou os itens dele já descomprimidos. Por isso, uma frase como “a maior parte deste ebook é imagem” precisa de duas coisas: uma lista definida de imagens e um denominador. Sem elas, dois cálculos corretos podem parecer contraditórios, embora respondam a perguntas diferentes sobre o mesmo arquivo.
Esta análise mede doze arquivos EPUB3 do Project Gutenberg, na variante com imagens, recebidos em 30 de outubro de 2026. Dois deles mudam de lado em relação à maioria de imagens quando o denominador muda: as imagens declaradas passam da metade dos bytes do arquivo recebido, mas ocupam menos da metade dos bytes dos itens descomprimidos. Além disso, a ordem pelo tamanho do arquivo recebido diverge da ordem de dois indicadores de texto, definidos de forma explícita e sem renderização, em 26 e em 29 dos 66 pares de arquivos. São resultados de contagem para esses arquivos de conversão. Não são estimativas sobre ebooks em geral nem sobre obras literárias independentes.
A lição comum é dizer o que se compara antes de interpretar um tamanho. Quem confere um download pode separar o arquivo inteiro de seus componentes internos. Quem produz ebooks ou analisa catálogos pode separar a lista de recursos de um indicador de texto. Nenhuma das duas verificações mede páginas exibidas, extensão validada da prosa ou esforço de leitura. Os resultados são exemplos reproduzíveis de escolhas de medição. Eles não mostram que alguma edição desperdiça espaço, tem ilustrações ruins, é difícil de ler ou deveria perder componentes.
Manter o conjunto de arquivos recebidos como está
Os doze arquivos têm os identificadores Gutenberg 11, 84, 98, 120, 140, 161, 345, 768, 1260, 1342, 2701 e 42324. As páginas canônicas, os endereços reais do espelho oficial, as datas de recebimento, os tamanhos em bytes e as impressões digitais (hashes) dos arquivos originais estão nos downloads de evidência. O conjunto vem, sem alterações, de um exame estrutural anterior. Ele não foi escolhido para representar um gênero, um grupo de autores ou a produção atual de EPUBs. Cada observação é um arquivo de conversão exato, recebido numa data, e não uma propriedade permanente de um título.
O conjunto inclui Alice’s Adventures in Wonderland, A Tale of Two Cities, Treasure Island, The Jungle, Sense and Sensibility, Dracula, Wuthering Heights, Jane Eyre, Pride and Prejudice e Moby Dick, além de duas transcrições de Frankenstein. Os dois arquivos de Frankenstein continuam como casos separados, mas não contam como duas obras independentes. Suas diferenças não podem ser atribuídas só ao empacotamento, porque não se verificou se o conteúdo de texto e a edição são equivalentes. Do mesmo modo, os nomes das variantes com imagens descrevem os arquivos recebidos. Eles não formam uma comparação controlada com edições sem imagens.
São os mesmos arquivos guardados que serviram a uma análise anterior da navegação, mas a pergunta aqui é outra. Aquela análise encontrou destinos de navegação que se resolvem e não sustentou a ideia isolada de que faltam capítulos. Falhas de navegação e de acessibilidade ficam fora deste estudo. Aqui, as observações tratam das funções declaradas dos itens, da contagem de bytes, dos estados de compressão e de comparações de ordem num conjunto finito. Nenhum EPUB foi baixado de novo para obter uma versão mais favorável. Um arquivo oficial modificado no futuro seria outro arquivo, e suas medidas não devem substituir em silêncio este conjunto datado.
Separar bytes do arquivo e bytes dos itens
Seja A o número de bytes do arquivo recebido. C é a soma dos tamanhos comprimidos dos itens do ZIP, e U é a soma dos tamanhos descomprimidos. O que sobra do contêiner é O = A − C. Nos doze arquivos, A soma 91.637.973 bytes, C soma 91.486.377, O soma 151.596 e U soma 97.688.762. As estruturas do contêiner não são outro item de conteúdo, e seus bytes não entram em U. Manter essa sobra à vista evita que as parcelas por função sejam recalculadas em silêncio sobre outro total.
Para uma função r (por exemplo, imagens declaradas), a parcela no arquivo comprimido é C_r/A. A parcela nos itens descomprimidos é U_r/U. As duas servem, mas não são porcentagens intercambiáveis. A primeira inclui o contêiner ZIP no denominador. A segunda trata os itens depois da descompressão do ZIP e deixa o contêiner de fora. “Descomprimido” vale aqui só para a camada ZIP: uma imagem JPEG, por exemplo, continua sendo um arquivo de imagem codificado, e não uma contagem de pixels. U também não representa memória de trabalho, desenho na tela nem exigências de recursos do aparelho.
A razão de compressão U_r/C_r só aparece quando C_r é positivo. Uma função observada sem itens tem zero itens e zero bytes, mas sua razão fica indefinida, não igual a zero. Isso difere de uma fonte indisponível, que interromperia a verificação em vez de receber um zero imputado. A distinção pesa sobretudo para as fontes tipográficas e para as funções diversas, que ficam em zero em todo o conjunto. Zero byte, quociente indefinido e dado ausente são três situações diferentes e devem continuar distinguíveis em qualquer planilha ou gráfico que reutilize esses números.
Classificar itens declarados, não ilustrações visíveis
A classificação segue o manifesto (a lista de itens) e a sequência de leitura (spine) de cada pacote real. Ela separa onze funções: controle do pacote, navegação, imagens de capa declaradas, outras imagens declaradas, XHTML do provedor, XHTML da sequência de leitura que entra na medida (o “XHTML elegível”), outros XHTML, folhas de estilo, fontes tipográficas, outros materiais declarados e outros materiais fora do manifesto. Cada arquivo mantém as onze linhas, inclusive os zeros observados. A capa é identificada pela declaração do pacote, não por palpite a partir do nome ou da aparência do arquivo. Os documentos de cabeçalho e rodapé do provedor e a navegação ficam separados das medidas de texto da sequência de leitura, para não serem contados em silêncio como conteúdo literário.
No conjunto, o registro tem 1.006 itens ZIP. Entre eles há 398 itens de imagem declarados: doze capas declaradas e 386 outras imagens. Todos os itens de imagem declarados estão armazenados no ZIP sem compressão, então seus bytes comprimidos e descomprimidos são iguais. Já os 412 documentos XHTML elegíveis ocupam 8.608.444 bytes descomprimidos e 3.520.103 bytes comprimidos. Esse tratamento diferente muda o peso relativo de cada tipo quando o denominador passa da contagem do arquivo para a dos itens descomprimidos. Isso não vale como regra universal para todos os conversores de EPUB.
Seis arquivos têm uma capa declarada e nenhum outro item de imagem declarado: os de identificadores 11, 84, 140, 161, 768 e 2701. Isso descreve o inventário. Não prova que as páginas desses livros, quando exibidas, não tenham outras ilustrações. Imagens incorporadas como dados, referências remotas, efeitos de diagramação e a visibilidade real das imagens ficam fora deste inventário de itens. Uma declaração de capa também não diz nada sobre a qualidade da imagem nem sobre como um aplicativo de leitura a mostra. A análise para antes dessas perguntas visuais e funcionais, que pediriam outras evidências e outros métodos.
Duas maiorias de imagens dependem do denominador
Em Alice’s Adventures in Wonderland (identificador 11), o item de imagem declarado tem 104.775 bytes. Sobre o arquivo recebido, de 189.249 bytes, isso dá 55,36%. Sobre os 314.264 bytes dos itens descomprimidos, a mesma imagem codificada dá 33,34%. Os bytes da imagem não sumiram nem perderam qualidade entre um cálculo e outro. O que muda é que os itens descomprimidos que não são imagem pesam mais no segundo denominador. “Arquivo com maioria de imagens” e “itens descomprimidos sem maioria de imagens” são, portanto, duas descrições corretas ao mesmo tempo, desde que cada uma diga qual forma de contagem usa.
O identificador 84, Frankenstein, mostra a segunda mudança. Seus 224.340 bytes de imagens declaradas são 50,97% do arquivo recebido, de 440.131 bytes, mas 31,02% dos 723.302 bytes dos itens descomprimidos. Nos dois exemplos, o inventário tem só a capa declarada. Os resultados, portanto, não dependem de um grande número de imagens internas declaradas à parte. As barras pareadas mostram todos os arquivos, e não só as mudanças, para que se vejam esses exemplos ao lado de casos em que as duas porcentagens ficam do mesmo lado da metade.
Os outros arquivos variam bastante sem cruzar o limite. As parcelas de imagens de Moby Dick são 31,57% e 14,44%; as de Treasure Island, 99,41% e 98,74%. Essas porcentagens descrevem os arquivos e os denominadores indicados. Não formam uma classificação de mérito editorial. Uma parcela alta pode conviver com ilustrações úteis, e uma parcela baixa não garante acessibilidade nem páginas pequenas na tela. A leitura correta é uma descrição exata do que ocupa os bytes, e não a recomendação de uma composição como melhor em si.
Definir indicadores de texto sem fingir que o livro foi renderizado
O primeiro indicador, X, é o número de bytes descomprimidos do XHTML serializado elegível, isto é, do código dos documentos com todas as suas marcas, sem a navegação e sem os documentos de cabeçalho e rodapé do provedor. A marcação faz parte dessa medida. Também entram elementos preliminares, legendas e outros materiais presentes nesses documentos. X é fácil de reproduzir a partir da estrutura do pacote, mas não é uma contagem validada de palavras do romance nem uma medida do texto visível. A marcação, a codificação de caracteres e a construção dos documentos podem alterá-lo, mesmo quando o leitor veria algo parecido na tela.
O segundo indicador, T, conta os pontos de código do corpo literal (a unidade básica de caracteres do Unicode), com espaços em branco normalizados por uma regra de extração explícita. O texto dos elementos mantidos e o texto que vem logo depois deles (o “tail”) são coletados na ordem do documento. Os trechos de script e style são ignorados, mas o texto que vem depois de cada elemento ignorado fica com o elemento pai. Os trechos coletados são unidos por um espaço ASCII inserido. Depois, os espaços em branco Unicode são reduzidos a um só (separando e juntando o texto de novo). As contagens são somadas entre os documentos, sem separador entre eles. Não há conversão de maiúsculas e minúsculas, reparo de hifens, divisão em palavras nem normalização Unicode.
Os espaços inseridos entre trechos são uma convenção do programa. Não significam que a página exibida tenha um espaço em cada fronteira de elemento. T também não determina o que o CSS mostra ou esconde, não identifica todo o conteúdo que não é prosa e não prova que duas edições sejam equivalentes. A regra exata de separação foi documentada depois do primeiro cálculo de T, para eliminar ambiguidade, sem mudar a regra aplicada nem os resultados. Ela não deve ser apresentada como detalhe pré-registrado sem conhecimento dos resultados. Usar os dois indicadores permite examinar suas definições. Mesmo que concordassem, nenhum dos dois viraria extensão literária ou tempo de leitura.
Comparar ordens num conjunto finito, sem prever livros
Para cada indicador, todo par não ordenado dos doze arquivos é comparado com o tamanho do arquivo recebido. Há discordância estrita quando o arquivo maior tem o menor valor do indicador, ou o contrário. Concordâncias estritas e empates ficam registrados à parte. São 66 pares interligados, não 66 observações sorteadas de forma independente. No conjunto completo, X dá 40 concordâncias e 26 discordâncias; T dá 37 e 29. Não há empate de tamanho nem de indicador. O registro de pares guarda os casos reais por trás desses totais, em vez de reduzir o resultado a uma correlação.
As correlações descritivas de Spearman (correlação de postos) são 0,279720 entre o tamanho do arquivo e X, e 0,146853 entre o tamanho do arquivo e T, arredondadas a seis casas decimais. Elas resumem quanto as ordens se associam dentro deste conjunto fixo. Não medem acerto de previsão, não são parâmetros de uma população e não mostram que o tamanho do arquivo nunca informe algo em outro contexto. Como cada arquivo entra em várias comparações, os totais de pares não devem alimentar um modelo simples de observações independentes. Não há testes de significância, intervalos de confiança nem um modelo geral do tamanho de ebooks nesta comparação, que é restrita de propósito.
Um contraste concreto ajuda a conferir as unidades. Treasure Island, identificador 120, é o maior arquivo recebido, com 49.452.703 bytes, mas seu X é 467.048 e seu T é 359.153. Moby Dick, identificador 2701, tem um arquivo de 814.023 bytes, e seu X é 1.299.019 e seu T é 1.113.194. A comparação mostra uma diferença de ordem entre essas grandezas registradas. Não mostra que um romance seja mais longo num sentido literário validado. Também não isola o efeito de tirar as imagens, porque não se produziu um pacote alternativo nem uma reconstrução com conteúdo equivalente.
Ver como os maiores arquivos influenciam o resultado
Tirar os identificadores 120 e 1342, os dois maiores arquivos recebidos, reforça de modo importante as associações. Entre os dez arquivos restantes, as correlações sobem para 0,648485 em X e 0,539394 em T. As discordâncias caem para 11 e 13 dos 45 pares, respectivamente. Esta é uma ressalva importante, e não uma nota de rodapé que se resuma a “os valores extremos não importam”. Eles importam para a força dessas associações. As divergências que sobram mostram que a diferença de ordem não se limita a esses dois arquivos.
Um segundo recorte deixa de fora o identificador 42324, a transcrição de Frankenstein de identificador mais alto. Os onze arquivos restantes têm 20 discordâncias em X e 23 em T entre 55 pares, com correlações de 0,363636 e 0,218182. As duas mudanças de maioria de imagens continuam nos dois recortes. Esses cálculos mostram que o resultado depende de um arquivo de obra repetida e dos maiores arquivos, sem tratar nenhum recorte como amostra corrigida ou preferida. Os doze arquivos seguem como conjunto principal, e não se afirma equivalência literária entre as duas transcrições de Frankenstein.
O recorte sem os dois maiores foi definido já conhecendo os tamanhos, que vinham da lista de fontes herdada. O novo protocolo não pode, portanto, afirmar que foi totalmente cego aos resultados. Ele fixou as regras de contagem e de comparação antes dos novos resultados por função e por indicador, mas a fonte e os tamanhos já tinham sido vistos. O esclarecimento posterior sobre T traz mais um momento declarado. Os recortes são análises de sensibilidade descritivas e transparentes. Não são amostras independentes de validação e não autorizam a escolher o coeficiente que renderia o título mais forte. Convém manter o conjunto completo ao lado das duas versões restritas.
Ler com cuidado totais somados e porcentagens arredondadas
O registro somado por função soma bytes de todos os arquivos. Não calcula a média de doze composições de ebooks. Um arquivo grande contribui com mais bytes para essa soma do que um pequeno. Assim, uma parcela somada de imagens responderia a uma pergunta de inventário ponderada pelo volume. Ela não descreveria o arquivo típico nem a proporção de títulos com maioria de imagens. A tabela por arquivo é o lugar para ver essa variação. Manter os dois níveis disponíveis evita que os dois maiores pacotes definam em silêncio um suposto livro típico.
Diferenças em pontos percentuais também pedem um rótulo próprio. As duas parcelas de Alice diferem em cerca de 22,02 pontos percentuais, calculados com as parcelas sem arredondamento. Isso não é uma redução medida nos bytes das imagens, nem uma melhora de 22,02% em coisa alguma. O numerador não muda. Uma variação percentual relativa usaria outra fórmula e responderia a outra pergunta. O indicador de maioria só testa se a parcela definida passa de 50%. Ele não avalia a dimensão nem a utilidade do inventário de imagens.
As porcentagens exibidas são arredondadas a duas casas, e as correlações, a seis. Os dados de evidência guardam os números inteiros de bytes e os valores calculados sem arredondar. Os indicadores de maioria e o sentido de cada par são calculados antes do arredondamento. Isso importa porque uma igualdade arredondada não precisa ser um empate de verdade em outro conjunto. Aqui não há empates de tamanho nem de indicador, mas o registro mantém estados de empate separados. Usar a tabela arredondada para recalcular com exatidão jogaria fora informação que as entradas compactas, legíveis por máquina, preservam de propósito.
Usar as distinções na leitura ou na produção de ebooks
Para quem lê, a pergunta imediata pode ser simples: o que mede o tamanho de download anunciado? Neste registro, a grandeza que responde é a contagem de bytes do arquivo recebido. Os totais dos itens respondem a outra pergunta de inspeção. Nenhum dos dois números, sozinho, diz quantas páginas um aplicativo vai mostrar. Guardar a data da captura e o endereço da variante real evita que o rótulo de uma edição ocupe o lugar de um arquivo exato. Isso ajuda sobretudo quando um distribuidor pode gerar de novo um EPUB sem mudar o título conhecido da obra.
Para quem escreve ou edita ebooks, o registro por função permite falar de empacotamento sem tomar uma porcentagem por veredito de qualidade. Um relatório pode identificar os arquivos de imagem declarados, separar capas de outras imagens declaradas e dizer se as porcentagens usam bytes comprimidos ou descomprimidos. Pode também manter à vista a navegação, os documentos do provedor e a sobra do contêiner. Essas distinções tornam reproduzível uma conversa técnica. Elas não mostram quais recursos apagar, se as imagens devem ser recomprimidas ou se uma mudança manteria a experiência de leitura pretendida.
Para quem analisa catálogos, a comparação de ordens avisa contra trocar uma quantidade de texto bem definida por um campo sem rótulo chamado “tamanho do livro”. As correlações mais fortes sem os maiores arquivos mostram também por que o conjunto completo importa: não existe um coeficiente único que dispense olhar os casos. Uma reutilização defensável nomearia o conjunto exato de fontes, o indicador e a forma de contagem, e depois reproduziria as comparações finitas pertinentes. Não exportaria os coeficientes deste conjunto como regra de previsão para outro catálogo, outro formato ou futuras conversões do Gutenberg.
Reproduzir fatos compactos sem redistribuir livros
O pacote público de evidências contém entradas selecionadas de bytes por função, valores dos indicadores de texto, referências aos arquivos de origem, métricas derivadas por arquivo e por função, todas as comparações de pares e um resumo. O script de reprodução agregada roda a partir dessas entradas compactas, com pastas de entrada e de saída indicadas de forma explícita. Um segundo script, opcional, pode medir EPUBs oficiais exatos obtidos à parte, depois de conferir os hashes dos arquivos. Ele não faz requisições às fontes e produz medidas numéricas, não conteúdo de livros. A lista pública de somas de verificação descreve os arquivos compactos distribuídos. As impressões digitais dos arquivos originais identificam arquivos externos que não vão no pacote.
Os arquivos de origem continuam guardados em caráter privado. O pacote público não inclui romances completos, texto extraído do corpo, capas nem ilustrações, e o registro interno com os nomes dos itens não é um download. Os autores das obras e o Project Gutenberg recebem crédito separado dos cálculos e da explicação originais de Alisson Bento. Cada pacote guardado traz a indicação de domínio público nos Estados Unidos e a licença do Gutenberg. Essas indicações e a política citada não comprovam liberação de direitos autorais no mundo todo, não eliminam condições de marca registrada e não dão licença geral para o artigo inteiro nem para qualquer uso posterior.
O resultado final é mais restrito do que um veredito sobre ebooks, e de propósito. Duas classificações de maioria mudam com o denominador da contagem, e as ordens de tamanho dos arquivos divergem de dois indicadores de texto definidos sem renderização. Os maiores arquivos pesam muito nos resumos de ordem, mas as divergências e as mudanças de maioria permanecem nos recortes declarados. Esses achados sustentam rótulos de unidade claros e exemplos que se podem conferir. Não sustentam afirmações sobre falhas de navegação, qualidade visual, tempo de leitura, tráfego na rede, latência, memória ou desempenho de aparelhos. É respeitar esses limites que torna útil o pequeno conjunto fixo, em vez de uma coleção de tamanhos de arquivo impressionantes.
Imagens declaradas: duas formas de contagem
EPUBs do Gutenberg · Recebidos em 30 de outubro de 2026 · 12 arquivos fixos
Gráfico completo e fonte
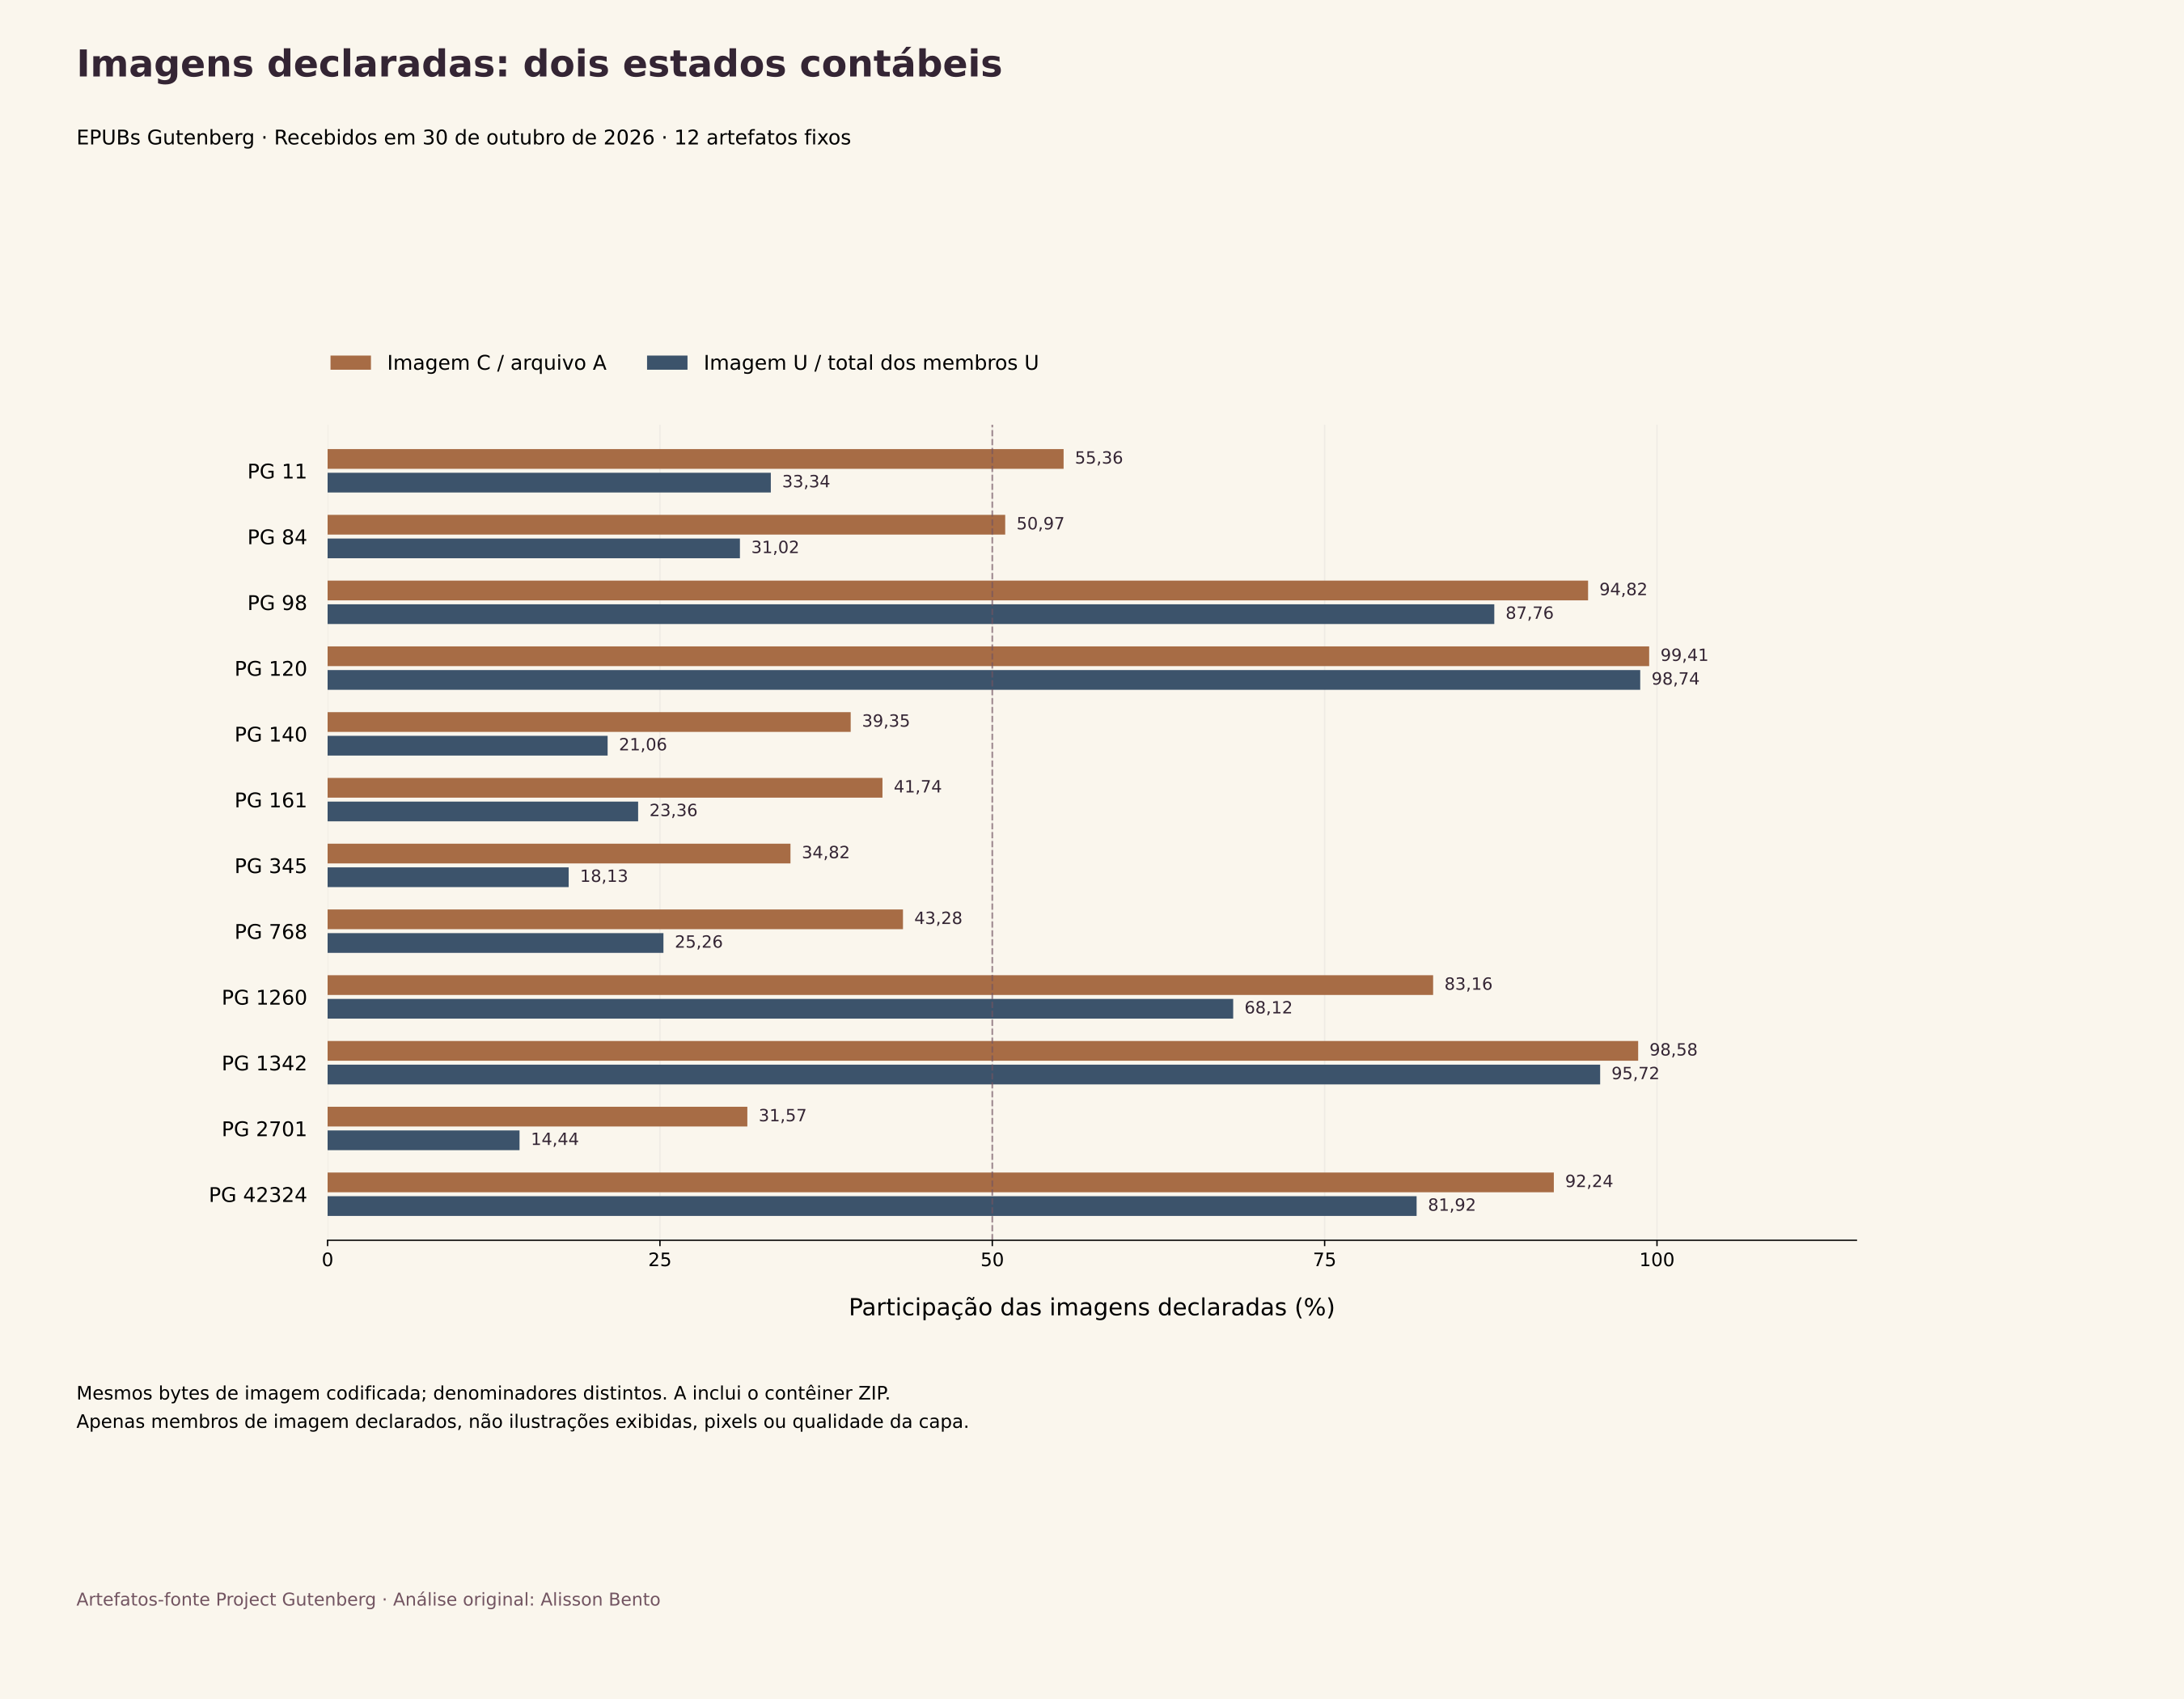
Role para os lados para examinar o gráfico. ↔
Gráfico e valores
Role a tabela para os lados para ver todas as colunas.
| Arquivo Gutenberg | A recebido (bytes) | Imagens declaradas C (bytes) | U descomprimido (bytes) | Imagens C_img/A (%) | Imagens U_img/U (%) | Mudança de maioria (1 = sim) |
|---|---|---|---|---|---|---|
| PG 11 | 189.249 | 104.775 | 314.264 | 55,36 | 33,34 | 1 |
| PG 84 | 440.131 | 224.340 | 723.302 | 50,97 | 31,02 | 1 |
| PG 98 | 7.923.060 | 7.512.341 | 8.559.932 | 94,82 | 87,76 | 0 |
| PG 120 | 49.452.703 | 49.162.018 | 49.789.786 | 99,41 | 98,74 | 0 |
| PG 140 | 615.474 | 242.178 | 1.149.729 | 39,35 | 21,06 | 0 |
| PG 161 | 580.103 | 242.125 | 1.036.582 | 41,74 | 23,36 | 0 |
| PG 345 | 602.902 | 209.921 | 1.157.585 | 34,82 | 18,13 | 0 |
| PG 768 | 587.952 | 254.472 | 1.007.298 | 43,28 | 25,26 | 0 |
| PG 1260 | 3.095.830 | 2.574.499 | 3.779.323 | 83,16 | 68,12 | 0 |
| PG 1342 | 24.864.457 | 24.512.383 | 25.607.139 | 98,58 | 95,72 | 0 |
| PG 2701 | 814.023 | 257.017 | 1.780.233 | 31,57 | 14,44 | 0 |
| PG 42324 | 2.472.089 | 2.280.260 | 2.783.589 | 92,24 | 81,92 | 0 |
Os doze arquivos fixos, recebidos em 30 de outubro de 2026. C_img/A usa os bytes do corpo do arquivo recebido; U_img/U usa os bytes dos itens descomprimidos. Contam só itens de imagem declarados, inclusive as capas declaradas; não são contagens de ilustrações renderizadas ou incorporadas. As porcentagens são arredondadas a duas casas; as indicações de maioria usam as parcelas sem arredondar. Os identificadores designam arquivos, não obras independentes.

A ordem arquivo–indicador depende do conjunto de arquivos
EPUBs do Gutenberg · Recebidos em 30 de outubro de 2026 · 12 arquivos fixos
Gráfico completo e fonte

Role para os lados para examinar o gráfico. ↔
Gráfico e valores
Role a tabela para os lados para ver todas as colunas.
| Conjunto fixo de arquivos | Indicador | Arquivos | Pares | Concordantes | Discordantes | Empates de tamanho | Empates de indicador | Empates nos dois | Rho de Spearman |
|---|---|---|---|---|---|---|---|---|---|
| Todos os arquivos fixos | X | 12 | 66 | 40 | 26 | 0 | 0 | 0 | 0,279720 |
| Todos os arquivos fixos | T | 12 | 66 | 37 | 29 | 0 | 0 | 0 | 0,146853 |
| Sem PG 42324 (apenas) | X | 11 | 55 | 35 | 20 | 0 | 0 | 0 | 0,363636 |
| Sem PG 42324 (apenas) | T | 11 | 55 | 32 | 23 | 0 | 0 | 0 | 0,218182 |
| Sem PG 120 e 1342 | X | 10 | 45 | 34 | 11 | 0 | 0 | 0 | 0,648485 |
| Sem PG 120 e 1342 | T | 10 | 45 | 32 | 13 | 0 | 0 | 0 | 0,539394 |
X = bytes descomprimidos do XHTML serializado elegível; T = pontos de código do corpo literal normalizado, com separadores inseridos entre trechos de elementos. Nenhum dos dois é extensão exibida nem extensão validada da prosa. Cada par não ordenado é interligado dentro do seu conjunto fixo. O coeficiente de Spearman é descritivo, arredondado a seis casas, sem valores-p nem intervalos de confiança. Os recortes são diagnósticos, não correções preferidas; o conhecimento prévio da fonte e dos tamanhos veio antes de defini-los.

Dados e downloads
Role a tabela para os lados para ver todas as colunas.
| Arquivo Gutenberg | A recebido (bytes) | Imagens declaradas C (bytes) | U descomprimido (bytes) | Imagens C_img/A (%) | Imagens U_img/U (%) | Mudança de maioria (1 = sim) |
|---|---|---|---|---|---|---|
| PG 11 | 189.249 | 104.775 | 314.264 | 55,36 | 33,34 | 1 |
| PG 84 | 440.131 | 224.340 | 723.302 | 50,97 | 31,02 | 1 |
| PG 98 | 7.923.060 | 7.512.341 | 8.559.932 | 94,82 | 87,76 | 0 |
| PG 120 | 49.452.703 | 49.162.018 | 49.789.786 | 99,41 | 98,74 | 0 |
| PG 140 | 615.474 | 242.178 | 1.149.729 | 39,35 | 21,06 | 0 |
| PG 161 | 580.103 | 242.125 | 1.036.582 | 41,74 | 23,36 | 0 |
| PG 345 | 602.902 | 209.921 | 1.157.585 | 34,82 | 18,13 | 0 |
| PG 768 | 587.952 | 254.472 | 1.007.298 | 43,28 | 25,26 | 0 |
| PG 1260 | 3.095.830 | 2.574.499 | 3.779.323 | 83,16 | 68,12 | 0 |
| PG 1342 | 24.864.457 | 24.512.383 | 25.607.139 | 98,58 | 95,72 | 0 |
| PG 2701 | 814.023 | 257.017 | 1.780.233 | 31,57 | 14,44 | 0 |
| PG 42324 | 2.472.089 | 2.280.260 | 2.783.589 | 92,24 | 81,92 | 0 |
Os doze arquivos fixos, recebidos em 30 de outubro de 2026. C_img/A usa os bytes do corpo do arquivo recebido; U_img/U usa os bytes dos itens descomprimidos. Contam só itens de imagem declarados, inclusive as capas declaradas; não são contagens de ilustrações renderizadas ou incorporadas. As porcentagens são arredondadas a duas casas; as indicações de maioria usam as parcelas sem arredondar. Os identificadores designam arquivos, não obras independentes.
Role a tabela para os lados para ver todas as colunas.
| Conjunto fixo de arquivos | Indicador | Arquivos | Pares | Concordantes | Discordantes | Empates de tamanho | Empates de indicador | Empates nos dois | Rho de Spearman |
|---|---|---|---|---|---|---|---|---|---|
| Todos os arquivos fixos | X | 12 | 66 | 40 | 26 | 0 | 0 | 0 | 0,279720 |
| Todos os arquivos fixos | T | 12 | 66 | 37 | 29 | 0 | 0 | 0 | 0,146853 |
| Sem PG 42324 (apenas) | X | 11 | 55 | 35 | 20 | 0 | 0 | 0 | 0,363636 |
| Sem PG 42324 (apenas) | T | 11 | 55 | 32 | 23 | 0 | 0 | 0 | 0,218182 |
| Sem PG 120 e 1342 | X | 10 | 45 | 34 | 11 | 0 | 0 | 0 | 0,648485 |
| Sem PG 120 e 1342 | T | 10 | 45 | 32 | 13 | 0 | 0 | 0 | 0,539394 |
X = bytes descomprimidos do XHTML serializado elegível; T = pontos de código do corpo literal normalizado, com separadores inseridos entre trechos de elementos. Nenhum dos dois é extensão exibida nem extensão validada da prosa. Cada par não ordenado é interligado dentro do seu conjunto fixo. O coeficiente de Spearman é descritivo, arredondado a seis casas, sem valores-p nem intervalos de confiança. Os recortes são diagnósticos, não correções preferidas; o conhecimento prévio da fonte e dos tamanhos veio antes de defini-los.
Role a tabela para os lados para ver todas as colunas.
| Função declarada do item | Itens | C_r comprimido (bytes) | U_r descomprimido (bytes) | U_r/C_r |
|---|---|---|---|---|
| Controle do pacote | 36 | 29.306 | 172.397 | 5,882652 |
| Navegação | 24 | 45.659 | 387.227 | 8,480847 |
| Imagens de capa declaradas | 12 | 2.743.502 | 2.743.502 | 1,000000 |
| Outras imagens declaradas | 386 | 84.832.827 | 84.832.827 | 1,000000 |
| XHTML do provedor | 24 | 270.425 | 771.931 | 2,854510 |
| XHTML elegível | 412 | 3.520.103 | 8.608.444 | 2,445509 |
| Outros XHTML | 0 | 0 | 0 | Indefinido (zero bytes comprimidos) |
| Folhas de estilo | 112 | 44.555 | 172.434 | 3,870138 |
| Fontes tipográficas | 0 | 0 | 0 | Indefinido (zero bytes comprimidos) |
| Outros materiais declarados | 0 | 0 | 0 | Indefinido (zero bytes comprimidos) |
| Outros materiais fora do manifesto | 0 | 0 | 0 | Indefinido (zero bytes comprimidos) |
Somas de bytes dos doze arquivos, não a composição média de um livro. Os bytes comprimidos dos itens somam C = 91.486.377, não A. A sobra do contêiner, O = 151.596, é A − C e não é um item de mídia nem parte de U. Nas funções sem itens, a ausência foi observada; U/C fica indefinido, não é zero nem fonte ausente. Os bytes de imagem continuam sendo bytes de imagem codificada, não pixels.
Role a tabela para os lados para ver todas as colunas.
| Arquivo Gutenberg | A recebido (bytes) | Itens comprimidos C (bytes) | Contêiner O (bytes) | U descomprimido (bytes) | XHTML serializado X (bytes) | Corpo literal T (pontos de código) |
|---|---|---|---|---|---|---|
| PG 11 | 189.249 | 185.883 | 3.366 | 314.264 | 168.759 | 142.244 |
| PG 84 | 440.131 | 434.011 | 6.120 | 723.302 | 452.075 | 418.114 |
| PG 98 | 7.923.060 | 7.904.510 | 18.550 | 8.559.932 | 949.314 | 751.407 |
| PG 120 | 49.452.703 | 49.408.691 | 44.012 | 49.789.786 | 467.048 | 359.153 |
| PG 140 | 615.474 | 608.964 | 6.510 | 1.149.729 | 855.571 | 805.861 |
| PG 161 | 580.103 | 570.581 | 9.522 | 1.036.582 | 730.802 | 666.929 |
| PG 345 | 602.902 | 596.404 | 6.498 | 1.157.585 | 897.699 | 834.892 |
| PG 768 | 587.952 | 580.950 | 7.002 | 1.007.298 | 703.951 | 642.920 |
| PG 1260 | 3.095.830 | 3.079.104 | 16.726 | 3.779.323 | 1.122.265 | 1.016.740 |
| PG 1342 | 24.864.457 | 24.837.583 | 26.874 | 25.607.139 | 693.662 | 599.785 |
| PG 2701 | 814.023 | 810.935 | 3.088 | 1.780.233 | 1.299.019 | 1.113.194 |
| PG 42324 | 2.472.089 | 2.468.761 | 3.328 | 2.783.589 | 268.279 | 258.014 |
A = C + O. U é a soma dos itens ZIP descomprimidos e não inclui a sobra do contêiner O. X é parte de U, não todo o texto nem toda a prosa; T é um indicador de pontos de código do corpo literal, calculado por programa, não palavras nem páginas. Os bytes do corpo do arquivo não são o tamanho transferido por HTTP; U não é memória RAM. Todas as contagens são números inteiros exatos. Título e autoria constam junto às fontes exatas de cada arquivo.
Evidências e método
Como calculamos
- Guardar exatamente os doze arquivos EPUB3 oficiais, na variante com imagens, recebidos em 30 de outubro de 2026: identificadores 11, 84, 98, 120, 140, 161, 345, 768, 1260, 1342, 2701 e 42324. Validar os hashes reais dos arquivos originais, os CRCs do ZIP, as declarações dos pacotes e os destinos da sequência de leitura. Sem trocar fontes nem baixar de novo.
- Medir os bytes do arquivo recebido (A), a soma dos itens comprimidos (C), a soma dos itens descomprimidos (U) e, à parte, a sobra do contêiner (O = A − C). Para cada função, usar C_r/A como parcela no arquivo comprimido e U_r/U como parcela nos itens descomprimidos. U_r/C_r só é definido quando C_r é positivo; funções observadas como zero não são fontes ausentes.
- Classificar cada item uma única vez, pelas declarações e pela sequência de leitura reais do pacote: controle do pacote, navegação, imagem de capa declarada, outra imagem declarada, XHTML do provedor, XHTML elegível, outro XHTML, folha de estilo, fonte tipográfica, outro material declarado e outro material fora do manifesto. Contar apenas ITENS de imagem declarados, não ilustrações renderizadas, incorporadas ou remotas.
- Definir X como os bytes descomprimidos do XHTML serializado elegível, sem navegação nem cabeçalho e rodapé do provedor. Definir T, para cada corpo de documento, coletando em ordem os .text e .tail mantidos, ignorando o interior de script e style mas mantendo o .tail que vem logo depois deles, inserindo um espaço ASCII entre os trechos, reduzindo os espaços em branco Unicode (separar e juntar), contando pontos de código e somando os documentos sem separador entre eles. Não se medem renderização, palavras nem páginas.
- Comparar todos os pares não ordenados de arquivos para A contra X e A contra T. Guardar as concordâncias e discordâncias estritas e os estados de empate em separado. Calcular correlações descritivas de Spearman, com postos médios nos empates. Não tratar pares interligados como observações independentes, nem apresentar intervalos inferenciais ou afirmações de previsão.
- Manter os doze arquivos como conjunto principal. Recalcular à parte sem o Frankenstein de identificador mais alto (PG 42324) e sem os dois maiores arquivos (PG 120 e 1342). São recortes declarados e não preferidos. A visualização das fontes e dos tamanhos veio antes do protocolo; a convenção de separação de T, que não mudou, foi esclarecida depois do primeiro cálculo, e não foi pré-registrada às cegas.
- Reproduzir as quatro saídas agregadas derivadas a partir das entradas factuais compactas, numa pasta limpa. A medição original, opcional, usa EPUBs oficiais exatos obtidos à parte, com conferência de hash e de CRC. Mostrar porcentagens com duas casas e correlações e fatores com seis; calcular as indicações de maioria e as ordens antes de arredondar. Não distribuir texto, capa, ilustração nem o registro privado de nomes dos itens.
O que os dados não permitem concluir
- Doze arquivos de conversão, guardados por escolha deliberada e incluindo duas transcrições de Frankenstein, não são doze obras independentes nem uma amostra representativa do Gutenberg, dos ebooks, de autores ou de formatos. A equivalência de conteúdo entre versões não foi verificada.
- A conta os bytes do corpo do arquivo recebido, não os cabeçalhos HTTP nem o tamanho transferido pela rede. U conta os bytes dos itens ZIP descomprimidos, não memória RAM, páginas renderizadas, tempo de leitura, latência, desempenho de aparelhos ou custos de entrega. Arquivos de imagem codificados não são pixels.
- As funções de imagem e de capa descrevem itens declarados do pacote. Não formam um inventário de ilustrações renderizadas ou incorporadas, não atestam a qualidade de imagens ou capas, não provam que não existam ilustrações e não sustentam apagar ou recomprimir recursos.
- X inclui a marcação serializada e possível conteúdo que não é prosa. T é uma convenção de contagem de pontos de código do corpo literal, com espaços inseridos entre trechos de elementos. Não representa a visibilidade pelo CSS, palavras validadas, extensão literária nem equivalência de conteúdo renderizado.
- Sem PG 120 e 1342, as correlações sobem de modo importante e o número de pares discordantes cai. As divergências que restam não provam falha geral de previsão. Os doze arquivos continuam sendo o conjunto principal, e nenhum recorte é um conjunto corrigido preferido.
- A lista de fontes e os tamanhos dos arquivos já eram conhecidos antes do novo protocolo. Os separadores de elementos em T foram explicitados depois do primeiro cálculo, sem ajustes e sem mudança de resultados. Não se afirma pré-registro totalmente cego aos resultados nem ineditismo do método.
- Os pares de arquivos são observações interligadas num conjunto finito escolhido de propósito. Correlações e contagens de ordem são apenas descritivas: sem valores-p, intervalos de confiança, ranking de qualidade ou estimativa para uma população geral.
- As funções observadas como zero têm zero itens e zero bytes, e suas razões de compressão ficam indefinidas. Não são dados ausentes. Arquivos oficiais gerados de novo no futuro, com hashes diferentes, seriam outros arquivos, e não substitutos silenciosos desta captura.
- As indicações de domínio público nos Estados Unidos incorporadas aos arquivos e a licença completa do Gutenberg não comprovam liberação em todo o mundo nem dão licença geral para este artigo. Continuam valendo as condições de marca registrada e de jurisdição. Nenhum conteúdo de livro nem recurso visual original é redistribuído. Falhas de navegação e de acessibilidade ficam fora desta análise.
Fontes originais
- Project Gutenberg: official generated-content mirroring
Project Gutenberg: espelhamento oficial do conteúdo gerado. A documentação, consultada antes, indica gutenberg.pglaf.org como fonte alternativa da coleção gerada. Os doze endereços reais dos arquivos recebidos, as datas em UTC e as impressões digitais SHA-256 reais dos arquivos oficiais estão em source-archives.json; os scripts não fazem novas requisições. https://www.gutenberg.org/help/mirroring.html
Acesso em 30 de outubro de 2026
- Project Gutenberg: licence and rights guidance
Project Gutenberg: licença e orientações sobre direitos. A política, consultada antes, e a licença completa e a indicação de domínio público nos EUA que cada pacote guardado traz definem os direitos das fontes. Elas não comprovam liberação em todo o mundo nem licenciam a análise inteira. Nenhum texto, ilustração, capa ou logotipo de ebook é redistribuído. https://www.gutenberg.org/policy/license.html
Acesso em 30 de outubro de 2026
- Project Gutenberg EPUB artifact 11: Alice's Adventures in Wonderland
Arquivo EPUB 11 do Project Gutenberg: Alice's Adventures in Wonderland: Lewis Carroll. Variante EPUB3 com imagens, exatamente como recebida, com 189.249 bytes no corpo do arquivo; página canônica https://www.gutenberg.org/ebooks/11. A impressão digital real do arquivo oficial, em source-archives.json, identifica o original obtido à parte, que não é distribuído como ebook. Indicação de domínio público nos EUA e licença Gutenberg incorporada; não se afirma liberação mundial nem equivalência de conteúdo. https://gutenberg.pglaf.org/cache/epub/11/pg11-images-3.epub
Acesso em 30 de outubro de 2026
- Project Gutenberg EPUB artifact 84: Frankenstein; or, The modern Prometheus
Arquivo EPUB 84 do Project Gutenberg: Frankenstein; or, The modern Prometheus: Mary Wollstonecraft Shelley. Variante EPUB3 com imagens, exatamente como recebida, com 440.131 bytes no corpo do arquivo; página canônica https://www.gutenberg.org/ebooks/84. A impressão digital real do arquivo oficial, em source-archives.json, identifica o original obtido à parte, que não é distribuído como ebook. Indicação de domínio público nos EUA e licença Gutenberg incorporada; não se afirma liberação mundial nem equivalência de conteúdo. https://gutenberg.pglaf.org/cache/epub/84/pg84-images-3.epub
Acesso em 30 de outubro de 2026
- Project Gutenberg EPUB artifact 98: A Tale of Two Cities
Arquivo EPUB 98 do Project Gutenberg: A Tale of Two Cities: Charles Dickens. Variante EPUB3 com imagens, exatamente como recebida, com 7.923.060 bytes no corpo do arquivo; página canônica https://www.gutenberg.org/ebooks/98. A impressão digital real do arquivo oficial, em source-archives.json, identifica o original obtido à parte, que não é distribuído como ebook. Indicação de domínio público nos EUA e licença Gutenberg incorporada; não se afirma liberação mundial nem equivalência de conteúdo. https://gutenberg.pglaf.org/cache/epub/98/pg98-images-3.epub
Acesso em 30 de outubro de 2026
- Project Gutenberg EPUB artifact 120: Treasure Island
Arquivo EPUB 120 do Project Gutenberg: Treasure Island: Robert Louis Stevenson. Variante EPUB3 com imagens, exatamente como recebida, com 49.452.703 bytes no corpo do arquivo; página canônica https://www.gutenberg.org/ebooks/120. A impressão digital real do arquivo oficial, em source-archives.json, identifica o original obtido à parte, que não é distribuído como ebook. Indicação de domínio público nos EUA e licença Gutenberg incorporada; não se afirma liberação mundial nem equivalência de conteúdo. https://gutenberg.pglaf.org/cache/epub/120/pg120-images-3.epub
Acesso em 30 de outubro de 2026
- Project Gutenberg EPUB artifact 140: The Jungle
Arquivo EPUB 140 do Project Gutenberg: The Jungle: Upton Sinclair. Variante EPUB3 com imagens, exatamente como recebida, com 615.474 bytes no corpo do arquivo; página canônica https://www.gutenberg.org/ebooks/140. A impressão digital real do arquivo oficial, em source-archives.json, identifica o original obtido à parte, que não é distribuído como ebook. Indicação de domínio público nos EUA e licença Gutenberg incorporada; não se afirma liberação mundial nem equivalência de conteúdo. https://gutenberg.pglaf.org/cache/epub/140/pg140-images-3.epub
Acesso em 30 de outubro de 2026
- Project Gutenberg EPUB artifact 161: Sense and Sensibility
Arquivo EPUB 161 do Project Gutenberg: Sense and Sensibility: Jane Austen. Variante EPUB3 com imagens, exatamente como recebida, com 580.103 bytes no corpo do arquivo; página canônica https://www.gutenberg.org/ebooks/161. A impressão digital real do arquivo oficial, em source-archives.json, identifica o original obtido à parte, que não é distribuído como ebook. Indicação de domínio público nos EUA e licença Gutenberg incorporada; não se afirma liberação mundial nem equivalência de conteúdo. https://gutenberg.pglaf.org/cache/epub/161/pg161-images-3.epub
Acesso em 30 de outubro de 2026
- Project Gutenberg EPUB artifact 345: Dracula
Arquivo EPUB 345 do Project Gutenberg: Dracula: Bram Stoker. Variante EPUB3 com imagens, exatamente como recebida, com 602.902 bytes no corpo do arquivo; página canônica https://www.gutenberg.org/ebooks/345. A impressão digital real do arquivo oficial, em source-archives.json, identifica o original obtido à parte, que não é distribuído como ebook. Indicação de domínio público nos EUA e licença Gutenberg incorporada; não se afirma liberação mundial nem equivalência de conteúdo. https://gutenberg.pglaf.org/cache/epub/345/pg345-images-3.epub
Acesso em 30 de outubro de 2026
- Project Gutenberg EPUB artifact 768: Wuthering Heights
Arquivo EPUB 768 do Project Gutenberg: Wuthering Heights: Emily Brontë. Variante EPUB3 com imagens, exatamente como recebida, com 587.952 bytes no corpo do arquivo; página canônica https://www.gutenberg.org/ebooks/768. A impressão digital real do arquivo oficial, em source-archives.json, identifica o original obtido à parte, que não é distribuído como ebook. Indicação de domínio público nos EUA e licença Gutenberg incorporada; não se afirma liberação mundial nem equivalência de conteúdo. https://gutenberg.pglaf.org/cache/epub/768/pg768-images-3.epub
Acesso em 30 de outubro de 2026
- Project Gutenberg EPUB artifact 1260: Jane Eyre: An Autobiography
Arquivo EPUB 1260 do Project Gutenberg: Jane Eyre: An Autobiography: Charlotte Brontë. Variante EPUB3 com imagens, exatamente como recebida, com 3.095.830 bytes no corpo do arquivo; página canônica https://www.gutenberg.org/ebooks/1260. A impressão digital real do arquivo oficial, em source-archives.json, identifica o original obtido à parte, que não é distribuído como ebook. Indicação de domínio público nos EUA e licença Gutenberg incorporada; não se afirma liberação mundial nem equivalência de conteúdo. https://gutenberg.pglaf.org/cache/epub/1260/pg1260-images-3.epub
Acesso em 30 de outubro de 2026
- Project Gutenberg EPUB artifact 1342: Pride and Prejudice
Arquivo EPUB 1342 do Project Gutenberg: Pride and Prejudice: Jane Austen. Variante EPUB3 com imagens, exatamente como recebida, com 24.864.457 bytes no corpo do arquivo; página canônica https://www.gutenberg.org/ebooks/1342. A impressão digital real do arquivo oficial, em source-archives.json, identifica o original obtido à parte, que não é distribuído como ebook. Indicação de domínio público nos EUA e licença Gutenberg incorporada; não se afirma liberação mundial nem equivalência de conteúdo. https://gutenberg.pglaf.org/cache/epub/1342/pg1342-images-3.epub
Acesso em 30 de outubro de 2026
- Project Gutenberg EPUB artifact 2701: Moby Dick; Or, The Whale
Arquivo EPUB 2701 do Project Gutenberg: Moby Dick; Or, The Whale: Herman Melville. Variante EPUB3 com imagens, exatamente como recebida, com 814.023 bytes no corpo do arquivo; página canônica https://www.gutenberg.org/ebooks/2701. A impressão digital real do arquivo oficial, em source-archives.json, identifica o original obtido à parte, que não é distribuído como ebook. Indicação de domínio público nos EUA e licença Gutenberg incorporada; não se afirma liberação mundial nem equivalência de conteúdo. https://gutenberg.pglaf.org/cache/epub/2701/pg2701-images-3.epub
Acesso em 30 de outubro de 2026
- Project Gutenberg EPUB artifact 42324: Frankenstein; or, The modern Prometheus
Arquivo EPUB 42324 do Project Gutenberg: Frankenstein; or, The modern Prometheus: Mary Wollstonecraft Shelley. Variante EPUB3 com imagens, exatamente como recebida, com 2.472.089 bytes no corpo do arquivo; página canônica https://www.gutenberg.org/ebooks/42324. A impressão digital real do arquivo oficial, em source-archives.json, identifica o original obtido à parte, que não é distribuído como ebook. Indicação de domínio público nos EUA e licença Gutenberg incorporada; não se afirma liberação mundial nem equivalência de conteúdo. https://gutenberg.pglaf.org/cache/epub/42324/pg42324-images-3.epub
Acesso em 30 de outubro de 2026
Como citar e reutilizar
Alisson Bento. Dentro de 12 arquivos EPUB: bytes e indicadores de texto. 2026, pesquisa original. https://alissonbento.com/pt/research/gutenberg-epub-payload-composition-12-artifacts/
Os autores das obras e o Project Gutenberg são creditados pelos arquivos EPUB exatos recebidos. Os downloads públicos contêm entradas factuais compactas de bytes e indicadores, resultados numéricos e código originais, referências canônicas às fontes e impressões digitais reais dos arquivos oficiais. Não contêm texto de ebooks, capas, ilustrações nem o registro privado de nomes dos itens. As impressões digitais identificam originais obtidos à parte; SHA256SUMS.txt lista as somas de verificação dos arquivos compactos de fato distribuídos. As indicações de domínio público nos Estados Unidos e a licença do Gutenberg continuam sujeitas a limites de jurisdição e de marca registrada; não se afirma liberação mundial, endosso nem licença geral para o artigo. Análise e explicação originais: Alisson Bento.
Correções ou dúvidas editoriais