
Eine Dateigröße, mehrere verschiedene Messgrößen
Ein EPUB-Download hat eine einzige Dateigröße. Diese Zahl fasst aber Bestandteile zusammen, die sich innerhalb der Datei unterschiedlich verhalten. Lesedokumente, kodierte Bilddateien, Navigation, Stylesheets und die Verpackung tragen jeweils Bytes bei. Wie groß ihre Anteile sind, hängt davon ab, ob man die heruntergeladene Datei misst oder ihre entpackten Bestandteile. Eine Aussage wie „Dieses E-Book besteht größtenteils aus Bildern“ braucht deshalb zweierlei: eine klare Liste dessen, was als Bild zählt, und eine Bezugsgröße. Ohne beides können zwei richtige Rechnungen einander zu widersprechen scheinen, obwohl sie verschiedene Fragen zu genau derselben Datei beantworten.
Diese Analyse misst zwölf feste EPUB3-Dateien von Project Gutenberg, jeweils in der Variante mit Bildern, die wir am 30. Oktober 2026 erhalten haben. Bei zwei Dateien wechselt die Einstufung als Bildmehrheit mit der Bezugsgröße. Die deklarierten Bilder machen mehr als die Hälfte der Dateigröße aus, aber weniger als die Hälfte der entpackten Größe der Einträge. Außerdem weicht die Rangfolge nach Dateigröße bei 26 beziehungsweise 29 der 66 Dateipaare von der Rangfolge nach zwei ausdrücklich definierten Textmaßen ab, die nicht dargestellten Text messen. Das sind Zählergebnisse für diese konvertierten Dateien. Sie sind keine Schätzungen für E-Books oder voneinander unabhängige literarische Werke im Allgemeinen.
Die verbindende Einsicht lautet: Man sollte benennen, was man vergleicht, bevor man eine Größe deutet. Wer einen Download prüft, kann die heruntergeladene Datei von ihren inneren Bestandteilen unterscheiden. Wer E-Books herstellt oder einen Katalog auswertet, kann eine Liste der Dateien im Paket von einem Textmaß unterscheiden. Keine dieser Prüfungen misst angezeigte Seiten, eine geprüfte Länge des Prosatexts oder den Leseaufwand. Die Ergebnisse sind reproduzierbare Beispiele für Messentscheidungen. Sie belegen nicht, dass eine Ausgabe unnötig aufgebläht, schlecht illustriert oder schwer lesbar ist oder dass man ihre Dateien löschen sollte.
Die Dateien so lassen, wie wir sie erhalten haben
Die zwölf Dateien tragen die Gutenberg-Kennungen 11, 84, 98, 120, 140, 161, 345, 768, 1260, 1342, 2701 und 42324. Die Adressen der offiziellen Titelseiten und der tatsächlich genutzten Spiegelserver stehen in den Downloads mit den Belegdaten. Dort finden sich auch das Datum des Erhalts, die Dateigrößen in Bytes und die Prüfsummen der Originaldateien. Die Auswahl stammt unverändert aus einer früheren Untersuchung der Struktur. Sie soll weder ein Genre noch eine Gruppe von Autorinnen und Autoren noch die heutige EPUB-Produktion abbilden. Jede Beobachtung ist eine genau so erhaltene konvertierte Datei und keine zeitlose Eigenschaft eines Buchtitels.
Die Auswahl umfasst Alice’s Adventures in Wonderland, A Tale of Two Cities, Treasure Island, The Jungle, Sense and Sensibility, Dracula, Wuthering Heights, Jane Eyre, Pride and Prejudice und Moby Dick sowie zwei Frankenstein-Transkriptionen. Die beiden Frankenstein-Dateien bleiben getrennte Fälle, ohne zu unabhängigen literarischen Werken zu werden. Ihre Unterschiede lassen sich nicht allein der Verpackung zuschreiben: Ob Text und Redaktion gleichwertig sind, wurde nicht geprüft. Ebenso beschreiben die Dateinamen der Variante mit Bildern nur die erhaltenen Dateien. Sie sind kein kontrollierter Vergleich mit Ausgaben ohne Bilder.
Es sind dieselben aufbewahrten Dateien wie bei einer früheren Prüfung der Navigation, aber die Frage ist eine andere. Jene Prüfung fand auflösbare Ziele in der Navigation und stützte keine eigenständige Behauptung über fehlende Kapitel. Aussagen über Navigationsfehler und Barrierefreiheit liegen außerhalb dieser Analyse. Hier geht es um die deklarierten Kategorien der Einträge, die Zählung der Bytes, den Zustand der Kompression und Vergleiche von Reihenfolgen in einer begrenzten Menge. Kein EPUB wurde erneut heruntergeladen, um eine günstigere Version zu erhalten. Eine künftig veränderte offizielle Datei wäre eine andere Datei. Ihre Messwerte dürfen diesen datierten Stand nicht stillschweigend ersetzen.
Die Größe der Datei von der Größe der Einträge trennen
A ist die Größe der erhaltenen Datei in Bytes. C ist die Summe der gepackten Größen aller ZIP-Einträge, U die Summe ihrer entpackten Größen. Auf die ZIP-Verpackung entfällt der Rest O = A − C. Über die zwölf Dateien summiert sich A auf 91.637.973 Bytes, C auf 91.486.377, O auf 151.596 und U auf 97.688.762. Die Verpackung ist kein weiterer Eintrag mit Inhalt, und ihre Bytes werden nicht zu U addiert. Weil der Rest sichtbar ausgewiesen wird, verschieben sich die Anteile der Kategorien nicht unbemerkt auf eine andere Gesamtgröße.
Für eine Kategorie r ist der Anteil an der erhaltenen Datei C_r/A. Der Anteil an den entpackten Einträgen ist U_r/U. Beide Größen sind nützlich, aber ihre Prozentsätze sind nicht austauschbar. Im ersten Nenner steckt die ZIP-Verpackung. Der zweite betrachtet die Einträge nach dem Entpacken und lässt die Verpackung außen vor. „Entpackt“ bezieht sich hier nur auf die ZIP-Ebene. Eine kodierte JPEG- oder andere Bilddatei bleibt eine kodierte Datei und ist keine Zahl roher Pixel. U ist auch kein Arbeitsspeicher, keine Bildschirmdarstellung und kein Ressourcenbedarf eines Lesegeräts.
Ein Kompressionsverhältnis U_r/C_r wird nur angegeben, wenn C_r größer als null ist. Eine Kategorie, in der keine Einträge vorkommen, hat null Einträge und null Bytes. Ihr Quotient ist dann aber nicht null, sondern nicht definiert. Davon zu unterscheiden ist eine nicht verfügbare Quelle: Dann würde die Prüfung abbrechen, statt einen Nullwert einzusetzen. Das ist besonders für Schriften und sonstige Kategorien wichtig, die in dieser Auswahl durchgehend mit null beobachtet werden. Null Bytes, ein nicht definierter Quotient und eine fehlende Eingabe sind drei verschiedene Zustände. In weiterverwendeten Tabellen und Diagrammen müssen sie unterscheidbar bleiben.
Deklarierte Einträge einordnen, nicht sichtbare Abbildungen
Die Einordnung folgt der tatsächlichen Inhaltsliste des Pakets (Manifest) und der Lesereihenfolge (Spine). Es gibt elf Kategorien: Paketsteuerung, Navigation, deklarierte Titelbilder (Cover), andere deklarierte Bilder, XHTML-Dateien des Anbieters, zulässige XHTML-Dateien des Lesetexts, sonstige XHTML-Dateien, Stylesheets, Schriften, sonstiges deklariertes Material und sonstiges Material, das nicht im Manifest steht. Jede Datei behält alle elf Zeilen, auch beobachtete Nullen. Ein Cover wird anhand der Deklaration im Paket erkannt und nicht anhand von Dateiname oder Aussehen vermutet. Die Kopf- und Schlussdokumente des Anbieters sowie die Navigation werden getrennt von den zulässigen Lesetext-Dateien gemessen. Sie zählen also nicht stillschweigend als literarischer Inhalt.
Insgesamt enthält die Liste 1.006 ZIP-Einträge. Darunter sind 398 deklarierte Bildeinträge: zwölf deklarierte Cover und 386 andere Bilder. Alle deklarierten Bildeinträge sind ohne weitere ZIP-Kompression gespeichert, ihre gepackte und entpackte Größe ist daher gleich. Die 412 zulässigen XHTML-Dateien des Lesetexts belegen dagegen entpackt 8.608.444 Bytes und gepackt 3.520.103 Bytes. Diese verschiedene Behandlung der Eintragsarten verändert ihr relatives Gewicht, wenn man von der Dateigröße zur entpackten Größe der Einträge wechselt. Eine allgemeine Regel für alle EPUB-Konverter folgt daraus nicht.
Sechs Dateien haben ein deklariertes Cover und keine weiteren deklarierten Bildeinträge: die Kennungen 11, 84, 140, 161, 768 und 2701. Das ist eine Aussage über die Liste der Einträge. Sie beweist nicht, dass die dargestellten Seiten keine anderen Abbildungen enthalten. Eingebettete Datenbilder, externe Verweise, Layouteffekte und die tatsächliche Sichtbarkeit von Bildern liegen außerhalb dieser Liste. Eine Cover-Deklaration sagt ebenfalls nichts über die Qualität des Bildes oder darüber, wie eine Leseanwendung es anzeigt. Die Analyse hört bewusst vor diesen Fragen zur Optik und Funktion auf. Dafür wären andere Belege und andere Verfahren nötig.
Zwei Bildmehrheiten hängen von der Bezugsgröße ab
Bei Alice’s Adventures in Wonderland (Kennung 11) macht der deklarierte Bildeintrag 104.775 Bytes aus. Gemessen an der erhaltenen Datei von 189.249 Bytes sind das 55,36 %. Gemessen an 314.264 Bytes entpackter Einträge sind es für dasselbe kodierte Bild 33,34 %. Zwischen den beiden Rechnungen verschwinden keine Bildbytes, und die Qualität ändert sich nicht. Stattdessen fallen entpackte Einträge, die keine Bilder sind, in der zweiten Bezugsgröße stärker ins Gewicht. „Datei mit Bildmehrheit“ und „entpackte Einträge ohne Bildmehrheit“ sind daher beide zutreffend, solange jede Aussage ihre eigene Zählweise nennt.
Kennung 84, Frankenstein, ist der zweite Fall mit Wechsel. Ihre 224.340 deklarierten Bildbytes sind 50,97 % einer erhaltenen Datei von 440.131 Bytes, aber 31,02 % ihrer 723.302 Bytes an entpackten Einträgen. Beide Beispiele haben in dieser Liste nur ein deklariertes Cover. Ihre Ergebnisse hängen deshalb nicht von vielen einzeln deklarierten Bildern im Innern ab. Die gepaarten Balken zeigen alle Dateien und nicht nur die Fälle mit Wechsel. So lassen sich diese Beispiele neben Fälle stellen, in denen beide Prozentsätze auf derselben Seite der Hälfte bleiben.
Die übrigen Dateien zeigen große Unterschiede, ohne dass die Mehrheit wechselt. Bei Moby Dick betragen die Bildanteile 31,57 % und 14,44 %, bei Treasure Island dagegen 99,41 % und 98,74 %. Diese Prozentsätze beschreiben die genannten Dateien und Bezugsgrößen. Sie sind keine Rangfolge redaktioneller Qualität. Ein hoher Anteil kann mit nützlichen Illustrationen vereinbar sein. Ein niedriger Anteil bescheinigt weder Barrierefreiheit noch kleine angezeigte Seiten. Sinnvoll ist eine genaue Aufstellung dessen, was Bytes belegt, und keine Empfehlung, eine bestimmte Zusammensetzung sei grundsätzlich besser.
Textmaße festlegen, ohne eine Darstellung vorzutäuschen
Das erste Textmaß, X, zählt die entpackten, serialisierten Bytes der zulässigen XHTML-Dateien des Lesetexts, ohne Navigation und ohne Kopf- und Schlussdokumente des Anbieters. Das Markup, also die Auszeichnung des Textes, zählt dabei mit. Das gilt auch für Titelei, Bildunterschriften und anderes Material in diesen Dokumenten. X lässt sich aus der Paketstruktur leicht reproduzieren. Es ist aber weder eine geprüfte Wortzahl des Romans noch ein Maß für sichtbaren Text. Unterschiede bei Markup, Zeichenkodierung und Aufbau der Dokumente können X beeinflussen, auch wenn das Leseerlebnis auf dem Bildschirm ähnlich sein könnte.
Das zweite Textmaß, T, zählt die Zeichen (Unicode-Codepunkte) im Textkörper der Seiten nach einer ausdrücklich festgelegten Regel, nachdem der Leerraum vereinheitlicht wurde. Der Text jedes Elements und der Text, der direkt hinter einem Unterelement folgt, werden in der Reihenfolge des Dokuments gesammelt. Inhalte von script- und style-Elementen werden übersprungen. Der Text, der direkt auf ein übersprungenes Element folgt, bleibt aber erhalten, weil er zum übergeordneten Element gehört. Die gesammelten Textstücke werden mit je einem eingefügten ASCII-Leerzeichen verbunden. Anschließend wird jede Folge von Leerraumzeichen nach Unicode mit split-and-join zu einem einzigen Leerzeichen zusammengezogen. Die Zahlen der einzelnen Dokumente werden ohne zusätzlichen Trenner zwischen den Dokumenten addiert. Es gibt keine Anpassung der Groß- und Kleinschreibung, keine Reparatur von Silbentrennung, keine Zerlegung in Wörter und keine Unicode-Normalisierung.
Die eingefügten Trenner zwischen den Textstücken sind eine technische Konvention. Sie behaupten nicht, dass die angezeigte Seite an jeder Elementgrenze ein Leerzeichen enthält. T erfasst auch nicht, was nach CSS sichtbar ist, erkennt nicht jeden Inhalt, der keine Prosa ist, und belegt keine gleichwertigen Ausgaben. Die genaue Trennregel wurde nach der ersten Berechnung von T dokumentiert, um eine Mehrdeutigkeit zu beseitigen. Die umgesetzte Regel und die Ergebnisse haben sich dabei nicht geändert. Man darf sie nicht als Detail bezeichnen, das vorab und unabhängig von den Ergebnissen festgelegt wurde. Die Definitionen beider Textmaße sind offen nachprüfbar. Selbst wenn sie übereinstimmten, wäre keines davon eine literarische Länge oder eine Lesezeit.
Begrenzte Reihenfolgen vergleichen, keine Bücher vorhersagen
Für jedes Textmaß wird jedes ungeordnete Paar der zwölf Dateien mit der Dateigröße verglichen. Ein Paar ist streng gegenläufig, wenn von den beiden Dateien die größere das kleinere Textmaß hat. Hat die größere Datei auch das größere Textmaß, ist es streng gleichläufig. Gleichläufige Paare und Gleichstände bleiben gesondert erhalten. Es gibt 66 verknüpfte Paare, nicht 66 unabhängig gezogene Beobachtungen. In der vollständigen Auswahl liefert X 40 gleichläufige und 26 gegenläufige Paare, T liefert 37 und 29. Weder bei der Dateigröße noch bei den Textmaßen gibt es Gleichstände. Die Paarliste hält die tatsächlichen Fälle hinter diesen Summen fest. Eine einzelne Korrelation ersetzt sie nicht.
Die beschreibenden Rangkorrelationen nach Spearman betragen, auf sechs Dezimalstellen gerundet, 0,279720 für Dateigröße und X sowie 0,146853 für Dateigröße und T. Sie fassen zusammen, wie ähnlich die Reihenfolgen in dieser festen Auswahl sind. Sie sind weder Maße für die Güte einer Vorhersage noch Kennwerte einer Grundgesamtheit. Sie belegen auch nicht, dass die Dateigröße anderswo nie aussagekräftig sein könne. Jede Datei geht in mehrere Vergleiche ein. Die Summen der Paare dürfen deshalb nicht einfach in ein Modell mit unabhängigen Versuchen eingehen. Für diesen bewusst begrenzten Vergleich geben wir weder Signifikanztests noch Konfidenzintervalle noch ein allgemeines Modell der Größe von E-Books an.
Ein konkreter Gegensatz macht die Einheiten leichter prüfbar. Treasure Island (Kennung 120) ist mit 49.452.703 Bytes die größte Datei. X beträgt dort aber 467.048 und T 359.153. Moby Dick (Kennung 2701) hat eine Datei von 814.023 Bytes, aber X beträgt 1.299.019 und T 1.113.194. Der Vergleich zeigt, dass die Reihenfolgen dieser erfassten Größen nicht übereinstimmen. Er zeigt nicht, dass ein Roman im geprüften literarischen Sinn länger ist. Er isoliert auch nicht die Wirkung entfernter Bilder, denn es gab weder ein Vergleichspaket ohne Bilder noch eine inhaltsgleiche Rekonstruktion.
Zeigen, wie stark die größten Dateien das Ergebnis beeinflussen
Lässt man die Kennungen 120 und 1342 weg, die beiden größten Dateien, werden die Zusammenhänge deutlich stärker. Unter den verbleibenden zehn Dateien steigen die Korrelationen auf 0,648485 für X und 0,539394 für T. Die gegenläufigen Paare sinken auf 11 beziehungsweise 13 von 45 Paaren. Das ist eine wichtige Einschränkung und keine Randbemerkung, die man mit „Die Ausreißer spielen keine Rolle“ zusammenfassen könnte. Für die Stärke dieser Zusammenhänge in der festen Auswahl spielen sie sehr wohl eine Rolle. Die verbleibenden Abweichungen zeigen nur, dass die Unterschiede in der Reihenfolge nicht ganz auf diese beiden Dateien beschränkt sind.
Eine zweite Variante lässt die Kennung 42324 weg, die Frankenstein-Transkription mit der höheren Kennung. Die elf verbleibenden Dateien ergeben 20 gegenläufige Paare bei X und 23 bei T unter 55 Paaren, bei Korrelationen von 0,363636 und 0,218182. Beide Wechsel der Bildmehrheit bleiben in beiden Varianten bestehen. Diese Rechnungen zeigen, wie sehr das Ergebnis an einer Datei hängt, die ein Werk doppelt enthält, und an den größten Dateien. Keine der beiden Varianten gilt dabei als korrigierte oder bevorzugte Auswahl. Alle zwölf Dateien bleiben die Hauptauswahl. Dass die beiden Frankenstein-Transkriptionen literarisch gleichwertig sind, behaupten wir nicht.
Die Variante ohne die beiden größten Dateien wurde festgelegt, als wir die Dateigrößen aus dem übernommenen Verzeichnis der Quellen schon kannten. Das neue Vorgehen kann deshalb nicht behaupten, vollkommen ohne Kenntnis der Daten festgelegt worden zu sein. Es legte die Regeln für Zählung und Vergleich vor den neuen Ergebnissen zu Kategorien und Textmaßen fest, aber Quellen und Größen waren schon bekannt. Die spätere Klarstellung zu T setzt eine weitere offengelegte zeitliche Grenze. Diese Varianten sind offen dargelegte, beschreibende Robustheitsprüfungen. Sie sind keine unabhängigen Stichproben zur Bestätigung und keine Erlaubnis, den Koeffizienten für die stärkste Schlagzeile auszuwählen. Lesende sollten die vollständige Auswahl neben beiden eingeschränkten Varianten im Blick behalten.
Zusammengefasste Summen und gerundete Prozentwerte richtig lesen
Die zusammengefasste Liste der Kategorien addiert Bytes über alle Dateien hinweg. Sie mittelt nicht zwölf E-Book-Zusammensetzungen. Eine große Datei trägt zu dieser gemeinsamen Summe mehr Bytes bei als eine kleine. Ein zusammengefasster Bildanteil würde deshalb eine Frage nach dem Gesamtvolumen beantworten. Er würde weder die typische Datei beschreiben noch den Anteil der Titel mit Bildmehrheit. Die Unterschiede zwischen den Dateien lassen sich in der Tabelle je Datei prüfen. Hält man beide Ebenen bereit, verhindert das, dass die zwei größten Pakete unbemerkt ein angeblich typisches Buch bestimmen.
Auch Unterschiede in Prozentpunkten brauchen eine eigene Bezeichnung. Die beiden Bildanteile von Alice unterscheiden sich um etwa 22,02 Prozentpunkte, berechnet aus den ungerundeten Anteilen. Das ist weder ein gemessener Rückgang der Bildbytes noch eine Verbesserung um 22,02 % in irgendeinem Sinn. Der Zähler bleibt unverändert. Eine relative prozentuale Änderung hätte eine andere Formel und würde eine andere Frage beantworten. Das Kennzeichen für die Mehrheit prüft nur, ob der definierte Anteil über 50 % liegt. Es bewertet weder den Umfang noch den Nutzen der Bilder.
Prozentwerte werden mit zwei, Korrelationen mit sechs Dezimalstellen angezeigt. Die Belegdaten behalten dagegen die ganzzahligen Bytewerte und die berechneten Werte. Die Kennzeichen für die Mehrheit und die Richtung der Paare werden vor dem Runden für die Anzeige berechnet. Das ist wichtig, denn eine gerundete Gleichheit muss in einer anderen Auswahl kein echter Gleichstand sein. Hier gibt es weder bei der Dateigröße noch bei den Textmaßen Gleichstände. Die Vergleichsliste führt aber dennoch getrennte Zustände für Gleichstände. Wer exakt nachrechnen will und dazu die gerundete Anzeigetabelle nutzt, verliert Informationen, die die kompakten maschinenlesbaren Eingaben bewusst erhalten.
Die Unterscheidungen beim Lesen und Herstellen nutzen
Für Lesende kann die nächstliegende Frage schlicht lauten, was eine angegebene Größe beim Herunterladen eigentlich misst. In dieser Auswertung ist dafür die Größe der erhaltenen Datei in Bytes die passende Zahl. Die Summen der Einträge beantworten eine andere Frage. Keine der beiden Zahlen legt für sich fest, wie viele Seiten eine Anwendung anzeigen wird. Wer das Datum des Stands und die genaue Adresse der Variante festhält, verhindert, dass eine Bezeichnung der Ausgabe eine exakt bestimmte Datei ersetzt. Das ist besonders nützlich, wenn ein Anbieter ein EPUB neu erzeugen kann, ohne den vertrauten Titel des Werks zu ändern.
Wer E-Books schreibt oder redigiert, kann mit der Liste der Kategorien über die Verpackung sprechen, ohne einen Prozentsatz mit einem Qualitätsurteil zu verwechseln. Ein Bericht kann die deklarierten Bilddateien nennen, Cover von anderen deklarierten Bildern trennen und erklären, ob die Prozentsätze gepackte oder entpackte Bytes verwenden. Er kann außerdem Navigation, Dokumente des Anbieters und den Rest der Verpackung sichtbar halten. So wird ein technisches Gespräch nachvollziehbar. Es klärt aber nicht, welche Dateien man löschen sollte, ob man Bilder neu komprimieren sollte oder ob eine Änderung das beabsichtigte Leseerlebnis erhielte.
Für die Auswertung von Katalogen warnt der Vergleich der Reihenfolgen davor, ein unbeschriftetes Feld „Buchgröße“ an die Stelle einer definierten Textgröße zu setzen. Die stärkeren Korrelationen ohne die größten Dateien zeigen ebenfalls, warum die vollständige Auswahl zählt: Kein einzelner Koeffizient ersetzt die Prüfung der Einzelfälle. Wer das Ergebnis weiterverwenden will, sollte die genaue Auswahl der Quellen, das Textmaß und die Zählweise nennen und dann die passenden Vergleiche nachrechnen. Die Koeffizienten dieser Auswahl dürfen nicht als Vorhersageregel auf andere Kataloge, andere Formate oder künftige Konvertierungen von Gutenberg übertragen werden.
Kompakte Fakten reproduzieren, ohne Bücher weiterzugeben
Das öffentliche Paket mit den Belegen enthält ausgewählte Eingaben mit den Bytes je Kategorie und die Werte der Textmaße. Dazu kommen Verweise auf die Quelldateien, abgeleitete Kennzahlen je Datei und Kategorie, alle Paarvergleiche und eine Zusammenfassung. Das Programm zur Reproduktion der Summen arbeitet mit diesen kompakten Eingaben und mit ausdrücklich angegebenen Verzeichnissen für Eingabe und Ausgabe. Ein getrenntes, optionales Skript zur Messung kann separat beschaffte, exakt passende offizielle EPUB-Dateien untersuchen, nachdem es ihre Prüfsummen kontrolliert hat. Es stellt keine Anfragen an Quellen und gibt Zahlen statt Buchinhalten aus. Die öffentliche Prüfsummenliste beschreibt die kompakten Dateien, die wir tatsächlich verteilen. Die Prüfsummen der Originaldateien kennzeichnen externe Quelldateien, die nicht zum Paket gehören und separat beschafft werden müssten.
Die Quelldateien bleiben privat aufbewahrte Eingaben. Das öffentliche Paket enthält weder vollständige Romantexte noch extrahierten Fließtext, Cover oder Illustrationen. Die interne Liste der Eintragsnamen ist kein Download. Die Autorinnen und Autoren der Quellen sowie Project Gutenberg werden getrennt von den eigenen Berechnungen und Erläuterungen von Alisson Bento genannt. Jedes aufbewahrte Paket trägt einen Hinweis auf Gemeinfreiheit in den Vereinigten Staaten und die Gutenberg-Lizenz. Diese Hinweise und die zitierte Richtlinie belegen keine weltweite Rechtefreiheit und heben Markenbedingungen nicht auf. Sie sind auch keine pauschale Lizenz für den gesamten Artikel oder jede mögliche spätere Verwendung.
Das Endergebnis ist bewusst enger als ein Urteil über E-Books. Zwei Einstufungen als Bildmehrheit ändern sich mit der Bezugsgröße, und die Reihenfolgen nach Dateigröße weichen von zwei ausdrücklich nicht dargestellten Textmaßen ab. Die größten Dateien beeinflussen die Zusammenfassungen der Reihenfolgen wesentlich. Zugleich bleiben die Abweichungen und die Wechsel der Mehrheit in beiden Varianten bestehen. Die Befunde stützen sorgfältige Bezeichnungen der Einheiten und überprüfbare Beispiele. Sie stützen keine Aussagen über Navigationsfehler, visuelle Qualität, Lesezeit, Datenverkehr, Latenz, Speicher oder Geräteleistung. Diese Grenzen machen die kleine feste Auswahl nützlich und verhindern, dass sie zu einer Sammlung eindrucksvoller Dateigrößen wird.
Deklarierte Bilder: zwei Zählweisen
Gutenberg-EPUBs · Erhalten am 30. Oktober 2026 · 12 feste EPUB-Dateien
Vollständige Grafik und Quelle
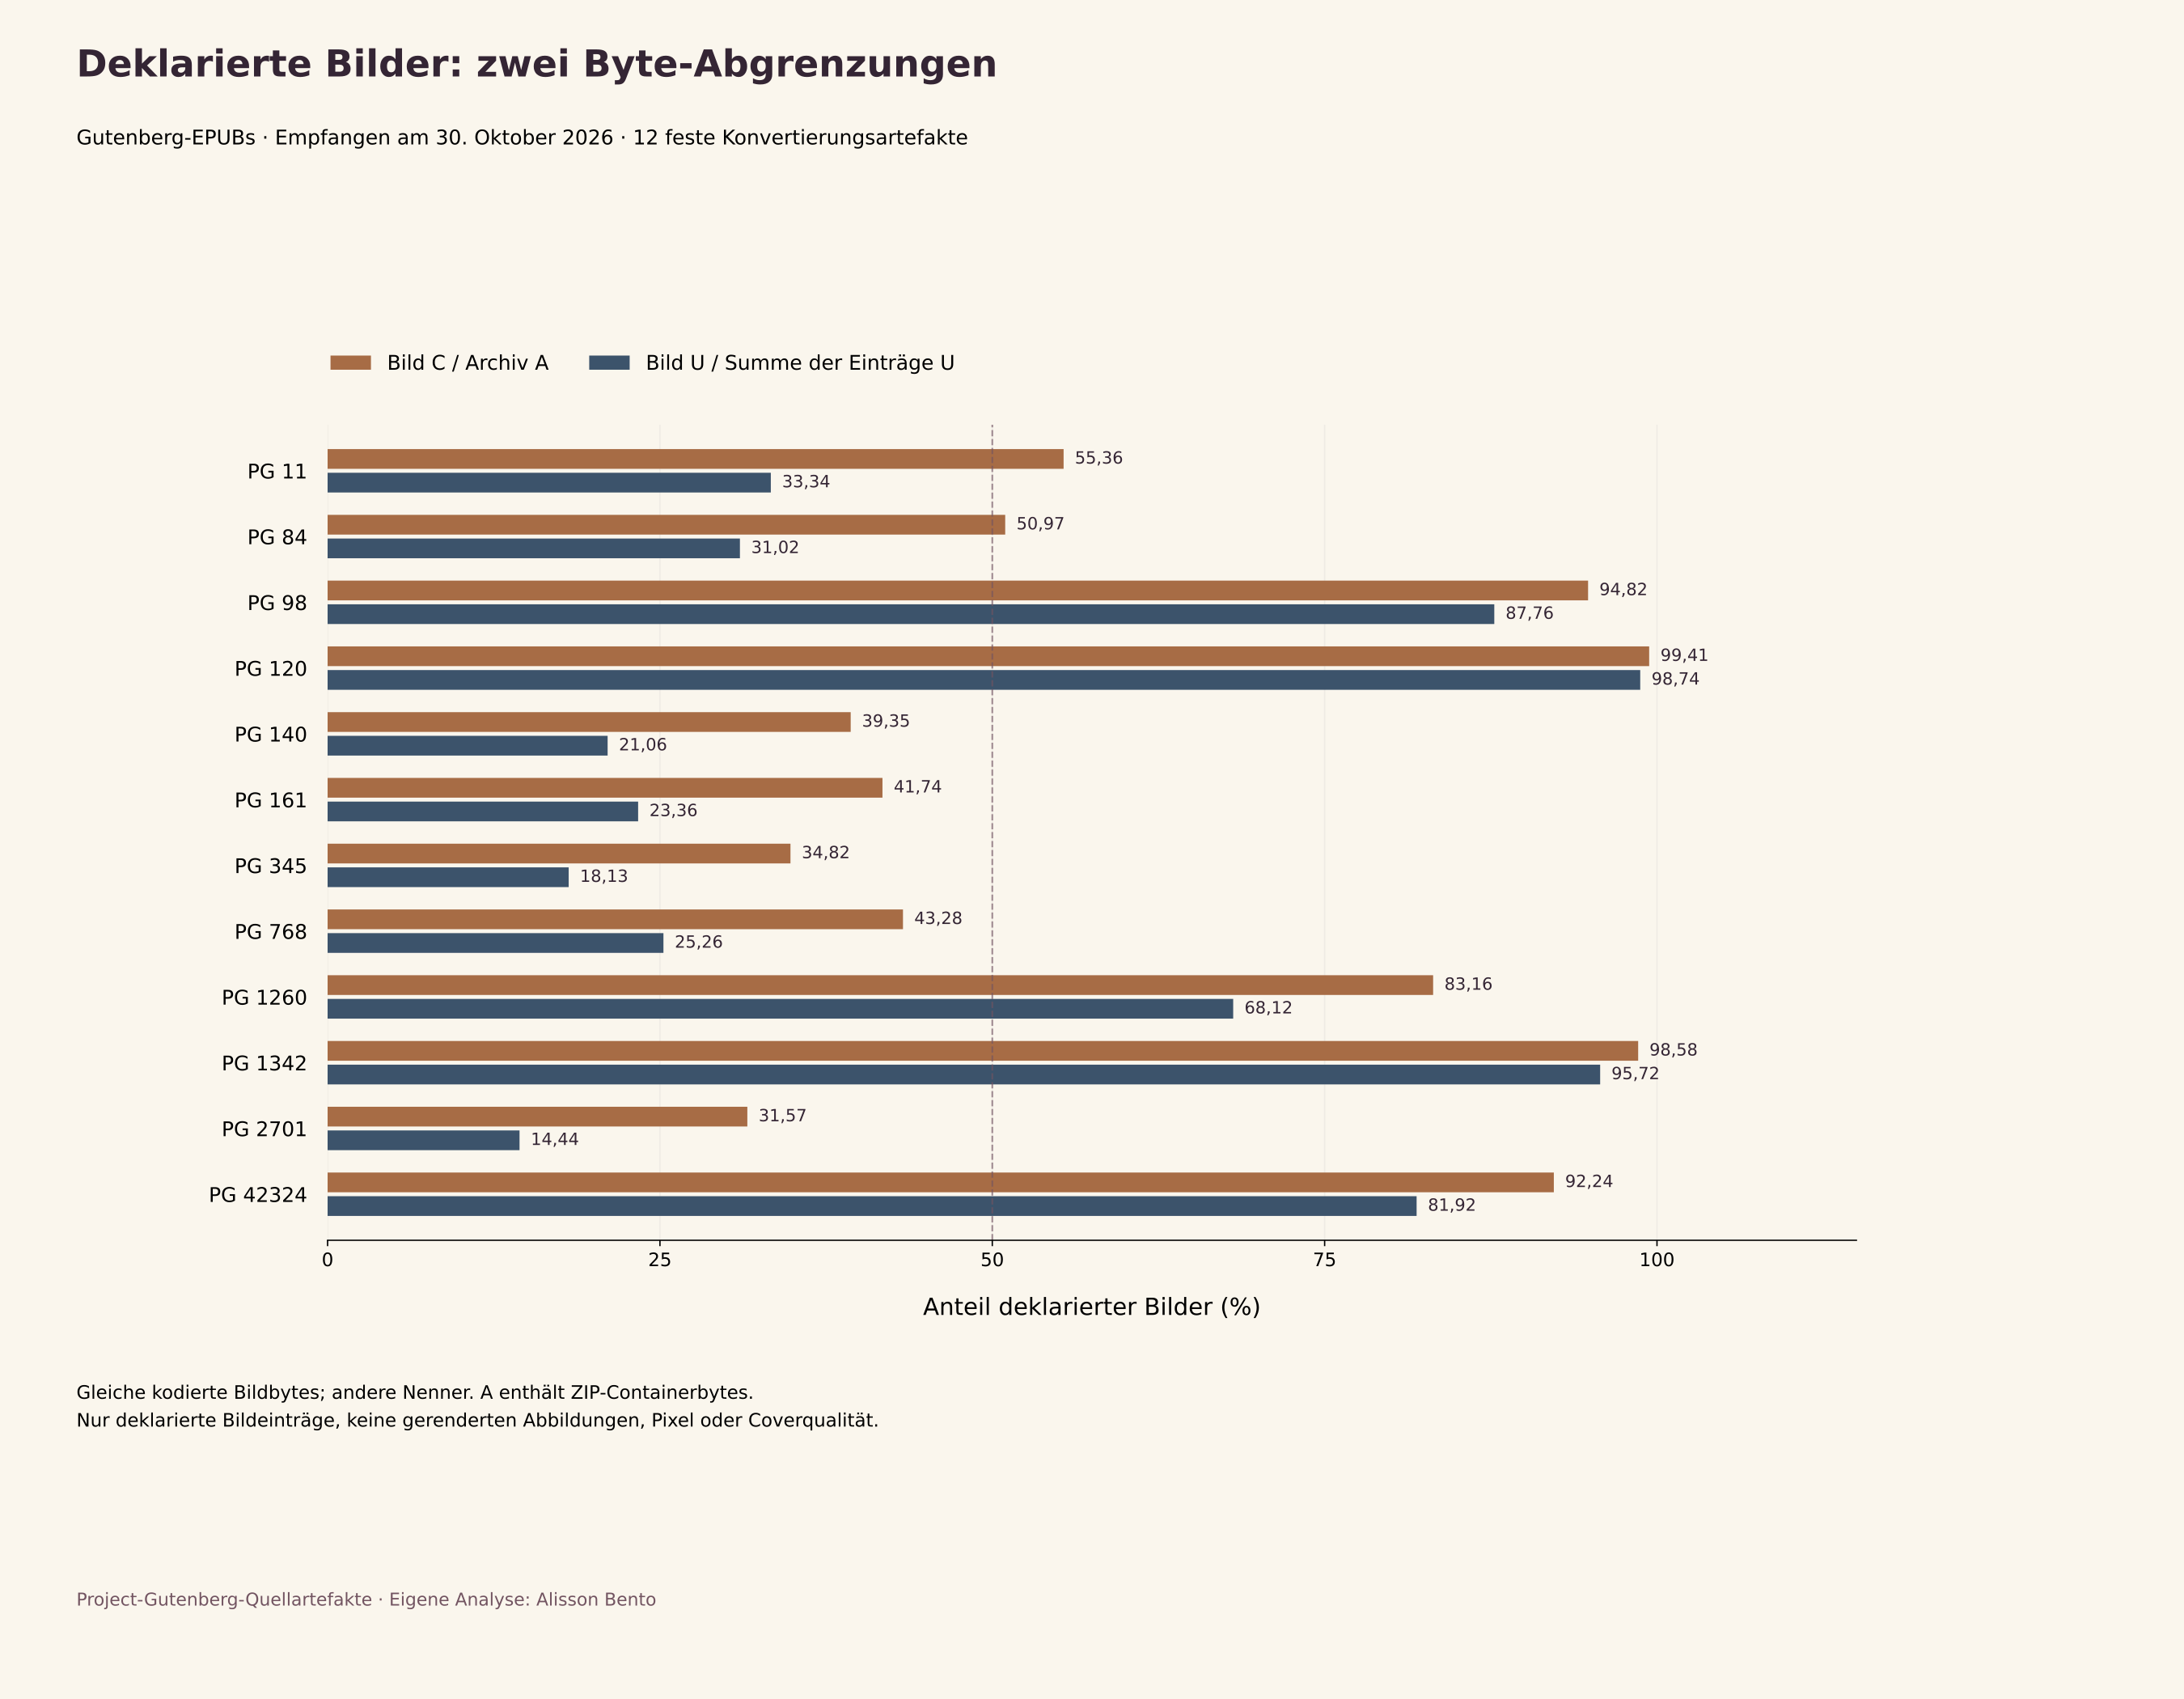
Diagramm seitlich scrollen, um alle Details zu sehen. ↔
Grafik und Werte
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Gutenberg-Datei | Erhaltene Datei A (Bytes) | Deklarierte Bilder C (Bytes) | Entpackte Einträge U (Bytes) | Bilder C_img/A (%) | Bilder U_img/U (%) | Wechsel der Mehrheit (1 = ja) |
|---|---|---|---|---|---|---|
| PG 11 | 189.249 | 104.775 | 314.264 | 55,36 | 33,34 | 1 |
| PG 84 | 440.131 | 224.340 | 723.302 | 50,97 | 31,02 | 1 |
| PG 98 | 7.923.060 | 7.512.341 | 8.559.932 | 94,82 | 87,76 | 0 |
| PG 120 | 49.452.703 | 49.162.018 | 49.789.786 | 99,41 | 98,74 | 0 |
| PG 140 | 615.474 | 242.178 | 1.149.729 | 39,35 | 21,06 | 0 |
| PG 161 | 580.103 | 242.125 | 1.036.582 | 41,74 | 23,36 | 0 |
| PG 345 | 602.902 | 209.921 | 1.157.585 | 34,82 | 18,13 | 0 |
| PG 768 | 587.952 | 254.472 | 1.007.298 | 43,28 | 25,26 | 0 |
| PG 1260 | 3.095.830 | 2.574.499 | 3.779.323 | 83,16 | 68,12 | 0 |
| PG 1342 | 24.864.457 | 24.512.383 | 25.607.139 | 98,58 | 95,72 | 0 |
| PG 2701 | 814.023 | 257.017 | 1.780.233 | 31,57 | 14,44 | 0 |
| PG 42324 | 2.472.089 | 2.280.260 | 2.783.589 | 92,24 | 81,92 | 0 |
Alle zwölf festen Dateien, erhalten am 30. Oktober 2026. C_img/A nutzt die Bytes der erhaltenen Datei, U_img/U die entpackten Bytes der Einträge. Gezählt werden nur deklarierte Bildeinträge einschließlich der deklarierten Cover, keine dargestellten oder eingebetteten Abbildungen. Prozentwerte sind auf zwei Dezimalstellen gerundet; die Kennzeichen für die Mehrheit beruhen auf ungerundeten Anteilen. Die Kennungen bezeichnen Dateien, keine voneinander unabhängigen literarischen Werke.

Die Rangfolge nach Dateigröße und Textmaß hängt von der Auswahl der Dateien ab
Gutenberg-EPUBs · Erhalten am 30. Oktober 2026 · 12 feste EPUB-Dateien
Vollständige Grafik und Quelle
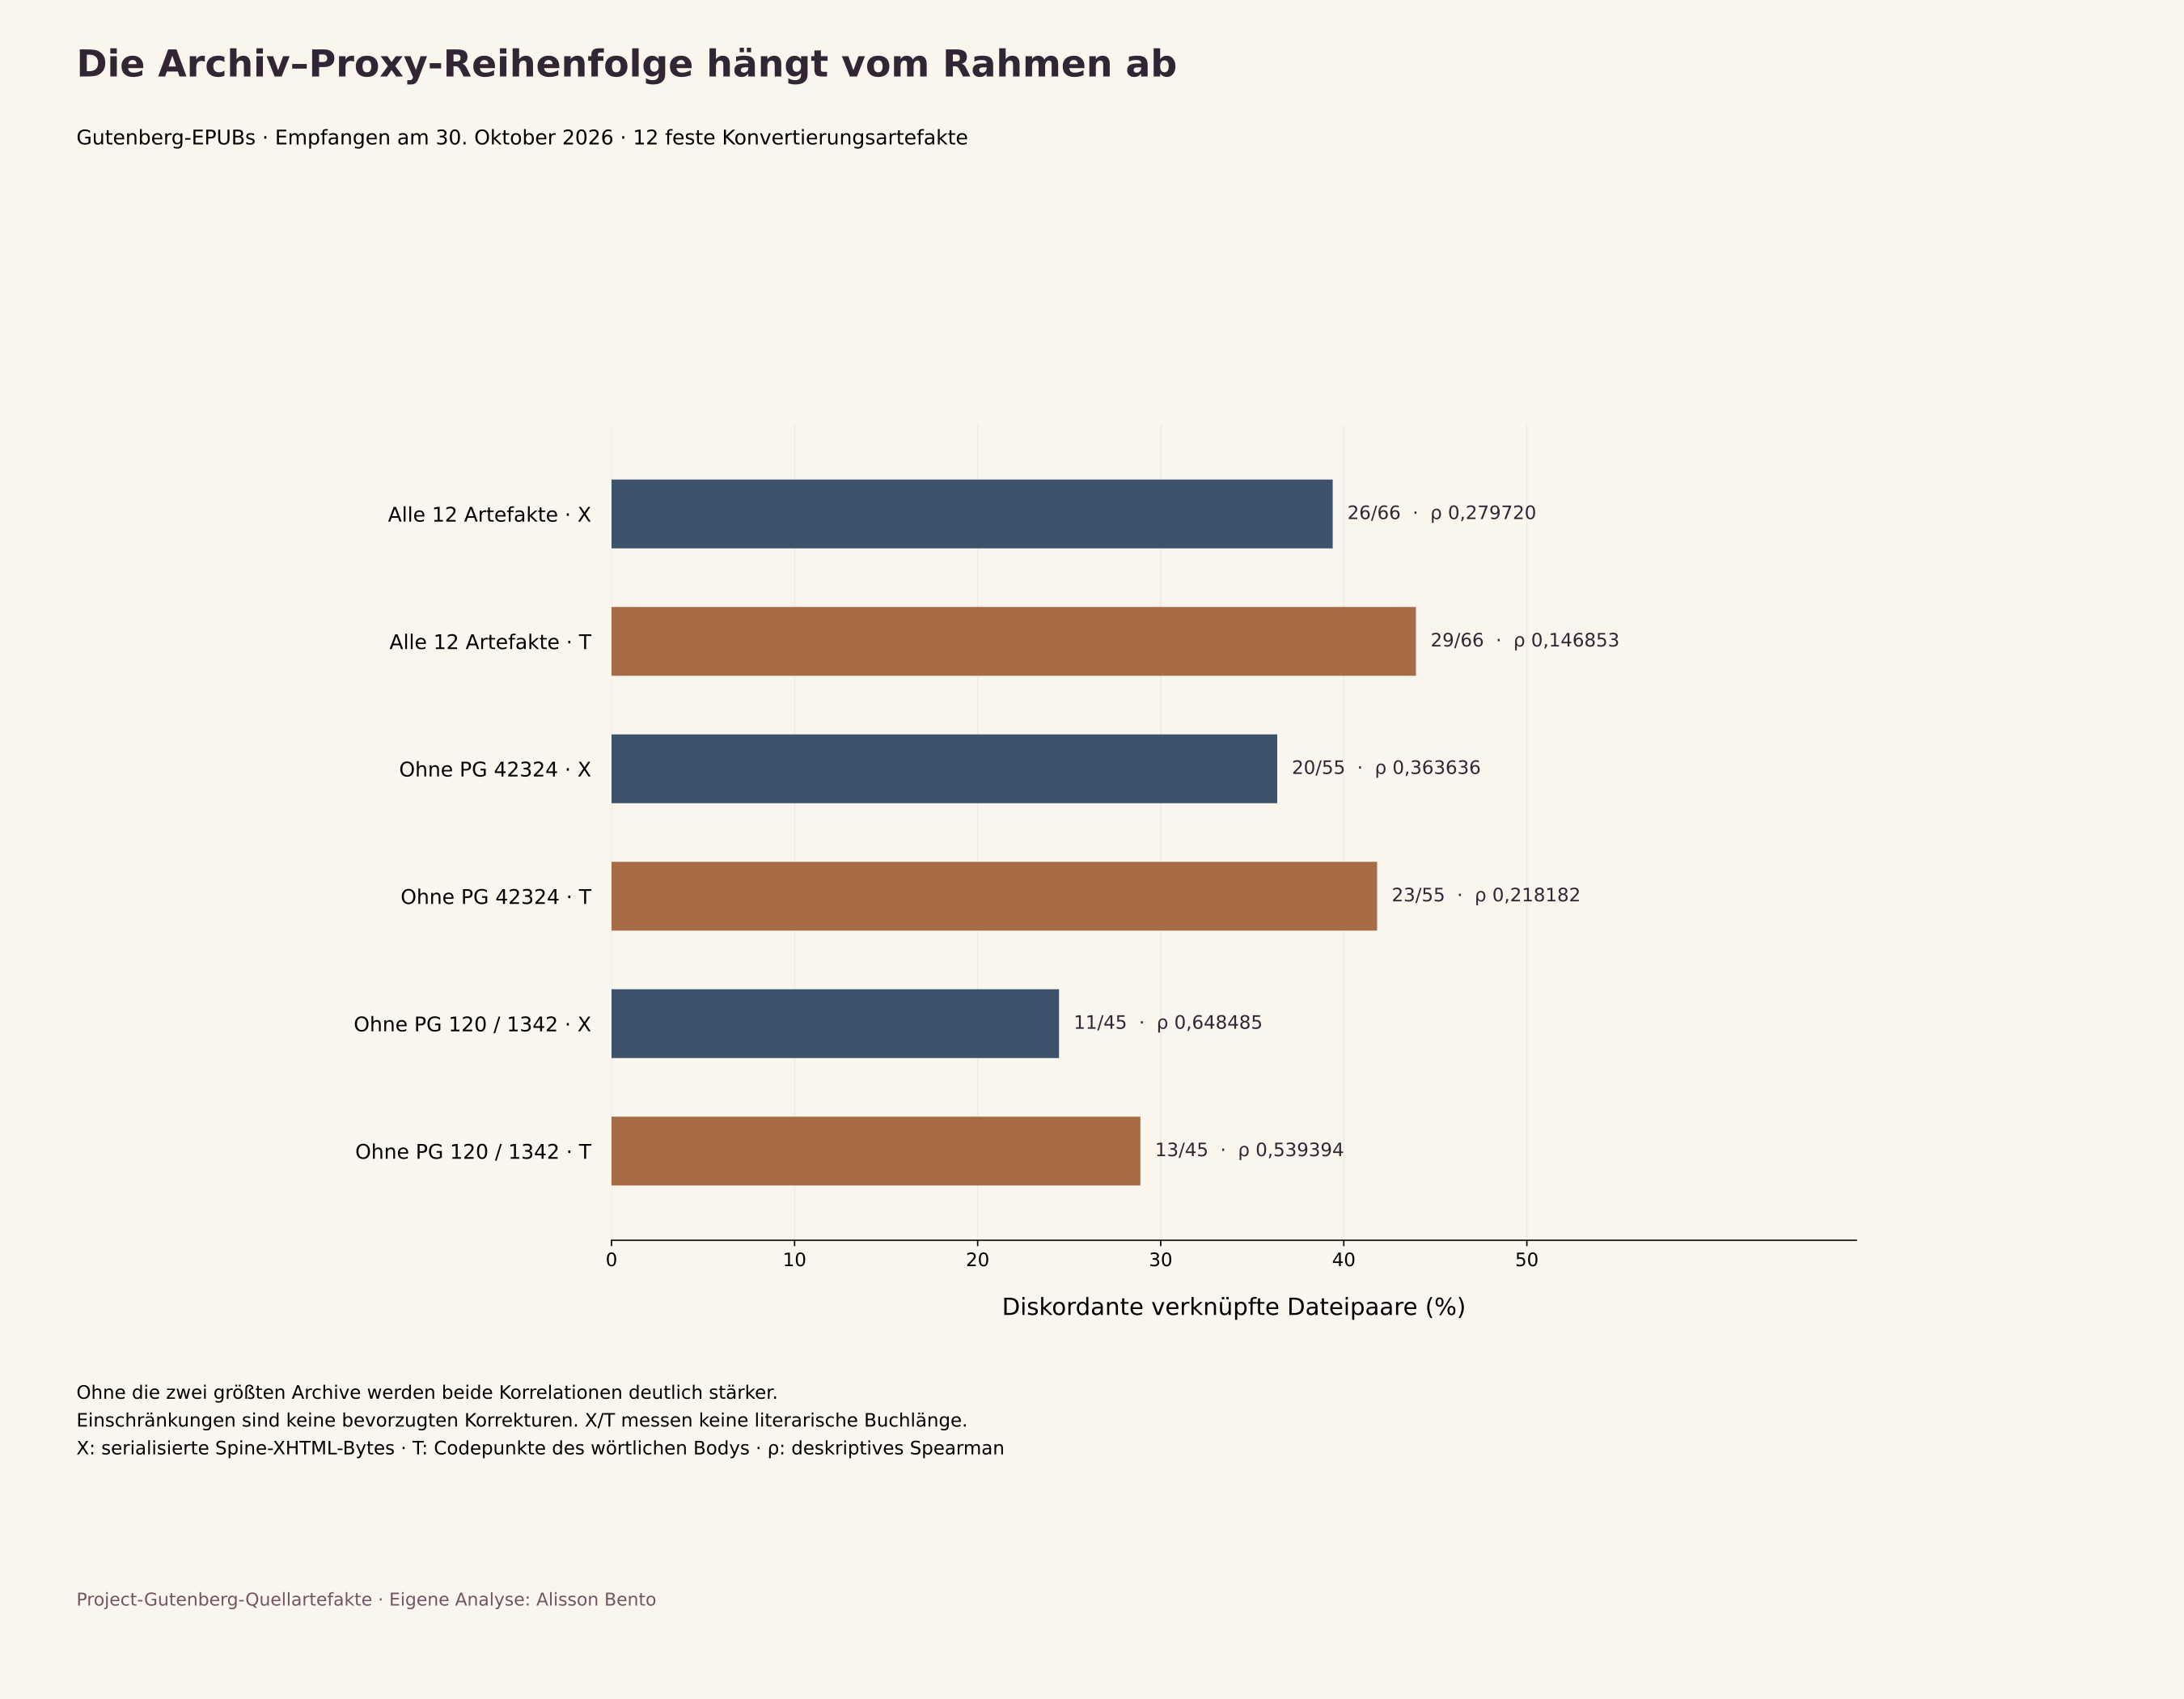
Diagramm seitlich scrollen, um alle Details zu sehen. ↔
Grafik und Werte
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Feste Auswahl | Textmaß | Dateien | Paare | Gleichläufig | Gegenläufig | Gleichstand bei Dateigröße | Gleichstand beim Textmaß | Gleichstand bei beiden | Rangkorrelation nach Spearman (rho) |
|---|---|---|---|---|---|---|---|---|---|
| Alle festen Dateien | X | 12 | 66 | 40 | 26 | 0 | 0 | 0 | 0,279720 |
| Alle festen Dateien | T | 12 | 66 | 37 | 29 | 0 | 0 | 0 | 0,146853 |
| Ohne PG 42324 | X | 11 | 55 | 35 | 20 | 0 | 0 | 0 | 0,363636 |
| Ohne PG 42324 | T | 11 | 55 | 32 | 23 | 0 | 0 | 0 | 0,218182 |
| Ohne PG 120 und 1342 | X | 10 | 45 | 34 | 11 | 0 | 0 | 0 | 0,648485 |
| Ohne PG 120 und 1342 | T | 10 | 45 | 32 | 13 | 0 | 0 | 0 | 0,539394 |
X = entpackte, serialisierte Bytes der zulässigen XHTML-Dateien des Lesetexts; T = Zeichen des Textkörpers nach Vereinheitlichung des Leerraums, mit eingefügten Trennern zwischen den Textstücken. Keines von beiden ist die angezeigte Länge oder eine geprüfte Länge der Prosa. Jedes ungeordnete Paar ist innerhalb seiner festen Auswahl mit den anderen Paaren verknüpft. Die Rangkorrelation nach Spearman ist beschreibend, auf sechs Dezimalstellen gerundet und ohne p-Werte oder Konfidenzintervalle. Die Varianten ohne einzelne Dateien dienen der Diagnose und sind keine bevorzugten Korrekturen. Die Dateigrößen der Quellen waren bekannt, bevor die Varianten festgelegt wurden.

Daten und Downloads
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Gutenberg-Datei | Erhaltene Datei A (Bytes) | Deklarierte Bilder C (Bytes) | Entpackte Einträge U (Bytes) | Bilder C_img/A (%) | Bilder U_img/U (%) | Wechsel der Mehrheit (1 = ja) |
|---|---|---|---|---|---|---|
| PG 11 | 189.249 | 104.775 | 314.264 | 55,36 | 33,34 | 1 |
| PG 84 | 440.131 | 224.340 | 723.302 | 50,97 | 31,02 | 1 |
| PG 98 | 7.923.060 | 7.512.341 | 8.559.932 | 94,82 | 87,76 | 0 |
| PG 120 | 49.452.703 | 49.162.018 | 49.789.786 | 99,41 | 98,74 | 0 |
| PG 140 | 615.474 | 242.178 | 1.149.729 | 39,35 | 21,06 | 0 |
| PG 161 | 580.103 | 242.125 | 1.036.582 | 41,74 | 23,36 | 0 |
| PG 345 | 602.902 | 209.921 | 1.157.585 | 34,82 | 18,13 | 0 |
| PG 768 | 587.952 | 254.472 | 1.007.298 | 43,28 | 25,26 | 0 |
| PG 1260 | 3.095.830 | 2.574.499 | 3.779.323 | 83,16 | 68,12 | 0 |
| PG 1342 | 24.864.457 | 24.512.383 | 25.607.139 | 98,58 | 95,72 | 0 |
| PG 2701 | 814.023 | 257.017 | 1.780.233 | 31,57 | 14,44 | 0 |
| PG 42324 | 2.472.089 | 2.280.260 | 2.783.589 | 92,24 | 81,92 | 0 |
Alle zwölf festen Dateien, erhalten am 30. Oktober 2026. C_img/A nutzt die Bytes der erhaltenen Datei, U_img/U die entpackten Bytes der Einträge. Gezählt werden nur deklarierte Bildeinträge einschließlich der deklarierten Cover, keine dargestellten oder eingebetteten Abbildungen. Prozentwerte sind auf zwei Dezimalstellen gerundet; die Kennzeichen für die Mehrheit beruhen auf ungerundeten Anteilen. Die Kennungen bezeichnen Dateien, keine voneinander unabhängigen literarischen Werke.
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Feste Auswahl | Textmaß | Dateien | Paare | Gleichläufig | Gegenläufig | Gleichstand bei Dateigröße | Gleichstand beim Textmaß | Gleichstand bei beiden | Rangkorrelation nach Spearman (rho) |
|---|---|---|---|---|---|---|---|---|---|
| Alle festen Dateien | X | 12 | 66 | 40 | 26 | 0 | 0 | 0 | 0,279720 |
| Alle festen Dateien | T | 12 | 66 | 37 | 29 | 0 | 0 | 0 | 0,146853 |
| Ohne PG 42324 | X | 11 | 55 | 35 | 20 | 0 | 0 | 0 | 0,363636 |
| Ohne PG 42324 | T | 11 | 55 | 32 | 23 | 0 | 0 | 0 | 0,218182 |
| Ohne PG 120 und 1342 | X | 10 | 45 | 34 | 11 | 0 | 0 | 0 | 0,648485 |
| Ohne PG 120 und 1342 | T | 10 | 45 | 32 | 13 | 0 | 0 | 0 | 0,539394 |
X = entpackte, serialisierte Bytes der zulässigen XHTML-Dateien des Lesetexts; T = Zeichen des Textkörpers nach Vereinheitlichung des Leerraums, mit eingefügten Trennern zwischen den Textstücken. Keines von beiden ist die angezeigte Länge oder eine geprüfte Länge der Prosa. Jedes ungeordnete Paar ist innerhalb seiner festen Auswahl mit den anderen Paaren verknüpft. Die Rangkorrelation nach Spearman ist beschreibend, auf sechs Dezimalstellen gerundet und ohne p-Werte oder Konfidenzintervalle. Die Varianten ohne einzelne Dateien dienen der Diagnose und sind keine bevorzugten Korrekturen. Die Dateigrößen der Quellen waren bekannt, bevor die Varianten festgelegt wurden.
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Kategorie (deklariert oder nach Eintrag) | Einträge | Gepackt C_r (Bytes) | Entpackt U_r (Bytes) | U_r/C_r |
|---|---|---|---|---|
| Paketsteuerung | 36 | 29.306 | 172.397 | 5,882652 |
| Navigation | 24 | 45.659 | 387.227 | 8,480847 |
| Deklarierte Cover | 12 | 2.743.502 | 2.743.502 | 1,000000 |
| Andere deklarierte Bilder | 386 | 84.832.827 | 84.832.827 | 1,000000 |
| XHTML des Anbieters (Kopf und Schluss) | 24 | 270.425 | 771.931 | 2,854510 |
| XHTML des Lesetexts (zulässig) | 412 | 3.520.103 | 8.608.444 | 2,445509 |
| Sonstiges XHTML | 0 | 0 | 0 | Nicht definiert (null gepackte Bytes) |
| Stylesheets | 112 | 44.555 | 172.434 | 3,870138 |
| Schriften | 0 | 0 | 0 | Nicht definiert (null gepackte Bytes) |
| Sonstiges deklariertes Material | 0 | 0 | 0 | Nicht definiert (null gepackte Bytes) |
| Sonstiges, nicht im Manifest | 0 | 0 | 0 | Nicht definiert (null gepackte Bytes) |
Summen der Bytes über alle zwölf Dateien, keine durchschnittliche Zusammensetzung eines Buches. Die gepackten Bytes der Einträge summieren sich zu C = 91.486.377, nicht zu A. Der Rest der Verpackung O = 151.596 wird gesondert als A − C berechnet. Er ist weder ein Eintrag mit Medien noch Teil von U. Kategorien ohne Einträge sind beobachtete Abwesenheit. Ihr U/C ist nicht definiert, weder null noch eine fehlende Quelle. Die Bytes der Bilddateien bleiben kodierte Bildbytes und sind keine rohen Pixel.
Tabelle seitlich scrollen, um alle Spalten zu sehen.
| Gutenberg-Datei | Erhaltene Datei A (Bytes) | Gepackte Einträge C (Bytes) | Rest der Verpackung O (Bytes) | Entpackte Einträge U (Bytes) | Serialisierter Lesetext X (Bytes) | Zeichen des Textkörpers T (Codepunkte) |
|---|---|---|---|---|---|---|
| PG 11 | 189.249 | 185.883 | 3.366 | 314.264 | 168.759 | 142.244 |
| PG 84 | 440.131 | 434.011 | 6.120 | 723.302 | 452.075 | 418.114 |
| PG 98 | 7.923.060 | 7.904.510 | 18.550 | 8.559.932 | 949.314 | 751.407 |
| PG 120 | 49.452.703 | 49.408.691 | 44.012 | 49.789.786 | 467.048 | 359.153 |
| PG 140 | 615.474 | 608.964 | 6.510 | 1.149.729 | 855.571 | 805.861 |
| PG 161 | 580.103 | 570.581 | 9.522 | 1.036.582 | 730.802 | 666.929 |
| PG 345 | 602.902 | 596.404 | 6.498 | 1.157.585 | 897.699 | 834.892 |
| PG 768 | 587.952 | 580.950 | 7.002 | 1.007.298 | 703.951 | 642.920 |
| PG 1260 | 3.095.830 | 3.079.104 | 16.726 | 3.779.323 | 1.122.265 | 1.016.740 |
| PG 1342 | 24.864.457 | 24.837.583 | 26.874 | 25.607.139 | 693.662 | 599.785 |
| PG 2701 | 814.023 | 810.935 | 3.088 | 1.780.233 | 1.299.019 | 1.113.194 |
| PG 42324 | 2.472.089 | 2.468.761 | 3.328 | 2.783.589 | 268.279 | 258.014 |
A = C + O. U ist die Summe der entpackten ZIP-Einträge und enthält den Rest der Verpackung O nicht. X ist ein Teil von U, nicht der gesamte Text und nicht nur Prosa. T ist ein technisch definiertes Maß für die Zeichen des Textkörpers, keine Zahl von Wörtern oder Seiten. Die Bytes der erhaltenen Datei sind nicht die Datenmenge bei der Übertragung über HTTP, und U ist kein Arbeitsspeicher. Alle Zahlen sind exakte ganze Zahlen. Titel und Autorinnen und Autoren stehen bei den genauen Quellen der Dateien.
Daten und Methode
So haben wir gerechnet
- Genau die zwölf offiziellen EPUB3-Dateien in der Variante mit Bildern, die wir am 30. Oktober 2026 erhalten haben, bleiben unverändert erhalten: die Kennungen 11, 84, 98, 120, 140, 161, 345, 768, 1260, 1342, 2701 und 42324. Wir prüfen die tatsächlichen Prüfsummen der Originaldateien, die ZIP-CRC-Werte, die Deklarationen im Paket und die Ziele der Lesereihenfolge. Es gibt keinen Ersatz der Quellen und keinen neuen Abruf.
- Wir messen die Größe der erhaltenen Datei A, die Summe der gepackten Einträge C, die Summe der entpackten Einträge U und getrennt den Rest der Verpackung O = A − C. Für jede Kategorie verwenden wir C_r/A als Anteil an der erhaltenen Datei und U_r/U als Anteil an den entpackten Einträgen. U_r/C_r ist nur definiert, wenn C_r größer als null ist. Beobachtete Kategorien mit dem Wert null sind keine fehlenden Quellen.
- Jeder Eintrag wird anhand der tatsächlichen Deklarationen im Paket und der Lesereihenfolge genau einer Kategorie zugeordnet: Paketsteuerung, Navigation, deklariertes Cover, anderes deklariertes Bild, XHTML des Anbieters, zulässiges XHTML des Lesetexts, sonstiges XHTML, Stylesheet, Schrift, sonstiges deklariertes Material und sonstiges Material ohne Eintrag im Manifest. Gezählt werden nur deklarierte Bildeinträge, keine dargestellten, eingebetteten oder extern verlinkten Abbildungen.
- X ist die Zahl der entpackten, serialisierten Bytes der zulässigen XHTML-Dateien des Lesetexts, ohne Navigation und ohne Kopf- und Schlussdokumente des Anbieters. T wird je Textkörper (body) so bestimmt: Die Texte der Elemente und der direkt folgende Text (.text und .tail) werden in der Reihenfolge des Dokuments gesammelt. Inhalte von script und style werden übersprungen, der Text, der direkt auf sie folgt, bleibt erhalten. Zwischen die gesammelten Textstücke wird je ein ASCII-Leerzeichen eingefügt, und Unicode-Leerraum wird per split-and-join zusammengezogen. Danach werden die Codepunkte gezählt, und die Dokumente werden ohne Trenner zwischen den Dokumenten addiert. Gemessen werden weder Darstellung noch Wörter noch Seiten.
- Wir vergleichen alle ungeordneten Dateipaare für Dateigröße A gegenüber X und A gegenüber T. Streng gleichläufige und gegenläufige Paare sowie die Gleichstände halten wir getrennt fest. Die beschreibenden Rangkorrelationen nach Spearman werden bei Gleichständen mit mittleren Rängen berechnet. Verknüpfte Paare behandeln wir nicht als unabhängige Versuche. Wir geben weder Intervalle für Schlussfolgerungen noch Prognosen an.
- Alle zwölf Dateien bleiben die Hauptauswahl. Getrennt rechnen wir neu ohne die Frankenstein-Datei mit der höheren Kennung PG 42324 und ohne die zwei größten Dateien PG 120/1342. Das sind offengelegte, nicht bevorzugte Varianten. Quellen und Größen waren vor der Festlegung des Vorgehens schon bekannt. Die unveränderte Konvention für die Trenner bei T wurde nach der ersten Berechnung klargestellt und nicht vorab unabhängig von den Ergebnissen festgelegt.
- Alle vier abgeleiteten Ausgaben mit Summen lassen sich aus den kompakten, ausgewählten Faktendaten in einem leeren Ordner reproduzieren. Die optionale Messung der Originale nutzt separat beschaffte, exakt passende offizielle EPUB-Dateien und prüft Prüfsummen und CRC-Werte. Prozentwerte zeigen wir mit zwei, Korrelationen und Kompressionsverhältnisse mit sechs Dezimalstellen an. Kennzeichen und Reihenfolgen werden vor dem Runden berechnet. Wir verteilen keine Quelltexte, Cover, Illustrationen oder die private Liste der Eintragsnamen.
Was die Daten nicht aussagen
- Zwölf gezielt aufbewahrte konvertierte Dateien, darunter zwei Frankenstein-Transkriptionen, sind weder zwölf voneinander unabhängige Werke noch eine repräsentative Stichprobe von Gutenberg, E-Books, Autorinnen und Autoren oder Formaten. Ob die Versionen inhaltlich gleichwertig sind, ist nicht geprüft.
- A zählt die Bytes der erhaltenen Datei, nicht HTTP-Header oder die Datenmenge bei der Übertragung. U zählt die Bytes der entpackten ZIP-Einträge, nicht Arbeitsspeicher, dargestellte Seiten, Lesezeit, Latenz, Geräteleistung oder Gebühren für die Auslieferung. Kodierte Bilddateien sind keine rohen Pixel.
- Die Kategorien für Bilder und Cover beschreiben deklarierte Einträge im Paket. Sie listen keine dargestellten oder eingebetteten Abbildungen auf, bescheinigen keine Qualität von Bild oder Cover und belegen nicht, dass keine Abbildungen vorhanden sind. Sie rechtfertigen auch nicht, Dateien zu löschen oder neu zu komprimieren.
- X enthält serialisiertes Markup und möglicherweise Inhalt, der keine Prosa ist. T folgt einer Konvention für die Zeichen des Textkörpers, mit eingefügten Leerzeichen zwischen den Textstücken. T gibt weder wieder, was nach CSS sichtbar ist, noch ist es eine geprüfte Wortzahl oder eine literarische Länge, und es belegt auch nicht, dass dargestellte Inhalte gleichwertig sind.
- Ohne PG 120/1342 steigen die Korrelationen wesentlich, und die Zahl der gegenläufigen Paare sinkt. Die verbleibenden Abweichungen belegen kein allgemeines Versagen von Vorhersagen. Alle zwölf Dateien bleiben die Hauptauswahl, und keine Variante ist eine bevorzugte korrigierte Auswahl.
- Das Verzeichnis der Quellen und die Dateigrößen waren vor dem neuen Vorgehen schon bekannt. Die Trenner bei T wurden nach der ersten Berechnung ausdrücklich klargestellt, ohne Anpassung und ohne Änderung der Ergebnisse. Wir behaupten weder, die Festlegungen vorab unabhängig von den Ergebnissen getroffen zu haben, noch, die Methode als Erste entwickelt zu haben.
- Dateipaare sind verknüpfte Beobachtungen in einer begrenzten, gezielt gewählten Auswahl. Korrelationen und Zählungen der Reihenfolge sind nur beschreibend, ohne p-Werte, Konfidenzintervalle, Qualitätsrangfolge oder allgemeine Schätzung für eine Grundgesamtheit.
- Beobachtete Kategorien mit null Einträgen haben null Bytes und nicht definierte Kompressionsverhältnisse. Das sind keine fehlenden Eingaben. Künftig neu erzeugte offizielle Dateien mit anderen Prüfsummen wären andere Dateien und kein stillschweigender Ersatz für diesen Stand.
- Eingebettete Hinweise auf Gemeinfreiheit in den USA und die vollständige Gutenberg-Lizenz belegen weder weltweite Rechtefreiheit noch eine pauschale Lizenz für diesen Artikel. Marken- und Rechtsbedingungen einzelner Länder bleiben bestehen. Buchinhalte und ursprüngliche Bildressourcen werden nicht weitergegeben. Aussagen über Navigationsfehler und Barrierefreiheit liegen außerhalb dieser Analyse.
Originalquellen
- Project Gutenberg: official generated-content mirroring
Project Gutenberg: offizielle Hinweise zum Spiegeln (Mirroring) der erzeugten Inhalte. Die zuvor geprüfte Dokumentation nennt gutenberg.pglaf.org als alternative Quelle für die erzeugte Sammlung. Die zwölf Adressen der tatsächlich erhaltenen Dateien, die UTC-Daten und die tatsächlichen SHA-256-Prüfsummen der offiziellen Dateien stehen in source-archives.json. Diese Skripte stellen keine neuen Anfragen. https://www.gutenberg.org/help/mirroring.html
Abgerufen am 30. Oktober 2026
- Project Gutenberg: licence and rights guidance
Project Gutenberg: Hinweise zu Lizenz und Rechten. Die zuvor geprüfte Richtlinie sowie die in jedem aufbewahrten Paket eingebettete vollständige Lizenz mit dem Hinweis auf Gemeinfreiheit in den USA begrenzen die Rechte an den Quellen. Sie belegen keine weltweite Rechtefreiheit und lizenzieren nicht die gesamte Analyse. Texte von E-Books, Illustrationen, Cover und Logos werden nicht weitergegeben. https://www.gutenberg.org/policy/license.html
Abgerufen am 30. Oktober 2026
- Project Gutenberg EPUB artifact 11: Alice's Adventures in Wonderland
Project-Gutenberg-EPUB-Datei 11: Alice's Adventures in Wonderland. Lewis Carroll. Genau so erhaltene EPUB3-Variante mit Bildern, 189.249 Bytes; kanonische Titelseite https://www.gutenberg.org/ebooks/11. Die tatsächliche offizielle Prüfsumme in source-archives.json kennzeichnet das separat beschaffte Original, kein verteiltes E-Book. Hinweis auf Gemeinfreiheit in den USA und eingebettete Gutenberg-Lizenz; wir behaupten weder weltweite Rechtefreiheit noch inhaltliche Gleichwertigkeit. https://gutenberg.pglaf.org/cache/epub/11/pg11-images-3.epub
Abgerufen am 30. Oktober 2026
- Project Gutenberg EPUB artifact 84: Frankenstein; or, The modern Prometheus
Project-Gutenberg-EPUB-Datei 84: Frankenstein; or, The modern Prometheus. Mary Wollstonecraft Shelley. Genau so erhaltene EPUB3-Variante mit Bildern, 440.131 Bytes; kanonische Titelseite https://www.gutenberg.org/ebooks/84. Die tatsächliche offizielle Prüfsumme in source-archives.json kennzeichnet das separat beschaffte Original, kein verteiltes E-Book. Hinweis auf Gemeinfreiheit in den USA und eingebettete Gutenberg-Lizenz; wir behaupten weder weltweite Rechtefreiheit noch inhaltliche Gleichwertigkeit. https://gutenberg.pglaf.org/cache/epub/84/pg84-images-3.epub
Abgerufen am 30. Oktober 2026
- Project Gutenberg EPUB artifact 98: A Tale of Two Cities
Project-Gutenberg-EPUB-Datei 98: A Tale of Two Cities. Charles Dickens. Genau so erhaltene EPUB3-Variante mit Bildern, 7.923.060 Bytes; kanonische Titelseite https://www.gutenberg.org/ebooks/98. Die tatsächliche offizielle Prüfsumme in source-archives.json kennzeichnet das separat beschaffte Original, kein verteiltes E-Book. Hinweis auf Gemeinfreiheit in den USA und eingebettete Gutenberg-Lizenz; wir behaupten weder weltweite Rechtefreiheit noch inhaltliche Gleichwertigkeit. https://gutenberg.pglaf.org/cache/epub/98/pg98-images-3.epub
Abgerufen am 30. Oktober 2026
- Project Gutenberg EPUB artifact 120: Treasure Island
Project-Gutenberg-EPUB-Datei 120: Treasure Island. Robert Louis Stevenson. Genau so erhaltene EPUB3-Variante mit Bildern, 49.452.703 Bytes; kanonische Titelseite https://www.gutenberg.org/ebooks/120. Die tatsächliche offizielle Prüfsumme in source-archives.json kennzeichnet das separat beschaffte Original, kein verteiltes E-Book. Hinweis auf Gemeinfreiheit in den USA und eingebettete Gutenberg-Lizenz; wir behaupten weder weltweite Rechtefreiheit noch inhaltliche Gleichwertigkeit. https://gutenberg.pglaf.org/cache/epub/120/pg120-images-3.epub
Abgerufen am 30. Oktober 2026
- Project Gutenberg EPUB artifact 140: The Jungle
Project-Gutenberg-EPUB-Datei 140: The Jungle. Upton Sinclair. Genau so erhaltene EPUB3-Variante mit Bildern, 615.474 Bytes; kanonische Titelseite https://www.gutenberg.org/ebooks/140. Die tatsächliche offizielle Prüfsumme in source-archives.json kennzeichnet das separat beschaffte Original, kein verteiltes E-Book. Hinweis auf Gemeinfreiheit in den USA und eingebettete Gutenberg-Lizenz; wir behaupten weder weltweite Rechtefreiheit noch inhaltliche Gleichwertigkeit. https://gutenberg.pglaf.org/cache/epub/140/pg140-images-3.epub
Abgerufen am 30. Oktober 2026
- Project Gutenberg EPUB artifact 161: Sense and Sensibility
Project-Gutenberg-EPUB-Datei 161: Sense and Sensibility. Jane Austen. Genau so erhaltene EPUB3-Variante mit Bildern, 580.103 Bytes; kanonische Titelseite https://www.gutenberg.org/ebooks/161. Die tatsächliche offizielle Prüfsumme in source-archives.json kennzeichnet das separat beschaffte Original, kein verteiltes E-Book. Hinweis auf Gemeinfreiheit in den USA und eingebettete Gutenberg-Lizenz; wir behaupten weder weltweite Rechtefreiheit noch inhaltliche Gleichwertigkeit. https://gutenberg.pglaf.org/cache/epub/161/pg161-images-3.epub
Abgerufen am 30. Oktober 2026
- Project Gutenberg EPUB artifact 345: Dracula
Project-Gutenberg-EPUB-Datei 345: Dracula. Bram Stoker. Genau so erhaltene EPUB3-Variante mit Bildern, 602.902 Bytes; kanonische Titelseite https://www.gutenberg.org/ebooks/345. Die tatsächliche offizielle Prüfsumme in source-archives.json kennzeichnet das separat beschaffte Original, kein verteiltes E-Book. Hinweis auf Gemeinfreiheit in den USA und eingebettete Gutenberg-Lizenz; wir behaupten weder weltweite Rechtefreiheit noch inhaltliche Gleichwertigkeit. https://gutenberg.pglaf.org/cache/epub/345/pg345-images-3.epub
Abgerufen am 30. Oktober 2026
- Project Gutenberg EPUB artifact 768: Wuthering Heights
Project-Gutenberg-EPUB-Datei 768: Wuthering Heights. Emily Brontë. Genau so erhaltene EPUB3-Variante mit Bildern, 587.952 Bytes; kanonische Titelseite https://www.gutenberg.org/ebooks/768. Die tatsächliche offizielle Prüfsumme in source-archives.json kennzeichnet das separat beschaffte Original, kein verteiltes E-Book. Hinweis auf Gemeinfreiheit in den USA und eingebettete Gutenberg-Lizenz; wir behaupten weder weltweite Rechtefreiheit noch inhaltliche Gleichwertigkeit. https://gutenberg.pglaf.org/cache/epub/768/pg768-images-3.epub
Abgerufen am 30. Oktober 2026
- Project Gutenberg EPUB artifact 1260: Jane Eyre: An Autobiography
Project-Gutenberg-EPUB-Datei 1260: Jane Eyre: An Autobiography. Charlotte Brontë. Genau so erhaltene EPUB3-Variante mit Bildern, 3.095.830 Bytes; kanonische Titelseite https://www.gutenberg.org/ebooks/1260. Die tatsächliche offizielle Prüfsumme in source-archives.json kennzeichnet das separat beschaffte Original, kein verteiltes E-Book. Hinweis auf Gemeinfreiheit in den USA und eingebettete Gutenberg-Lizenz; wir behaupten weder weltweite Rechtefreiheit noch inhaltliche Gleichwertigkeit. https://gutenberg.pglaf.org/cache/epub/1260/pg1260-images-3.epub
Abgerufen am 30. Oktober 2026
- Project Gutenberg EPUB artifact 1342: Pride and Prejudice
Project-Gutenberg-EPUB-Datei 1342: Pride and Prejudice. Jane Austen. Genau so erhaltene EPUB3-Variante mit Bildern, 24.864.457 Bytes; kanonische Titelseite https://www.gutenberg.org/ebooks/1342. Die tatsächliche offizielle Prüfsumme in source-archives.json kennzeichnet das separat beschaffte Original, kein verteiltes E-Book. Hinweis auf Gemeinfreiheit in den USA und eingebettete Gutenberg-Lizenz; wir behaupten weder weltweite Rechtefreiheit noch inhaltliche Gleichwertigkeit. https://gutenberg.pglaf.org/cache/epub/1342/pg1342-images-3.epub
Abgerufen am 30. Oktober 2026
- Project Gutenberg EPUB artifact 2701: Moby Dick; Or, The Whale
Project-Gutenberg-EPUB-Datei 2701: Moby Dick; Or, The Whale. Herman Melville. Genau so erhaltene EPUB3-Variante mit Bildern, 814.023 Bytes; kanonische Titelseite https://www.gutenberg.org/ebooks/2701. Die tatsächliche offizielle Prüfsumme in source-archives.json kennzeichnet das separat beschaffte Original, kein verteiltes E-Book. Hinweis auf Gemeinfreiheit in den USA und eingebettete Gutenberg-Lizenz; wir behaupten weder weltweite Rechtefreiheit noch inhaltliche Gleichwertigkeit. https://gutenberg.pglaf.org/cache/epub/2701/pg2701-images-3.epub
Abgerufen am 30. Oktober 2026
- Project Gutenberg EPUB artifact 42324: Frankenstein; or, The modern Prometheus
Project-Gutenberg-EPUB-Datei 42324: Frankenstein; or, The modern Prometheus. Mary Wollstonecraft Shelley. Genau so erhaltene EPUB3-Variante mit Bildern, 2.472.089 Bytes; kanonische Titelseite https://www.gutenberg.org/ebooks/42324. Die tatsächliche offizielle Prüfsumme in source-archives.json kennzeichnet das separat beschaffte Original, kein verteiltes E-Book. Hinweis auf Gemeinfreiheit in den USA und eingebettete Gutenberg-Lizenz; wir behaupten weder weltweite Rechtefreiheit noch inhaltliche Gleichwertigkeit. https://gutenberg.pglaf.org/cache/epub/42324/pg42324-images-3.epub
Abgerufen am 30. Oktober 2026
Studie zitieren und weiterverwenden
Alisson Bento. Im Innern von 12 EPUB-Dateien: Dateigröße und Textmaße. 2026, eigene Forschung. https://alissonbento.com/de/research/gutenberg-epub-payload-composition-12-artifacts/
Die Autorinnen und Autoren der Quellen sowie Project Gutenberg werden für die genau erhaltenen EPUB-Dateien genannt. Die öffentlichen Downloads enthalten kompakte Faktendaten mit Bytes und Textmaßen, eigene numerische Ergebnisse und eigenen Code, Verweise auf die kanonischen Quellen und die tatsächlichen Prüfsummen der offiziellen Dateien. Sie enthalten keine E-Book-Texte, Cover und Illustrationen und nicht die private Liste der Eintragsnamen. Die Prüfsummen der Originaldateien kennzeichnen separat beschaffte Originale. SHA256SUMS.txt enthält die Prüfsummen der kompakten Dateien, die wir tatsächlich verteilen. Hinweise auf Gemeinfreiheit in den USA und die Gutenberg-Lizenz unterliegen weiterhin den Rechtsbedingungen einzelner Länder und den Markenbedingungen. Wir behaupten weder weltweite Rechtefreiheit noch eine Befürwortung durch Institutionen noch eine pauschale Lizenz für den Artikel. Eigene Analyse und Erläuterung: Alisson Bento.
Korrekturen oder redaktionelle Fragen