
Une taille de fichier, plusieurs mesures
Un fichier EPUB téléchargé n’a qu’une seule taille, mais ce nombre additionne des contenus qui se comportent différemment dans l’archive : documents de lecture, fichiers d’images encodées, navigation, feuilles de style et structure du paquet. Leur part dépend de ce que l’on compte : l’archive reçue ou ses éléments une fois décompressés. Une phrase comme « ce livre numérique est surtout composé d’images » exige donc de définir les images prises en compte et le dénominateur. Sans cela, deux calculs justes peuvent sembler se contredire alors qu’ils répondent à deux questions différentes sur le même fichier.
Cette analyse mesure douze fichiers EPUB3 fixes de Project Gutenberg, dans leur variante avec images, reçus le 30 octobre 2026. Deux fichiers changent de classement quand le dénominateur change : leurs images déclarées dépassent la moitié des octets de l’archive reçue, mais occupent moins de la moitié des octets des éléments décompressés. Par ailleurs, l’ordre des archives reçues diffère de l’ordre donné par deux mesures indirectes du texte, calculées sans affichage, dans 26 et 29 des 66 paires de fichiers. Ce sont des comptes limités à ces fichiers de conversion ; ce ne sont pas des estimations sur les livres numériques en général, ni sur des œuvres littéraires indépendantes.
La leçon commune : nommer l’objet comparé avant d’interpréter une taille. Pour vérifier un téléchargement, on peut distinguer le corps réel de l’archive de ses composants internes. Pour un livre numérique ou un catalogue, on peut distinguer l’inventaire des fichiers d’une mesure indirecte du texte. Ni l’un ni l’autre ne mesure les pages affichées, la longueur validée du texte ou l’effort de lecture. Les résultats donnent des exemples reproductibles de choix de mesure ; ils n’établissent pas qu’une édition gaspille de l’espace, soit mal illustrée, difficile à lire, ni qu’on puisse en supprimer des fichiers.
Garder intact le cadre des fichiers reçus
Les douze fichiers portent les identifiants Gutenberg 11, 84, 98, 120, 140, 161, 345, 768, 1260, 1342, 2701 et 42324. Leurs pages officielles, les adresses réelles des miroirs officiels, les dates de réception, les tailles en octets et les empreintes des archives d’origine figurent dans les fichiers à télécharger. Cet ensemble vient tel quel d’un examen structurel antérieur. Il n’a pas été choisi pour représenter un genre, un groupe d’auteurs ou la production actuelle d’EPUB. Chaque observation est un fichier de conversion précis, reçu à une date donnée, et non une propriété permanente d’un titre.
L’ensemble comprend Alice’s Adventures in Wonderland, A Tale of Two Cities, Treasure Island, The Jungle, Sense and Sensibility, Dracula, Wuthering Heights, Jane Eyre, Pride and Prejudice et Moby Dick, ainsi que deux transcriptions de Frankenstein. Ces deux fichiers restent deux cas distincts, sans devenir deux œuvres indépendantes. On ne peut pas attribuer leurs différences au seul conditionnement : nous n’avons pas vérifié que leur contenu textuel et éditorial est équivalent. De même, les noms de fichiers « avec images » décrivent les fichiers reçus ; ils ne forment pas une comparaison contrôlée avec des éditions sans images.
Ce sont les mêmes fichiers que dans un audit de navigation antérieur, mais la question est autre. Cet audit avait trouvé des cibles de navigation valides et n’avait pas permis d’affirmer qu’un chapitre manquait. Les défauts de navigation et l’accessibilité sortent du cadre de cette analyse. Ici, nous observons les catégories déclarées des éléments, le décompte des octets, l’état de compression et des comparaisons d’ordre sur un nombre fini de fichiers. Aucun EPUB n’a été téléchargé une seconde fois pour obtenir une version plus favorable. Un futur fichier officiel modifié serait un autre fichier, et ses mesures ne doivent pas remplacer discrètement ce cadre daté.
Distinguer les octets de l’archive et ceux des éléments
Notons A le nombre d’octets du corps de l’archive reçue, C la somme des tailles compressées des éléments du ZIP et U la somme de leurs tailles décompressées. Le reste du conteneur est O = A − C. Pour les douze fichiers, A totalise 91 637 973 octets, C 91 486 377, O 151 596 et U 97 688 762. Les structures du conteneur ne sont pas un élément de contenu de plus, et leurs octets ne sont pas ajoutés à U. Garder ce reste visible évite que les parts par catégorie soient recalculées en silence sur un autre total.
Pour une catégorie r, la part de l’archive compressée est C_r/A, et la part des éléments décompressés est U_r/U. Les deux sont utiles, mais on ne peut pas les échanger. La première inclut le conteneur ZIP dans le dénominateur ; la seconde porte sur les éléments après décompression du ZIP et exclut le conteneur. Ici, « décompressé » ne concerne que la couche ZIP. Un fichier JPEG ou une autre image encodée reste un fichier encodé, et non un nombre de pixels bruts. U ne représente pas non plus la mémoire de travail, l’affichage à l’écran ou les ressources qu’exige un appareil.
Le rapport de compression U_r/C_r n’est donné que si C_r est positif. Une catégorie observée sans élément compte zéro élément et zéro octet, mais son rapport est indéfini, et non nul. C’est différent d’une source indisponible, qui arrêterait la vérification au lieu de recevoir un zéro inventé. Ces distinctions comptent surtout pour les polices et les éléments divers, observés à zéro dans tout cet ensemble. Zéro octet, un quotient indéfini et une donnée manquante sont trois situations différentes, et un tableur ou un graphique repris ailleurs doit pouvoir les distinguer.
Classer les éléments déclarés, et non les illustrations visibles
Le classement suit le manifeste et l’ordre de lecture (le « spine ») réels de chaque paquet EPUB. Il sépare le contrôle du paquet, la navigation, les images de couverture déclarées, les autres images déclarées, le XHTML du fournisseur, le XHTML de lecture retenu, les autres XHTML, les feuilles de style, les polices, les autres éléments déclarés et les éléments hors manifeste. Chaque fichier garde ses onze lignes de catégories, zéros observés compris. La couverture est repérée par la déclaration du paquet, et non d’après un nom de fichier ou une apparence. Les documents d’en-tête et de pied du fournisseur et la navigation sont séparés du texte de lecture retenu, au lieu d’être comptés en silence comme du contenu littéraire.
Au total, le registre contient 1 006 éléments ZIP. Parmi eux, 398 sont des images déclarées : douze couvertures et 386 autres images. Chaque image déclarée est stockée sans compression dans le ZIP, de sorte que ses octets compressés et décompressés sont égaux. À l’inverse, les 412 documents XHTML de lecture retenus occupent 8 608 444 octets décompressés et 3 520 103 octets compressés. Ce traitement différent des types d’éléments change leur poids relatif quand on passe du comptage de l’archive à celui des éléments décompressés. Cela n’implique pas une règle valable pour tous les outils de conversion EPUB.
Six fichiers ont une couverture déclarée et aucune autre image déclarée : les identifiants 11, 84, 140, 161, 768 et 2701. C’est un constat d’inventaire, et non la preuve que leurs pages affichées ne contiennent aucune autre illustration. Les images incorporées sous forme de données, les références distantes, les effets de mise en page et la visibilité réelle des images sortent de cet inventaire. Une couverture déclarée ne dit rien non plus de la qualité de l’image ni de la façon dont une application de lecture l’affiche. L’analyse s’arrête volontairement avant ces questions visuelles et fonctionnelles, qui exigeraient d’autres preuves et d’autres méthodes.
Deux majorités d’images dépendent du dénominateur
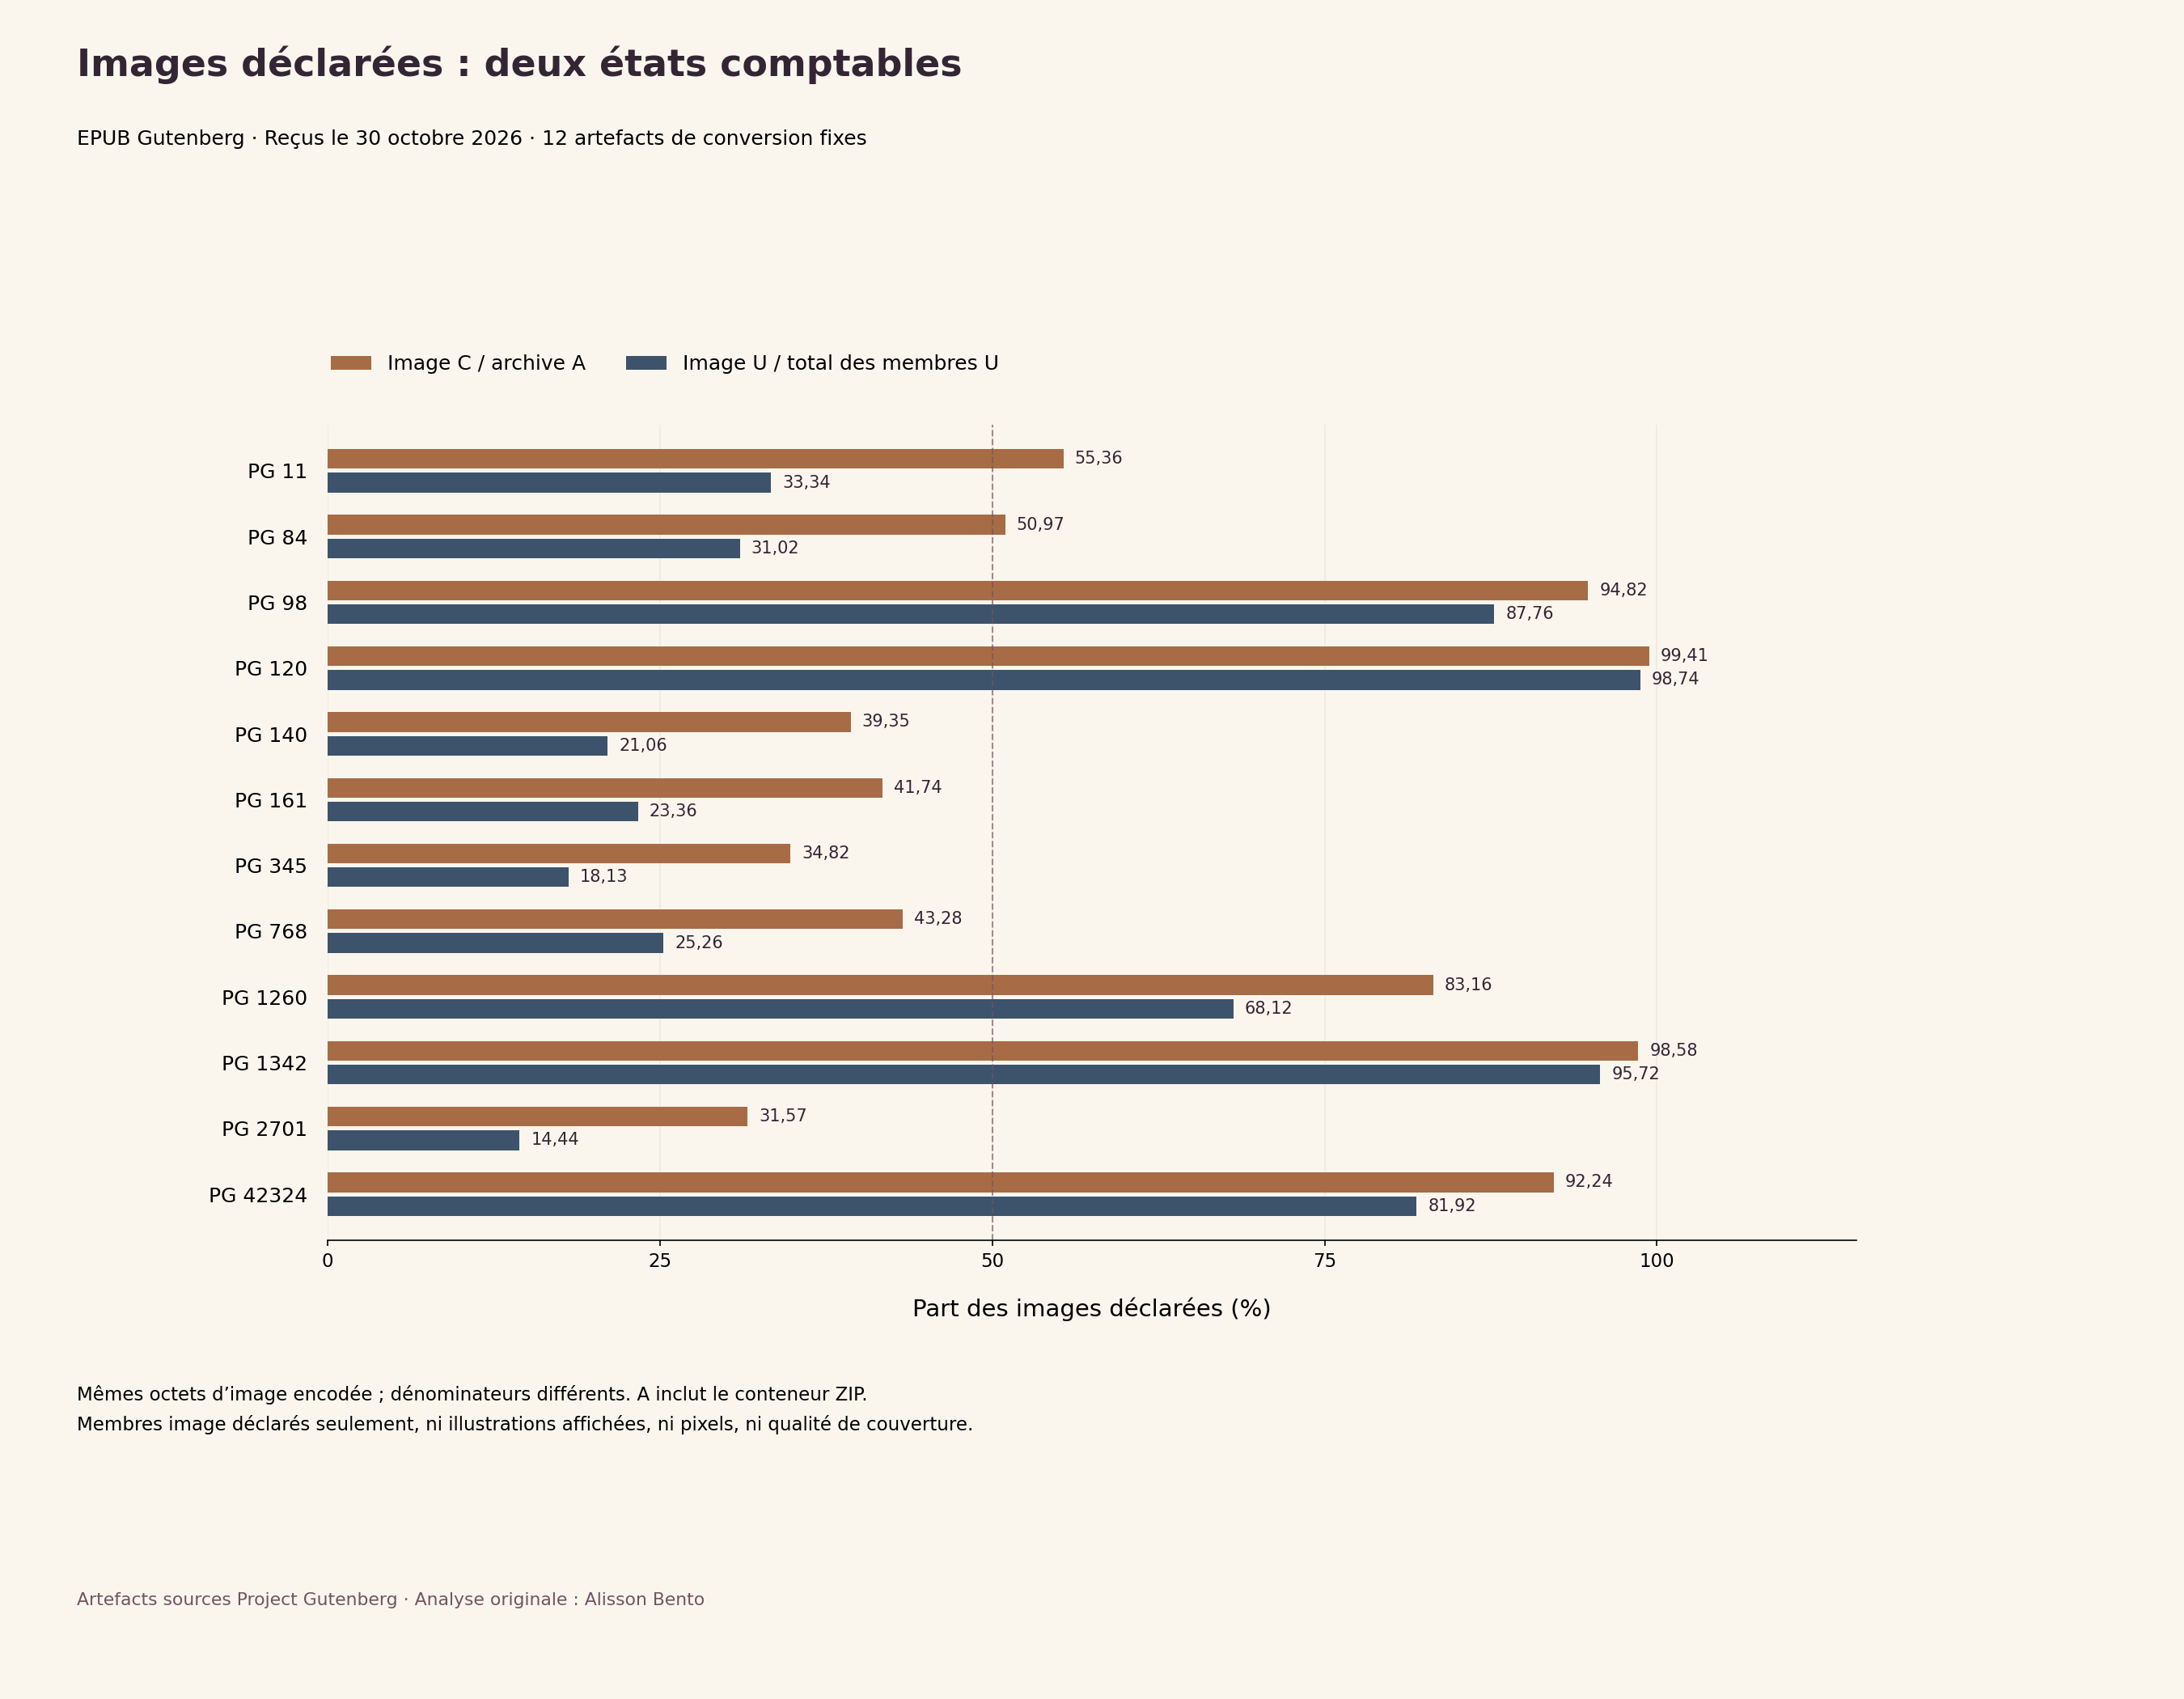
Pour Alice’s Adventures in Wonderland (identifiant 11), l’image déclarée représente 104 775 octets. Rapportée aux 189 249 octets de l’archive reçue, elle pèse 55,36 %. Rapportée aux 314 264 octets des éléments décompressés, la même image encodée pèse 33,34 %. Les octets de l’image n’ont pas disparu et leur qualité n’a pas changé entre ces deux calculs. Ce sont les éléments décompressés qui ne sont pas des images qui pèsent davantage dans le second dénominateur. « Archive à majorité d’images » et « éléments décompressés sans majorité d’images » sont donc deux descriptions exactes à la fois, à condition que chacune nomme sa base de comptage.
L’identifiant 84, Frankenstein, montre le second changement. Ses 224 340 octets d’image déclarée font 50,97 % d’une archive reçue de 440 131 octets, mais 31,02 % de ses 723 302 octets d’éléments décompressés. Dans les deux exemples, l’inventaire ne compte qu’une couverture déclarée. Leurs résultats ne dépendent donc pas d’un grand nombre d’images intérieures déclarées séparément. Les barres appariées montrent tous les fichiers, et pas seulement ceux qui changent de côté, pour que l’on voie ces exemples à côté des cas où les deux pourcentages restent du même côté de la moitié.
Les autres fichiers montrent de grandes variations sans changement de côté. Pour Moby Dick, les parts d’images sont de 31,57 % et 14,44 % ; pour Treasure Island, de 99,41 % et 98,74 %. Ces pourcentages décrivent des fichiers et des dénominateurs précis ; ils ne classent pas la qualité éditoriale. Une part élevée peut aller avec de belles illustrations, et une part faible ne garantit ni l’accessibilité ni des pages affichées légères. La bonne lecture est un compte précis de ce qui occupe les octets, et non la recommandation d’une composition plutôt qu’une autre.
Définir deux mesures indirectes du texte sans prétendre afficher le livre
La première mesure, X, est le nombre d’octets décompressés des documents XHTML de lecture retenus, une fois sérialisés, hors navigation et hors en-têtes et pieds du fournisseur. Le balisage fait partie de cette mesure, tout comme les pages liminaires, les légendes et tout autre contenu de ces documents. X se reproduit facilement à partir de la structure du paquet, mais ce n’est ni un nombre de mots validé pour un roman, ni une mesure du texte visible. Le balisage, l’encodage des caractères et la construction des documents peuvent faire varier X même quand l’expérience de lecture affichée serait semblable.
La seconde mesure, T, compte les points de code Unicode du texte littéral du corps, espaces normalisés, selon une règle d’extraction explicite. On recueille dans l’ordre du document le texte des éléments et le texte qui suit chacun d’eux (leur « queue ») ; on saute le contenu des balises script et style, mais le texte qui suit chacune de ces balises est conservé par l’élément parent. Les segments recueillis sont joints par une espace ASCII insérée, puis tous les espaces blancs Unicode sont réduits en un seul (séparation puis réunion). Les comptes s’additionnent d’un document à l’autre, sans espace inséré entre documents. On ne change ni la casse, ni les traits d’union, et il n’y a ni découpage en mots ni normalisation Unicode.
Ces espaces insérés entre segments sont une convention de calcul ; elles ne signifient pas que la page affichée contient une espace à chaque frontière d’élément. T ne détermine pas non plus la visibilité en CSS, n’identifie pas tout le contenu qui n’est pas de la prose et n’établit pas l’équivalence de deux éditions. La règle exacte de l’espace inséré a été documentée après le premier calcul de T, pour lever une ambiguïté, sans changer la règle appliquée ni les résultats. On ne doit pas la présenter comme un détail préenregistré à l’aveugle. Utiliser deux mesures rend leurs définitions vérifiables ; même si elles concordaient, aucune ne deviendrait une longueur littéraire ni un temps de lecture.
Comparer des ordres sur un ensemble fini, sans prédire des livres
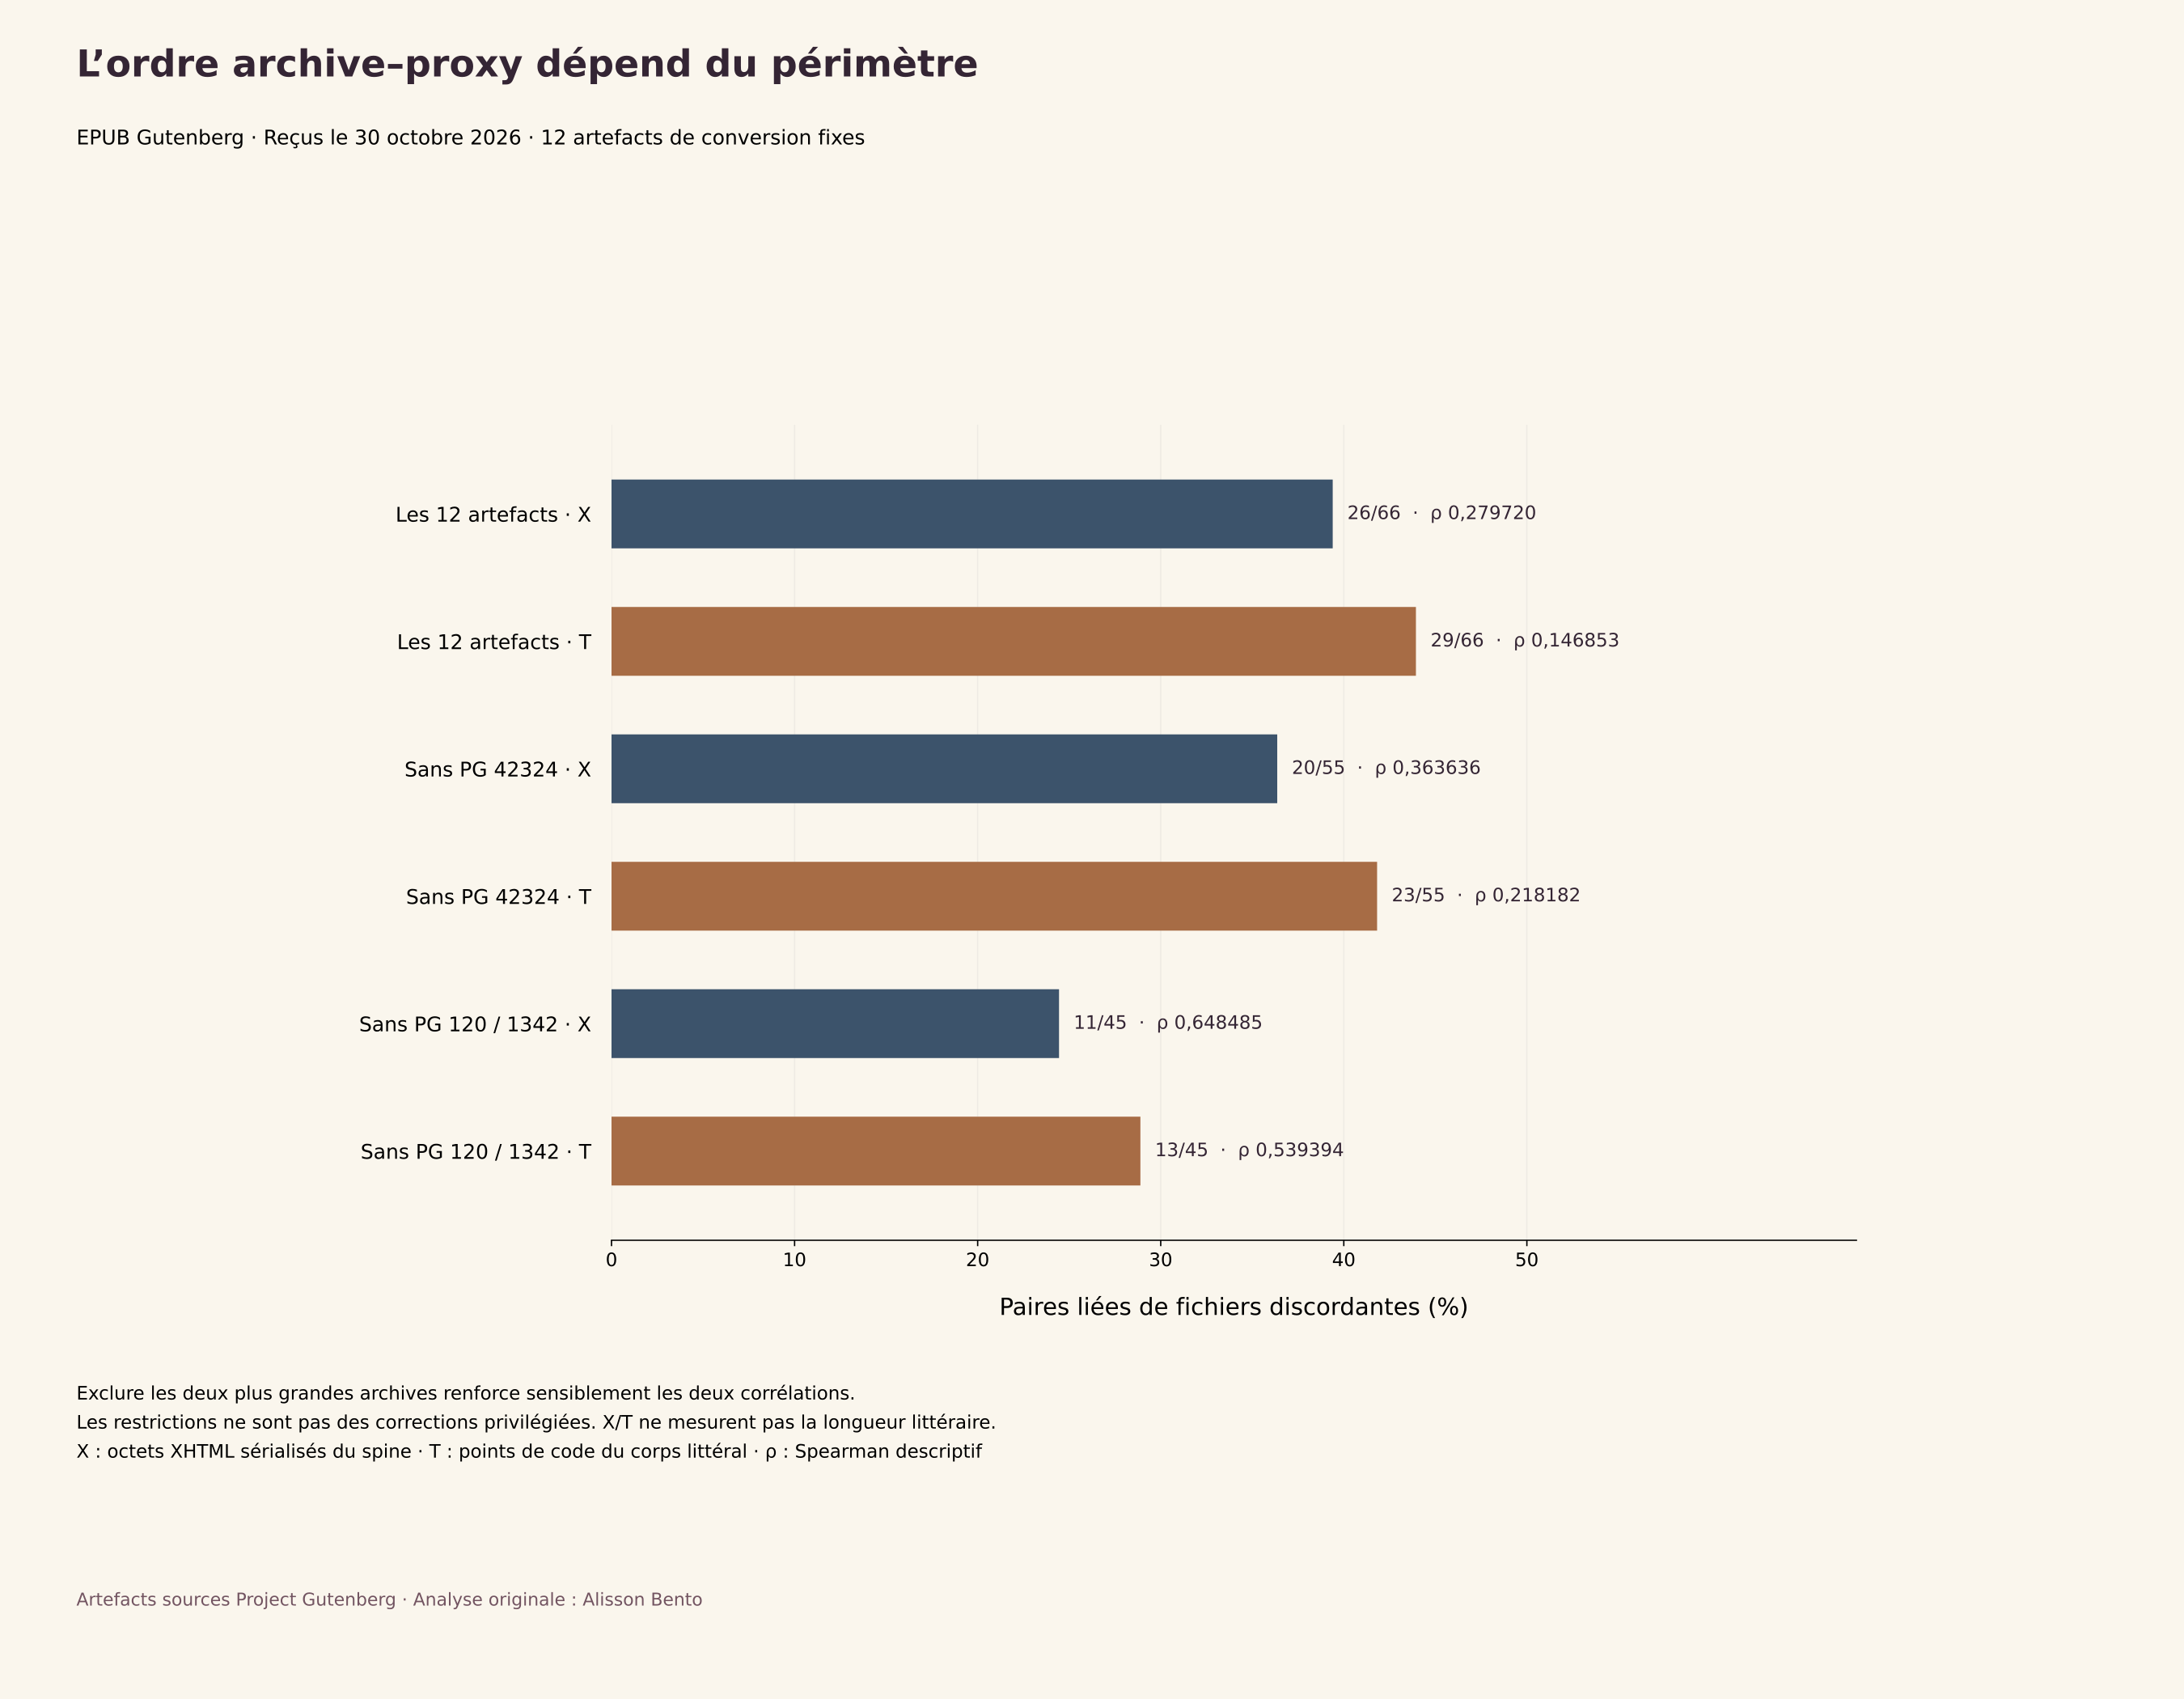
Pour chaque mesure, on compare à la taille de l’archive reçue chaque paire possible parmi les douze fichiers. Une paire est strictement discordante quand la plus grande archive a la plus petite valeur de la mesure, ou l’inverse. Les paires strictement concordantes et les égalités sont comptées à part. Il y a 66 paires liées entre elles, et non 66 observations tirées indépendamment. Pour l’ensemble complet, X donne 40 paires concordantes et 26 discordantes ; T en donne 37 et 29. Il n’y a aucune égalité, ni de taille d’archive ni de mesure. Le registre des paires garde les cas réels derrière ces totaux, au lieu de faire d’une simple corrélation le résultat.
Les corrélations de rang de Spearman, à titre descriptif, valent 0,279720 entre taille d’archive et X, et 0,146853 entre taille d’archive et T, arrondies à six décimales. Elles résument l’association des ordres dans cet ensemble fixe. Ce ne sont ni des scores de précision de prédiction, ni des paramètres d’une population, ni la preuve que la taille d’archive ne peut jamais être informative ailleurs. Comme chaque fichier intervient dans plusieurs comparaisons, on ne doit pas injecter ces totaux de paires dans un modèle d’essais indépendants. Nous ne fournissons ni test de significativité, ni intervalle de confiance, ni modèle général de la taille des livres numériques pour cette comparaison volontairement limitée.
Un contraste concret aide à lire les unités. Treasure Island (identifiant 120) est la plus grande archive reçue, avec 49 452 703 octets, mais son X vaut 467 048 et son T 359 153. Moby Dick (identifiant 2701) a une archive de 814 023 octets, et pourtant son X vaut 1 299 019 et son T 1 113 194. La comparaison montre un désaccord d’ordre entre ces quantités enregistrées ; elle ne montre pas qu’un roman est plus long au sens littéraire. Elle n’isole pas non plus l’effet d’un retrait des images, puisque nous n’avons produit ni paquet contrefactuel ni reconstruction au contenu équivalent.
Voir comment les plus grands fichiers influencent le résultat
Retirer les identifiants 120 et 1342, les deux plus grandes archives reçues, renforce nettement les associations. Parmi les dix fichiers restants, les corrélations montent à 0,648485 pour X et 0,539394 pour T. Les paires discordantes tombent à 11 et 13 sur 45. C’est une réserve importante, et non une note de bas de page que l’on pourrait résumer par « les valeurs extrêmes ne comptent pas ». Elles comptent bel et bien pour la force de ces associations. Les désaccords restants montrent que la différence d’ordre ne se limite pas à ces deux fichiers.
Une seconde restriction écarte l’identifiant 42324, la transcription de Frankenstein au plus grand identifiant. Les onze fichiers restants donnent 20 paires discordantes pour X et 23 pour T sur 55, avec des corrélations de 0,363636 et 0,218182. Les deux changements de majorité d’images subsistent dans les deux restrictions. Ces calculs montrent ce que le résultat doit à un fichier en double (une même œuvre) et aux plus grandes archives, sans faire d’aucune restriction un échantillon corrigé ou préféré. Les douze fichiers restent le cadre principal, et nous n’affirmons aucune équivalence littéraire entre les deux transcriptions de Frankenstein.
Nous avons défini la restriction aux deux plus grandes archives en connaissant déjà leurs tailles, d’après le manifeste source hérité. Le nouveau protocole ne peut donc pas se dire entièrement aveugle aux résultats. Il a fixé les règles de comptage et de comparaison avant les nouveaux résultats par catégorie et par mesure, mais nous avions déjà vu les sources et leurs tailles. La précision ultérieure sur T ajoute une autre limite de calendrier, déclarée elle aussi. Ces restrictions sont des analyses de sensibilité descriptives et transparentes ; ce ne sont pas des échantillons de validation indépendants, ni une permission de choisir le coefficient qui donne le titre le plus frappant. Il faut garder l’ensemble complet à côté des deux vues restreintes.
Lire avec soin les totaux groupés et les pourcentages arrondis
Le registre groupé par catégorie additionne les octets de tous les fichiers ; il ne fait pas la moyenne de douze compositions de livres numériques. Une grande archive y apporte plus d’octets qu’une petite. Une part d’images groupée répondrait donc à une question d’inventaire pondéré par le volume ; elle ne décrirait ni le fichier typique ni la proportion de titres à majorité d’images. Le tableau par fichier est l’endroit où voir cette variation. Garder les deux niveaux évite de laisser les deux plus gros paquets définir un livre prétendument typique.
Les écarts en points de pourcentage demandent aussi leur propre libellé. Les deux parts d’images d’Alice diffèrent d’environ 22,02 points de pourcentage, calculés sur les parts non arrondies. Ce n’est pas une baisse mesurée des octets d’images, ni une amélioration de 22,02 % de quoi que ce soit : le numérateur ne change pas. Une variation relative en pourcentage utiliserait une autre formule et répondrait à une autre question. L’indicateur de majorité teste seulement si la part définie dépasse 50 % ; il ne juge ni l’importance ni l’utilité de l’inventaire d’images.
Les pourcentages affichés sont arrondis à deux décimales et les corrélations à six, alors que les données de preuve gardent les entiers d’octets et les valeurs calculées. Les indicateurs de majorité et le sens des paires sont établis avant l’arrondi d’affichage. Cela compte, car une égalité arrondie n’est pas forcément une vraie égalité dans un autre ensemble. Ici, il n’y a pas d’égalité d’archive ni de mesure, mais le registre des comparaisons garde quand même des états d’égalité distincts. Reprendre le tableau arrondi pour recalculer exactement ferait perdre une information que les données compactes lisibles par machine conservent exprès.
Utiliser ces distinctions dans le travail des lecteurs et des auteurs
Pour qui télécharge un livre, la question immédiate peut être simple : que mesure la taille annoncée ? Dans ce registre, la grandeur utile est le nombre d’octets du corps de l’archive reçue, tandis que les totaux par élément répondent à une autre question d’inspection. Aucun de ces nombres ne dit, à lui seul, combien de pages une application affichera. Garder la date de réception et l’adresse exacte de la variante empêche qu’un simple nom d’édition remplace un fichier précis. C’est utile surtout quand un distributeur peut régénérer un EPUB sans changer le titre familier de l’œuvre.
Pour qui crée ou édite des livres numériques, le registre par catégorie permet de parler de conditionnement sans prendre un pourcentage pour un verdict de qualité. Un rapport peut nommer les fichiers d’images déclarés, distinguer les couvertures des autres images déclarées et préciser si les pourcentages portent sur des octets compressés ou décompressés. Il peut aussi laisser visibles la navigation, les documents du fournisseur et le poids du conteneur. Ces distinctions rendent une discussion technique reproductible. Elles n’établissent pas quels fichiers supprimer, s’il faut recompresser les images, ni si un changement préserverait l’expérience de lecture voulue.
Pour qui analyse un catalogue, la comparaison d’ordre déconseille de remplacer une mesure précise du texte par un champ « taille du livre » sans définition. Les corrélations plus fortes après exclusion des plus grands fichiers montrent aussi pourquoi l’ensemble complet compte : aucun coefficient unique ne dispense d’examiner les cas. Une réutilisation solide nommerait le cadre source exact, la mesure et la base de comptage, puis reproduirait les comparaisons limitées utiles. Elle n’exporterait pas les coefficients de cet ensemble comme règle de prédiction pour un autre catalogue, un autre format ou de futures conversions Gutenberg.
Reproduire des faits compacts sans redistribuer de livres
Le dossier de preuves public contient les données d’octets par catégorie retenues, les valeurs des mesures de texte, les références aux archives sources, les mesures dérivées par fichier et par catégorie, toutes les comparaisons de paires et un résumé. Le script de reproduction agrégée travaille à partir de ces données compactes, avec des dossiers d’entrée et de sortie explicites. Un script de mesure distinct, facultatif, peut examiner des EPUB officiels exacts obtenus séparément, après vérification de leurs empreintes d’archive. Il n’envoie aucune requête à la source et produit des mesures chiffrées, pas du contenu de livre. La liste publique de sommes de contrôle décrit les fichiers compacts distribués ; les empreintes des archives d’origine identifient des sources externes qui ne sont pas incluses.
Les archives sources restent des données privées que nous conservons. Le dossier public ne contient aucun roman complet, aucun texte extrait, aucune couverture ni illustration, et le registre interne des noms d’éléments n’est pas à télécharger. Les auteurs des textes et Project Gutenberg sont cités à part des calculs et de l’explication originaux d’Alisson Bento. Chaque paquet conservé porte une mention de domaine public aux États-Unis et la licence Gutenberg. Ces mentions et la politique citée n’établissent pas une autorisation valable dans le monde entier, ne lèvent pas les conditions liées à la marque et ne donnent pas de licence générale pour l’ensemble de l’article ni pour tous les usages ultérieurs.
Le résultat final est volontairement plus étroit qu’un verdict sur les livres numériques. Deux classements en majorité d’images changent avec le dénominateur, et l’ordre des archives diffère de celui de deux mesures indirectes du texte, calculées sans affichage. Les plus grands fichiers influencent nettement les résumés d’ordre, tandis que les désaccords et les changements de majorité subsistent dans les restrictions indiquées. Ces résultats appuient des unités bien nommées et des exemples vérifiables ; ils n’appuient aucune affirmation sur des défauts de navigation, la qualité visuelle, le temps de lecture, le trafic réseau, la latence, la mémoire ou les performances des appareils. Garder ces limites rend utile ce petit ensemble fixe, au lieu d’en faire une simple collection de tailles de fichiers impressionnantes.
Parts d’images déclarées : deux bases de comptage
EPUB Gutenberg · Reçus le 30 octobre 2026 · 12 fichiers EPUB fixes
Graphique complet et source

Faites défiler le graphique horizontalement pour le consulter. ↔
Graphique et valeurs
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Fichier Gutenberg | A reçu (octets) | C des images déclarées (octets) | U décompressé (octets) | Images C_img/A (%) | Images U_img/U (%) | Changement de majorité (1 = oui) |
|---|---|---|---|---|---|---|
| PG 11 | 189 249 | 104 775 | 314 264 | 55,36 | 33,34 | 1 |
| PG 84 | 440 131 | 224 340 | 723 302 | 50,97 | 31,02 | 1 |
| PG 98 | 7 923 060 | 7 512 341 | 8 559 932 | 94,82 | 87,76 | 0 |
| PG 120 | 49 452 703 | 49 162 018 | 49 789 786 | 99,41 | 98,74 | 0 |
| PG 140 | 615 474 | 242 178 | 1 149 729 | 39,35 | 21,06 | 0 |
| PG 161 | 580 103 | 242 125 | 1 036 582 | 41,74 | 23,36 | 0 |
| PG 345 | 602 902 | 209 921 | 1 157 585 | 34,82 | 18,13 | 0 |
| PG 768 | 587 952 | 254 472 | 1 007 298 | 43,28 | 25,26 | 0 |
| PG 1260 | 3 095 830 | 2 574 499 | 3 779 323 | 83,16 | 68,12 | 0 |
| PG 1342 | 24 864 457 | 24 512 383 | 25 607 139 | 98,58 | 95,72 | 0 |
| PG 2701 | 814 023 | 257 017 | 1 780 233 | 31,57 | 14,44 | 0 |
| PG 42324 | 2 472 089 | 2 280 260 | 2 783 589 | 92,24 | 81,92 | 0 |
Les douze fichiers fixes reçus le 30 octobre 2026. C_img/A utilise les octets du corps de l’archive reçue ; U_img/U utilise les octets des éléments décompressés. Éléments d’image déclarés seulement, couvertures comprises ; ce ne sont pas des nombres d’illustrations affichées ou intégrées. Pourcentages arrondis à deux décimales ; l’indicateur de majorité utilise les parts non arrondies. Les identifiants désignent des fichiers, et non des œuvres indépendantes.
Télécharger le graphique (SVG) ↓ · Télécharger le graphique (PNG) ↓
L’ordre des archives et des mesures de texte dépend du groupe de fichiers
EPUB Gutenberg · Reçus le 30 octobre 2026 · 12 fichiers EPUB fixes
Graphique complet et source
Faites défiler le graphique horizontalement pour le consulter. ↔
Graphique et valeurs
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Groupe fixe de fichiers | Mesure | Fichiers | Paires | Concordantes | Discordantes | Égalités de taille d’archive | Égalités de la mesure | Égalités des deux | Rho de Spearman |
|---|---|---|---|---|---|---|---|---|---|
| Tous les fichiers fixes | X | 12 | 66 | 40 | 26 | 0 | 0 | 0 | 0,279720 |
| Tous les fichiers fixes | T | 12 | 66 | 37 | 29 | 0 | 0 | 0 | 0,146853 |
| Sans PG 42324 seulement | X | 11 | 55 | 35 | 20 | 0 | 0 | 0 | 0,363636 |
| Sans PG 42324 seulement | T | 11 | 55 | 32 | 23 | 0 | 0 | 0 | 0,218182 |
| Sans PG 120 et 1342 | X | 10 | 45 | 34 | 11 | 0 | 0 | 0 | 0,648485 |
| Sans PG 120 et 1342 | T | 10 | 45 | 32 | 13 | 0 | 0 | 0 | 0,539394 |
X = octets décompressés du XHTML de lecture retenu, sérialisé ; T = points de code du texte littéral normalisé, avec espaces insérés entre segments. Ni l’une ni l’autre n’est une longueur affichée ou une longueur validée du texte. Chaque paire de fichiers est liée à son groupe fixe. Le coefficient de Spearman est descriptif, arrondi à six décimales, sans valeurs p ni intervalles de confiance. Les restrictions sont des diagnostics, et non des corrections à préférer ; nous connaissions déjà les tailles des sources quand nous les avons définies.
Télécharger le graphique (SVG) ↓ · Télécharger le graphique (PNG) ↓

Données et téléchargements
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Fichier Gutenberg | A reçu (octets) | C des images déclarées (octets) | U décompressé (octets) | Images C_img/A (%) | Images U_img/U (%) | Changement de majorité (1 = oui) |
|---|---|---|---|---|---|---|
| PG 11 | 189 249 | 104 775 | 314 264 | 55,36 | 33,34 | 1 |
| PG 84 | 440 131 | 224 340 | 723 302 | 50,97 | 31,02 | 1 |
| PG 98 | 7 923 060 | 7 512 341 | 8 559 932 | 94,82 | 87,76 | 0 |
| PG 120 | 49 452 703 | 49 162 018 | 49 789 786 | 99,41 | 98,74 | 0 |
| PG 140 | 615 474 | 242 178 | 1 149 729 | 39,35 | 21,06 | 0 |
| PG 161 | 580 103 | 242 125 | 1 036 582 | 41,74 | 23,36 | 0 |
| PG 345 | 602 902 | 209 921 | 1 157 585 | 34,82 | 18,13 | 0 |
| PG 768 | 587 952 | 254 472 | 1 007 298 | 43,28 | 25,26 | 0 |
| PG 1260 | 3 095 830 | 2 574 499 | 3 779 323 | 83,16 | 68,12 | 0 |
| PG 1342 | 24 864 457 | 24 512 383 | 25 607 139 | 98,58 | 95,72 | 0 |
| PG 2701 | 814 023 | 257 017 | 1 780 233 | 31,57 | 14,44 | 0 |
| PG 42324 | 2 472 089 | 2 280 260 | 2 783 589 | 92,24 | 81,92 | 0 |
Les douze fichiers fixes reçus le 30 octobre 2026. C_img/A utilise les octets du corps de l’archive reçue ; U_img/U utilise les octets des éléments décompressés. Éléments d’image déclarés seulement, couvertures comprises ; ce ne sont pas des nombres d’illustrations affichées ou intégrées. Pourcentages arrondis à deux décimales ; l’indicateur de majorité utilise les parts non arrondies. Les identifiants désignent des fichiers, et non des œuvres indépendantes.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Groupe fixe de fichiers | Mesure | Fichiers | Paires | Concordantes | Discordantes | Égalités de taille d’archive | Égalités de la mesure | Égalités des deux | Rho de Spearman |
|---|---|---|---|---|---|---|---|---|---|
| Tous les fichiers fixes | X | 12 | 66 | 40 | 26 | 0 | 0 | 0 | 0,279720 |
| Tous les fichiers fixes | T | 12 | 66 | 37 | 29 | 0 | 0 | 0 | 0,146853 |
| Sans PG 42324 seulement | X | 11 | 55 | 35 | 20 | 0 | 0 | 0 | 0,363636 |
| Sans PG 42324 seulement | T | 11 | 55 | 32 | 23 | 0 | 0 | 0 | 0,218182 |
| Sans PG 120 et 1342 | X | 10 | 45 | 34 | 11 | 0 | 0 | 0 | 0,648485 |
| Sans PG 120 et 1342 | T | 10 | 45 | 32 | 13 | 0 | 0 | 0 | 0,539394 |
X = octets décompressés du XHTML de lecture retenu, sérialisé ; T = points de code du texte littéral normalisé, avec espaces insérés entre segments. Ni l’une ni l’autre n’est une longueur affichée ou une longueur validée du texte. Chaque paire de fichiers est liée à son groupe fixe. Le coefficient de Spearman est descriptif, arrondi à six décimales, sans valeurs p ni intervalles de confiance. Les restrictions sont des diagnostics, et non des corrections à préférer ; nous connaissions déjà les tailles des sources quand nous les avons définies.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Catégorie d’éléments | Éléments | C_r compressé (octets) | U_r décompressé (octets) | U_r/C_r |
|---|---|---|---|---|
| Contrôle du paquet | 36 | 29 306 | 172 397 | 5,882652 |
| Navigation | 24 | 45 659 | 387 227 | 8,480847 |
| Images de couverture déclarées | 12 | 2 743 502 | 2 743 502 | 1,000000 |
| Autres images déclarées | 386 | 84 832 827 | 84 832 827 | 1,000000 |
| XHTML du fournisseur | 24 | 270 425 | 771 931 | 2,854510 |
| XHTML de lecture retenus | 412 | 3 520 103 | 8 608 444 | 2,445509 |
| Autres XHTML | 0 | 0 | 0 | Indéfini (zéro octet compressé) |
| Feuilles de style | 112 | 44 555 | 172 434 | 3,870138 |
| Polices | 0 | 0 | 0 | Indéfini (zéro octet compressé) |
| Autres éléments déclarés | 0 | 0 | 0 | Indéfini (zéro octet compressé) |
| Autres éléments hors manifeste | 0 | 0 | 0 | Indéfini (zéro octet compressé) |
Sommes d’octets sur les douze fichiers, et non composition moyenne d’un livre. La somme des octets compressés des éléments est C = 91 486 377, et non A. Le reste du conteneur O = 151 596 est la différence A − C ; ce n’est ni un élément média ni une part de U. Une catégorie sans élément est une absence observée ; son U/C est indéfini, et non nul ou dû à une source manquante. Les octets d’images restent des octets d’images encodées, et non des pixels bruts.
Faites défiler le tableau horizontalement pour voir toutes les colonnes.
| Fichier Gutenberg | A reçu (octets) | Éléments compressés C (octets) | Reste du conteneur O (octets) | U décompressé (octets) | XHTML de lecture sérialisé X (octets) | Texte littéral T (points de code) |
|---|---|---|---|---|---|---|
| PG 11 | 189 249 | 185 883 | 3 366 | 314 264 | 168 759 | 142 244 |
| PG 84 | 440 131 | 434 011 | 6 120 | 723 302 | 452 075 | 418 114 |
| PG 98 | 7 923 060 | 7 904 510 | 18 550 | 8 559 932 | 949 314 | 751 407 |
| PG 120 | 49 452 703 | 49 408 691 | 44 012 | 49 789 786 | 467 048 | 359 153 |
| PG 140 | 615 474 | 608 964 | 6 510 | 1 149 729 | 855 571 | 805 861 |
| PG 161 | 580 103 | 570 581 | 9 522 | 1 036 582 | 730 802 | 666 929 |
| PG 345 | 602 902 | 596 404 | 6 498 | 1 157 585 | 897 699 | 834 892 |
| PG 768 | 587 952 | 580 950 | 7 002 | 1 007 298 | 703 951 | 642 920 |
| PG 1260 | 3 095 830 | 3 079 104 | 16 726 | 3 779 323 | 1 122 265 | 1 016 740 |
| PG 1342 | 24 864 457 | 24 837 583 | 26 874 | 25 607 139 | 693 662 | 599 785 |
| PG 2701 | 814 023 | 810 935 | 3 088 | 1 780 233 | 1 299 019 | 1 113 194 |
| PG 42324 | 2 472 089 | 2 468 761 | 3 328 | 2 783 589 | 268 279 | 258 014 |
A = C + O. U est la somme des éléments ZIP décompressés et exclut le reste O du conteneur. X est une partie de U ; ce n’est pas tout le texte ni toute la prose. T est une mesure automatique en points de code du texte littéral, et non un nombre de mots ou de pages. Les octets du corps de l’archive ne sont pas la taille transmise en HTTP ; U n’est pas la mémoire vive. Tous les comptes sont des entiers exacts. Les titres et les auteurs figurent avec les sources exactes des fichiers.
Données et méthode
Notre méthode de calcul
- Conserver exactement les douze archives EPUB3 officielles, variante avec images, reçues le 30 octobre 2026 : identifiants 11, 84, 98, 120, 140, 161, 345, 768, 1260, 1342, 2701 et 42324. Vérifier les véritables empreintes des archives d’origine, les sommes de contrôle CRC du ZIP, les déclarations du paquet et les cibles du spine ; aucun remplacement de source, aucun nouveau téléchargement.
- Mesurer les octets A de l’archive reçue, la somme C des éléments compressés, la somme U des éléments décompressés et le reste O du conteneur, O = A − C. Pour chaque catégorie, utiliser C_r/A comme part de l’archive compressée et U_r/U comme part des éléments décompressés. U_r/C_r n’est défini que si C_r est positif ; une catégorie observée à zéro n’est pas une source manquante.
- Classer chaque élément une seule fois d’après les déclarations réelles du paquet et le spine : contrôle du paquet, navigation, image de couverture déclarée, autre image déclarée, XHTML du fournisseur, XHTML de lecture retenu, autres XHTML, feuille de style, police, autre élément déclaré et autre élément hors manifeste. Ne compter que les ÉLÉMENTS d’image déclarés, et non les illustrations affichées, incorporées ou distantes.
- Définir X comme les octets décompressés du XHTML de lecture retenu, sérialisé, hors navigation et hors en-têtes et pieds du fournisseur. Définir T, pour chaque corps de document : recueillir dans l’ordre du document le texte des éléments (.text) et le texte qui suit chacun d’eux (.tail) ; sauter l’intérieur des balises script et style tout en gardant le texte qui les suit ; insérer une espace ASCII entre les segments ; réduire les espaces blancs Unicode par séparation puis réunion ; compter les points de code et additionner les documents sans séparateur entre eux. Aucun affichage, ni mot, ni page n’est mesuré.
- Comparer toutes les paires de fichiers pour A contre X et A contre T. Garder les paires strictement concordantes et discordantes, et les états d’égalité, à part. Calculer les corrélations de Spearman, à titre descriptif, avec les rangs moyens en cas d’égalité. Ne pas traiter les paires liées comme des essais indépendants, et ne fournir ni intervalles d’inférence ni affirmations de prédiction.
- Garder les douze fichiers comme cadre principal. Recalculer séparément sans le Frankenstein au plus grand identifiant (PG 42324), puis sans les deux plus grandes archives (PG 120 et 1342). Ces restrictions sont déclarées et ne sont pas préférées. Nous avions vu les sources et leurs tailles avant le protocole ; la convention inchangée des séparateurs de T a été précisée après son premier calcul, et n’a pas été préenregistrée à l’aveugle.
- Reproduire les quatre sorties agrégées dérivées à partir des données factuelles compactes retenues, dans un dossier vierge. La mesure d’origine, facultative, utilise des EPUB officiels exacts obtenus séparément, avec vérification des empreintes et des CRC. Afficher les pourcentages avec deux décimales et les corrélations et facteurs avec six ; calculer les indicateurs et les ordres avant l’arrondi. Aucun texte source, couverture, illustration ni registre privé des noms d’éléments n’est distribué.
Ce que les données ne permettent pas de conclure
- Douze fichiers de conversion retenus de façon délibérée, dont deux transcriptions de Frankenstein, ne sont ni douze œuvres indépendantes ni un échantillon représentatif de Gutenberg, des livres numériques, des auteurs ou des formats. L’équivalence de contenu entre les versions n’est pas vérifiée.
- A compte les octets du corps de l’archive reçue, et non les en-têtes HTTP ni la taille transmise sur le réseau. U compte les octets des éléments ZIP décompressés, et non la mémoire vive, les pages affichées, le temps de lecture, la latence, les performances d’un appareil ou les frais de livraison. Les fichiers d’images encodées ne sont pas des pixels bruts.
- Les catégories image et couverture décrivent des éléments déclarés du paquet. Elles ne recensent pas les illustrations affichées ou incorporées, ne certifient pas la qualité des images ou des couvertures, n’établissent pas l’absence d’illustrations et ne justifient ni la suppression ni la recompression de fichiers.
- X inclut le balisage sérialisé et d’éventuels contenus qui ne sont pas de la prose. T est une convention de comptage de points de code du texte littéral, avec des espaces insérés entre segments ; ce n’est ni la visibilité en CSS, ni un nombre de mots validé, ni une longueur littéraire, ni une équivalence du contenu affiché.
- Exclure PG 120 et 1342 augmente nettement les corrélations et réduit le nombre de paires discordantes. Les désaccords restants n’établissent pas que la prédiction échoue en général ; les douze fichiers restent le cadre principal, et aucune restriction n’est un cadre corrigé à préférer.
- Le manifeste des sources et les tailles des archives étaient déjà connus avant le nouveau protocole. Les séparateurs de segments de T ont été précisés après le premier calcul, sans ajustement ni changement des résultats. Nous ne prétendons ni à un préenregistrement entièrement aveugle aux résultats, ni à une première méthodologique.
- Les paires de fichiers sont des observations liées dans un petit ensemble fini, choisi à dessein. Les corrélations et les comptes d’ordre sont uniquement descriptifs ; il n’y a ni valeurs p, ni intervalles de confiance, ni classement de qualité, ni estimation pour une population générale.
- Les catégories observées à zéro ont zéro élément et zéro octet, et leurs rapports de compression sont indéfinis. Ce ne sont pas des données manquantes. De futurs fichiers officiels régénérés, avec d’autres empreintes, seraient d’autres fichiers, et non des substituts silencieux de cet instantané.
- Les mentions de domaine public aux États-Unis intégrées aux fichiers et la licence complète de Gutenberg n’établissent ni une autorisation valable dans le monde entier ni une licence générale pour cet article. Les conditions liées à la marque et aux juridictions demeurent ; aucun contenu de livre ni aucune ressource visuelle d’origine n’est redistribué. Les défauts de navigation et l’accessibilité sortent du cadre de cette analyse.
Sources originales
- Project Gutenberg: official generated-content mirroring
Project Gutenberg : miroirs officiels du contenu généré. La documentation consultée précédemment indique gutenberg.pglaf.org comme autre source de la collection générée. Les adresses réelles des douze fichiers reçus, leurs dates UTC et les véritables empreintes SHA-256 des archives officielles figurent dans source-archives.json ; ces scripts n’envoient aucune nouvelle requête. https://www.gutenberg.org/help/mirroring.html
Consulté le 30 octobre 2026
- Project Gutenberg: licence and rights guidance
Project Gutenberg : licence et droits. La politique consultée précédemment et la licence complète intégrée à chaque paquet conservé, avec sa mention de domaine public aux États-Unis, délimitent les droits sur les sources. Elles n’établissent pas une autorisation valable dans le monde entier et ne donnent aucune licence pour l’ensemble de l’analyse. Aucun texte de livre numérique, aucune illustration, couverture ou logo n’est redistribué. https://www.gutenberg.org/policy/license.html
Consulté le 30 octobre 2026
- Project Gutenberg EPUB artifact 11: Alice's Adventures in Wonderland
Fichier EPUB Project Gutenberg 11 : Alice’s Adventures in Wonderland (Lewis Carroll). Version EPUB3 avec images, reçue telle quelle : 189 249 octets de corps d’archive ; fiche canonique https://www.gutenberg.org/ebooks/11. La véritable empreinte de l’archive officielle, dans source-archives.json, identifie l’original obtenu séparément ; ce n’est pas un livre numérique distribué. Mention de domaine public aux États-Unis et licence Gutenberg intégrée ; nous n’affirmons ni autorisation mondiale ni équivalence de contenu. https://gutenberg.pglaf.org/cache/epub/11/pg11-images-3.epub
Consulté le 30 octobre 2026
- Project Gutenberg EPUB artifact 84: Frankenstein; or, The modern Prometheus
Fichier EPUB Project Gutenberg 84 : Frankenstein; or, The modern Prometheus (Mary Wollstonecraft Shelley). Version EPUB3 avec images, reçue telle quelle : 440 131 octets de corps d’archive ; fiche canonique https://www.gutenberg.org/ebooks/84. La véritable empreinte de l’archive officielle, dans source-archives.json, identifie l’original obtenu séparément ; ce n’est pas un livre numérique distribué. Mention de domaine public aux États-Unis et licence Gutenberg intégrée ; nous n’affirmons ni autorisation mondiale ni équivalence de contenu. https://gutenberg.pglaf.org/cache/epub/84/pg84-images-3.epub
Consulté le 30 octobre 2026
- Project Gutenberg EPUB artifact 98: A Tale of Two Cities
Fichier EPUB Project Gutenberg 98 : A Tale of Two Cities (Charles Dickens). Version EPUB3 avec images, reçue telle quelle : 7 923 060 octets de corps d’archive ; fiche canonique https://www.gutenberg.org/ebooks/98. La véritable empreinte de l’archive officielle, dans source-archives.json, identifie l’original obtenu séparément ; ce n’est pas un livre numérique distribué. Mention de domaine public aux États-Unis et licence Gutenberg intégrée ; nous n’affirmons ni autorisation mondiale ni équivalence de contenu. https://gutenberg.pglaf.org/cache/epub/98/pg98-images-3.epub
Consulté le 30 octobre 2026
- Project Gutenberg EPUB artifact 120: Treasure Island
Fichier EPUB Project Gutenberg 120 : Treasure Island (Robert Louis Stevenson). Version EPUB3 avec images, reçue telle quelle : 49 452 703 octets de corps d’archive ; fiche canonique https://www.gutenberg.org/ebooks/120. La véritable empreinte de l’archive officielle, dans source-archives.json, identifie l’original obtenu séparément ; ce n’est pas un livre numérique distribué. Mention de domaine public aux États-Unis et licence Gutenberg intégrée ; nous n’affirmons ni autorisation mondiale ni équivalence de contenu. https://gutenberg.pglaf.org/cache/epub/120/pg120-images-3.epub
Consulté le 30 octobre 2026
- Project Gutenberg EPUB artifact 140: The Jungle
Fichier EPUB Project Gutenberg 140 : The Jungle (Upton Sinclair). Version EPUB3 avec images, reçue telle quelle : 615 474 octets de corps d’archive ; fiche canonique https://www.gutenberg.org/ebooks/140. La véritable empreinte de l’archive officielle, dans source-archives.json, identifie l’original obtenu séparément ; ce n’est pas un livre numérique distribué. Mention de domaine public aux États-Unis et licence Gutenberg intégrée ; nous n’affirmons ni autorisation mondiale ni équivalence de contenu. https://gutenberg.pglaf.org/cache/epub/140/pg140-images-3.epub
Consulté le 30 octobre 2026
- Project Gutenberg EPUB artifact 161: Sense and Sensibility
Fichier EPUB Project Gutenberg 161 : Sense and Sensibility (Jane Austen). Version EPUB3 avec images, reçue telle quelle : 580 103 octets de corps d’archive ; fiche canonique https://www.gutenberg.org/ebooks/161. La véritable empreinte de l’archive officielle, dans source-archives.json, identifie l’original obtenu séparément ; ce n’est pas un livre numérique distribué. Mention de domaine public aux États-Unis et licence Gutenberg intégrée ; nous n’affirmons ni autorisation mondiale ni équivalence de contenu. https://gutenberg.pglaf.org/cache/epub/161/pg161-images-3.epub
Consulté le 30 octobre 2026
- Project Gutenberg EPUB artifact 345: Dracula
Fichier EPUB Project Gutenberg 345 : Dracula (Bram Stoker). Version EPUB3 avec images, reçue telle quelle : 602 902 octets de corps d’archive ; fiche canonique https://www.gutenberg.org/ebooks/345. La véritable empreinte de l’archive officielle, dans source-archives.json, identifie l’original obtenu séparément ; ce n’est pas un livre numérique distribué. Mention de domaine public aux États-Unis et licence Gutenberg intégrée ; nous n’affirmons ni autorisation mondiale ni équivalence de contenu. https://gutenberg.pglaf.org/cache/epub/345/pg345-images-3.epub
Consulté le 30 octobre 2026
- Project Gutenberg EPUB artifact 768: Wuthering Heights
Fichier EPUB Project Gutenberg 768 : Wuthering Heights (Emily Brontë). Version EPUB3 avec images, reçue telle quelle : 587 952 octets de corps d’archive ; fiche canonique https://www.gutenberg.org/ebooks/768. La véritable empreinte de l’archive officielle, dans source-archives.json, identifie l’original obtenu séparément ; ce n’est pas un livre numérique distribué. Mention de domaine public aux États-Unis et licence Gutenberg intégrée ; nous n’affirmons ni autorisation mondiale ni équivalence de contenu. https://gutenberg.pglaf.org/cache/epub/768/pg768-images-3.epub
Consulté le 30 octobre 2026
- Project Gutenberg EPUB artifact 1260: Jane Eyre: An Autobiography
Fichier EPUB Project Gutenberg 1260 : Jane Eyre: An Autobiography (Charlotte Brontë). Version EPUB3 avec images, reçue telle quelle : 3 095 830 octets de corps d’archive ; fiche canonique https://www.gutenberg.org/ebooks/1260. La véritable empreinte de l’archive officielle, dans source-archives.json, identifie l’original obtenu séparément ; ce n’est pas un livre numérique distribué. Mention de domaine public aux États-Unis et licence Gutenberg intégrée ; nous n’affirmons ni autorisation mondiale ni équivalence de contenu. https://gutenberg.pglaf.org/cache/epub/1260/pg1260-images-3.epub
Consulté le 30 octobre 2026
- Project Gutenberg EPUB artifact 1342: Pride and Prejudice
Fichier EPUB Project Gutenberg 1342 : Pride and Prejudice (Jane Austen). Version EPUB3 avec images, reçue telle quelle : 24 864 457 octets de corps d’archive ; fiche canonique https://www.gutenberg.org/ebooks/1342. La véritable empreinte de l’archive officielle, dans source-archives.json, identifie l’original obtenu séparément ; ce n’est pas un livre numérique distribué. Mention de domaine public aux États-Unis et licence Gutenberg intégrée ; nous n’affirmons ni autorisation mondiale ni équivalence de contenu. https://gutenberg.pglaf.org/cache/epub/1342/pg1342-images-3.epub
Consulté le 30 octobre 2026
- Project Gutenberg EPUB artifact 2701: Moby Dick; Or, The Whale
Fichier EPUB Project Gutenberg 2701 : Moby Dick; Or, The Whale (Herman Melville). Version EPUB3 avec images, reçue telle quelle : 814 023 octets de corps d’archive ; fiche canonique https://www.gutenberg.org/ebooks/2701. La véritable empreinte de l’archive officielle, dans source-archives.json, identifie l’original obtenu séparément ; ce n’est pas un livre numérique distribué. Mention de domaine public aux États-Unis et licence Gutenberg intégrée ; nous n’affirmons ni autorisation mondiale ni équivalence de contenu. https://gutenberg.pglaf.org/cache/epub/2701/pg2701-images-3.epub
Consulté le 30 octobre 2026
- Project Gutenberg EPUB artifact 42324: Frankenstein; or, The modern Prometheus
Fichier EPUB Project Gutenberg 42324 : Frankenstein; or, The modern Prometheus (Mary Wollstonecraft Shelley). Version EPUB3 avec images, reçue telle quelle : 2 472 089 octets de corps d’archive ; fiche canonique https://www.gutenberg.org/ebooks/42324. La véritable empreinte de l’archive officielle, dans source-archives.json, identifie l’original obtenu séparément ; ce n’est pas un livre numérique distribué. Mention de domaine public aux États-Unis et licence Gutenberg intégrée ; nous n’affirmons ni autorisation mondiale ni équivalence de contenu. https://gutenberg.pglaf.org/cache/epub/42324/pg42324-images-3.epub
Consulté le 30 octobre 2026
Citer et réutiliser cette étude
Alisson Bento. Dans 12 fichiers EPUB : octets et mesures indirectes du texte. 2026, recherche originale. https://alissonbento.com/fr/research/gutenberg-epub-payload-composition-12-artifacts/
Les auteurs des textes et Project Gutenberg sont cités pour les fichiers EPUB exacts reçus. Les fichiers à télécharger contiennent des données factuelles compactes (octets et mesures de texte), des résultats chiffrés et du code originaux, des références canoniques vers les sources et les véritables empreintes des archives officielles ; ils ne contiennent ni texte de livre numérique, ni couverture, ni illustration, ni le registre privé des noms d’éléments. Les empreintes identifient des originaux obtenus séparément ; SHA256SUMS.txt donne les sommes de contrôle des fichiers compacts réellement distribués. Les mentions de domaine public aux États-Unis et la licence Gutenberg restent soumises aux limites de juridiction et de marque ; nous n’affirmons ni autorisation mondiale, ni approbation, ni licence générale pour l’article. Analyse et explication originales : Alisson Bento.
Corrections ou questions éditoriales