
Un solo tamaño de archivo, varias mediciones distintas
Una descarga EPUB tiene un único tamaño de archivo, pero esa cifra suma materiales que se comportan de forma distinta dentro del archivo: los documentos de lectura, los archivos de imagen codificados, la navegación, las hojas de estilo y la estructura del paquete aportan bytes. Su porcentaje depende de si se cuenta el archivo recibido o sus elementos ya descomprimidos. Por eso, una frase como «la mayor parte de este ebook son imágenes» necesita dos cosas: un inventario definido de imágenes y un denominador, es decir, el total sobre el que se calcula el porcentaje. Sin ellos, dos cálculos correctos pueden parecer contradictorios cuando en realidad responden a preguntas distintas sobre el mismo archivo.
Este análisis mide doce archivos EPUB3 de Project Gutenberg, en su variante con imágenes, recibidos el 30 de octubre de 2026. En dos de ellos cambia la mayoría de imágenes al cambiar el denominador: las imágenes declaradas superan la mitad de los bytes del archivo recibido, pero ocupan menos de la mitad de los bytes de los elementos descomprimidos. Por otra parte, el orden de los archivos por tamaño recibido no coincide con el orden de dos indicadores de texto explícitos, calculados sin renderizar el libro, en 26 y 29 de los 66 pares de archivos. Son resultados de cuenta sobre un conjunto finito de archivos de conversión; no son estimaciones sobre los ebooks ni sobre obras literarias independientes en general.
La idea común es indicar qué objeto se compara antes de interpretar un tamaño. Quien comprueba una descarga puede distinguir el archivo recibido de sus componentes internos. Quien escribe o cataloga ebooks puede distinguir un inventario de recursos de un indicador de texto. Ninguno de los dos ejercicios mide páginas mostradas, longitud validada de la prosa ni esfuerzo de lectura. Los resultados dan ejemplos reproducibles de decisiones de medición; no establecen que una edición sea derrochadora, esté mal ilustrada, resulte difícil de leer o convenga quitarle recursos.
Mantener intacto el conjunto de archivos recibidos
Los doce archivos llevan los identificadores de Gutenberg 11, 84, 98, 120, 140, 161, 345, 768, 1260, 1342, 2701 y 42324. Sus páginas canónicas, las direcciones reales del espejo oficial, las fechas de recepción, los tamaños en bytes y las huellas digitales de los archivos originales figuran en las descargas de evidencia. El conjunto se heredó sin cambios de un examen estructural anterior. No se eligió para representar un género, un grupo de autores ni la producción actual de EPUB. Cada observación es un archivo de conversión concreto, tal como se recibió, y no una propiedad permanente de un título.
El conjunto incluye Alice’s Adventures in Wonderland, A Tale of Two Cities, Treasure Island, The Jungle, Sense and Sensibility, Dracula, Wuthering Heights, Jane Eyre, Pride and Prejudice y Moby Dick, además de dos transcripciones de Frankenstein. Los dos archivos de Frankenstein siguen siendo casos separados, sin convertirse en obras literarias independientes. Sus diferencias no pueden atribuirse solo al empaquetado, porque no se ha comprobado que su contenido textual y editorial sea equivalente. Del mismo modo, los nombres de la variante con imágenes describen los archivos recibidos; no son una comparación controlada con ediciones sin imágenes.
Son los mismos archivos conservados que se usaron en una revisión de la navegación, pero la pregunta es otra. Aquella revisión encontró destinos de navegación que se resolvían y no respaldó por sí sola la afirmación de que faltaran capítulos. Los fallos de navegación y la accesibilidad quedan fuera de este análisis. Aquí se observan los tipos de elemento declarados, la cuenta de bytes, la compresión y comparaciones de orden entre un número finito de pares. No se volvió a descargar ningún EPUB para buscar una versión más favorable. Un archivo oficial modificado en el futuro sería otro archivo, y sus medidas no deben reemplazar sin aviso este conjunto fechado.
Separar los bytes del archivo de los bytes de sus elementos
Llamamos A a los bytes del cuerpo del archivo recibido. C es la suma de los tamaños comprimidos de los elementos del ZIP y U, la suma de sus tamaños descomprimidos. El resto del contenedor es O = A − C. En los doce archivos, A suma 91.637.973 bytes, C suma 91.486.377, O suma 151.596 y U suma 97.688.762. Las estructuras del contenedor no son otro elemento de contenido y sus bytes no se añaden a U. Mantener visible ese resto evita que los porcentajes por tipo se reajusten sin aviso a otro total.
Para un tipo de elemento r, el porcentaje sobre el archivo comprimido es C_r/A y el porcentaje sobre los elementos descomprimidos es U_r/U. Ambos sirven, pero no son intercambiables. El primero incluye el contenedor ZIP en el denominador; el segundo considera los elementos después de descomprimir el ZIP y deja fuera el contenedor. «Descomprimido» se refiere aquí solo a la capa ZIP. Un JPEG u otro archivo de imagen sigue siendo un archivo codificado, no una cuenta de píxeles. U tampoco representa la memoria de trabajo, la visualización en pantalla ni los recursos que necesita un dispositivo.
El factor de compresión U_r/C_r solo se indica cuando C_r es positivo. Un tipo observado sin elementos tiene cero elementos y cero bytes, pero su factor está indefinido, no es cero. Es distinto de una fuente no disponible, que detendría la verificación en lugar de recibir un cero imputado. Estas diferencias importan sobre todo para las tipografías y los tipos residuales («otros»), que valen cero en todo el conjunto. Cero bytes, un cociente indefinido y un dato ausente son tres situaciones distintas, y deben seguir distinguiéndose en cualquier hoja de cálculo o gráfico que reutilice estos datos.
Clasificar elementos declarados, no ilustraciones visibles
La clasificación sigue el manifiesto y el orden de lectura (spine) reales de cada paquete. Distingue entre: paquete y control, navegación, imágenes de cubierta declaradas, otras imágenes declaradas, XHTML del proveedor, XHTML elegible del orden de lectura, otros XHTML, hojas de estilo, tipografías, otro material declarado y otro material no incluido en el manifiesto. Cada archivo conserva las once filas, incluidos los ceros observados. La cubierta se clasifica según lo que declara el paquete, no según el nombre del archivo ni su aspecto. Los documentos de cabecera y pie del proveedor y la navegación se separan de las mediciones del texto elegible del orden de lectura, para no contarlos como contenido literario.
En todos los archivos, el registro contiene 1.006 elementos ZIP. De ellos, 398 son imágenes declaradas: doce cubiertas declaradas y otras 386 imágenes. Todas las imágenes declaradas están almacenadas sin comprimir en el ZIP, así que sus bytes comprimidos y descomprimidos coinciden. En cambio, los 412 documentos XHTML elegibles del orden de lectura ocupan 8.608.444 bytes descomprimidos y 3.520.103 comprimidos. Este trato distinto cambia el peso relativo de cada tipo cuando el denominador pasa de los bytes del archivo a los bytes de los elementos descomprimidos. No implica una regla general para todos los conversores de EPUB.
Seis archivos tienen una cubierta declarada y ninguna otra imagen declarada: los identificadores 11, 84, 140, 161, 768 y 2701. Es un dato de inventario, no una prueba de que sus páginas no contengan otras ilustraciones. Las imágenes incrustadas como datos, las referencias remotas, los efectos de maquetación y la visibilidad real de las imágenes quedan fuera de este inventario de elementos. Tampoco una cubierta declarada indica la calidad de la imagen ni cómo la muestra una aplicación de lectura. El análisis se detiene a propósito antes de esas preguntas visuales y funcionales, que exigirían otra evidencia y otros métodos.
Dos mayorías de imágenes dependen del denominador
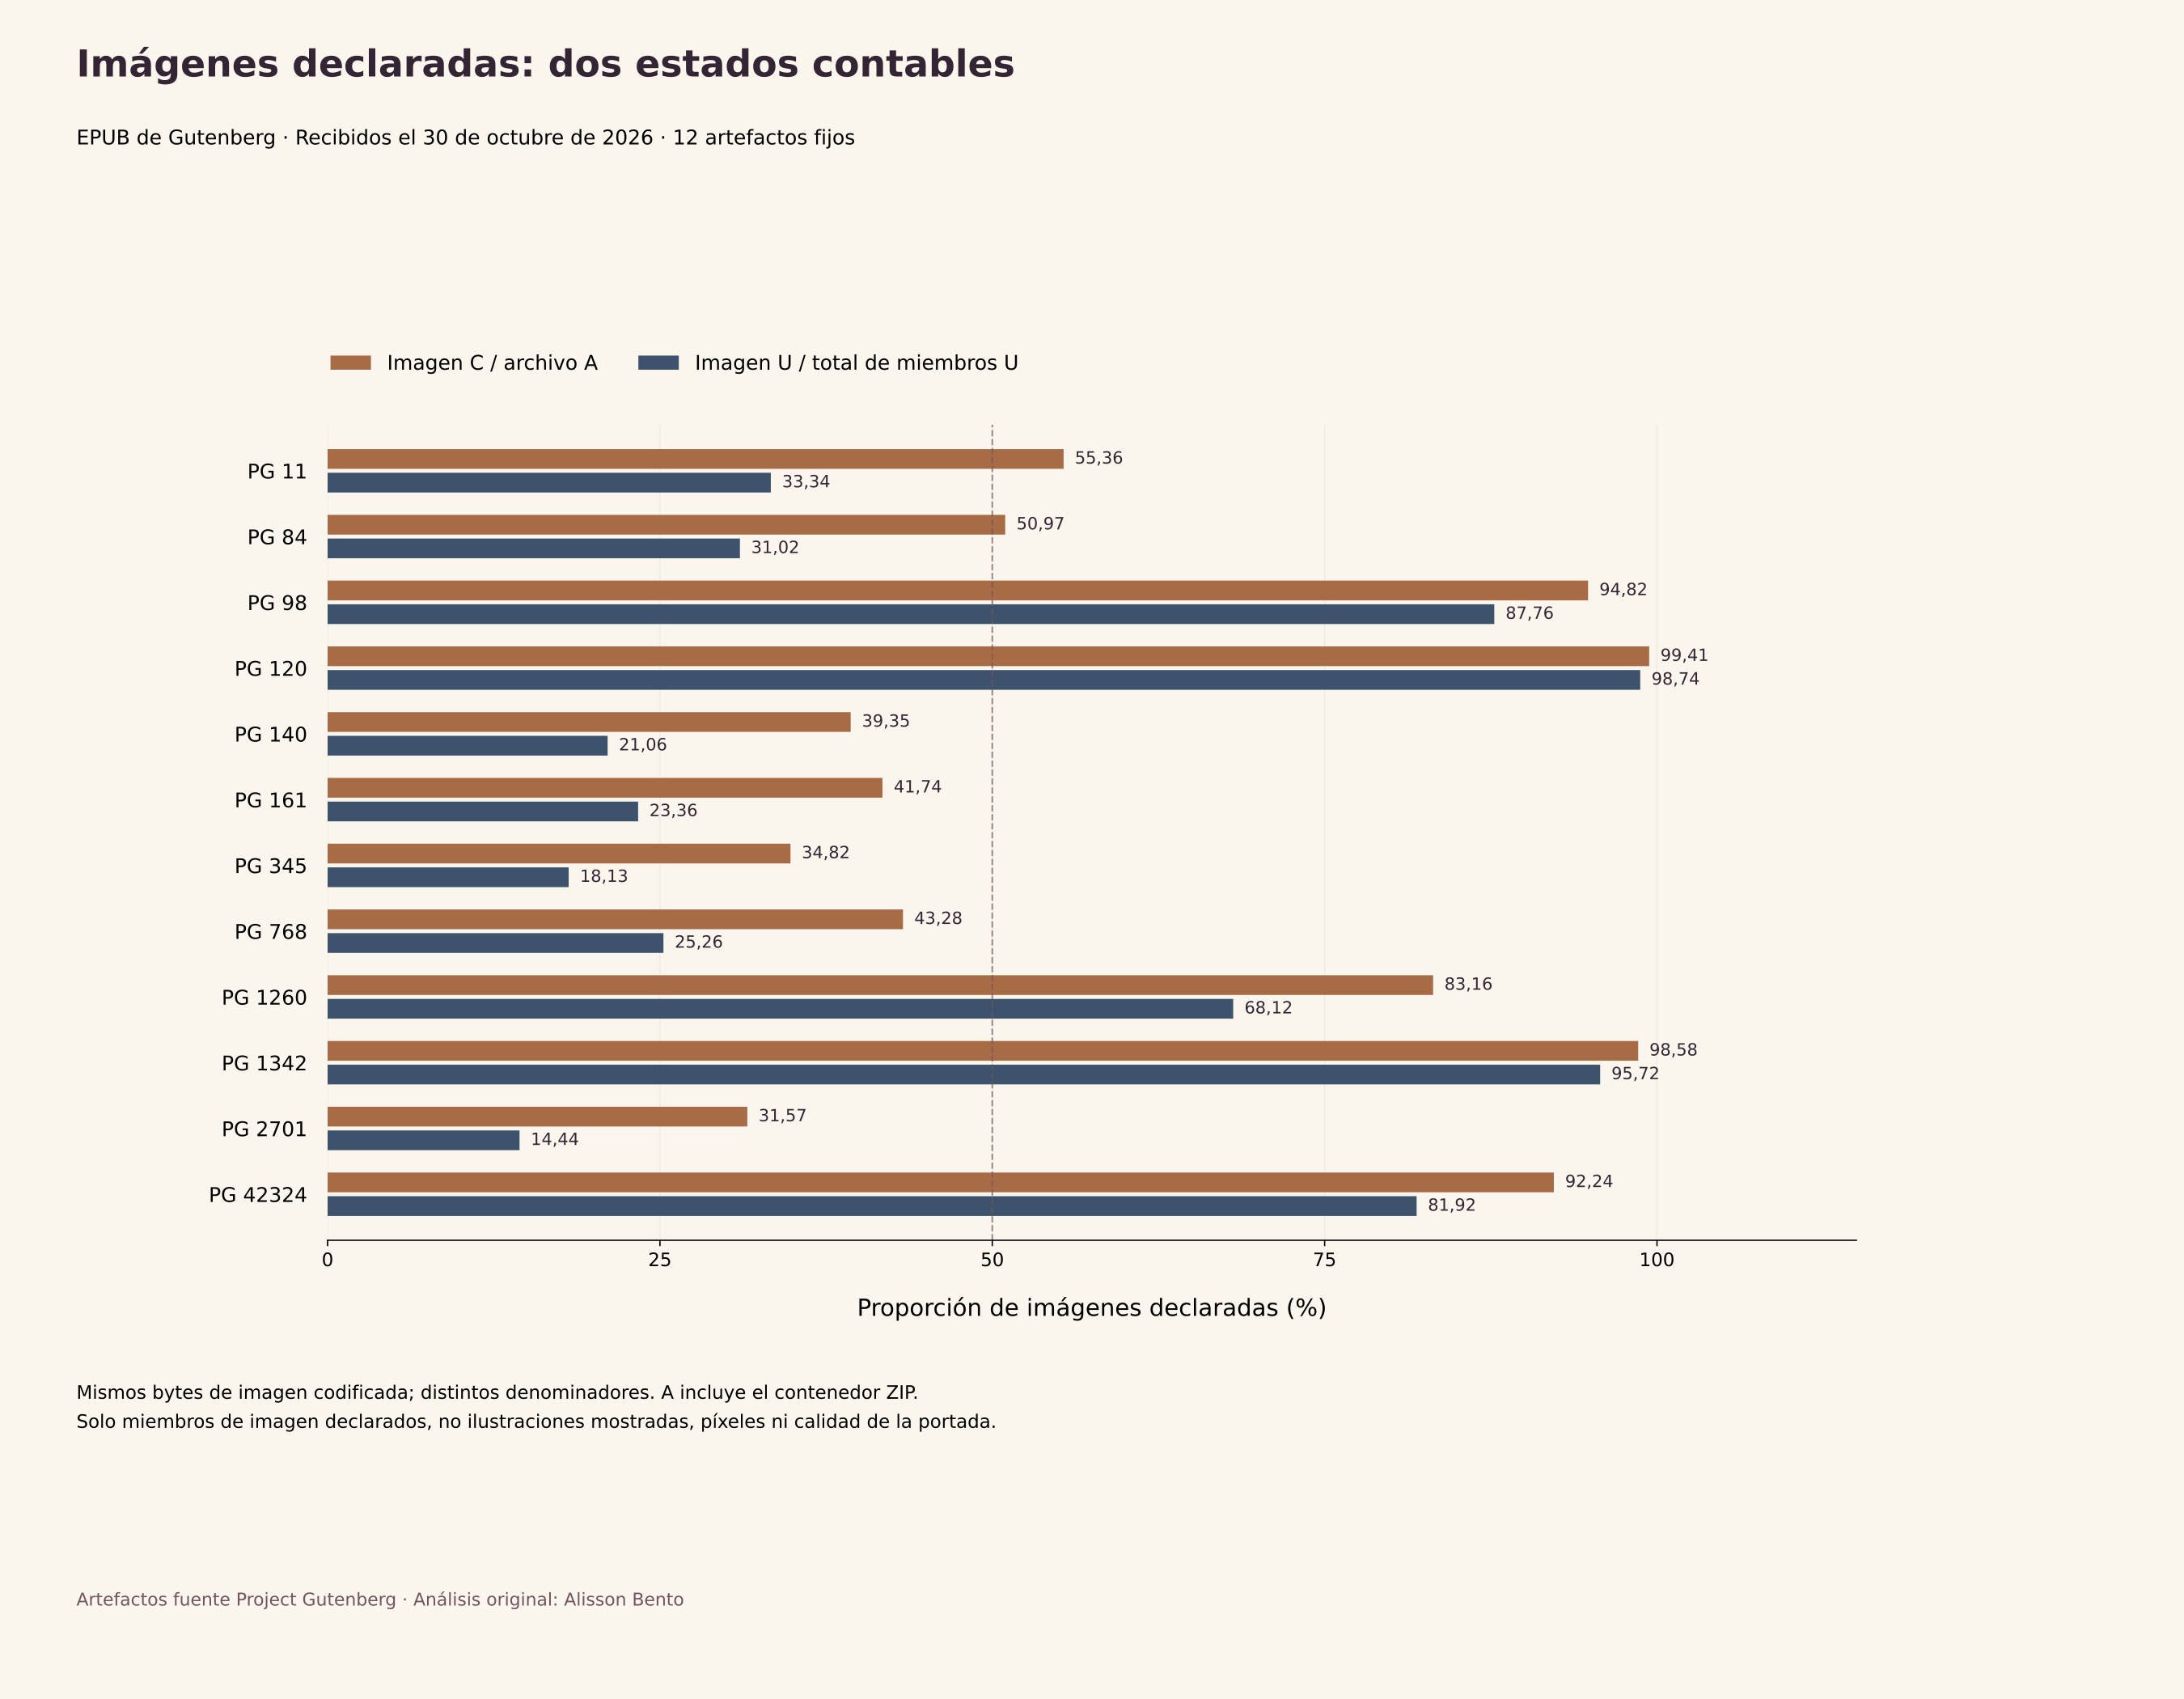
En Alice’s Adventures in Wonderland, identificador 11, la imagen declarada aporta 104.775 bytes. Sobre los 189.249 bytes del archivo recibido, eso es el 55,36 %. Sobre los 314.264 bytes de los elementos descomprimidos, la misma imagen codificada aporta el 33,34 %. Los bytes de la imagen no han desaparecido ni han cambiado de calidad entre un cálculo y otro: lo que cambia es que los elementos descomprimidos que no son imágenes pesan más en el segundo denominador. Por eso son correctas a la vez las frases «el archivo tiene mayoría de imágenes» y «los elementos descomprimidos no tienen mayoría de imágenes», siempre que cada una diga con qué cuenta.
El identificador 84, Frankenstein, muestra el segundo cambio de mayoría. Sus 224.340 bytes de imágenes declaradas son el 50,97 % de un archivo recibido de 440.131 bytes, pero el 31,02 % de sus 723.302 bytes de elementos descomprimidos. En ambos ejemplos, el inventario solo incluye una cubierta declarada. Sus resultados no dependen, por tanto, de un gran número de imágenes interiores declaradas aparte. Las barras emparejadas muestran todos los archivos y no solo los dos casos, para poder verlos junto a aquellos en que ambos porcentajes quedan del mismo lado de la mitad.
Los demás archivos muestran mucha variación sin que haya un cambio de mayoría. En Moby Dick, los porcentajes de imágenes son 31,57 % y 14,44 %; en Treasure Island, 99,41 % y 98,74 %. Estos porcentajes describen los archivos y los denominadores indicados, no una jerarquía de mérito editorial. Un porcentaje alto puede convivir con ilustraciones útiles, y uno bajo no garantiza accesibilidad ni páginas pequeñas. Lo razonable es leerlos como una descripción exacta de lo que ocupa los bytes, no como una recomendación de que una composición sea mejor en sí misma.
Definir indicadores de texto sin fingir que se renderiza
El primer indicador, X, es el número de bytes descomprimidos del XHTML serializado elegible del orden de lectura, sin la navegación ni los documentos de cabecera y pie del proveedor. El marcado serializado forma parte de esa medida, igual que las páginas preliminares, los pies de imagen y cualquier otro material presente en esos documentos. X es fácil de reproducir a partir de la estructura del paquete, pero no es un recuento validado de las palabras de una novela ni una medida del texto visible. El marcado, la codificación de caracteres y la forma de construir los documentos pueden afectar a X aunque la experiencia de lectura en pantalla fuera parecida.
El segundo indicador, T, cuenta los puntos de código del cuerpo literal, con los espacios en blanco normalizados según una convención de extracción explícita. El texto de los elementos retenidos y el texto que sigue a cada elemento (el «tail» de cada hijo) se recogen en el orden del documento. Se omite el interior de los elementos script y style, pero el elemento padre conserva el texto que sigue a cada elemento omitido. Los fragmentos recogidos se unen con un espacio ASCII insertado y después los espacios en blanco Unicode se reducen a uno, separando y volviendo a unir el texto. Los recuentos se suman entre documentos sin añadir ningún separador entre ellos. No se pasa a minúsculas, no se reparan guiones, no se separa en palabras ni se normaliza Unicode.
Esos separadores insertados entre nodos son una convención de cálculo; no afirman que la página mostrada tenga un espacio en cada límite entre elementos. T tampoco determina qué es visible según el CSS, ni identifica todo el contenido que no es prosa, ni establece que las ediciones sean equivalentes. La regla exacta del separador se documentó después del primer cálculo de T para eliminar una ambigüedad, sin cambiar la regla aplicada ni los resultados. No debe presentarse como un detalle registrado de antemano y sin conocer los resultados. Usar los dos indicadores permite inspeccionar sus definiciones; aunque coincidieran, ninguno pasaría a ser la longitud literaria ni el tiempo de lectura.
Comparar órdenes en un conjunto finito, no predecir libros
Para cada indicador, se compara con el tamaño del archivo recibido cada par posible de los doce archivos. Hay una discordancia estricta cuando el archivo mayor tiene el valor menor del indicador, o al revés. Las concordancias estrictas y los empates se cuentan aparte. Son 66 pares dependientes entre sí, no 66 observaciones muestreadas de forma independiente. En el conjunto completo, X da 40 concordancias y 26 discordancias; T da 37 y 29. No hay empates ni en el tamaño del archivo ni en los indicadores. El registro de pares conserva los casos reales detrás de esos totales, en lugar de reducir el resultado a una correlación.
Las correlaciones de Spearman, solo descriptivas, son 0,279720 entre el tamaño del archivo y X, y 0,146853 entre el tamaño del archivo y T, redondeadas a seis decimales. Resumen la asociación de órdenes dentro de este panel fijo. No son medidas de acierto predictivo ni parámetros de una población, ni prueba de que el tamaño del archivo no pueda ser informativo en otro contexto. Como cada archivo participa en varias comparaciones, los totales de pares no deben introducirse en un modelo sencillo de ensayos independientes. Para esta comparación, acotada a propósito, no se ofrecen pruebas de significación, intervalos de confianza ni un modelo general del tamaño de los ebooks.
Un contraste concreto ayuda a entender las unidades. Treasure Island, identificador 120, es el archivo recibido más grande, con 49.452.703 bytes, pero X vale 467.048 y T vale 359.153. Moby Dick, identificador 2701, tiene un archivo de 814.023 bytes, y sin embargo X vale 1.299.019 y T vale 1.113.194. La comparación muestra una diferencia de orden entre esas cantidades registradas; no demuestra que una novela sea más larga en un sentido literario validado. Tampoco aísla el efecto de quitar las imágenes, porque no se produjo ningún paquete alternativo ni una reconstrucción con contenido equivalente.
Mostrar cuánto influyen los archivos más grandes
Al omitir los identificadores 120 y 1342, los dos archivos recibidos más grandes, las asociaciones se refuerzan de forma notable. Entre los diez archivos restantes, las correlaciones suben a 0,648485 para X y a 0,539394 para T. Las discordancias bajan a 11 y 13 de 45 pares, respectivamente. Es una salvedad importante, no una nota que se pueda resumir como «los valores extremos no importan»: sí importan para la fuerza de estas asociaciones. Las discrepancias que quedan muestran que la diferencia de orden no se debe solo a esos dos archivos.
Una segunda restricción omite el identificador 42324, la transcripción de Frankenstein con el identificador más alto. Los once archivos restantes dan 20 discordancias en X y 23 en T entre 55 pares, con correlaciones de 0,363636 y 0,218182. Los dos cambios de mayoría de imágenes se mantienen en ambas restricciones. Estos cálculos muestran la dependencia respecto de un archivo de una obra duplicada y respecto de los archivos más grandes, sin tratar ninguna restricción como una muestra corregida o preferida. Los doce archivos siguen siendo el conjunto principal y no se afirma que las dos transcripciones de Frankenstein sean equivalentes literariamente.
La restricción de los dos mayores se definió conociendo ya los tamaños por el manifiesto heredado. Por eso el nuevo protocolo no puede presumir de haber sido totalmente ciego a los resultados. Fijó las reglas de cuenta y de comparación antes de obtener los nuevos resultados por tipo de elemento y por indicador, pero ya se habían visto la fuente y los tamaños. La aclaración posterior sobre T añade otro límite de fechas, que también se declara. Estas restricciones son análisis de sensibilidad descriptivos y transparentes; no son muestras de validación independientes ni permiten escoger el coeficiente que dé el titular más fuerte. El panel completo debe mantenerse junto a las dos vistas restringidas.
Leer con cuidado los totales agrupados y los porcentajes redondeados
El registro agrupado por tipo suma bytes de todos los archivos; no promedia la composición de doce ebooks. Un archivo grande aporta más bytes a esa suma que uno pequeño. Por eso, un porcentaje agrupado de imágenes respondería a una pregunta de inventario ponderada por volumen; no describiría el archivo típico ni la proporción de títulos con mayoría de imágenes. La tabla por archivo es el lugar adecuado para ver esa variación. Mantener los dos niveles evita que los dos paquetes más grandes definan, sin que se note, un supuesto libro típico.
Las diferencias en puntos porcentuales también necesitan su propia etiqueta. Los dos porcentajes de imágenes de Alice difieren en unos 22,02 puntos porcentuales, calculados con los porcentajes exactos, sin redondear. Eso no es una reducción medida de los bytes de imagen ni una mejora del 22,02 % de nada. El numerador no cambia. Un cambio porcentual relativo usaría otra fórmula y respondería a otra pregunta. El indicador de mayoría solo comprueba si el porcentaje definido supera el 50 %; no valora la magnitud ni la utilidad del inventario de imágenes.
Los porcentajes se muestran con dos decimales y las correlaciones con seis, mientras que los datos de evidencia conservan los números enteros de bytes y los valores calculados sin redondear. Las marcas de mayoría y el sentido de cada par se calculan antes de redondear. Esto importa porque una igualdad tras el redondeo no tiene por qué ser un empate real en otro panel. Aquí no hay empates, ni en el tamaño del archivo ni en los indicadores, pero el registro mantiene aparte los casos de empate. Reutilizar la tabla redondeada para recalcular con exactitud descartaría información que los datos compactos legibles por máquina conservan a propósito.
Aplicar estas distinciones al trabajo de quien lee o escribe ebooks
Para quien lee, la pregunta inmediata puede ser sencilla: qué mide el tamaño de descarga que se anuncia. En este registro, la cantidad pertinente es el número de bytes del cuerpo del archivo recibido; los totales de los elementos responden a otra pregunta de inspección. Ninguna de las dos cifras establece por sí sola cuántas páginas mostrará una aplicación. Guardar la fecha de la captura y la dirección de la variante concreta evita que la etiqueta de una edición ocupe el lugar de un archivo exacto. Es especialmente útil cuando un distribuidor puede regenerar un EPUB sin cambiar el título conocido de la obra.
Para quien escribe o edita ebooks, el registro por tipo de elemento permite hablar del empaquetado sin confundir un porcentaje con un juicio de calidad. Un informe puede identificar los archivos de imagen declarados, distinguir las cubiertas de las demás imágenes declaradas y explicar si los porcentajes usan bytes comprimidos o descomprimidos. También puede mantener visibles la navegación, los documentos del proveedor y el peso del contenedor. Estas distinciones hacen reproducible una conversación técnica. No establecen qué recursos habría que borrar, si conviene volver a comprimir las imágenes ni si un cambio mantendría la experiencia de lectura prevista.
Para quien analiza catálogos, la comparación de órdenes advierte contra sustituir una cantidad de texto definida por un campo sin etiquetar de «tamaño del libro». Las correlaciones más fuertes al excluir los archivos más grandes muestran también por qué importa el panel completo: no hay un coeficiente único que evite examinar los casos. Una reutilización defendible nombraría el conjunto exacto de archivos, el indicador y la forma de contar, y reproduciría las comparaciones finitas pertinentes. No exportaría los coeficientes de este panel como regla de predicción para otro catálogo, otro formato o futuras conversiones de Gutenberg.
Reproducir los datos compactos sin redistribuir libros
El paquete público de evidencia contiene los datos seleccionados de bytes por tipo de elemento, los valores de los indicadores de texto, las referencias a los archivos de origen, las métricas derivadas por archivo y por tipo, todas las comparaciones de pares y un resumen. El programa que reproduce los agregados parte de esos datos compactos y usa carpetas de entrada y de salida indicadas de forma explícita. Un script opcional aparte puede medir EPUB oficiales exactos, obtenidos por separado, tras comprobar sus hashes. No pide nada a las fuentes y produce mediciones numéricas, no contenido de libros. La lista pública de sumas de verificación describe los archivos compactos que se distribuyen; las huellas digitales originales identifican archivos externos que no se incluyen en el paquete.
Los archivos de origen siguen siendo datos privados conservados. El paquete público no incluye el texto completo de ninguna novela, ni texto del cuerpo extraído, ni cubiertas ni ilustraciones, y el registro interno de nombres de elementos no se ofrece para descargar. Los autores de las fuentes y Project Gutenberg reciben atribución aparte de los cálculos y la explicación originales de Alisson Bento. Cada paquete conservado lleva una marca de dominio público en Estados Unidos y la licencia de Gutenberg. Esas marcas y la política citada no acreditan una autorización de derechos en todo el mundo, no suprimen las condiciones sobre la marca ni dan una licencia general para todo el artículo o para cualquier uso posterior.
El resultado final es deliberadamente más acotado que un juicio sobre los ebooks. Dos clasificaciones de mayoría cambian con el denominador, y el orden de los archivos por tamaño difiere del de dos indicadores explícitamente calculados sin renderizar. Los archivos más grandes influyen de forma notable en los resúmenes de orden, mientras que las discrepancias y los cambios de mayoría se mantienen en las restricciones declaradas. Estos resultados apoyan el uso cuidadoso de unidades y ejemplos que se pueden inspeccionar; no apoyan afirmaciones sobre fallos de navegación, calidad visual, tiempo de lectura, tráfico de red, latencia, memoria ni rendimiento de los dispositivos. Respetar esos límites hace útil este pequeño panel fijo, en vez de ser una simple colección de tamaños de archivo llamativos.
Porcentaje de imágenes declaradas: dos formas de contar
EPUB de Gutenberg · Recibidos el 30 de octubre de 2026 · 12 archivos de conversión fijos
Gráfico completo y fuente
Desplaza el gráfico horizontalmente para examinarlo. ↔
Gráfico y valores
Desplaza la tabla horizontalmente para ver todas las columnas.
| Archivo de Gutenberg | A recibido (bytes) | C de imágenes declaradas (bytes) | U descomprimido (bytes) | Imágenes C_img/A (%) | Imágenes U_img/U (%) | Cambio de mayoría (1 = sí) |
|---|---|---|---|---|---|---|
| PG 11 | 189.249 | 104.775 | 314.264 | 55,36 | 33,34 | 1 |
| PG 84 | 440.131 | 224.340 | 723.302 | 50,97 | 31,02 | 1 |
| PG 98 | 7.923.060 | 7.512.341 | 8.559.932 | 94,82 | 87,76 | 0 |
| PG 120 | 49.452.703 | 49.162.018 | 49.789.786 | 99,41 | 98,74 | 0 |
| PG 140 | 615.474 | 242.178 | 1.149.729 | 39,35 | 21,06 | 0 |
| PG 161 | 580.103 | 242.125 | 1.036.582 | 41,74 | 23,36 | 0 |
| PG 345 | 602.902 | 209.921 | 1.157.585 | 34,82 | 18,13 | 0 |
| PG 768 | 587.952 | 254.472 | 1.007.298 | 43,28 | 25,26 | 0 |
| PG 1260 | 3.095.830 | 2.574.499 | 3.779.323 | 83,16 | 68,12 | 0 |
| PG 1342 | 24.864.457 | 24.512.383 | 25.607.139 | 98,58 | 95,72 | 0 |
| PG 2701 | 814.023 | 257.017 | 1.780.233 | 31,57 | 14,44 | 0 |
| PG 42324 | 2.472.089 | 2.280.260 | 2.783.589 | 92,24 | 81,92 | 0 |
Los doce archivos fijos, recibidos el 30 de octubre de 2026. C_img/A usa los bytes del cuerpo del archivo recibido; U_img/U usa los bytes de los elementos descomprimidos. Solo elementos de imagen declarados, incluidas las cubiertas declaradas; no son recuentos de ilustraciones mostradas o incrustadas. Los porcentajes se redondean a dos decimales; la marca de mayoría se calcula con los porcentajes sin redondear. Los identificadores designan archivos, no obras literarias independientes.

El orden archivo–indicador depende del conjunto de archivos
EPUB de Gutenberg · Recibidos el 30 de octubre de 2026 · 12 archivos de conversión fijos
Gráfico completo y fuente

Desplaza el gráfico horizontalmente para examinarlo. ↔
Gráfico y valores
Desplaza la tabla horizontalmente para ver todas las columnas.
| Conjunto fijo de archivos | Indicador | Archivos | Pares | Concordantes | Discordantes | Empates en el tamaño del archivo | Empates en el indicador | Empates en ambos | Rho de Spearman |
|---|---|---|---|---|---|---|---|---|---|
| Todos los archivos fijos | X | 12 | 66 | 40 | 26 | 0 | 0 | 0 | 0,279720 |
| Todos los archivos fijos | T | 12 | 66 | 37 | 29 | 0 | 0 | 0 | 0,146853 |
| Omitir solo PG 42324 | X | 11 | 55 | 35 | 20 | 0 | 0 | 0 | 0,363636 |
| Omitir solo PG 42324 | T | 11 | 55 | 32 | 23 | 0 | 0 | 0 | 0,218182 |
| Omitir PG 120 y 1342 | X | 10 | 45 | 34 | 11 | 0 | 0 | 0 | 0,648485 |
| Omitir PG 120 y 1342 | T | 10 | 45 | 32 | 13 | 0 | 0 | 0 | 0,539394 |
X = bytes descomprimidos del XHTML serializado elegible del orden de lectura; T = puntos de código del cuerpo literal normalizado, con separadores insertados entre fragmentos de nodos. Ninguno es la longitud mostrada ni la longitud validada de la prosa. Cada par posible depende de los demás dentro de su conjunto fijo. La correlación de Spearman es descriptiva, con seis decimales y sin valores p ni intervalos de confianza. Las restricciones son diagnósticos, no correcciones preferidas; la vista previa de las fuentes y los tamaños fue anterior a su definición.

Datos y descargas
Desplaza la tabla horizontalmente para ver todas las columnas.
| Archivo de Gutenberg | A recibido (bytes) | C de imágenes declaradas (bytes) | U descomprimido (bytes) | Imágenes C_img/A (%) | Imágenes U_img/U (%) | Cambio de mayoría (1 = sí) |
|---|---|---|---|---|---|---|
| PG 11 | 189.249 | 104.775 | 314.264 | 55,36 | 33,34 | 1 |
| PG 84 | 440.131 | 224.340 | 723.302 | 50,97 | 31,02 | 1 |
| PG 98 | 7.923.060 | 7.512.341 | 8.559.932 | 94,82 | 87,76 | 0 |
| PG 120 | 49.452.703 | 49.162.018 | 49.789.786 | 99,41 | 98,74 | 0 |
| PG 140 | 615.474 | 242.178 | 1.149.729 | 39,35 | 21,06 | 0 |
| PG 161 | 580.103 | 242.125 | 1.036.582 | 41,74 | 23,36 | 0 |
| PG 345 | 602.902 | 209.921 | 1.157.585 | 34,82 | 18,13 | 0 |
| PG 768 | 587.952 | 254.472 | 1.007.298 | 43,28 | 25,26 | 0 |
| PG 1260 | 3.095.830 | 2.574.499 | 3.779.323 | 83,16 | 68,12 | 0 |
| PG 1342 | 24.864.457 | 24.512.383 | 25.607.139 | 98,58 | 95,72 | 0 |
| PG 2701 | 814.023 | 257.017 | 1.780.233 | 31,57 | 14,44 | 0 |
| PG 42324 | 2.472.089 | 2.280.260 | 2.783.589 | 92,24 | 81,92 | 0 |
Los doce archivos fijos, recibidos el 30 de octubre de 2026. C_img/A usa los bytes del cuerpo del archivo recibido; U_img/U usa los bytes de los elementos descomprimidos. Solo elementos de imagen declarados, incluidas las cubiertas declaradas; no son recuentos de ilustraciones mostradas o incrustadas. Los porcentajes se redondean a dos decimales; la marca de mayoría se calcula con los porcentajes sin redondear. Los identificadores designan archivos, no obras literarias independientes.
Desplaza la tabla horizontalmente para ver todas las columnas.
| Conjunto fijo de archivos | Indicador | Archivos | Pares | Concordantes | Discordantes | Empates en el tamaño del archivo | Empates en el indicador | Empates en ambos | Rho de Spearman |
|---|---|---|---|---|---|---|---|---|---|
| Todos los archivos fijos | X | 12 | 66 | 40 | 26 | 0 | 0 | 0 | 0,279720 |
| Todos los archivos fijos | T | 12 | 66 | 37 | 29 | 0 | 0 | 0 | 0,146853 |
| Omitir solo PG 42324 | X | 11 | 55 | 35 | 20 | 0 | 0 | 0 | 0,363636 |
| Omitir solo PG 42324 | T | 11 | 55 | 32 | 23 | 0 | 0 | 0 | 0,218182 |
| Omitir PG 120 y 1342 | X | 10 | 45 | 34 | 11 | 0 | 0 | 0 | 0,648485 |
| Omitir PG 120 y 1342 | T | 10 | 45 | 32 | 13 | 0 | 0 | 0 | 0,539394 |
X = bytes descomprimidos del XHTML serializado elegible del orden de lectura; T = puntos de código del cuerpo literal normalizado, con separadores insertados entre fragmentos de nodos. Ninguno es la longitud mostrada ni la longitud validada de la prosa. Cada par posible depende de los demás dentro de su conjunto fijo. La correlación de Spearman es descriptiva, con seis decimales y sin valores p ni intervalos de confianza. Las restricciones son diagnósticos, no correcciones preferidas; la vista previa de las fuentes y los tamaños fue anterior a su definición.
Desplaza la tabla horizontalmente para ver todas las columnas.
| Tipo de elemento (declarado) | Elementos | C_r comprimido (bytes) | U_r descomprimido (bytes) | U_r/C_r |
|---|---|---|---|---|
| Paquete y control | 36 | 29.306 | 172.397 | 5,882652 |
| Navegación | 24 | 45.659 | 387.227 | 8,480847 |
| Imágenes de cubierta declaradas | 12 | 2.743.502 | 2.743.502 | 1,000000 |
| Otras imágenes declaradas | 386 | 84.832.827 | 84.832.827 | 1,000000 |
| XHTML del proveedor | 24 | 270.425 | 771.931 | 2,854510 |
| XHTML elegible del orden de lectura | 412 | 3.520.103 | 8.608.444 | 2,445509 |
| Otros XHTML | 0 | 0 | 0 | Indefinido (cero bytes comprimidos) |
| Hojas de estilo | 112 | 44.555 | 172.434 | 3,870138 |
| Tipografías | 0 | 0 | 0 | Indefinido (cero bytes comprimidos) |
| Otros declarados | 0 | 0 | 0 | Indefinido (cero bytes comprimidos) |
| Otros no incluidos en el manifiesto | 0 | 0 | 0 | Indefinido (cero bytes comprimidos) |
Sumas de bytes de los doce archivos; no son la composición media de un libro. Los bytes comprimidos de los elementos suman C = 91.486.377, no A. El resto del contenedor, O = 151.596, es A − C y no es un elemento multimedia ni forma parte de U. Los tipos sin elementos son una ausencia observada; su U/C está indefinido, no es cero ni una fuente ausente. Los bytes de imagen siguen siendo bytes de imagen codificada, no píxeles.
Desplaza la tabla horizontalmente para ver todas las columnas.
| Archivo de Gutenberg | A recibido (bytes) | Elementos comprimidos C (bytes) | Resto del contenedor O (bytes) | U descomprimido (bytes) | XHTML serializado X (bytes) | Cuerpo literal T (puntos de código) |
|---|---|---|---|---|---|---|
| PG 11 | 189.249 | 185.883 | 3.366 | 314.264 | 168.759 | 142.244 |
| PG 84 | 440.131 | 434.011 | 6.120 | 723.302 | 452.075 | 418.114 |
| PG 98 | 7.923.060 | 7.904.510 | 18.550 | 8.559.932 | 949.314 | 751.407 |
| PG 120 | 49.452.703 | 49.408.691 | 44.012 | 49.789.786 | 467.048 | 359.153 |
| PG 140 | 615.474 | 608.964 | 6.510 | 1.149.729 | 855.571 | 805.861 |
| PG 161 | 580.103 | 570.581 | 9.522 | 1.036.582 | 730.802 | 666.929 |
| PG 345 | 602.902 | 596.404 | 6.498 | 1.157.585 | 897.699 | 834.892 |
| PG 768 | 587.952 | 580.950 | 7.002 | 1.007.298 | 703.951 | 642.920 |
| PG 1260 | 3.095.830 | 3.079.104 | 16.726 | 3.779.323 | 1.122.265 | 1.016.740 |
| PG 1342 | 24.864.457 | 24.837.583 | 26.874 | 25.607.139 | 693.662 | 599.785 |
| PG 2701 | 814.023 | 810.935 | 3.088 | 1.780.233 | 1.299.019 | 1.113.194 |
| PG 42324 | 2.472.089 | 2.468.761 | 3.328 | 2.783.589 | 268.279 | 258.014 |
A = C + O. U es la suma de los elementos ZIP descomprimidos y no incluye el resto del contenedor O. X es una parte de U, no todo el texto ni toda la prosa; T es un indicador calculado de puntos de código del cuerpo literal, no son palabras ni páginas. Los bytes del cuerpo del archivo no son el tamaño transferido por HTTP; U no es memoria RAM. Todos los recuentos son números enteros exactos. El título y el autor figuran en las fuentes exactas de cada archivo.
Evidencia y método
Cómo lo calculamos
- Se conservan exactamente los doce archivos EPUB3 oficiales con imágenes, recibidos el 30 de octubre de 2026: IDs 11, 84, 98, 120, 140, 161, 345, 768, 1260, 1342, 2701 y 42324. Se validan los hashes de los originales, los CRC del ZIP, las declaraciones del paquete y los destinos del orden de lectura; no se sustituye ninguna fuente ni se vuelve a descargar nada.
- Se miden los bytes del archivo recibido (A), la suma comprimida de los elementos (C), la suma descomprimida (U) y, aparte, el resto del contenedor (O = A − C). Para cada tipo de elemento se usa C_r/A como porcentaje sobre el archivo comprimido y U_r/U como porcentaje sobre los elementos descomprimidos. U_r/C_r solo se define si C_r es positivo; los tipos observados con valor cero no son fuentes ausentes.
- Cada elemento se clasifica una sola vez según las declaraciones y el orden de lectura reales del paquete: paquete y control, navegación, imagen de cubierta declarada, otra imagen declarada, XHTML del proveedor, XHTML elegible del orden de lectura, otros XHTML, hoja de estilo, tipografía, otro declarado y otro no incluido en el manifiesto. Solo se cuentan los ELEMENTOS de imagen declarados, no las ilustraciones mostradas, incrustadas o remotas.
- X se define como los bytes descomprimidos del XHTML serializado elegible del orden de lectura, sin la navegación ni la cabecera y el pie del proveedor. T se define para cada cuerpo así: se recogen el texto y el tail retenidos en el orden del documento, se omite el interior de script y style pero se conserva el tail que sigue a cada uno, se inserta un espacio ASCII entre fragmentos, se reducen los espacios en blanco Unicode con separación y unión, se cuentan los puntos de código y se suman los documentos sin separadores entre ellos. No se miden el renderizado, las palabras ni las páginas.
- Se comparan todos los pares posibles de archivos: A frente a X y A frente a T. Se conservan por separado las concordancias y las discordancias estrictas, y los empates. Se calculan correlaciones de Spearman descriptivas, con rangos medios en los empates. Los pares dependientes no se tratan como ensayos independientes y no se ofrecen intervalos inferenciales ni afirmaciones predictivas.
- Se mantienen los doce archivos como conjunto principal. Por separado, se recalcula omitiendo la transcripción de Frankenstein con el identificador más alto, PG 42324, y omitiendo los dos archivos más grandes, PG 120 y 1342. Son restricciones declaradas y no preferidas. La vista previa de las fuentes y los tamaños fue anterior al protocolo; la convención del separador de T, sin cambios, se aclaró después de su primer cálculo y no se registró de antemano a ciegas.
- Se reproducen las cuatro salidas agregadas derivadas a partir de datos factuales compactos seleccionados, en una carpeta limpia. La medición original opcional usa EPUB oficiales exactos, obtenidos por separado, con comprobación de hash y de CRC. Los porcentajes se muestran con dos decimales y las correlaciones y los factores con seis; las marcas y los órdenes se calculan antes de redondear. No se distribuye ningún texto de origen, cubierta, ilustración ni el registro privado de nombres de elementos.
Lo que los datos no permiten concluir
- Doce archivos de conversión, conservados por decisión propia e incluidas dos transcripciones de Frankenstein, no son doce obras independientes ni una muestra representativa de Gutenberg, de los ebooks, de los autores o de los formatos. No se ha verificado la equivalencia de contenido entre versiones.
- A cuenta los bytes del cuerpo del archivo recibido, no las cabeceras HTTP ni el tamaño transferido por la red. U cuenta los bytes de los elementos ZIP descomprimidos, no la memoria RAM, las páginas mostradas, el tiempo de lectura, la latencia, el rendimiento del dispositivo ni los costes de entrega. Los archivos de imagen codificados no son píxeles.
- Los tipos de imagen y cubierta describen elementos declarados del paquete. No son un inventario de ilustraciones mostradas o incrustadas, no certifican la calidad de imágenes o cubiertas, no establecen que no haya ilustraciones y no justifican borrar ni volver a comprimir recursos.
- X incluye el marcado serializado y posible contenido que no es prosa. T es una convención de puntos de código del cuerpo literal con espacios insertados entre fragmentos de nodos; no es la visibilidad según el CSS, ni un recuento validado de palabras, ni la longitud literaria, ni una equivalencia del contenido mostrado.
- Excluir PG 120 y 1342 aumenta de forma notable las correlaciones y reduce el número de pares discordantes. Las discrepancias que quedan no establecen que la predicción falle en general; los doce archivos siguen siendo el conjunto principal y ninguna restricción es un conjunto corregido preferido.
- El manifiesto de origen y los tamaños de los archivos ya se conocían antes del nuevo protocolo. Los separadores de nodos de T se aclararon expresamente tras el primer cálculo, sin ajustes ni cambios en los resultados. No se afirma un registro previo totalmente ciego a los resultados ni ser el primer método.
- Los pares de archivos son observaciones dependientes entre sí dentro de un panel finito elegido a propósito. Las correlaciones y los recuentos de orden son solo descriptivos, sin valores p, intervalos de confianza, clasificación de calidad ni estimación de una población general.
- Los tipos observados con valor cero tienen cero elementos y cero bytes y factores de compresión indefinidos. No son datos ausentes. Los futuros archivos oficiales regenerados, con otros hashes, serían archivos distintos y no sustitutos silenciosos de esta captura.
- Las marcas de dominio público en Estados Unidos incorporadas y la licencia completa de Gutenberg no establecen una autorización en todo el mundo ni una licencia general para este artículo. Siguen vigentes las condiciones sobre la marca y las de cada jurisdicción; no se redistribuye contenido de libros ni recursos visuales originales. Los fallos de navegación y la accesibilidad quedan fuera de este análisis.
Fuentes originales
- Project Gutenberg: official generated-content mirroring
Project Gutenberg: copia oficial del contenido generado: La documentación inspeccionada antes identifica gutenberg.pglaf.org como fuente alternativa de la colección generada. Las doce direcciones reales de los archivos recibidos, las fechas UTC y las huellas SHA-256 reales de los archivos oficiales figuran en source-archives.json; estos scripts no hacen nuevas solicitudes. https://www.gutenberg.org/help/mirroring.html
Consultado 30 de octubre de 2026
- Project Gutenberg: licence and rights guidance
Project Gutenberg: licencia y derechos: La política inspeccionada antes y la licencia completa o marca de dominio público en Estados Unidos que lleva cada paquete conservado delimitan los derechos sobre las fuentes. No establecen una autorización en todo el mundo ni dan licencia sobre todo el análisis. No se redistribuye ningún texto, ilustración, cubierta ni logotipo. https://www.gutenberg.org/policy/license.html
Consultado 30 de octubre de 2026
- Project Gutenberg EPUB artifact 11: Alice's Adventures in Wonderland
Archivo EPUB 11 de Project Gutenberg: Alice's Adventures in Wonderland: Lewis Carroll. Variante EPUB3 con imágenes, tal como se recibió, de 189.249 bytes en el cuerpo del archivo; página canónica https://www.gutenberg.org/ebooks/11. La huella digital oficial real del archivo, en source-archives.json, identifica el original obtenido por separado, no un ebook distribuido. Lleva la marca de dominio público en Estados Unidos y la licencia de Gutenberg incorporada; no se afirma autorización mundial ni equivalencia de contenido. https://gutenberg.pglaf.org/cache/epub/11/pg11-images-3.epub
Consultado 30 de octubre de 2026
- Project Gutenberg EPUB artifact 84: Frankenstein; or, The modern Prometheus
Archivo EPUB 84 de Project Gutenberg: Frankenstein; or, The modern Prometheus: Mary Wollstonecraft Shelley. Variante EPUB3 con imágenes, tal como se recibió, de 440.131 bytes en el cuerpo del archivo; página canónica https://www.gutenberg.org/ebooks/84. La huella digital oficial real del archivo, en source-archives.json, identifica el original obtenido por separado, no un ebook distribuido. Lleva la marca de dominio público en Estados Unidos y la licencia de Gutenberg incorporada; no se afirma autorización mundial ni equivalencia de contenido. https://gutenberg.pglaf.org/cache/epub/84/pg84-images-3.epub
Consultado 30 de octubre de 2026
- Project Gutenberg EPUB artifact 98: A Tale of Two Cities
Archivo EPUB 98 de Project Gutenberg: A Tale of Two Cities: Charles Dickens. Variante EPUB3 con imágenes, tal como se recibió, de 7.923.060 bytes en el cuerpo del archivo; página canónica https://www.gutenberg.org/ebooks/98. La huella digital oficial real del archivo, en source-archives.json, identifica el original obtenido por separado, no un ebook distribuido. Lleva la marca de dominio público en Estados Unidos y la licencia de Gutenberg incorporada; no se afirma autorización mundial ni equivalencia de contenido. https://gutenberg.pglaf.org/cache/epub/98/pg98-images-3.epub
Consultado 30 de octubre de 2026
- Project Gutenberg EPUB artifact 120: Treasure Island
Archivo EPUB 120 de Project Gutenberg: Treasure Island: Robert Louis Stevenson. Variante EPUB3 con imágenes, tal como se recibió, de 49.452.703 bytes en el cuerpo del archivo; página canónica https://www.gutenberg.org/ebooks/120. La huella digital oficial real del archivo, en source-archives.json, identifica el original obtenido por separado, no un ebook distribuido. Lleva la marca de dominio público en Estados Unidos y la licencia de Gutenberg incorporada; no se afirma autorización mundial ni equivalencia de contenido. https://gutenberg.pglaf.org/cache/epub/120/pg120-images-3.epub
Consultado 30 de octubre de 2026
- Project Gutenberg EPUB artifact 140: The Jungle
Archivo EPUB 140 de Project Gutenberg: The Jungle: Upton Sinclair. Variante EPUB3 con imágenes, tal como se recibió, de 615.474 bytes en el cuerpo del archivo; página canónica https://www.gutenberg.org/ebooks/140. La huella digital oficial real del archivo, en source-archives.json, identifica el original obtenido por separado, no un ebook distribuido. Lleva la marca de dominio público en Estados Unidos y la licencia de Gutenberg incorporada; no se afirma autorización mundial ni equivalencia de contenido. https://gutenberg.pglaf.org/cache/epub/140/pg140-images-3.epub
Consultado 30 de octubre de 2026
- Project Gutenberg EPUB artifact 161: Sense and Sensibility
Archivo EPUB 161 de Project Gutenberg: Sense and Sensibility: Jane Austen. Variante EPUB3 con imágenes, tal como se recibió, de 580.103 bytes en el cuerpo del archivo; página canónica https://www.gutenberg.org/ebooks/161. La huella digital oficial real del archivo, en source-archives.json, identifica el original obtenido por separado, no un ebook distribuido. Lleva la marca de dominio público en Estados Unidos y la licencia de Gutenberg incorporada; no se afirma autorización mundial ni equivalencia de contenido. https://gutenberg.pglaf.org/cache/epub/161/pg161-images-3.epub
Consultado 30 de octubre de 2026
- Project Gutenberg EPUB artifact 345: Dracula
Archivo EPUB 345 de Project Gutenberg: Dracula: Bram Stoker. Variante EPUB3 con imágenes, tal como se recibió, de 602.902 bytes en el cuerpo del archivo; página canónica https://www.gutenberg.org/ebooks/345. La huella digital oficial real del archivo, en source-archives.json, identifica el original obtenido por separado, no un ebook distribuido. Lleva la marca de dominio público en Estados Unidos y la licencia de Gutenberg incorporada; no se afirma autorización mundial ni equivalencia de contenido. https://gutenberg.pglaf.org/cache/epub/345/pg345-images-3.epub
Consultado 30 de octubre de 2026
- Project Gutenberg EPUB artifact 768: Wuthering Heights
Archivo EPUB 768 de Project Gutenberg: Wuthering Heights: Emily Brontë. Variante EPUB3 con imágenes, tal como se recibió, de 587.952 bytes en el cuerpo del archivo; página canónica https://www.gutenberg.org/ebooks/768. La huella digital oficial real del archivo, en source-archives.json, identifica el original obtenido por separado, no un ebook distribuido. Lleva la marca de dominio público en Estados Unidos y la licencia de Gutenberg incorporada; no se afirma autorización mundial ni equivalencia de contenido. https://gutenberg.pglaf.org/cache/epub/768/pg768-images-3.epub
Consultado 30 de octubre de 2026
- Project Gutenberg EPUB artifact 1260: Jane Eyre: An Autobiography
Archivo EPUB 1260 de Project Gutenberg: Jane Eyre: An Autobiography: Charlotte Brontë. Variante EPUB3 con imágenes, tal como se recibió, de 3.095.830 bytes en el cuerpo del archivo; página canónica https://www.gutenberg.org/ebooks/1260. La huella digital oficial real del archivo, en source-archives.json, identifica el original obtenido por separado, no un ebook distribuido. Lleva la marca de dominio público en Estados Unidos y la licencia de Gutenberg incorporada; no se afirma autorización mundial ni equivalencia de contenido. https://gutenberg.pglaf.org/cache/epub/1260/pg1260-images-3.epub
Consultado 30 de octubre de 2026
- Project Gutenberg EPUB artifact 1342: Pride and Prejudice
Archivo EPUB 1342 de Project Gutenberg: Pride and Prejudice: Jane Austen. Variante EPUB3 con imágenes, tal como se recibió, de 24.864.457 bytes en el cuerpo del archivo; página canónica https://www.gutenberg.org/ebooks/1342. La huella digital oficial real del archivo, en source-archives.json, identifica el original obtenido por separado, no un ebook distribuido. Lleva la marca de dominio público en Estados Unidos y la licencia de Gutenberg incorporada; no se afirma autorización mundial ni equivalencia de contenido. https://gutenberg.pglaf.org/cache/epub/1342/pg1342-images-3.epub
Consultado 30 de octubre de 2026
- Project Gutenberg EPUB artifact 2701: Moby Dick; Or, The Whale
Archivo EPUB 2701 de Project Gutenberg: Moby Dick; Or, The Whale: Herman Melville. Variante EPUB3 con imágenes, tal como se recibió, de 814.023 bytes en el cuerpo del archivo; página canónica https://www.gutenberg.org/ebooks/2701. La huella digital oficial real del archivo, en source-archives.json, identifica el original obtenido por separado, no un ebook distribuido. Lleva la marca de dominio público en Estados Unidos y la licencia de Gutenberg incorporada; no se afirma autorización mundial ni equivalencia de contenido. https://gutenberg.pglaf.org/cache/epub/2701/pg2701-images-3.epub
Consultado 30 de octubre de 2026
- Project Gutenberg EPUB artifact 42324: Frankenstein; or, The modern Prometheus
Archivo EPUB 42324 de Project Gutenberg: Frankenstein; or, The modern Prometheus: Mary Wollstonecraft Shelley. Variante EPUB3 con imágenes, tal como se recibió, de 2.472.089 bytes en el cuerpo del archivo; página canónica https://www.gutenberg.org/ebooks/42324. La huella digital oficial real del archivo, en source-archives.json, identifica el original obtenido por separado, no un ebook distribuido. Lleva la marca de dominio público en Estados Unidos y la licencia de Gutenberg incorporada; no se afirma autorización mundial ni equivalencia de contenido. https://gutenberg.pglaf.org/cache/epub/42324/pg42324-images-3.epub
Consultado 30 de octubre de 2026
Cómo citar y reutilizar
Alisson Bento. Dentro de 12 archivos EPUB: bytes e indicadores de texto. 2026, investigación original. https://alissonbento.com/es/research/gutenberg-epub-payload-composition-12-artifacts/
Se atribuyen a los autores de las fuentes y a Project Gutenberg los archivos EPUB exactos recibidos. Las descargas públicas contienen datos factuales compactos de bytes e indicadores, resultados numéricos y código originales, referencias canónicas a las fuentes y huellas digitales reales de los archivos oficiales; no incluyen texto de ebooks, cubiertas, ilustraciones ni el registro privado de nombres de elementos. Las huellas identifican los originales obtenidos por separado; SHA256SUMS.txt contiene los hashes de los archivos compactos que se distribuyen realmente. Las marcas de dominio público en Estados Unidos y la licencia de Gutenberg están sujetas a límites de jurisdicción y de marca; no se afirma autorización mundial, aval ni licencia general para el artículo. Análisis y explicación originales: Alisson Bento.
Correcciones o consultas editoriales