
Una sola dimensione del file, molte misure
Un download EPUB ha un’unica dimensione, ma quel numero somma materiali che dentro l’archivio si comportano in modo diverso. Contribuiscono ai byte i documenti di lettura, i file di immagini codificate, la navigazione, i fogli di stile e le strutture dell’archivio. Le loro quote cambiano a seconda che si misuri l’archivio ricevuto o i suoi membri non compressi. Un’affermazione come «questo ebook è fatto per lo più di immagini» richiede quindi un elenco preciso delle immagini e un denominatore. Senza questi due elementi, due calcoli corretti possono sembrare in contraddizione, pur rispondendo a domande diverse sullo stesso file.
Questa analisi misura dodici artefatti EPUB3 di Project Gutenberg nella variante con immagini (un artefatto è un file preciso, ricevuto in una data precisa), ricevuti il 30 ottobre 2026 e tenuti come insieme fisso. Per due file la maggioranza delle immagini cambia quando cambia il denominatore: le immagini dichiarate superano metà dei byte dell’archivio ricevuto, ma restano sotto la metà dei byte dei membri non compressi. Inoltre, l’ordine degli archivi per dimensione non coincide con quello di due proxy testuali espliciti, calcolati senza rendering, in 26 e 29 delle 66 coppie di file. Sono risultati contabili su un numero finito di artefatti di conversione, non stime sugli ebook in generale né su opere letterarie indipendenti.
La lezione generale è indicare che cosa si sta confrontando prima di interpretare una dimensione. Chi controlla un download può distinguere il corpo vero dell’archivio dalle sue parti interne. Chi scrive ebook o analizza cataloghi può distinguere un elenco di risorse da un proxy testuale. Nessuna delle due operazioni misura le pagine visualizzate, una lunghezza validata del testo o l’impegno di lettura. I risultati sono esempi riproducibili di scelte di misura; non dimostrano che un’edizione sia inutilmente pesante, illustrata male, difficile da leggere o adatta a eliminarne delle risorse.
Tenere intatto l’insieme dei file ricevuti
I dodici file hanno gli identificatori Gutenberg 11, 84, 98, 120, 140, 161, 345, 768, 1260, 1342, 2701 e 42324. Le pagine canoniche dei titoli, gli indirizzi effettivi del mirror ufficiale, le date di ricezione, le dimensioni in byte e le impronte degli archivi originali sono nei file scaricabili. L’insieme è stato ripreso senza modifiche da un esame precedente della struttura. Non è stato scelto per rappresentare un genere, un gruppo di autori o la produzione EPUB di oggi. Ogni osservazione è un file di conversione preciso, ricevuto in una data precisa, non una proprietà del titolo valida per sempre.
L’insieme comprende Alice’s Adventures in Wonderland, A Tale of Two Cities, Treasure Island, The Jungle, Sense and Sensibility, Dracula, Wuthering Heights, Jane Eyre, Pride and Prejudice e Moby Dick, più due trascrizioni di Frankenstein. I due file di Frankenstein restano casi distinti, senza diventare due opere letterarie indipendenti. Le differenze tra loro non si possono attribuire soltanto al confezionamento del file: non è stato verificato che testo e cura editoriale siano equivalenti. Allo stesso modo, i nomi delle varianti con immagini descrivono i file ricevuti; non sono un confronto controllato con edizioni senza immagini.
Sono gli stessi file conservati per un esame precedente della navigazione, ma la domanda è diversa. Quell’esame aveva trovato destinazioni di navigazione valide e non sosteneva, da solo, l’idea di capitoli mancanti. Qui non si parla di guasti della navigazione né di accessibilità. Si osservano invece i ruoli dichiarati dei membri, il conteggio dei byte, gli stati di compressione e confronti di ordine su un numero finito di coppie. Nessun EPUB è stato scaricato di nuovo per ottenere una versione più favorevole. Un futuro file ufficiale modificato sarebbe un altro artefatto, e le sue misure non devono sostituire in silenzio questo insieme datato.
Distinguere i byte dell’archivio da quelli dei membri
Sia A il numero di byte del corpo dell’archivio ricevuto, C la somma delle dimensioni compresse dei membri ZIP e U la somma delle loro dimensioni non compresse. Il residuo del contenitore è O=A−C. Per questi dodici artefatti, A somma 91.637.973 byte, C 91.486.377, O 151.596 e U 97.688.762. Le strutture del contenitore non sono un altro membro di contenuto e i loro byte non vengono aggiunti a U. Mostrare il residuo evita che le quote dei ruoli vengano ricalcolate in silenzio su un totale diverso.
Per un ruolo r, la quota nell’archivio compresso è C_r/A e la quota nei membri non compressi è U_r/U. Sono utili entrambe, ma non sono percentuali intercambiabili. La prima ha al denominatore anche il contenitore ZIP; la seconda riguarda i membri dopo la decompressione ZIP e lo esclude. «Non compresso» si riferisce qui solo al livello ZIP. Un JPEG o un altro file di immagine codificato resta un file codificato, non un conteggio di pixel grezzi. U non indica nemmeno la memoria di lavoro, il rendering a schermo o le risorse necessarie a un dispositivo.
Il rapporto di compressione U_r/C_r si riporta solo quando C_r è positivo. Un ruolo osservato senza membri ha zero membri e zero byte, ma il suo rapporto è indefinito, non zero. Questo caso è diverso da quello di una fonte non disponibile, che bloccherebbe la verifica invece di ricevere uno zero inventato. La distinzione vale soprattutto per i font e per i ruoli residui, che in questo insieme sono sempre a zero. Zero byte, un quoziente indefinito e un dato mancante sono tre stati diversi, e in un foglio di calcolo o in un grafico riutilizzati devono restare distinguibili.
Classificare i membri dichiarati, non le illustrazioni visibili
La classificazione segue il manifest e lo spine effettivi di ogni pacchetto (il manifest elenca i file del pacchetto, lo spine ne indica l’ordine di lettura). Distingue controllo del pacchetto, navigazione, immagini di copertina dichiarate, altre immagini dichiarate, XHTML del fornitore, XHTML dello spine considerato, altro XHTML, fogli di stile, font, altro materiale dichiarato e altro materiale non presente nel manifest. Per ogni file si conservano tutti gli undici ruoli, compresi gli zeri osservati. La copertina si riconosce dalla dichiarazione del pacchetto, non da un’ipotesi basata sul nome o sull’aspetto del file. I documenti di intestazione e di chiusura del fornitore e la navigazione restano separati dalle misure sul testo dello spine considerato, per non contarli in silenzio come contenuto letterario.
In tutti i file il registro contiene 1.006 membri ZIP. I membri immagine dichiarati sono 398: dodici copertine dichiarate e 386 altre immagini. Ogni membro immagine dichiarato è memorizzato senza compressione ZIP, quindi i suoi byte compressi e non compressi sono uguali. I 412 documenti XHTML dello spine considerato, invece, occupano 8.608.444 byte non compressi e 3.520.103 byte compressi. Il diverso trattamento di questi tipi di membri cambia il loro peso relativo quando si passa dal conteggio sull’archivio a quello sui membri non compressi. Non ne deriva una regola valida per tutti i convertitori EPUB.
Sei artefatti hanno una copertina dichiarata e nessun altro membro immagine dichiarato: i numeri 11, 84, 140, 161, 768 e 2701. È un’affermazione sull’inventario, non la prova che le pagine visualizzate non contengano altre illustrazioni. Le immagini incorporate come dati, i riferimenti remoti, gli effetti di impaginazione e la visibilità reale delle immagini restano fuori da questo inventario dei membri. Una copertina dichiarata non dice nulla né sulla qualità dell’immagine né su come un’app di lettura la mostri. L’analisi si ferma di proposito prima di queste domande visive e funzionali, che richiederebbero altre prove e altri metodi.
Due maggioranze di immagini dipendono dal denominatore
Per Alice’s Adventures in Wonderland (identificatore 11) il membro immagine dichiarato pesa 104.775 byte. Rispetto all’archivio ricevuto di 189.249 byte è il 55,36%. Rispetto ai 314.264 byte dei membri non compressi, la stessa immagine codificata è il 33,34%. I byte dell’immagine non sono spariti e la sua qualità non è cambiata tra i due calcoli. Cambia il fatto che i membri non immagine, una volta decompressi, pesano di più nel secondo denominatore. «Archivio a maggioranza di immagini» e «membri non compressi senza maggioranza di immagini» possono quindi essere entrambe descrizioni corrette, purché ognuna indichi il proprio modo di contare.
L’identificatore 84, Frankenstein, mostra il secondo cambio di maggioranza. I suoi 224.340 byte di immagini dichiarate sono il 50,97% di un archivio ricevuto di 440.131 byte, ma il 31,02% dei suoi 723.302 byte di membri non compressi. In questo inventario entrambi gli esempi hanno solo una copertina dichiarata, perciò i risultati non dipendono da molte immagini interne dichiarate a parte. Le barre affiancate mostrano tutti gli artefatti e non solo quelli che cambiano maggioranza, così si vedono questi esempi accanto ai casi in cui le due percentuali restano dalla stessa parte della metà.
Gli altri file mostrano una grande variazione anche senza cambiare maggioranza. Le quote di immagini di Moby Dick sono 31,57% e 14,44%, quelle di Treasure Island 99,41% e 98,74%. Queste percentuali descrivono gli artefatti e i denominatori indicati, non una graduatoria di valore editoriale. Una quota alta può convivere con illustrazioni utili, così come una quota bassa non garantisce accessibilità né pagine visualizzate piccole. L’interpretazione sensata è una descrizione precisa di ciò che occupa i byte, non il consiglio di preferire una composizione rispetto a un’altra.
Definire i proxy testuali senza fingere di fare il rendering
Il primo proxy, X, è il numero di byte non compressi e serializzati dell’XHTML dello spine considerato, esclusi la navigazione e i documenti di intestazione e chiusura del fornitore. Fa parte della misura anche la marcatura serializzata, come pure eventuali pagine iniziali, didascalie e altro materiale presente in quei documenti. X si riproduce facilmente dalla struttura del pacchetto, ma non è un conteggio validato delle parole del romanzo né una misura del testo visibile. Marcatura, codifica dei caratteri e costruzione dei documenti possono influenzarlo anche quando l’esperienza di lettura sullo schermo sarebbe simile.
Il secondo proxy, T, conta i punti di codice del corpo letterale, con gli spazi normalizzati, secondo una convenzione di estrazione esplicita. Il testo degli elementi mantenuti e il testo che segue i loro elementi figli («tail») si raccolgono nell’ordine del documento; i sottoalberi script e style si saltano, mentre il testo che segue ciascun elemento saltato viene conservato dall’elemento genitore. Le sequenze raccolte si uniscono inserendo un solo spazio ASCII, poi gli spazi Unicode si riducono con split-and-join (si divide il testo sugli spazi e lo si ricompone con uno spazio singolo). I conteggi dei documenti si sommano senza inserire un separatore tra un documento e l’altro. Non si applicano conversione tra maiuscole e minuscole, correzione dei trattini di sillabazione, divisione in parole né normalizzazione Unicode.
Gli spazi inseriti tra i nodi sono una convenzione di calcolo, non l’affermazione che la pagina visualizzata abbia uno spazio a ogni confine tra elementi. T non stabilisce nemmeno la visibilità in CSS, non individua tutto il contenuto che non è prosa e non dimostra che le edizioni siano equivalenti. La regola esatta sul separatore è stata documentata dopo il primo calcolo di T, per eliminare un’ambiguità, senza cambiare la regola applicata né i risultati. Non va presentata come un dettaglio preregistrato senza conoscere i risultati. Usare entrambi i proxy permette di controllarne le definizioni; neppure un loro accordo li trasformerebbe in lunghezza letteraria o in tempo di lettura.
Confrontare ordini su insiemi finiti, senza prevedere i libri
Per ciascun proxy, ogni coppia non ordinata dei dodici artefatti viene confrontata con la dimensione dell’archivio ricevuto. C’è una discordanza stretta quando l’archivio più grande ha il valore di proxy più piccolo, o viceversa. Concordanze strette e parità si contano a parte. Le coppie sono 66 e sono collegate tra loro: non sono 66 osservazioni campionate in modo indipendente. Nell’insieme completo X dà 40 concordanze e 26 discordanze; T ne dà 37 e 29. Non ci sono parità né tra gli archivi né tra i proxy. Il registro delle coppie conserva i casi concreti dietro questi totali, invece di ridurre il risultato a una correlazione.
Le correlazioni di Spearman, usate solo per descrivere, sono 0,279720 tra dimensione dell’archivio e X e 0,146853 tra dimensione dell’archivio e T, arrotondate a sei decimali. Riassumono quanto gli ordini si assomigliano nell’insieme fisso. Non sono punteggi di accuratezza di una previsione né parametri di una popolazione, e non provano che la dimensione di un archivio non possa essere informativa altrove. Poiché ogni artefatto partecipa a più confronti, i totali delle coppie non vanno inseriti in un semplice modello di prove indipendenti. Per questo confronto volutamente limitato non si forniscono test di significatività, intervalli di confidenza né un modello generale delle dimensioni degli ebook.
Un contrasto concreto aiuta a controllare le unità. Treasure Island (identificatore 120) è l’archivio ricevuto più grande, con 49.452.703 byte, ma X è 467.048 e T è 359.153. Moby Dick (identificatore 2701) ha un archivio di 814.023 byte, eppure X è 1.299.019 e T è 1.113.194. Il confronto mostra un ordine che non coincide tra queste quantità registrate; non mostra che un romanzo sia più lungo in senso letterario validato. Non isola nemmeno l’effetto di togliere le immagini, perché non è stato prodotto alcun pacchetto alternativo né una ricostruzione con contenuto equivalente.
Come i file più grandi influenzano il risultato
Se si tolgono gli identificatori 120 e 1342, i due archivi ricevuti più grandi, le associazioni si rafforzano molto. Nei dieci artefatti rimasti le correlazioni salgono a 0,648485 per X e a 0,539394 per T. Le discordanze scendono rispettivamente a 11 e 13 su 45 coppie. È una precisazione importante, non una nota che si possa riassumere con «i valori anomali non contano». Contano, per la forza di queste associazioni su un numero finito di file. Le discordanze che restano mostrano che la differenza tra gli ordini non dipende interamente da quei due file.
Una seconda restrizione omette l’identificatore 42324, la trascrizione di Frankenstein con l’identificatore più alto. Gli undici artefatti rimasti danno 20 discordanze per X e 23 per T su 55 coppie, con correlazioni di 0,363636 e 0,218182. I due cambi di maggioranza delle immagini restano in entrambe le restrizioni. Questi calcoli rendono visibile la dipendenza da un file che riguarda un’opera già presente e dagli archivi più grandi, senza considerare nessuna restrizione come un campione corretto o preferito. Il riferimento resta l’insieme di tutti i dodici artefatti, e non si afferma alcuna equivalenza letteraria tra le due trascrizioni di Frankenstein.
La restrizione ai due archivi più grandi è stata definita conoscendo già le dimensioni degli archivi, grazie all’elenco delle fonti ereditato. Il nuovo protocollo non può quindi dirsi del tutto cieco rispetto ai risultati. Ha fissato le regole di conteggio e di confronto prima dei nuovi risultati su ruoli e proxy, ma fonti e dimensioni erano già state viste. La successiva precisazione su T aggiunge un altro limite temporale dichiarato. Queste restrizioni sono analisi di sensibilità descrittive e trasparenti, non campioni di validazione indipendenti né un permesso di scegliere il coefficiente che dà il titolo più forte. Chi legge deve tenere sempre presente l’insieme completo accanto alle due viste ristrette.
Leggere con cautela i totali aggregati e le percentuali arrotondate
Il registro aggregato dei ruoli somma i byte di tutti gli artefatti; non è la media di dodici composizioni di ebook. Un archivio grande aggiunge a questo conteggio più byte di uno piccolo. Una quota aggregata di immagini risponderebbe quindi a una domanda d’inventario pesata sul volume, e non descriverebbe l’artefatto tipico né la proporzione di titoli con una maggioranza di immagini. La tabella per file è il posto giusto per vedere questa variazione. Tenere disponibili entrambi i livelli evita che i due pacchetti più grandi definiscano in silenzio un presunto libro tipico.
Anche le differenze in punti percentuali vanno indicate come tali. Le due quote di immagini di Alice differiscono di circa 22,02 punti percentuali, calcolati sulle quote non arrotondate. Non è una riduzione misurata dei byte delle immagini, né un miglioramento del 22,02% di qualcosa. Il numeratore non cambia. Una variazione percentuale relativa userebbe un’altra formula e risponderebbe a un’altra domanda. L’indicatore di maggioranza verifica soltanto se la quota definita supera il 50%; non giudica l’entità né l’utilità dell’inventario delle immagini.
Le percentuali mostrate sono arrotondate a due decimali e le correlazioni a sei, mentre gli input conservano i byte interi e i valori calcolati. Gli indicatori di maggioranza e la direzione delle coppie si calcolano prima dell’arrotondamento. La regola conta perché un’uguaglianza dovuta all’arrotondamento potrebbe non essere una vera parità in un altro insieme. Qui non ci sono parità tra archivi o proxy, ma il registro tiene comunque stati di parità distinti. Usare la tabella arrotondata per ricalcolare i valori esatti farebbe perdere informazioni che gli input compatti, leggibili da programma, conservano di proposito.
Usare queste distinzioni nel lavoro di chi legge e di chi produce ebook
Per chi legge, la domanda immediata può essere semplicemente che cosa misuri la dimensione indicata per un download. In questo registro la quantità pertinente è il numero di byte del corpo dell’archivio ricevuto, mentre i totali dei membri rispondono a un’altra domanda di controllo. Nessuno dei due numeri dice, da solo, quante pagine mostrerà un’app. Indicare la data della rilevazione e l’indirizzo preciso della variante evita che l’etichetta di un’edizione prenda il posto del file reale. È utile soprattutto quando un distributore può rigenerare un EPUB senza cambiare il titolo, noto a tutti, dell’opera.
Per chi scrive o cura ebook, il registro dei ruoli permette di parlare del confezionamento senza scambiare una percentuale per un giudizio di qualità. Un rapporto può indicare i file immagine dichiarati, distinguere le copertine dalle altre immagini dichiarate e spiegare se le percentuali usano byte compressi o non compressi. Può anche tenere visibili navigazione, documenti del fornitore e residuo del contenitore. Queste distinzioni rendono riproducibile una discussione tecnica. Non stabiliscono quali risorse eliminare, se ricomprimere le immagini o se una modifica manterrebbe l’esperienza di lettura voluta.
Per chi analizza cataloghi, il confronto degli ordini avverte di non sostituire una quantità di testo ben definita con un campo «dimensione del libro» privo di spiegazione. Anche le correlazioni più forti dopo l’esclusione dei file più grandi mostrano perché serve l’insieme completo: nessun coefficiente evita di esaminare i singoli casi. Un riuso corretto indicherebbe l’insieme preciso di fonti, il proxy e il modo di contare, e poi riprodurrebbe i confronti pertinenti. Non userebbe i coefficienti di questo insieme come regola di previsione per un altro catalogo, un altro formato o future conversioni di Gutenberg.
Riprodurre fatti compatti senza ridistribuire libri
Il pacchetto pubblico di prove contiene input selezionati sui byte dei ruoli, i valori dei proxy testuali, riferimenti agli archivi fonte, metriche derivate per file e per ruolo, tutti i confronti finiti tra coppie e un riepilogo. Il programma che riproduce i totali parte da questi input compatti, con cartelle di ingresso e di uscita indicate esplicitamente. Uno script di misura facoltativo e separato può esaminare EPUB ufficiali identici, ottenuti a parte, dopo aver controllato gli hash degli archivi. Non fa richieste alle fonti e produce misure numeriche, non contenuto di libri. L’elenco pubblico dei checksum descrive i file compatti distribuiti; le impronte degli archivi originali identificano file fonte esterni, che non sono inclusi.
Gli archivi fonte restano input conservati in privato. Il pacchetto pubblico non contiene testi integrali di romanzi, testo estratto dal corpo, copertine o illustrazioni, e il registro interno dei nomi dei membri non si può scaricare. Gli autori delle fonti e Project Gutenberg sono citati a parte rispetto ai calcoli e alla spiegazione originali di Alisson Bento. Ogni pacchetto conservato riporta l’indicazione di pubblico dominio negli Stati Uniti e la licenza di Gutenberg. Queste indicazioni e la politica citata non stabiliscono un’autorizzazione valida in tutto il mondo, non eliminano le condizioni sul marchio e non offrono una licenza generale per l’intero articolo né per ogni riuso successivo.
Il risultato finale è volutamente più ristretto di un giudizio sugli ebook. Due classificazioni di maggioranza cambiano con il denominatore, e gli ordini degli archivi per dimensione differiscono da quelli di due proxy dichiaratamente calcolati senza rendering. I file più grandi influiscono molto sui riepiloghi degli ordini, mentre discordanze e cambi di maggioranza restano nelle restrizioni dichiarate. I risultati sostengono unità ben definite ed esempi controllabili, non affermazioni su problemi di navigazione, qualità visiva, tempo di lettura, traffico di rete, latenza, memoria o prestazioni dei dispositivi. Mantenere questi confini rende utile un piccolo insieme fisso, invece di ridurlo a una raccolta di dimensioni di file impressionanti.
Immagini dichiarate: due stati contabili
EPUB Gutenberg · Ricevuti il 30 ottobre 2026 · 12 artefatti di conversione fissi
Grafico completo e fonte

Scorri il grafico in orizzontale per esaminarlo. ↔
Grafico e valori
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Artefatto Gutenberg | A ricevuto (byte) | Immagini dichiarate C (byte) | U non compresso (byte) | Immagini C_img/A (%) | Immagini U_img/U (%) | Cambio di maggioranza (1=sì) |
|---|---|---|---|---|---|---|
| PG 11 | 189.249 | 104.775 | 314.264 | 55,36 | 33,34 | 1 |
| PG 84 | 440.131 | 224.340 | 723.302 | 50,97 | 31,02 | 1 |
| PG 98 | 7.923.060 | 7.512.341 | 8.559.932 | 94,82 | 87,76 | 0 |
| PG 120 | 49.452.703 | 49.162.018 | 49.789.786 | 99,41 | 98,74 | 0 |
| PG 140 | 615.474 | 242.178 | 1.149.729 | 39,35 | 21,06 | 0 |
| PG 161 | 580.103 | 242.125 | 1.036.582 | 41,74 | 23,36 | 0 |
| PG 345 | 602.902 | 209.921 | 1.157.585 | 34,82 | 18,13 | 0 |
| PG 768 | 587.952 | 254.472 | 1.007.298 | 43,28 | 25,26 | 0 |
| PG 1260 | 3.095.830 | 2.574.499 | 3.779.323 | 83,16 | 68,12 | 0 |
| PG 1342 | 24.864.457 | 24.512.383 | 25.607.139 | 98,58 | 95,72 | 0 |
| PG 2701 | 814.023 | 257.017 | 1.780.233 | 31,57 | 14,44 | 0 |
| PG 42324 | 2.472.089 | 2.280.260 | 2.783.589 | 92,24 | 81,92 | 0 |
Tutti i dodici artefatti fissi, ricevuti il 30 ottobre 2026. C_img/A usa i byte del corpo dell’archivio ricevuto; U_img/U usa i byte dei membri non compressi. Solo membri immagine dichiarati, copertine dichiarate comprese; non sono conteggi di illustrazioni visualizzate o incorporate. Percentuali arrotondate a due decimali; gli indicatori di maggioranza usano le quote non arrotondate. Gli identificatori indicano file, non opere letterarie indipendenti.

L’ordine archivio–proxy dipende dall’insieme
EPUB Gutenberg · Ricevuti il 30 ottobre 2026 · 12 artefatti di conversione fissi
Grafico completo e fonte
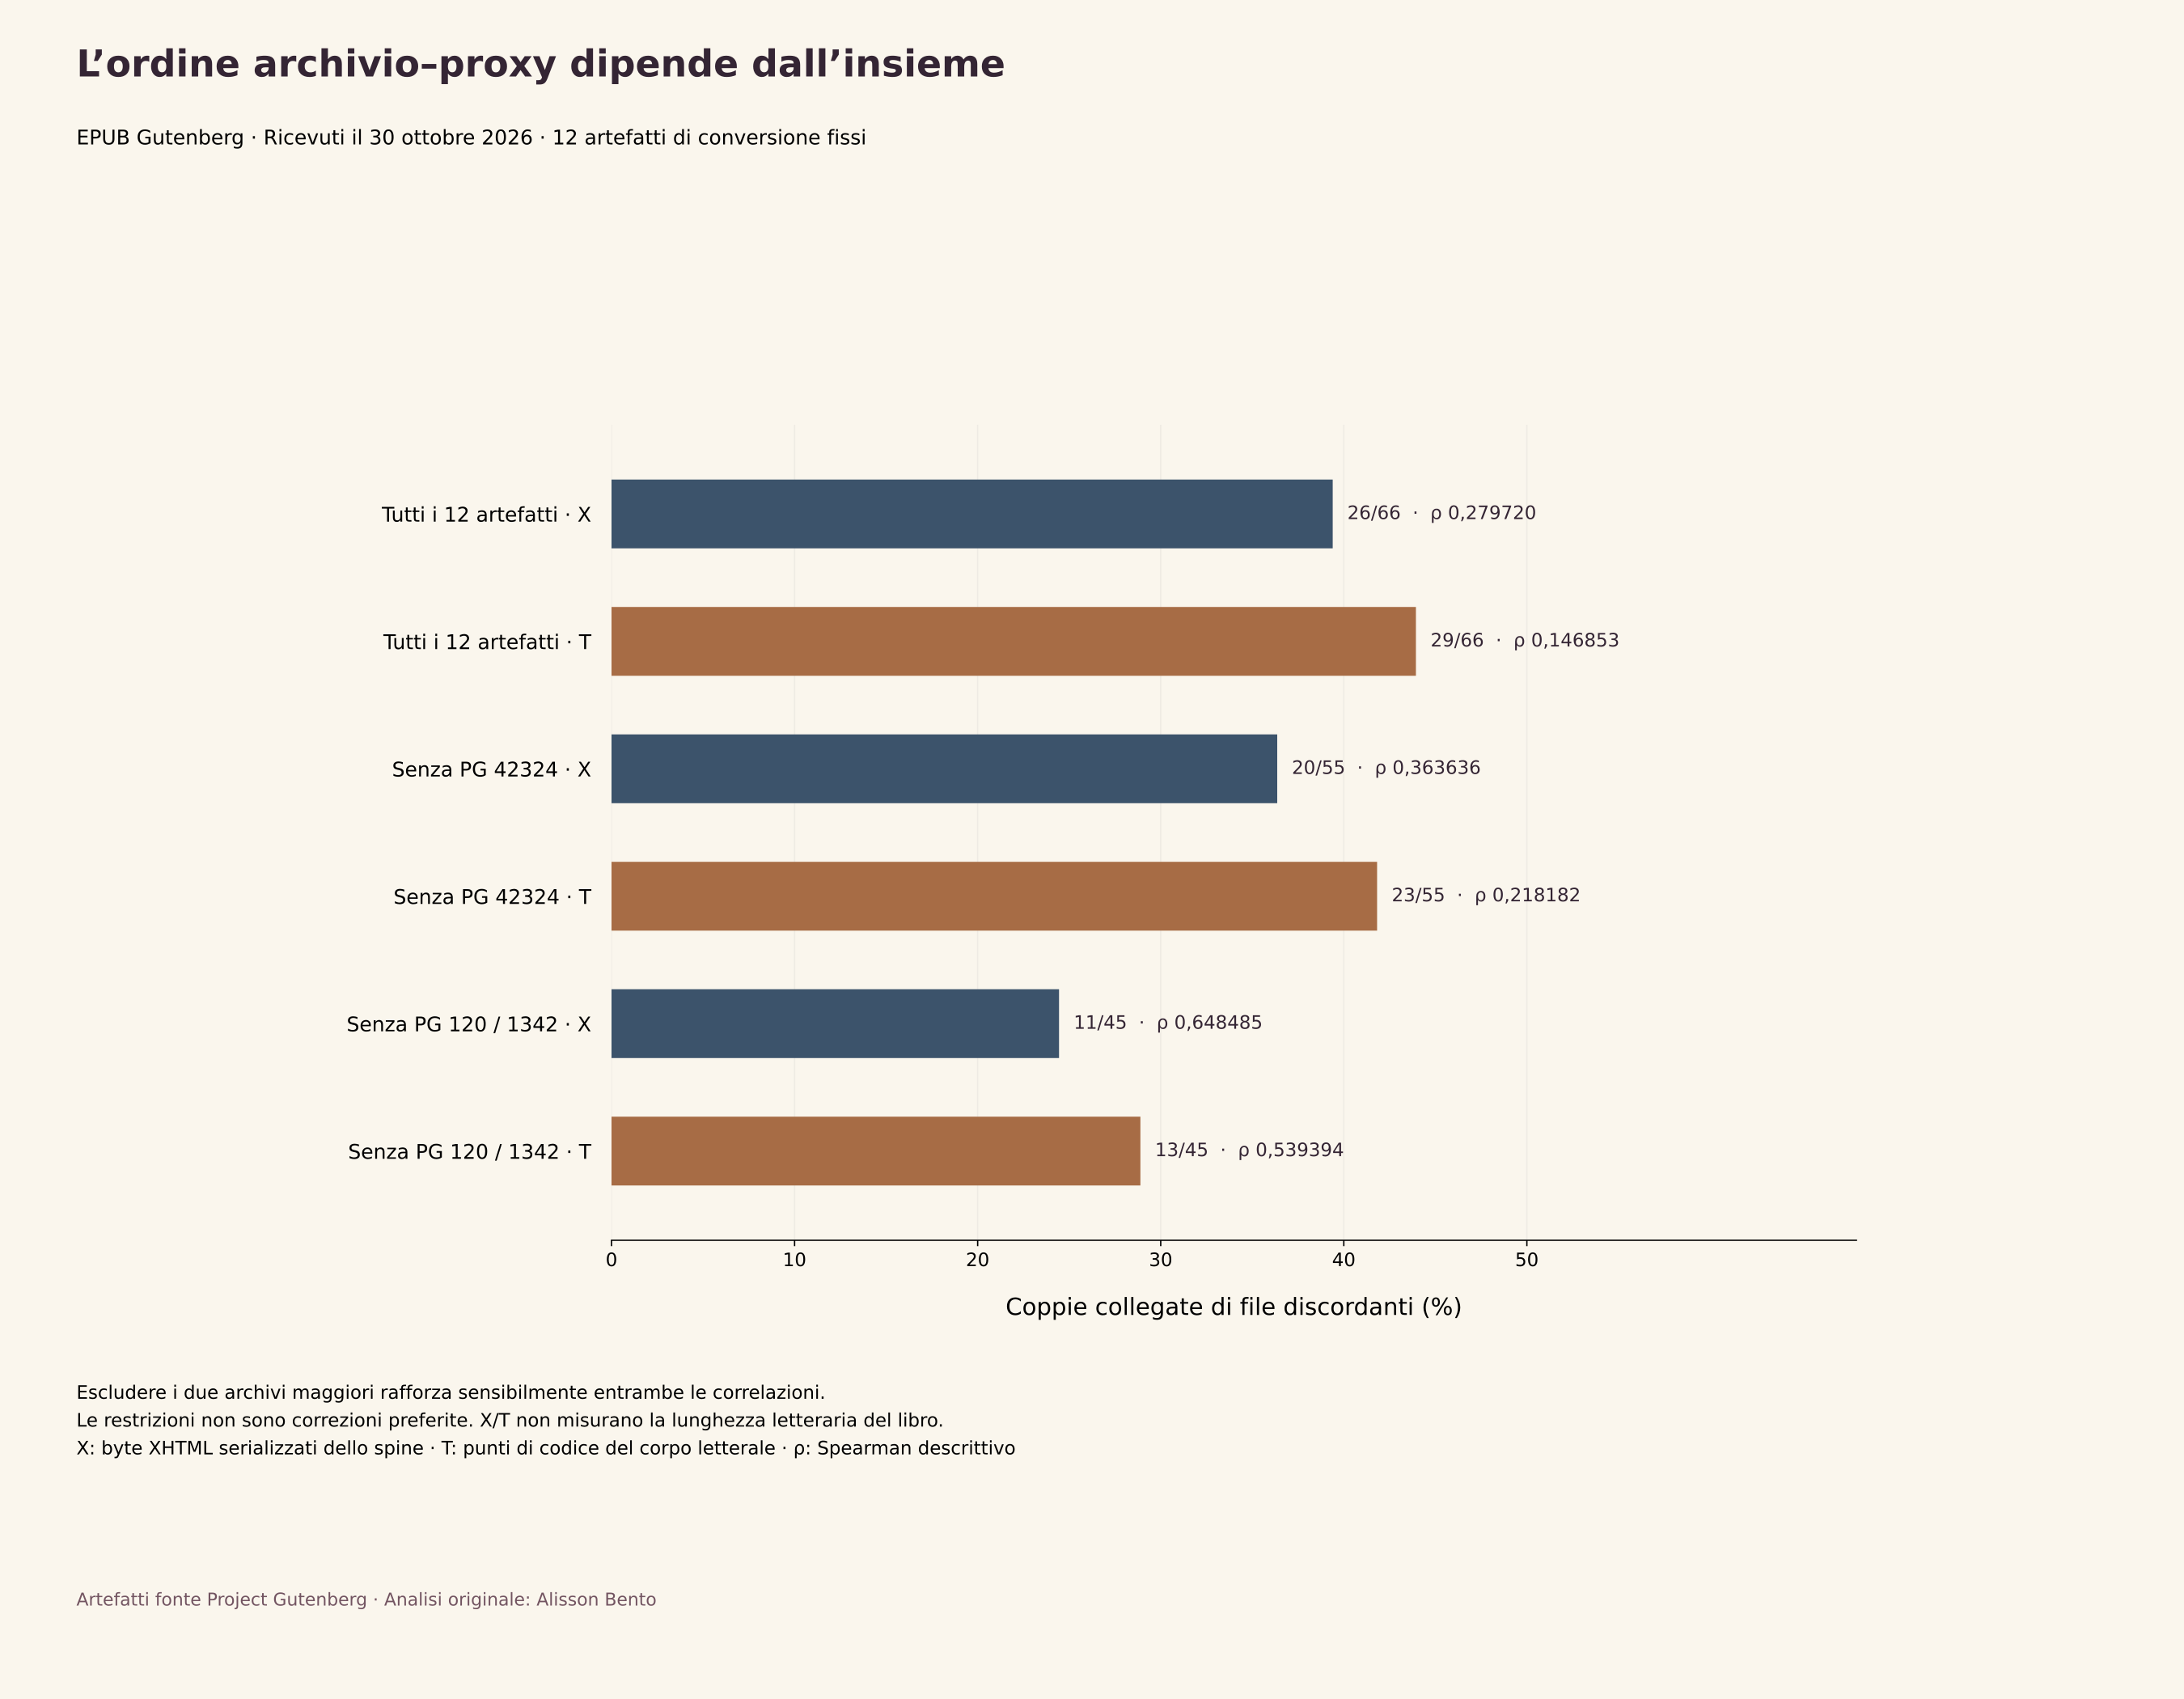
Scorri il grafico in orizzontale per esaminarlo. ↔
Grafico e valori
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Insieme fisso di artefatti | Proxy | File | Coppie | Concordanti | Discordanti | Parità negli archivi | Parità nei proxy | Parità in entrambi | Rho di Spearman |
|---|---|---|---|---|---|---|---|---|---|
| Tutti gli artefatti fissi | X | 12 | 66 | 40 | 26 | 0 | 0 | 0 | 0,279720 |
| Tutti gli artefatti fissi | T | 12 | 66 | 37 | 29 | 0 | 0 | 0 | 0,146853 |
| Senza PG 42324 | X | 11 | 55 | 35 | 20 | 0 | 0 | 0 | 0,363636 |
| Senza PG 42324 | T | 11 | 55 | 32 | 23 | 0 | 0 | 0 | 0,218182 |
| Senza PG 120 e 1342 | X | 10 | 45 | 34 | 11 | 0 | 0 | 0 | 0,648485 |
| Senza PG 120 e 1342 | T | 10 | 45 | 32 | 13 | 0 | 0 | 0 | 0,539394 |
X = byte non compressi e serializzati dell’XHTML dello spine considerato; T = punti di codice del corpo letterale normalizzato, con separatori inseriti tra le sequenze di nodi. Nessuno dei due misura la lunghezza visualizzata né la lunghezza validata della prosa. Ogni coppia non ordinata è collegata alle altre nel proprio insieme fisso. Spearman serve solo a descrivere, è arrotondato a sei decimali e non ha valori p né intervalli di confidenza. Le restrizioni sono diagnostiche, non correzioni preferite; la conoscenza anticipata delle dimensioni delle fonti precedeva la loro definizione.
Dati e download
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Artefatto Gutenberg | A ricevuto (byte) | Immagini dichiarate C (byte) | U non compresso (byte) | Immagini C_img/A (%) | Immagini U_img/U (%) | Cambio di maggioranza (1=sì) |
|---|---|---|---|---|---|---|
| PG 11 | 189.249 | 104.775 | 314.264 | 55,36 | 33,34 | 1 |
| PG 84 | 440.131 | 224.340 | 723.302 | 50,97 | 31,02 | 1 |
| PG 98 | 7.923.060 | 7.512.341 | 8.559.932 | 94,82 | 87,76 | 0 |
| PG 120 | 49.452.703 | 49.162.018 | 49.789.786 | 99,41 | 98,74 | 0 |
| PG 140 | 615.474 | 242.178 | 1.149.729 | 39,35 | 21,06 | 0 |
| PG 161 | 580.103 | 242.125 | 1.036.582 | 41,74 | 23,36 | 0 |
| PG 345 | 602.902 | 209.921 | 1.157.585 | 34,82 | 18,13 | 0 |
| PG 768 | 587.952 | 254.472 | 1.007.298 | 43,28 | 25,26 | 0 |
| PG 1260 | 3.095.830 | 2.574.499 | 3.779.323 | 83,16 | 68,12 | 0 |
| PG 1342 | 24.864.457 | 24.512.383 | 25.607.139 | 98,58 | 95,72 | 0 |
| PG 2701 | 814.023 | 257.017 | 1.780.233 | 31,57 | 14,44 | 0 |
| PG 42324 | 2.472.089 | 2.280.260 | 2.783.589 | 92,24 | 81,92 | 0 |
Tutti i dodici artefatti fissi, ricevuti il 30 ottobre 2026. C_img/A usa i byte del corpo dell’archivio ricevuto; U_img/U usa i byte dei membri non compressi. Solo membri immagine dichiarati, copertine dichiarate comprese; non sono conteggi di illustrazioni visualizzate o incorporate. Percentuali arrotondate a due decimali; gli indicatori di maggioranza usano le quote non arrotondate. Gli identificatori indicano file, non opere letterarie indipendenti.
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Insieme fisso di artefatti | Proxy | File | Coppie | Concordanti | Discordanti | Parità negli archivi | Parità nei proxy | Parità in entrambi | Rho di Spearman |
|---|---|---|---|---|---|---|---|---|---|
| Tutti gli artefatti fissi | X | 12 | 66 | 40 | 26 | 0 | 0 | 0 | 0,279720 |
| Tutti gli artefatti fissi | T | 12 | 66 | 37 | 29 | 0 | 0 | 0 | 0,146853 |
| Senza PG 42324 | X | 11 | 55 | 35 | 20 | 0 | 0 | 0 | 0,363636 |
| Senza PG 42324 | T | 11 | 55 | 32 | 23 | 0 | 0 | 0 | 0,218182 |
| Senza PG 120 e 1342 | X | 10 | 45 | 34 | 11 | 0 | 0 | 0 | 0,648485 |
| Senza PG 120 e 1342 | T | 10 | 45 | 32 | 13 | 0 | 0 | 0 | 0,539394 |
X = byte non compressi e serializzati dell’XHTML dello spine considerato; T = punti di codice del corpo letterale normalizzato, con separatori inseriti tra le sequenze di nodi. Nessuno dei due misura la lunghezza visualizzata né la lunghezza validata della prosa. Ogni coppia non ordinata è collegata alle altre nel proprio insieme fisso. Spearman serve solo a descrivere, è arrotondato a sei decimali e non ha valori p né intervalli di confidenza. Le restrizioni sono diagnostiche, non correzioni preferite; la conoscenza anticipata delle dimensioni delle fonti precedeva la loro definizione.
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Ruolo dichiarato o del membro | Membri | C_r compresso (byte) | U_r non compresso (byte) | U_r/C_r |
|---|---|---|---|---|
| Controllo del pacchetto | 36 | 29.306 | 172.397 | 5,882652 |
| Navigazione | 24 | 45.659 | 387.227 | 8,480847 |
| Immagini di copertina dichiarate | 12 | 2.743.502 | 2.743.502 | 1,000000 |
| Altre immagini dichiarate | 386 | 84.832.827 | 84.832.827 | 1,000000 |
| XHTML del fornitore | 24 | 270.425 | 771.931 | 2,854510 |
| XHTML dello spine considerato | 412 | 3.520.103 | 8.608.444 | 2,445509 |
| Altro XHTML | 0 | 0 | 0 | Indefinito (zero byte compressi) |
| Fogli di stile | 112 | 44.555 | 172.434 | 3,870138 |
| Font | 0 | 0 | 0 | Indefinito (zero byte compressi) |
| Altro dichiarato | 0 | 0 | 0 | Indefinito (zero byte compressi) |
| Altro non presente nel manifest | 0 | 0 | 0 | Indefinito (zero byte compressi) |
Somme dei byte su tutti i dodici artefatti, non composizione media di un libro. I byte compressi dei membri sommano a C=91.486.377, non ad A. Il residuo del contenitore O=151.596 è A−C, calcolato a parte: non è un membro multimediale né parte di U. I ruoli senza membri sono un’assenza osservata; il loro U/C è indefinito, non zero né fonte mancante. I byte dei file di immagine restano byte di immagini codificate, non pixel grezzi.
Scorri la tabella in orizzontale per vedere tutte le colonne.
| Artefatto Gutenberg | A ricevuto (byte) | Membri compressi C (byte) | Contenitore O (byte) | U non compresso (byte) | Spine serializzato X (byte) | Corpo letterale T (punti di codice) |
|---|---|---|---|---|---|---|
| PG 11 | 189.249 | 185.883 | 3.366 | 314.264 | 168.759 | 142.244 |
| PG 84 | 440.131 | 434.011 | 6.120 | 723.302 | 452.075 | 418.114 |
| PG 98 | 7.923.060 | 7.904.510 | 18.550 | 8.559.932 | 949.314 | 751.407 |
| PG 120 | 49.452.703 | 49.408.691 | 44.012 | 49.789.786 | 467.048 | 359.153 |
| PG 140 | 615.474 | 608.964 | 6.510 | 1.149.729 | 855.571 | 805.861 |
| PG 161 | 580.103 | 570.581 | 9.522 | 1.036.582 | 730.802 | 666.929 |
| PG 345 | 602.902 | 596.404 | 6.498 | 1.157.585 | 897.699 | 834.892 |
| PG 768 | 587.952 | 580.950 | 7.002 | 1.007.298 | 703.951 | 642.920 |
| PG 1260 | 3.095.830 | 3.079.104 | 16.726 | 3.779.323 | 1.122.265 | 1.016.740 |
| PG 1342 | 24.864.457 | 24.837.583 | 26.874 | 25.607.139 | 693.662 | 599.785 |
| PG 2701 | 814.023 | 810.935 | 3.088 | 1.780.233 | 1.299.019 | 1.113.194 |
| PG 42324 | 2.472.089 | 2.468.761 | 3.328 | 2.783.589 | 268.279 | 258.014 |
A=C+O. U è la somma dei membri ZIP non compressi ed esclude il residuo del contenitore O. X è una parte di U, non tutto il testo né tutta la prosa; T è un proxy di calcolo, in punti di codice del corpo letterale, non parole o pagine. I byte del corpo dell’archivio non sono la dimensione trasferita in rete con HTTP; U non è RAM. Tutti i conteggi sono interi esatti. Titolo e autore sono indicati nei riferimenti precisi di ciascun artefatto.
Dati e metodo
Come abbiamo calcolato
- Conservare esattamente i dodici corpi di archivio EPUB3 ufficiali, variante con immagini, ricevuti il 30 ottobre 2026: ID 11, 84, 98, 120, 140, 161, 345, 768, 1260, 1342, 2701 e 42324. Verificare gli hash degli archivi originali, i CRC ZIP, le dichiarazioni del pacchetto e le destinazioni dello spine; nessuna sostituzione della fonte e nessun nuovo download.
- Misurare i byte dell’archivio ricevuto A, la somma dei membri compressi C, la somma dei membri non compressi U e il residuo del contenitore O=A−C, tenuto a parte. Per ogni ruolo usare C_r/A come quota nell’archivio compresso e U_r/U come quota nei membri non compressi. U_r/C_r è definito solo per C_r positivo; i ruoli osservati a zero sono indicati esplicitamente e non sono fonti mancanti.
- Classificare ogni membro una sola volta in base alle dichiarazioni effettive del pacchetto e allo spine: controllo del pacchetto, navigazione, immagine di copertina dichiarata, altra immagine dichiarata, XHTML del fornitore, XHTML dello spine considerato, altro XHTML, foglio di stile, font, altro dichiarato e altro non presente nel manifest. Contare soltanto i MEMBRI immagine dichiarati, non le illustrazioni visualizzate, incorporate o remote.
- Definire X come i byte non compressi e serializzati dell’XHTML dello spine considerato, esclusi navigazione e intestazione/chiusura del fornitore. Definire T per ogni corpo raccogliendo nell’ordine del documento il testo (.text) e il testo che segue gli elementi (.tail) da mantenere, saltando l’interno di script e style ma conservando il testo che li segue, inserendo uno spazio ASCII tra le sequenze, riducendo gli spazi Unicode con split-and-join, contando i punti di codice e sommando i documenti senza separatori tra l’uno e l’altro. Non si misurano rendering, parole o pagine.
- Confrontare tutte le coppie non ordinate di file per A rispetto a X e per A rispetto a T. Conservare concordanze strette, discordanze e stati di parità separati. Calcolare correlazioni di Spearman descrittive, con ranghi medi per le parità. Non trattare le coppie collegate come prove indipendenti e non fornire intervalli inferenziali né affermazioni predittive.
- Tenere tutti i dodici artefatti come insieme principale. Ricalcolare a parte senza Frankenstein PG 42324, quello con l’identificatore più alto, e senza i due archivi più grandi PG 120/1342. Sono restrizioni dichiarate e non preferite. L’esame preliminare di fonti e dimensioni precedeva il protocollo; la convenzione sui separatori di T, rimasta invariata, è stata precisata dopo il primo calcolo e non era preregistrata in modo cieco.
- Riprodurre tutti e quattro i risultati aggregati derivati dagli input fattuali compatti selezionati, in una cartella pulita. La misura facoltativa sugli originali usa EPUB ufficiali identici, ottenuti a parte, con controlli di hash e di CRC. Mostrare le percentuali con due decimali e correlazioni e fattori con sei; calcolare indicatori e ordini prima di arrotondare. Non si distribuiscono testo delle fonti, copertine, illustrazioni né il registro privato dei nomi dei membri.
Cosa non possiamo dedurre dai dati
- Dodici artefatti di conversione, scelti di proposito e conservati, tra cui due trascrizioni di Frankenstein, non sono dodici opere indipendenti né un campione rappresentativo di Gutenberg, degli ebook, degli autori o dei formati. L’equivalenza dei contenuti tra le versioni non è verificata.
- A conta i byte del corpo dell’archivio ricevuto, non le intestazioni HTTP né la dimensione trasferita in rete. U conta i byte dei membri ZIP decompressi, non la RAM, le pagine visualizzate, il tempo di lettura, la latenza, le prestazioni dei dispositivi o i costi di consegna. I file di immagine codificati non sono pixel grezzi.
- I ruoli immagine e copertina descrivono membri dichiarati del pacchetto. Non sono un inventario delle illustrazioni visualizzate o incorporate, non certificano la qualità di immagini e copertine, non stabiliscono che manchino illustrazioni e non giustificano l’eliminazione o la ricompressione di risorse.
- X comprende la marcatura serializzata ed eventuale materiale che non è prosa. T è una convenzione sui punti di codice del corpo letterale, con spazi inseriti tra le sequenze di nodi: non indica la visibilità in CSS, né parole validate, lunghezza letteraria o equivalenza dei contenuti visualizzati.
- Escludere PG 120/1342 aumenta molto le correlazioni e riduce le coppie discordanti. Le discordanze che restano non dimostrano che una previsione fallisca in generale; tutti e dodici restano l’insieme principale e nessuna restrizione è un insieme corretto da preferire.
- L’elenco delle fonti e le dimensioni degli archivi erano noti prima del nuovo protocollo. I separatori tra nodi di T sono stati precisati dopo il primo calcolo, senza aggiustamenti né cambi nei risultati. Non si dichiara una preregistrazione del tutto cieca rispetto ai risultati né di aver usato un metodo mai usato prima.
- Le coppie di file sono osservazioni collegate in un insieme finito scelto di proposito. Correlazioni e conteggi degli ordini sono solo descrittivi, senza valori p, intervalli di confidenza, graduatorie di qualità o stime generali su una popolazione.
- I ruoli osservati a zero hanno zero membri e zero byte e un rapporto di compressione indefinito. Non sono dati mancanti. Futuri file ufficiali rigenerati, con hash diversi, sarebbero artefatti diversi e non sostituirebbero in silenzio questa fotografia.
- Le indicazioni incorporate di pubblico dominio negli Stati Uniti e la licenza completa di Gutenberg non stabiliscono un’autorizzazione valida in tutto il mondo né una licenza generale per questo articolo. Restano le condizioni sul marchio e quelle di ciascun Paese; non si ridistribuiscono contenuti dei libri né risorse visive originali. Qui non si trattano i guasti della navigazione né l’accessibilità.
Fonti originali
- Project Gutenberg: official generated-content mirroring
Project Gutenberg, copia ufficiale dei contenuti generati (mirroring): La documentazione già consultata indica gutenberg.pglaf.org come fonte alternativa della raccolta generata. I dodici indirizzi effettivi dei file ricevuti, le date UTC e le impronte SHA-256 reali degli archivi ufficiali sono in source-archives.json; gli script non fanno nuove richieste. https://www.gutenberg.org/help/mirroring.html
Consultato il 30 ottobre 2026
- Project Gutenberg: licence and rights guidance
Project Gutenberg, indicazioni su licenza e diritti: La politica già consultata e la licenza completa incorporata, con l’indicazione di pubblico dominio negli Stati Uniti, in ogni pacchetto conservato definiscono i diritti sulle fonti. Non stabiliscono un’autorizzazione valida in tutto il mondo e non concedono licenza sull’intera analisi. Non si ridistribuiscono testi di ebook, illustrazioni, copertine o loghi. https://www.gutenberg.org/policy/license.html
Consultato il 30 ottobre 2026
- Project Gutenberg EPUB artifact 11: Alice's Adventures in Wonderland
Project Gutenberg, artefatto EPUB 11: Alice's Adventures in Wonderland (Lewis Carroll). Variante EPUB3 con immagini, ricevuta così com’è: 189.249 byte del corpo dell’archivio; pagina canonica https://www.gutenberg.org/ebooks/11. L’impronta reale dell’archivio ufficiale, in source-archives.json, identifica l’originale ottenuto a parte, non un ebook distribuito qui. Indicazione di pubblico dominio negli Stati Uniti e licenza Gutenberg incorporata; non si afferma alcuna autorizzazione valida in tutto il mondo né l’equivalenza dei contenuti. https://gutenberg.pglaf.org/cache/epub/11/pg11-images-3.epub
Consultato il 30 ottobre 2026
- Project Gutenberg EPUB artifact 84: Frankenstein; or, The modern Prometheus
Project Gutenberg, artefatto EPUB 84: Frankenstein; or, The modern Prometheus (Mary Wollstonecraft Shelley). Variante EPUB3 con immagini, ricevuta così com’è: 440.131 byte del corpo dell’archivio; pagina canonica https://www.gutenberg.org/ebooks/84. L’impronta reale dell’archivio ufficiale, in source-archives.json, identifica l’originale ottenuto a parte, non un ebook distribuito qui. Indicazione di pubblico dominio negli Stati Uniti e licenza Gutenberg incorporata; non si afferma alcuna autorizzazione valida in tutto il mondo né l’equivalenza dei contenuti. https://gutenberg.pglaf.org/cache/epub/84/pg84-images-3.epub
Consultato il 30 ottobre 2026
- Project Gutenberg EPUB artifact 98: A Tale of Two Cities
Project Gutenberg, artefatto EPUB 98: A Tale of Two Cities (Charles Dickens). Variante EPUB3 con immagini, ricevuta così com’è: 7.923.060 byte del corpo dell’archivio; pagina canonica https://www.gutenberg.org/ebooks/98. L’impronta reale dell’archivio ufficiale, in source-archives.json, identifica l’originale ottenuto a parte, non un ebook distribuito qui. Indicazione di pubblico dominio negli Stati Uniti e licenza Gutenberg incorporata; non si afferma alcuna autorizzazione valida in tutto il mondo né l’equivalenza dei contenuti. https://gutenberg.pglaf.org/cache/epub/98/pg98-images-3.epub
Consultato il 30 ottobre 2026
- Project Gutenberg EPUB artifact 120: Treasure Island
Project Gutenberg, artefatto EPUB 120: Treasure Island (Robert Louis Stevenson). Variante EPUB3 con immagini, ricevuta così com’è: 49.452.703 byte del corpo dell’archivio; pagina canonica https://www.gutenberg.org/ebooks/120. L’impronta reale dell’archivio ufficiale, in source-archives.json, identifica l’originale ottenuto a parte, non un ebook distribuito qui. Indicazione di pubblico dominio negli Stati Uniti e licenza Gutenberg incorporata; non si afferma alcuna autorizzazione valida in tutto il mondo né l’equivalenza dei contenuti. https://gutenberg.pglaf.org/cache/epub/120/pg120-images-3.epub
Consultato il 30 ottobre 2026
- Project Gutenberg EPUB artifact 140: The Jungle
Project Gutenberg, artefatto EPUB 140: The Jungle (Upton Sinclair). Variante EPUB3 con immagini, ricevuta così com’è: 615.474 byte del corpo dell’archivio; pagina canonica https://www.gutenberg.org/ebooks/140. L’impronta reale dell’archivio ufficiale, in source-archives.json, identifica l’originale ottenuto a parte, non un ebook distribuito qui. Indicazione di pubblico dominio negli Stati Uniti e licenza Gutenberg incorporata; non si afferma alcuna autorizzazione valida in tutto il mondo né l’equivalenza dei contenuti. https://gutenberg.pglaf.org/cache/epub/140/pg140-images-3.epub
Consultato il 30 ottobre 2026
- Project Gutenberg EPUB artifact 161: Sense and Sensibility
Project Gutenberg, artefatto EPUB 161: Sense and Sensibility (Jane Austen). Variante EPUB3 con immagini, ricevuta così com’è: 580.103 byte del corpo dell’archivio; pagina canonica https://www.gutenberg.org/ebooks/161. L’impronta reale dell’archivio ufficiale, in source-archives.json, identifica l’originale ottenuto a parte, non un ebook distribuito qui. Indicazione di pubblico dominio negli Stati Uniti e licenza Gutenberg incorporata; non si afferma alcuna autorizzazione valida in tutto il mondo né l’equivalenza dei contenuti. https://gutenberg.pglaf.org/cache/epub/161/pg161-images-3.epub
Consultato il 30 ottobre 2026
- Project Gutenberg EPUB artifact 345: Dracula
Project Gutenberg, artefatto EPUB 345: Dracula (Bram Stoker). Variante EPUB3 con immagini, ricevuta così com’è: 602.902 byte del corpo dell’archivio; pagina canonica https://www.gutenberg.org/ebooks/345. L’impronta reale dell’archivio ufficiale, in source-archives.json, identifica l’originale ottenuto a parte, non un ebook distribuito qui. Indicazione di pubblico dominio negli Stati Uniti e licenza Gutenberg incorporata; non si afferma alcuna autorizzazione valida in tutto il mondo né l’equivalenza dei contenuti. https://gutenberg.pglaf.org/cache/epub/345/pg345-images-3.epub
Consultato il 30 ottobre 2026
- Project Gutenberg EPUB artifact 768: Wuthering Heights
Project Gutenberg, artefatto EPUB 768: Wuthering Heights (Emily Brontë). Variante EPUB3 con immagini, ricevuta così com’è: 587.952 byte del corpo dell’archivio; pagina canonica https://www.gutenberg.org/ebooks/768. L’impronta reale dell’archivio ufficiale, in source-archives.json, identifica l’originale ottenuto a parte, non un ebook distribuito qui. Indicazione di pubblico dominio negli Stati Uniti e licenza Gutenberg incorporata; non si afferma alcuna autorizzazione valida in tutto il mondo né l’equivalenza dei contenuti. https://gutenberg.pglaf.org/cache/epub/768/pg768-images-3.epub
Consultato il 30 ottobre 2026
- Project Gutenberg EPUB artifact 1260: Jane Eyre: An Autobiography
Project Gutenberg, artefatto EPUB 1260: Jane Eyre: An Autobiography (Charlotte Brontë). Variante EPUB3 con immagini, ricevuta così com’è: 3.095.830 byte del corpo dell’archivio; pagina canonica https://www.gutenberg.org/ebooks/1260. L’impronta reale dell’archivio ufficiale, in source-archives.json, identifica l’originale ottenuto a parte, non un ebook distribuito qui. Indicazione di pubblico dominio negli Stati Uniti e licenza Gutenberg incorporata; non si afferma alcuna autorizzazione valida in tutto il mondo né l’equivalenza dei contenuti. https://gutenberg.pglaf.org/cache/epub/1260/pg1260-images-3.epub
Consultato il 30 ottobre 2026
- Project Gutenberg EPUB artifact 1342: Pride and Prejudice
Project Gutenberg, artefatto EPUB 1342: Pride and Prejudice (Jane Austen). Variante EPUB3 con immagini, ricevuta così com’è: 24.864.457 byte del corpo dell’archivio; pagina canonica https://www.gutenberg.org/ebooks/1342. L’impronta reale dell’archivio ufficiale, in source-archives.json, identifica l’originale ottenuto a parte, non un ebook distribuito qui. Indicazione di pubblico dominio negli Stati Uniti e licenza Gutenberg incorporata; non si afferma alcuna autorizzazione valida in tutto il mondo né l’equivalenza dei contenuti. https://gutenberg.pglaf.org/cache/epub/1342/pg1342-images-3.epub
Consultato il 30 ottobre 2026
- Project Gutenberg EPUB artifact 2701: Moby Dick; Or, The Whale
Project Gutenberg, artefatto EPUB 2701: Moby Dick; Or, The Whale (Herman Melville). Variante EPUB3 con immagini, ricevuta così com’è: 814.023 byte del corpo dell’archivio; pagina canonica https://www.gutenberg.org/ebooks/2701. L’impronta reale dell’archivio ufficiale, in source-archives.json, identifica l’originale ottenuto a parte, non un ebook distribuito qui. Indicazione di pubblico dominio negli Stati Uniti e licenza Gutenberg incorporata; non si afferma alcuna autorizzazione valida in tutto il mondo né l’equivalenza dei contenuti. https://gutenberg.pglaf.org/cache/epub/2701/pg2701-images-3.epub
Consultato il 30 ottobre 2026
- Project Gutenberg EPUB artifact 42324: Frankenstein; or, The modern Prometheus
Project Gutenberg, artefatto EPUB 42324: Frankenstein; or, The modern Prometheus (Mary Wollstonecraft Shelley). Variante EPUB3 con immagini, ricevuta così com’è: 2.472.089 byte del corpo dell’archivio; pagina canonica https://www.gutenberg.org/ebooks/42324. L’impronta reale dell’archivio ufficiale, in source-archives.json, identifica l’originale ottenuto a parte, non un ebook distribuito qui. Indicazione di pubblico dominio negli Stati Uniti e licenza Gutenberg incorporata; non si afferma alcuna autorizzazione valida in tutto il mondo né l’equivalenza dei contenuti. https://gutenberg.pglaf.org/cache/epub/42324/pg42324-images-3.epub
Consultato il 30 ottobre 2026
Citare e riutilizzare lo studio
Alisson Bento. Dentro 12 file EPUB: byte e proxy testuali. 2026, ricerca originale. https://alissonbento.com/it/research/gutenberg-epub-payload-composition-12-artifacts/
Gli autori delle fonti e Project Gutenberg sono citati per gli artefatti EPUB esatti che sono stati ricevuti. I download pubblici contengono input fattuali compatti su byte e proxy, risultati numerici e codice originali, riferimenti canonici alle fonti e impronte reali degli archivi ufficiali; non contengono testi di ebook, copertine, illustrazioni né il registro privato dei nomi dei membri. Le impronte degli archivi identificano gli originali ottenuti a parte; SHA256SUMS.txt riporta gli hash dei file compatti effettivamente distribuiti. Le indicazioni di pubblico dominio negli Stati Uniti e la licenza di Gutenberg restano soggette ai limiti di ciascun Paese e a quelli sul marchio; non si afferma alcuna autorizzazione valida in tutto il mondo, alcuna approvazione né alcuna licenza generale sull’articolo. Analisi e spiegazione originali: Alisson Bento.
Correzioni o domande editoriali